

В 2026 году проверку проходят четыре AI-процесса в финансах: сверка счетов, прогнозирование, категоризация расходов и подготовка к аудиту. Всё остальное — пилотные проекты с красивыми демонстрациями.
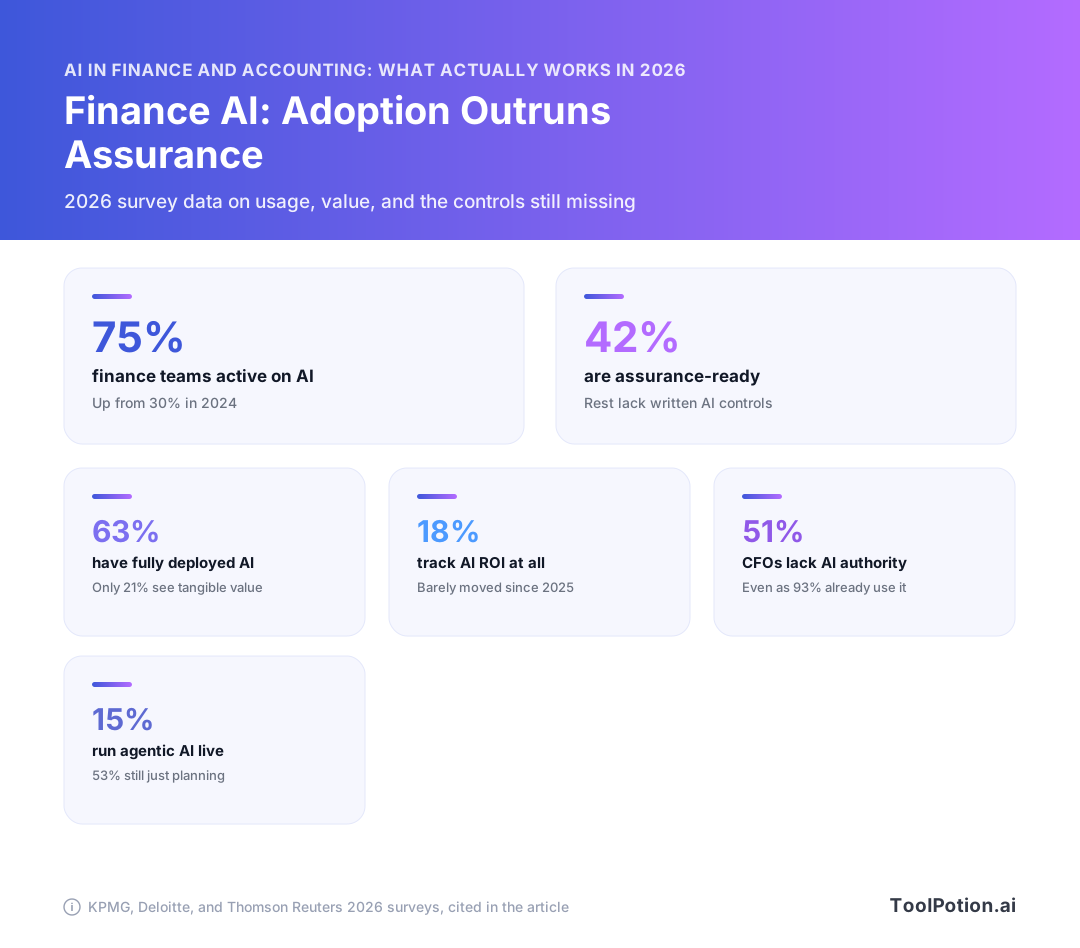
Цифры о внедрении не помогут вам выбрать. KPMG сообщает, что активное использование ИИ в финансовой функции достигло 75% в 2026 году против 30% в 2024-м. Опрос Deloitte Finance Trends среди 1 326 руководителей показал: 63% полностью внедрили ИИ, но лишь 21% видят ощутимую ценность. Thomson Reuters установил, что только 18% вообще как-либо отслеживают ROI. Это не противоречия — это три разных определения слова «внедрение».
Поэтому в этом материале мы фильтруем по контролям: что требует руководство COSO по GenAI от февраля 2026 года, что на самом деле измеряет сноска к показателям точности поставщика и какие из 309 инструментов в нашем каталоге для финансов и банкинга проходят оба теста.
Цифры внедрения ИИ в 2026 году противоречат друг другу — читайте их через определения
Когда один опрос показывает 93%, а другой — 14%, оба могут быть правы. Они считают разные вещи, и почти никто не указывает это в заголовке.
Пилотное использование, внедрённое использование и использование в ключевых процессах — три разных вопроса
Глобальное исследование KPMG «ИИ в финансах 2026» показало, что активное применение ИИ в финансовой функции более чем удвоилось: с 30% в 2024-м до 75% в 2026-м, при этом 71% финансовых руководителей заявили, что ИИ соответствует или превосходит ожидания по ROI. «Активное использование» здесь охватывает всё работающее — включая контроллера, который вставляет комментарии по отклонениям в окно чата. Thomson Reuters, спрашивая об использовании GenAI в масштабе организации, получил 40%, против 22% годом ранее, и лишь 15% для агентного ИИ — при том что 53% планируют или рассматривают его. Один год, одна профессия, разброс в три раза. Виновата формулировка вопроса, а не рынок.
Поэтому, прежде чем цитировать цифру, найдите определение: считает ли она всех, кто попробовал инструмент, всех, чья компания купила его, или процесс, который пережил закрытие периода под взглядом аудитора? Только третье что-то говорит о вашей собственной дорожной карте.
Разрыв между внедрением и ценностью, который никто не сверяет
Опрос Deloitte Finance Trends 2026 среди 1 326 глобальных финансовых руководителей — тот, который стоит держать под рукой, потому что в нём задавали оба вопроса. 63% полностью внедрили ИИ в финансы, 21% считают, что инвестиции принесли ощутимую ценность, и 14% полностью интегрировали AI-агентов. Внедрение примерно втрое опережает ценность. Этот разрыв и есть реальное состояние финансового ИИ в 2026 году — и именно эту цифру стоит брать на любой звонок с поставщиком.
ROI почти никто не измеряет
Вот что делает каждую диаграмму внедрения слабее, чем кажется: только 18% респондентов знали, что их организация хоть как-то отслеживает ROI от ИИ — примерно на том же уровне, что и год назад, — и большинство из тех, кто отслеживает, измеряют внутренние операционные метрики, а не бизнес-результаты. Субъективная удовлетворённость незамеренными затратами — это настроение, а не свидетельство.
Помогают две привычки. Проверяйте каждую статистику по определению из самого опроса, прежде чем её цитировать, и относитесь к любой цифре из спонсированного поставщиком исследования как к маркетинговому заявлению — пока не найдёте сноску. Мы применяем тот же фильтр к 309 AI-инструментам для финансов и банкинга в нашем каталоге и к отчётам об AI-трендах, которые мы отслеживаем, — именно поэтому шортлист в следующем разделе такой короткий.
Сверка счетов: реальный процент автоматического сопоставления
Рассчитывайте на 60–80% автоматически сертифицированных счетов и стройте бизнес-кейс от нижней границы этого диапазона. Число, которое вы услышите на демо, — «до 98%» автосертификации при 99% точности сопоставления. Наблюдаемые результаты у реальных клиентов — от 43% до 85%, так что 60–80% — это честное плановое предположение (Numeric). Если ваша модель укомплектования штата работает только при 90%, проект провалится до первого закрытия месяца.
Маркетинговый потолок против наблюдаемого диапазона у клиентов
43% и 85% — это одно и то же программное обеспечение. Разброс определяется вашими данными, а не моделью поставщика.
98% достижимы на узком срезе: высокообъёмные счета с малой дисперсией — например, банковский кэш и расчёты по кредитным картам, — с чистым сопоставлением один-к-одному и щедро установленным порогом существенности. Подключите к тому же инструменту предоплаченные расходы, внутрифирменные расчёты, начисленные обязательства и запасы — и процент сертифицированных упадёт резко, потому что эти счета требуют суждения, а не сопоставления. Спросите у любого поставщика, какие типы счетов покрывает процент его эталонного клиента. Если ответ — «наличность и дебиторская задолженность», вы узнали, что цифра — это показатель по подмножеству, а не по всему портфелю.
Что определяет разрыв: качество данных, охват суб-книг, пороги существенности
Три фактора решают, где вы окажетесь, и все три под вашим контролем — ещё до подписания. Первый — охват суб-книг: счета, вспомогательная детализация которых хранится в таблицах или системах без API, не поддаются автосертификации ни при какой точности — посчитайте их и вычтите из знаменателя прямо сейчас. Второй — качество данных: согласованные идентификаторы в справочниках, стабильные наименования поставщиков и банковский фид, не переписывающий прошлые периоды. Третий — пороги существенности, и именно здесь тихо нажимают на рычаг, чтобы дашборд выглядел красиво.
Поднимите порог автосертификации с $500 до $5 000, и ваш показатель вырастет — без единого улучшения в качестве сопоставления. Аудитор это заметит. Установите порог из вашей текущей документации SOX и оставьте его на всё время пилота, а потом замерьте. Кейсы ИИ с раскрытыми результатами в нашем каталоге стоит читать с тем же фильтром: проверяйте, называет ли заявленный показатель типы счетов и порог, — большинство не называет.
Критерии приёмки, которые нужно внести в договор о пилоте
Внесите их в форму заказа, а не в презентацию для кик-оффа. Проведите полный квартальный конец — все три месяца, по всему реальному портфелю счетов.
- Уровень автосертификации не менее 65% по всем балансовым счетам в периметре, измеренный по вашему текущему порогу существенности — зафиксированному на всё время пилота.
- Нулевой уровень ложной сертификации по счетам выше порога существенности, где ложная сертификация означает, что инструмент сертифицировал остаток, который проверяющий впоследствии был вынужден открыть заново. Именно эта цифра завершает пилот, а не уровень сопоставления.
- Каждая сертификация создаёт экспортируемый аудиторский след с исходными сопоставленными записями, применённым правилом или версией модели и именем сотрудника, одобрившего очередь исключений.
- Процент переопределений отслеживается ежемесячно и передаётся вам, чтобы вы видели отклонение раньше аудитора.
Если поставщик не готов взять на себя измеренный показатель по вашим данным, оцените сделку так, будто получите 43%.
Прогнозирование: реальный выигрыш в скорости, очень неравномерный — в точности
Покупайте AI для FP&A ради сокращения цикла, а не ради улучшения цифры. Мартовский опрос KPMG 2026 года среди 1 013 старших финансовых руководителей из 20 стран показал: скорость принятия решений улучшилась у 71%, качество решений — у 70%, а точность прогнозов — у 64% (KPMG). Эти 64% — самый слабый из трёх показателей, и за ним скрывается разброс, достаточный, чтобы разрушить бизнес-кейс.
Скорость принятия решений улучшается надёжнее, чем точность прогнозов
Выигрыш в скорости и качестве обеспечивается там, где ИИ работает хорошо: сведение фактических данных из четырёх систем в одно представление отклонений, составление комментариев, пересчёт сценариев за минуты вместо дня. Ни одно из этих действий не требует, чтобы модель что-то предсказывала. Требуется, чтобы она собирала и объясняла — и вот в этом она сильна.
Поэтому прописывайте критерии успеха в днях, а не в базисных пунктах. Время от закрытия до готового прогноза, количество сценариев за цикл, часы аналитика, потраченные на сборку данных. Если ваш единственный критерий приёмки — ошибка прогноза, вы делаете ставку на самый слабый из трёх измеренных KPMG результатов.
Почему в банкинге 71%, а в здравоохранении — 44%
Прирост точности прогнозов варьировался от 71% в банкинге до 44% в здравоохранении по данным того же исследования KPMG (KPMG). Разрыв соответствует объёму чистой, высокочастотной, структурированной истории данных в отрасли. У банкинга — ежедневные транзакционные данные за десятилетия, с ценами и временны́ми метками. В здравоохранении прогнозирование зависит от структуры плательщиков, условий контрактов и сроков возмещения, которые хранятся в тексте и меняются с каждым договором.
Спросите поставщика, из какого из этих двух миров пришли его эталонные клиенты. Результат 71% в data-rich секторе практически ничего не говорит о вашем прогнозе выручки, если исходные данные — это PDF-контракты.
Где FP&A-копайлоты останавливаются: уровень допущений остаётся за людьми
Модель может экстраполировать тренд ваших бронирований. Она не может решить, что новый ценовой уровень меняет отток, что план найма на Q3 сдвигается на шесть недель или что клиенту, перезаключающему договор в ноябре, нужно сделать 30-процентный дисконт. Эти допущения управляют прогнозом, и они исходят от людей, которые общаются с продажами и операционным блоком.
Ограничьте инструмент всем, что ниже уровня допущений, а сами допущения ведите в доступном для проверки реестре с указанием ответственного и даты для каждого.
Категоризация расходов: ближайшее к решённому рабочему процессу
Если в этом квартале вы запускаете один AI-процесс в финансах, пусть это будет кодирование транзакций и проверка политики расходов. Задача узкая, эталон истины записан в вашем же документе с политикой, и каждое решение агента оставляет проверяемый след.
Почему проверка политики лучше подходит агенту, чем суждение
Проверка политики — это поиск по правилам, которые вы сами написали. Есть ли чек на этот ужин за $340, указана ли бизнес-цель и вписываются ли участники в лимит на человека? Это детерминированное рассуждение по структурированным полям плюс изображение чека, а режимы отказа видны проверяющему за секунды. Сравните это с прогнозом, где никто не скажет вам, была ли цифра неверной, пока не закроется квартал. Кодирование ближе к концу политики: продавец, сумма, подразделение, счёт GL, а историческое кодирование — это набор меток.
Помогает и объём. В месяц вы получаете тысячи почти одинаковых решений — это именно та форма, при которой показатель точности становится значимым, а не анекдотичным.
Что на самом деле измеряет определение точности поставщика
Ramp публикует ~85% сокращения ручных проверок при точности 99%+ для своего агента по политикам, и определяет точность в сноске: одобрения, рекомендованные агентом, которые также одобрили проверяющие-люди, — по внутреннему анализу от 01.07.25 (Ramp Support). Прочитайте это определение дважды, прежде чем вносить его в бизнес-кейс. Оно оценивает согласованность по пути одобрения — значит, ничего не говорит о расходах, которые агент ошибочно пометил, и о нарушениях, которые он одобрил, а проверяющий пропустил. Раскрытая методология ставит Ramp впереди большинства игроков на рынке, которые в основном публикуют процент без знаменателя. Запросите у каждого поставщика в шортлисте ту же сноску — и воспринимайте отказ как ответ.
Дизайн с участием человека для оставшихся исключений
Направляйте 15%, которые агент не пропускает, именованному проверяющему, фиксируйте уровень переопределений и устанавливайте порог, при достижении которого запускается переобучение. Этот процент переопределений — один из KPI дрейфа, которого требует руководство COSO по GenAI от февраля 2026 года (Deloitte Heads Up). Среди 550 AI-агентов в нашем каталоге заслуживают внимания те, которые передают вам этот лог без обращения в поддержку.
Подготовка к аудиту: доказательства, которые аудитор действительно может проверить
Задайте любому поставщику систем для подготовки к аудиту один вопрос, прежде чем смотреть демо: как выглядит экспорт, когда команда аудиторов спрашивает, как была получена та или иная цифра? Если ответ — транскрипт чата, вы покупаете инструмент для повышения производительности, а не для подготовки к аудиту.
Специального стандарта PCAOB для GenAI нет, но AS 1105 и AS 2301 уже применяются
Стандарт PCAOB, написанный специально для генеративного ИИ, отсутствует. Но это не пробел, которым можно воспользоваться. Действующие стандарты доказательства аудита и оценки рисков уже устанавливают планку для работы с применением ИИ (Fieldguide), а значит, расписание, подготовленное с помощью ИИ, оценивается по достаточности и уместности точно так же, как и таблица, которую вручную составил младший сотрудник. Аудитору не нужно новое правило, чтобы её отклонить.
23 февраля 2026 года COSO заполнил пробел в части управления: был опубликован первый официальный документ, расширяющий Интегрированную систему внутреннего контроля на ИИ. В нём варианты использования GenAI распределены по восьми типам возможностей: ввод данных, трансформация, проводка и суждение — в том числе (Journal of Accountancy). Ввод данных и трансформацию защитить легче всего. Суждение — там вопросы становятся длинными.
Что означает «достаточное надлежащее доказательство», когда его создала модель
Это означает, что результат должен прослеживаться до исходного документа, который аудитор может открыть. Извлечение — это процесс, где выполнение условия наиболее надёжно: базовый PDF или счёт-фактура по-прежнему является доказательством, а модель — лишь более быстрый взгляд на него. Если вы выбираете инструменты для этого уровня, наш каталог включает 217 инструментов для извлечения данных из документов и PDF, и заслуживающие внимания покажут вам ссылку на страницу и координаты для каждого извлечённого поля, а не обобщённый ответ.
Себастьян Штёкле, глобальный руководитель по инновациям в аудите и ИИ KPMG International, сформулировал тест прямо: «ИИ приносит реальную ценность только тогда, когда его можно объяснить и контролировать» (KPMG).
Хранение, логирование и воспроизводимость: что фиксировать заранее
Внесите это в контракт, потому что добавлять постфактум после внедрения — дорого. Запросите: идентификатор модели и версии, проставляемый при каждом запуске; использованный промпт или конфигурацию; неизменяемую цепочку происхождения от выходного поля до исходного документа и страницы; экспортируемый лог того, кто проверил и одобрил каждый элемент с временно́й меткой; и окно хранения, соответствующее вашей политике аудиторского хранения, а не умолчаниям поставщика. Спросите, что происходит с вашими логами, когда поставщик обновляет базовую модель в середине года.
И продолжайте следить. Руководство COSO требует непрерывного мониторинга производительности модели с KPI по объёму транзакций, сумме транзакций и проценту переопределений — поскольку контроли в режиме «установил и забыл» не улавливают дрейф (Deloitte). Процент переопределений — тот, что нужно разместить на дашборде. Если проверяющие тихо исправляют модель в 30% случаев, у вас есть готовая находка для внутреннего контроля и бизнес-кейс, который так и не сработал.
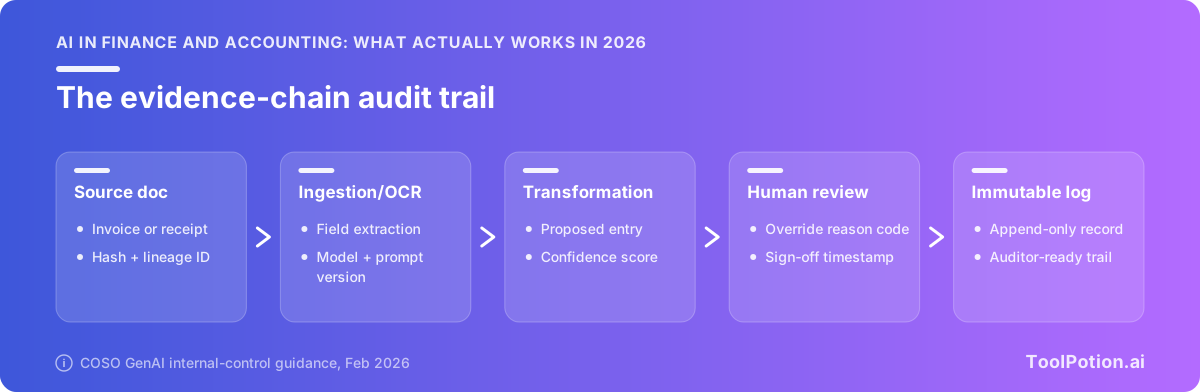
Контрольный список для фильтрации шортлиста поставщиков
Передайте его каждому поставщику перед вторым демо. Большая часть взята напрямую из документа COSO «Обеспечение эффективного внутреннего контроля над генеративным ИИ», опубликованного 23 февраля 2026 года как первое официальное расширение Интегрированной системы внутреннего контроля (2013) на управление ИИ (Journal of Accountancy). Это ближайший аналог письменного стандарта, которым вы располагаете, и поставщики, продающие в финансовом секторе, должны уже его знать.
Восемь типов возможностей GenAI по COSO и какие из них затрагивает ваш кейс
COSO распределяет варианты использования GenAI по восьми типам возможностей: ввод данных, трансформация, проводка, оркестрация, суждение, мониторинг, регуляторная аналитика и взаимодействие человека с ИИ (Journal of Accountancy). Заставьте поставщика письменно указать, какие из них выполняет его продукт.
Ключевая граница — проводка и суждение. Инструмент, который только вводит документы и трансформирует их в черновик, — это другая задача контроля по сравнению с тем, что пишет в книгу учёта или решает, является ли исключение приемлемым. Кодирование расходов обычно затрагивает ввод данных, трансформацию и суждение. Автосертификация при сверке затрагивает проводку. Если ответ поставщика — «все восемь», они тоже не читали документ.
От разовой проверки к непрерывному мониторингу
Старый обход в стиле SOC не покрывает модель, которая дрейфует между кварталами. Руководство COSO требует непрерывного мониторинга производительности модели вместо статической, разовой проверки, с приоритетными KPI по объёму транзакций, сумме транзакций и проценту переопределений для выявления дрейфа. Контроли в режиме «установил и забыл» явно признаются недостаточными (Deloitte Heads Up).
KPI по проценту переопределений и дрейфу, которые нужно закрепить в контракте
- Процент переопределений по пользователю и типу транзакции, экспортируемый ежемесячно — а не только видимый в дашборде.
- История версий модели с датами, чтобы можно было связать изменение уровня ошибок с конкретным релизом, а не гадать.
- Точность, измеренная по вашим данным в период параллельной работы, который вы определяете сами, с зафиксированным знаменателем.
- Конкретный порог, при достижении которого запускается проверка. Выберите цифру сейчас (например, процент переопределений выше 8% в любом месяце) и внесите её в контракт.
Готовность к верификации — переменная, предсказывающая результаты
KPMG выяснил, что только 42% организаций полностью готовы к верификации, и разрыв в результатах неочевиден: такие компании сообщают об улучшении снижения ошибок на 33% против 6% у неготовых коллег, а уверенность в масштабировании ИИ — 42% против 14% (KPMG).
ИИ приносит реальную ценность только тогда, когда его можно объяснить и контролировать. Готовность к верификации отличает устойчивые результаты от скрытых рисков. — Себастьян Штёкле, глобальный руководитель по инновациям в аудите и ИИ, KPMG International
Применяйте чек-лист до составления шортлиста, а не после. В нашей категории финансов и банкинга 309 листингов, и чек-лист сужает их до нескольких быстрее, чем любое сравнение функций.
Читайте каждое заявление о точности через его же сноску
Каждая цифра производительности в демо финансового ИИ — это измерение, а измерение без указания генеральной совокупности, определения «правильного ответа» и даты — это маркетинговый актив. Сноски, как правило, опубликованы. Их почти никто не читает.
Три вопроса, которые сдуют большинство цифр
Задавайте их по порядку, письменно, перед вторым демо.
- Какие транзакции учитывались? Не общий объём, а подмножество, по которому была вычислена цифра.
- Что делало ответ правильным? Кто-то определил эталон истины. Получите это определение дословно.
- Когда и на чьих данных это измерялось? Один внутренний анализ годовой давности — не уровень сервиса.
Знаменатели, даты и самоотобранные сравнения
Ramp публикует примерно 85-процентное сокращение ручных проверок расходов при точности 99%+, а в собственной документации определяет эту точность как одобрения, рекомендованные агентом, которые также одобрили проверяющие-люди, — по внутреннему анализу от 01.07.25 (Ramp Support). Это мера согласованности по пути одобрения. Она ничего не говорит о расходах, которые агент ошибочно отметил и которые проверяющий вынужден был отменить, — а это именно тот тип ошибок, который волнует вашего контроллера.
Заявления о сверке проваливаются иначе. Показатель автосертификации формулируется как потолок — «до 98%», — тогда как реальные результаты у клиентов находятся в диапазоне от 43% до 85% (Numeric). Потолок — это факт о лучшем счёте в лучший месяц у лучшего клиента.
Как выглядит достоверное раскрытие
Оно называет размер выборки, правило подсчёта и дату — так, как это делает Ramp, — и сообщает уровень ложных одобрений наряду с показателем точности. Запросите цифру, вычисленную по вашим данным за последний квартал в ходе пилота. Поставщик, который отказывается провести этот тест, уже дал вам ответ о том, что было бы написано в его сноске.
Почему демо рассыпается при закрытии месяца, и дизайн пилота, который это предотвращает
Демо работает на отобранной выгрузке. Чистая суб-книга прошлого квартала, дюжина правильно оформленных счетов-фактур, никаких внутрифирменных, никаких ручных проводок, занесённых налоговым отделом в 23:00 третьего дня. Закрытие — это противоположная совокупность, и каждый режим отказа, который инженер по продажам отсеял бы для звонка, появляется разом, в дедлайн, перед вашим контроллером.
Построение поиска влияет на точность сильнее, чем выбор модели
Замените одну frontier-модель другой на том же наборе финансовых вопросов — ответы изменятся незначительно. Измените разбивку документов на чанки, определите, чей файл за какой период подтягивается, и путешествуют ли сноски вместе с таблицей — ответы изменятся сильно. Большинство неверных ответов в финансовых Q&A — это сбои поиска в гладко написанном предложении: инструмент нашёл расписание за FY24, когда вы спрашивали о FY25, а текст читается безупречно в обоих случаях.
Руководство COSO от февраля 2026 года рассматривает ввод данных и трансформацию как отдельные типы возможностей с собственными требованиями к контролю (Journal of Accountancy). Тестируйте пайплайн на ваших собственных «грязных» исходных файлах. Набор данных поставщика практически ничего не говорит вам о реальных условиях.
Опытные проверяющие обеспечивают большую часть выигрыша
Дайте инструмент сначала вашим двум сильнейшим старшим специалистам, прежде чем разворачивать его для всего персонала. Полевые исследования, количественно оценивающие экономию времени ИИ для дипломированных бухгалтеров, указывают в том же направлении: часы достаются тем, кто уже знает, как выглядит правильный ответ, и замечает неверный за секунды (Journal of Accountancy).
Пропустите уровень проверки — и получите результат Deloitte: возврат более $60 000 австралийскому правительству за отчёт, содержавший ошибки, сгенерированные ИИ (CFO Dive).
Стоимость, неясная ценность и слабый контроль рисков губят агентные проекты
Возможности модели редко являются тем, что стопорит эти программы. Опрос Deloitte Finance Trends среди 1 326 финансовых руководителей показал: 63% полностью внедрили ИИ в финансы, но лишь 21% видят ощутимую ценность, и 14% полностью интегрировали агентов (CFO Dive). Thomson Reuters оценивает внедрение агентного ИИ в 15% против 53%, которые планируют или рассматривают его (Thomson Reuters). В опросе Deloitte Q2 2026 CFO Signals 59% финансовых директоров назвали главным вызовом балансирование давления на внедрение с рисками, а 51% заявили об отсутствии у них полномочий в области управления (Deloitte).
90-дневный пилот с числами, зафиксированными до старта
- Выберите один процесс и одну организацию. Сверка для одной дочерней компании лучше, чем общефинансовый запуск, который невозможно измерить.
- Установите базовые показатели за два закрытия до того, как инструмент вообще что-то коснётся: затраченные часы, количество исключений, уровень доработки, дни до сертификации.
- Согласуйте порог приёмки письменно с вашим контроллером и партнёром по внешнему аудиту — и поставьте дату.
- Отслеживайте процент переопределений еженедельно вместе с объёмом транзакций и суммой транзакций — это сигнал дрейфа, на котором строится требование COSO к непрерывному мониторингу (Deloitte Heads Up).
- Запишите критерий остановки в первый день. Например: если автосертификация остаётся ниже 55% на 90-й день или процент переопределений проверяющими превышает 15% три недели подряд — останавливаемся и пересматриваем условия.
Затем опубликуйте результат внутри компании — с цифрами, — так же, как команды документируют реальные внедрения в нашем каталоге. Только 18% организаций как-либо отслеживают ROI от ИИ (Thomson Reuters), поэтому один письменный базовый показатель ставит вас впереди четырёх из пяти покупателей в момент продления.
Часто задаваемые вопросы
Достаточно ли надёжен ИИ для ведения бухгалтерии без проверяющего-человека в 2026 году?
Нет, и контрольные фреймворки теперь исходят из того, что проверяющий у вас будет. KPMG фиксирует активное использование ИИ в финансовой функции на уровне 75% в 2026 году против 30% в 2024-м, но только 42% организаций полностью готовы к верификации, и у тех, кто готов, улучшение снижения ошибок составляет 33% против 6% у остальных (KPMG, 11 мая 2026). Руководство COSO от февраля 2026 года явно признаёт контроли в режиме «установил и забыл» недостаточными и требует непрерывного мониторинга производительности модели (Deloitte Heads Up). Непроверенный вывод уже имеет ценник: Deloitte вернул более $60 000 австралийскому правительству за отчёт, содержавший ошибки ИИ (CFO Dive).
Какой процент автоматического сопоставления ожидать от программ для сверки с ИИ?
Рассчитывайте на 60–80% автосертификации, а не на цифру со слайда. Поставщики систем сверки заявляют «до 98%» автосертификации при 99% точности сопоставления, тогда как наблюдаемые результаты у клиентов находятся в диапазоне от 43% до 85% (Numeric). Внесите показатель в критерии приёмки и измерьте его по своей исторической книге учёта в ходе пилота — не по демо-данным, — а затем перемерьте после трёх закрытий, поскольку качество сопоставления дрейфует вместе с изменением структуры транзакций (Deloitte Heads Up по COSO).
Что требует руководство COSO от февраля 2026 года для ИИ, применяемого в финансовой отчётности?
23 февраля 2026 года COSO опубликовал «Обеспечение эффективного внутреннего контроля над генеративным ИИ» — первое официальное расширение Интегрированной системы внутреннего контроля 2013 года на управление ИИ. Документ распределяет варианты использования GenAI по восьми типам возможностей: ввод данных, трансформация, проводка, оркестрация, суждение, мониторинг, регуляторная аналитика и взаимодействие человека с ИИ (Journal of Accountancy). Операционное требование — переход от разовой верификации к непрерывному мониторингу с KPI по объёму транзакций, сумме транзакций и проценту переопределений для выявления дрейфа модели (Deloitte Heads Up). Классифицируйте каждый используемый инструмент по типу возможностей, установите порог для каждого KPI и ведите лог переопределений с первого дня — инструмент для проводки или суждения несёт несравнимо более серьёзные требования к контролю, чем инструмент для ввода данных.
Примет ли мой аудитор рабочие документы, подготовленные с помощью генеративного ИИ?
Да, если вы можете показать, как был получен результат и кто его проверил. PCAOB не выпустил стандарт для генеративного ИИ, и его действующие стандарты в части аудиторских доказательств и оценки рисков уже устанавливают планку по достаточности, уместности и проверяемости (Fieldguide). Сохраняйте промпт, исходные документы, которые инструмент извлёк, модель и версию, дату, а также подписи составителя и проверяющего, чтобы рабочий документ стоял на собственных ногах без повторного запуска модели. Ожидайте, что вопросы будут становиться острее: PwC призвала PCAOB сделать ИИ в аудите главным приоритетом (Big4 News).
Как рассчитать ROI от AI-инструмента для финансов, если только 18% организаций его отслеживают?
Зафиксируйте базовые показатели до начала пилота, потому что восстановить их потом невозможно. Только 18% специалистов знали, что их организация как-либо отслеживает ROI от ИИ в 2026 году — примерно столько же, что и в 2025-м, — и большинство из тех, кто отслеживает, измеряют внутренние операционные метрики, а не бизнес-результаты (Thomson Reuters, 9 февраля 2026). Разрыв, который это создаёт, виден в опросе Deloitte Finance Trends среди 1 326 финансовых руководителей: 63% полностью внедрили ИИ в финансы, и 21% считает, что он принёс ощутимую ценность (CFO Dive). Отслеживайте четыре показателя в фиксированном окне: часы на закрытие, уровень исключений, время цикла на транзакцию и полная стоимость с учётом времени на проверку, которое создаёт инструмент. Вывод KPMG о том, что 71% финансовых руководителей считают ИИ соответствующим или превосходящим ожидания по ROI, измеряет ожидания — не подменяйте его собственными цифрами (KPMG).
Какой финансовый процесс автоматизировать первым?
Категоризацию расходов и проверку политики — главным образом потому, что это единственный процесс, где поставщик публикует значение своего показателя точности: Ramp сообщает примерно о 85% сокращении ручных проверок при точности 99%+, определяя её как одобрения, рекомендованные агентом, которые также одобрили проверяющие-люди, — по внутреннему анализу от 01.07.25 (Ramp). Сверка идёт второй, поскольку достижимый процент сопоставления значительно ниже заявленного и требует платного пилота на ваших данных (Numeric). Прогнозирование — позже: 44% финансовых директоров компаний с выручкой от $1 млрд уже используют ИИ для планирования и бюджетирования (Deloitte Q2 2026 CFO Signals), но прирост точности сильно варьируется по отраслям: от 71% в банкинге до 44% в здравоохранении (KPMG). Сузьте поле до демо — наш каталог уже содержит 550 AI-агентов, и очень немногие из них созданы для контролируемого закрытия.