

Ваш мультимодальный пайплайн сломается не из-за галлюцинаций модели. Он сломается потому, что ссылка для скачивания из Sora истекла через 61 минуту после окончания рендера, или потому что ваш 90-минутный подкаст упёрся в ограничение OpenAI в 25 МБ для транскрипции, тогда как AssemblyAI принял бы весь 5-гигабайтный файл одним запросом.
Каждый переход между моделями — это контракт: точный формат файла, тарифный план, который его открывает, окно истечения и резервный вариант на случай, если вендор отключит модель. Большинство руководств пропускают все четыре пункта.
Здесь вы найдёте эти контракты, три готовых пайплайна и план замены, который нужен вам до того, как OpenAI отключит Videos API и обе модели Sora 2 24 сентября 2026 года — без указания замены. До этого момента остаётся 19 дней.
Почему мультимодальные пайплайны ломаются на стыках, а не в моделях
Каждая модель в цепочке работает. Транскрипция точная, изображение выглядит правильно, голос звучит естественно, видео рендерится. Ломается момент, когда вывод одной модели должен стать вводом следующей, а никто не записал, как именно должен выглядеть этот вывод.
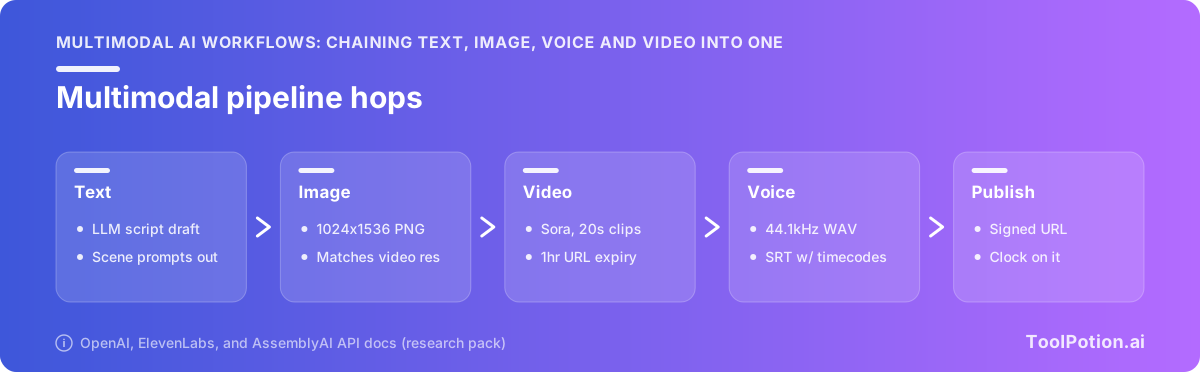
Конкретный пример: ссылки для скачивания сгенерированных активов Sora действительны не более одного часа после генерации, а вывод приходит в виде MP4 плюс WebP-миниатюра и JPG-спрайтшит (OpenAI). Если ваш пайплайн поставил рендер в очередь и добрался до шага копирования через 90 минут — рендер исчез. Модель выполнила свою работу идеально.
Контракт передачи: формат, тариф, истечение, резерв
Относитесь к каждому переходу как к контракту из четырёх пунктов, которые вы записываете до начала разработки.
Формат — это точная спецификация файла, которую требует следующий этап: частота дискретизации и размер в пикселях, а не соотношение сторон «на удачу». Тариф — уровень плана или конкретный параметр API, открывающий этот формат, потому что многие нужные форматы заблокированы за платной подпиской или именем устаревшей модели. Истечение — как долго артефакт доступен на стороне вендора, прежде чем вы несёте убытки. Резерв — что вы подставляете, когда вендор снимает модель с поддержки, что сейчас уже не гипотетический сценарий.
Запишите эти четыре строки для каждого перехода — и большая часть отладки исчезнет ещё до начала работы.
Четыре сбоя, которые убивают пайплайн на середине работы
- Предыдущий этап выдаёт формат, который следующий этап молча понижает в качестве или полностью отвергает.
- Функция, которую вы считали частью API, оказывается доступной только на более высоком тарифном плане или в старой версии модели.
- Артефакт истекает в хранилище вендора, пока ваша задача всё ещё стоит в очереди.
- У модели, на которой вы строили, появляется дата отключения, а вендор не указывает рекомендованную замену.
Три пайплайна ниже — это примеры одного и того же контракта: подкаст в шоу-ноутс, сценарий в озвученное видео и фото продукта в рекламный набор. Каждый называет формат, тариф, истечение и резерв для каждого перехода.
Это написано для того, кто сдаёт результат, а не сравнивает архитектуры fusion. Отдельные инструменты вы можете выбрать среди 18 982 активных AI-инструментов в нашем каталоге. Их связывание воедино — вот что никто не документирует.
Пайплайн 1: из статьи в озвученное видео
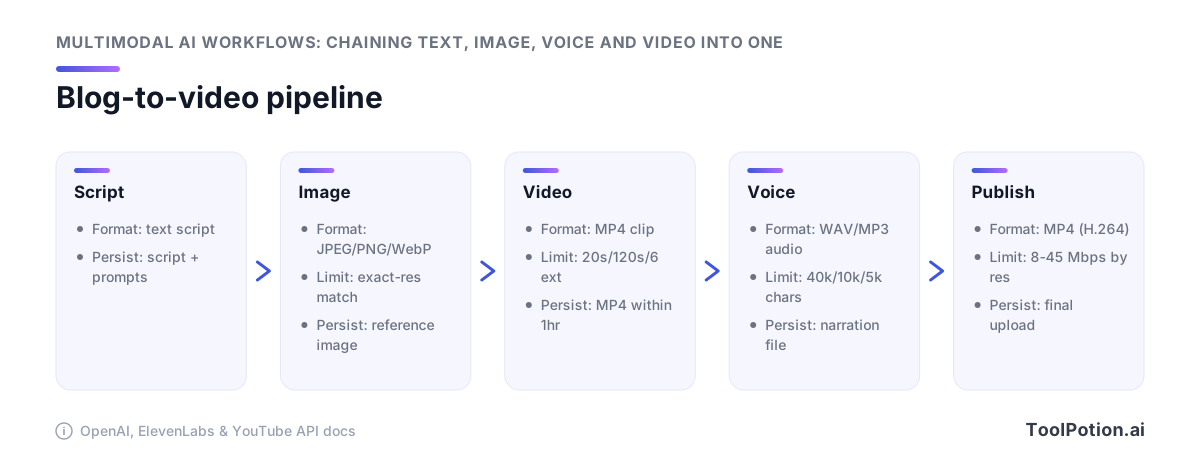
Берёте статью в 1200 слов — на выходе хотите двухминутное озвученное видео. Четыре перехода: разбить текст, сгенерировать стоп-кадры, анимировать их, наложить голос. Каждый из этих переходов имеет спецификацию, которую должен удовлетворить предыдущий, и большинство этих спецификаций вы задаёте до первого вызова API.
Сегментация сценария до любого вызова генерации
Сегментация — это не шаг форматирования в конце. Это параметр, который наследует всё последующее, потому что выбранная голосовая модель ограничивает размер одного запроса. Eleven Flash v2.5 принимает 40 000 символов, Multilingual v2 — 10 000, а v3 останавливается на 5 000 (ElevenLabs). Выберите v3 для выразительной начитки — и ваш сценарий в 1200 слов уложится в один вызов. Выберите его для разъяснительного текста на 9 000 слов — придётся делить на два фрагмента, и шов нужно будет скрыть.
Сегментируйте по границам сцен, а не по количеству предложений. К каждому сегменту нужно прикрепить одну визуальную идею, целевую продолжительность в секундах и целевое разрешение в пикселях в виде метаданных. Это последнее поле читает этап генерации изображений.
Этап изображения: точное соответствие пикселям видео-этапа
Путь Sora «изображение → видео» требует, чтобы опорное изображение точно совпадало с целевым разрешением видео, в формате image/jpeg, image/png или image/webp (OpenAI). Точно — это пиксели, а не «16:9». Генератор изображений, получив задание на широкоэкранный стоп-кадр, с удовольствием вернёт 1792×1024, тогда как видео-вызов ждёт 1280×720 — и задача упадёт при отправке, а не во время рендера. Поэтому шаблон промпта для изображения содержит ширину и высоту как целые числа, взятые из конфига видео-этапа, а вы проверяете размеры и MIME-тип возвращённого файла до постановки чего-либо в очередь. Среди 324 AI-моделей в нашем каталоге стоит подключать именно те, что позволяют задавать произвольные размеры в пикселях, а не именованные пресеты.
Видео-этап: клипы по 16 и 20 секунд в цепочке
Модели sora-2 и sora-2-pro генерируют клипы по 16 или 20 секунд. Каждое продление добавляет до 20 секунд, максимум шесть продлений и 120 секунд в сумме (OpenAI). Ваш двухминутный сегмент — это шесть последовательных вызовов.
Непрерывность между этими шестью — ваша ответственность. Модель не помнит нарративную дугу между третьим и четвёртым продлением, поэтому каждый вызов должен повторно описывать место действия, объект и поведение камеры. Закладывайте бюджет на повторные попытки на стыках.
Голосовой этап и мультиплексирование
Генерируйте озвучку по сегменту, а не по видео целиком — тогда неудачный дубль обходится одним вызовом. Затем выравниваете: аудио для сегмента 4 должно вписываться в 20-секундный клип, отрендеренный для сегмента 4, что обычно означает сокращение текста, а не растяжку аудио по времени. Мультиплексируйте с ffmpeg по одному сегменту, затем склейте.
Пайплайн 2: из эпизода подкаста в клипы и шоу-ноутс
На входе — один WAV-файл продолжительностью 58 минут. На выходе — транскрипт, главы с тайм-кодами, шесть вертикальных клипов с вшитыми субтитрами и страница шоу-ноутс. Аудио не меняет формат после первого этапа — именно это делает этот пайплайн проще видео-пайплайна. Успех определяется выбором вендора для транскрипции и тремя параметрами запроса.
Ограничение в 25 МБ и как его обойти
Endpoint транскрипции OpenAI ограничивает загрузку 25 МБ и принимает mp3, mp4, mpeg, mpga, m4a, wav и webm (OpenAI). WAV-файл 48 кГц продолжительностью 58 минут весит около 300 МБ. Значит, нужно либо перекодировать в MP3 с низким битрейтом и надеяться на лучшее, либо разбить файл — а разбиение аудио по произвольным байтовым границам режет слова пополам и смещает все тайм-коды после разреза.
AssemblyAI принимает до 5 ГБ на запрос через /v2/transcript (2,2 ГБ при загрузке локальных файлов через /v2/upload) и работает с файлами от 160 мс до 10 часов (AssemblyAI). Это примерно в 200 раз больший потолок. Для длинного аудио — отправляйте целый эпизод туда, а LLM-вендора оставляйте для этапов рассуждения далее по цепочке.
Тайм-коды на уровне слов — примитив для нарезки клипов
Автоматически нарезать клипы из транскрипта с только границами абзацев невозможно. Нужно знать, что слово «anyway» начинается в 00:41:12.340, чтобы разрез лёг до него, а не сквозь него.
На стороне OpenAI есть два нюанса. Вывод SRT и VTT, а также параметр timestamp_granularities[] работают только с whisper-1, но не с gpt-transcribe или gpt-4o-transcribe (OpenAI). Если ваш пайплайн вшивает субтитры или режет по тайм-коду — вы намеренно оставляете более старую модель в цепочке, и это не технический долг. ElevenLabs Scribe v2 даёт тайм-коды на уровне слов, диаризацию и распознавание именованных сущностей на 90+ языках в одном ответе (ElevenLabs) — более чистый выбор, если вы уже платите им за TTS-этап.
Диаризация работает только если её запросить
Метки спикеров требуют установки chunking_strategy в auto для аудио длиннее 30 секунд, а gpt-4o-transcribe-diarize выполняет только идентификацию спикера (OpenAI). Пропустите параметр — и запрос выполнится успешно. В ответе вы получите чистый, беглый, абсолютно неразмеченный текстовый массив, и ничто в ответе не укажет, что интервью двух ведущих только что свернулось в один голос. Проверяйте поля спикеров на шаге валидации, а не вручную.
Из транскрипта в шоу-ноутс, главы и контент для соцсетей
Один транскрипт с тайм-кодами слов разворачивается в четыре артефакта без дополнительной обработки аудио: маркеры глав по тематическим сдвигам, краткое резюме с перечнем ссылок для страницы шоу-ноутс, ранжированные кандидаты на клип по плотности цитат, и сами вертикальные нарезки, отрендеренные по этим точкам входа и выхода. Кормите тем же транскриптом каждый из них параллельно, с разными промптами. Если вам нужны ориентиры по форматам до начала разработки — в нашем каталоге 201 AI-подкаст, публикующий примерно на таком же стеке.
Пайплайн 3: из фотографий продукта в рекламные варианты
Одна студийная фотография кроссовка превращается в двенадцать фирменных стоп-кадров, а затем в четыре 8-секундных рекламных ролика для платного продвижения. Переходы: изображение на вход, изображение на выход, видео на выход — а интересная инженерия сосредоточена между вторым и третьим переходами, где визуальная модель смотрит на результат генератора изображений и решает, годится ли он к публикации.
Проверка визуальной моделью как шлюз контроля качества
Сгенерированные фото продукта имеют предсказуемые дефекты. Неправильное размещение логотипа, шесть блочных отверстий вместо пяти, тень, противоречащая ключевому свету. Вы не хотите, чтобы человек проверял 120 вариантов вручную — поэтому отправляете их в визуальную модель вместе с исходным снимком и письменной брендбук-спецификацией, и просите вынести вердикт «прошёл/не прошёл» с причиной.
Claude принимает до 100 изображений на запрос на моделях с контекстом 200k и до 600 на других моделях, с ограничением 20 на сообщение в claude.ai, максимум 8000×8000 пкс и 10 МБ на изображение (Claude Docs). Не эти числа будут проблемой.
Проблемой будет стандартное ограничение размера запроса в 32 МБ. Двенадцать 4K PNG превышают его задолго до приближения к 100 изображениям — именно поэтому Anthropic рекомендует загружать через Files API и ссылаться на каждое изображение по file_id, а не вставлять base64 (Claude Docs). Стройте шаг проверки именно так с самого начала. Переделка после роста размеров партий означает одновременное переписывание и построителя запросов, и логики повторных попыток.
Выборка кадров — прямой рычаг управления затратами
Claude тарифицирует изображения как визуальные токены размером 28×28 пикселей, вычисляемые как ⌈ширина/28⌉ × ⌈высота/28⌉. Кадр 3840×2160 стоит 4784 визуальных токена на уровне высокого разрешения и 1560 после уменьшения на стандартном уровне — примерно $23,92 за тысячу 4K-кадров при входной ставке Claude Opus 5 в $5/М (Claude Docs). Уменьшайте масштаб перед отправкой, если только проверка качества не зависит от мелких деталей — строчки или швов.
Та же математика применима к этапу анализа видео. Проверка четырёх 8-секундных роликов при 24 fps — это 768 кадров при наивном подходе. Выборка 2 fps даёт 64 кадра, и счёт за проверку падает в двенадцать раз без потери ни одной смены сцены.
Пакетная обработка изображений без превышения потолка запроса
Делите на группы по байтам полезной нагрузки, а не по количеству изображений. Сортируйте варианты в группы, которые остаются ниже примерно 25 МБ ссылок, держите исходную фотографию в каждой партии как эталон для сравнения, а неудачные — повторно отправляйте по одному в полном разрешении, чтобы строка с причиной была содержательной. В нашем каталоге среди AI-инструментов для изображений и фото числятся 727 генераторов изображений и 342 редактора фото — и почти ни один не раскрывает механику пакетной обработки, которая нужна здесь. Эта часть остаётся в вашем коде.
Спецификация передачи: что требовать на каждом этапе
Записывайте контракт до того, как пишете код. У каждого перехода в цепочке есть три вещи, которые нужно зафиксировать: точный выходной формат, тарифный план или параметр, который его открывает, и время жизни артефакта до его исчезновения. Ошибитесь в них — и сбой появится два этапа спустя в виде жалобы на качество, которую никто не сможет отследить.
Аудио: тариф, открывающий вывод студийного качества
ElevenLabs ставит pcm_44100, pcm_48000, wav_44100 и wav_48000 за подписку Pro, а mp3_44100_192 — за Creator (ElevenLabs API reference). Значит, на бесплатном или начальном плане ваш видеоредактор получит потерянный MP3 при 128 кбит/с или ниже — независимо от качества голосовой модели. Это потолок качества, заданный биллингом, а не инференсом.
Если ваш продукт — подкаст, которому нужно попасть в -16 LKFS с истинным пиком не выше -1 дБ FS (Apple Podcasts), вам нужен несжатый звук на входе и одно кодирование в конце. Нормализация 128-кбит/с MP3 с последующим перекодированием — это два поколения потерь. Закладывайте тариф Pro в производственные затраты, а не в статью «апгрейд».
Видео: истекающие URL и сопутствующие активы
Sora не отдаёт один файл. Завершённый рендер даёт MP4, WebP-миниатюру и JPG-спрайтшит — и ссылки на скачивание действительны не более одного часа (OpenAI video guide). Ваша задача на этом этапе — копирование в собственное объектное хранилище, запускаемое событием завершения, а не ночным пакетным заданием. Пропустите окно — рендер не восстановить.
Текст и тайминг: поля, которые требуют последующие шаги
Последующие шаги жёстко требуют конкретных полей, и те, что связаны с таймингом, ломаются незаметно. Вывод SRT и VTT, а также timestamp_granularities[] работают только с whisper-1, но не с новыми моделями транскрипции (OpenAI speech to text). Всему, что нарезает клипы или вшивает субтитры, нужны тайм-коды на уровне слов в контракте.
| Переход | Что требовать на выходе | Что это открывает | Истечение |
|---|---|---|---|
| Текст в речь | wav_48000 или pcm_44100 | Тариф Pro; Creator для mp3_44100_192 | Не истекает, сохранять при записи |
| Речь в текст | Тайм-коды на уровне слов, метки спикеров | whisper-1 для SRT/VTT; chunking_strategy: auto при диаризации дольше 30 с | Не истекает |
| Изображение в видео | MP4 плюс миниатюра и спрайтшит | Опорное изображение точно соответствует разрешению видео | 1 час на ссылках для скачивания |
| Видео в текст | Выборочные кадры с фиксированной частотой | Стандартный vs. высококачественный уровень меняет стоимость визуальных токенов ~в 3 раза | Не истекает |
Какой бы оркестратор вы ни выбрали из 128 AI-фреймворков в нашем каталоге, сначала тестируйте его на двоичных переходах. Передача JSON между моделями — лёгкая часть.
Платформа автоматизации или ручная склейка
Правило простое: доверьте платформе решать, что и когда происходит, а перемещение байтов оставьте собственному коду. Всё, что работает с большим файлом или гонится с истечением, должно быть в скрипте с объектным хранилищем за ним.
Где платформа выигрывает
Триггеры, повторные попытки на дешёвых шагах, шлюзы согласования и разветвление в конце. Zapier предлагает 9000+ интеграций приложений, встроенных в Zaps, Tables, Forms и Zapier MCP — и именно этот каталог и является настоящей причиной его использовать. Доставить готовые шоу-ноутс в CMS и ссылки на клипы в контент-календарь — это работа с коннекторами, и писать их самостоятельно ничего не даёт.
Здесь же место для участия человека в процессе. Zap, который публикует четыре рекламных варианта в Slack, ждёт одобрения, а затем запускает шаг публикации — это двадцать минут настройки и единственное, что стоит между выдуманным заявлением о продукте и вашим бюджетом на платное продвижение.
Где двоичные медиаданные побеждают платформу
Узлы без кода хорошо передают JSON и плохо — файлы. WAV-файл на 58 минут нужно разбить на куски по 25 МБ или меньше, прежде чем endpoint транскрипции OpenAI его примет (OpenAI). Двухминутный рендер Sora — это до шести последовательных вызовов по 20 секунд (OpenAI), и ссылка на скачивание действительна не более одного часа после генерации (OpenAI). Логика повторных попыток для шести вызовов с обратным отсчётом на артефакте — это программа, а не холст.
Две платформы всё-таки работают с медиа. n8n хранит файлы как двоичные данные между узлами, не вынуждая делать round-trip через base64, и его узел кода стоит прямо рядом с агентными узлами (n8n). Descript открывает транскрипцию, клипы и субтитры через API, а не через GUI (Descript).
Средний путь: платформа для управления потоком, код для байтов
Каждый переход пишет в ваш собственный бакет и возвращает ключ. Платформа передаёт ключи и коды статусов, но никогда сам файл. Такая постановка работы ещё и сокращает вычислительные затраты: система OnePiece сообщает о снижении потребления GPU в 16 раз для Wan2.1 «изображение → видео» после декомпозиции монолитного пайплайна в поэтапные сервисы (arXiv).
Если вы подбираете компоненты, наш каталог отслеживает 550 AI-агентов и инструментов оркестрации наряду с 301 репозиторием AI с открытым кодом. Именно в репозиториях обычно живёт «клей» для перемещения байтов — ни один вендор эту часть не продаёт.
Спецификации доставки: соответствие платформе публикации
Ваш последний этап — не рендер. Это загрузка, и у загрузки тоже есть спецификация.
Видео: целевые битрейт и аудио для загрузки
YouTube публикует рекомендуемые битрейты по разрешению: 8 Мбит/с для 1080p SDR, 16 Мбит/с при 1440p и 35–45 Мбит/с при 4K, аудио доставляется как AAC-LC, Opus или Eclipsa при 48 кГц и 384 кбит/с стерео (YouTube Help). Если ваш видео-этап отдаёт файл значительно ниже этих значений — не повышайте битрейт при экспорте. Вы только потратите время на кодирование артефактов сжатия. Правильное решение — сделать так, чтобы шаг кодирования читал исходное разрешение и выбирал соответствующий целевой профиль, и тогда рендер Sora в 1080p не будет принудительно обрабатываться по 4K-лесенке из-за жёстко заданного значения в конфиге полугодовой давности.
Для озвученного контента аудио-цель важнее видео. AAC-трек 48 кГц / 384 кбит/с из источника 44,1 кГц означает передискретизацию где-то по пути — и вы хотите, чтобы она происходила один раз, в вашем собственном вызове ffmpeg, где вы её видите.
Аудио: предварительная обработка громкости перед кодированием
Apple Podcasts требует -16 дБ LKFS ±1 дБ с истинным пиком не выше -1 дБ FS, измеренным по ITU-R BS.1770-5, и явно указывает, что аудио должно быть предварительно приведено к этому уровню до кодирования (Apple Podcasts for Creators). Порядок операций, а не рекомендация. Нормализация готового MP3 означает проталкивание усиления через потерянные артефакты, запечённые при другом уровне, и истинный пик декодированного MP3 уже может превышать то, что видел кодировщик. Сначала проводите обработку громкости на WAV, затем кодируйте.
Вот почему тарифный уровень TTS-формата из начала цепочки продолжает иметь значение. Передать нормализатору 128-кбит/с MP3 — худший старт по сравнению с PCM, и никакая последующая забота этого не исправит.
Провенанс и маркировка сгенерированных активов
Решайте вопрос провенанса при проектировании пайплайна, а не когда платформа об этом спросит. SynthID от Google встраивает водяные знаки в генерируемые медиа при создании — а значит, они будут с активом только если ваш пайплайн их не сотрёт и не перекодирует. Каждый проход ffmpeg между генерацией и загрузкой — это шанс потерять этот сигнал, поэтому отслеживайте, на каком этапе был создан файл, и храните запись о модели, промпте и временной метке в собственном хранилище метаданных, а не рассчитывайте, что контейнер это сохранит.
Готовьтесь к замене: скала устаревания под каждым видео-этапом
Если ваш видео-этап вызывает Sora — у вас 19 дней. OpenAI объявил 24 марта 2026 года, что Videos API и обе модели sora-2 и sora-2-pro (снимки sora-2-2025-10-06, sora-2-2025-12-08 и sora-2-pro-2025-10-06) отключаются 24 сентября 2026 года без указания рекомендованной замены (OpenAI deprecations). Пустая колонка замены означает, что преемника выбираете вы сами — и выбираете до дедлайна, а не после.
Абстрагирование этапа, чтобы замена стала изменением конфига
Решение — тонкий адаптер на каждый генеративный переход. Ваш пайплайн передаёт адаптеру нормализованное задание: промпт, путь к опорному изображению, целевое разрешение, продолжительность в секундах, ключ в выходном бакете. Адаптер владеет всем специфичным для вендора. Требование Sora о точном совпадении опорного изображения с разрешением видео, клипы по 16 и 20 секунд с продлением шагами по 20 секунд до потолка в 120 секунд, 1-часовое истечение ссылок на скачивание (OpenAI video generation). Ничто из этого не попадает в ваш оркестрационный код.
Тогда смена провайдера — это значение в конфиге, а не переписывание. Проверьте второй адаптер по документации моделей Runway сейчас, прогоните оба на одних и тех же десяти промптах и держите запасной в тепле.
У семейств изображений и аудио тоже есть собственные даты устаревания, поэтому относитесь к этому как к регулярному обслуживанию, а не к разовой панике. Наш каталог существует отчасти для того, чтобы вы могли отслеживать выходы и закаты моделей среди 324 перечисленных.
Чек-лист миграции для работающих сегодня пайплайнов
- Выполните grep по всем репозиториям и JSON-файлам воркфлоу на наличие
sora-2,sora-2-proи базового пути Videos API. Включая cron-задачи и разовые скрипты — именно там живут забытые вызовы. - Оберните каждое попадание в адаптер с вашей собственной схемой задания до смены провайдера, чтобы замена и рефакторинг не были одним коммитом.
- Прогоните альтернативного провайдера на десяти реальных промптах и сравните результаты по разрешению, длине клипа и качеству движения.
- Поставьте напоминание в календарь за две недели до каждой опубликованной даты устаревания — по вендору и по семейству моделей.
- Логируйте ID модели и снимок для каждого рендера, чтобы потом можно было ответить на вопрос «что сгенерировало этот актив» после отключения модели.
Часто задаваемые вопросы
Что такое мультимодальный AI-воркфлоу на практике?
Это цепочка вызовов API, где выходной файл одной модели становится входным файлом следующей, и у каждого перехода есть контракт формата, который нужно соблюсти. Типичная цепочка: транскрипт → сценарий → стоп-кадр → видео → озвучка → финальный рендер, и каждая стрелка — место, где неверное разрешение или кодек ломает весь прогон. Путь Sora «изображение → видео» — хороший пример буквальности этих контрактов: опорное изображение должно точно совпадать с целевым разрешением видео и быть в формате image/jpeg, image/png или image/webp, поэтому шаг генерации изображения выше по цепочке нуждается в размерах видео-шага в пикселях, а не просто в соотношении сторон (OpenAI video generation docs). Думайте о пайплайне как о наборе передач, а не о наборе инструментов.
Как объединять AI-инструменты в цепочку без потери качества между шагами?
Зафиксируйте спецификацию выхода на каждом этапе исходя из того, что нужно последнему шагу цепочки, затем работайте в обратном направлении. Потеря качества обычно происходит из-за тарифного плана или параметра по умолчанию, а не из-за модели: ElevenLabs ставит pcm_44100, pcm_48000, wav_44100 и wav_48000 за подписку Pro, а mp3_44100_192 — за тариф Creator, поэтому на начальном тарифе ваш редактор получит потерянный MP3 — хотите вы того или нет (ElevenLabs create speech reference). Немедленно копируйте каждый сгенерированный артефакт в собственное объектное хранилище, потому что ссылки Sora на скачивание действительны не более одного часа после генерации (OpenAI video generation docs). Частота дискретизации — это также рычаг стоимости, а не только качества: Claude оценивает 4K-кадр в 4784 визуальных токена на уровне высокого разрешения против 1560 на стандартном — примерно $23,92 за тысячу 4K-кадров при входной ставке Opus 5 в $5/М (Claude vision docs).
В каком аудио-формате передавать результат этапа «текст в речь» в видеоредактор?
В несжатом WAV 48 кГц или PCM — на ElevenLabs это wav_48000 или pcm_48000 и подписка Pro или выше (ElevenLabs create speech reference). Передача редактору MP3 на 128 кбит/с навсегда запекает артефакты сжатия, которые переживут все последующие кодирования. Если пунктом назначения является YouTube, финальная цель доставки — AAC-LC, Opus или Eclipsa при 48 кГц и 384 кбит/с стерео (YouTube upload encoding settings), а если подкаст-лента, Apple требует предварительной обработки до -16 дБ LKFS ±1 дБ с истинным пиком не выше -1 дБ FS по ITU-R BS.1770-5 до кодирования (Apple Podcasts audio requirements). Ни одной из этих целей нельзя надёжно достичь из потерянного промежуточного формата.
Почему транскрипция подкаста падает на полнометражных эпизодах?
Endpoint транскрипции OpenAI ограничивает загрузку 25 МБ и принимает mp3, mp4, mpeg, mpga, m4a, wav и webm — поэтому всё длиннее примерно получаса при нормальном битрейте нужно делить на куски по 25 МБ или меньше (OpenAI speech-to-text docs). Именно поэтому долгосрочные пайплайны обычно уводят транскрипцию от LLM-вендора: AssemblyAI принимает до 5 ГБ на запрос через /v2/transcript (2,2 ГБ для локальных загрузок) и файлы от 160 мс до 10 часов — примерно в 200 раз выше потолка OpenAI (AssemblyAI pre-recorded audio docs). Ещё два режима сбоя выглядят как успех: диаризация молча возвращает неразмеченный текст, если не установить chunking_strategy в 'auto' для аудио длиннее 30 секунд, а вывод SRT/VTT и timestamp_granularities[] работают только с whisper-1, но не с gpt-transcribe или gpt-4o-transcribe (OpenAI speech-to-text docs). Если вам нужны тайм-коды на уровне слов для автоматической нарезки клипов, ElevenLabs Scribe v2 даёт их на 90+ языках вместе с диаризацией (ElevenLabs models).
Строить AI-пайплайн для контента в n8n или Zapier, или писать код самому?
Пишите код для любого этапа, который перемещает двоичные медиаданные, и используйте платформу автоматизации для триггеров, согласований и уведомлений вокруг него. Сила Zapier — в широте охвата: по данным вендора, 9000+ интеграций приложений плюс Zaps, Tables, Forms и Zapier MCP (Zapier developer platform) — и именно это вам нужно для «новая строка в Airtable, запускаем рендер, кидаем ссылку в Slack». Это не тот уровень для MP4 на 200 МБ с истекающей через час ссылкой. n8n находится посередине: его агентные узлы и сквозная обработка двоичных данных позволяют держать файлы внутри воркфлоу (n8n Tools Agent docs), и есть веский инфраструктурный аргумент в пользу разбивки цепочки на этапы, а не в один монолит: статья OnePiece сообщает о снижении потребления GPU в 16 раз при декомпозиции AIGC-пайплайна на поэтапные микросервисы для Wan2.1 «изображение → видео» (arXiv).
Что заменяет Sora в видео-пайплайне после отключения в сентябре 2026 года?
OpenAI объявил 24 марта 2026 года, что Videos API и модели sora-2 и sora-2-pro (снимки sora-2-2025-10-06, sora-2-2025-12-08 и sora-2-pro-2025-10-06) отключаются 24 сентября 2026 года, и не указывает рекомендованной замены (OpenAI deprecations). С 5 сентября 2026 года это 19 дней, поэтому практичный шаг — поставить видео-этап за тонким интерфейсом прямо сейчас и направить его на другого вендора, причём API Runway — наиболее прямая замена для оценки (Runway models docs). Закладывайте бюджет и на переписывание логики разбивки на куски, поскольку лимиты Sora определили форму многих пайплайнов: клипы по 16 и 20 секунд, до 20 секунд добавляется за продление, и максимум 120 секунд в рамках до шести продлений — из-за чего двухминутный озвученный сегмент превращался в шесть последовательных вызовов (OpenAI video generation docs). Если ищете альтернативы, наш каталог сейчас отслеживает 452 инструмента в категории AI Video Generators.