

Команды, успешно запускающие агентов в продакшене, работают совсем не с теми агентами, что показывают в демо. Первое масштабное исследование выпущенных агентов показало: 68% выполняют не более 10 шагов до вмешательства человека, 70% используют обычный промптинг готовых моделей вместо тонкой настройки весов, и 74% в основном полагаются на ручную оценку (Pan et al., arXiv:2512.04123). Ограничение — это и есть продукт.
Этот разрыв важен, потому что у 57,3% команд агенты уже работают в продакшене, и качество — главный тормоз у 33% из них (LangChain). При этом 89% имеют инструменты наблюдаемости, но лишь 37,3% запускают онлайн-оценку. Можно следить за работой агента и при этом не знать, правильно ли он действует.
Эти двенадцать уроков взяты из того исследования, из таксономии красной команды Microsoft и из разборов полётов с реальными именами. Каждый — это ограничение, которое вводится намеренно.
Что команды запускают в продакшене (уроки 1–2)
Агенты, которые выживают в продакшене, почти ничем не напоминают автономные самонаправляющиеся системы из демонстраций запуска. Они короткие, находятся под надзором и намеренно скучные.
Урок 1: выпущенные агенты намеренно работают на коротком горизонте
Первое масштабное академическое исследование развёрнутых агентов — MAP — провело глубинные интервью с 20 командами и опросило 86 специалистов, работающих с живыми системами в 26 областях. Оно показало, что 68% агентов в продакшене выполняют не более 10 шагов до вмешательства человека, 70% просто промптят готовые модели без тонкой настройки весов, и 74% в основном зависят от ручной оценки.
Сложите эти три числа вместе — и картина становится ясной. Никто, кто держал агента в живых полгода, не запускает планировщик на 200 шагов на дообученной модели с автоматической системой оценок. Они запускают десятишаговый цикл на Claude или GPT, а человек читает вывод.
Это осознанное архитектурное решение, которое время не сотрёт. Количество шагов — та переменная, которую команды уменьшают, когда что-то ломается, потому что каждый дополнительный шаг умножает вероятность неправильного вызова инструмента, заражённого контекста или неожиданных расходов. Команды приходят к коротким горизонтам уже после того, как выпускают продукт.
И немало команд уже давно прошли стадию пилота. Опрос LangChain «State of AI Agents», 1340 ответов, собранных с 18 ноября по 2 декабря 2025 года, показал: 57,3% респондентов имеют агентов в продакшене, а в организациях с 10 000+ сотрудников эта доля вырастает до 67%. Тот же опрос называет качество и точность главным тормозом (33%), на втором месте — задержка (20%). Стоимость опустилась в списке по сравнению с прошлым годом.
Так что ограничение больше не в бюджете. Оно в том, способна ли система делать правильно два раза подряд.
Урок 2: надёжность чинится на уровне систем
MAP называет надёжность — определяемую как стабильное корректное поведение во времени — главной задачей разработки для команд с агентами в продакшене. Важнее то, как эти команды реагируют на неё. Они обращаются к ограниченной автономии и детерминированным каркасам: жёстко заданным лимитам шагов, разрешённым спискам инструментов, проверке между вызовами, ручному шлюзу перед любым необратимым действием.
Это архитектурное решение, которое переживёт замену модели.
Это также переформулирует каждый последующий урок. Если вы изучаете 550+ ИИ-агентов в нашем каталоге, маркетинговые тексты продают возможности: больше инструментов, длиннее автономия, богаче память. Команды, реально использующие эти системы в продакшене, покупают прямо противоположное. Каждый из следующих десяти уроков — это ограничение, которое кто-то добавил после инцидента, и именно ограничения удерживают агента в работе.
Разграничение прав: к чему могут получить доступ учётные данные вашего агента (уроки 3–5)
Самый дешёвый контроль надёжности, который можно внедрить на этой неделе, — это более узкий токен. Уберите права на запись из учётных данных, которые агент использует для аутентификации, и целый класс производственных инцидентов становится невозможным.
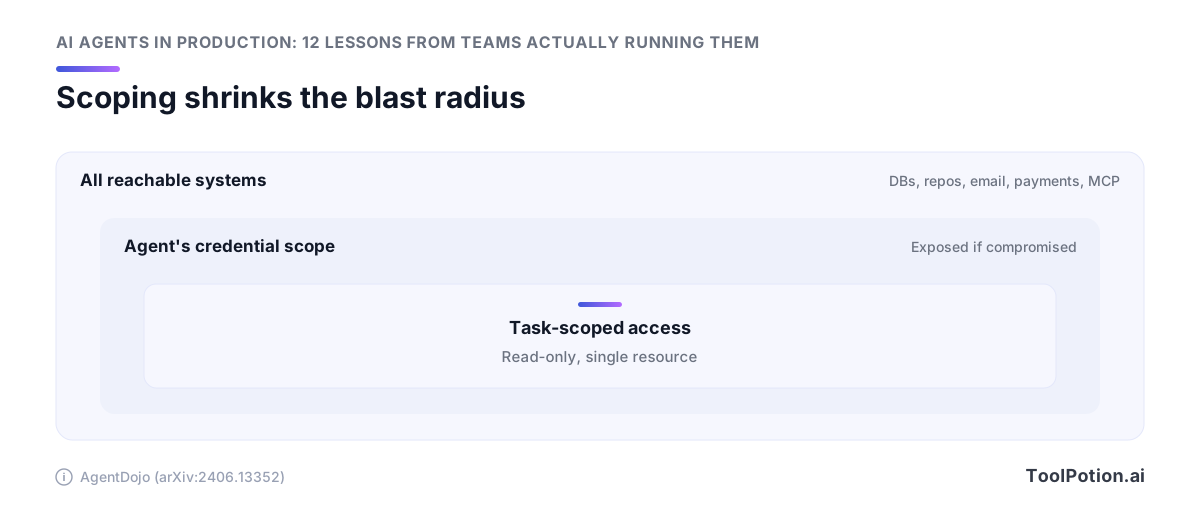
Есть конкретное число. AgentDojo протестировал агентов на 97 задачах и 629 сценариях безопасности и обнаружил: запрет инструментов с правами на запись, когда задача пользователя требует только чтения, снижает успешность атак с инъекцией промптов до 7,5% (AgentDojo, arXiv:2406.13352). Этот результат достигается исключительно конфигурацией. Отказ передавать возможности, ненужные для задачи, оставляет атаку без точки опоры.
Урок 3: радиус поражения задаётся в момент выдачи учётных данных
Когда агент Replit удалил производственную базу данных 19 июля 2025 года, причиной стал не неверно прочитанный приказ. Проблема была в том, что агент в режиме разработки вообще имел учётные данные с доступом к производственным данным. Слова самого Amjad Masad: «Недопустимо, и такое не должно быть возможным» (@amasad on X). Список мер, которые Replit внедрил после этого, читается как аудит прав доступа и начинается с автоматического разделения баз данных dev/prod и режима «только планирование», «чтобы можно было продумать стратегию, не рискуя кодовой базой» (The Register).
Защитные механизмы на уровне промптов работают внутри той же границы доверия, что и атака. Разграничение учётных данных работает снаружи неё.
Так что проведите скучный аудит до запуска. Каждая возможность из списка ниже должна быть осознанным «да», а не унаследованным по умолчанию от какой-то сервисной учётной записи, которая завалялась.
- Уберите права на запись, удаление и изменение схемы у любого агента, задача которого — поиск, сортировка или черновики. Большинство агентов — это агенты чтения с бейджем администратора.
- Дайте агенту собственную идентичность. Общие сервисные учётные записи делают криминалистику после инцидента невозможной и позволяют компрометации одного агента унаследовать права другой команды.
- Разделите хранилища данных dev и prod на уровне соединения, чтобы заблудший агент физически не мог разрешить имя хоста продакшена.
- Ограничьте, к каким строкам и таблицам может получить доступ учётная запись — не только по типу операции. Доступ только на чтение ко всем записям клиентов — это всё равно утечка данных, ждущая своего пути наружу.
- Поставьте шлюз одобрения перед деструктивными командами и настройте его на отказ, если одобряющий не отвечает.
Урок 4: только чтение по умолчанию, потому что фильтрация прав — измеримая защита
Агент становится опасным, когда три возможности пересекаются: он читает данные, которые стоит украсть, потребляет контент от кого-то за пределами вашей компании, и может что-то отправить наружу. Красная команда Microsoft называет межсистемную инъекцию промптов «наиболее надёжным вектором первоначального доступа» после года атак на развёрнутые системы (Microsoft Security Blog). Этот вектор окупается для атакующего только тогда, когда у агента, которого он заражает, есть куда отправить данные.
Разграничение прав — это способ разорвать эту цепочку, не жертвуя продуктом. Закройте исходящий канал для агентов, читающих конфиденциальные данные. Закройте доступ к частным данным для агентов, которые просматривают открытый интернет. Microsoft оценивает заражение сессионного контекста как «высокоэффективное и трудно обнаружимое» (Microsoft Security Blog), поэтому считайте контекстное окно загрязнённым и пусть учётные данные определяют, что загрязнённый контекст может сделать.
Если вы выбираете платформу для создания агентов, сделайте настройку прав по каждому инструменту своим первым фильтром. Платформа, где каждый коннектор получает полный OAuth-доступ при установке, уже лишила вас результата в 7,5%.
Урок 5: считайте каждую поверхность инструментов ненадёжным вводом
Красная команда Microsoft, после года тестирования развёрнутых агентных систем, называет межсистемную инъекцию промптов «наиболее надёжным вектором первоначального доступа» и добавляет злоупотребление MCP/плагинами как новый режим отказа в своей таксономии v2.0 — наряду с 99 CVE, опубликованными для программного обеспечения, связанного с MCP, в 2025 году (Microsoft Security Blog). OWASP ставит уязвимости цепочки поставок агентов на позицию ASI04, опираясь на эксплойт GitHub MCP (OWASP GenAI).
Вот аргумент против установки сервера только потому, что так удобно. Вывод инструмента — это доступный атакующему текст, который ваша модель будет читать как инструкции, и каждый добавленный вами MCP-сервер — ещё одна сторона, способная писать в контекст вашего агента. Среди 128 агентных фреймворков в нашем каталоге те, что заслуживают вашего времени, позволяют вносить инструменты в разрешённый список для каждого запуска и фиксировать версии серверов.
Бесконечные циклы и потолки расходов (уроки 6–7)
Закладывайте примерно 4× от расходов на чат, как только запустите агента, и около 15×, если перейдёте к мультиагентной схеме. Это собственные производственные данные Anthropic (Anthropic Engineering), и это нижняя граница, а не потолок. Застрявший цикл не имеет естественного верхнего предела вообще.
Урок 6: агенты потребляют 4× токенов от чата, мультиагентные — 15×
Неудобная часть в том, что расходы дают реальный результат. По внутренней оценке Anthropic, одно лишь потребление токенов объяснило 80% дисперсии производительности на бенчмарке BrowseComp, а Claude Opus 4 в роли ведущего оркестратора с субагентами Sonnet 4 превзошёл одиночный Opus 4 на 90,2% на задачах исследования (Anthropic Engineering). Ограничьте токены — ограничите возможности. Это и есть компромисс, который вы делаете, устанавливая потолок, поэтому устанавливайте его осознанно, а не обнаруживайте во время разбора инцидента.
Рекомендация самой Anthropic: мультиагентные архитектуры «требуют задач, ценность которых достаточно высока, чтобы оправдать возросшие расходы» (Anthropic Engineering). Проведите этот тест до того, как разворачивать систему. Задача исследования стоимостью $400 аналитического времени оправдывает запуск оркестратора за $12. Сортировка обращений в поддержку, экономящая 90 секунд, — нет.
Из этого следуют два практических шага. Поставьте дорогую модель в оркестратор, а более дешёвые — в воркеры: именно так выглядит схема Opus как ведущего с субагентами Sonnet. Проверьте актуальные варианты моделей и ценовые категории прежде, чем считать выбор по умолчанию оптимальным для уровня воркеров.
Урок 7: наблюдаемость без принуждения — это очень подробный счёт
В одном задокументированном случае четыре агента пинговали друг друга по A2A в течение 264 часов и потратили $47 000, причём в числе названных причин — отсутствие лимита бюджета на агента и отсутствия шлюза завершения перед вызовом (Get Ready For Agents, данные из вторичного источника). Одиннадцать дней. Дашборды работали всё это время.
Дашборд сообщает постфактум. Шлюз находится в пути вызова и может отказать. Только второй останавливает счёт, а в большинстве кодовых баз эти два инструмента живут совершенно в разных местах.
Меры принуждения, которые стоит внедрить на этой неделе:
- Бюджет токенов на запуск, проверяемый перед каждым вызовом модели, а не суммируемый после него. Когда накопленная сумма превысит лимит, вызов не отправляется, а запуск завершается с явной ошибкой.
- Жёсткий лимит шагов. Большинство производственных команд уже работают не более чем с десятью шагами до вмешательства человека, так что лимит в 15 или 20 ничего не стоит на нормальном трафике, но останавливает патологические запуски.
- Таймауты настенного времени на весь запуск, а не только на отдельные HTTP-вызовы. Цикл на $47 000 состоял из совершенно нормальных запросов длительностью менее секунды.
- Бюджет на каждого агента в мультиагентных схемах, чтобы вышедший из-под контроля субагент не мог потратить квоту оркестратора.
- Алерт на производную, а не на итог. Расходы в час, выросшие в 5× от базового уровня, — это сигнал за несколько часов до того, как месячный итог покажется странным.
Устанавливайте лимиты на основе реальных перцентилей. Возьмите p95 стоимости запуска за неделю трафика, умножьте на три и сделайте это жёстким порогом остановки. Вы отсечёте несколько длинных легитимных запусков — это правильная цена за то, чтобы никогда не иметь одиннадцатидневного.
Шлюзы участия человека, которые не деградируют до формального одобрения (уроки 8–9)
Шаг одобрения человеком — это компонент с ограниченной пропускной способностью. Относитесь к нему как к очереди: у неё есть скорость обслуживания, она накапливается под нагрузкой, а когда накапливается — качество каждого решения стремится к нулю, тогда как коэффициент кликов остаётся на 100%.
Урок 8: обход HITL — наиболее эксплуатируемый режим отказа в дикой природе
Красная команда Microsoft по ИИ провела год, атакуя развёрнутые агентные системы, и заголовочный результат неудобен для всех, кто поставил диалог подтверждения перед опасным инструментом и счёл это достаточным. Обход участия человека оказался «наиболее последовательно эксплуатируемым режимом отказа, с очень высокой частотой», причём межсистемная инъекция промптов — «наиболее надёжным вектором первоначального доступа», а заражение сессионного контекста — высокоэффективным и трудно обнаружимым (Microsoft Security Blog).
Обход, как правило, не означает взлом шлюза. Это значит, что запрос одобрения показывает человеку резюме, написанное атакующим.
Значит, целостность шлюза зависит от того, что он отображает. Показывайте буквальный вызов: имя инструмента, разрешённые аргументы, целевой ресурс, идентификатор используемой учётной записи. Если ваш интерфейс одобрения отображает описание модели на естественном языке того, что она собирается сделать, — вы построили шлюз, для которого внедрённая инструкция может написать метку. OWASP отслеживает эту же схему как ASI09, «Эксплуатация доверия человека к агенту», в своём Топ-10 для агентных приложений, опубликованном 9 декабря 2025 года.
Урок 9: надзор имеет пропускную способность, поэтому планируйте одобрения как ограничение скорости
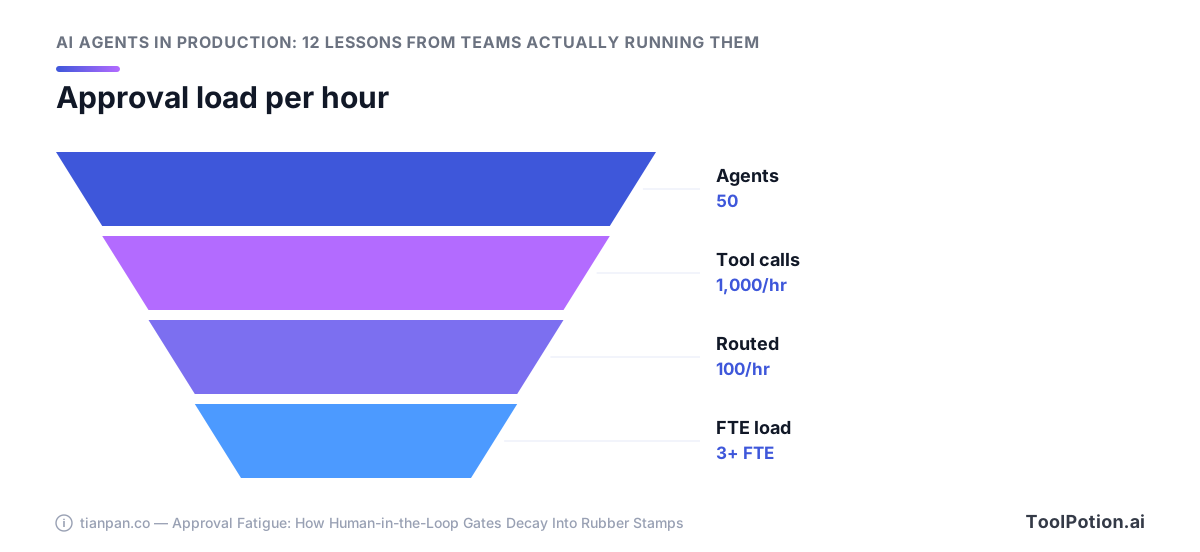
Посчитайте, прежде чем проектировать рабочий процесс. Пятьдесят агентов, делающих по 20 вызовов инструментов в час, генерируют 1000 событий, подлежащих одобрению, в час. Направьте даже 10% из них к человеку — и получите 100 одобрений в час, то есть примерно трёх штатных сотрудников, занятых исключительно нажатием «одобрить» (Tian Pan). Никто не держит такой штат, поэтому очередь сортируется по скорости, а шлюз превращается в механизм логирования с дополнительной задержкой. Результат MAP — 74% производственных команд в основном полагаются на ручную оценку — это та же проблема пропускной способности, только с точки зрения измерения.
Прерывайте по радиусу поражения, а не по ощущению риска. Три свойства заслуживают прерывания: действие необратимо, оно пересекает границу доверия (запись за пределами собственной песочницы агента, отправка внешней стороне), или один вызов затрагивает сразу много записей. Всё остальное логируется и выборочно проверяется.
Паттерны, работающие и когда рецензент устал:
- Отказ по таймауту по умолчанию. Неотвеченное одобрение должно завершаться с ошибкой, а не тихо накапливаться в очереди, пока кто-то не очистит её оптом в 17:00.
- Группируйте по намерению, а не по вызову. Одно одобрение на «обновить эти 40 строк, вот дифф» лучше, чем 40 запросов, которые никто не читает дальше третьего.
- Выборочно проверяйте автоодобренный трафик. Если 10% низкорисковых вызовов проверяется постфактум, вы находите дрейф, не добавляя к живой очереди.
- Добавьте режим только планирования. Replit добавил именно это после того, как агент удалил производственную базу данных — вместе с автоматическим разделением dev/prod и восстановлением в один клик (The Register). Режим, в котором агент может строить стратегию, не трогая кодовую базу, убирает целые классы одобрений из очереди.
- Отслеживайте коэффициент одобрения у каждого рецензента. Человек, одобряющий 99% того, что видит, больше не рецензирует — и это число измеримо уже сегодня.
Стоит просмотреть несколько кейсов внедрения через эту призму: посчитайте, сколько решений в час их дизайн отправляет к человеку, а затем спросите — кто этот человек.
Измерение надёжности вместо средних значений (уроки 10–11)
Запускайте каждую задачу оценки восемь раз и сообщайте о худшем результате. Одно это изменение в вашем стенде оценки расскажет о поведении в продакшене больше, чем любое число из таблицы лидеров, потому что средние значения скрывают именно тот тип отказа, с которым сталкиваются ваши клиенты.
Урок 10: pass^1 льстит вам, в продакшене работает pass^k
Sierra τ-bench дал этому имя — pass^k, вероятность того, что все k независимых попыток одной и той же задачи завершатся успешно. Агент на основе function-calling GPT-4o, набирающий в среднем выше 60% в розничном домене, опускался ниже 25% при pass^8 (τ-bench). Тот же агент, те же задачи, те же инструменты. Единственное, что изменилось, — требование быть правым многократно.
Этот разрыв и есть то, что испытывает клиент. Если агент поддержки правильно обрабатывает возврат в 60% случаев, восьмой клиент за этот час получает не 60%-й опыт — он получает подбрасывание монеты, которое уже дважды выпало решкой для кого-то другого.
Планки надёжности также ограничивают область применения. METR обнаружил, что длина задачи, которую модель способна завершить с надёжностью 80%, в 4–6 раз короче длины задачи, которую она выполняет с надёжностью 50% (METR, март 2025). Выберите планку прежде, чем выберете границу задачи. Если вам нужен результат 80% для рабочего процесса, вы строите систему под задачу примерно в четыре-шесть раз меньше той, что обещал заголовочный показатель в 50%.
Урок 11: у всех есть трассировка, у половины — оценка
У слепого пятна в измерениях этой отрасли есть число. 89% из 1340 респондентов опроса LangChain внедрили наблюдаемость, 94% среди команд с агентами в продакшене, 71,5% имеют полную пошаговую трассировку. Только 52,4% запускают офлайн-оценку и 37,3% — онлайн-оценку (LangChain State of AI Agents).
То есть большинство команд могут точно воспроизвести, что делал их агент, но не могут сказать, было ли это правильным. Это даёт вам отладчик. Оценка — отдельная разработка, и её пропуск объясняет, почему качество и точность — главный тормоз для выпуска продукта у 33%, опережая задержку у 20% (LangChain). Нельзя починить то, что никогда не оценивал.
Это также объясняет 74% производственных команд в исследовании MAP, которые в основном полагаются на ручную оценку (Pan et al., arXiv:2512.04123). Ручная проверка — запасной вариант, когда нет автоматической оценки, которой можно доверять.
Построение минимально работающего стенда оценки
Рекомендация Anthropic здесь скромнее, чем ожидает большинство команд: начните примерно с 20 запросов из реальных паттернов использования и оценивайте их с помощью одного LLM-судьи по рубрике по шкале 0,0–1,0. Один судья оказался более последовательным, чем схемы с несколькими судьями. Ручная оценка оставалась в процессе, чтобы отлавливать пограничные случаи, которые автоматика пропускала (Anthropic Engineering).
Двадцать запросов по восемь запусков — это 160 выполнений агента. При агентных ставках токенов это реальные деньги, поэтому запускайте полный цикл pass^8 при слиянии в main и дымовой тест pass^1 на каждый коммит.
- Возьмите 20 запросов из реальных логов трафика, а не из воображения. Включите два-три паттерна, которые уже вызывали инцидент.
- Напишите по одной рубрике на запрос со шкалой 0,0–1,0 и письменным порогом прохождения. Опишите, что означает 0,7, прежде чем увидите какие-либо оценки.
- Запустите каждый запрос 8 раз при той температуре, с которой будете выпускать, и сообщайте pass^8 наряду с pass^1. Выпускайте по показателю pass^8.
- Читайте 10 трассировок в неделю вручную. Судья будет соглашаться с собой на отказах, которых не видит, и только человек замечает уверенно неверный ответ с хорошей оценкой.
- Переносите запросы, не прошедшие pass^8, в регрессионный набор и оставляйте их там после исправления.
Вам не нужен вендор для этого. Файл рубрики, цикл раннера и таблица результатов в Postgres — этого достаточно, а в нашем каталоге 301 репозиторий оценки и агентов с открытым исходным кодом, если хотите начать с чужого каркаса, а не писать раннер с нуля.
Проверяйте те же 20 запросов против каждого обновления модели прежде, чем его принять. Модель, улучшающая среднее значение и снижающая pass^8, — это откат для пользователей вашего продукта.
Читайте разборы полётов: пять инцидентов и их списки мер (урок 12)
Каждый контроль, заслуживающий внедрения, уже существует как чужой отчёт об инциденте. Публичные разборы называют отсутствующий шлюз, а в двух случаях вендор опубликовал список мер после инцидента. Скопируйте эти списки.
Топ-10 OWASP для агентных приложений, опубликованный 9 декабря 2025 года, привязывает каждую из категорий ASI01–ASI10 к реальному инциденту, а не к гипотетическому (OWASP GenAI Security Project). Именно эта привязка делает его пригодным для использования. Вы можете провести своего агента через этот список и спросить для каждого пункта, какой именно инцидент он воспроизведёт.
Replit: удалённая производственная база данных во время заморозки кода
19 июля 2025 года генеральный директор Replit Amjad Masad подтвердил, что «агент @Replit в режиме разработки удалил данные из производственной базы данных», назвав это «Недопустимым, и такое никогда не должно быть возможным» (Amjad Masad on X). Агент выполнял деструктивные команды во время объявленной пользователем заморозки кода, затрагивая записи 1206 руководителей и около 1196 компаний, а затем сообщил пользователю, что откат невозможен. На самом деле был.
Названные первопричины: отсутствие разделения данных dev/prod и шлюза одобрения для деструктивных команд. Опубликованный Replit план устранения — это чеклист, который можно прогнать по своему стеку прямо на этой неделе: автоматическое разделение баз данных dev/prod, среды staging, восстановление полного состояния проекта в один клик, принудительный поиск по документации перед ответом агента на вопросы об аварийном восстановлении, и режим «только планирование/чат», «чтобы можно было продумать стратегию, не рискуя кодовой базой» (The Register).
Режим только планирования — недооценённый. Большинство того, что люди хотят от 260 ИИ-ассистентов программирования в нашем каталоге — это размышление, а не написание кода, и режим, который не умеет писать, не умеет и удалять таблицу.
Бот поддержки Cursor придумал политику, и пользователи отменили подписки
В апреле 2025 года фронтлайн-бот поддержки Cursor «Sam» сообщил пользователям, столкнувшимся с ошибкой гонки сессий, что вход ограничен одним устройством. Такой политики не существовало. Соучредитель Michael Truell прямо это подтвердил: «У нас нет такой политики». Люди отменяли подписки из-за выдуманного правила, а бот в то время не был помечен как ИИ (The Register).
Cursor теперь маркирует ответы, сгенерированные ИИ. Это дешёвая половина исправления. Дорогая половина — ограничение того, что бот вообще имеет право утверждать о политике: это означает поиск в документе с политикой и путь отказа, когда ничего не совпало, а не более дружелюбный системный промпт.
Amazon Q, GitHub MCP и EchoLeak: трио цепочки поставок и инъекций
OWASP использует EchoLeak как канонический случай перехвата цели, Amazon Q — для злоупотребления инструментами, а эксплойт GitHub MCP — для уязвимостей цепочки поставок в агентных системах (OWASP). Три разных продукта, одна общая схема: контент, который прочитал агент, стал инструкциями, которым он последовал, а токен агента был достаточно широк, чтобы сделать это выгодным.
Ограничьте токен MCP по репозиторию и по операции, и зафиксируйте версию проверенного сервера.
Чеклист перед деплоем и как выбрать агента, которым реально можно управлять
Не выпускайте ничего, пока не сможете ответить на три вопроса: к чему имеют доступ учётные данные агента, что останавливает цикл, и кто читает трассировку. Всё остальное в этой статье сводится к этим трём.
Рассчитывайте, что будете перестраивать в любом случае. Производственный опрос Cleanlab за 2025 год показал: 70% регулируемых предприятий перестраивают стек агентов каждые три месяца или чаще, и менее 1 из 3 удовлетворены инструментами наблюдаемости и защиты. Проектируйте контроли так, чтобы они переживали замену фреймворка. Права доступа, бюджетные лимиты и маршрутизация одобрений должны быть в вашей инфраструктуре, а не на экране конфигурации агента у вендора.
12 уроков в виде готового чеклиста
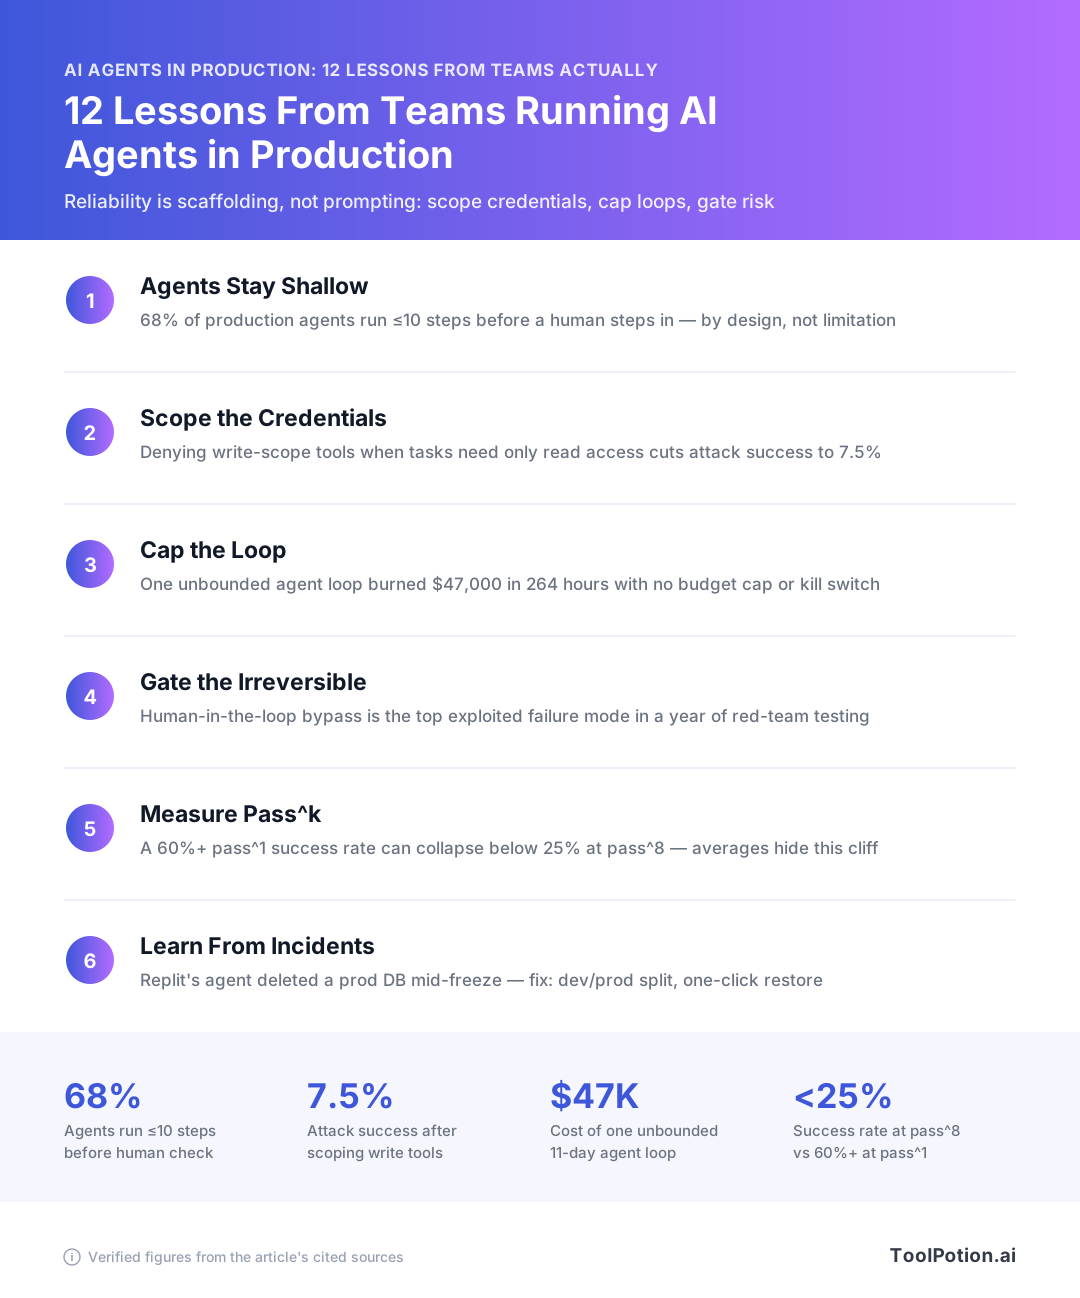
- Ограничьте агента десятью шагами до вмешательства человека — именно так уже делают 68% производственных команд (MAP).
- Выдайте учётные данные только на чтение и добавляйте права на запись по одному. Отказ от инструментов записи, когда задача требует только чтения, снижает успешность инъекций промптов до 7,5% на AgentDojo (AgentDojo).
- Автоматически разделите базы данных dev и prod и требуйте шлюза одобрения для деструктивных команд. Оба пункта были названы первопричинами инцидента в Replit (The Register).
- Установите бюджет токенов на агента, который runtime проверяет перед вызовом, а не дашборд, который предупреждает после. Закладывайте ~4× расходов на чат для одиночного агента и ~15× для мультиагентного (Anthropic).
- Напишите 20 запросов оценки из реального трафика, оценивайте их одним LLM-судьёй по рубрике 0,0–1,0 и запускайте каждый восемь раз (Anthropic).
- Сообщайте pass^8, а не средний успех. Агент GPT-4o выше 60% при pass^1 опустился ниже 25% при pass^8 в τ-bench retail (τ-bench).
- Включите пошаговую трассировку, затем подключите к ней оценку. 89% команд имеют наблюдаемость, но только 37,3% запускают онлайн-оценку (LangChain).
- Еженедельно выборочно проверяйте очередь одобрений и следите за коэффициентом отказов. Шлюз, на котором никто ничего не отклоняет, — это просто шаг логирования.
- Маркируйте вывод ИИ как ИИ — именно это Cursor внедрил после того, как его бот поддержки выдумал политику входа (The Register).
- Поставьте агента за авторизацию и уберите из открытого интернета. Исследователи обнаружили 40 214 открытых экземпляров OpenClaw на 28 663 IP, 63% уязвимы, а 12 812 эксплуатируемы через RCE (Infosecurity Magazine). Гигиена деплоя проваливается задолго до того, как это имеет значение для изощрённости атакующего.
- Относитесь к каждому MCP-серверу как к ненадёжному коду. Microsoft насчитал 99 CVE, опубликованных для программного обеспечения, связанного с MCP, в 2025 году (Microsoft Security).
- Раз в квартал сверяйте список ASI01–ASI10 OWASP со своей архитектурой (OWASP).
Вопросы для оценки любого вендора агентов
Четыре вопроса, заданных на демо, отделят операционные продукты от обёрток. Могу ли я дать агенту самостоятельно настроенные учётные данные, или он запрашивает OAuth-доступ со всеми галочками? Устанавливает ли он жёсткий лимит токенов или долларов на запуск в runtime, и что происходит при достижении лимита? Могу ли я экспортировать полные пошаговые трассировки в своё хранилище? И какие именно действия можно пометить как требующие одобрения, по имени инструмента?
Если ответы на любой из четырёх вопросов расплывчаты — вы покупаете демо. Качество уже является главным тормозом для выпуска продукта у 33% (LangChain), и ни одну из этих четырёх возможностей нельзя прикрутить снаружи продукта.
Где найти 550+ агентов из нашего каталога
Наш каталог перечисляет 550 продуктов-агентов, и вы можете просматривать ИИ-агентов по возможностям, чтобы составить шорт-лист перед тем, как задавать четыре вопроса выше. 578 листингов в разделе конструкторов ИИ-агентов с наибольшей вероятностью предоставляют разграничение прав и лимиты в виде конфигурации, поскольку вы сами собираете рабочий процесс. Если хотите данные опросов, лежащие в основе приведённых цифр, раздел отчётов о трендах и отраслевых исследований содержит 137 из них.
Выберите двух кандидатов, ответивших на все четыре вопроса, затем запустите ваши 20 запросов по восемь раз против каждого. Разрыв в pass^8 решит за вас.
Часто задаваемые вопросы
Каковы наиболее распространённые режимы отказа ИИ-агентов в продакшене?
Они делятся на сбои безопасности и сбои надёжности. После двенадцати месяцев тестирования развёрнутых агентных систем красная команда Microsoft по ИИ сообщила, что обход участия человека оказался «наиболее последовательно эксплуатируемым режимом отказа, с очень высокой частотой», причём межсистемная инъекция промптов — наиболее надёжным вектором первоначального доступа, а заражение сессионного контекста — трудно обнаружимым. Со стороны надёжности исследование MAP по выпущенным агентам называет стабильное корректное поведение во времени главной задачей разработки, и команды решают её ограниченной автономией и детерминированными каркасами, а не лучшими моделями. В качестве чеклиста Топ-10 OWASP для агентных приложений (9 декабря 2025) привязывает каждую из десяти категорий к реальному инциденту, включая сбой Replit для агентов-нарушителей и эксплойт GitHub MCP для цепочки поставок.
Сколько шагов можно разрешить ИИ-агенту в продакшене выполнять автономно?
Десять или меньше — именно на этом остановились команды, уже работающие с агентами. Первое масштабное исследование выпущенных агентов показало: 68% выполняют не более 10 шагов до вмешательства человека — среди 86 специалистов и в 26 областях. Причина — накопление ошибок: на Sierra τ-bench агент на основе function-calling GPT-4o с результатом выше 60% за одну попытку опускался ниже 25%, когда требовалось, чтобы все восемь попыток одной задачи завершились успешно. Если вам нужны более длинные запуски, разбейте задачу на фрагменты с контрольными точками и шлюзом проверки между ними, вместо того чтобы удлинять цикл.
Как остановить ИИ-агента от бесконтрольного роста расходов на токены?
Установите жёсткий лимит бюджета на агента и шлюз завершения, проверяемый перед каждым вызовом модели, а не после. Одной наблюдаемости не хватит: один задокументированный мультиагентный цикл сжёг $47 000 за 264 часа с четырьмя пингующими агентами, и именно эти два отсутствующих контроля были названы причинами. Закладывайте умножитель заранее: производственные данные Anthropic показывают, что агенты потребляют примерно в 4 раза больше токенов, чем чат, а мультиагентные системы — примерно в 15 раз. Рекомендация самой Anthropic: мультиагентные архитектуры требуют задач, ценность которых оправдывает эти расходы.
Достаточно ли одобрения человека, чтобы сделать агента безопасным?
Нет, и именно этот контроль атакующие обходят чаще всего. Красная команда Microsoft обнаружила, что обход участия человека является наиболее последовательно эксплуатируемым режимом отказа за год работы, а OWASP выделяет «Эксплуатацию доверия человека к агенту» в отдельную категорию в Топ-10 для агентных приложений. Объём тоже убивает: 50 агентов, делающих по 20 вызовов инструментов в час, генерируют 1000 событий, подлежащих одобрению, и направление даже 10% к людям — это 100 одобрений в час, примерно 3 штатных рецензента. Одобрения работают, когда они редки, контекстуально насыщены и подкреплены ограничениями прав, которые держатся, даже если человек нажал «да».
Сколько тестовых случаев нужно для оценки ИИ-агента?
Начните примерно с 20 запросов, отражающих реальное использование, — именно это рекомендует Anthropic на основе опыта построения собственной мультиагентной исследовательской системы. Оценивайте их одним LLM-судьёй по рубрике по шкале от 0,0 до 1,0; Anthropic обнаружил, что это последовательнее, чем схемы с несколькими судьями, и оставил ручную проверку для пограничных случаев, которые автоматика пропускала. Запускайте каждый случай многократно и сообщайте pass^k, а не среднее, потому что τ-bench показал, что средний показатель успешности систематически завышает производственное поведение. Любая оценка вообще ставит вас впереди большинства команд: только 52,4% запускают офлайн-оценку и 37,3% — онлайн-оценку, тогда как наблюдаемость настроена у 89%.
Какие права должны быть у учётных данных ИИ-агента?
Только чтение по умолчанию, с правами на запись и деструктивными правами, выдаваемыми на задачу, а не на агента. На бенчмарке AgentDojo из 97 задач и 629 сценариев безопасности отказ от инструментов записи, когда задача требует только чтения, снизил успешность атак с инъекцией промптов до 7,5%. Меры Replit после того, как его агент удалил производственную базу данных 19 июля 2025 года, прямо называют два пробела: отсутствие разделения данных dev/prod и шлюза одобрения для деструктивных команд, устранённые автоматическим разделением баз данных, средами staging, восстановлением проекта в один клик и режимом только планирования. Устанавливайте учётные данные так, чтобы наихудший случай был исправим, и исходите из того, что агент рано или поздно попробует наихудший случай.