

GitHub сообщает, что в Artificial Analysis Coding Agent Index Copilot Fusion Max «набрал 60 баллов, уступив Claude Code с Opus 5.5 Max меньше двух пунктов» (GitHub changelog). The New Stack в заголовке превратил это в систему, которая «обходит Claude Code за полцены по API» (The New Stack). Это разные утверждения, и именно в зазоре между ними команде стоит подумать.
Fusion доступен в GitHub Copilot в общем доступе как новый пункт в списке моделей. Модель вы не выбираете. Вы выбираете уровень усилий, а Copilot сам решает, какие модели запускать и в каком порядке для каждого промпта. Идея хорошая, но доказательная база тонкая, поэтому мы бы считали это в первую очередь функцией контроля расходов, а уже во вторую — заявлением о качестве.
Шестьдесят — это не шестьдесят два
Перечитайте формулировку самого GitHub. Fusion Max оказался в двух пунктах от Claude Code на Opus 5.5 Max при примерно вдвое меньшей средней стоимости API на задачу, вдвое меньшем числе токенов и примерно на 40% меньшем времени (changelog). Результат достойный, и для питча этого хватает. Но это не победа: в самом тексте The New Stack написано «сопоставимо», хотя заголовок говорит «обходит». GitHub повторил это утверждение в итогах Universe, и по свету разошлась именно версия «вдвое дешевле».
Индекс, на который ссылается GitHub, публикует Artificial Analysis. Он объединяет три бенчмарка — FrontierCode, Terminal-Bench 4.0 и SWE-Atlas-QnA-AA — с равными весами (Artificial Analysis). В режиме по умолчанию на странице Claude Code с Opus 5.5 Max стоит на 62, а записи Fusion нет. Если включить переключатель «Router models», появится GitHub Copilot - Copilot Fusion (Max) с 60 баллами: число настоящее и совпадает с тем, что заявил GitHub. Тот же переключатель показывает Devin Fusion CLI от Cognition, который объединяет Opus 5.5 Max с GPT-6 Luna и делит с Claude Code 62 балла. Это говорит о том, что роутеры как класс догоняют, а не о том, что роутер GitHub — лучший. Столбцы со стоимостью на этой странице мы с цифрой GitHub «вдвое дешевле» не сверяли, так что эта часть остаётся на слове GitHub.
Три пути за одним пунктом меню
В документации Fusion назван «интеллектуальным роутером и оркестратором моделей во время выполнения» (GitHub Docs). Для каждого промпта он выбирает один из трёх паттернов выполнения, и разные промпты в одной сессии могут идти разными путями.
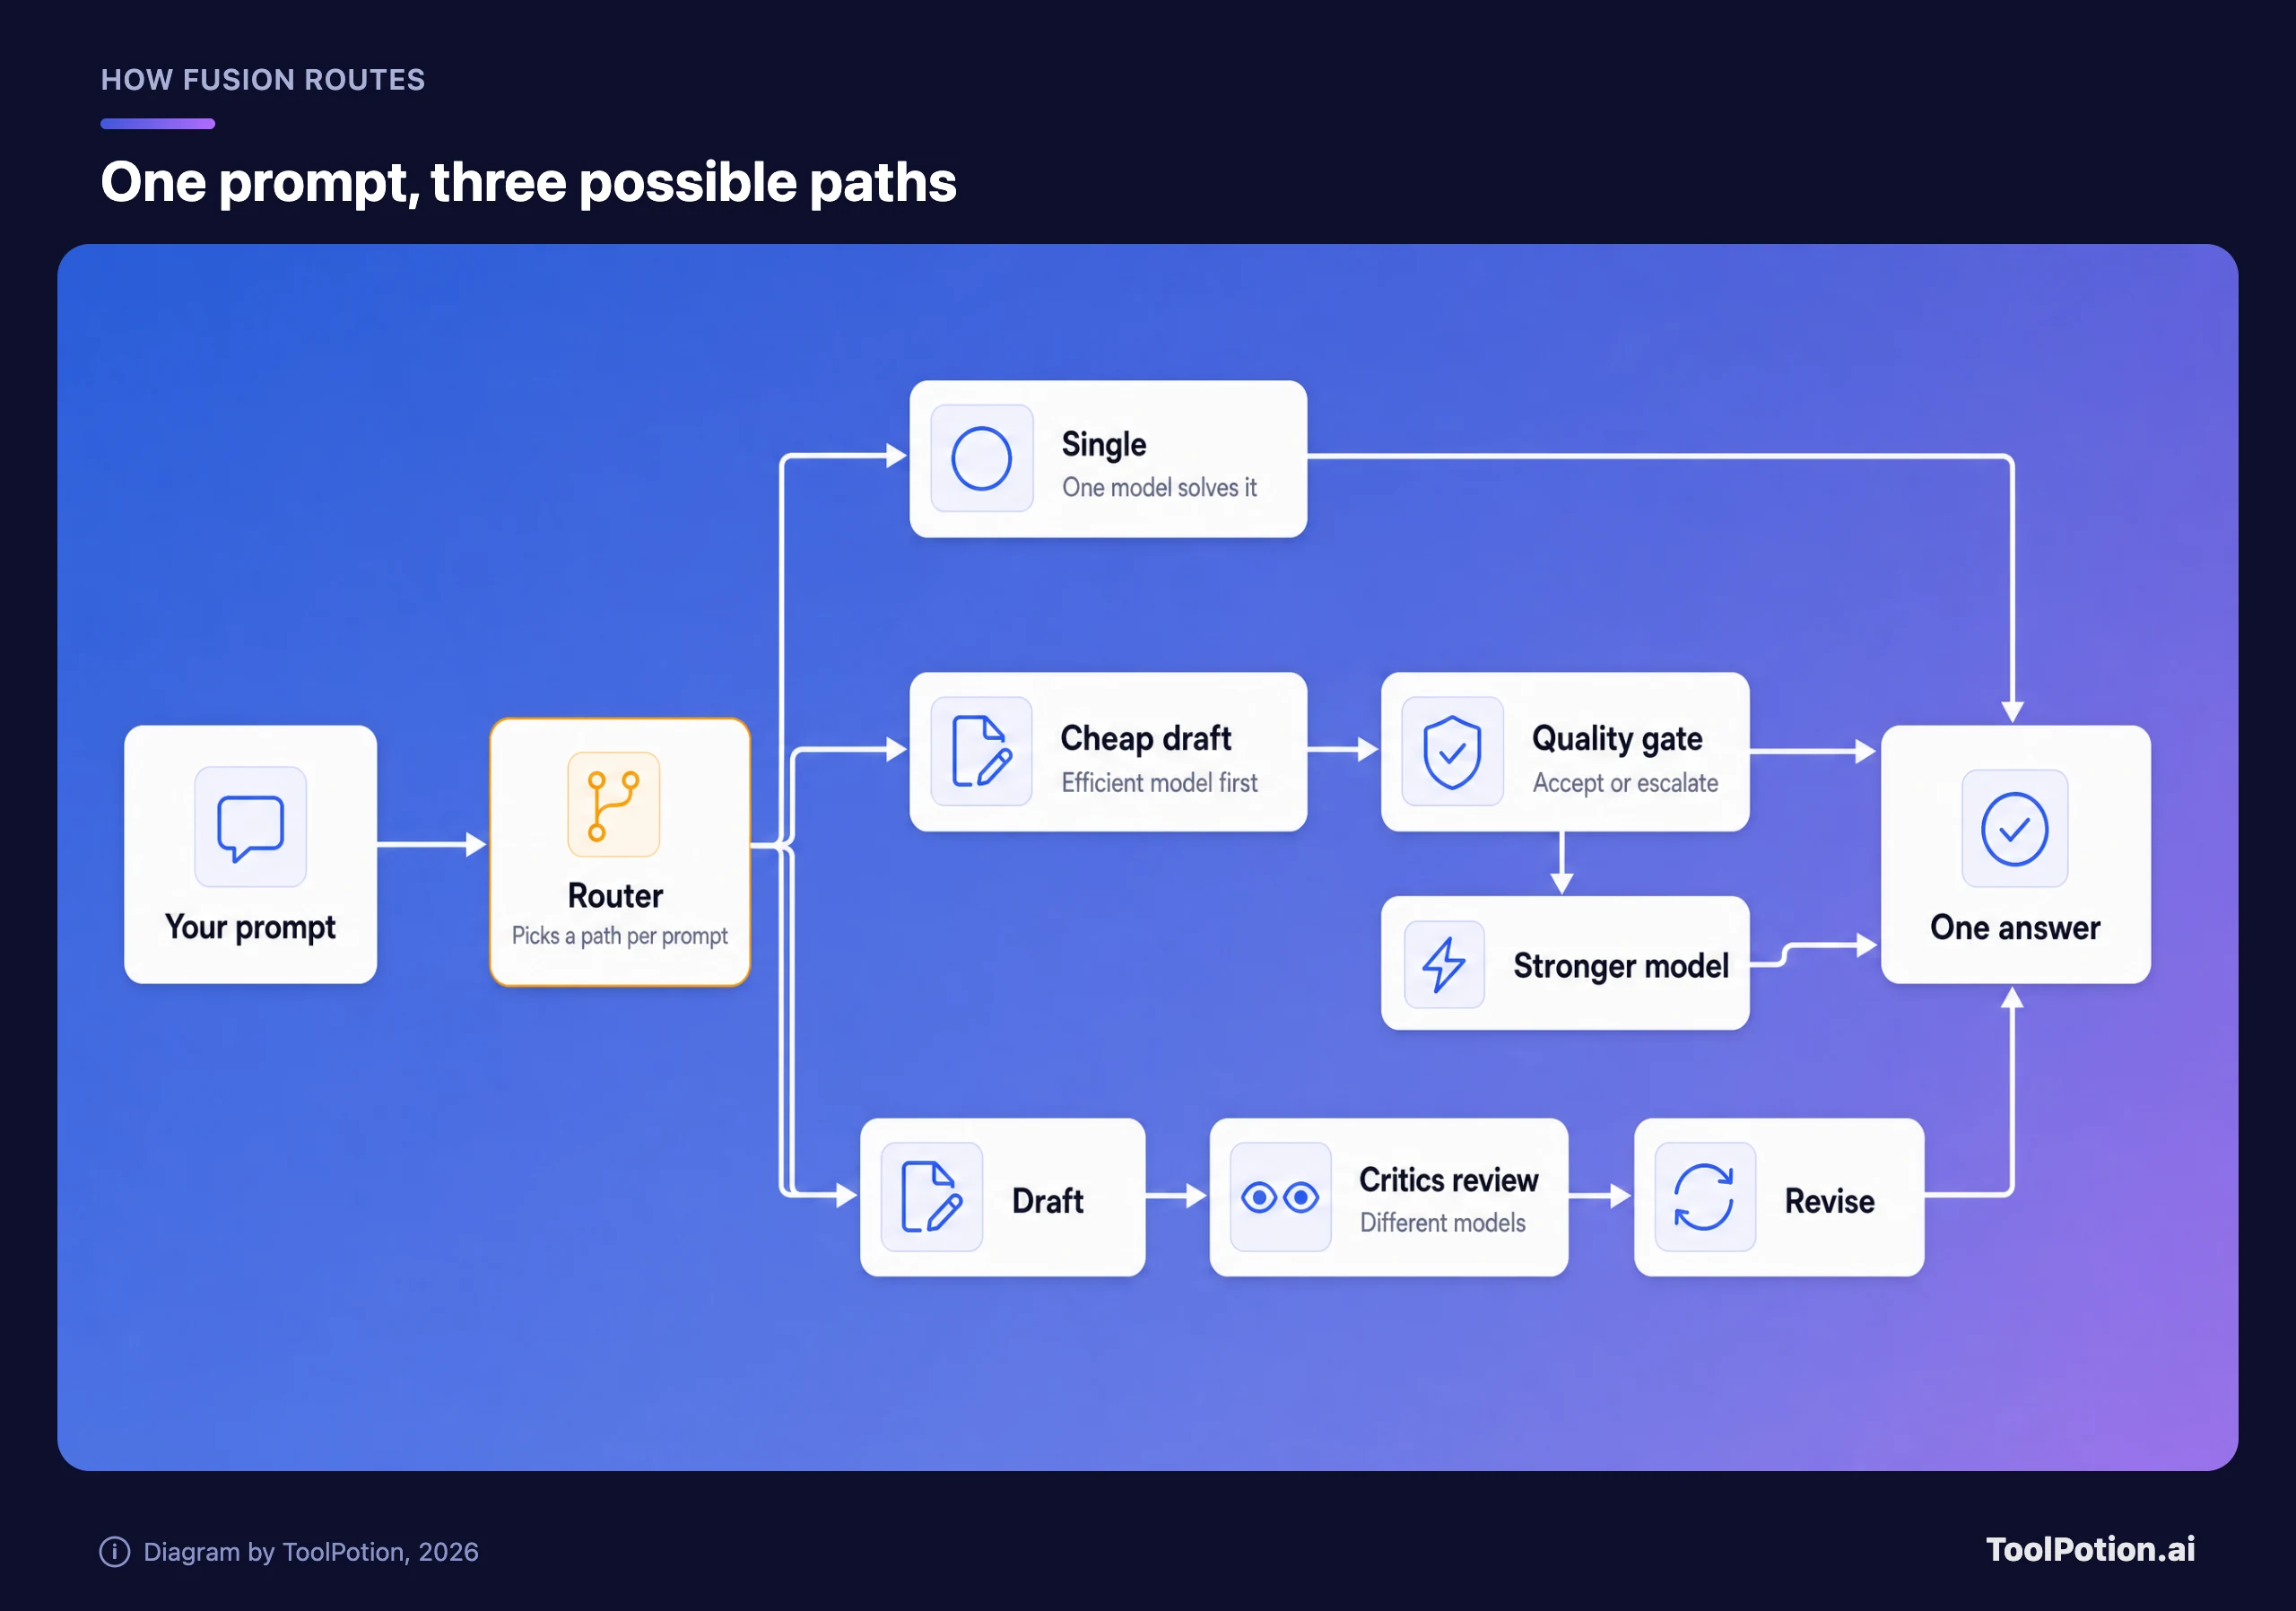
Single — это когда отвечает одна модель. В Cascade черновик пишет эффективная модель, а судья решает, принять его или передать более сильной модели. В Critique одна модель пишет черновик, другие его рецензируют, и автор черновика вносит правки. Уровни усилий задают, насколько агрессивной будет маршрутизация: Standard для повседневной работы, High для серьёзных задач, Max для самых сложных рассуждений.
Между превью и запуском одна деталь изменилась. В более раннем посте GitHub о research preview говорилось о «независимом критике только для чтения из другого семейства моделей» (GitHub blog). В changelog запуска сказано «другая модель проверяет его», а в документации — что несколько моделей критикуют параллельно, а их отзывы агрегируются. Мы читаем это так: этап критики вырос с одного рецензента до нескольких, но GitHub об этом не говорит, и changelog разницу не отмечает.
Доступно на всех планах, платите за каждую модель
Согласно changelog, Fusion доступен на всех планах Copilot в VS Code, приложении Copilot, Copilot CLI и IDE JetBrains, а другие клиенты появятся позже. Вы платите за каждую использованную модель по её стандартной ставке, отдельной платы за Fusion нет. Платные планы временно получают скидку 30% на стоимость моделей, и по документации она закончится позже в этом году (docs).
Два нестыковки. В документации Fusion сказано, что он «доступен на всех планах GitHub Copilot». А страница планов говорит, что на Free и Student доступ к моделям идёт только через автоматический выбор модели. GitHub эти два утверждения не согласует. В таблице уровней усилий по планам в документации доступность отмечена иконками, которые при нашем чтении превратились в пустые ячейки, поэтому какие уровни получают места Free и Student, мы сказать не можем. Проверьте свой список моделей. И поскольку High и Max могут вызывать несколько моделей, сама документация предупреждает, что задача может потратить больше AI-кредитов, чем на Standard. «Вдвое дешевле на задачу» — это утверждение про Max в сравнении с Claude Code, а не обещание про ваш баланс кредитов.
Бенчмарк: GitHub оценивает GitHub
Более ранний пост про HydraFusion откровеннее, чем материалы запуска. Тесты шли на одинаковом среднем уровне рассуждений для всех моделей, использовали оценочные затраты при общих допущениях о ценах и сравнивались с Opus 5 и GPT-5.6 Sol. GitHub также сообщает, что настраивал политику маршрутизации лучевым поиском (beam search) на тех же трёх бенчмарках, о которых отчитался (GitHub blog).
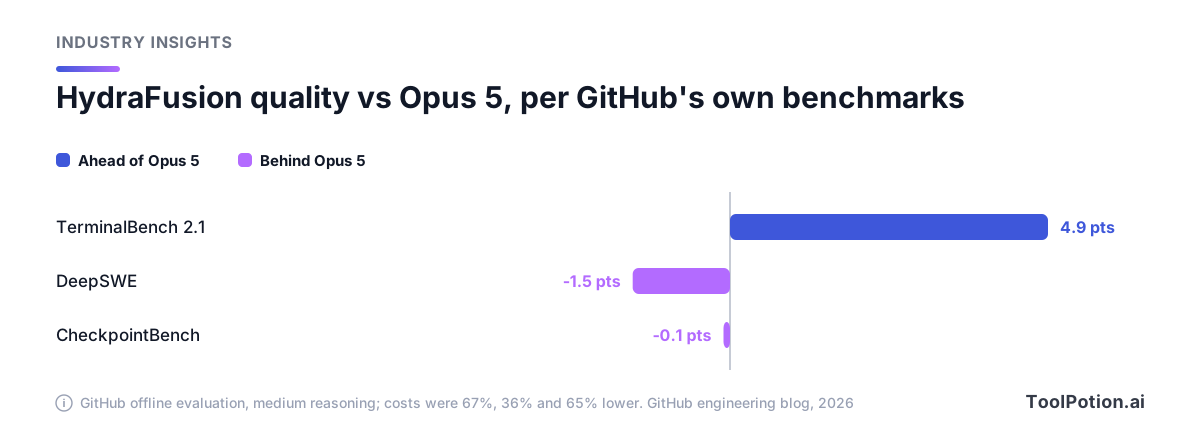
Посмотрите на форму результата. На одном бенчмарке прирост 4,9 пункта. На двух других небольшие потери, при этом затраты ниже на 36–67%. Это история про экономию при примерно том же качестве, и в тексте запуска в итоге сказано то же самое.
Разработчики на Hacker News сосредоточились на базовой модели для сравнения. Один комментатор написал, что «Opus 5 (на практике) — плохая база для сравнения» (HN). Другой усомнился в результате: «Чтобы обойти фронтирные модели на отдельных бенчмарках, много не нужно — достаточно поставить дополнительный софт между моделью и обвязкой» (HN). Пользователь Copilot CLI в той же ветке сказал, что авторежим «меняет модели только в начале сессии или после компактизации» (HN), а другой назвал автовыбор для себя «практически непригодным» (HN). Это мнения отдельных людей, а не исследования. Но они показывают, где сосредоточен скепсис.
Есть и расхождение в биллинге. Индекс и сравнение GitHub используют стоимость API по токенам. Разработчик на фиксированной подписке Claude Code этой цифры никогда не видит, поэтому «вдвое дешевле» для одиночки звучит иначе, чем для команды, которая считает расходы на API. Сама Artificial Analysis отмечает, что многие пользуются этими инструментами по подпискам, а не с оплатой за токены. Этот вывод — наше умозаключение, а не заявление GitHub, но он меняет представление о том, на кого рассчитан заголовок.
Единственный клиентский голос, который приводит GitHub, — Хари Покрел из AT&T, цитата из того же changelog: «Раньше разработчики часто выбирали более мощную модель для сложной задачи и забывали переключиться обратно для повседневных дел». Это честный аргумент в пользу Fusion: он не даёт оставлять дорогую модель включённой для рутины.
Ваша политика решает, кто читает ваш diff
Эту часть мы бы прочитали раньше бенчмарка. Fusion использует только модели, включённые в политиках вашего предприятия и организации. Администраторы могут отключать отдельные модели для Fusion, не отключая их везде, а модели, исключённые политиками резидентности данных или FedRAMP, не используются (docs).
Ревью второй моделью — главная ставка в этой конструкции, а в посте о превью сказано, что рецензент берётся из другого семейства моделей. Если это значит другой вендор, то он видит ваш diff, а это решение о работе с данными, которое кто-то в вашей команде должен принять осознанно. После ответа можно навести курсор на метку уровня усилий и увидеть, какие модели отработали.
Раздел об ограничениях тоже важен. Если Fusion отбрасывает черновик, правки файлов, которые этот черновик уже внёс, автоматически не откатываются, поэтому проверяйте diff перед коммитом. Кроме того, у Fusion нет собственного контекстного окна: показывается наименьшее среди его моделей.
Куда бы мы поставили его в пилоте для команды
Для команды на Copilot мы бы запускали Fusion Standard по умолчанию, а Max по умолчанию не включали. Его 60 баллов в независимом индексе — достойный результат, но Max вызывает больше всего моделей и тратит больше всего кредитов. Именно на Standard работает история AT&T и именно там маршрутизация экономит больше всего. Для команд, которые уже сидят на Claude Code или Codex, вопрос привязки к вендору стоит с другой стороны: эти инструменты привязаны к моделям одного вендора, а Fusion — это роутер, которым управляет GitHub и который он может перетасовать. Ни то ни другое не свободно от зависимости.
Наши прежние сравнения посвящены самим инструментам: терминальные кодинг-агенты, Cursor против Copilot и Windsurf, подбор уровня модели под задачу и более широкий список инструментов для кодинга. Fusion меняет в них колонку стоимости, но не тот инструмент, который вы бы выбрали. Для пользователей Cursor аналогичного вердикта пока нет, а рейтинг ToolRank по ИИ-ассистентам для кодинга — место, где можно посмотреть, как сейчас расставлены силы.
Тест, который всё решает, дешёвый. Возьмите десять реальных тикетов, прогоните их через Fusion Standard и через ваш текущий сетап и посчитайте принятые изменения и потраченные кредиты. Скидка GitHub закончится позже в этом году, так что измерьте всё до этого. Потом ещё раз загляните в раздел Router models на Artificial Analysis: записи роутеров там, скорее всего, будут двигаться.