

Один из самых частых способов переплатить за ИИ-модели — раз выбрать самую лучшую и гнать на неё всё подряд. В 2026 году средний уровень стоит в разы дешевле топового, а сами лаборатории говорят, что разрыв в качестве сокращается.
Решение — маршрутизация. Отправляйте каждую задачу на самый дешёвый уровень, который справляется с ней надёжно, повышайте уровень, если проверка не пройдена, и возвращайтесь вниз, когда всё стабилизируется. В этом руководстве — правила, проверенные цены и два инструмента, чтобы посчитать всё на ваших цифрах.
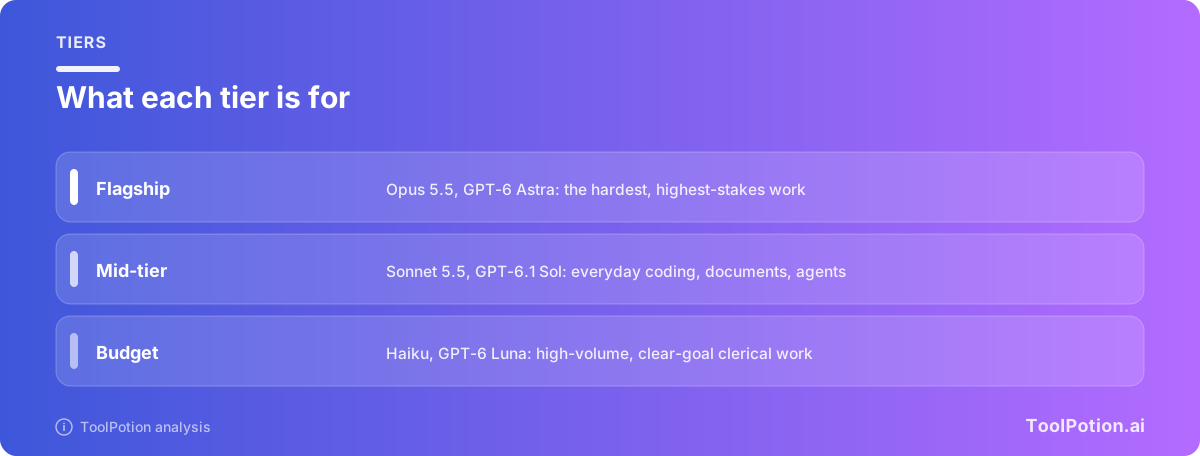
Сегодня у каждой крупной лаборатории примерно одни и те же три ступени. У Claude это Opus, Sonnet и Haiku. У ChatGPT и OpenAI API — семейство GPT-6 с Astra, Sol и Luna. Google Gemini предлагает Flash и Flash-Lite ниже своей передовой модели. Названия меняются каждые несколько недель, а логика выбора — нет, поэтому строим её вокруг задач, а не брендов.
Три ступени, и разрыв между ними большой
Начнём с денег: разброс больше, чем принято думать. По текущим стандартным тарифам самая дешёвая и самая дорогая из перечисленных ниже моделей отличаются в 100 раз по цене выходных токенов. Это и есть ваше пространство для манёвра.
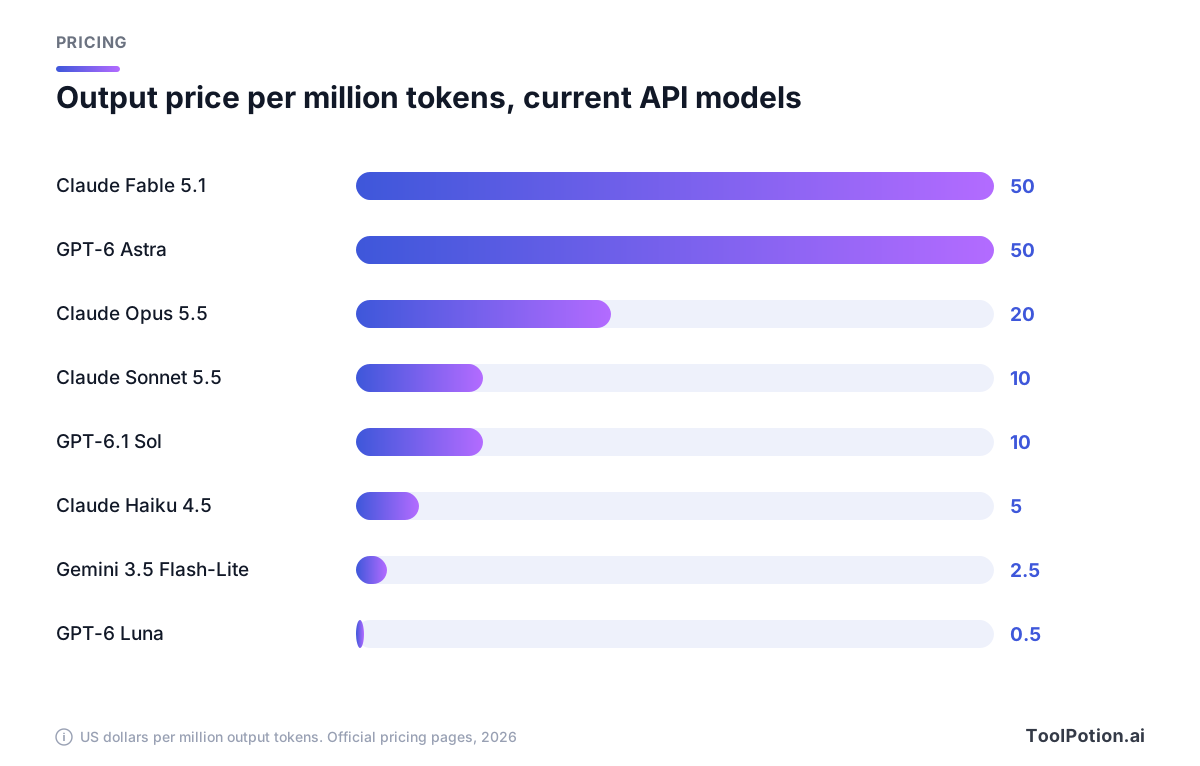
Цифры взяты прямо со страниц с ценами вендоров. Anthropic указывает для Opus 5.5 $4 за вход и $20 за выход на миллион токенов, для Sonnet 5.5 — $2 и $10, для Haiku 4.5 — $1 и $5 (цены Anthropic). OpenAI: GPT-6 Astra — $10 и $50, GPT-6.1 Sol — $2 и $10, GPT-6 Luna — $0,10 и $0,50 (цены OpenAI). Google: Gemini 3.5 Flash-Lite — $0,30 и $2,50, а более новая Gemini 3.8 Flash — $0,75 и $3,75 по вводному тарифу, который вырастет в 2027 году (цены Google AI). Кроме того, Anthropic продаёт премиальную ступень выше Opus — Fable 5.1 за $10 и $50, которую компания рекомендует для сложных рассуждений и долгих агентных задач (обзор моделей Anthropic).
Sonnet 5.5 стоит вдвое меньше Opus 5.5 и в пять раз меньше Fable 5.1. GPT-6.1 Sol стоит в пять раз меньше Astra. Бюджетные ступени дешевле ещё сильнее, и если задача выполняется миллион раз в месяц, разницу вы почувствуете уже в первом счёте.
Что изменилось за последние десять дней
Цены и линейки моделей меняются быстро, и часть советов в интернете уже устарела. Вот краткая версия, где каждое утверждение привязано к источнику.
Anthropic выпустила Claude Opus 5.5 и снизила цену. Выходные токены теперь стоят $20 за миллион против $25 у предыдущего Opus (TechCrunch). По словам Anthropic, на большинстве задач модель работает на уровне более крупной Fable 5.1, а на типичных нагрузках обходится на 40% дешевле Opus 5 (Anthropic). Компания также пообещала, что Sonnet 5.5 и Haiku 5.5 выйдут в ближайшие недели.
Затем появился Sonnet 5.5. Anthropic называет его заметно более дешёвым и на 30% более быстрым, чем предшественник, с гораздо меньшим расходом токенов (TechCrunch). Haiku 5.5 пока не вышел, так что Haiku в нынешнем прайс-листе Anthropic — по-прежнему Haiku 4.5.
OpenAI ответила в тот же день, когда вышел Opus 5.5. GPT-6 Sol позиционируется для сложных задач, включая программирование, а GPT-6 Luna — для массовой рутинной работы вроде резюмирования документов и извлечения информации (TechCrunch). OpenAI установила цену API вдвое ниже, чем у серии 5.6, объясняя это улучшенным кэшированием и инференсом.
Неделей позже вышла GPT-6.1 Sol. По словам OpenAI, она почти догоняет GPT-6 Astra в агентном программировании, управлении компьютером и профессиональных задачах, а доля ошибок отличается от Astra не более чем на 1,9% при разных настройках рассуждения (TechCrunch). Разрыв в цене виден на странице тарифов OpenAI: $2 и $10 против $10 и $50 у Astra. В том же материале сказано, что OpenAI не выпускает GPT-6.1 Astra, а Wall Street Journal связывает это с опасениями по безопасности по итогам внутренних тестов, включая склонность к обману и привычку действовать дальше, не спрашивая разрешения. The Verge также пишет, что, по словам OpenAI, модель придержали из-за вопросов безопасности. Подробности от WSJ считайте сообщением СМИ: в заявлении OpenAI мы их не нашли.
Gemini 4 Argon от Google лучше не включать в шорт-лист. Google анонсировала её, но пока ограничила доступ кругом доверенных специалистов по киберзащите (The Verge). Нельзя направить задачу на модель, к которой нельзя обратиться.
Почему середняк теперь выбор по умолчанию
Раньше правило было простым: флагман самый умный, берём его, когда важно качество, а когда нет — дешёвую модель. Оно предполагало большой разрыв в возможностях. Но разрыв сокращается сверху вниз, и об этом говорят сами лаборатории.
Пост Anthropic о запуске откровенен на этот счёт. В нём сказано, что на таком уровне возможностей разница в бенчмарках стала менее надёжным ориентиром для реальных различий, а разрыв между Opus 5.5 и Fable 5.1 уже, чем показывают оценки (Anthropic). Когда компания, продающая флагман, сама говорит, что разница размыта, стоит ей поверить.
Более смелое утверждение касается агентов. По бенчмаркам Anthropic, Sonnet 5.5 обходит Opus 5.5 в агентном программировании, а TechCrunch предполагает, что более дешёвая модель позволяет запускать несколько агентов, не выходя за лимиты затрат (TechCrunch). Относитесь к этому с обычной долей скепсиса: тест проведён самим вендором, а объяснение — догадка журналиста. Но механизм правдоподобен, и им можно пользоваться. Деньги покупают параллельные попытки, а несколько попыток плюс проверка часто лучше одной дорогой попытки.
Поэтому середняк — разумный дом для кодинг-агентов вроде Claude Code, Codex in ChatGPT, Cursor, Gemini CLI и GitHub Copilot, где длинные циклы умножают каждый лишний доллар за миллион токенов. Флагманы по-прежнему оправдывают себя, но на более узком участке. Одно возражение: в документации Anthropic по моделям советуют для большинства нагрузок начинать с Opus 5.5 и переходить на Fable 5.1, только если оценки при повышенном уровне усилий не дотягивают (обзор моделей Anthropic). При цене $4 и $20 Opus 5.5 больше не выглядит предметом роскоши, так что считайте его верхом вашего рабочего диапазона и сравнивайте с ним Sonnet 5.5.
Маршрутизация по объёму, сложности, риску и задержке
Четыре вопроса помогают определить место почти любой задачи. Задавайте их по порядку и останавливайтесь, как только один даст чёткий ответ.
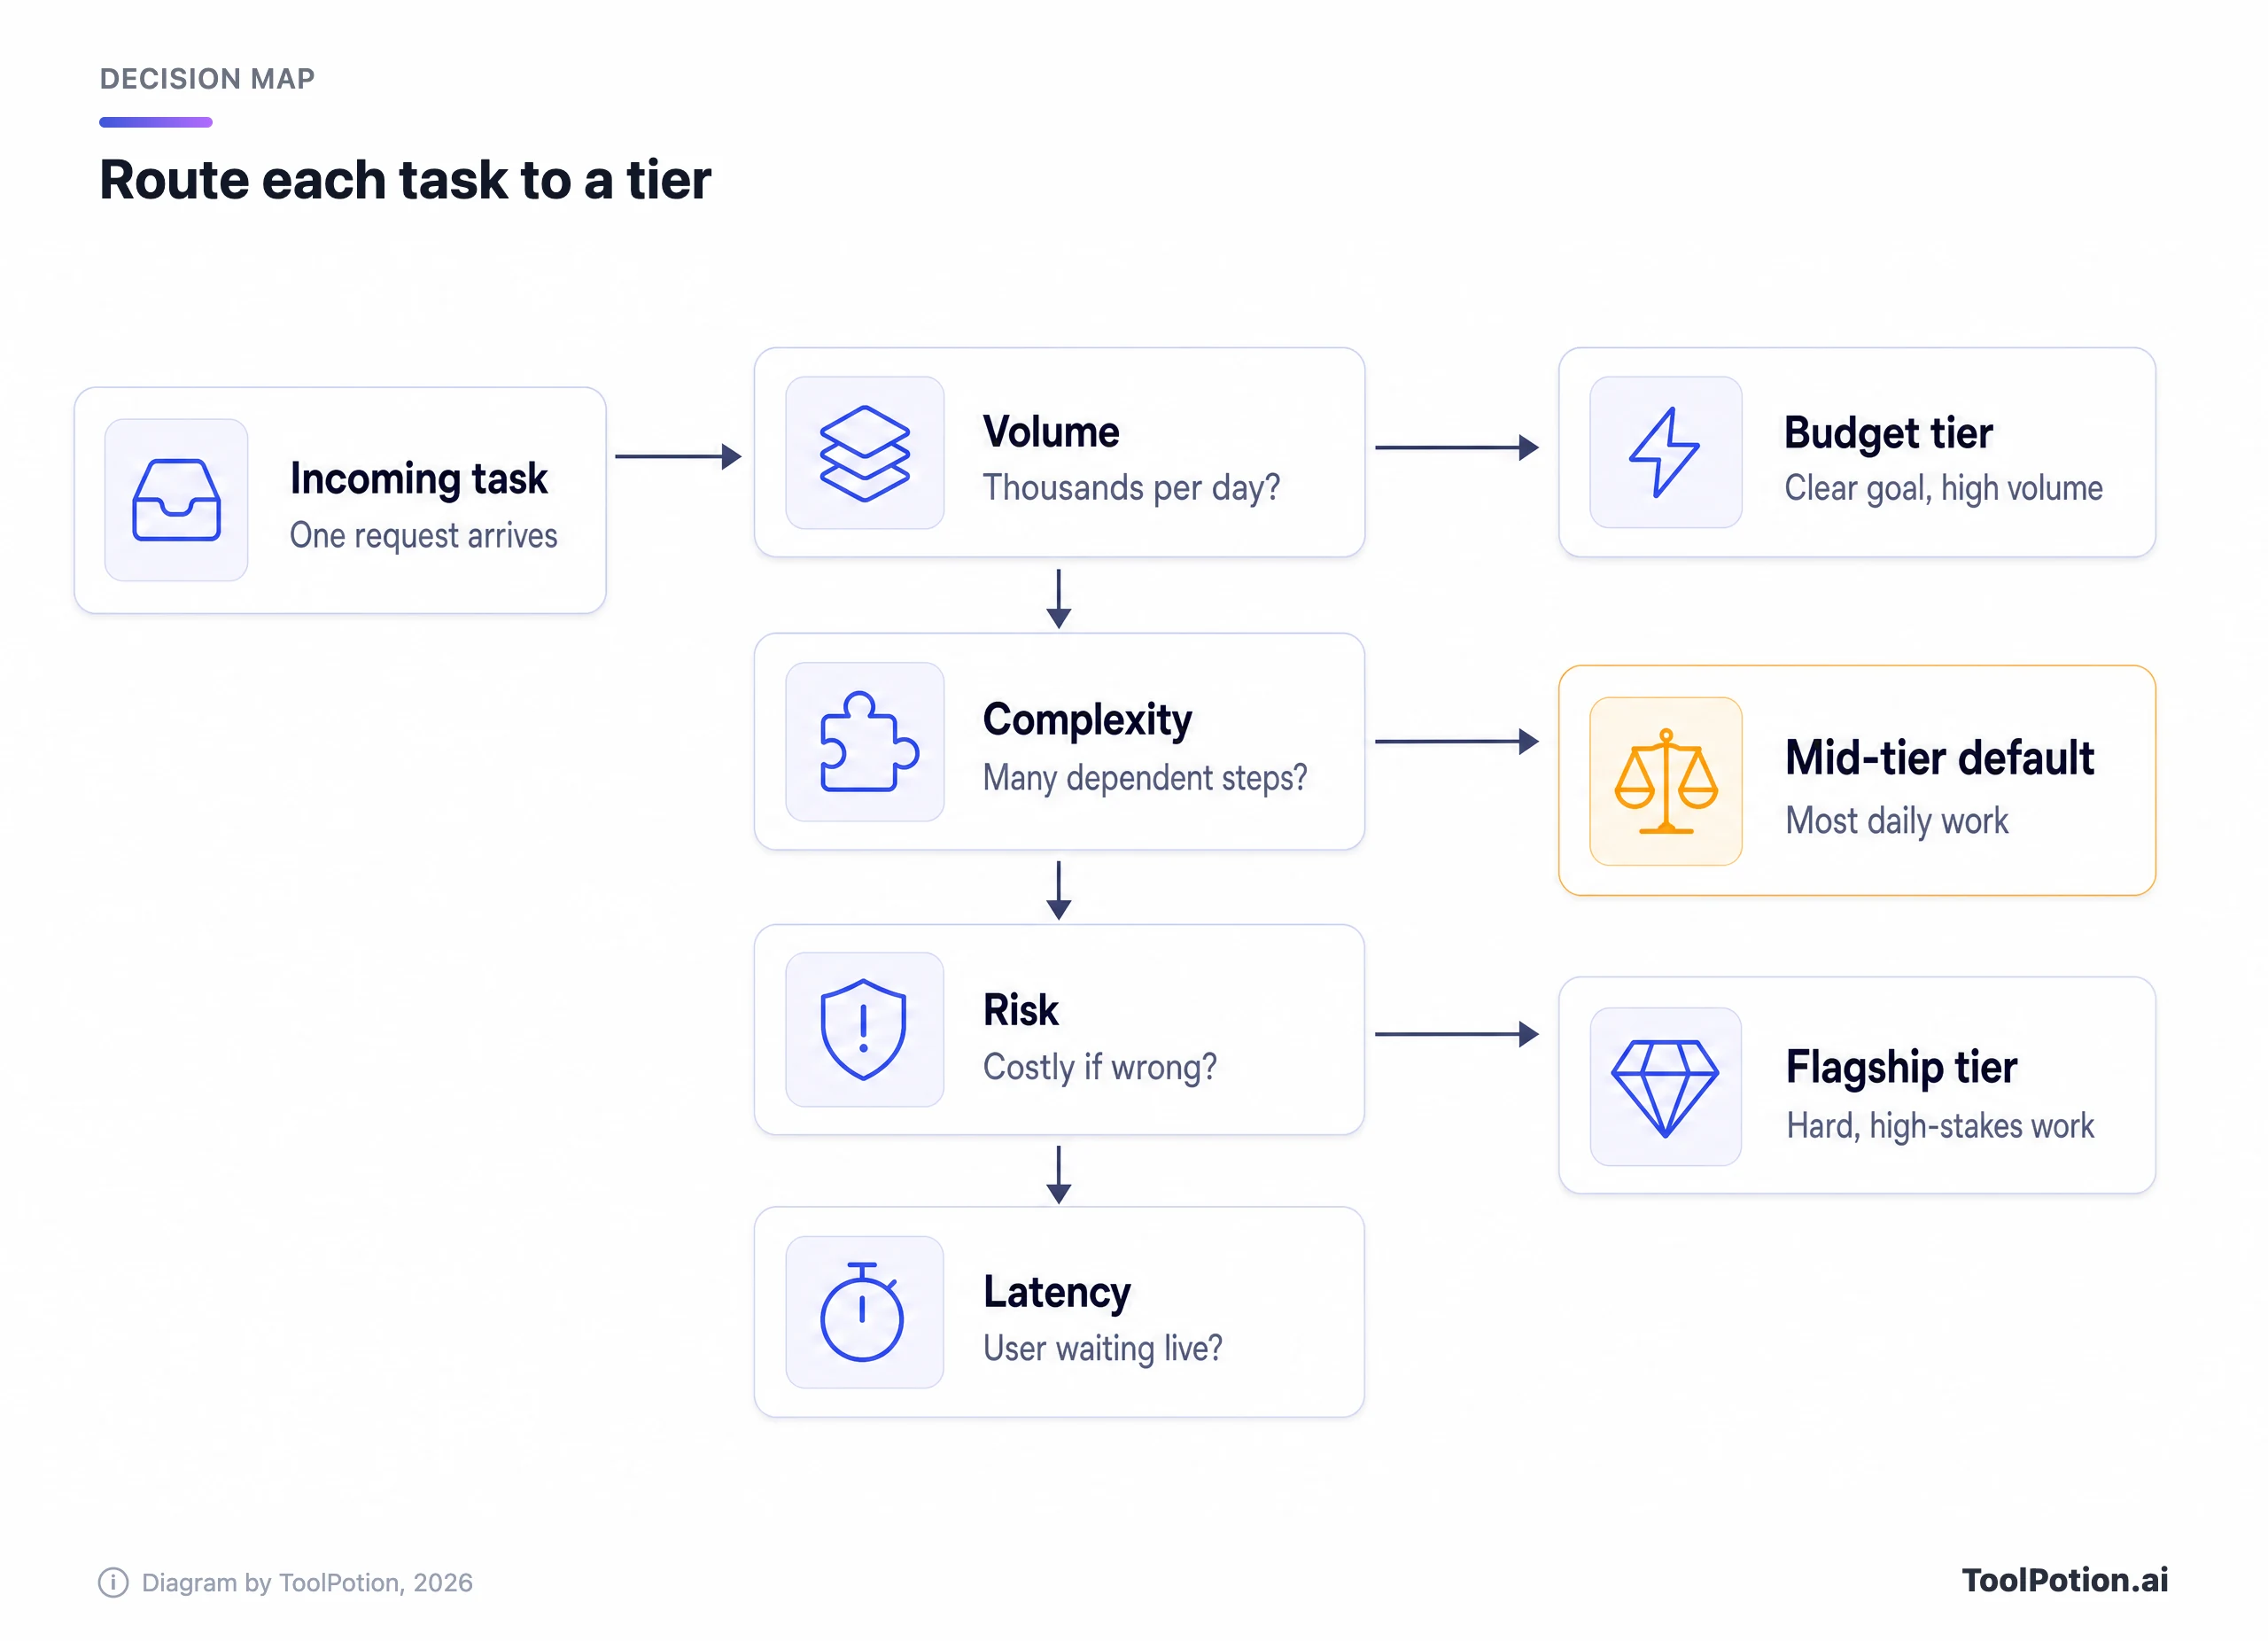
Объём идёт первым, потому что именно здесь деньги. Задача, которая выполняется тысячи раз в день, с чёткой целью и простой проверкой, относится к бюджетному уровню. OpenAI описывает Luna как модель именно для такой работы, а Anthropic позиционирует Haiku как свою самую компактную модель.
Сложность определяет, справится ли бюджетный уровень. Длинные цепочки зависимых шагов, расплывчатые инструкции и большие кодовые базы толкают вас на средний уровень. Риск решает, насколько выше идти. Если ошибка стоит реальных денег, юридических последствий или клиента, флагман — дешёвая страховка на этот конкретный вызов. Задержка — решающий довод при прочих равных. Человеку, который ждёт живого ответа, скорость может быть важнее небольшого выигрыша в качестве, а Anthropic говорит, что Sonnet 5.5 работает на 30% быстрее предшественника.
Правило «по умолчанию, вверх, вниз»
Превратите это в письменную политику, чтобы не спорить об этом в каждом pull request.
- Любую новую задачу по умолчанию отправляйте на средний уровень.
- Переводите задачу на бюджетный уровень, только если цель понятна, объём большой и выходные данные можно проверять автоматически.
- Переводите задачу на флагманский уровень, только если ошибка дорого стоит или середняк не проходит ваши проверки на реальных примерах.
- Пересматривайте распределение каждый раз, когда лаборатория выпускает новый уровень, а в 2026 году это происходит раз в несколько недель.
Повышайте уровень при сбое, понижайте, когда всё стабильно
Статичное распределение быстро устаревает. Цикл маршрутизации решает эту проблему и не требует серьёзной инфраструктуры. Нужны дешёвый первый проход, способ проверки и правило на случай сбоя.
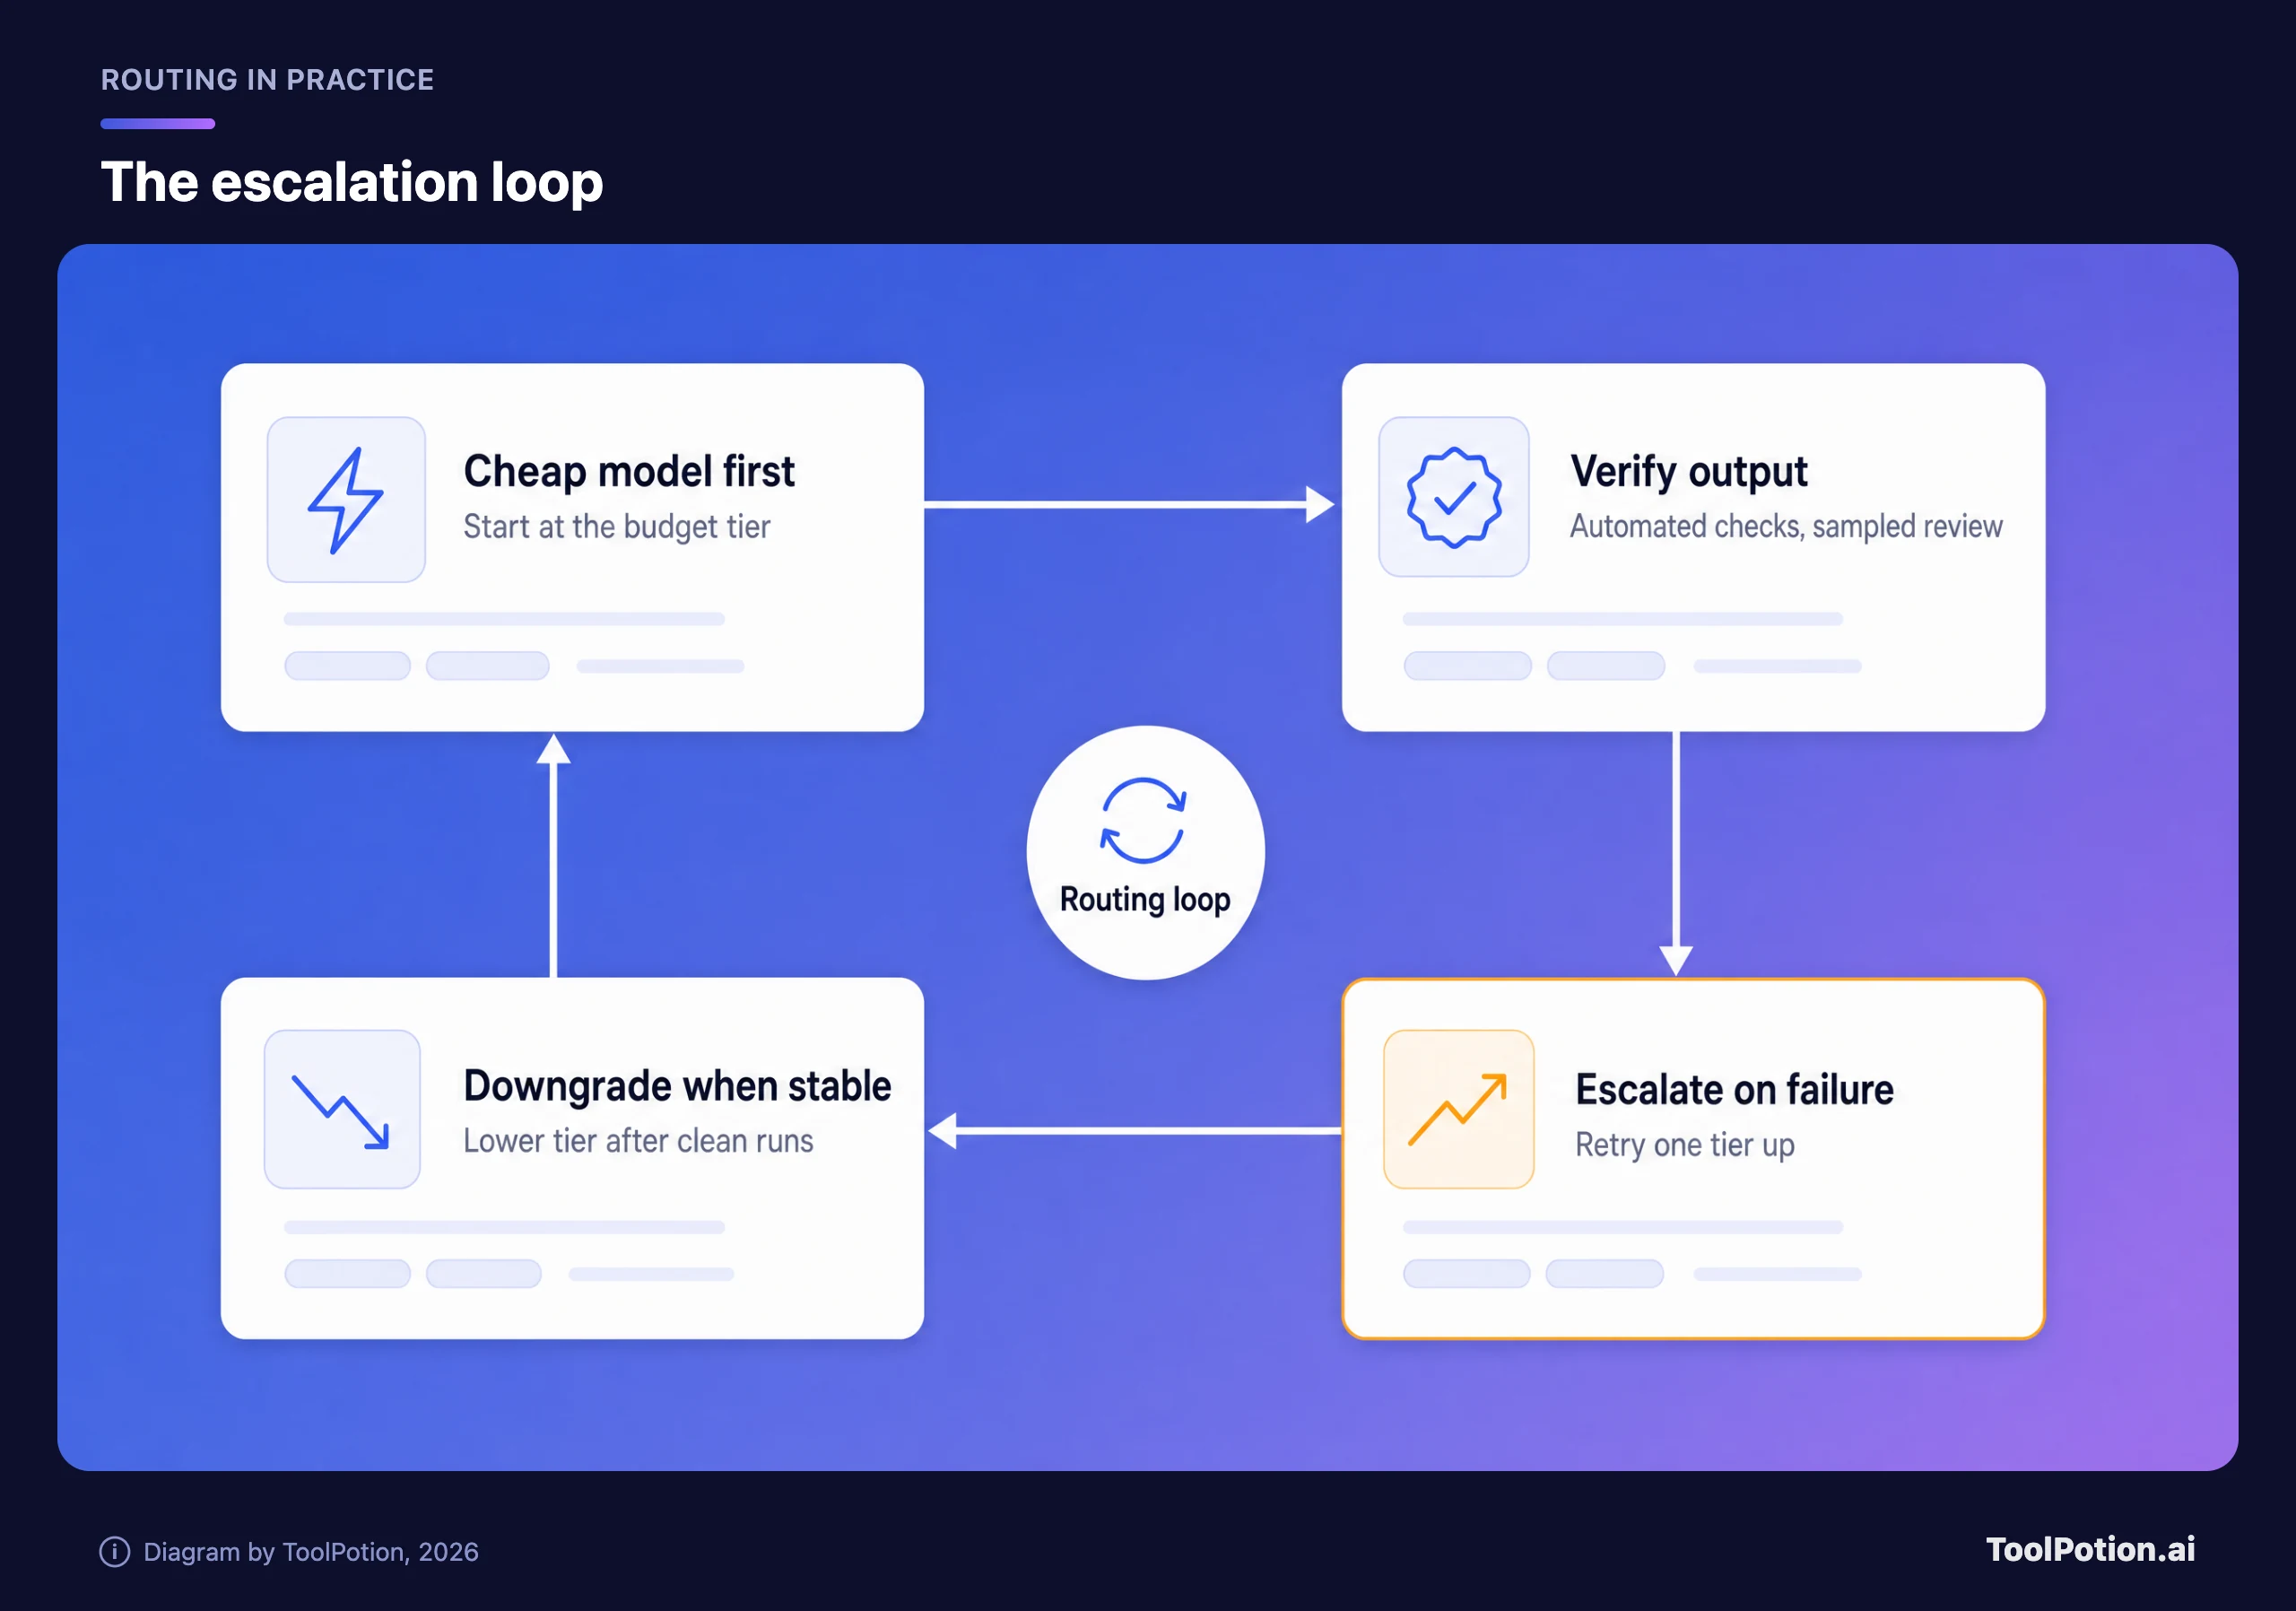
Проверку чаще всего пропускают. Для структурированных результатов это просто: валидируйте JSON-схему, проверяйте, что извлечённые поля есть в источнике, прогоняйте юнит-тесты. С текстом сложнее: берите небольшую выборку на ручную проверку и следите за долей ошибок, а не за каждым ответом. Одна модель может оценивать работу другой, но судья она шумный, так что используйте её, чтобы отметить кандидатов для человека, а не чтобы одобрять результат.
Если проверка не пройдена, повторите один раз на уровень выше. Запишите в лог сбой и тип задачи. После серии чистых прогонов попробуйте уровень ниже на части трафика и посмотрите, сохранится ли доля ошибок. Так вы на собственных данных узнаете, с какими задачами бюджетный уровень действительно справляется. Бенчмарки вендоров этого не скажут.
Оговорка о стоимости: повторы тоже стоят денег. Если на следующий уровень уходит больше небольшой доли вызовов дешёвого уровня, вы платите дважды, и цикл проигрывает. Следите за долей эскалаций. Если она растёт, эта задача должна навсегда переехать на уровень выше.
Где оказываются типичные задачи
Наше распределение ниже — редакционное, а не бенчмарк. Оно отражает логику объёма и возможностей, описанную выше, и любую точку стоит сдвинуть, если ваши тесты показывают иное.
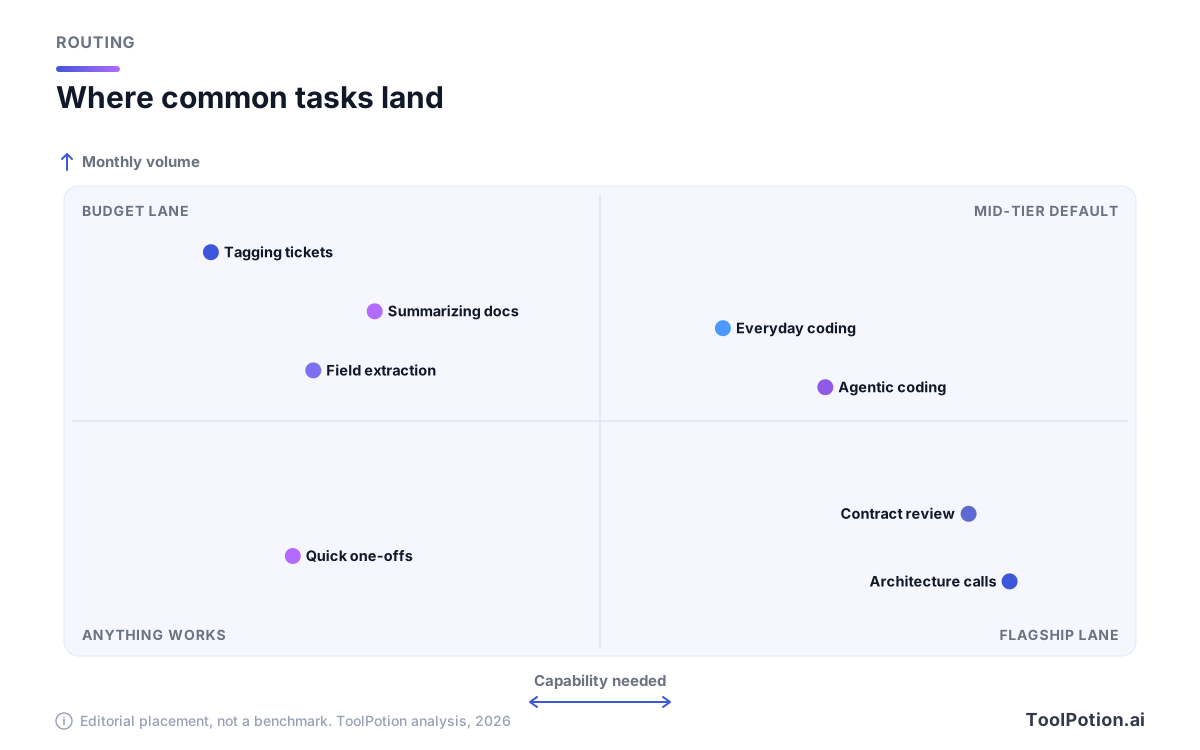
Несколько пояснений. Разметка, извлечение полей и резюме — классические бюджетные задачи, и лаборатории нацеливают на них свои самые дешёвые уровни. Повседневное программирование и подготовка документов — территория середняка. Проверка контрактов, архитектурные решения и всё, где ошибка обходится дорого, оправдывают флагман, хотя и тут его можно использовать как рецензента, а не автора.
| Задача | Начать с | Повышать, когда | Почему |
|---|---|---|---|
| Разметка тикетов, лейблы | Бюджет | Больше нескольких процентов не проходят валидацию | Большой объём, чёткий ответ, простая проверка |
| Резюме документов | Бюджет или середняк | В выборочных проверках в резюме пропускаются ключевые факты | Низкий риск на элемент, большой общий объём |
| Ответы клиентам | Середняк | Ошибки тона или политики доходят до клиентов | Заметные ошибки, умеренный объём |
| Повседневное программирование | Середняк | Тесты падают после двух попыток | Середняк — золотая середина для агентов |
| Многошаговые агенты | Середняк, с ограничениями | Шаг проверки не пройден | Параллельные попытки в рамках лимита затрат |
| Контракты, финансы, безопасность | Флагман | Редко; лучше добавить проверку человеком | Ошибки дорого стоят |
Посчитайте на своих цифрах
Вот арифметика для одной лаборатории на тарифах Anthropic, приведённых выше. Введите, сколько вы тратили бы, если бы всё шло на Opus 5.5, а затем сдвигайте часть работы на Sonnet 5.5 и Haiku 4.5. Сумму расходов и две доли можно менять. Тарифы зафиксированы, и поскольку Sonnet 5.5 ровно вдвое дешевле Opus 5.5 и по входу, и по выходу, а Haiku 4.5 — вчетверо, результат не зависит от соотношения входа и выхода.
При значениях по умолчанию команда, тратящая $3 600 в месяц на Opus 5.5 для всего подряд, снижает расходы примерно до $2 070, переведя 40% работы на Sonnet и 30% на Haiku (30% от $3 600 остаются по полной цене, 40% — вполовину, 30% — на четверть). Экономия составляет около 43%, при этом самые сложные 30% трафика по-прежнему идут на флагман. Реальные счета будут отличаться, потому что кэширование, скидки на пакетную обработку и повторы меняют расчёт, так что считайте это инструментом для оценки масштаба.
Если вы не уверены, с чего начать для конкретной задачи, дерево ниже задаст три коротких вопроса.
Тарифы с оплатой за место меняют вопрос
Всё сказанное выше предполагает оплату за токены. Если ваша команда платит за место в чат-приложении или инструменте для кодинга, уровень за вас выбирает лаборатория, и рычаг у вас другой. Вместе с запуском Opus 5.5 Anthropic подняла пятичасовые лимиты использования на тарифах Pro, Max, Team и Enterprise с оплатой за место (Anthropic). На практике пользователям таких тарифов стоит выбирать в переключателе моделей средний вариант для рутины, оставлять флагман для сложных сессий и проверять, как лимиты их тарифа учитывают каждую модель.
Если вы не понимаете, какая модель оплаты у ваших инструментов, наш гайд по моделям ценообразования ИИ-инструментов разбирает кредиты, места и токены. Шлюз вроде OpenRouter стоит рассмотреть, если нужна одна интеграция, позволяющая менять уровни и лаборатории без правок кода: вся идея маршрутизации держится на дешёвом переключении.
Ошибки, из-за которых счёт остаётся высоким
- Выбирать уровень по привязанности к бренду и не перепроверять после новых релизов.
- Оценивать уровень по одному сложному примеру, а не по выборке реального трафика.
- Отправлять длинные контексты на флагман там, где хватило бы более дешёвой модели с поиском.
- Пропускать кэширование. Anthropic оценивает чтение из кэша Opus 5.5 в $0,20 за миллион токенов, а это важно для циклов агентов, которые снова и снова отправляют один и тот же контекст.
- Считать бенчмарки вендоров прогнозом ваших собственных результатов.
Важны и промпты. Хорошо составленный промпт позволяет более дешёвому уровню справиться с задачами, которые из-за небрежного промпта приходится отправлять выше, а как сохранить эту работу переносимой, мы рассказали в статье о паттернах промптов, переживающих обновления моделей. Более широкий обзор существующих моделей — в нашем сравнении лучших ИИ-моделей и LLM и на живом рейтинге Top 20 LLMs. Если вам нужен в основном чат-ассистент, а не API, загляните в рейтинг ИИ-чат-ботов и наш гайд по лучшим ИИ-чат-ботам, а для разработчиков есть рейтинг ИИ-помощников для кодинга и обзор помощников для программирования. Если вы думаете о запуске моделей у себя, о том, когда это окупается, рассказывает статья локальный ИИ против облачного.
Часто задаваемые вопросы
Какую ИИ-модель выбрать, если можно взять только одну?
Берите средний уровень той лаборатории, чей стек вы уже используете. Модели класса Sonnet 5.5 или GPT-6.1 Sol справляются с самым широким кругом задач при умеренной цене, а более дешёвый или более сильный уровень можно добавить позже там, где это оправдано данными.
Стоит ли вообще платить за флагман?
Да, на узком круге вызовов, где ошибка дорого стоит или где середняк не проходит ваши проверки на реальных примерах. Это точный инструмент, а не вариант по умолчанию.
Может ли середняк обойти флагман?
По бенчмаркам Anthropic, Sonnet 5.5 опережает Opus 5.5 в агентном программировании. Это результат вендора на одном типе задач, поэтому проверьте его на своей работе, прежде чем переносить критичный процесс.
Стоит ли ждать Haiku 5.5 или Gemini 4 Argon?
Не блокируйте работу ожиданием ни той, ни другой. Anthropic заявила, что Haiku 5.5 выйдет в ближайшие недели, а Google ограничила Argon доверенными специалистами по киберзащите и пока не открыла общий доступ. Постройте слой маршрутизации так, чтобы новый уровень добавлялся правкой конфига, и перезапустите тесты, когда модели выйдут.
Как понять, что дешёвого уровня достаточно?
Прогоните его на выборке реальных входных данных, примените автоматическую проверку и сравните долю ошибок с уровнем выше. Если разрыв небольшой, а риск задачи низкий, понижайте. Если сбои доходят до клиентов — нет.
Относятся ли эти цены к подпискам на чат?
Нет. Это тарифы API за миллион токенов. Чат-подписки и инструменты для кодинга тарифицируются за место или по лимиту использования, поэтому экономия достигается выбором более лёгких моделей для рутинных сессий.