

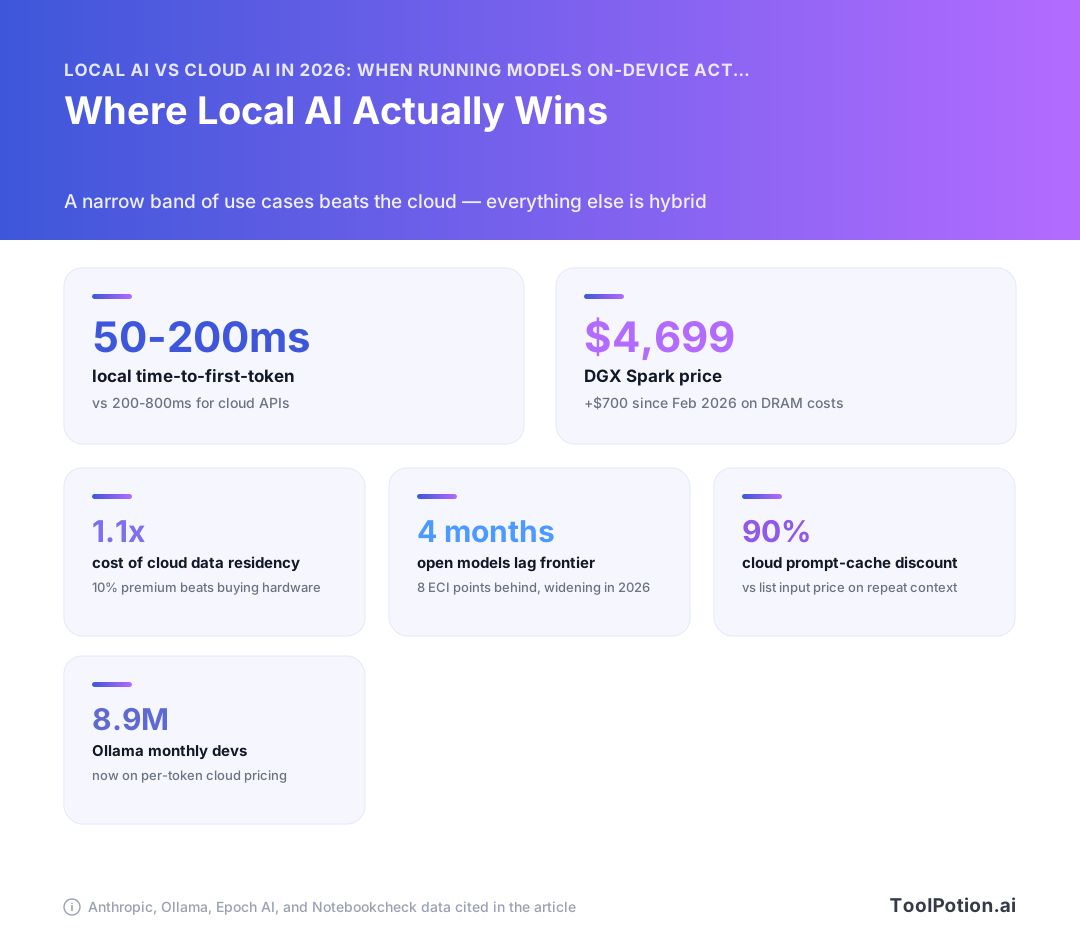
Покупай GPU, только если будешь держать его загруженным. Это короткий ответ на вопрос «локальный AI vs облачный AI в 2026»: при устойчивой суточной загрузке выше примерно 26% собственный стенд обходит оплату за токен. Ниже этой отметки ты финансируешь простаивающий кремний по ценам памяти 2026 года, а цены некрасивые: NVIDIA подняла DGX Spark с $3 999 до $4 699 в феврале 2026, сославшись на рост стоимости DRAM и хранилищ (Notebookcheck).
Тем временем облачная сторона подешевела так, как большинство сравнений не учитывают. Чтение из кеша промптов стоит 0,1× от базовой входной цены, и к этому добавляется ещё 50% скидка Batch API, доводящая Claude Haiku 4.5 до $0,50 вход / $2,50 выход за миллион токенов (Anthropic).
Вот как выглядит эта математика, что помещается в 24 ГБ и где пролегает граница для тебя.
Локальный AI vs облачный AI: сценарий 2026 сломался в четырёх местах
Математика точки безубыточности, которую ты читал, неверна — и не из-за ошибки округления. Она неверна потому, что железо подорожало, метрика возможностей была неправильно прочитана, инструментарий сменил стороны, а облачный прайс-лист тихо упал у всех под ногами.
Три допущения, на которых строится каждое сравнение
Почти каждый гайд «локальный vs облако» на первой странице результатов опирается на одни и те же три утверждения — все они датируются 2024 годом. Первое: железо — это фиксированная, падающая стоимость, поэтому ты амортизируешь GPU за $1 999 на 18 месяцев и сравниваешь с расходами на токены. Второе: open-weight модели отстают от закрытых фронтирных моделей на три-шесть месяцев, так что то, что ты запускаешь дома, — это пара кварталов назад. Третье: «локально» означает Ollama на твоей машине, а «облако» — фронтирный API; чистая дуэль двух сторон.
Все три были разумны в 2024 году. Ни одно не выживает при столкновении с 2026-м.
Что изменилось с 2024 по сегодняшний день
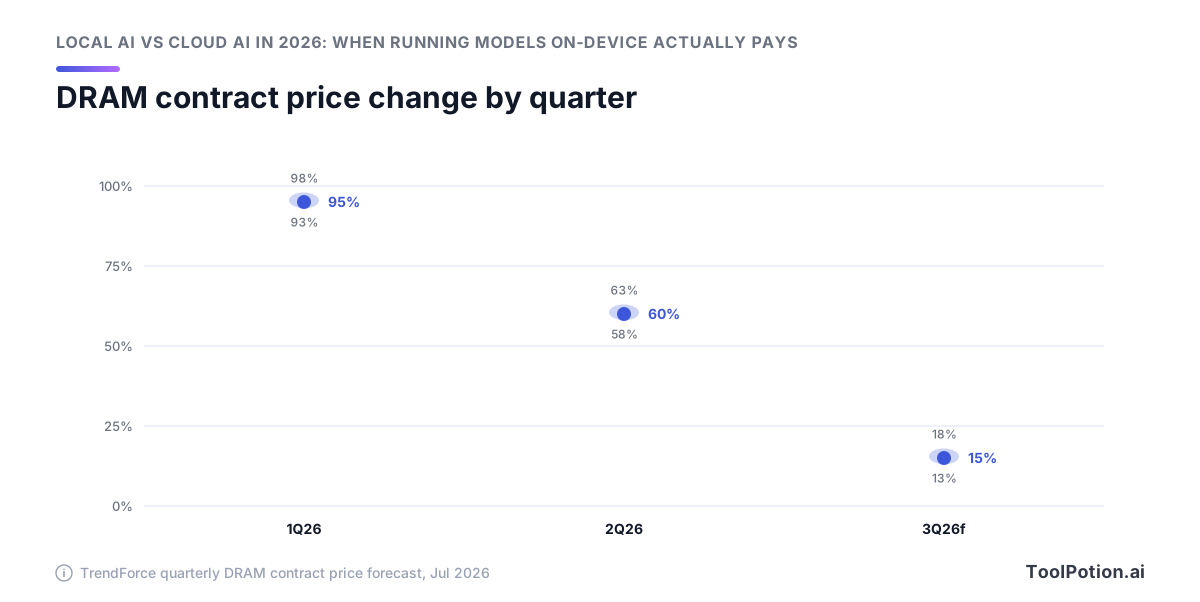
Начнём с ценового дна по железу, потому что оно сдвинулось в неправильном направлении. NVIDIA подняла DGX Spark с $3 999 до $4 699 в феврале 2026 — повышение на $700, которое компания объяснила стремительным ростом стоимости DRAM и хранилищ. Контрактные цены на обычную DRAM выросли примерно на 93–98% квартал к кварталу в 1К26 и продолжают расти на 13–18% в 3К26. Любой калькулятор, использующий MSRP, занижает твои капзатраты на четыре порядка.
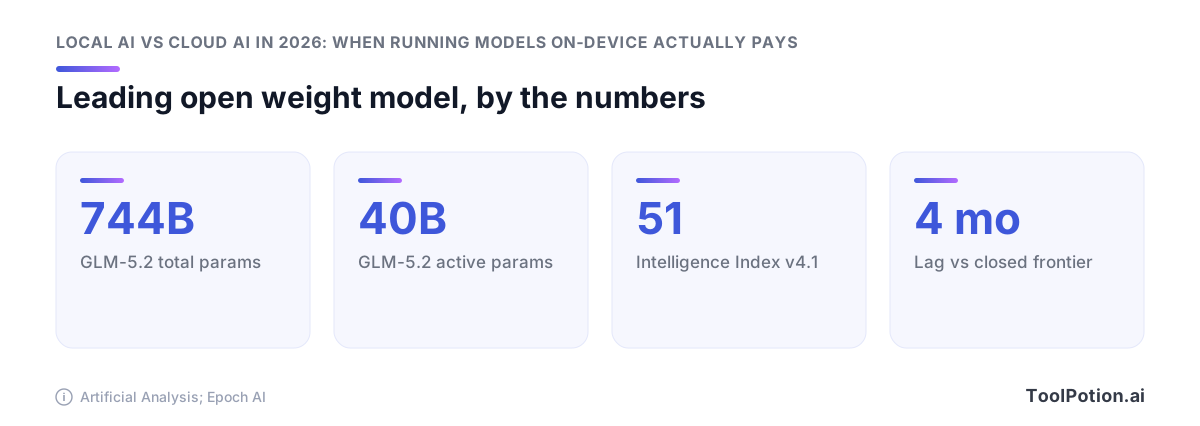
Затем — разрыв в возможностях. Epoch AI оценивает отставание в 4 месяца, или 8 очков ECI с января 2026, что шире среднего значения в 3 месяца, измеренного с января 2023 по октябрь 2025. Момент, который никто не цитирует: модель, несущая это утверждение, GLM-5.2, имеет 744B параметров всего и 40B активных. Это стойка, а не ноутбук.
Третий разрыв — самый странный. 31 августа 2026 года Ollama перевёл планы Pro, Max и Team на поотоконное облачное ценообразование за $20, $100 и $500 в месяц. Инструмент, который учил поколение разработчиков запускать модели локально, теперь продаёт тебе токены. Это превращает сравнение в трёхстороннее соревнование: твой GPU, дешёвые облачные open-weight'ы и фронтирные API. Если ты оцениваешь варианты среди AI-моделей, которые мы отслеживаем, именно средний вариант стоит рассчитать первым.
И облачная сторона подешевела так, как ни один опубликованный калькулятор не учитывает: чтение из кеша промптов — 0,1× от базовой входной цены, плюс 50% скидка Batch API поверх этого, плюс фиксация вывода только в США за множитель 1,1×. Последний пункт продаёт тебе свойство защиты данных, ради которого люди покупают железо, — за 10% надбавки вместо $4 699.
Что локальные модели реально умеют в 2026 году
Карта в 24 ГБ в 2026 году тянет хорошую модель класса MoE 20–30B, и эта модель будет составлять тексты, резюмировать, классифицировать и рассуждать над структурированными задачами на уровне, который большинство команд считает приемлемым. Она также будет уверенно выдумывать факты обо всём, что выходит за пределы обучающих данных. Эти два предложения — вся карта возможностей, и большинство гайдов по точке безубыточности пропускают второе.
Потолок потребительского железа — класс MoE 20–30B
gpt-oss-20b и Qwen3-30B-A3B — практический потолок для одного потребительского GPU. Обе — разреженные MoE-архитектуры, поэтому количество активных параметров остаётся достаточно малым, чтобы карта в 24 ГБ удержала веса и ещё имела место для контекста. Ниже идут плотные модели Llama, Mistral и Phi класса 7–14B: они помещаются комфортнее и теряют в возможностях в обмен на это. Наши листинги open-weight LLM сильно перекошены в сторону этого диапазона — потому что именно это люди могут запустить дома.
Сильны в рассуждениях, слабы в знаниях о мире
Дай локальной модели 30B документ и попроси извлечь поля, следовать схеме или пройти цепочку шагов — она справится. Спроси, кто кого поглотил в 2024 году — получишь правдоподобную выдумку.
Количество параметров — это то, что покупает запомненные факты, а модель потребительского размера большую часть этих параметров выбросила. Retrieval закрывает разрыв: вложи факты в контекст и позволь локальной модели делать структурированную часть. Всё, что требует широкого воспроизведения без retrieval-слоя, принадлежит фронтирному API.
Почему заголовок «open-модели догоняют» — это про железо, которого у тебя нет
Epoch AI оценивает разрыв в 4 месяца, или 8 очков ECI, с января 2026, немного шире среднего в 3 месяца, измеренного с января 2023 по октябрь 2025 (Epoch AI). Цифра корректна, но ничего не говорит о твоём ноутбуке. Модель, носящая корону open-weight, GLM-5.2, набирает 51 балл на Intelligence Index v4.1 от Artificial Analysis при 744B параметров всего и 40B активных (Artificial Analysis). Это дата-центровое железо. То же измерение показывает, что GLM-5.2 сжигает 43 000 выходных токенов на задачу, 37 000 из них — токены рассуждений, что даёт около $0,46 за задачу против $0,18 для MiniMax-M3.
Что стоит квантизация
Q4_K_M — это дефолт не без причины. На Mistral-7B-Instruct-v0.2 в llama.cpp на Apple M1 Pro он уменьшил модель с 7,2 ГБ до 4,1 ГБ, то есть на 43,1%, при потере перплексии в 0,51% (dasroot). Q2_K — это место, где кривая ломается: потеря перплексии 7,94%, и ты это чувствуешь в следовании инструкциям задолго до того, как увидишь в бенчмарке. Квантизируй до 4 бит, остановись там и потрать сэкономленную память на длину контекста.
Ценовое дно по железу сдвинулось — и не в ту сторону
Каждый калькулятор точки безубыточности, который ты найдёшь, исходит из того, что ты можешь купить устройство по прейскуранту. В 2026 году это в основном невозможно, а сам прейскурант вырос.
Кризис памяти — в ценах, которые можно проверить
Контрактные цены на обычную DRAM выросли примерно на 93–98% квартал к кварталу в 1К26, ещё на 58–63% во 2К26, и TrendForce прогнозирует ещё 13–18% в 3К26 (TrendForce). Это замедление, но не снижение. Цены всё ещё растут от базы, которая уже удвоилась. Спрос идёт не от тебя: дата-центры поглощают до 70% мирового производства памяти в 2026 году против примерно 20–30% в 2022-м, а HBM в одиночку занимает 23% пластин DRAM в этом году против 8% в 2024-м (IDC). Локальный вывод — это покупка ёмкости памяти в конкуренции с теми, кто строит облака, которых ты пытаешься избежать.
DGX Spark, RTX 5090 и разрыв между MSRP и уличной ценой
NVIDIA подняла DGX Spark с $3 999 до $4 699 в феврале 2026 — повышение на $700, которое компания объяснила стремительным ростом стоимости DRAM и хранилищ (Notebookcheck). Его 128 ГБ LPDDR5X — единственная причина, по которой он интересен для локальных моделей, и именно она делает его цену зависимой от товарного рынка, которым ты не управляешь.
Воспринимай любой MSRP 2025 года, который тебе цитируют в сравнительных статьях, как выдумку. Проверь, за сколько продаётся эта позиция на этой неделе, и только потом считай математику на основе этой цифры.
Электричество — статья расходов, о которой все забывают
GPU — это разовая покупка, которая присылает тебе счёт каждый месяц. Средняя цена электроэнергии для жилого сектора США составила 18,34 ¢/кВт·ч в июне 2026 года, что на 5,0% выше год к году, при разбросе от 8,96¢ в Нью-Мексико до 28,50¢ в Калифорнии (EIA). Одна и та же установка имеет эксплуатационную стоимость, которая варьируется более чем в 3 раза в зависимости от места подключения. Если ты в Калифорнии, электричество одно может соперничать со стоимостью эквивалентных облачных токенов. В Нью-Мексико расчёт достаточно другой, чтобы изменить ответ.
Во сколько обходится нормальный стенд в 2026 году
Бюджетируй устройство по текущей уличной цене, добавь потребление мощности по твоему фактическому тарифу на электроэнергию и добавь часы, которые ты потратишь на фреймворки локального вывода и настройку квантизации — то, чего облачный эндпоинт от тебя не требует. Цифра CapEx в четыре знака с ежегодным хвостом OpEx в три знака — это честная отправная точка, и обе части ухудшились в этом году по причинам, не связанным с качеством моделей.
Ollama vs облачный API: сравнение теперь трёхстороннее
Сейчас важны три цены: GPU, который ты покупаешь, облачные open-weight'ы в хостинге и фронтирный API. Средний вариант выигрывает для большинства нагрузок, и именно его почти ни одна опубликованная формула безубыточности не включает.
Сам Ollama стал облачным API 31 августа 2026 года
Инструмент, который научил целое поколение разработчиков запускать модели на своих машинах, теперь продаёт токены. 31 августа 2026 года Ollama перевёл планы Pro, Max и Team на поотоконное облачное ценообразование: $20/мес, включая $60 использования; $100/мес, включая $300; и $500/мес, включая $1 000 для неограниченного числа пользователей — без хранения данных, с хостингом в США и Европе (Ollama). Так что «Ollama vs облако» больше не описывает реальный выбор.
Облачные open-weight'ы: средний вариант, который никто не считает
| Модель | Вход / выход за млн токенов | Источник |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
Читай мелкий шрифт, прежде чем строить прогноз на этих цифрах. Большинство тарифов Ollama Cloud удваиваются с 12:00 до 18:00 UTC по будням (Ollama), что превращает твой счёт в вопрос планирования. Перенеси массовые задачи на ночь и выходные — сохранишь заявленный тариф. Запускай интерактивный продукт для европейских пользователей во второй половине дня — будешь платить удвоенный тариф каждый рабочий день. Эта переменная времени стоит бо́льшего внимания, чем выбор между двумя схожими по цене хостинг-провайдерами.
Фронтирные API дешевле, чем подсказывает прейскурант
Чтение из кеша тарифицируется по 0,1× от базовой входной цены, Batch API снижает и вход, и выход на 50%, и обе скидки суммируются (Anthropic). Пакетная Haiku 4.5 выходит в $0,50 за вход и $2,50 за выход на миллион токенов, а Sonnet 5 сохранила вводную цену $2/$10 вместо запланированного перехода на $3/$15 с 1 сентября 2026 года (Anthropic). Асинхронная массовая работа — это именно то, под что рекламируют локальные стенды, и именно та нагрузка, где облачные скидки кусают сильнее всего.
Сноска о токенизаторе, которая работает в обратную сторону
Claude 4.7 и более поздние версии используют новый токенизатор, производящий примерно на 30% больше токенов для того же текста (Anthropic). Реальный счёт Sonnet 5 на фиксированном корпусе будет примерно на 30% выше, чем подразумевает ставка $2/$10, если сравнивать с локальной моделью со старым токенизатором. Посчитай токены на своём тексте обоими способами, прежде чем делать выводы.
Считаем точку пересечения: при каком объёме твой GPU выигрывает?
Собственное железо начинает обходить облачные open-weight'ы где-то около 26% устойчивой суточной загрузки GPU — примерно шесть часов реальной работы каждый день, с амортизацией по ценам железа 2026 года и твоему местному тарифу на электроэнергию. Ниже этой отметки карта простаивает, пока тикает счётчик амортизации. Оцени свой объём против облачного тарифа, прежде чем покупать: deepseek-v4-flash стоит $0,22 за вход и $0,66 за выход на миллион токенов в Ollama Cloud (Ollama).
Где локальный AI выигрывает (короткий, конкретный список)
Четыре случая выдерживают проверку. Всё остальное — гибридная схема, где простые запросы идут к локальной модели, а остальные эскалируются.
Устойчивая высокообъёмная пакетная работа, которая держит карту занятой
Если твой GPU простаивает 90% дня, ты купил обогреватель. Кейс покупки требует, чтобы карта работала более четверти дня каждый день и выдерживала сравнение с Claude Batch API, который снижает входные и выходные токены на 50% и суммируется с кешированием промптов (Anthropic). Это ставит пакетную Haiku 4.5 на $0,50 за миллион входных токенов и $2,50 за выходные. Твой локальный стенд должен побить это с учётом амортизированного железа плюс электричество — а при среднем тарифе 18,34 ¢/кВт·ч для жилого сектора США в июне 2026 года (EIA) карта под реальной нагрузкой тоже не бесплатна. Считай математику на своём реальном объёме токенов, а не на спецификации.
Жёсткий суверенитет данных, CLOUD Act, а не только GDPR
Это реальная категория, и она уже, чем большинство людей утверждает. Соответствие GDPR — это вопрос контракта. Требование о том, что ни одна структура под юрисдикцией США не может быть принуждена предоставить твои данные, — это физическая задача, а физические задачи решаются с помощью железа, которым ты управляешь.
Интерактивные циклы, где время до первого токена — это продукт
Локальный вывод обеспечивает 50–200 мс до первого токена против 200–800 мс для облака, при этом Claude Haiku 4.5 измерен на 597 мс, а GPT-4.1 Mini — около 2 400 мс (Eden AI). В окне чата этого никто не заметит. Для автодополнения кода или многошагового агента, выполняющего восемь вызовов подряд, эта разница накапливается во что-то ощутимое. Если ты строишь именно такое, посмотри AI-агентов в нашем каталоге и проверь, сколько из них делают один круговой запрос на нажатие клавиши.
Офлайн и изолированная работа без сети
Тут нечего обсуждать. Либо сеть есть, либо её нет.
Аргумент конфиденциальности, который облако теперь продаёт тебе само
Самый сильный контраргумент ко второму кейсу: Anthropic продаст тебе это свойство напрямую. На Claude 4.6 и выше фиксация вывода только в США с помощью inference_geo: "us" обходится в множитель 1,1× по всем категориям токенов (Anthropic). Это 10% надбавки вместо $4 699 за DGX Spark. Платные планы Ollama, в свою очередь, декларируют нулевое хранение данных с хостингом в США и Европе начиная с 31 августа 2026 года (Ollama). Если твоё требование к конфиденциальности удовлетворяется договорной гарантией и географической фиксацией, у тебя нет требования к железу.
Гибридная схема, на которой оседает большинство практиков
Маршрутизируй по сложности, а не по принципу. Модель MoE 20–30B на твоей карте обрабатывает примерно семь из десяти запросов в типичной нагрузке ассистента или обработки документов, а оставшиеся три идут во фронтирный API. Это и есть архитектура. Всё остальное — настройка.
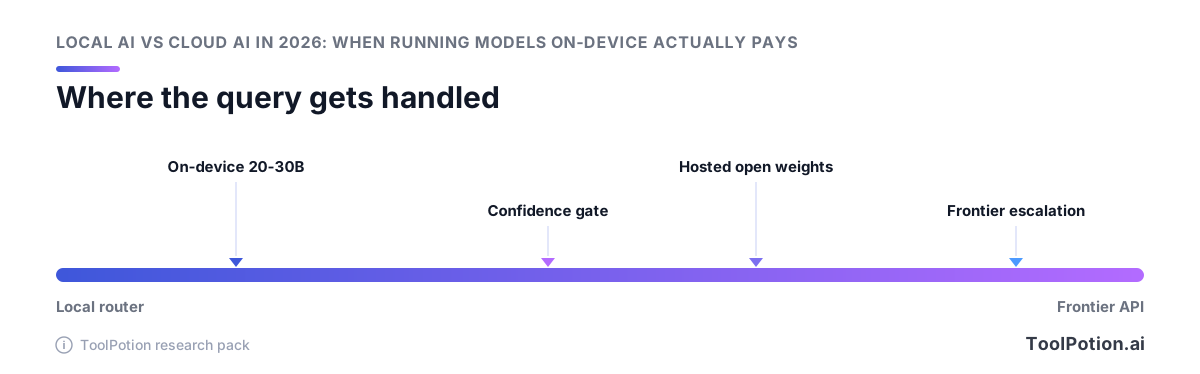
Три сигнала определяют эскалацию, и все три можно вычислить ещё до того, как локальная модель завершит ответ: уверенность самой модели (маржа log-prob или дешёвая самопроверка), нужны ли запросу знания о мире, которых у локальных весов нет, и длина контекста. Знаниевый сигнал ловит большинство сбоев. Модель класса 24 ГБ хорошо рассуждает и плохо вспоминает, поэтому всё, что звучит как «кто кого поглотил в 2025 году», должно полностью пропускать локальный слой.
Конкретный стек, который работает
Ollama или LM Studio спереди, один фронтирный API сзади и тонкий роутер между ними, который логирует каждое решение.
Направляй эскалированный трафик сначала к Claude Haiku 4.5 по $1/млн вход и $5/млн выход, и переходи к Sonnet 5 по $2/$10 только тогда, когда ответ Haiku не прошёл проверку (Anthropic pricing). Если эскалированная работа асинхронна — пакетируй её: Batch API делит обе стороны пополам, так что Haiku выходит в $0,50/$2,50. Большинство команд пропускают этот шаг и платят по прейскуранту за работу, которая могла бы подождать двадцать минут.
Замеряй частоту эскалации, иначе летишь вслепую
Логируй четыре числа по каждому запросу: какой уровень его обслужил, уверенность локальной модели, количество токенов и повторял ли человек запрос. Частота повторов — это твой реальный сигнал качества. Если эскалация ниже примерно 20%, локальная модель отвечает на то, на что не должна, — ты увидишь это в повторах. Выше 45% — и GPU не отрабатывает свою амортизацию.
Почему граница сдвигается каждый квартал
Цены с обеих сторон меняются быстрее, чем твоя архитектура. Ollama перевёл Pro, Max и Team на поотоконный облачный тариф 31 августа 2026 года (Ollama), тарифы Ollama Cloud удваиваются с 12:00 до 18:00 UTC по будням (Ollama pricing), а возможности open-weight'ов отстают от закрытых фронтирных моделей примерно на 4 месяца в среднем с января 2026 года (Epoch AI). Пересчитывай пороги маршрутизации по актуальным числам раз в квартал. Внеси это в календарь.
Инструментальный слой достаточно стабилен, чтобы на нём строить
Ollama охватывает 8,9 миллиона активных разработчиков в месяц при команде из 14 человек, присутствует в 85% компаний Fortune 500 и привлёк $65 млн под руководством Theory Ventures в июле 2026 года (TechCrunch). Это не проект, который исчезнет в следующем году. Связующий код роутера вокруг него — та часть, которую ты контролируешь, и большую часть его можно позаимствовать из open-source AI-репозиториев, уже публикующих этот паттерн.
Реши за пять вопросов
Отвечай по порядку. Первый вопрос, давший тебе однозначное «да», определяет твою схему — и на нём можно остановиться.
Есть ли у тебя жёсткое требование суверенитета данных?
Жёсткое означает: air-gap, задокументированный юридическим отделом риск CLOUD Act или контракт, в котором прописана конкретная машина. Если это твой случай — купи железо и прекрати читать раздел про затраты. Если требование мягче, Anthropic зафиксирует вывод только в США с помощью inference_geo: "us" на Claude 4.6 и выше за множитель 1,1× по всем категориям токенов (Anthropic pricing docs), а платные планы Ollama обеспечивают нулевое хранение данных в США и Европе (Ollama). 10% надбавки лучше $4 699 железа для почти всех.
Твоя нагрузка ограничена латентностью или пропускной способностью?
Интерактивные циклы, где человек ждёт каждого токена, предпочитают локальный вариант: 50–200 мс до первого токена против 200–800 мс для облака, при этом Claude Haiku 4.5 измерен на 597 мс (Eden AI). Работа на пропускную способность — наоборот. Пакетируй и бери 50% скидку, что даёт Haiku 4.5 по $0,50/млн вход и $2,50 выход (Anthropic).
GPU будет занят более четверти каждого дня?
Ниже этой отметки карта амортизируется в простое, и облачные open-weight'ы выигрывают по стоимости. Выше — локальная математика начинает работать. Будь честен со знаменателем: ночи и выходные тоже считаются.
Твоя задача требует знаний о мире или только рассуждений?
Рассуждения над текстом, который ты предоставляешь, нормально работают на модели MoE 20–30B. Вопросы, зависящие от фактов, которые модель уже должна знать, относятся к фронтирному API или к облачному GLM-5.2, имеющему 744B параметров всего и никогда не помещающемуся на твой ноутбук (Artificial Analysis).
Ты готов перенастраиваться каждый квартал?
Разрыв открытые/закрытые составляет 4 месяца и вырос с 3-месячного среднего (Epoch AI), так что срок годности твоих порогов маршрутизации ограничен. Команды, которые не будут пересматривать их, должны по умолчанию использовать фронтирный API с включённым кешированием и ничего не маршрутизировать. Те, кто будет, могут изучить реальные кейсы развёртывания, чтобы узнать, на каких порогах остановились другие.
Что изменит этот вердикт в 2027 году
У этого совета есть срок годности, и его задают три конкретных числа.
Цены на память замедляются, но не падают
Контрактные цены на обычную DRAM выросли примерно на 93–98% квартал к кварталу в 1К26, затем на 58–63% во 2К26, и прогноз на 3К26 — 13–18%. Кривая выравнивается. Она всё ещё смотрит вверх. Более медленный рост не возвращает тебе те $700, которые NVIDIA добавила к DGX Spark в феврале 2026, и ничто в прогнозе не говорит о том, что уличные цены упадут в следующем году. Рассчитывай, что кейс для железа останется слабым до 2027 года, если только спрос дата-центров не ослабнет.
Следи за разрывом открытые/закрытые, а не за заголовочными бенчмарками
Два сигнала важнее любой позиции в лидерборде. Первый — разрыв ECI от Epoch AI, который составлял 4 месяца, или 8 очков, с января 2026. Второй — количество активных параметров: GLM-5.2 лидирует по open-weight'ам при 40B активных из 744B всего, так что в день, когда модель с менее чем 30B активными параметрами окажется в нескольких очках ECI от фронтира, карта в 24 ГБ снова станет интересной. Также следи, нормализуется ли или останется удвоение тарифов Ollama в часы пик (12:00–18:00 UTC по будням). Наши отчёты о тенденциях AI отслеживают релизы моделей, которые могут изменить любое из этих значений.
Часто задаваемые вопросы
Что дешевле в 2026 году: запускать LLM локально или использовать облачный API?
Для большинства людей — облако, и разрыв расширился в 2026 году. Claude Haiku 4.5 стоит $1 за миллион входных токенов и $5 за миллион выходных, снижается до $0,50/$2,50 через Batch API, а попадания в кеш промптов тарифицируются по 0,1× от базовой входной ставки (Anthropic pricing). С другой стороны, NVIDIA DGX Spark вырос с $3 999 до $4 699 в феврале 2026 из-за стоимости DRAM и хранилищ (Notebookcheck), и ты всё равно платишь за электроэнергию по среднему жилому тарифу США 18,34 ¢/кВт·ч в июне 2026 года (EIA). Локальный вариант зарабатывает своё право на существование при устойчивой высокообъёмной пакетной работе, загружающей карту большую часть каждого дня, при работе без сети и в циклах с чувствительной латентностью.
Какое железо нужно для запуска LLM локально в 2026 году?
24 ГБ GPU — это практический потребительский минимум, и он ограничивает тебя классом MoE 20–30B, а не чем-то близким к open-weight фронтиру. Выше — ты покупаешь устройство с 128 ГБ LPDDR5X, например DGX Spark, который теперь стоит $4 699 (Notebookcheck). Закладывай бюджет с учётом продолжающегося роста цен на память: контрактные цены на обычную DRAM выросли примерно на 93–98% квартал к кварталу в 1К26 и на 58–63% во 2К26, с прогнозом ещё 13–18% в 3К26 (TrendForce). Квантизация растягивает то, что влезает, а 4-бит почти бесплатен: Q4_K_M уменьшил Mistral-7B-Instruct-v0.2 с 7,2 ГБ до 4,1 ГБ при потере перплексии 0,51%, тогда как Q2_K резко деградировал на 7,94% (quantization tradeoffs).
Насколько хороши локальные модели по сравнению с Claude или GPT?
Широко цитируемый разрыв реален, но он описывает железо, которого у тебя, вероятно, нет. Epoch AI зафиксировал отставание open-weight моделей от закрытых фронтирных в среднем на 4 месяца, или 8 очков ECI, с января 2026 — чуть шире 3-месячного среднего за январь 2023 — октябрь 2025 (Epoch AI). Модель, несущая это утверждение, GLM-5.2, набирает 51 балл на Intelligence Index v4.1 от Artificial Analysis при 744B параметров всего и 40B активных — это дата-центровое железо (Artificial Analysis). То, что реально помещается на ноутбук или один GPU, хорошо справляется со структурированными рассуждениями и плохо — со знаниями о мире, так что воспринимай цифру в 4 месяца как потолок, которого дома не достичь.
Ollama всё ещё бесплатен, и как сравниваются цены Ollama Cloud с фронтирными API?
Постановка «локально vs Ollama» потеряла смысл 31 августа 2026 года, когда Ollama перевёл планы Pro, Max и Team на поотоконное облачное ценообразование: $20/мес, включая $60 использования; $100/мес, включая $300; и $500/мес, включая $1 000 для неограниченного числа пользователей — без хранения данных с хостингом в США и Европе (Ollama blog). Облачные open-weight'ы там дёшевы: deepseek-v4-flash — $0,22 вход и $0,66 выход на миллион токенов, nemotron-3-super — $0,015/$0,60, qwen3.5:397b — $0,60/$3,60, хотя большинство тарифов удваиваются в часы пик с 12:00 до 18:00 UTC по будням (Ollama pricing). Сравни это с Claude Haiku 4.5 по $1/$5 (Anthropic pricing), и реальный выбор становится трёхсторонним: облачные open-weight'ы обходят твой GPU по стоимости для большинства нагрузок. У Ollama достаточно масштаба, чтобы его серьёзно воспринимали в любом случае: 8,9 миллиона активных разработчиков в месяц и 85% Fortune 500 (TechCrunch).
Действительно ли запуск модели локально делает мои данные более приватными, чем облачный API?
Это даёт одно свойство, которого нет ни у чего другого: байты никогда не покидают твою машину, и это важно для работы без сети и жёстких требований суверенитета данных, таких как CLOUD Act. Для всего мягче этого провайдеры теперь продают ту же гарантию дёшево. На Claude 4.6 и выше фиксация вывода только в США с помощью inference_geo: "us" обходится в множитель 1,1× по всем категориям токенов (Anthropic pricing), а платные планы Ollama обеспечивают нулевое хранение данных в США и Европе (Ollama blog). 10% надбавки — несравнимо меньшее обязательство, чем $4 699 железа (Notebookcheck).
С какой локальной модели начать на 24 ГБ GPU?
Начни с модели MoE 20–30B, например Qwen3-30B-A3B или gpt-oss-20b, квантизированной до Q4_K_M. Этот класс набирает 73–87% на AIME 2024 на одном RTX 5090, так что с рассуждениями всё хорошо, а слабое место — фактические знания о мире. Q4_K_M — правильная остановка по квантизации: она уменьшила модель в 7,2 ГБ до 4,1 ГБ при потере перплексии 0,51%, а Q2_K резко деградировал на 7,94% (quantization tradeoffs). Запускай как первый хоп и эскалируй насыщенные знаниями запросы к облачной модели.