

Поиск превращается из списка ссылок в один готовый ответ, а платформы между вами и вашей аудиторией меняют условия: кому платят и кого посещают. Устойчивый ответ скучный, но рабочий: заведите канал, где читатели найдут вас без чьего-либо алгоритма, осознанно решите, каким ИИ-краулерам можно использовать ваши материалы, и публикуйте страницы, которые answer engine может чисто процитировать.
Это актуально сейчас, потому что все новости 2026 года пришли в течение нескольких дней. Google платит некоторым издателям за вклад в ИИ-ответы, Reddit закрывает открытые ленты, а Instagram, YouTube и Spotify дают авторам и слушателям ИИ-инструменты, определяющие, что будет показано. В этом руководстве новости превращены в план, который можно запустить на этой неделе, будь у вас рассылка, канал, блог магазина или подкаст.
Это практический план, а не прогноз. Если цифра взята из отчёта, мы указываем, чей это отчёт. Если Google, OpenAI или Perplexity документируют настройку, мы даём ссылку на документацию. Про софт для SEO читайте в нашем обзоре лучших ИИ-инструментов для SEO. Эта статья о стратегии, которой эти инструменты служат.
Раньше поиск заканчивался на вашем сайте
В классическом поиске человек вводил запрос, просматривал десять ссылок и кликал по одной. Продуктом был клик. Ваша аналитика, рекламные блоки и форма подписки на рассылку находились по ту сторону клика.
ИИ-ответ меняет середину этого пути. Читатель получает синтезированный ответ с несколькими источниками, и клик становится необязательным. Кто-то всё равно переходит, и Google говорит, что страницы, показанные как вспомогательные ссылки в AI Overviews и AI Mode, учитываются в обычном веб-трафике Search Console. Но кликнувший читатель часто уже уловил суть, поэтому визитов меньше, а намерение у них теплее.
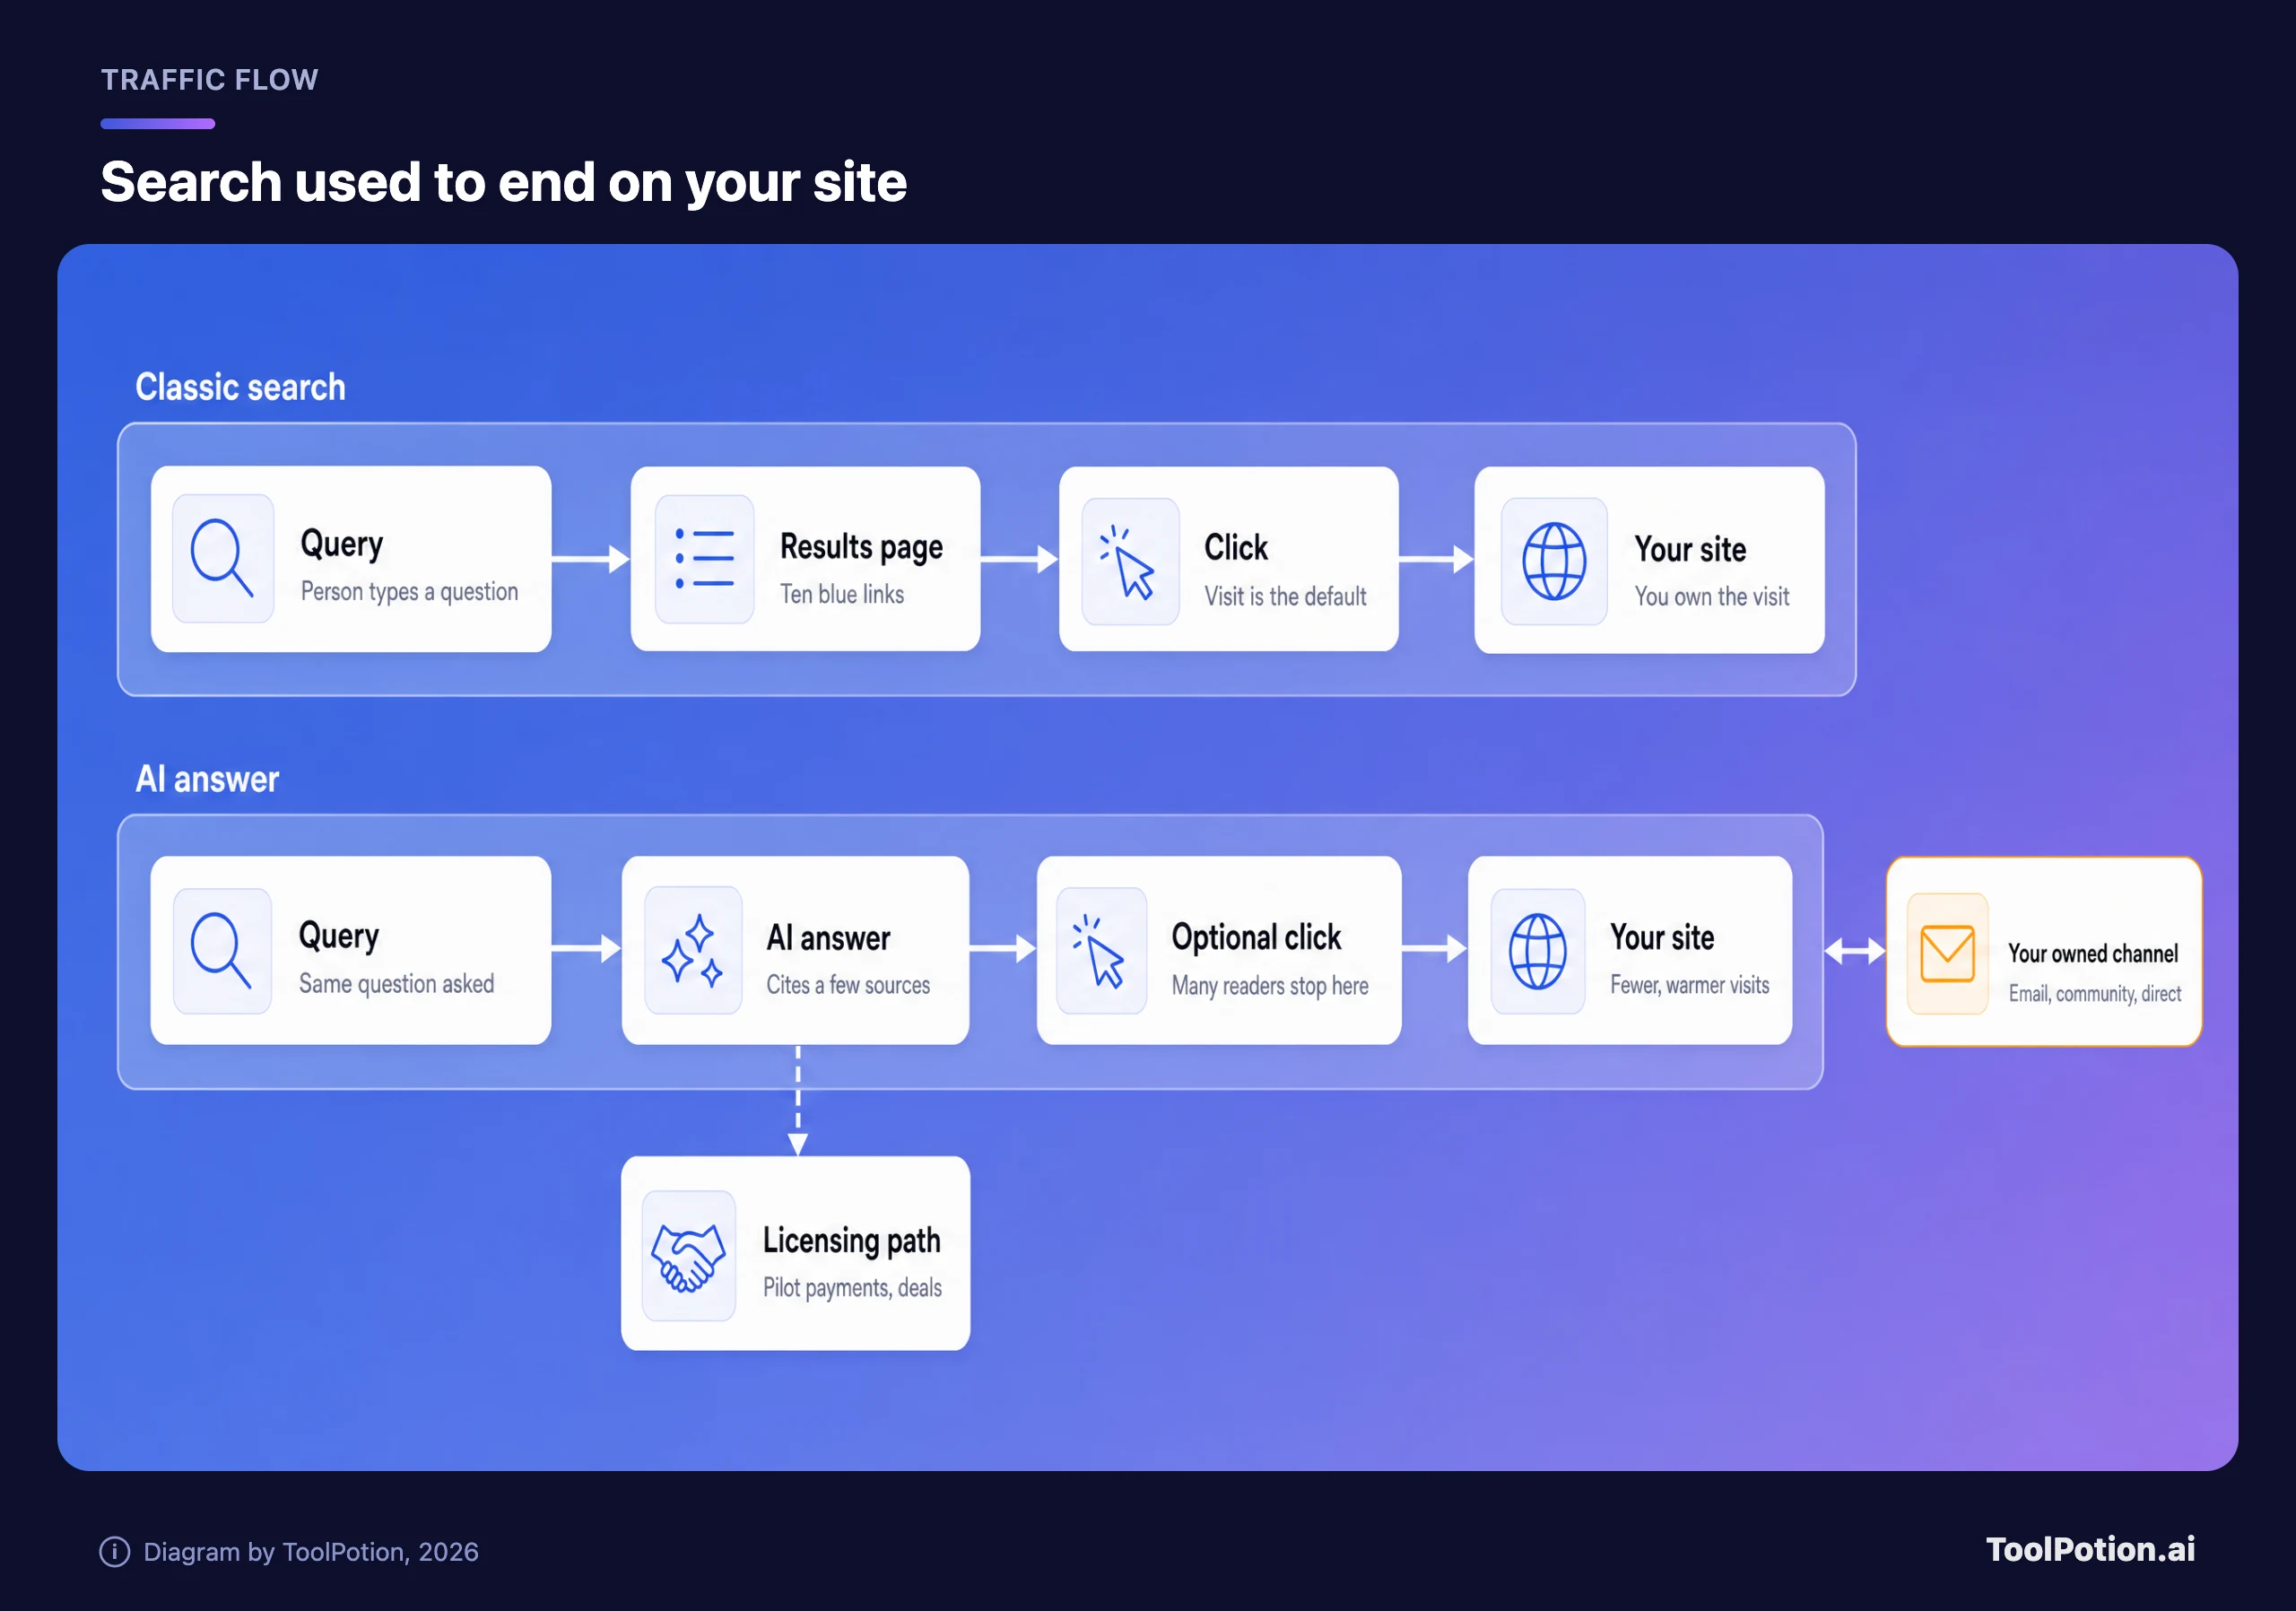
На схеме также виден новый в этом году боковой путь: лицензирование. Если ваш контент питает ответ, кто-то может заплатить вам за него. Хватит ли этих денег, это следующий вопрос.
Что платят платформы и что они закрывают
Пилот Google — самый показательный пример. По данным The Information, со ссылкой на The Verge, около 100 издателей вступили в программу, которая платит в зависимости от того, насколько их контент помог AI Overviews, AI Mode и чат-боту Gemini. Один из издателей, вступивших в самом начале, по сообщениям, заработал за год более $1 млн. Тот, кто присоединился несколько месяцев назад, заработал примерно $50–60 тысяч, говорится в том же отчёте. Сам Google эти цифры, насколько нам удалось выяснить, не публиковал.
Цифры обнадёживающие, но опираются на единственный отчёт. Ранние и поздние участники получают совершенно разные чеки, и никто за пределами пилота не сможет спрогнозировать ваш.
The Verge также отмечает, что в Великобритании решили: Google должен позволить издателям отказаться от показа в ИИ-функциях поиска, а Евросоюз начал расследование влияния на веб-трафик. Если это сохранится, отказ станет реальным рычагом, а не теоретическим.
Reddit демонстрирует противоположную позицию. Он закрывает RSS-ленты позже в этом году, а публичный доступ к API в начале 2027 года, сообщает TechCrunch, ссылаясь на масштабный скрейпинг и автоматизированные злоупотребления. В том же материале сказано, что «прочая выручка» Reddit, куда входит лицензирование для ИИ, выросла за год на 24% и составила $43 млн, а ИИ-ассистентам, отвечающим на вопросы по данным Reddit, после закрытия открытой двери понадобятся коммерческие соглашения. Каковы бы ни были мотивы, для всех, кто строил что-то на лентах Reddit, итог один: открытый веб сжимается, а доступ превращается в платный продукт.
Вывод для небольшого издателя неприятный. Скорее всего, договариваться с Google или OpenAI вы сегодня не можете. Но вы можете решить, что разрешает ваш собственный сайт, и перестать зависеть от трубы, на которую вот-вот поставят счётчик.
Ассистенты подталкивают вас к целям самой платформы
Пока доступ сужается, платформы дают авторам ИИ-помощников. В приложении Edits от Instagram теперь есть творческий ассистент, использующий данные вашего аккаунта; The Verge называет среди них лайки, просмотры, удержание и репосты. Можно спросить, почему одно видео сработало, а другое нет, или какой взять хук. YouTube только что обновил собственную ИИ-панель для авторов, которая, как сказано в той же статье, подсказывает, как максимизировать вовлечённость.
Это полезно, но это и замкнутый круг. Оба ассистента оптимизируют вовлечённость внутри своей платформы. The Verge высказывает очевидное опасение: когда все оптимизируются под одни и те же метрики, контент сближается, а выгода от следования советам сокращается.
Меняется и сторона аудитории. YouTube позволит зрителям собирать персональную ленту по текстовому запросу с помощью Gemini; она будет закреплена вкладкой на главной рядом с обычными рекомендациями. Taste Profile от Spotify позволяет слушателям Premium в США от 18 лет править свои рекомендации обычным языком, и «Главная» меняется в течение нескольких часов. А ChatGPT теперь предлагает сторонние приложения прямо в ходе разговора: у него 16 партнёров на старте, включая Notion и Vercel, а также корпоративный маркетплейс с более чем 30 партнёрами.
В сумме получается, что discovery раскалывается. Аудитория всё чаще будет говорить ассистенту, чего она хочет, а ассистент будет решать, что показать. Вот как эти функции соотносятся.
Суть в закономерности последнего столбца. Почти все настройки находятся у платформы или у зрителя и почти ни одной — у вас. Поэтому стратегия ниже начинается с того, что принадлежит вам.
Разделите каналы на собственные, арендованные и лицензируемые
Канал собственный, если вы можете связаться с человеком завтра, ни у кого не спрашивая разрешения. Список рассылки подходит. Сайт с прямыми визитами тоже, как и сообщество на инфраструктуре, которую вы контролируете. Канал арендованный, если платформа решает, кто увидит ваш пост. Сюда относятся соцсети, видеоплатформы и маркетплейсы. Лицензируемые каналы — самый новый слой: ИИ-компании или поисковики платят за право повторно использовать вашу работу.
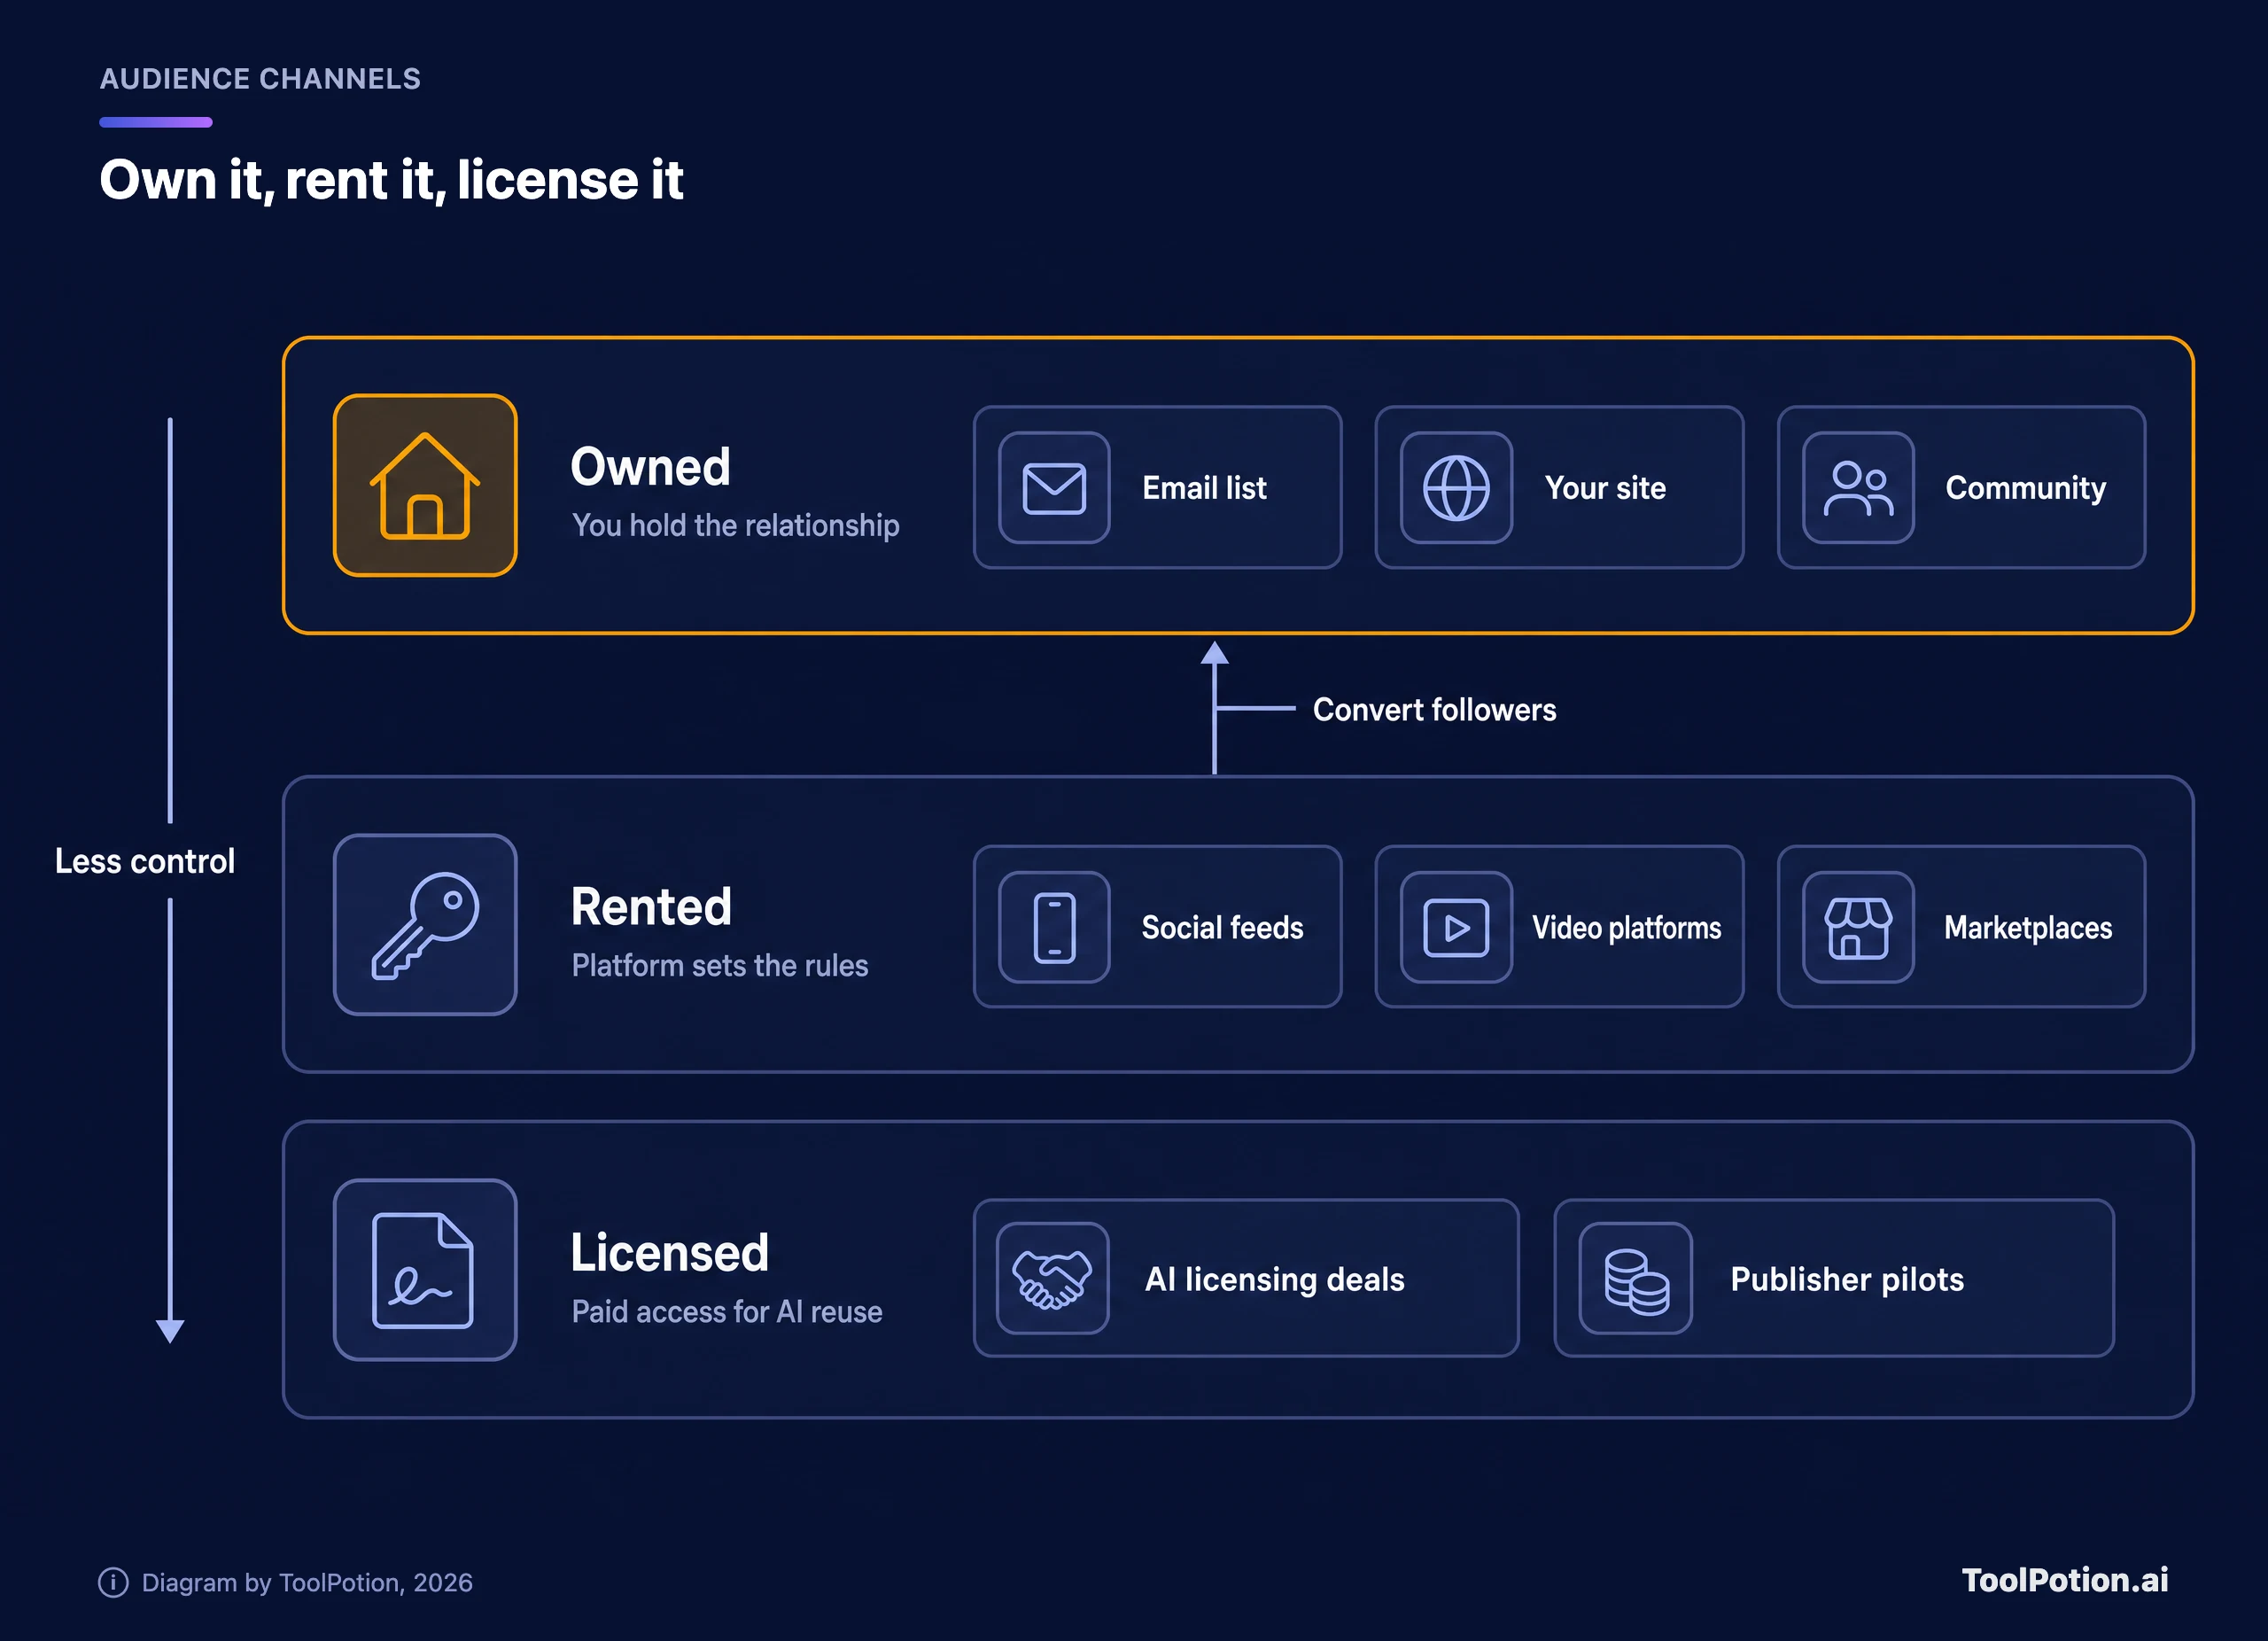
Арендованными каналами по-прежнему стоит пользоваться. Именно там происходит discovery. Ошибка в том, чтобы считать число подписчиков активом, когда платформа может перетасовать его за ночь. У каждого поста в арендованном канале должна быть задача, и обычно это перевести человека в канал, который вам принадлежит.
Для рассылки обычно начинают с платформы вроде beehiiv или Mailchimp, а как удерживают аудиторию известные ИИ-рассылки, например Superhuman AI и Axios AI+, можно посмотреть в нашем каталоге. Для сообщества пример того, во что может вырасти пространство, которым управляет автор, — Discord-сервер, такой как Midjourney.
Попробуйте калькулятор ниже со своим распределением трафика. Это эвристика, а не прогноз: он складывает доли поиска и соцсетей, чтобы показать, какая часть вашего трафика приходит по арендованным каналам, а затем применяет заданное вами предполагаемое падение кликов из поиска.
Если арендованный трафик выше примерно 70%, одно изменение политики на одной платформе может сильно по вам ударить. От 40% до 70% вы уязвимы, но не хрупки. Ниже 40% база у вас уже есть. Эти диапазоны — наше практическое правило, так что подстройте их под свою готовность к риску.
Задайте политику доступа для ботов осознанно
У большинства сайтов нет письменного решения по ИИ-краулерам. Они либо блокируют всё, потому что так кажется безопаснее, либо разрешают всё, потому что никогда не вникали. Оба варианта выбраны по умолчанию. Лучше принять по одному решению на каждого бота, исходя из того, что он на самом деле делает.
У OpenAI их три. В документации по краулерам сказано, что OAI-SearchBot показывает сайты в поисковых функциях ChatGPT, а сайты, которые отказались, не будут показываться в поисковых ответах ChatGPT. GPTBot собирает контент для обучения генеративных моделей. ChatGPT-User выполняет действия, запущенные человеком, и правила robots.txt на него могут не распространяться. Каждая настройка независима, и по словам OpenAI, после обновления robots.txt поисковым системам может потребоваться около 24 часов, чтобы подстроиться.
Токен Google-Extended определяет, можно ли использовать просканированный контент для обучения будущих моделей Gemini и для grounding в приложениях Gemini. Google заявляет, что он не влияет на включение в Google Search и не имеет отношения к ранжированию. AI Overviews регулируются обычными настройками Search: руководство по ИИ-функциям указывает nosnippet, data-nosnippet, max-snippet и noindex.
Документация Perplexity делит ботов на два типа. PerplexityBot показывает сайты со ссылками в результатах Perplexity и, по словам компании, не используется для краулинга ради обучения базовых моделей. Perplexity-User загружает страницы, когда об этом просит человек, и, как сообщает Perplexity, обычно игнорирует robots.txt для таких запросов, потому что их инициировал пользователь.
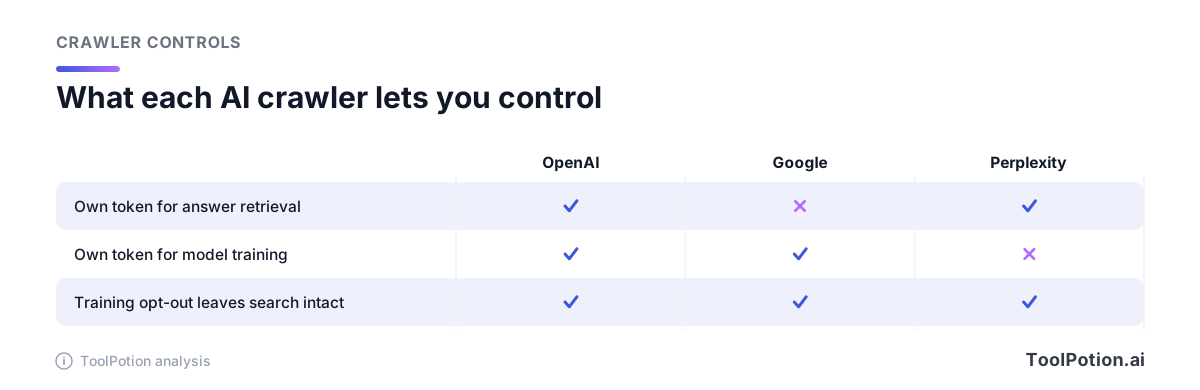
Вот разумный вариант по умолчанию для издателя, который хочет цитирования, но не хочет бесплатно отдавать данные для обучения. Разрешите поисковых ботов (OAI-SearchBot и PerplexityBot), запретите токен для обучения (GPTBot) и Google-Extended (обучение Gemini и grounding), а Googlebot не трогайте. Такой robots.txt выглядит так.
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# OpenAI model training
User-agent: GPTBot
Disallow: /

# Gemini training and grounding only. Does not affect Search or AI Overviews.
User-agent: Google-Extended
Disallow: /
Обратите внимание, чего этот файл не делает. Запрет Google-Extended не уберёт вас из AI Overviews и AI Mode, потому что они подчиняются Googlebot и настройкам Search. Чтобы ограничить то, что Google показывает со страницы, используйте nosnippet, data-nosnippet, max-snippet или noindex, и учтите, что каждый из них стоит вам видимости.
Магазину или сервисному бизнесу, возможно, нужен противоположный акцент: разрешить всё, потому что упоминание в ответе и есть цель. Издатель с платным доступом и планами на лицензирование может заблокировать больше. Если вы собираетесь вести переговоры, письменная политика и чистые серверные логи станут вашим доказательством того, что вы контролируете.
Публикуйте страницы, которые ИИ-ответ может процитировать
Google прямо говорит, что никакого особого трюка нет. По его рекомендациям, для показа в AI Overviews или AI Mode нет дополнительных требований, и новые машиночитаемые файлы или ИИ-разметка не нужны. Страница должна быть проиндексирована и допускать показ со сниппетом. Поэтому первый аудит скучный: убедитесь, что на страницах, которые вы хотите видеть в цитатах, нет случайного noindex или nosnippet.
Дальше работа редакторская. Answer engine цитируют страницы, где мысль сформулирована прямо, указан источник и назван автор. Начинайте каждый раздел с ответа, ставьте число и его источник в одно предложение и датируйте утверждения. Оригинальные данные лучше пересказа, потому что цитировать больше нечего.
Структурированные данные помогают машинам читать содержимое страницы, но с ограничениями. Google рекомендует JSON-LD, не гарантирует расширенные результаты и просит не размечать информацию, которую читатели не видят. Тип Article на Schema.org даёт author, datePublished, dateModified и publisher — эти свойства стоит заполнять правильно в каждом посте. Полнота и точность важнее исчерпывающего объёма.
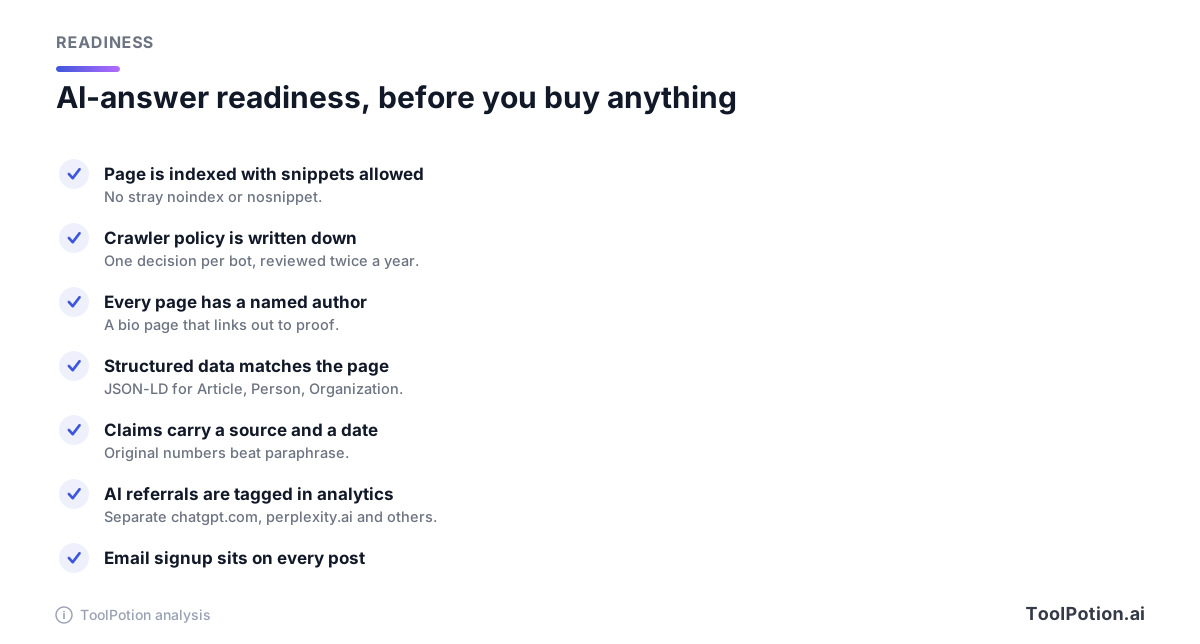
Страницы авторов весят больше, чем раньше. Названный человек с биографией и ссылками на подтверждения работы — это то, что читатель может проверить, и именно на такое качество опирается модель, выбирая между почти одинаковыми страницами. Если нужна помощь в подготовке и проверке этого в масштабе, доска ИИ-инструментов для SEO ранжирует варианты, а Semrush, Ahrefs и Frase — известные имена для сравнения.
Измеряйте ИИ-переходы, прежде чем оптимизироваться под них
Нельзя управлять тем, что ваша аналитика сваливает в «прямые». Начните с выделения реферреров, которые вы видите. Чат-ассистенты и answer engine присылают трафик со своих доменов, например chatgpt.com и perplexity.ai, так что сегмент по этим хостам даст базовую картину за неделю. В Search Console, по словам Google, AI Overviews и AI Mode отображаются внутри типа поиска «Веб» вместе со всем остальным, так что отдельного отчёта ждать не стоит.
Отслеживайте три числа каждый месяц: визиты с ИИ-реферреров, сколько из них попадает на форму подписки и сколько ваших целевых страниц цитируется, когда вы сами задаёте свои вопросы. Третье делается вручную. Откройте Perplexity и ChatGPT, задайте десять вопросов, которые задают ваши клиенты, и отметьте, какие ваши страницы появились. Это займёт час и расскажет больше, чем дашборд.
Поглядывайте и в серверные логи. Если бот, которого вы запретили, всё равно загружает страницы, это повод поднять вопрос о политике. Если сборщик, запущенный пользователем, приходит вопреки robots.txt, это ожидаемое поведение по документации вендоров выше, и при необходимости с ним справляются правилами файрвола, а не robots.txt.
Выберите план по типу бизнеса
Одна и та же стратегия ложится по-разному в зависимости от того, как вы зарабатываете.
- Независимым авторам на YouTube, в Instagram или Spotify стоит воспринимать ассистентов платформ как бесплатную аналитику и не более. Узнайте с их помощью, какие хуки работают, а затем добавьте ссылку на подписку в каждое описание видео и в био.
- Издателям с доходом от рекламы стоит сначала написать политику для ботов, а потом наблюдать за пилотом Google и решениями Великобритании и ЕС, прежде чем решать, отказываться ли от ИИ-функций. Отказ стоит видимости, а выплаты пока сильно различаются.
- Интернет-магазинам и сервисному бизнесу нужно, чтобы их называли в ответах. Разрешите поисковых ботов, держите факты о товарах и ценах на индексируемых страницах с согласованной структурированной разметкой и проверьте, подходят ли вашей категории приложения, которые предлагает ChatGPT.
- У владельцев рассылок уже есть лучший канал. Потратьте силы на страницы архива, которые простым языком отвечают на вопросы: именно их цитируют, и именно они возвращают новых читателей к форме подписки.
- Создатели сообществ сильнее всех сталкиваются с проблемой Reddit. Если ваша аудитория собирается на чужом форуме, зеркалируйте лучшие треды в пространство, которым управляете вы.
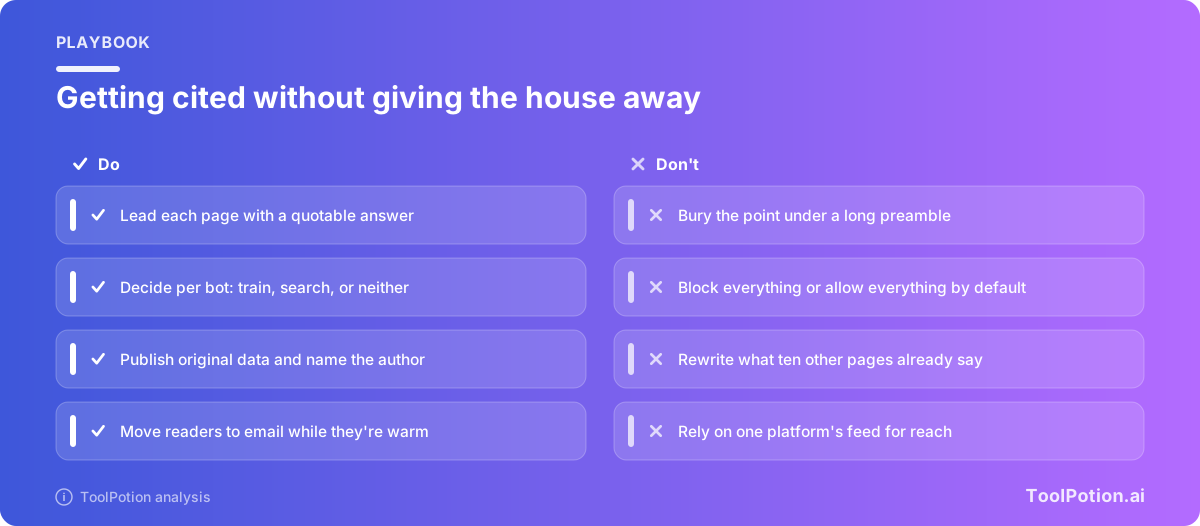
Если не знаете, с чего начать, начните с рассылки. Добавьте подписку на пять самых результативных страниц, отправляйте по одному полезному письму в неделю и следите за долей трафика, которая возвращается сама. Про инструменты для производства контента читайте на нашей доске для создателей контента и в руководстве лучшие ИИ-инструменты для создателей контента, а ИИ-ридеры новостей показывают, как другие формируют привычку у аудитории. Наш список лучших ИИ-каналов на YouTube показывает, как выглядит арендованный канал в масштабе.
Часто задаваемые вопросы
Нужна ли специальная разметка, чтобы попасть в Google AI Overviews?
Нет. По рекомендациям Google, дополнительных требований или специальной оптимизации нет. Страница должна быть проиндексирована и допускать показ со сниппетом, так что сначала проверьте noindex и nosnippet.
Уберёт ли блокировка Google-Extended меня из Google Search?
Нет. Google заявляет, что Google-Extended не влияет на включение в Search и не связан с ранжированием. Он управляет использованием для обучения Gemini и grounding и не убирает вас из AI Overviews и AI Mode, которые подчиняются настройкам Search.
Стоит ли блокировать GPTBot?
Зависит от того, согласны ли вы, чтобы ваш контент использовался для обучения. Блокировка GPTBot не зависит от OAI-SearchBot, так что можно запретить обучение и при этом позволить поисковым функциям ChatGPT вас цитировать.
Могу ли я получать деньги за использование моего контента ИИ?
Возможно, но ненадёжно. Пилот Google, по сообщениям, охватывает около 100 издателей с очень неравными выплатами, а ИИ-лицензирование Reddit входит в статью выручки в $43 млн, по данным TechCrunch. Небольшим издателям стоит исходить из того, что пока платы не будет, и держать наготове письменную политику для ботов.
Как понять, приводят ли меня ИИ-ответы к трафику?
Выделите в аналитике реферреры с chatgpt.com, perplexity.ai и похожих хостов. ИИ-функции Google учитываются в обычном веб-трафике поиска в Search Console, поэтому отдельной строкой они не появятся.
Калькулятор трафика — это прогноз?
Нет, это грубая эвристика. Он складывает доли поиска и соцсетей, чтобы показать арендованную долю, и применяет выбранное вами падение кликов из поиска, так что результат настолько хорош, насколько хорошо ваше допущение.