

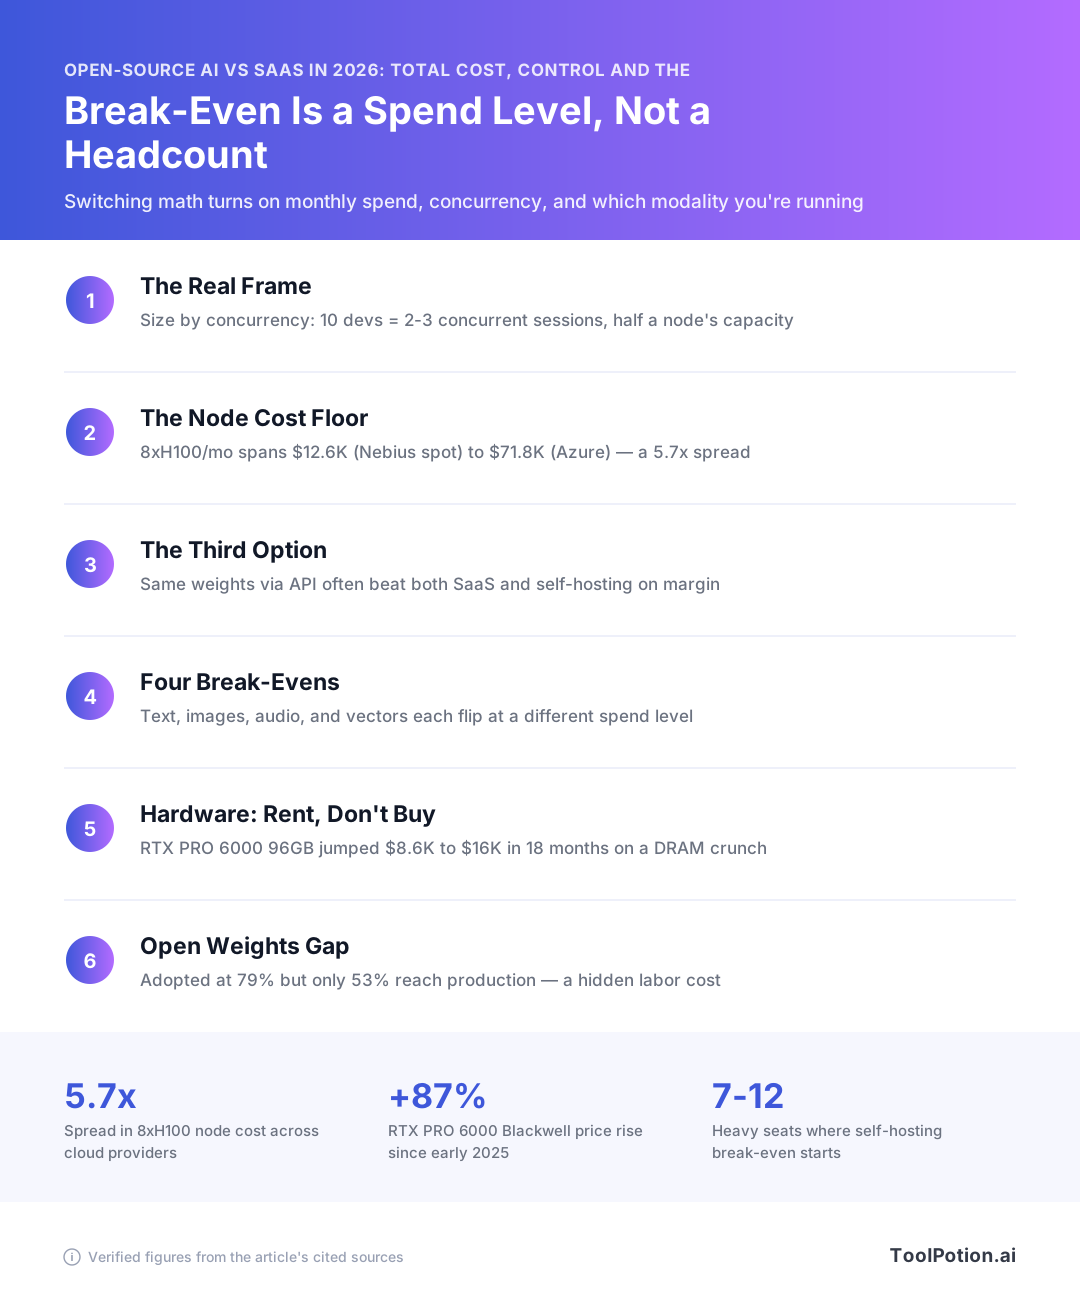
Выбор между ИИ с открытым исходным кодом и SaaS определяется двумя числами: ежемесячными расходами и профилем параллелизма. Численность персонала — плохой ориентир для обоих. Собственные инженеры DoiT в среднем тратят $2 200 на разработчика в месяц на usage-based Claude Code, что делает узел за $15–25 тыс. целесообразным примерно при 7–12 тяжёлых пользователях. Но только 10–20% команды одновременно выполняет запросы, то есть десять разработчиков — это две-три параллельные сессии, а половина узла простаивает.
И прежде чем вообще считать стоимость GPU, проверьте третий вариант, против которого почти никто не проводит сравнительных тестов: DeepInfra предлагает Llama-3.3-70B по цене $0,10 за ввод / $0,32 за вывод на миллион токенов. Те же веса, многопользовательская маржа, которую вам не повторить. Расчёты ниже приводятся четыре раза — для текста, изображений, транскрипции и векторного слоя.
Точка безубыточности — это уровень расходов и профиль параллелизма
Два числа определяют, стоит ли вам самостоятельно размещать ИИ, и размер команды не входит ни в одно из них. Первое — сколько вы тратите на ИИ в месяц сейчас. Второе — сколько запросов выполняется одновременно. Всё остальное, включая выбор модели, вторично.
Два числа, которые всё решают до выбора модели
GPU-узел стоит одинаково — используете ли вы его на полную мощность или он простаивает в 3 часа ночи. В этой асимметрии и состоит суть сравнения: SaaS берёт деньги за токен, узел — за час. Вопрос в том, превысил ли ваш ежемесячный счёт фиксированную стоимость сервера, который можно держать занятым.
Инженеры DoiT тратят в среднем около $2 200 на разработчика в месяц при usage-based тарификации Claude Code Enterprise, что ставит точку безубыточности в $15–25 тыс./мес. при самостоятельном размещении примерно на уровне 7–12 активных AI-пользователей. Это значительно ниже порога «сотни инженеров», который повторяется в большинстве TCO-руководств. Это порог расходов, а не порог по людям. Двенадцать разработчиков, почти не использующих ассистента, не дотянут, а семь, запускающих агентов весь день, — вполне.
Параллелизм — второе число, и именно его команды чаще всего недооценивают. Аргумент DoiT: в любой момент только 10–20% разработчиков имеет активный запрос, поэтому десять разработчиков — это две-три параллельные сессии, в лучшем случае половина мощности одного узла. Вы платите за восемь H100, а используете три-четыре. Рассчитывайте по пиковым параллельным запросам и целевой пропускной способности по токенам, а затем проверьте, укладывается ли это в один узел, прежде чем что-то считать.
Почему «у нас 50 инженеров» — не тот триггер
Численность персонала коррелирует с расходами только тогда, когда потребление на человека одинаково, а так никогда не бывает. Команда из 50 человек, где 8 постоянно запускают агентов для кодинга, а 42 иногда пользуются чатом, требует ровно столько же ресурсов узла, что и команда из 8 активных пользователей, и счёт примерно такой же. Считайте тяжёлых пользователей.
Прежде чем сравнивать open-weight модели из нашего каталога с чем-либо, запустите эти два расчёта. Выбирайте модель только после того, как узнаете, можно ли держать узел занятым, — модель, уступающая лидеру на 6 пунктов, вполне приемлема на насыщенном сервере и дорого обходится на четверть загруженном.
ИИ open source vs SaaS: во сколько обходится самостоятельное размещение в 2026
Начните с прайс-листа, потому что это единственное число, которое можно найти. Всё остальное в бюджете на self-hosting — оценки, которые вам придётся защищать в таблице.
Тарифы на аренду GPU: разброс ~7x для inference-совместимого железа
Публичный прайс RunPod: H100 SXM 80GB — $3,29/час на Secure Cloud и $2,69/час на Community Cloud, H200 141GB — $4,59/$3,59, A100 PCIe 80GB — $1,39/$1,19, L40S 48GB — $0,99/$0,79, B200 180GB — $6,79/$5,98 (RunPod). Это примерно 7-кратный разрыв между самой дешёвой и самой дорогой картой, пригодной для inference. Если ваша нагрузка — модель 7B или 8B с небольшим контекстом, ориентируйтесь на линейку L40S, которую большинство TCO-обзоров вообще не упоминает.
Lambda берёт $4,29/час за одиночный H100 SXM по требованию, снижая до $3,99/час за GPU на узле 8x, H100 PCIe — $3,29/час, B200 SXM6 — $6,69–$6,99/час (Lambda). Узел 8xH100 по этому тарифу — около $31,92/час, или примерно $23 300 за 730-часовой месяц при 100% uptime. Никто не работает на 100%, что и составляет суть следующего числа.
Скидка за обязательства — самый крупный рычаг, которым вы управляете. Together AI берёт $3,99/GPU-час по требованию за HGX H100 и $3,19–$3,69/GPU-час на зарезервированных условиях сроком от 7 до 180+ дней (Together AI). Назовём это скидкой в 20%, доступной только если вы достаточно уверены в своей нагрузке, чтобы подписать соглашение.
Множитель провайдера: от $12 600 до $71 800 за одинаковый месяц с 8xH100
DoiT рассчитал стоимость идентичного узла 8xH100 за 730-часовой месяц у разных провайдеров: около $12 600 на Nebius spot, $22 500 на Nebius on-demand, $40 200 на AWS, $64 100 на GCP и $71 800 на Azure (DoiT). Одно и то же железо — разброс в 5,7 раза. Выбор провайдера влияет на математику перехода сильнее, чем выбор модели, поэтому если вы проводите оценку по прайсу гиперскейлера из-за committed spend, вы сравниваете худший вариант self-hosting с SaaS.
| Провайдер / карта | Почасовой тариф | Примечания |
|---|---|---|
| RunPod L40S 48GB | $0,99 / $0,79 | Secure vs Community Cloud |
| RunPod H100 SXM 80GB | $3,29 / $2,69 | Secure vs Community Cloud |
| Lambda H100 SXM (узел 8x) | $3,99 за GPU | ~$23 300 / 730-часовой месяц |
| Together AI HGX H100 | $3,99 по требованию, $3,19–$3,69 зарезервировано | Сроки 7–180+ дней |
Статьи расходов, которые никто не считает: простой, резервирование и трудозатраты на обслуживание
Арендованный узел тарифицируется по настенным часам. Ваш API-счёт отслеживает токены, а счёт за GPU — часы, которые вы можете никогда не использовать. Если ваш трафик — рабочие часы и будни, вы платите примерно за 168 часов полезной мощности из 730, а остальное — потери; умножьте эффективную стоимость токена на четыре, прежде чем сравнивать с API-счётом. Добавьте второй узел или резервный API-ключ, если сервис ориентирован на клиентов, — у одного узла нет отказоустойчивости. Добавьте инженера, который патчит vLLM, ротирует версии моделей, следит за давлением KV-кеша и отвечает на звонки в 2 ночи. Поставщики из нашего каталога платформ машинного обучения возьмут на себя часть этого за маржу, что обычно дешевле половины ставки, которую вы иначе потратили бы.
Обоснованная ежемесячная цифра такова: часы работы узла по реальному тарифу провайдера, делённые на реальный uptime, плюс резервирование, плюс загруженные трудозатраты инженеров. Считайте всё четыре составляющих перед любым сравнением.
Третий вариант, который разрушает большинство аргументов в пользу self-hosting
Почти в каждой статье, сравнивающей open source с SaaS, счёт за GPU ставится рядом со счётом за frontier API и объявляется победитель. При этом упускается вариант, который большинству команд подходит лучше всего: кто-то другой запускает open-weight для вас, в многопользовательском режиме, и берёт деньги за токен.
DeepInfra предлагает Llama-3.3-70B-Instruct-Turbo по $0,10 за ввод / $0,32 за вывод на миллион токенов, и Meta-Llama-3.1-8B по $0,02/$0,04 (DeepInfra). Те же чекпоинты, что вы бы скачали. Те же условия лицензии. Разница в том, что их H100 работают почти на полную мощность для тысяч клиентов, а ваши — при том трафике, что есть в 3 часа ночи в воскресенье.
Те же открытые веса, чужая кривая загрузки
Посчитайте против выделенного тарифа самого DeepInfra — разрыв становится неловким. Выделенный H100 80GB стоит там $2,20/час (DeepInfra), то есть $1 606 за 730-часовой месяц. По $0,32 за миллион выходных токенов те же $1 606 покупают около пяти миллиардов выходных токенов на serverless-эндпоинте. За 43 800 минут этого месяца ваш одиночный H100 должен был бы устойчиво выдавать около 115 000 выходных токенов в минуту — каждую минуту, — только чтобы сравняться с API по цене. В реальном развёртывании значительную часть этих минут занимает простой.
Выделенную мощность покупают по причинам, не связанным с ценой за единицу: место хранения данных, отсутствие сторонней обработки, управляемые вами минимумы задержки, кастомные LoRA, модели, которые никто не хостит. Это реальные аргументы. Это причины для закупок, а не для таблиц, и вы должны говорить об этом вслух, когда обосновываете решение.
Когда аренда весов перестаёт быть дешевле
Нижний ценовой сегмент рынка схлопнулся. GPT-5-nano стоит $0,05/$0,40 за миллион токенов, а GPT-5 — $1,25/$10,00 (OpenAI), то есть проприетарная модель теперь дешевле, чем держать открытую 8B-модель на своём железе. Дешёвые open-weight API и дешёвые проприетарные API конкурируют на одной оси, и self-hosting проигрывает обоим.
Тщательно выбирайте точку сравнения, ведь она определяет ответ. Диапазон Anthropic — от $10/$50 за миллион для Fable 5.1 до $1/$5 для Haiku 4.5 (Anthropic). Сравнивайте self-hosting с верхней границей — выглядит как выгодная сделка. Сравнивайте с Haiku или с Llama от DeepInfra — и GPU-узел должен оправдывать себя контролем, а не стоимостью.
Четыре модальности — четыре совершенно разные точки безубыточности
Команда, которая размещает транскрипцию самостоятельно, почти никогда не делает то же самое с text inference, и причина — арифметика. У каждой нагрузки своя минимальная цена SaaS, свой паттерн загрузки GPU и свои правила лицензирования. Используйте одну модель безубыточности для всех четырёх — и получите неверный ответ три раза из четырёх.
Text inference: самая широкая и наименее предсказуемая точка перехода
Это модальность с наибольшим разбросом точки перехода, потому что цена API, с которой вы сравниваете, различается на порядок. Anthropic берёт $2/$10 за миллион входных/выходных токенов для Sonnet 5 и $1/$5 для Haiku 4.5 (Claude pricing), OpenAI указывает GPT-5-mini по $0,25/$2,00 и GPT-5-nano по $0,05/$0,40 (OpenAI API pricing). Выберите уровень сравнения — и точка безубыточности сдвинется от нескольких сотен миллионов токенов в месяц до нескольких миллиардов.
Выделенный H100 по $2,20/час на DeepInfra обходится примерно в $1 606 в месяц при полном uptime (DeepInfra pricing). При тарифе GPT-5-nano вам потребуется объём, которого большинство команд никогда не достигает. При Fable 5.1 по $10/$50 за миллион (Claude pricing) тот же узел окупается значительно быстрее. Определите, какой уровень нужен вашей нагрузке, до построения любой модели, и просматривайте каталог моделей и LLM, если вы ещё выбираете open-weight варианты.
Генерация изображений: лицензия решает раньше, чем GPU
Здесь математика GPU — простая часть, а лицензия — ловушка. Веса FLUX.1 [dev] широко считаются распространяемыми под некоммерческой лицензией, что означало бы необходимость платной лицензии Black Forest Labs между вами и коммерческим продуктом, поэтому прочитайте условия самостоятельно, прежде чем закладывать в бюджет железо. Никто из тех, кто сравнивает открытые модели изображений с Midjourney, об этом не говорит, а это именно та строка, которая может перевернуть решение.
Скачкообразная работа с изображениями — то, что не проходит тест. Маркетинговая команда, генерирующая партиями по вторникам, оставляет карту простаивать всю остальную неделю, а простой тарифицируется так же, как занятость. L40S по $0,79/час на RunPod Community Cloud (RunPod pricing) достаточно дёшев, чтобы постоянные пакетные задания уверенно окупались, именно поэтому запланированные конвейеры — это та форма, которая здесь работает. В нашем каталоге 727 инструментов для генерации изображений, и условия лицензирования там варьируются сильнее, чем качество результата.
Транскрипция: модальность, которая достигает точки перехода быстрее всего
Хотя обычно этого не происходит — из-за AssemblyAI. OpenAI берёт $0,006/мин за Whisper и gpt-4o-transcribe и $0,003/мин за gpt-4o-mini-transcribe, то есть $0,36 и $0,18 за аудиочас (OpenAI API pricing). При $0,36/час L40S за $0,79/час окупается уже при нескольких сотнях аудиочасов в месяц — при условии пакетной обработки быстрее реального времени. Это действительно низкий порог. Затем AssemblyAI устанавливает цену на Universal-2 в $0,15/час и Universal-3.5 Pro в $0,21/час (AssemblyAI pricing), и ваша точка безубыточности сдвигается вверх более чем в 2 раза.
Единственное место, где self-hosting безоговорочно побеждает, — стриминг. AssemblyAI тарифицирует стриминг по продолжительности WebSocket-сессии, включая время простоя подключения (AssemblyAI pricing). Если вы держите сокеты открытыми на совещаниях, где люди молчат, вы платите за тишину. Self-hosted эндпоинт берёт деньги за GPU-секунды, а не за настенные часы.
RAG и векторный слой работают на объёме запросов
Точка безубыточности векторного поиска измеряется в запросах в месяц, и цифра, которая обычно фигурирует, — около 60–80 миллионов запросов до того момента, когда self-hosting выгоднее управляемых тарифов. Воспринимайте это как приблизительный ориентир, а не как прайс-лист — цифра меняется в зависимости от размера индекса, числа реплик и приемлемого бюджета задержки. Ниже этого диапазона вы платите инженеру за присмотр за индексом, который управляемый сервис обслужит дешевле, чем его зарплата. Генерация эмбеддингов — отдельный расчёт, и это дешевле всего для самостоятельного размещения из всего, что здесь обсуждается, — модель небольшая, а работа прекрасно пакетируется.
Четыре нагрузки, четыре порога — и никаких причин переносить их все одновременно.
Покупать железо? Кризис памяти 2026 года говорит: арендуйте
Любой расчёт окупаемости, написанный до середины 2026 года, основан на ценах, которых больше нет. В своё время совет был разумным: купите сервер, амортизируйте за три года, окупите аренду к 14-му месяцу. Потом рынок памяти сломался.
Рост ~87% для неизменившегося GPU
NVIDIA RTX PRO 6000 Blackwell 96GB — самый наглядный пример, потому что продукт не изменился. В начале 2025 года он стоил в рознице $8 565 (с минимумом предзаказа $7 673), в июне 2026 года достиг $13 250, а к августу 2026 — $16 000 (igor'sLAB). Примерно 87% за около 18 месяцев, и NVIDIA не дала никаких официальных объяснений.
Прогоните это через таблицу образца 2025 года — и месяц окупаемости примерно удваивается. Сборка рабочей станции на одной карте, которую вы планировали в $12 000 all-in, теперь ближе к $20 000 — ещё до покупки RAM.
Почему HBM поглотил поставки DRAM
Спрос на GPU — только половина истории. Важно то, что этот спрос сделал с фабриками памяти: высокополосная память теперь занимает около 23% мировых мощностей по производству DRAM-пластин — по сравнению с 8% в 2024 году, — поскольку HBM приносит в 3–5 раз больше дохода с пластины, чем обычный DDR5 (DatacenterDisk). Фабрики перенаправили пластины туда, где деньги. В результате цены на серверные DDR5 ECC RDIMM выросли примерно на 100–116% с Q1 2025 по Q1 2026, так что оперативная память рядом с вашими GPU пострадала не меньше, чем сами ускорители. Вы чувствуете это дважды в одной сборке: карта и 1 ТБ системной RAM под ней.
Что должен учитывать план амортизации, составленный в 2026 году
Рассчитывайте, что искажение переживёт ваше решение о покупке. Goldman Sachs в мае 2026 года спрогнозировал дефицит DRAM в 4,9% на год — самый широкий за 15 лет — плюс дефицит HBM в 5,1%, и большинство аналитиков не ожидают значимого облегчения до конца 2027 года (Wccftech). Трёхлетний план амортизации, начатый сегодня, проведёт первые два года внутри дефицита.
Поэтому рассчитывайте вариант покупки по ценам приобретения августа 2026 года, а не по цифрам 2025 года, которые до сих пор фигурируют в рейтинговых страницах, и не рассчитывайте на более дешёвое обновление через год. Если цифры сходятся только с ценами на железо 2025 года — арендуйте. Аренда — это способ сохранить возможность купить в 2028 году.
Контроль и соответствие нормам: то, что упускает таблица
Некоторые гарантии можно получить, только запустив веса самостоятельно. Большинство из тех, что команды называют своей причиной для self-hosting, теперь можно купить.
Что self-hosting действительно даёт и что только кажется, что даёт
Запуск собственного inference даёт вам четыре вещи, которые никакой договорной пункт не заменит: веса модели, не меняющиеся в соответствии с расписанием устаревания вендора; ни один запрос с данными не покидает ваш VPC; никаких ограничений скорости, навязанных чужим планированием мощностей; и возможность дообучать или квантизировать без чьего-либо разрешения. Если в вашем реестре рисков есть строка о том, что версия модели может быть выведена из эксплуатации в разгар аудита, — это реальный аргумент за владение артефактом.
Список того, что self-hosting только кажется, что даёт, длиннее. Резидентность данных, шифрование в покое, обязательства не обучаться на ваших данных, доказательства SOC 2, журналы аудита, региональная обработка — всё это покупается как договорные условия плюс селектор региона, и уже давно. Платить премию за GPU ради них — это платить дважды. Риск, стоящий за этими разговорами, — штрафная математика, а штрафная математика не волнует, кто стоит у стойки с железом. Регуляторы выписали €7,1 млрд по 2 245 штрафам GDPR к началу 2026 года, при этом ответственность по GDPR достигает 4% мирового оборота, а по AI Act — до 7%. Self-hosted модель с неправильной конфигурацией провалит аудит так же быстро, как hosted.
Регуляторный сброс 2026 года изменил дедлайны, на которые вы ориентируетесь
Проверьте дату на любом соответствующем нормам графике, по которому работает ваша команда. Обязательства по высокорисковым системам в рамках EU AI Act были перенесены Digital Omnibus 2026, так что дедлайн 2 августа 2026 года, который несколько широко цитируемых сравнительных страниц всё ещё публикуют, устарел — уточните актуальные даты у своих юристов, прежде чем тратить против них. Если вы утвердили бюджет на self-hosting в начале 2026 года, чтобы успеть до этой даты, срочность, на которой он строился, исчезла, и расходы заслуживают пересмотра.
Это важнее всего для регулируемых отраслей. Команды, подбирающие инструменты ИИ для здравоохранения и наук о жизни, скорее всего, заложили стоимость частного развёртывания против дедлайна, который сдвинулся.
Суверенное управляемое облако — промежуточный путь
Аргумент резидентности ослаб в 2026 году. Суверенные облачные регионы, укомплектованные и управляемые внутри ЕС, теперь доступны как управляемый вариант, которого не существовало, когда писалось большинство сравнений open source vs SaaS, которые вы найдёте в сети, — поэтому проверьте, что ваш предпочтительный гиперскейлер предлагает в регионе, прежде чем рассчитывать стоимость узла. Вы можете получить обработку данных только в ЕС, не нанимая никого для присмотра за vLLM в 2 часа ночи.
Порядок, который выдерживает проверку, таков. Если требование — резидентность данных, покупайте суверенное управляемое облако. Если — постоянство весов или неограниченное дообучение, используйте self-hosting. Если это строка в вопроснике «данные не должны покидать наш контроль» — сначала выясните у аудитора, что он примет, прежде чем подписывать договор на узел.
Насколько открытые веса отстают на самом деле?
Четыре месяца. Это измеренное отставание, и именно это число должно заменить всё, во что вы сейчас верите относительно отставания открытых моделей на целое поколение.
Четыре месяца и шесть индексных пунктов
Epoch AI дала этому цифровое выражение, отслеживая лучший open-weight релиз против закрытого frontier на Epoch Capabilities Index с 1 января по 28 мая 2026 года: отставание в 4 месяца, или 8 пунктов ECI с 90%-м доверительным интервалом от 7 до 11. Artificial Analysis измеряет то же самое иначе и приходит к тому же выводу. Лидеры открытых моделей набирают 52–54 по Intelligence Index против 60 у GPT-5.5 — разрыв в 6 пунктов, который год назад составлял 13.
Итак, разрыв реален и сокращается. Для большинства производственных нагрузок (классификация, извлечение данных, резюмирование, ответы с поиском по базе знаний, первичный код) frontier четырёхмесячной давности вполне годится. Для сложного логического хвоста — нет, и никакая работа с промптами не закроет 8 пунктов ECI. Определите нагрузку, прежде чем выбирать сторону. Открытые веса, отслеживаемые в нашем каталоге, обновляются достаточно быстро, чтобы модель, которую вы тестировали в марте, уже не была той, что вы развернули бы сегодня.
Разрыв между внедрением и производством, который стоит реальных денег
Открытые модели проигрывают на этапе запуска, а не на уровне возможностей. Опрос 2026 State of Open Source AI (N=1 410) показал: 79% разработчиков ИИ внедряют открытые модели, но только 53% доводят их до production — против 71% внедрения и 63% production для закрытых моделей. Их больше пробуют и меньше запускают.
Этот разрыв в 26 процентных пунктов — инженерное время, которое вы платите, но не фиксируете в TCO-таблице. К тому же с масштабом ситуация ухудшается, а не улучшается: доля production для закрытых моделей растёт с 54% у небольших компаний до 73% у предприятий, тогда как у открытых она почти не меняется — от 53% до 57%. Организации с наибольшим числом platform-инженеров чаще всего отказываются от открытых развёртываний — это противоположно тому, что обещает pitch в пользу self-hosting. Закладывайте бюджет на попытки, которые не дойдут до запуска.
Пути миграции: что на самом деле требует переход
Сам переход дёшев. Дорого обходится оценочная работа, которую вы пропустили перед переходом, — и за которую вы платите инцидентами в production.
Замена base URL и задокументированные исключения, заслуживающие упоминания
vLLM поставляется с OpenAI-совместимым сервером, поэтому для простого chat completion миграция — это base URL и алиас модели. Укажите существующему клиенту ваш эндпоинт, смените model с gpt-5-mini на то, что вы обслуживаете, остальной код не трогайте. Это та часть, которую каждый конкурент считает чёрным ящиком, и она действительно лёгкая половина.
Исключения — там, где команды теряют неделю. Structured outputs и строгое принудительное применение JSON-схемы ведут себя по-разному на разных serving-стеках, поэтому всё, что зависит от гарантированно корректных аргументов функций, требует тестирования на реальных данных, а не smoke-теста. Параллельные вызовы инструментов — частый пробел. Кеширование промптов специфично для провайдера, и если ваша модель стоимости предполагала кешированные входные тарифы на стороне SaaS, эта скидка за вами не следует. Поведение при длинном контексте деградирует в других точках, чем рекламирует контекстное окно, и токенизаторы тоже различаются — значит, бюджеты на основе подсчёта токенов и логика усечения требуют перекалибровки.
Создайте eval-набор до перехода, а не после
Если вы не можете измерить качество на своём трафике, вы не сможете понять, важно ли для вашего случая отставание в четыре месяца по возможностям. Зафиксируйте несколько сотен реальных production-запросов с ответами, оцените их так, как ваш бизнес их оценивает, затем прогоните кандидата в открытых моделях на том же наборе. Сделайте это до того, как провизионируете GPU.
- Залогируйте 200–500 реальных запросов с ответами и любыми downstream-сигналами, которые вы уже отслеживаете (лайки, правки, повторы, эскалации).
- Оцените текущий SaaS-вывод, чтобы установить базовую линию. Вам нужна цифра, которую вы защищаете, а не ощущение.
- Прогоните open-weight кандидата сначала через API, — DeepInfra предлагает Llama-3.3-70B по $0,10 за ввод / $0,32 за вывод на миллион токенов (DeepInfra), и инфраструктурных затрат на тестирование нет.
- Только если качество выдерживает и объём это оправдывает — переходите на выделенную мощность.
Гибридный вариант по умолчанию: маршрутизация по классу запроса вместо полной замены
Разделяйте трафик по ценности каждого запроса. Классификация, извлечение данных, резюмирование и переформулировка для поиска прекрасно работают на модели 8B по $0,02/$0,04 за миллион токенов (DeepInfra), а сложный логический хвост идёт на Sonnet 5 по $2/$10 (Anthropic). Если 80% ваших вызовов — дешёвый класс, вы срезаете большую часть счёта, не ставя качество на одну модель.
Маршрутизация также даёт вам путь отступления, которого нет при полной замене. Serving-стеки и роутеры составляют значительную часть 128 AI-фреймворков в нашем каталоге, а open-source AI репозитории, с которых стоит начать, — те, что имеют OpenAI-совместимый интерфейс, потому что именно он обеспечивает откат одним изменением конфига.
Кому стоит переходить в 2026 году — и кому не стоит
Три профиля, у которых арифметика на их стороне. Три — у которых нет, и никакой энтузиазм platform-команды этого не исправит.
Три профиля, где self-hosting явно побеждает
Высокообъёмная транскрипция при стабильной нагрузке. Если вы прогоняете через конвейер, работающий по расписанию, более нескольких тысяч аудиочасов в месяц, вы можете держать карту занятой и обогнать порог AssemblyAI в $0,15/час (AssemblyAI). Пакетная работа — идеальная форма здесь, потому что вы управляете временем опустошения очереди, превращая поддержание карты занятой в задачу планирования, а не в надежду.
Регулируемые данные, которые не могут покидать ваш периметр, — где требование договорное, а не предпочтение. Оптимизация затрат в этом случае не цель. Вы покупаете ответ аудитору, и счёт за GPU — его цена.
Пятьдесят и более разработчиков на usage-based coding-ассистентах. При ~50 разработчиках счёт достигает около $110 000 в месяц против узла, который можно держать насыщенным, — премия в 3–9 раз, а при ~100 разработчиках (~$220 000/мес.) собственное железо окупается примерно за год (DoiT).
Три, где проигрывают только по арифметике
Команды менее ~10 разработчиков. При ~$22 000/мес. счёт за ассистента примерно равен стоимости узла, который эти 10 человек не смогут держать занятым (DoiT), а равенство не оправдывает дежурство on-call.
Те, у кого нагрузка скачкообразная и потребительская. Простаивающие GPU тарифицируются по полной ставке, а скачкообразная суточная кривая означает, что вы платите за пик, при среднем использовании, скажем, 20% от него. Serverless open-model API съедят этот профиль живьём.
Команды, чья планка качества находится на уровне frontier. Если ваши eval'ы проходят только на Fable 5.1 по $10/$50 за миллион токенов (Anthropic), self-hosted open-model — это другой продукт другого качества, а экономия покупает вам деградацию.
90-дневный тест перед тем, как вкладывать капитал
- Недели 1–2: замеряйте параллелизм, а не расходы. Логируйте запросы в полёте в минуту и найдите свой p95. Если он ниже 4 — остановитесь здесь.
- Недели 3–6: направьте 10% трафика на open-weight эндпоинты DeepInfra и прогоните существующий eval-набор. Для большинства стеков это замена base URL и алиас модели.
- Недели 7–12: арендуйте, не покупайте. Выделенный H100 по $2,20/час (DeepInfra) даёт реальную цифру утилизации менее чем за $1 700 в месяц — ту самую цифру, которую попросит ваш финансовый директор.
Если по итогам карта простаивает более 60% времени — ответ: управляемый open-weight API, и вы потратили один квартал на обучение вместо трёх лет амортизации.
Часто задаваемые вопросы
Действительно ли self-hosting open-source ИИ дешевле, чем подписки ChatGPT Business или Claude Team?
По прайсовым ценам на места — нет. Claude Team стоит $20 за место в месяц при годовом биллинге ($25 при ежемесячном), премиум-места — $100/$125, а Enterprise — $20 за место в год плюс использование по тарифам API (Anthropic pricing). Ни один арендованный GPU не приближается к $20 за голову, поэтому flat-rate подписки — самое сложное в ИИ, что можно побить своим железом. Self-hosting начинает конкурировать только тогда, когда ваша команда работает по usage-based биллингу, где собственные инженеры DoiT в среднем тратят около $2 200 на разработчика в месяц (DoiT).
При каком ежемесячном расходе self-hosting LLM окупается в 2026 году?
Примерно при $15 000–$25 000 в месяц usage-based API-расходов, что при наблюдаемых DoiT $2 200 на разработчика в месяц составляет около 7–12 активных пользователей (DoiT). Цифра меняется больше в зависимости от облачного провайдера, чем от модели: тот же узел 8xH100 за 730-часовой месяц стоит около $12 600 на Nebius spot, $22 500 на Nebius on-demand, $40 200 на AWS и $71 800 на Azure (DoiT). Численность — в любом случае неправильная единица. Только 10–20% команды разработчиков имеет активный запрос в любой момент, поэтому десять разработчиков — это две-три параллельные сессии, в лучшем случае половина мощности узла (DoiT).
Сколько GPU-часов нужно, чтобы побить $0,36 за аудиочас API Whisper?
Это решает пропускная способность, а часы важны лишь через тариф, по которому тарифицируются. OpenAI берёт $0,006/мин за Whisper и gpt-4o-transcribe, то есть $0,36 за аудиочас, и $0,003/мин ($0,18/час) за gpt-4o-mini-transcribe (OpenAI). На RunPod L40S 48GB по $0,79/час Community Cloud (RunPod) вам нужна пропускная способность лучше ~2,2x реального времени, чтобы побить $0,36, ~4,4x — чтобы побить мини-уровень, и ~5,3x — чтобы побить $0,15/час Universal-2 от AssemblyAI (AssemblyAI). Время простоя GPU считается против вас, поэтому развёртывание выигрывает только при стабильной очереди, а не при скачкообразном дневном трафике.
Можно ли использовать open-source ИИ бесплатно в коммерческих целях?
Нет, и именно на моделях изображений команды попадаются. Сообщается, что веса FLUX.1 [dev] распространяются под некоммерческой лицензией, что означало бы необходимость платной лицензии Black Forest Labs для коммерческого развёртывания, — поэтому прочитайте условия, прежде чем строить на них планы. Даже при полностью разрешительных весах вычисления не бесплатны: DeepInfra предлагает Llama-3.3-70B-Instruct-Turbo по $0,10 за ввод и $0,32 за вывод на миллион токенов, а Meta-Llama-3.1-8B — по $0,02/$0,04 (DeepInfra), что дешевле, чем большинство команд могут запустить те же веса сами на выделенном H100 за $2,20/час.
Нужно ли использовать self-hosting для соответствия GDPR и EU AI Act?
Нет. Соответствие нормам — это место хранения данных, соглашения об обработке и документация, ничто из которых не требует владения inference-стеком. Ставки реальны (регуляторы выписали €7,1 млрд по 2 245 штрафам GDPR к началу 2026 года, а ответственность достигает 4% мирового оборота по GDPR и до 7% по AI Act, согласно Kiteworks), но управляемые и суверенные варианты хостинга в регионе ЕС теперь покрывают большинство требований сотрудника по защите данных. Используйте self-hosting, когда договор или регулятор специально запрещает стороннюю обработку, — а не как общую страховку.
Покупать GPU или арендовать их во время дефицита памяти 2026 года?
Арендовать, если только у вас нет многолетней нагрузки, которая держит карты занятыми. NVIDIA RTX PRO 6000 Blackwell 96GB вырос с $8 565 в рознице в начале 2025 до $13 250 в июне 2026 и $16 000 к августу 2026 — примерно на 87% за неизменившийся продукт (igor'sLAB). Причина — память: HBM теперь занимает около 23% мировых мощностей по производству DRAM-пластин против 8% в 2024 году, а серверные DDR5 ECC RDIMM подорожали примерно на 100–116% с Q1 2025 по Q1 2026 (DataCenterDisk). Goldman Sachs прогнозирует дефицит DRAM в 4,9% на 2026 год — самый широкий за 15 лет, а облегчения до конца 2027 года аналитики не ожидают (Wccftech), — поэтому рассчитывайте на повышенные цены покупки и используйте разброс арендного рынка — от $2,20/час за выделенный H100 на DeepInfra до $4,29/час на Lambda.