

Чтобы проверять факты в ответах ИИ и не утонуть в этом, перестаньте пытаться верифицировать каждое предложение. Выделите утверждения, ранжируйте их по тому, что сломается, если они окажутся неверными, и сверяйте с первоисточником те, на которых держится ваш материал. Ни аккуратная ссылка, ни ответ модели «да, я уверена» ничего не доказывают.
Цена пропуска этого шага продолжает расти. В публичной базе судебных решений, где фигурируют галлюцинации ИИ, на момент написания статьи значилось 2125 дел, и 1193 из них приходятся только на этот год (AI Hallucination Cases database). Ранее в этом году KPMG отозвала опубликованный отчёт из-за явных галлюцинаций ИИ: организации, о которых шла речь в отчёте, назвали его утверждения об использовании ими ИИ «либо неверными, либо вводящими в заблуждение» (TechCrunch).
Галлюцинации никуда не делись. Их просто стало сложнее заметить: текст вокруг них гладкий, а поддельные ссылки выглядят как настоящие. Ниже вы найдёте типы утверждений, где ошибки встречаются чаще всего, объяснение, почему самопроверка не работает, процесс проверки с учётом рисков с готовыми промптами и честный разбор инструментов с опорой на источники, таких как Gemini Notebook (бывший NotebookLM), Perplexity и Consensus.
Поддельные цитаты стали жанром судебной практики
Юристы столкнулись с этим первыми, и сразу публично. В базе Дамьена Шарлотена собраны решения, в которых суд или трибунал установил или счёл вероятным, что сторона опиралась на галлюцинированные материалы, чаще всего на выдуманную судебную практику. Подсчитать все когда-либо поданные поддельные ссылки база не пытается, в неё попадают только те, которые суд разобрал в письменном виде. Но даже с таким узким фильтром кривая растёт круто.
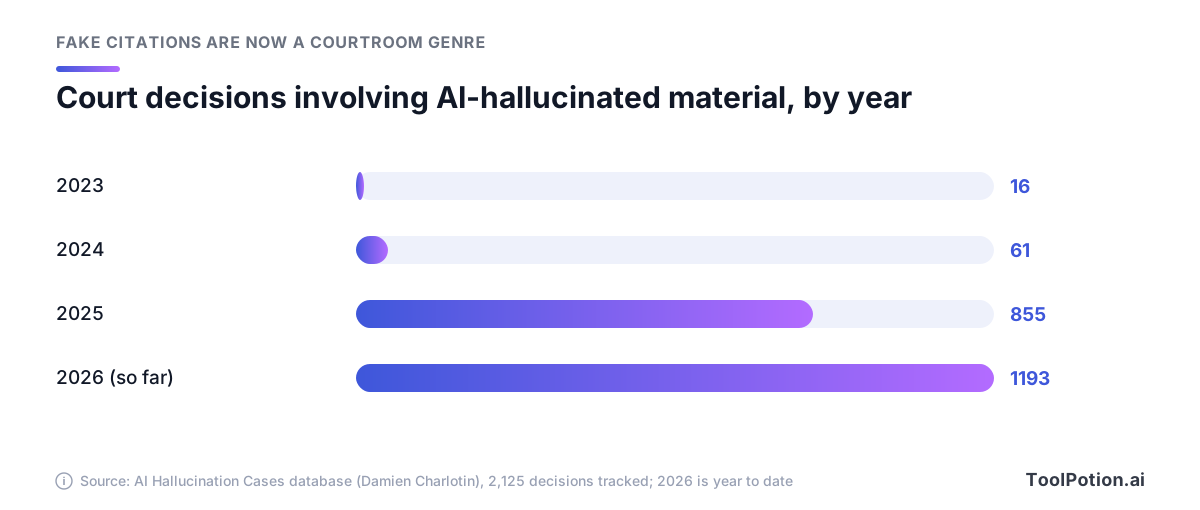
Столбец 2026 года охватывает лишь часть года и уже превысил 2025-й. На людей, выступавших без адвоката, приходится 1227 отслеживаемых решений, на юристов — 840, а в 33 делах галлюцинированные материалы исходили от судьи. Лидируют США с 1459 решениями, за ними следуют Канада (223) и Австралия (112).
Дело, с которого всё началось, остаётся лучшим уроком. В деле Mata v. Avianca в 2023 году юрист из федерального дела в Нью-Йорке спросил ChatGPT, настоящее ли одно из дел, которые тот ему выдал. Модель ответила, что да. После повторного вопроса она заявила, что дело «действительно существует и его можно найти в базах юридических исследований, таких как Westlaw и LexisNexis» (CNN). Дела не существовало, а суд оштрафовал юристов и их фирму на $5000. В письменных показаниях под присягой юрист сказал, что «не знал о возможности того, что содержание может быть ложным».
С тех пор суммы выросли. В деле Couvrette v. Wisnovsky федеральный суд в Орегоне обнаружил в документах истцов пятнадцать сфабрикованных ссылок и семь искажённых цитат. Суд исключил эти документы из дела, отклонил иски без права повторной подачи и назначил санкции и возмещение издержек на $110 204 — рекордную сумму среди американских дел в базе. Если вы используете ИИ в юридической работе, в нашем руководстве по ИИ для юридической работы разобраны более безопасные варианты.
Суды — лишь самая заметная арена. Deloitte согласилась на частичный возврат денег за обзор для правительства Австралии стоимостью $440 000: в нём ссылались на несуществующие отчёты университетских профессоров и привели выдуманную отсылку к реальному судебному решению. Позднее фирма сообщила, что использовала цепочку инструментов на базе GPT-4o от Azure OpenAI (The Guardian). EY в этом году отозвала отчёт о программах лояльности, в котором, судя по всему, были поддельные сноски, — об этом сообщалось в том же материале TechCrunch, где писали про KPMG. А в 2025 году Chicago Sun-Times напечатала синдицированный список летнего чтения, в котором 10 книг из 15 оказались выдуманными, сообщало NPR.
Где ошибается ИИ
Модели почти не делают орфографических ошибок, а исследователи OpenAI объясняют, почему ошибки переместились в другое место. Орфография подчиняется закономерностям, которые большая модель усваивает, но «произвольные редкие факты, например день рождения питомца, нельзя предсказать по одним лишь закономерностям, поэтому они приводят к галлюцинациям» (OpenAI). Когда исследователи спросили популярный чат-бот, как называлась докторская диссертация одного из авторов самой статьи, он дал три разных ответа. Ни один не был верным.
Отсюда получается карта. Ошибки группируются в нескольких типах утверждений, и самые опасные из них — те, что выдают себя за доказательство.
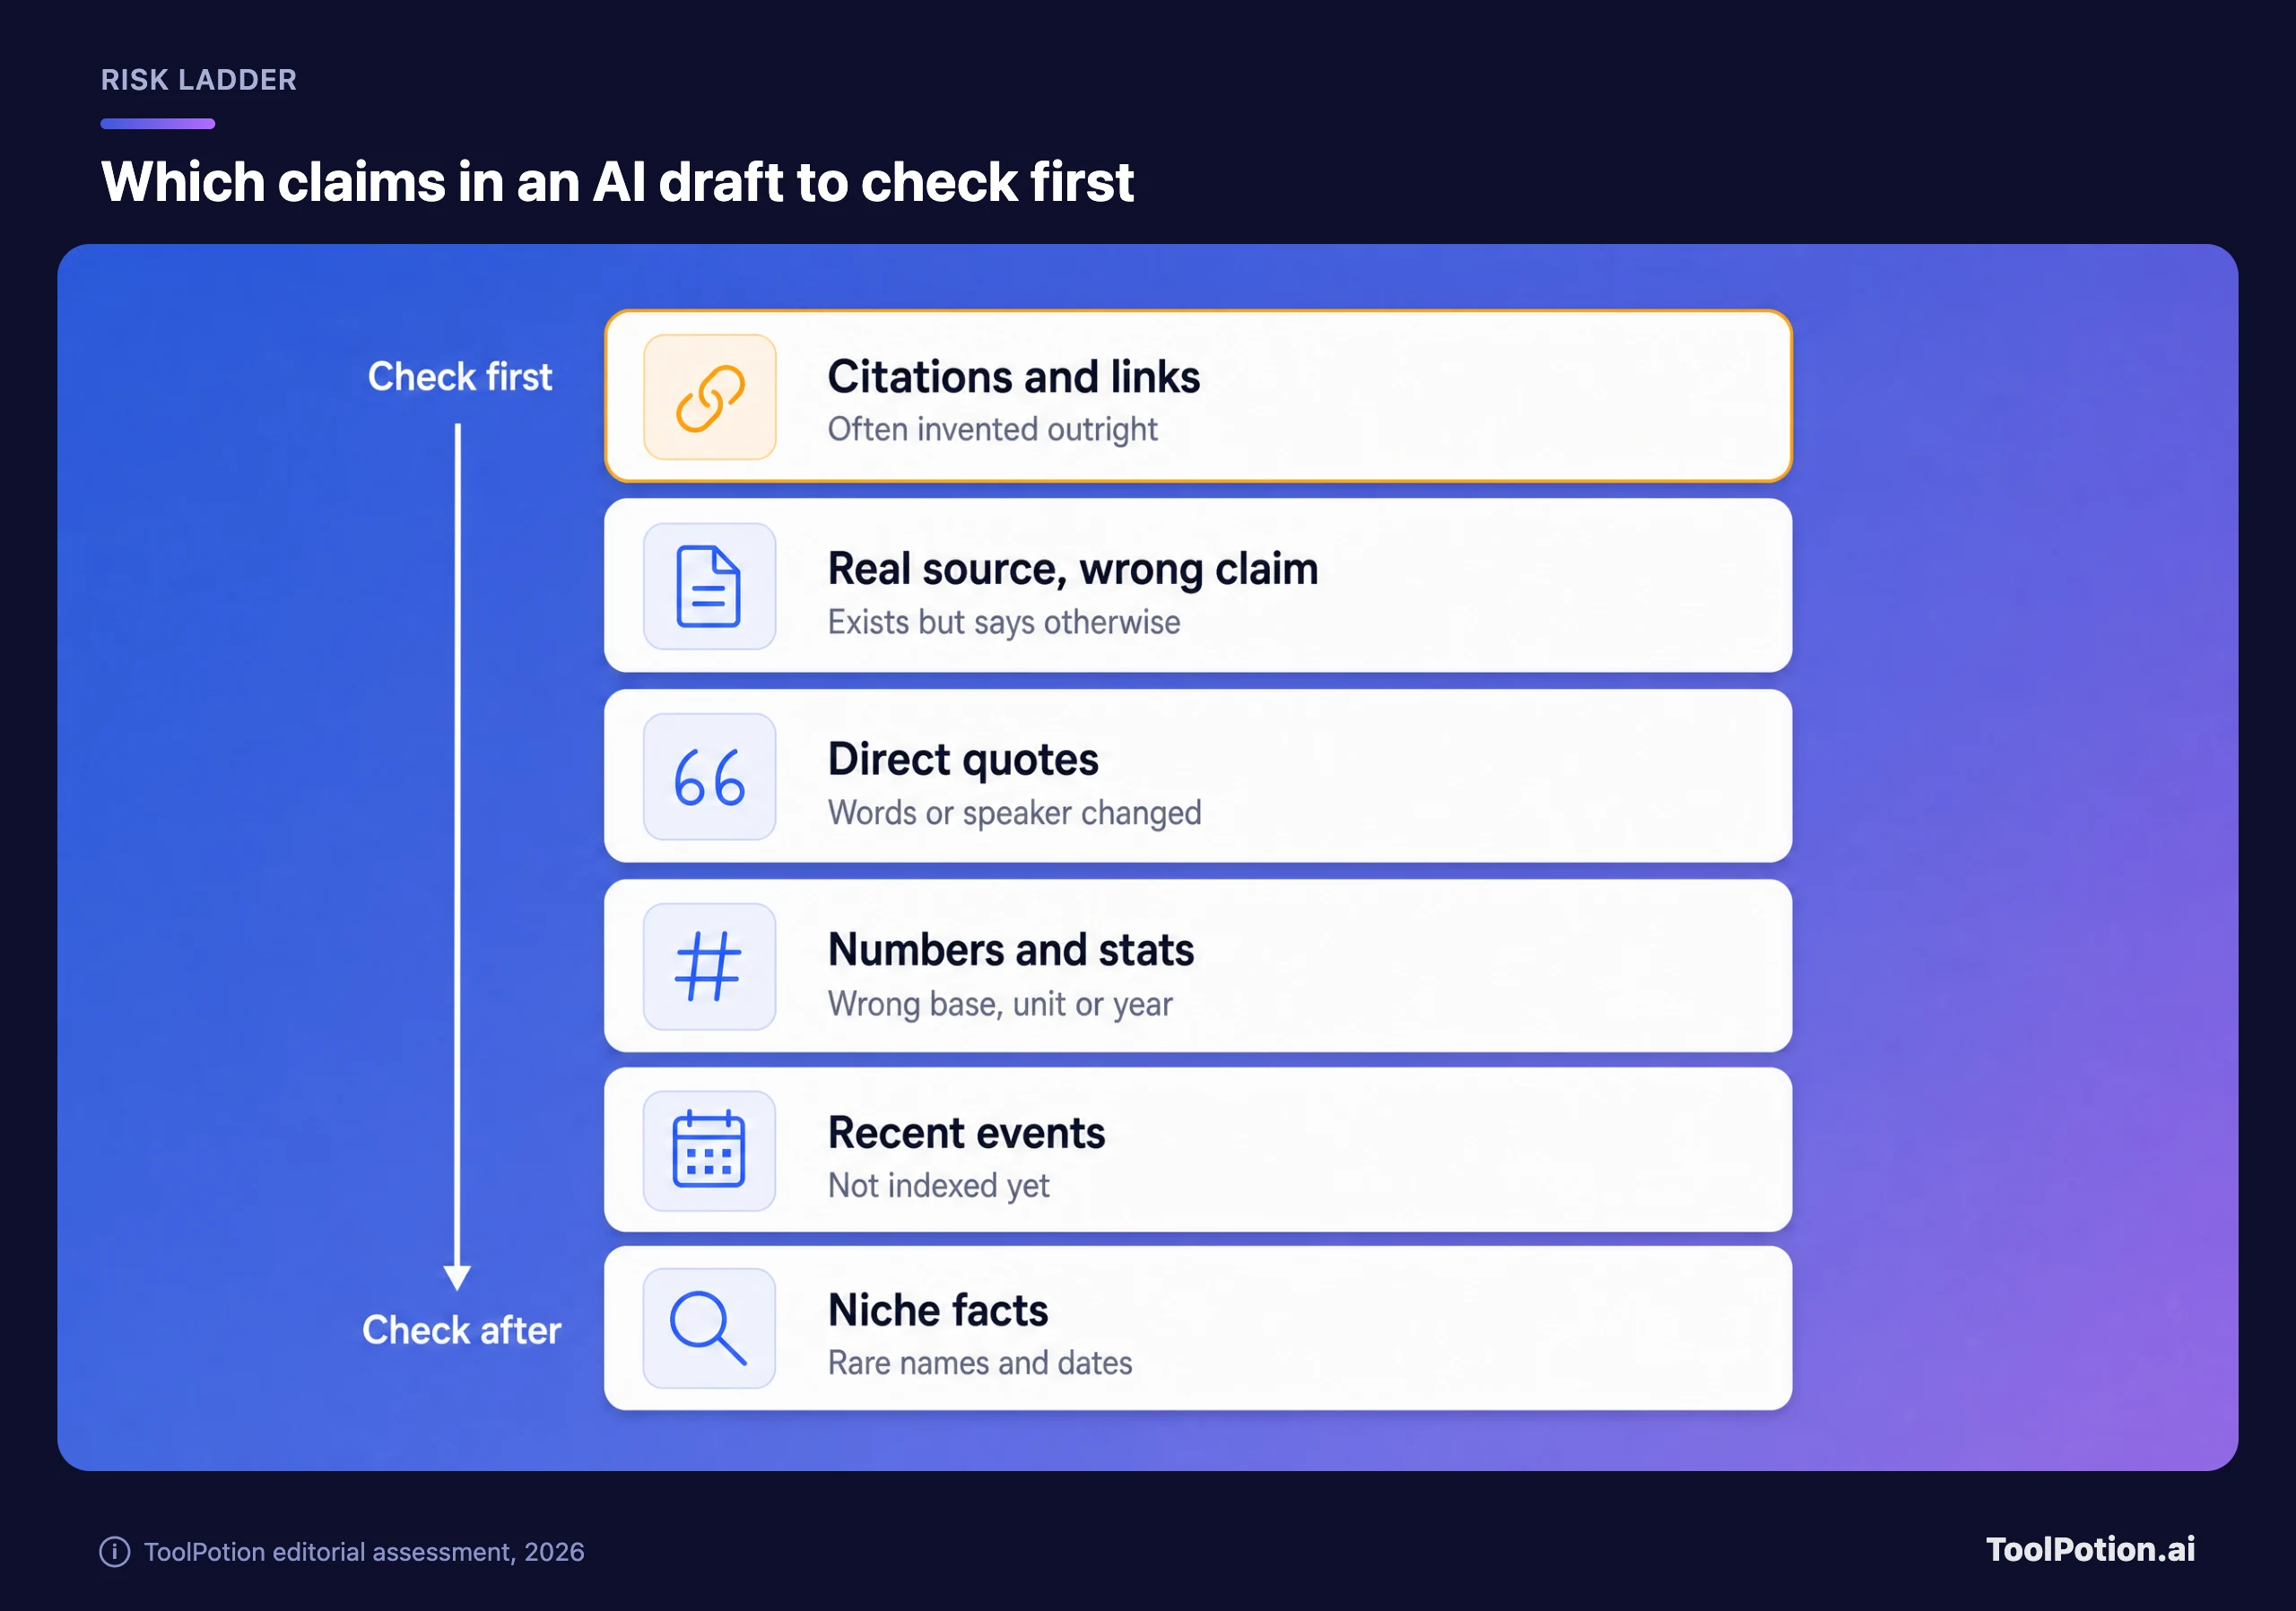
Цитаты стоят на вершине, потому что ломаются двумя способами. Одни выдуманы целиком: в 2025 году Tow Center при Колумбийском университете прогнал 1600 запросов через восемь поисковых инструментов с ИИ, прося каждый назвать источник фрагмента новости, и в сумме инструменты ошиблись более чем в 60% случаев, а Grok 3 в 154 из 200 цитат отправил на страницы с ошибками (Tow Center). Другие реальны, но приведены для того, чего в них нет. В базе Шарлотена 894 решения касаются искажённых материалов, и ещё 1752 — фабрикации. Рабочая ссылка этот второй тип не выявит.
Дальше идут цитаты. В базе 572 решения с ложными цитатами, а справочный центр самой OpenAI называет «выдуманные цитаты, исследования, ссылки или отсылки к несуществующим источникам» среди известных сбоев ChatGPT (OpenAI Help). Числа ломаются тише: реальная цифра, но не за тот год, проценты вместо процентных пунктов, региональная цена, выданная за глобальную.
Актуальность — отдельная ловушка. В документации Perplexity для разработчиков сказано, что галлюцинации наиболее вероятны, когда информация закрыта логином или пейволом, когда поиск возвращает «связанные, но не совпадающие результаты» или «когда совсем свежая информация ещё не проиндексирована» (Perplexity docs). Исследование 2025 года под руководством BBC, в котором разобрали более 3000 ответов на новостные вопросы от ChatGPT, Microsoft Copilot, Google Gemini и Perplexity, выявило серьёзные проблемы с точностью, включая устаревшую информацию, в 20% из них.
Есть и вопрос тона. В тесте Tow Center ChatGPT неверно определил источник 134 статей, но выразил неуверенность лишь 15 раз в 200 ответах, а платные тарифы некоторых инструментов отвечали правильно на большее число вопросов и при этом чаще уверенно ошибались. На справочной странице OpenAI сказано прямо: «Модель может выражать высокую уверенность даже в неверных ответах». В ответах ИИ уверенный тон почти ничего не говорит о точности.
Почему просьба перепроверить себя не помогает
Очевидный shortcut — вставить черновик обратно и спросить, всё ли в нём верно. Как это работает, уже показало дело Mata v. Avianca, и исследования это подтверждают. В статье, представленной на ICLR 2024, обнаружили, что модели «с трудом исправляют свои ответы без внешней обратной связи, а порой их результат после самокоррекции даже ухудшается» (Huang et al.).
Причина кроется в обучении. Исследователи OpenAI утверждают, что «стандартные процедуры обучения и оценки поощряют угадывание, а не признание неопределённости», как экзамен с вариантами ответа поощряет слепой выбор больше, чем пустую клетку. Они также признают, что точность «никогда не достигнет 100%», потому что на некоторые реальные вопросы ответить нельзя. Модель, проверяющая собственный черновик, опирается на те же знания, которые породили ошибку, поэтому проверка склонна её повторять.
У самопроверки всё же есть применение. Статья 2023 года о Chain-of-Verification показала, что помогает структурированная версия: модель пишет черновик ответа, формулирует проверочные вопросы, отвечает на них независимо от черновика, а затем исправляет текст. Это сократило число галлюцинаций в нескольких задачах. Используйте это, чтобы находить подозреваемых, а не чтобы их оправдывать.
Опора на источник — не то же самое, что правильность
Если дать модели источник для работы, доля ошибок снижается, но не до нуля. Публичный рейтинг Vectara просит модели суммировать более 7700 статей, используя только факты из каждой, а затем оценивает резюме собственной моделью обнаружения. Даже в такой простой постановке каждая модель из списка добавляет в какую-то долю резюме неподтверждённое содержание (Vectara).
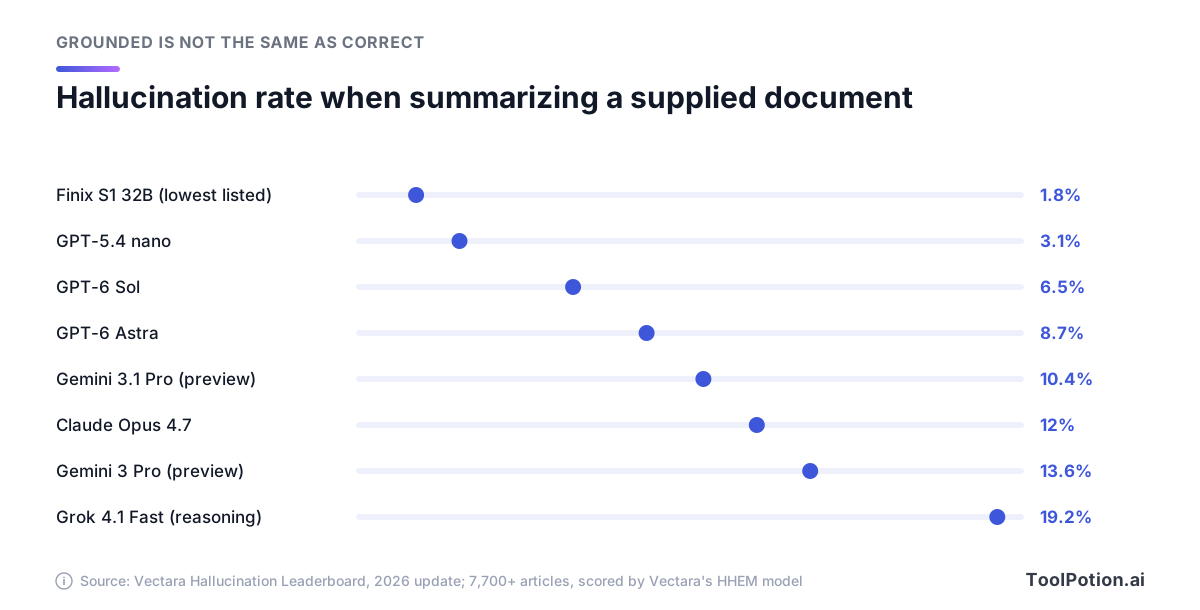
В последнем обновлении GPT-6 Sol добавил неподтверждённый материал в 6,5% резюме, а Claude Opus 4.7 — в 12%. Модель, оценивающая другую модель, несовершенна, Vectara прямо говорит, что тест не охватывает все виды галлюцинаций, а в таблице пока нет всех актуальных релизов. Но направление понятно. Исследование 2024 года об инструментах юридического поиска, которые достают реальную судебную практику, включая Lexis+ AI и AI-Assisted Research от Westlaw, показало, что они всё равно галлюцинировали в 17–33% случаев. Опора на источник сужает проблему до одного вопроса: говорит ли это источник? Задавать его всё равно придётся вам.
Процесс проверки, выстроенный по риску
Решение — сортировка. Большая часть черновика — соединительная ткань: рамка, переходы и мнения, которые вы всё равно готовы отстаивать. Материал держится на небольшом наборе утверждений, и именно там ошибка причиняет ущерб. Сначала отсортируйте, потом тратьте время на проверку там, где это окупается.
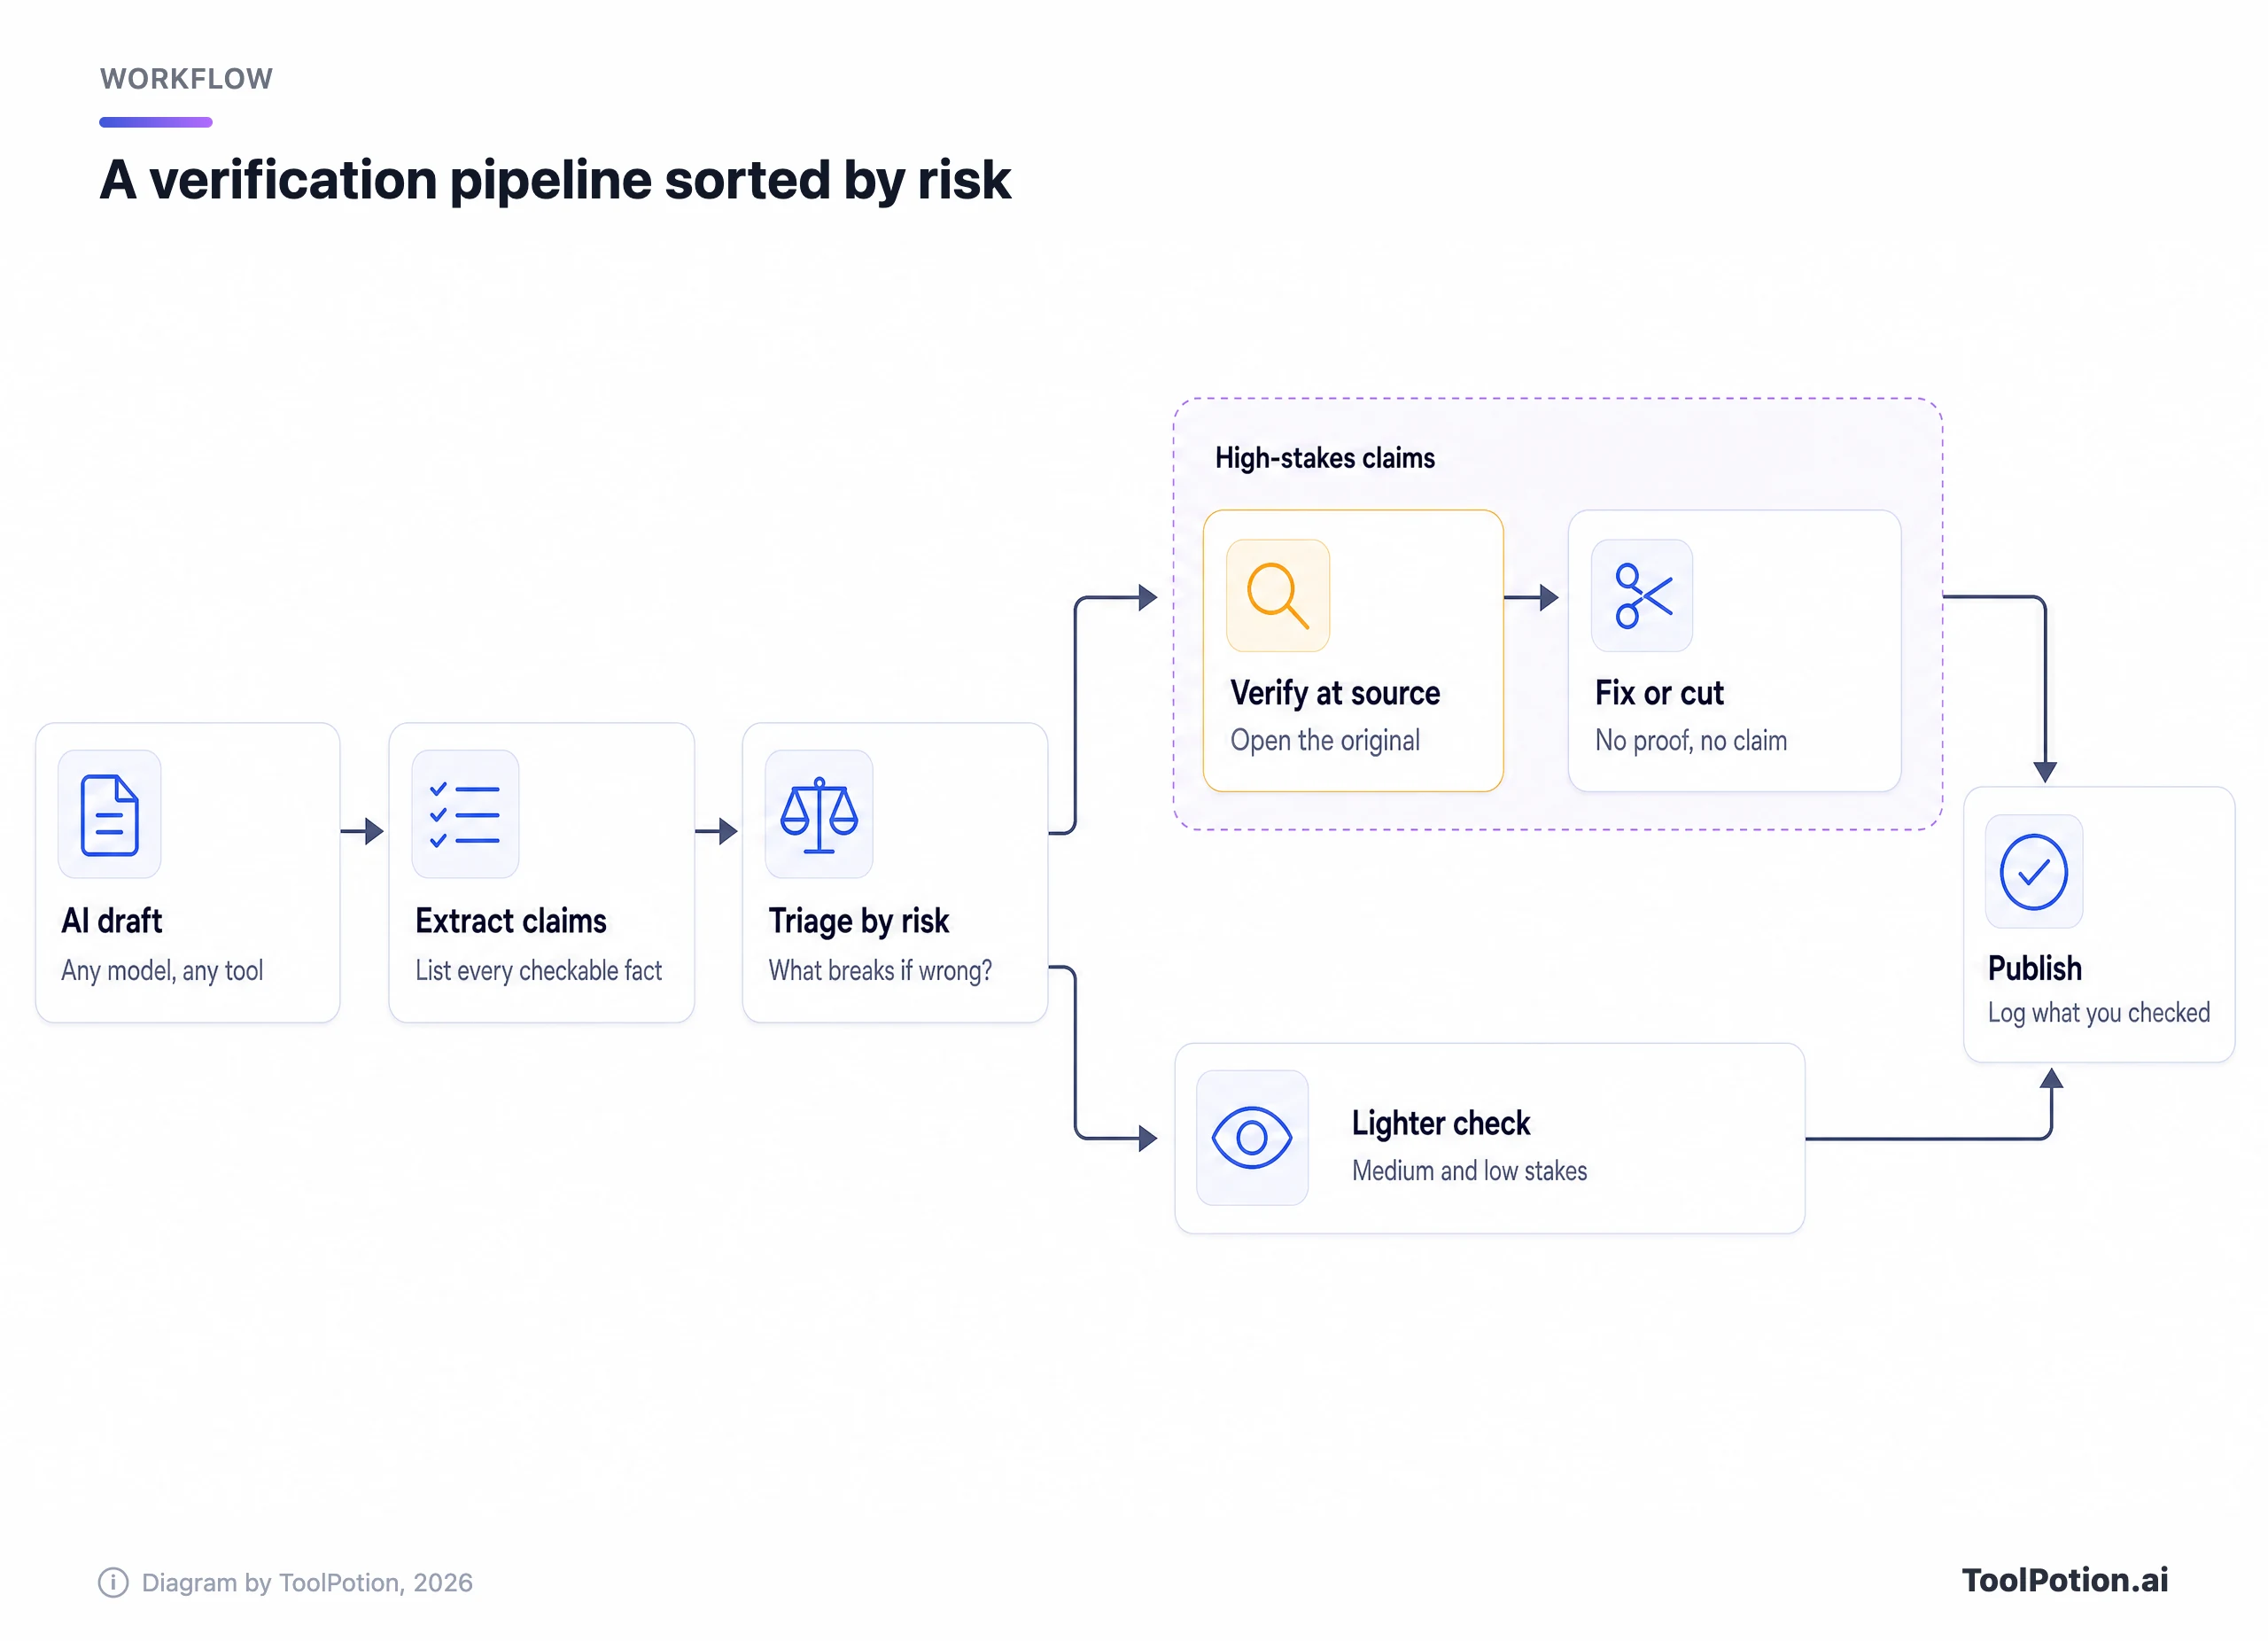
- Извлеките утверждения. Попросите модель перечислить все проверяемые высказывания в черновике: имена, числа, даты, цитаты, ссылки и причинно-следственные утверждения. Вы найдёте утверждения, о которых и не подозревали, что делаете их.
- Отсортируйте по ставкам. Спросите себя, что будет, если утверждение неверно. Всё юридическое, медицинское и финансовое относится к высоким ставкам, как и каждая ссылка, каждая прямая цитата, любая статистика в заголовке или резюме и любое утверждение об упомянутом человеке или компании. Вспомогательный контекст, который читатель может повторить, — средний уровень. Рамка, которую вы могли бы отстоять по памяти, — низкий.
- Проверьте высокий уровень по первоисточнику: судебное решение, документ из реестра, набор данных, страница самой компании, сама статья. Новость об исследовании — это не исследование.
- Средний уровень проверьте выборочно с помощью горизонтального чтения (о нём ниже), а низкому уровню достаточно редакторского прочтения.
- Исправьте, смягчите или вырежьте. Если вы не можете подтвердить утверждение за разумное время, уберите его или атрибутируйте прямо («по словам вендора»). Никогда не оставляйте утверждение только потому, что оно звучит правдоподобно.
- Ведите журнал. Одна строка на каждое утверждение высокого уровня — само утверждение, источник и место в нём, где найдено подтверждение, — занимает минуты и отвечает на вопрос, который рано или поздно зададут редактор, клиент или судья.
Соразмеряйте усилия с тем, как далеко уйдёт текст. Для мозгового штурма хватит внимательного прочтения. Для клиентской работы каждое утверждение высокого уровня нужно открыть в источнике. Если счёт за проверку выглядит слишком большим, в черновике, скорее всего, слишком много утверждений, а сократить часто быстрее, чем верифицировать.
Не уверены, к какому уровню относится ваш текст? Ответьте максимум на три вопроса ниже.
Обратите внимание, о чём спрашивает это дерево: куда уйдёт текст и что в нём есть, но не какая модель его написала. Более сильная модель меняет шансы. Но не меняет того, кто отвечает за ошибку.
Как проверять цитаты, цитируемые высказывания и числа
У каждого типа утверждений есть свой быстрый тест. Специальное ПО не нужно, нужна лишь дисциплина: выйти из чат-бота и открыть оригинал.
Ссылки на источники
Сначала проверьте существование. Ищите название, DOI, номер дела или URL в базе или поисковике, которые вы контролируете, а не в чат-боте, который это выдал. Затем проверьте подтверждение: откройте источник и найдите отрывок, который поддерживает предложение. Если не нашли за несколько минут, ссылка не прошла проверку. Следите и за версией. Tow Center обнаружил, что поисковые инструменты с ИИ часто указывали на синдицированные копии вместо оригинального издателя, а препринт может отличаться от опубликованной статьи.
Цитаты
Найдите характерную фразу из пяти-шести слов в кавычках. Если она нигде не находится или есть только на страницах, похожих на написанные машиной, считайте цитату выдуманной. Если она настоящая, прочитайте абзац вокруг неё и убедитесь в авторе, дате и смысле. Настоящая цитата, вырванная из контекста, вводит в заблуждение не хуже поддельной.
Числа
Пересчитайте всё, что можно. Уточните единицу (проценты или процентные пункты, в месяц или в год, какая валюта), год и знаменатель. Если в черновике сказано, что показатель удвоился, найдите оба числа. Статистика без названного источника в текст не попадает, как бы правдоподобно она ни выглядела.
Недавние события и вирусные утверждения
Проверяйте дату на каждом источнике и отдавайте предпочтение материалам, опубликованным после события. Если утверждение уже ходит по сети, Fact Check Explorer от Google ищет по опубликованным проверкам фактов и показывает, какая организация и как его оценила. Можно также загрузить изображение и узнать, проверяли ли его раньше.
Перед публикацией прогоните черновик по этому чек-листу. Первые четыре пункта считаются вдвойне.
Весовые коэффициенты следуют судебным данным: выдуманные ссылки, искажённые источники и ложные цитаты составляют большую часть этой базы. Если эти четыре пункта не отмечены, ничто другое в списке не сделает черновик безопасным для отправки.
Горизонтальное чтение для утверждений без бумажного следа
Некоторые утверждения приходят без ссылки, которую можно открыть. Для них перенимите привычку профессиональных фактчекеров. Группа Civic Online Reasoning из Стэнфорда, понаблюдав за работой фактчекеров, пришла к выводу, что «лучший способ узнать о сайте — горизонтальное чтение»: уйти со страницы и посмотреть, что о ней говорят другие источники, вместо того чтобы изучать саму страницу.
Майк Колфилд превратил эту привычку в четырёхшаговую процедуру SIFT (Caulfield). Она хорошо подходит к ответам ИИ с одной поправкой: источник, который вы изучаете, — это чат-бот плюс ссылка, которую он выбрал.
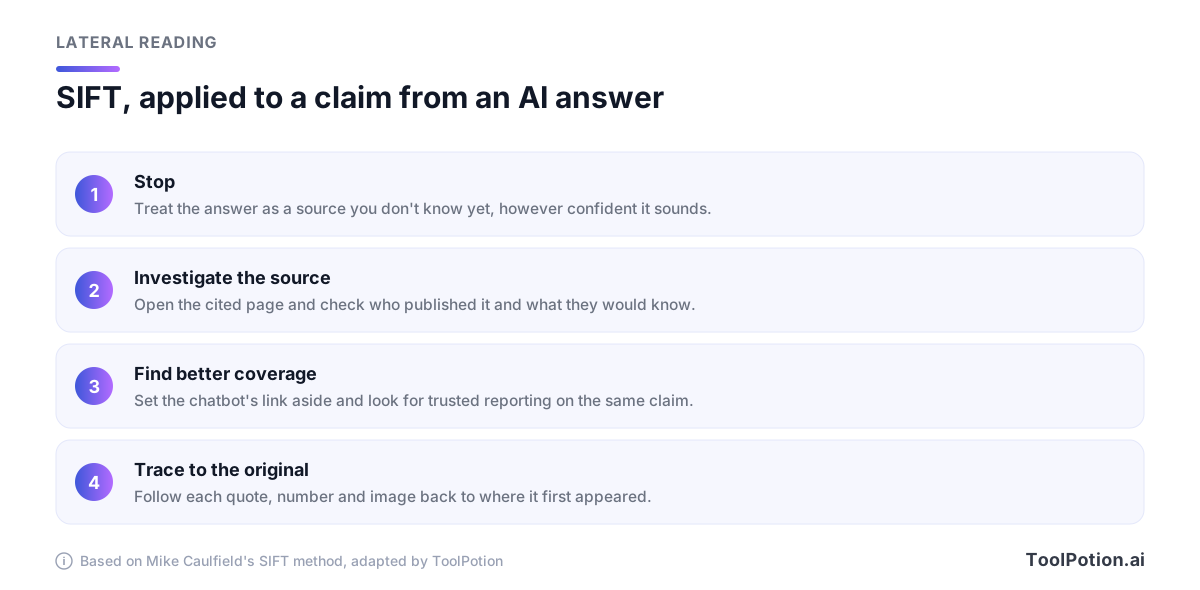
Больше всего с чат-ботами даёт третий шаг. Когда утверждение важнее статьи, которая его принесла, Колфилд советует «игнорировать источник, который до вас дошёл, и искать надёжные репортажи или анализ самого утверждения». Так что ищите утверждение заново, своими словами. Если у того, что должно широко освещаться, нет независимого освещения, ответ у вас в руках.
Горизонтальное чтение помогает и с источниками, которые модель находит сама. Настоящий URL на сайте, о котором вы никогда не слышали, — слабый источник, как бы аккуратно ИИ ни оформил ссылку.
Промпты, которые упрощают проверку
Промптом галлюцинации не убрать, но можно оформить ответ так, чтобы ошибки было легче поймать. Лучший путеводитель — документация самих вендоров. Anthropic говорит, что её рекомендуемые приёмы «существенно снижают галлюцинации», но «не устраняют их полностью» (Anthropic docs). Об общих привычках работы с промптами читайте в нашем практическом руководстве по промпт-инжинирингу.
Разрешите модели сказать «не знаю»
И Anthropic, и Perplexity советуют разработчикам явно разрешать модели признавать неопределённость или сообщать, что ничего не найдено. Почему это важно, показывает исследование OpenAI. В сравнении на бенчмарке SimpleQA модель, воздержавшаяся от ответа на 52% вопросов, ошиблась в 26%, а воздержавшаяся на 1% — в 75% при почти одинаковой точности. Используйте это как постоянную инструкцию:
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
Просите цитаты раньше выводов
Документация Anthropic рекомендует перед выполнением задачи извлекать из длинных документов дословные цитаты, а потом просить модель найти подтверждающую цитату для каждого утверждения и отозвать те, которые подтвердить не получилось. На практике это выглядит так:
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
Заставьте её отмечать почти совпадения и не требуйте краткости
В руководстве Perplexity есть правило, которое стоит позаимствовать: «Если вы находите связанные, но не совпадающие результаты (например, другой год, материнскую компанию или дочернюю), явно укажите на несоответствие перед ответом». Это ловит верный факт о неверном объекте — одну из самых трудных для глаза ошибок. Его примеры правил также требуют ссылаться на источники по домену и «не писать полные URL».
Важна и длина. Giskard, парижская компания по тестированию ИИ, выяснила, что просьба о кратких ответах делала GPT-4o, Mistral Large и Claude 3.7 Sonnet менее точными, потому что «когда их заставляют быть краткими, модели неизменно выбирают краткость вместо точности». То же исследование показало, что модели реже возражали против спорного утверждения, которое пользователь высказывал уверенно. Формулируйте вопросы нейтрально: «Правда ли, что X?», а не исходя из готового утверждения, как в «Объясни, почему X».
Извлеките утверждения и запустите дважды
Этот промпт обеспечивает первый шаг процесса. Прогоняйте его на любом черновике, в том числе на написанном вами самими.
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic также предлагает проверку best-of-N: запустить один и тот же промпт несколько раз и сравнить результаты, поскольку расходящиеся ответы указывают на вероятные галлюцинации. Это тот же симптом, что OpenAI увидела с тремя названиями диссертации. Расхождение между запусками показывает, куда смотреть. Совпадение ничего не доказывает.
Инструменты с опорой на источники помогают, но до определённого предела
Другой класс инструментов сужает то, на что может опираться модель. Вопрос «правда ли это?» превращается в «говорит ли это источник?», а проверить это быстрее. Но проверка от этого не исчезает.
Google в начале этого года переименовала NotebookLM в Gemini Notebook и оставила его отдельным исследовательским инструментом, которым, по словам Google, пользуются более 30 миллионов человек (Google). В чате он отвечает по добавленным вами источникам и «использует прямые цитаты, текст и изображения из ваших источников в качестве ссылок». Наведите курсор на ссылку, чтобы увидеть цитируемый текст, или нажмите, чтобы перейти к нему в контексте (Gemini Notebook Help). Это ускоряет проверку подтверждения. Но знайте и о пробелах: в справке Google сказано, что веб-страницы за пейволом не поддерживаются, а сноски и комментарии в файлах Google не импортируются. Более новые агентные функции чата, которые умеют искать в вебе и запускать код, помечены как экспериментальные с указанием «Обязательно перепроверьте».
Ответные поисковые системы вроде Perplexity прикрепляют ссылки к каждому ответу, и это реальный шаг вперёд по сравнению с чат-ботом без источников. Но ссылки всё равно надо открывать. Perplexity ошибся в 37% запросов в тесте Tow Center 2025 года (с тех пор инструменты изменились), а в справке самого Google по Gemini отмечено, что «не все ответы содержат связанные ссылки или источники».
Для исследовательских утверждений есть академические поисковики, которые опираются на статьи, а не на открытый веб. Consensus ищет по рецензируемой литературе и заявляет, что если «не может найти достаточно релевантных данных, то скажет вам об этом», а не заполнит пробелы. Elicit утверждает, что подкрепляет каждое сгенерированное ИИ утверждение цитатами на уровне предложений. Scite показывает, подтвердили или опровергли выводы статьи последующие работы, и тем самым ловит сбой, который другие пропускают: реальное исследование, которое с тех пор оспорено.
Если вы строите собственный конвейер, Citations API от Anthropic возвращает точный отрывок, стоящий за каждым утверждением, а в документации Anthropic сказано, что такие ссылки «гарантированно содержат корректные указатели на предоставленные документы». Это исключает выдуманные источники. Но не подтверждает, что отрывок поддерживает предложение, к которому его приложили. Проверка ссылок — последний рубеж. У GPTZero есть детектор галлюцинаций, сканирующий библиографии, и его команда отметила отчёт KPMG, а ранее в этом году нашла 100 галлюцинированных ссылок в 51 статье, принятой на NeurIPS, крупную конференцию по ИИ, сообщал TechCrunch.
| Тип инструмента | На что опирает ответы | Что вам всё равно проверять |
|---|---|---|
| Блокнотные инструменты (Gemini Notebook) | Загруженные вами источники | Что каждый приведённый отрывок поддерживает утверждение и что ваши источники верны |
| Ответные поисковики (Perplexity, ChatGPT с поиском) | Результаты живого поиска в вебе | Открыть каждую ссылку, проверить дату и найти оригинального издателя |
| Исследовательский поиск (Consensus, Elicit, Scite) | Научные статьи | Фактические выводы статьи, её ограничения и более поздние работы, которые ей противоречат |
| API цитирования (Claude Citations) | Документы, которые вы предоставляете | Подтверждение утверждения, а не просто валидный указатель |
| Проверка ссылок (GPTZero) | Библиографические записи | Говорит ли реальная ссылка то, что утверждает черновик |
Чтобы сравнить варианты, загляните в рейтинг ИИ-помощников для исследований, рейтинг ИИ-поисковиков и рейтинг для поиска по научной литературе. Наши обзоры ИИ-помощников для исследований и ИИ-поисковиков подробнее разбирают функции и цены.
Часто задаваемые вопросы
Можно ли использовать одну ИИ-модель для проверки фактов другой?
Как первый проход — да. Вторая модель, особенно с поиском, заметит часть ошибок, которые пропустила первая, а расхождения покажут, куда смотреть. Но подтвердить она ничего не может, ведь у обеих могут быть одни и те же пробелы. Относитесь к её пометкам как к списку дел и закрывайте каждый пункт по источнику. Если вы выбираете вторую модель, в нашем руководстве по альтернативам ChatGPT сравниваются основные варианты.
Проверяют ли ИИ-детекторы факты?
Нет. Инструменты вроде детектора Originality.ai оценивают, написан ли текст машиной. Это ничего не говорит о том, верно ли утверждение, а черновик, написанный человеком, может быть столь же ошибочным. Для проверки фактов нужен первоисточник.
Сколько времени должна занимать проверка черновика ИИ?
Это зависит от числа утверждений с высокими ставками, а не от длины текста. Посчитайте их после сортировки. Объяснительный материал на 2000 слов с четырьмя цифрами и двумя цитатами — небольшая работа, а одностраничная записка, набитая ссылками, — нет.
Можно ли ссылаться на ChatGPT или другой чат-бот как на источник?
Для фактов — нет. Совет самой OpenAI: «используйте ChatGPT как первый черновик, а не как окончательный источник». Ссылайтесь на исходный документ, который вы проверили. Если предмет описания — сам вывод ИИ, как в тесте модели, укажите, какую модель вы использовали и когда.
Делают ли агенты глубокого исследования проверку ненужной?
Нет. Агенты вроде deep research от OpenAI собирают отчёты со ссылками из множества источников в вебе, и это значит, что вам нужно открыть больше ссылок, а не проверять меньше утверждений. Проблема искажённых источников касается каждого предложения со ссылкой, поэтому сортировка тем важнее, чем длиннее отчёты.