

Заявление «№1 в рейтинге» верно только для одного конкретного теста, проведённого одним конкретным способом в один конкретный день. Оно гораздо меньше говорит о том, лучшая ли это модель для вашей работы. Прежде чем менять инструмент или переплачивать за тариф из-за рейтинга, выясните, из какого он рейтинга, кто его проводил и что он измеряет.
В 2026 году это важнее, чем раньше: рейтинги превратились в бизнес. Arena, публичный рейтинг, ранее известный как LMArena, в этом году привлекла $200 млн при оценке $3,1 млрд — почти вдвое больше, чем $1,7 млрд в начале 2026 года (Phemex). По словам Arena, её годовая выручка в пересчёте превысила $100 млн (Arena). Сегодня каждый релиз модели начинается с места в рейтинге, и это место продаёт.
Это не значит, что рейтинги фальшивые. Большинство из них сделаны серьёзными людьми и измеряют что-то реальное. Проблема в том, что каждый измеряет своё, а в анонсе цитируют тот, который лучше выглядит для модели. В этом руководстве разберём, как устроены основные рейтинги, где каждый из них даёт сбой и как разобрать заявление примерно за две минуты.
Четыре типа рейтингов — четыре разных вопроса
Большинство рейтингов, с которыми вы столкнётесь, делятся на четыре группы. Группы важнее любого отдельного рейтинга: цифра что-то значит, только когда вы знаете, из какой она группы.
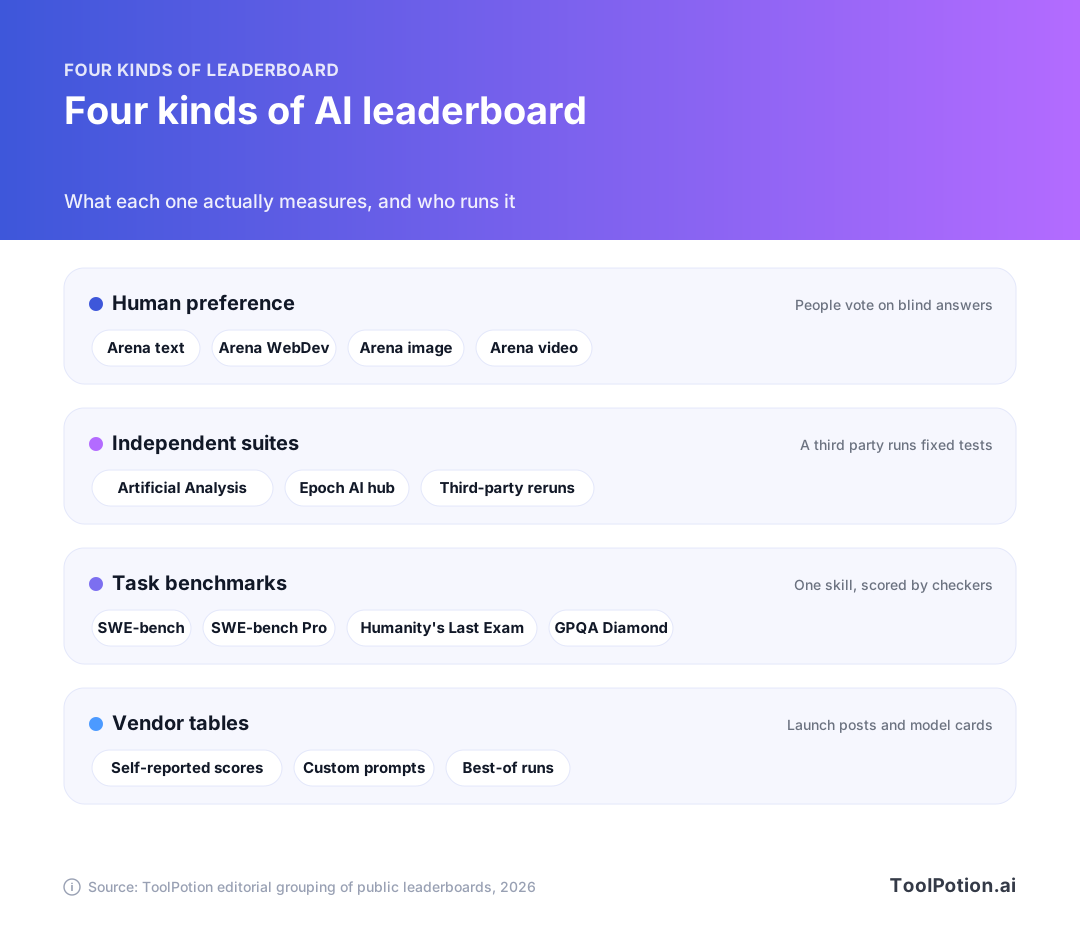
Арены предпочтений спрашивают людей, какой ответ им нравится больше. Независимые наборы тестов прогоняют каждую модель через один и тот же набор проверок в одинаковых условиях. Тесты на отдельные задачи проверяют один навык, например исправление реальных багов, с автоматической оценкой. Таблицы вендоров — это результаты, которые лаборатория публикует в своём анонсе или model card, обычно с настройками, выбранными самой лабораторией.
Эти группы не конкурируют, а отвечают на разные вопросы. Предпочтения показывают, с какой моделью людям приятно общаться. Набор тестов показывает, как модели соотносятся, когда секундомер держит нейтральная сторона. Тест на задачу показывает, справляется ли модель с одной узкой работой. Таблица вендора показывает, что лаборатория хочет, чтобы вы заметили.
| Тип рейтинга | Пример | Что измеряет | Главная слабость |
|---|---|---|---|
| Предпочтения людей | Arena Text и WebDev | За какой ответ голосуют люди | Поощряет стиль и длину, можно накрутить |
| Независимый набор тестов | Artificial Analysis, Epoch AI hub | Баллы на фиксированном наборе тестов | Хорош настолько, насколько хороши выбранные тесты |
| Тест на задачу | SWE-bench, Humanity's Last Exam | Один навык с автоматической проверкой | Утечки в обучение, ошибки в задачах, насыщение |
| Таблица вендора | Анонсы, model cards | Всё, что лаборатория решила показать | Настройки и промпты, которые нельзя проверить |
Как голос на арене превращается в рейтинг
Arena начиналась как Chatbot Arena, исследовательский проект UC Berkeley. Идея проста: вы вводите промпт, две анонимные модели отвечают, а вы выбираете ответ получше. В оригинальной статье исследователей описана платформа, которая за первые месяцы собрала более 240 000 голосов и показала, что оценки толпы хорошо совпадают с мнением экспертов (arXiv).
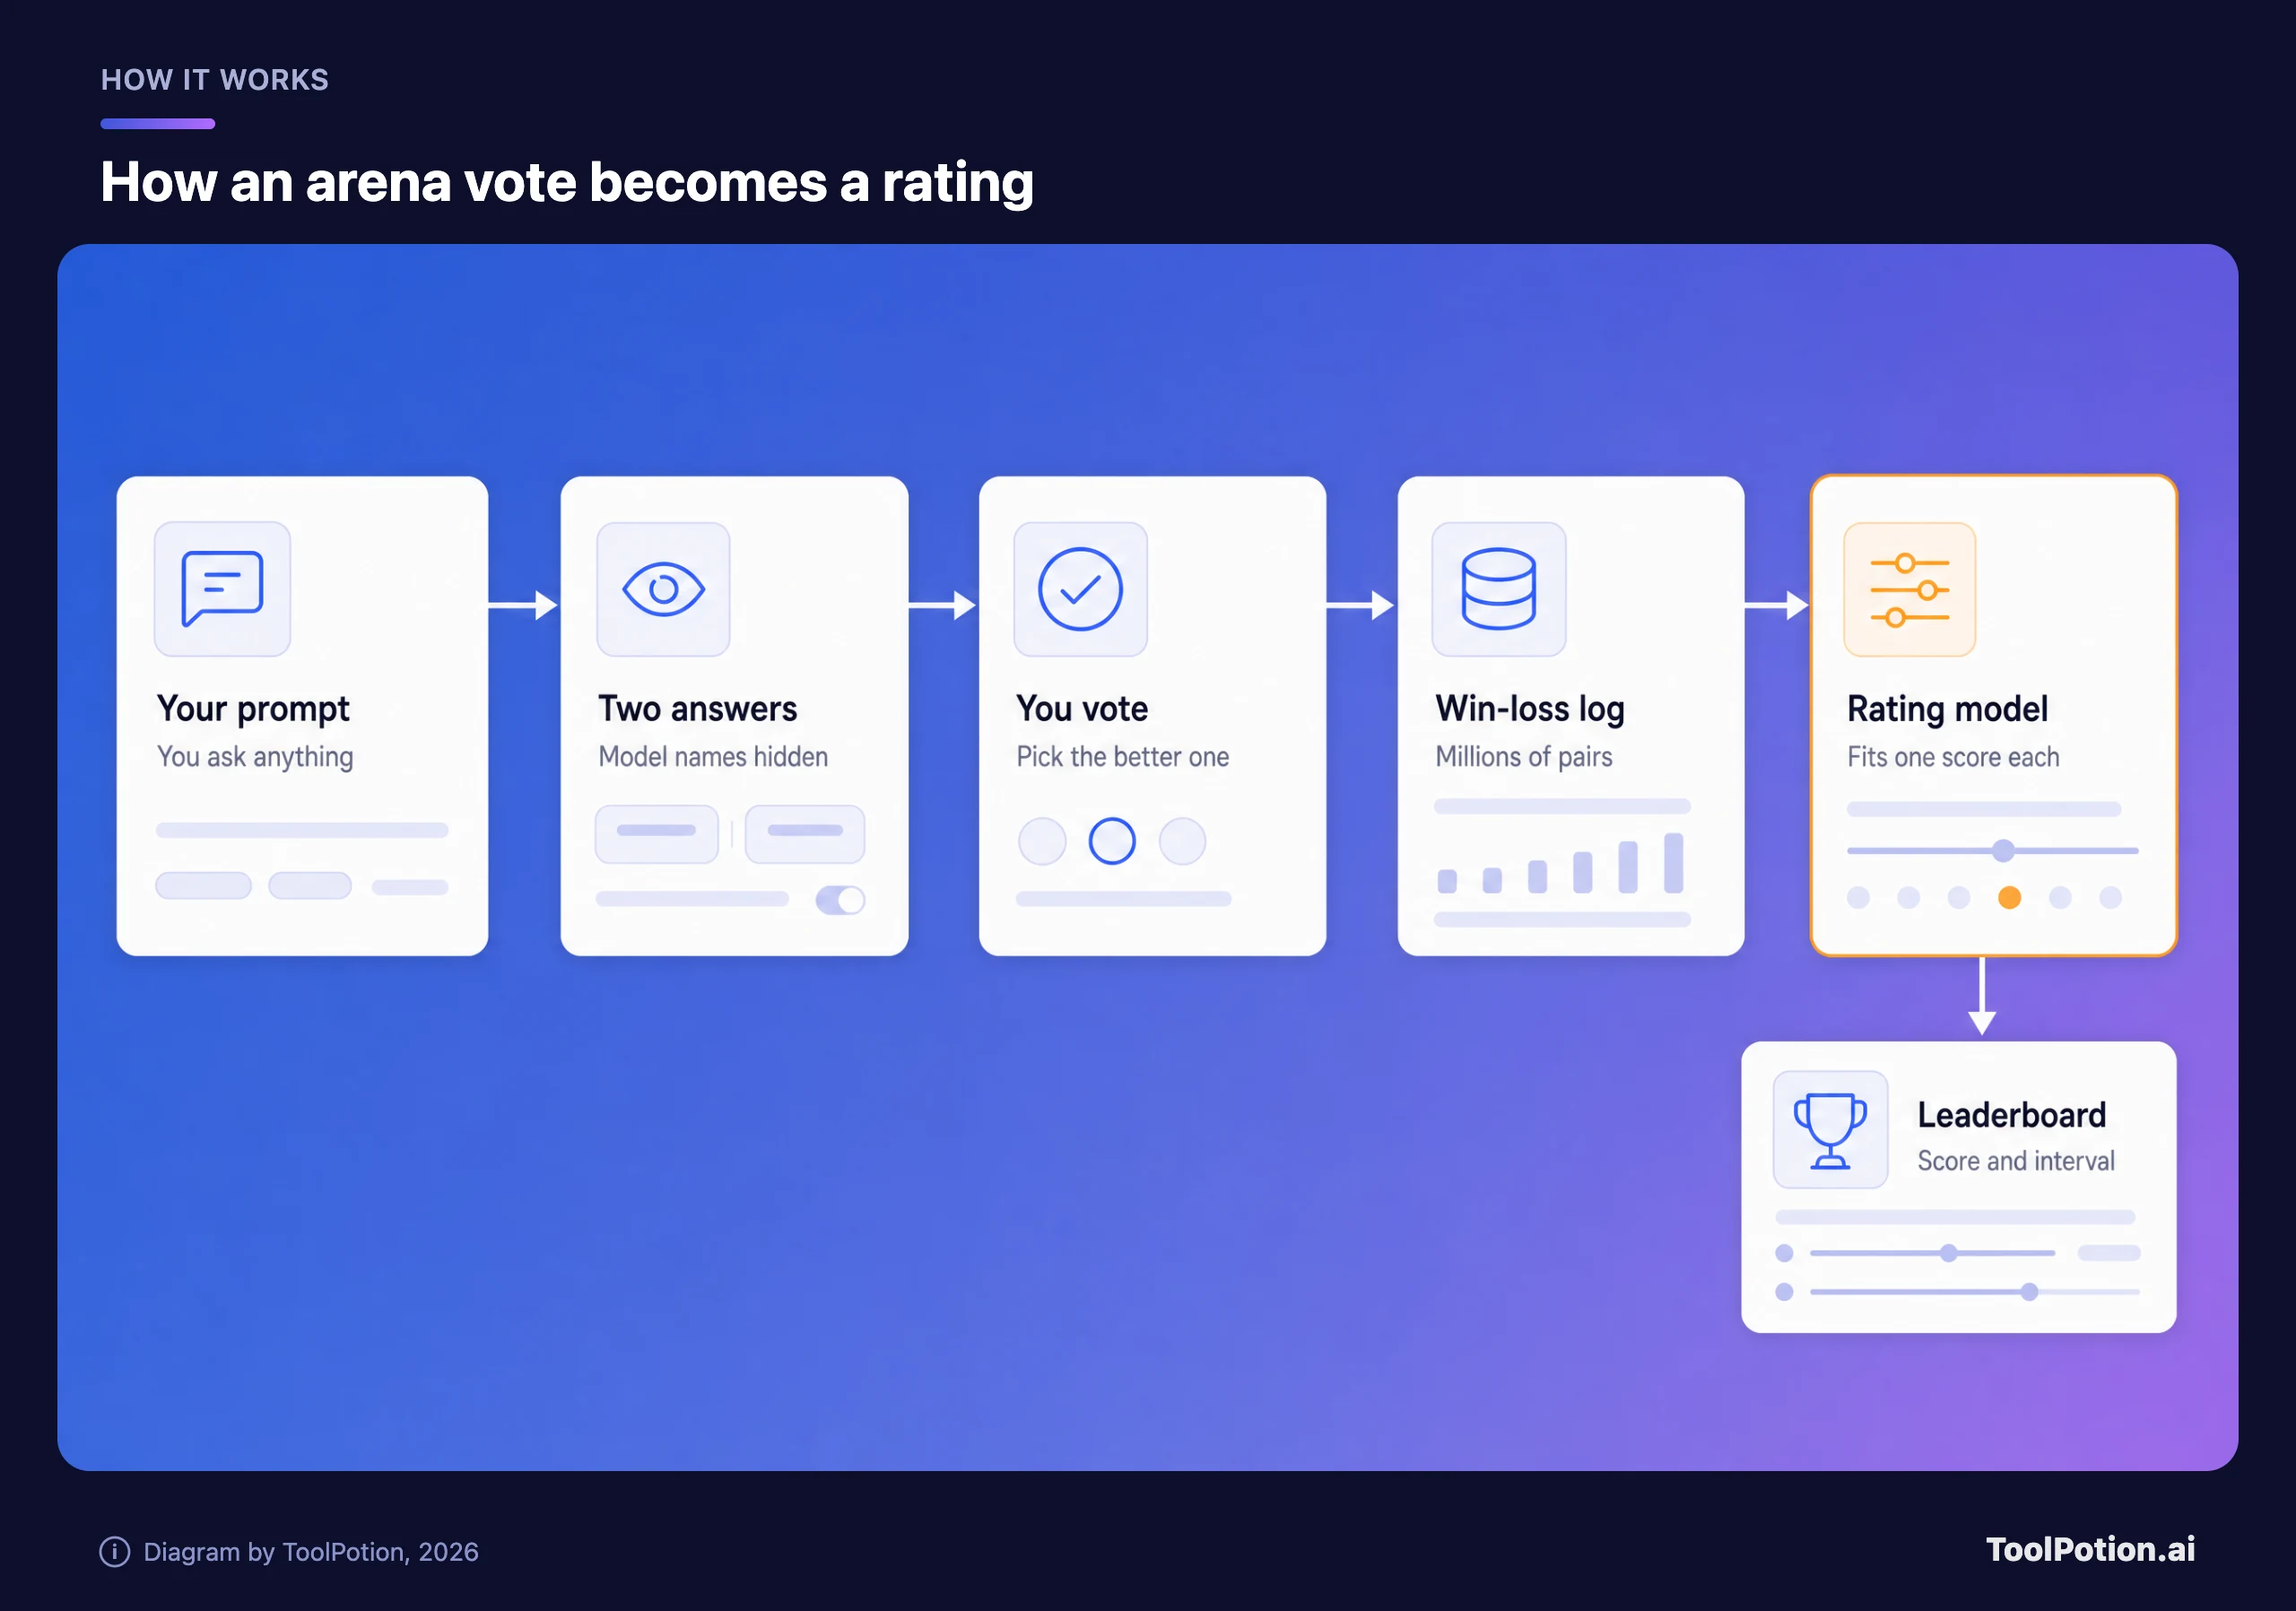
Каждый голос — крошечная запись: модель A победила модель B на этом промпте. Миллионы таких записей попадают в статистическую модель, которая присваивает каждой модели один балл. В собственных материалах Arena метод описан как регрессия Брэдли — Терри, близкий родственник системы Эло, которую используют в шахматах (LMSYS). Балл модели растёт, когда она побеждает сильных соперников, и падает, когда проигрывает слабым, а в текстовом рейтинге рядом с каждым баллом показан интервал (значение «±»), а не только точечная оценка.
Именно этот интервал пропускают в анонсах. Если две модели отличаются на несколько баллов и их интервалы пересекаются, честный вывод — ничья. «№1», основанное на разрыве в два-три балла, обычно не лучше подбрасывания монетки.
Arena давно вышла за рамки чата. В её рейтинге теперь отдельные таблицы для текста, WebDev, зрения, поиска, генерации и редактирования изображений и видео, а также новая таблица для агентов, где рядом с долей побед указана стоимость на задачу (Arena). Колонку со стоимостью стоит читать. Модель, которая на одну строчку выше, но в несколько раз дороже, — это уже другая рекомендация.
Чего арена вам не скажет
У голосования по предпочтениям три хорошо задокументированные проблемы. Первая — стиль. Людям нравятся длинные, хорошо оформленные ответы, поэтому модель может подняться, просто больше пишя и добавляя заголовки. Анализ самой команды Arena показал, что главный стилевой эффект даёт длина ответа, а поправка на длину и markdown меняет расстановку моделей. В анализе 2024 года GPT-4o-mini упала с шестого места на одиннадцатое, а Claude 3.5 Sonnet поднялась с шестого на четвёртое (LMSYS). Сейчас Arena предлагает виды с поправкой на стиль, и ими стоит пользоваться.
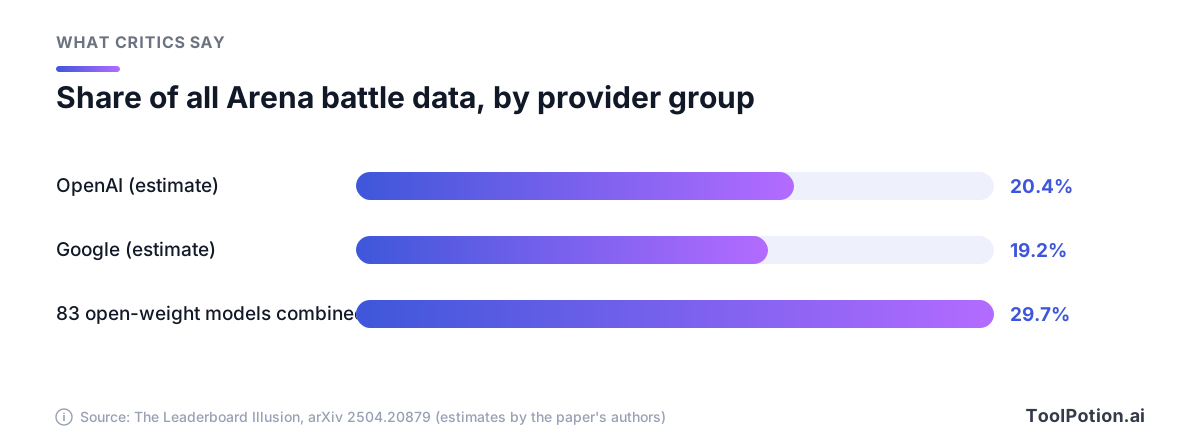
Вторая проблема — доступ. В статье 2025 года «The Leaderboard Illusion» (среди авторов Sayash Kapoor и Noah Smith) утверждалось, что крупные лаборатории получают на Arena структурные преимущества. Там сообщалось, что Meta протестировала 27 закрытых вариантов модели перед выпуском Llama 4 и опубликовала только лучший результат, а доли Google и OpenAI во всех данных Arena оценивались примерно в 19,2% и 20,4%, тогда как 83 open-weight модели вместе получили около 29,7% (arXiv).
Также в статье сообщалось, что обучение на данных в стиле Arena может повысить результат на распределении Arena до 112%, а это стимул подгонять модель под рейтинг, а не улучшать её общие способности. Это оценки и утверждения авторов, и они отражают срез на момент написания статьи. Тем не менее это самое ясное внешнее описание того, как рейтинг на основе предпочтений можно накрутить, никого не нарушая правил.
Третья проблема: предпочтение — это не правильность. Уверенный и дружелюбный ответ может выиграть голосование и при этом содержать неверный факт. Для ощущения от чата и для текстов предпочтение — неплохой ориентир. Для кода, который должен работать, или цифры, которая должна быть верной, — слабый.
Нынешняя страница политики Arena отчасти отвечает на эти претензии. Там сказано, что пред-релизные модели тестируются под анонимными названиями, пока баллы не стабилизируются (минимум 1 000 голосов), что эти баллы приватно передаются поставщику и что после публичного релиза балл модели помечается как «preliminary», пока не придут свежие голоса. Также сказано, что в каждом сражении участвует хотя бы одна общедоступная модель и что не менее 20% сражений проходят только между публичными моделями (Arena). Практическое правило: пометка «preliminary» значит, что цифра ещё не устоялась.
Независимые наборы тестов: Artificial Analysis и Epoch AI
Если рейтинги предпочтений спрашивают, что нравится людям, то независимые наборы тестов спрашивают, на что способна модель, когда все решают один и тот же тест. Самый известный из них — Artificial Analysis. Его Intelligence Index, сейчас версии 4.3.2, объединяет 10 оценок в четыре группы: агенты (30% веса), общие знания и рассуждение (30%), кодинг (20%) и научное рассуждение (20%). Каждая модель запускается в одинаковых условиях с оценкой pass@1, то есть одна попытка на вопрос, и сайт заявляет, что хранит собственные копии датасетов. Для субъективной оценки используется панель из трёх передовых моделей от разных лабораторий. Индекс в основном англоязычный и текстовый, а многоязычные и мультимодальные способности сайт оценивает отдельно (Artificial Analysis).
Веса — это редакторский выбор. Другое распределение, с меньшим упором на агентов и большим на кодинг, переставило бы некоторые модели. Это не недостаток, но «общая» цифра оказывается одним из мнений о том, что важно. Если вам важен в основном кодинг, смотрите результаты по кодингу, а не заголовочную цифру.
Epoch AI ведёт хаб бенчмарков, где тесты, которые Epoch запускает сам, такие как GPQA Diamond, FrontierMath и SWE-bench Verified, соседствуют с результатами из внешних источников. Самая полезная для читателя находка касается цифр вендоров. Для Claude 3.5 Sonnet заявляли 65% на GPQA Diamond. Epoch намерил 55% плюс-минус 3 по 16 запускам и отметил, что лаборатории часто не публикуют использованный промпт и температуру (Epoch AI). Разрыв в 10 пунктов только из-за настроек — хороший повод предпочитать перепроверки третьей стороной. Хаб финансируется UK AI Security Institute, а его данные можно свободно использовать.
Независимость не означает беспристрастность. Тесты всё равно выбирает третья сторона, а любой индекс с LLM-судьями наследует их привычки. Собственное исследование Arena об ИИ-судьях показало, что модели предпочитают свои ответы. В 1 460 сражениях Text Arena, которые оценивали 12 моделей, судьи выбирали собственные ответы примерно на 70% чаще, чем люди (Arena).
Бенчмарки изнашиваются
У тестов на отдельные задачи обратная проблема. Они объективны, но быстро стареют. Бенчмарк выходит сложным, лаборатории под него оптимизируются, баллы растут, тест утекает в обучающие данные, и вскоре все топовые модели сидят у потолка, а рейтинг теряет смысл.
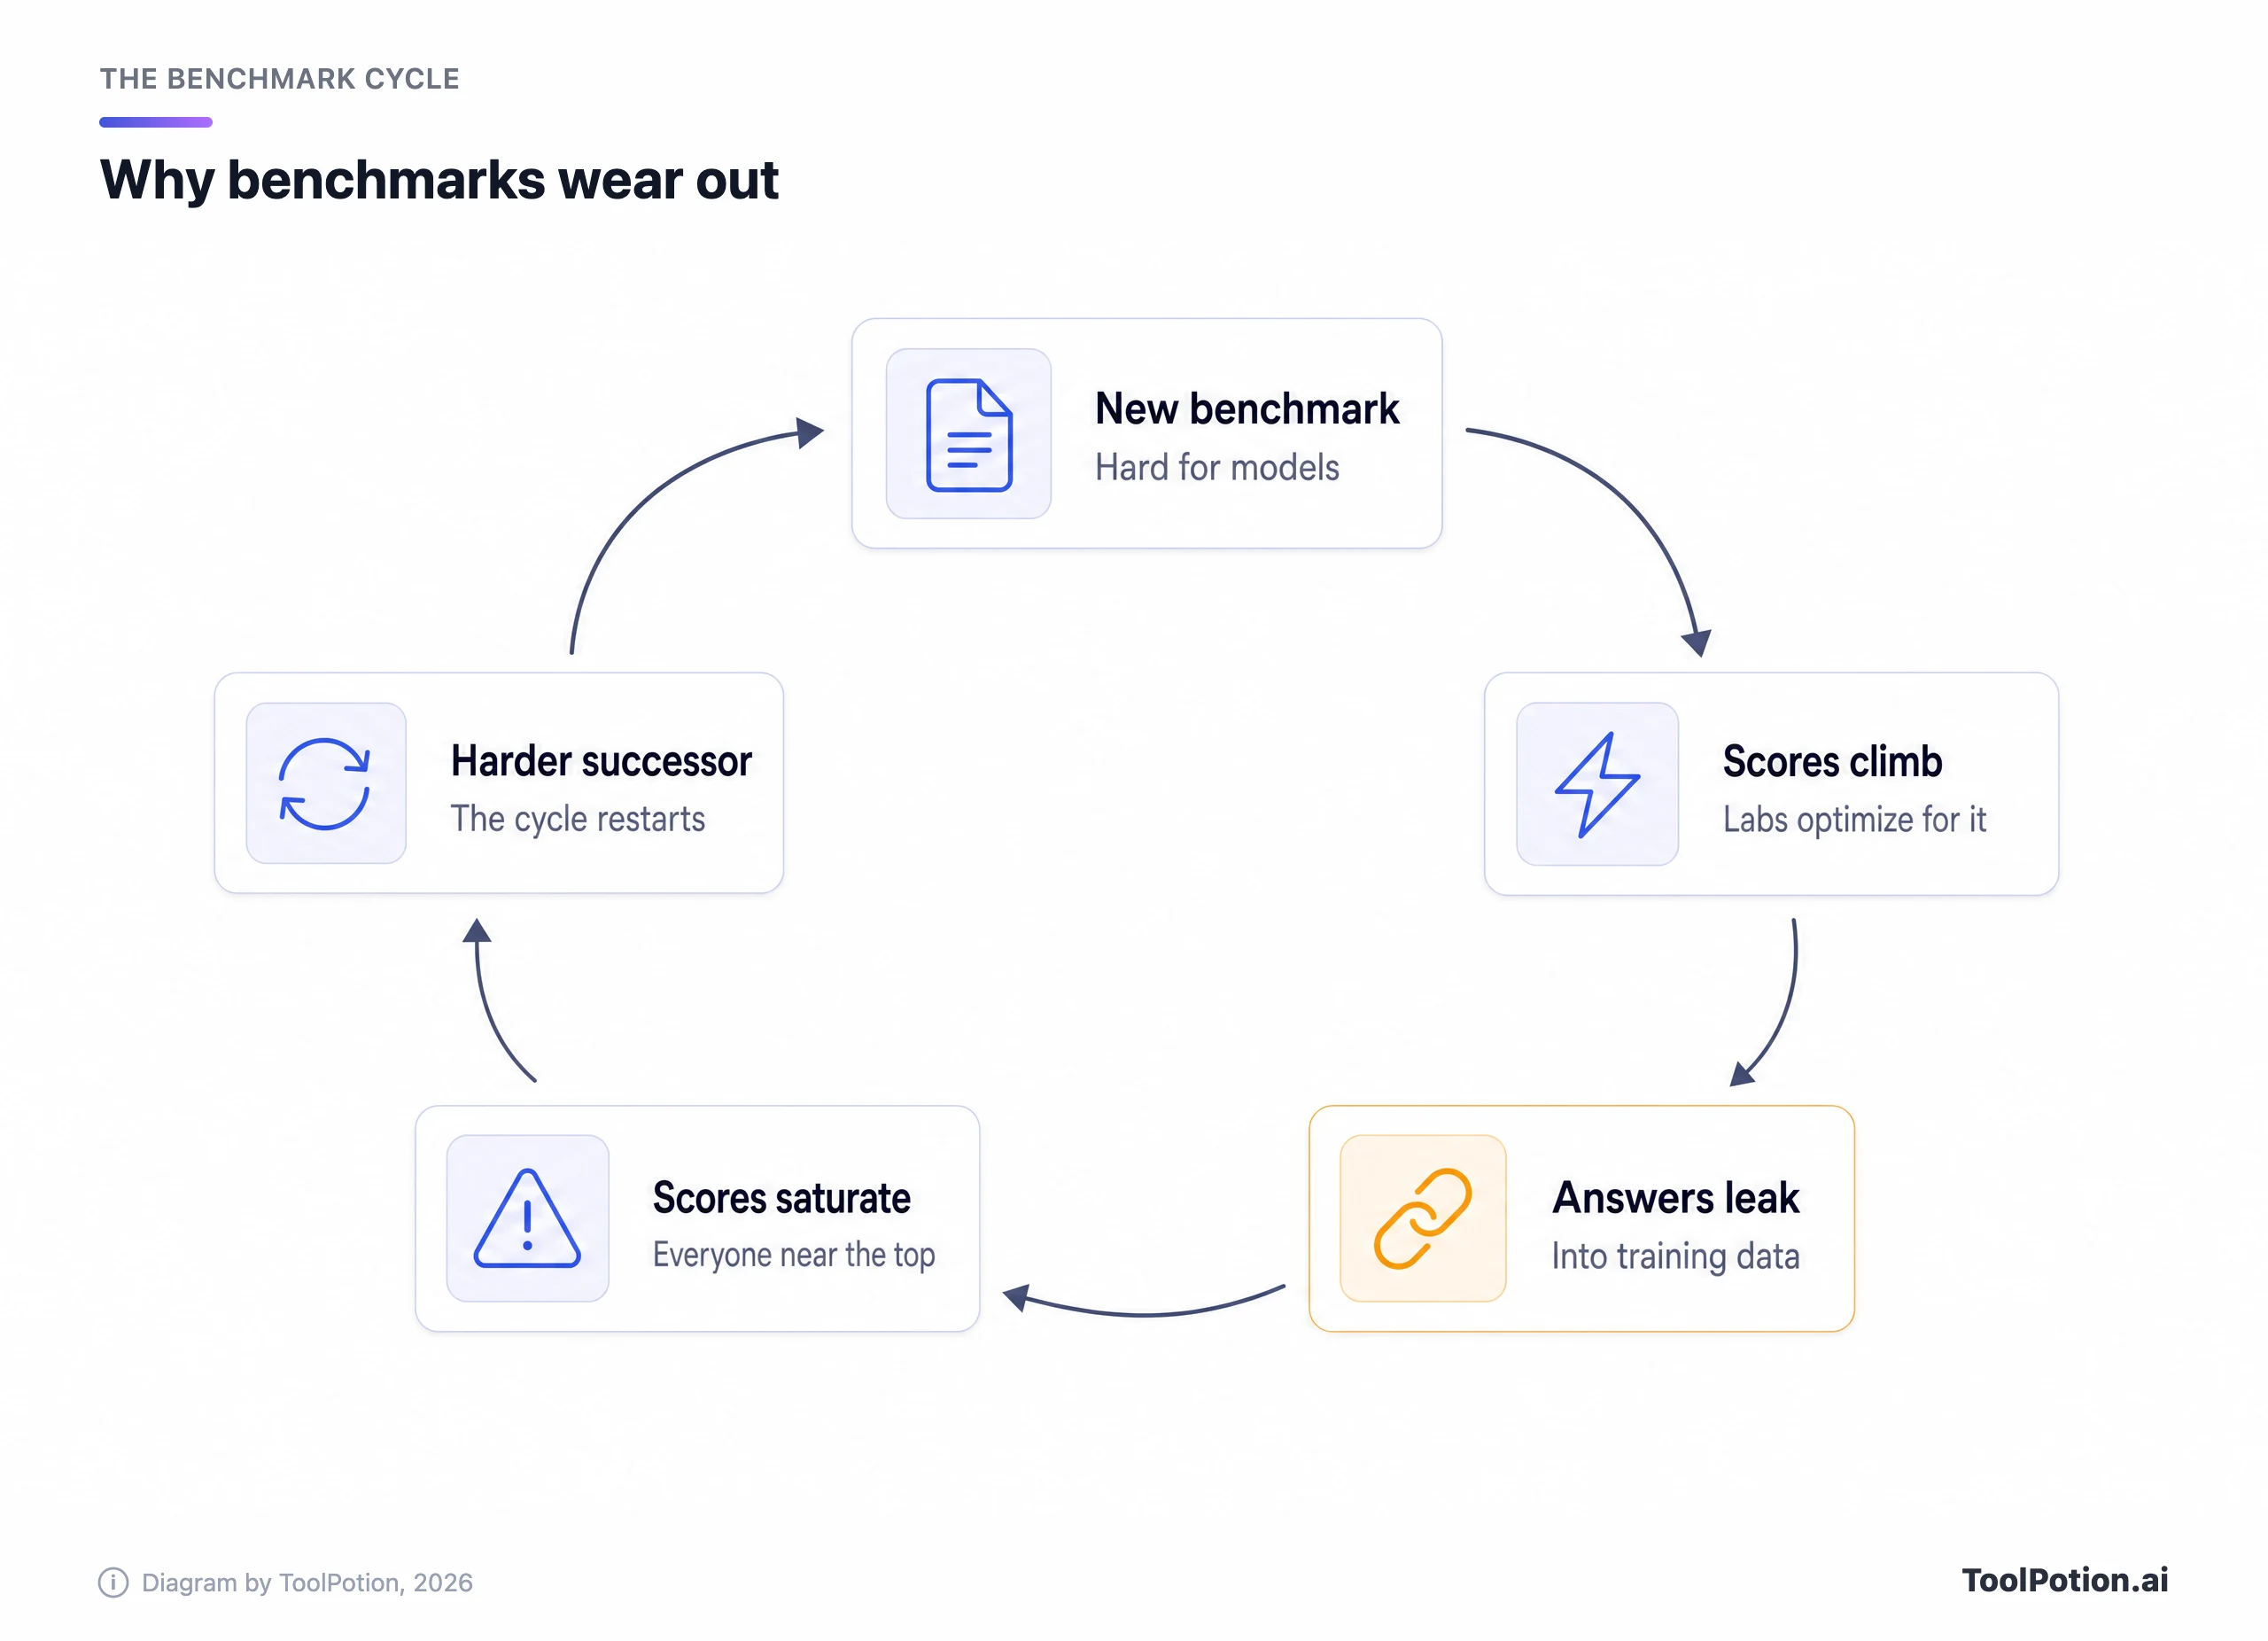
Humanity's Last Exam — хороший пример ответа на это. В нём 2 500 вопросов по более чем сотне предметов, их написали почти 1 000 экспертов из более чем 500 учреждений, а для выявления переобучения хранится закрытый тестовый набор. Авторы создали его, потому что передовые модели довели старые тесты вроде MMLU до результатов выше 90% (arXiv). В 2026 году его опубликовал Nature, и даже создатели ожидали быстрого роста баллов.
SWE-bench показывает весь жизненный цикл. В исходном бенчмарке было 2 294 реальных issue с GitHub из 12 Python-проектов, и лучшая модель того времени, Claude 2, решала 1,96% из них (по данным исходной статьи). Очищенное подмножество из 500 задач под названием Verified стало стандартной цифрой в анонсах про кодинг. А потом пришёл аудит.
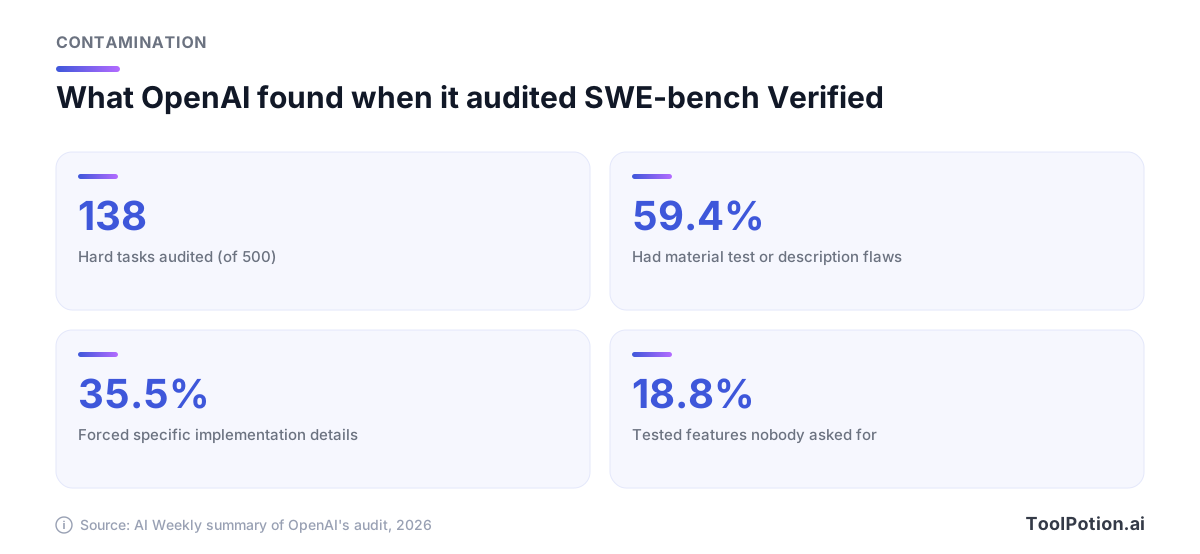
OpenAI проверила 138 задач из Verified, которые её модель o3 решала нестабильно, и каждую разбирали не менее шести инженеров. У 59,4% нашлись существенные проблемы в тестах или описаниях. В отдельном тесте на утечки GPT-5.2, Claude Opus 4.5 и Gemini 3 Flash Preview смогли воспроизвести детали оригинальных исправлений, что говорит о попадании задач в обучающие данные. OpenAI сообщает, что прекратила публиковать результаты Verified и рекомендует SWE-bench Pro (OpenAI). В сводке AI Weekly добавляется, что топовые модели набирали около 80% на Verified и примерно на 35 пунктов меньше на Pro, а более поздний внешний аудит поставил под вопрос и проверяющие механизмы Pro (AI Weekly).
Вывод не в том, что бенчмарки по кодингу бесполезны. Вывод в том, что результат с выведенного из обращения или «протёкшего» теста — это устаревшая цифра. Когда в анонсе цитируют SWE-bench, проверьте вариант и то, какая агентская обвязка стояла вокруг модели. Исследование Arena «HarnessTax» на 21 паре «модель + обвязка» показало, что выбор обвязки почти не влиял на успех задач, но менял стоимость до 5 раз при похожих результатах, причём на небольшой выборке из 30 задач на бенчмарк (Arena).
Чек-лист для любого заявления «№1»
Вот версия на две минуты. Пройдитесь по ней, прежде чем верить рейтингу, и особенно прежде чем тратить деньги из-за него.
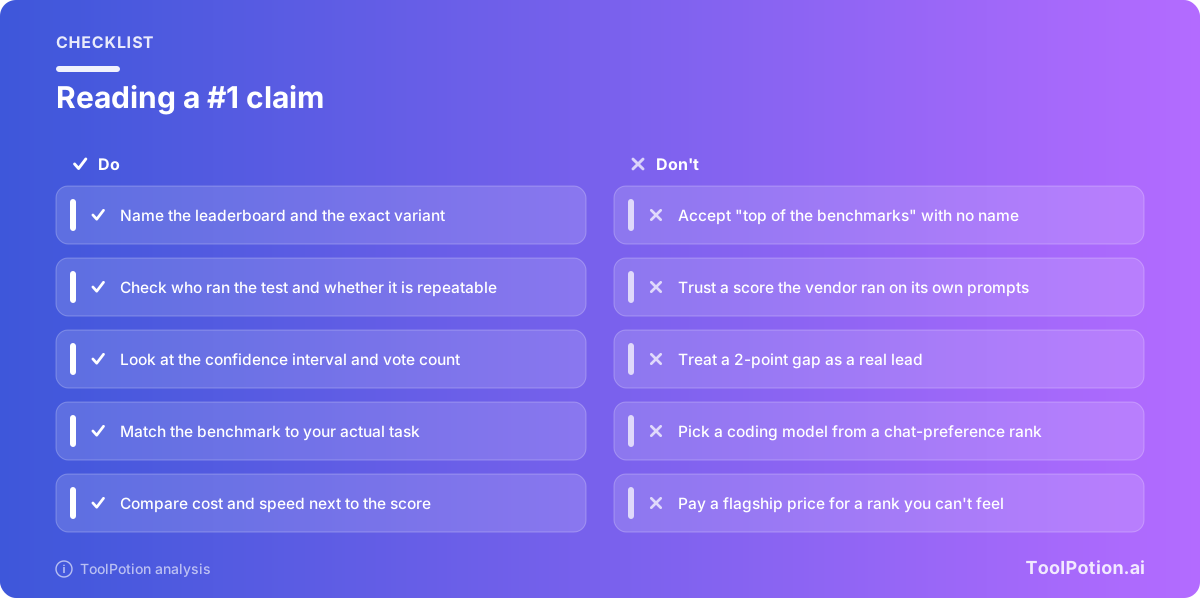
- Найдите точный рейтинг и версию. «Лидирует в бенчмарках» — заявление, которое нельзя проверить. «Первое место в Arena Text с поправкой на стиль» — можно.
- Выясните, кто проводил запуск. Запуск лаборатории на её собственных промптах — маркетинговая цифра. Перепроверка третьей стороной весит больше.
- Прочитайте интервал и число голосов. Если отрыв меньше интервала, это ничья.
- Проверьте, доступна ли модель публично. Балл за то, что нельзя попробовать сегодня, не поможет с выбором.
- Спросите, соответствует ли тест вашей задаче. Предпочтения в чате не предскажут, как модель справится с вашими таблицами или вашей кодовой базой.
- Поищите второй, другой рейтинг, который это подтверждает. Один рейтинг может ошибаться или быть накрученным. Совпадение двух независимых подделать гораздо сложнее.
- Сопоставьте с баллом цену и скорость. Более дешёвая модель на два места ниже часто оказывается лучшей покупкой.
Оценить заявление можно самостоятельно по чек-листу ниже. Он делает упор на то, что сложнее всего подделать: запуски третьей стороны и совпадение разных рейтингов.
Подберите рейтинг под свой вопрос
Поскольку рейтинги отвечают на разные вопросы, разумно начинать с вопроса, а рейтинг выбирать потом. Если вы выбираете ассистента для текстов и разговоров, арена предпочтений — неплохой первый фильтр. Если нужно воспроизводимое сравнение «сырых» способностей, берите независимый набор тестов. Если выбираете инструмент для кодинга, смотрите тесты на реальных репозиториях, а затем проверяйте на собственном коде.
Дерево даёт отправную точку, а не вердикт. Какой бы рейтинг вы ни выбрали, короткий тест на ваших задачах лучше любого публичного места. Возьмите 10 реальных задач, которые вы выполняете каждую неделю, прогоните их через двух-трёх финалистов и сравните результаты бок о бок. Это займёт полдня и измерит то единственное, что не измерит ни один рейтинг, — вашу работу.
Чтобы выбирать по категориям, в каталоге AI Models & LLMs и на доске ИИ-моделей ToolPotion модели выстроены рядом, а руководство по подбору уровня ИИ-модели под задачу объясняет, когда флагман стоит своих денег. Для более широкого обзора загляните в Top 15 AI Models & LLMs in 2026, а если вы отталкиваетесь от одного ассистента — в альтернативы ChatGPT в 2026 году.
Где цифры наименее надёжны
Несколько ситуаций требуют особой осторожности. У новых моделей в первые дни меньше голосов и шире интервалы, и Arena не зря помечает такие баллы как preliminary. Другое слепое пятно — open-weight модели, которые можно скачать с Hugging Face: авторы Leaderboard Illusion оценивали, что их доля данных Arena меньше, поэтому их баллы могут быть шумнее. Кроме того, размещённые модели могут меняться под тем же названием, так что балл с недели релиза может не описывать модель, которой вы пользуетесь спустя месяцы.
Специализированные задачи — самый большой пробел. Юридические тексты, медицинское кодирование, редкий язык и внутренняя кодовая база компании плохо покрыты публичными рейтингами. Real-SWE Benchmark — один из ответов: он оценивает передовые модели на закрытых корпоративных кодовых базах, которые реже утекают в обучающие данные, чем публичные репозитории. Относитесь к такому рейтингу как к полезному второму мнению, а не как к замене собственного теста.
А если вы обычный пользователь, всё это вам, возможно, и не нужно. Для повседневных текстов и вопросов несколько лучших моделей от OpenAI, Anthropic и Google настолько близки, что выбор сведётся к цене, интерфейсу и привычке. Тратить час на рейтинги, чтобы выбрать между почти равными, — плохая сделка.
Частые вопросы
Arena и LMArena — это одно и то же?
Да. LMArena выросла из исследовательского проекта Chatbot Arena в UC Berkeley и теперь называется Arena, адрес — arena.ai. Старое название всё ещё встречается в статьях и старых работах.
Какому рейтингу можно доверять больше всего?
Ни один не заслуживает доверия во всех случаях, и ответ зависит от того, что вы хотите узнать. Для воспроизводимости надёжнее всего сторонний набор тестов, который сам прогоняет каждую модель. Для вопроса «что нравится людям» больше всего данных у Arena. Самое надёжное свидетельство — совпадение двух независимых рейтингов, а затем короткий тест на ваших задачах.
Что такое загрязнение бенчмарка (contamination)?
Это когда модель видела вопросы или ответы теста во время обучения, и высокий балл отражает запоминание, а не навык. Аудит OpenAI по SWE-bench Verified показал, что передовые модели могли воспроизвести оригинальные исправления для некоторых задач. Одна из защит — закрытые тестовые наборы, как у Humanity's Last Exam.
Жульничают ли вендоры в рейтингах?
Имеющиеся данные поддерживают более узкое утверждение. Лаборатории выбирают, какие результаты публиковать, какие настройки использовать и, по данным статьи Leaderboard Illusion, какие закрытые варианты раскрывать. Это избирательная отчётность в рамках правил, а не обязательно нарушение. Именно поэтому важны независимые перепроверки.
Нужно ли переходить на новую модель каждый раз, когда она становится №1?
Нет. Разрыв в рейтинге часто укладывается в погрешность, а переход имеет реальную цену: промпты, рабочие процессы, тестирование. Переходите, когда модель обходит вашу текущую на ваших же задачах или когда она не хуже, но заметно дешевле.