

Dans une base de connaissances IA, l'IA est la partie facile. Les réponses sont fausses parce que les documents sous-jacents sont périmés, en double ou partagés avec les mauvaises personnes. Réparez donc vos 50 documents les plus utilisés et vos réglages de partage avant d'acheter quoi que ce soit.
Le sujet est d'actualité, car vous en avez peut-être déjà une. Atlassian active l'IA par défaut dans toutes les applications de ses offres cloud Standard, Premium et Enterprise, Rovo compris, tant qu'un admin ne la désactive pas (Atlassian). ChatGPT Business active les apps par défaut (OpenAI Help Center). Claude Team et Enterprise incluent un projet de recherche « Ask Your Org » activé par défaut, qui attend seulement qu'un propriétaire termine la configuration (Claude Help Center). Vos collègues risquent donc bientôt d'interroger une IA sur vos fichiers sans que personne ait vérifié ce qu'elle va y trouver.
Ce guide s'adresse aux responsables d'équipe, aux ops et aux équipes IT d'entreprises d'environ 10 à 500 personnes. Il explique comment les réponses sont fabriquées, présente trois façons de construire avec les prix 2026 vérifiés, détaille ce qui rend les réponses fausses et propose un déploiement sur 30 jours.
Comment une réponse IA est construite à partir des connaissances de l'entreprise
Si l'on met le marketing de côté, tous les produits dont il est question ici font le même travail en quatre temps. Ils vérifient qui pose la question. Ils cherchent uniquement dans les documents que cette personne peut déjà ouvrir. Ils transmettent les passages les plus pertinents à un modèle de langage, qui rédige une réponse à partir d'eux. Enfin, ils relient chaque partie de la réponse au passage dont elle vient, pour que le lecteur puisse vérifier.
Le nom technique est retrieval-augmented generation, ou RAG. Le modèle n'a pas mémorisé votre wiki. Il lit quelques passages récupérés au moment de la question, un peu comme un nouvel arrivant qui survole trois pages avant de répondre sur Slack. Une réponse ne peut être plus à jour et plus juste que les passages qu'on lui a fournis : un modèle brillant ne sauvera pas une page erronée.
Les permissions sont l'étape que les équipes sous-estiment. La documentation de Microsoft indique que Microsoft Copilot « ne présente que les données de l'organisation auxquelles chaque utilisateur a au moins un droit de lecture », et demande aux admins de s'appuyer sur le modèle de permissions de SharePoint pour que les bonnes personnes aient les bons accès (Microsoft Learn). Lisez cela à l'envers. L'IA ne montrera pas un fichier à quelqu'un qui ne peut pas l'ouvrir. En revanche, elle fera remonter tous les fichiers qu'il peut ouvrir, y compris le tableur des révisions de salaires que quelqu'un a partagé avec toute l'entreprise il y a des années et oublié. (Microsoft a renommé Microsoft 365 Copilot en Microsoft Copilot, mais certaines licences peuvent encore afficher l'ancien nom pendant la transition.)
Le schéma suit une question à travers ces étapes. La case ambre est celle qui décide de ce que l'IA a le droit de lire.
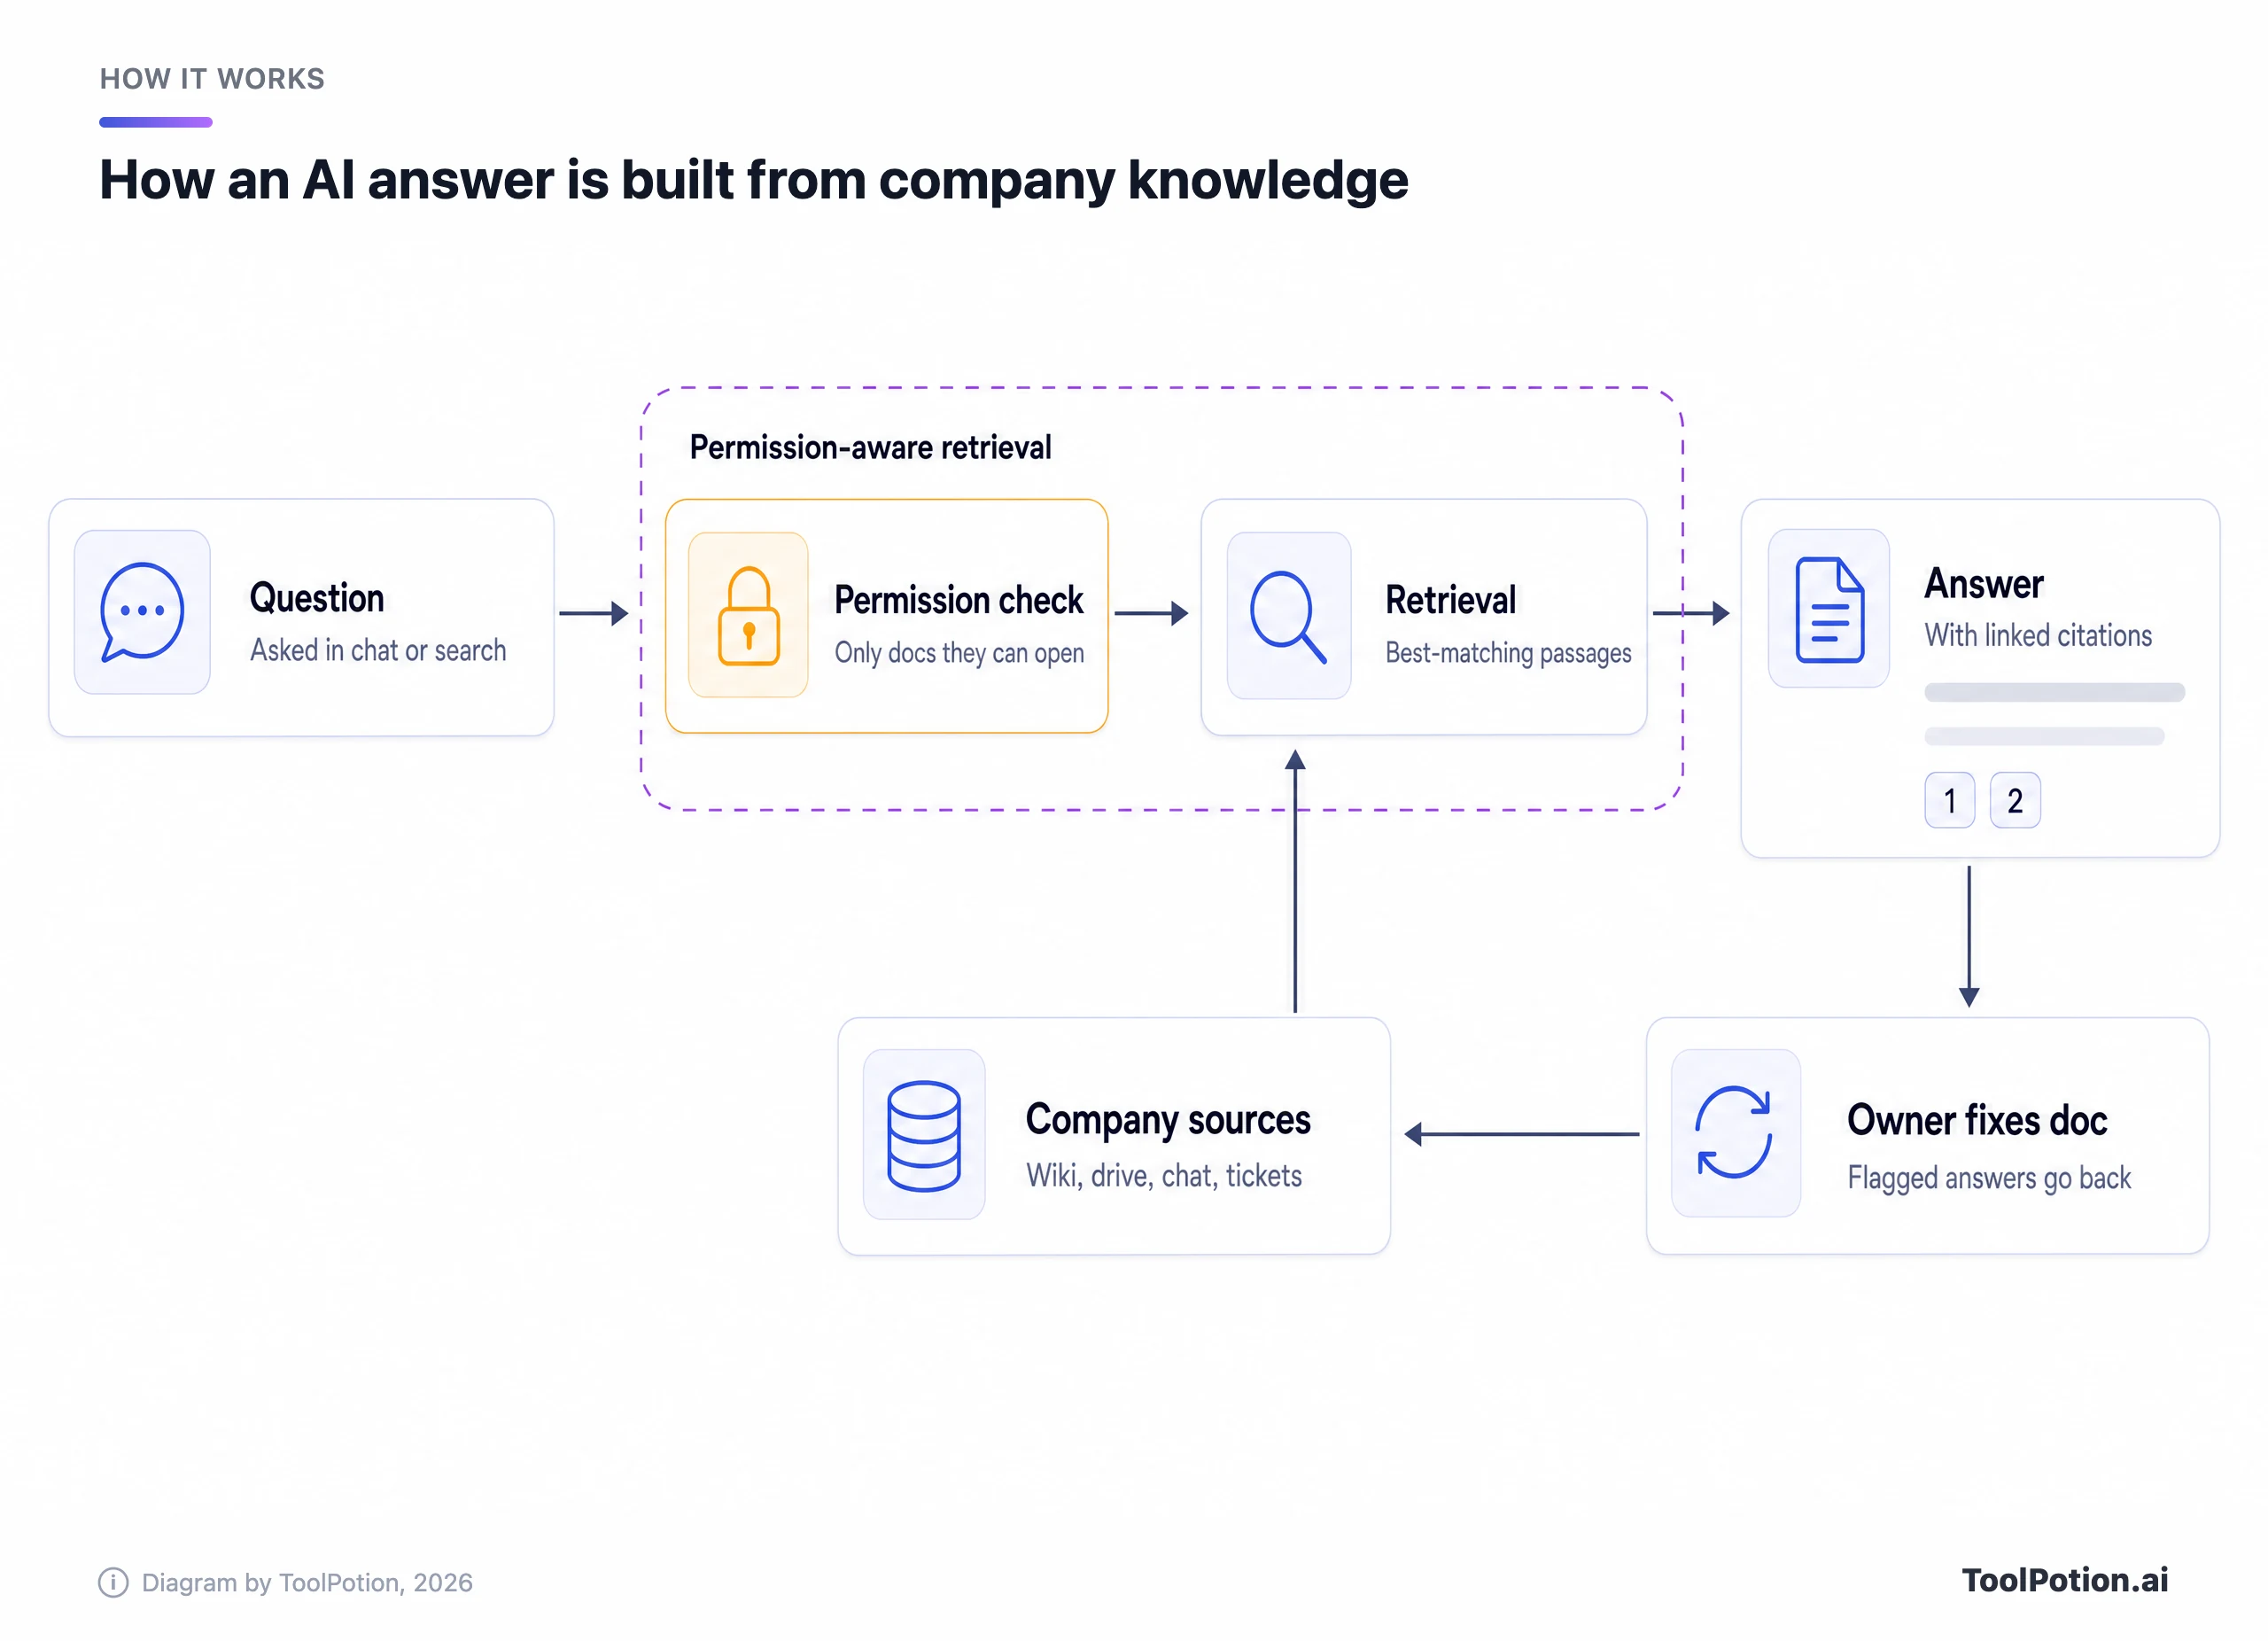
Regardez la boucle en bas. Quand quelqu'un signale une mauvaise réponse, le signalement doit aller au propriétaire du document source, car corriger la page corrige toutes les réponses futures qui la citent. Corriger la réponse dans le chat ne règle qu'une seule conversation.
Sous le capot, il existe deux architectures, et elles ne tombent pas en panne de la même façon. Les outils à index copient à l'avance votre contenu et ses réglages de permissions dans leur propre index. C'est le cas du Semantic Index de Microsoft, de Rovo, de Glean et de Gemini Enterprise : c'est rapide, mais la copie peut prendre du retard sur la source. Les outils à appel direct interrogent vos applications au moment de la question. La recherche d'entreprise de Claude passe par des appels MCP vers les services connectés et affirme que rien n'en est indexé côté Anthropic.
Une ligne de la page d'aide d'Anthropic compte pour l'IT. Chaque personne se connecte normalement avec ses propres identifiants, de sorte que les résultats correspondent à ses propres accès. Un connecteur personnalisé configuré avec une clé API partagée fonctionne autrement : tous ceux qui l'utilisent voient tout ce que cet unique identifiant peut voir.
Trois voies de construction, selon la façon dont votre savoir est réparti
Le modèle embarqué compte très peu pour cet usage. Notion permet par exemple aux utilisateurs d'Enterprise Search de choisir entre GPT d'OpenAI, Claude d'Anthropic et Gemini de Google. Ce qui différencie les produits, c'est où ils cherchent et à quel point ils respectent vos permissions : le bon choix découle donc de l'endroit où vit déjà votre savoir.
Il existe trois manières réalistes de construire. L'assistant d'équipe est un projet ou un notebook partagé pour une équipe, avec un ensemble de documents borné ; il peut être opérationnel en un après-midi. L'IA dans votre wiki consiste à activer l'assistant que l'éditeur de votre wiki fournit déjà. La couche de réponses indexe de nombreux outils derrière une seule barre de recherche, et ne justifie son coût que si le savoir est éparpillé dans beaucoup de systèmes.
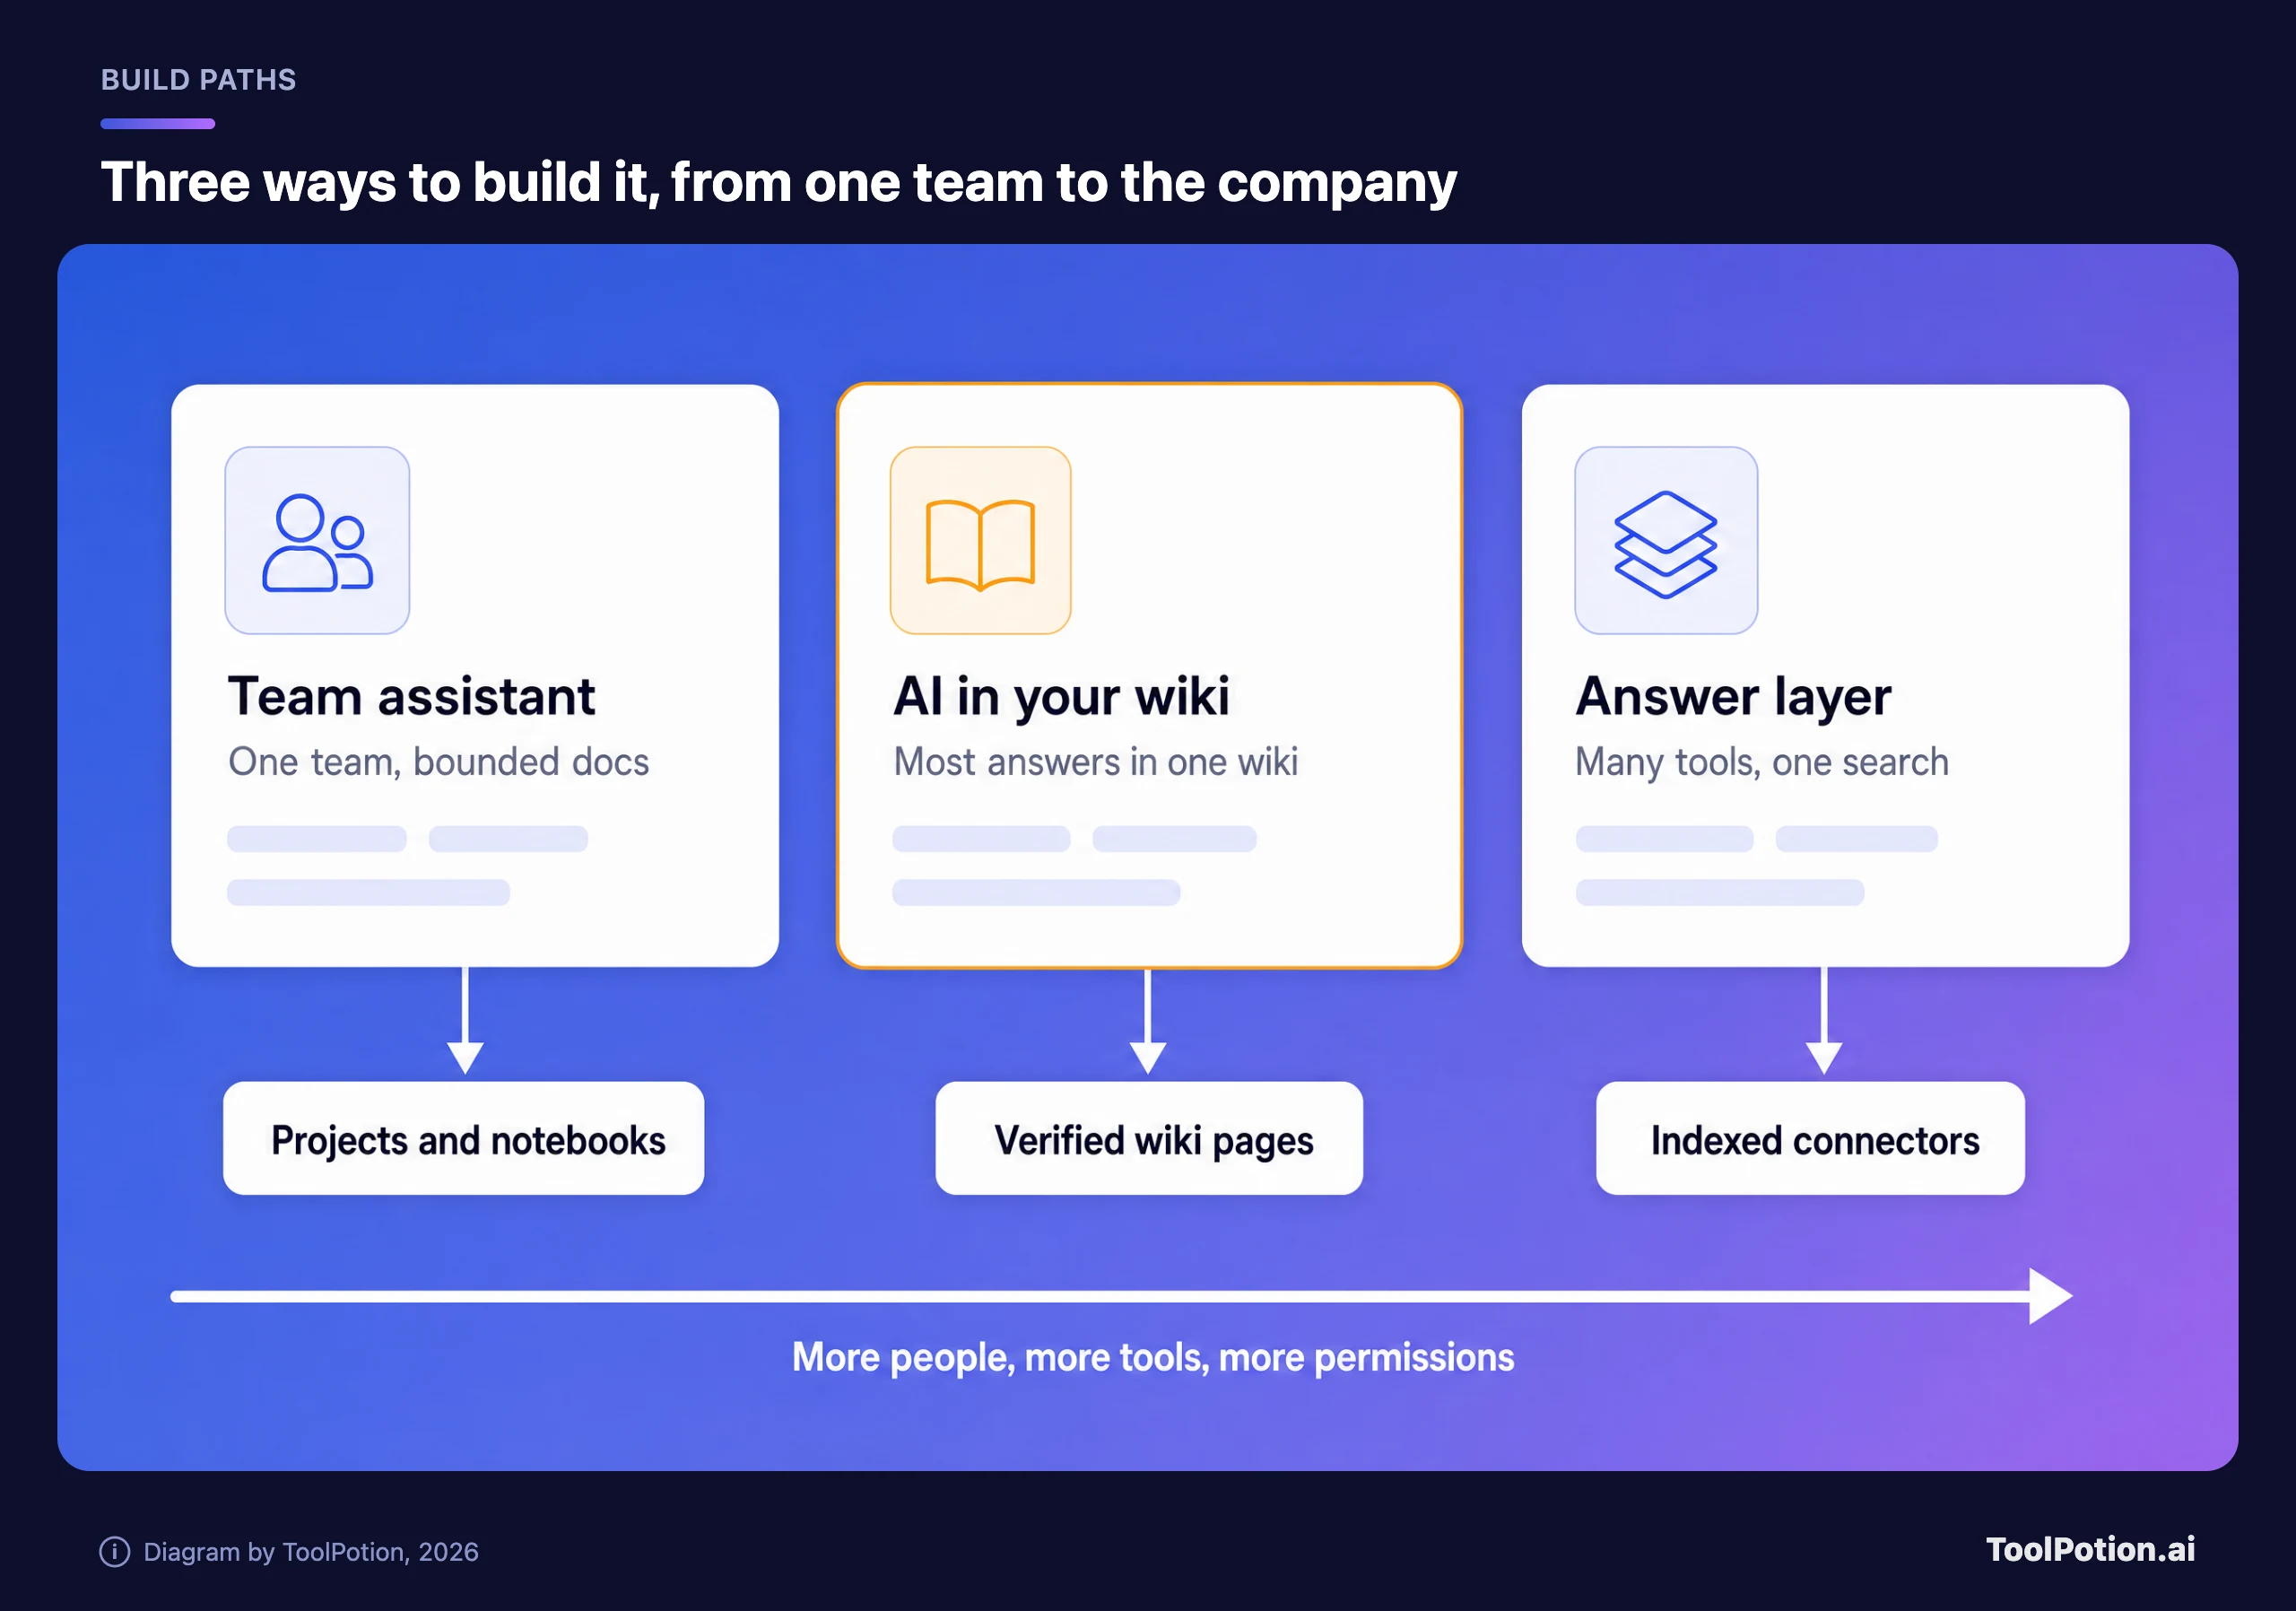
De gauche à droite, chaque voie couvre plus de monde et plus d'outils, et hérite de plus de réglages de permissions que quelqu'un doit avoir vérifiés. La carte ambre du milieu est le choix par défaut raisonnable pour la plupart des entreprises de 10 à 500 personnes. Si vous payez déjà un wiki, son IA est la voie la moins chère vers des réponses citées, et l'argent économisé peut servir à nettoyer les pages.
Vous ne savez pas laquelle vous correspond ? L'arbre ci-dessous pose deux questions au maximum.
Si vous arrivez à « Acheter une couche de réponses », lisez la section sur les raisons pour lesquelles les réponses sont fausses avant de signer quoi que ce soit. Plus l'index est grand, plus il déterrera de réglages de partage oubliés.
Voie 1 : activer l'IA du wiki que vous avez déjà
Les éditeurs de wiki ont ce que les autres voies n'ont pas : des fonctions pour garder les pages à jour, et plusieurs affichent désormais ce statut directement dans les réponses de l'IA.
Notion réserve son IA à l'offre Business, à 20 $ par membre et par mois en facturation annuelle, ou 24 $ en mensuel. Les offres Free et Plus n'ont droit qu'à un essai (Notion pricing). Business inclut Enterprise Search sur Notion et sur des outils connectés comme Slack, Microsoft Teams et GitHub, avec d'autres en bêta. Sa fonction la plus utile ici est toute simple : vous pouvez ajouter un badge « vérifié » aux pages à jour, et Notion précise que ce badge « apparaît dans les résultats de recherche et les citations de l'IA », si bien que les lecteurs voient si une source a été contrôlée.
Confluence est moins cher par siège, car Rovo est inclus. Standard est affiché à 5,42 $ par utilisateur et par mois, Premium à 10,44 $, avec des allocations Rovo de 25 crédits par utilisateur et par mois en Standard, 70 en Premium et 150 en Enterprise (Atlassian). La documentation d'usage d'Atlassian ajoute que les crédits sont mutualisés au niveau de l'organisation et ne se reportent pas, et que la facturation de l'usage supplémentaire démarre plus tard cette année, activée par défaut à 10 $ pour 1 000 crédits sauf si un admin la plafonne. Prévoyez-le avant que le pilote ne devienne populaire.
Les petits outils de wiki misent davantage sur l'entretien. Slite Basic coûte 10 $ par utilisateur et par mois en facturation annuelle et répond uniquement à partir des docs Slite, dans la limite de 30 questions par siège et par mois. Pro, à 20 $, ajoute la recherche dans les outils connectés et la vérification des docs avec suggestions de corrections (Slite). Tettra Scaling est à 8 $ par utilisateur et par mois en facturation annuelle, avec un minimum de 10 utilisateurs, plus des rapports sur les pages périmées et les contenus sans propriétaire (Tettra). Guru ne publie pas ses prix, mais son offre inclut des workflows de vérification et des réponses citées qui respectent les permissions.
| Offre | Prix par utilisateur et par mois | Sources des réponses de l'IA | À surveiller |
|---|---|---|---|
| Notion Business | 20 $ par an, 24 $ par mois | Notion et apps connectées | Pas d'IA en dessous de Business, hormis un essai |
| Confluence Standard | $5.42 | Apps Atlassian et outils connectés | 25 crédits Rovo par utilisateur |
| Confluence Premium | $10.44 | Idem, allocation plus large | 70 crédits Rovo par utilisateur |
| Slite Basic | 10 $ par an | Docs Slite uniquement | 30 questions par siège et par mois |
| Slite Pro | 20 $ par an | Slite et outils connectés | 50 crédits par siège et par mois |
| Tettra Scaling | 8 $ par an | Pages Tettra, dans l'app et dans Slack | Minimum de 10 utilisateurs |
| Guru | Sur devis commercial | Guru et plus de 100 intégrations | Pas de prix public |
Choisissez entre ces outils sur les fonctions d'entretien, pas sur le modèle. Un badge « vérifié » ou un rapport de pages périmées, c'est ce qui garde les réponses justes six mois après le lancement, quand les pages ont dérivé. Et si votre wiki est un cimetière de pages à moitié finies, activer son IA ne fait que donner une voix au cimetière.
Voie 2 : un assistant partagé pour une équipe
Parfois, le problème de connaissance concerne une seule équipe : les 40 macros du support, par exemple, ou le playbook commercial. Un projet d'assistant partagé gère en un après-midi une masse bornée comme celle-là, sans migration de wiki.
ChatGPT Business coûte 25 $ par utilisateur et par mois, ou 20 $ en offre annuelle, avec un minimum de deux sièges (OpenAI Help Center). Son plugin Company Knowledge répond à partir de sources connectées, et OpenAI affirme qu'un membre n'y récupère que ce qu'il a déjà le droit de consulter. Attention toutefois au manque côté admin : les apps sont activées par défaut dans Business, alors que le contrôle par rôle des apps individuelles est une fonction réservée à Enterprise et Edu.
Claude Team revient à 20 $ par siège standard et par mois en facturation annuelle, ou 25 $ en mensuel, pour des équipes de 2 à 150 personnes (Claude pricing). Les projets peuvent être publics pour toute l'organisation ou privés pour les membres invités, avec les rôles Can view et Can edit. Quand les fichiers d'un projet approchent de la limite de contexte, Anthropic explique que Claude passe tout seul à la recherche et peut en gérer jusqu'à dix fois plus.
Google a renommé NotebookLM en Gemini Notebook cette année, et affirme que plus de 30 millions de personnes et plus de 600 000 organisations l'utilisent. Son modèle de partage est ce qu'il faut comprendre avant d'y téléverser quoi que ce soit. Dans un notebook partagé, un lecteur « a un accès en lecture seule à tous les documents sources et à toutes les notes », et la Chat View, qui masque ces contenus, « ne révoque pas complètement l'accès sous-jacent d'un lecteur » (Google).
D'où une règle unique pour toute cette voie : ne mettez jamais dans un projet ou un notebook partagé un document que vous ne remettriez pas tel quel, sans caviardage, à chaque personne avec qui il est partagé.
Le tableau d'évaluation compare ces assistants aux outils de wiki et à Microsoft Copilot sur cinq critères qui déterminent si les réponses restent justes. Commencez par la dernière colonne.
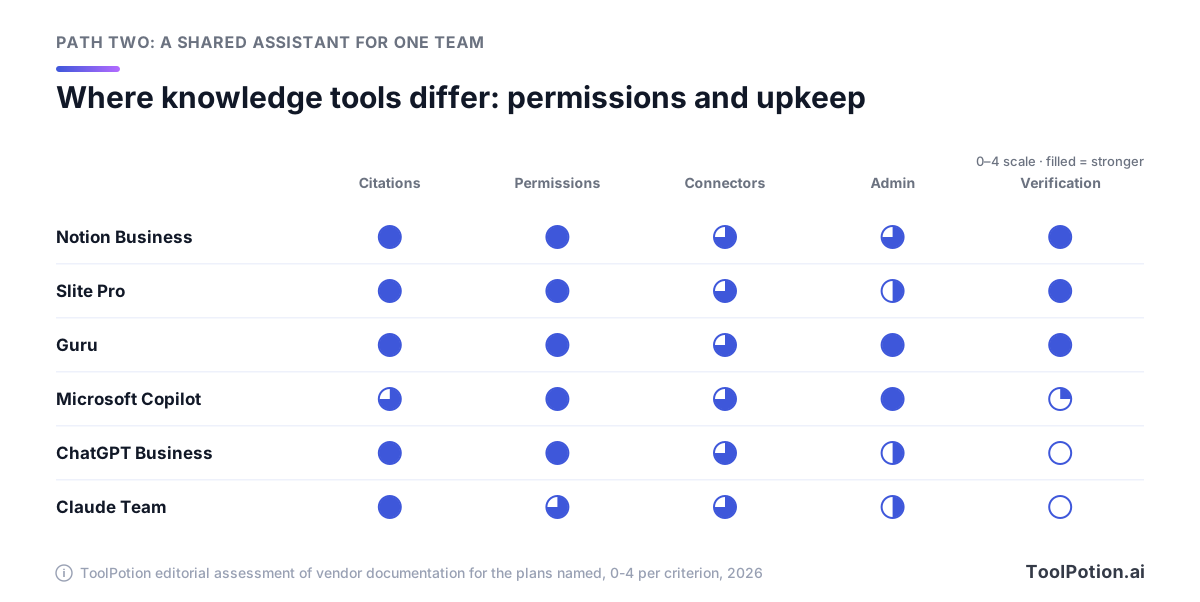
Tous les outils citent leurs sources et respectent les permissions d'origine, Claude perdant un cran à cause des connecteurs à identifiants partagés. La différence se joue sur l'entretien. ChatGPT Business et Claude Team n'ont aucune fonction pour marquer un document comme vérifié ou le signaler comme périmé : la fraîcheur dépend donc entièrement de la personne qui possède les fichiers. C'est acceptable pour une équipe support avec un seul responsable et quelques dizaines de documents. Ça ne passe pas à l'échelle d'une entreprise entière.
Voie 3 : une couche de réponses sur tous vos outils
Quand la réponse à une question courante peut se trouver dans Confluence, un dossier Google Drive, un fil Slack ou un ticket Jira, l'IA d'un wiki n'en voit qu'une partie. Les couches de réponses indexent tout et appliquent dans les résultats les permissions de chaque source. Glean affirme proposer plus de 250 connecteurs et que « les utilisateurs ne voient que ce à quoi ils ont le droit d'accéder ». Il ne publie pas ses prix.
Les anciennes pages d'Agentspace de Google redirigent désormais vers Gemini Enterprise. Son édition Business démarre à 21 $ par siège et par mois, ne demande aucune configuration IT, se connecte à Microsoft 365, Google Workspace, HubSpot et Jira, et mutualise 25 GiB de stockage et d'indexation par siège. Standard et Plus démarrent à 30 $ (Google Cloud).
Microsoft 365 Copilot Business est un module complémentaire d'une offre Microsoft 365 Business, à 21 $ par utilisateur et par mois payé à l'année. Les clients existants qui souscrivent avant fin 2026 bénéficient d'un tarif promotionnel de 18 $ la première année (Microsoft). Microsoft décrit le Copilot Chat gratuit fourni avec les offres éligibles comme ancré sur le web ; vérifiez donc quel Copilot vos équipes utilisent avant de supposer que les réponses viennent de SharePoint.
Si l'on met côte à côte les prix d'entrée par siège, l'écart entre les trois voies est étroit.
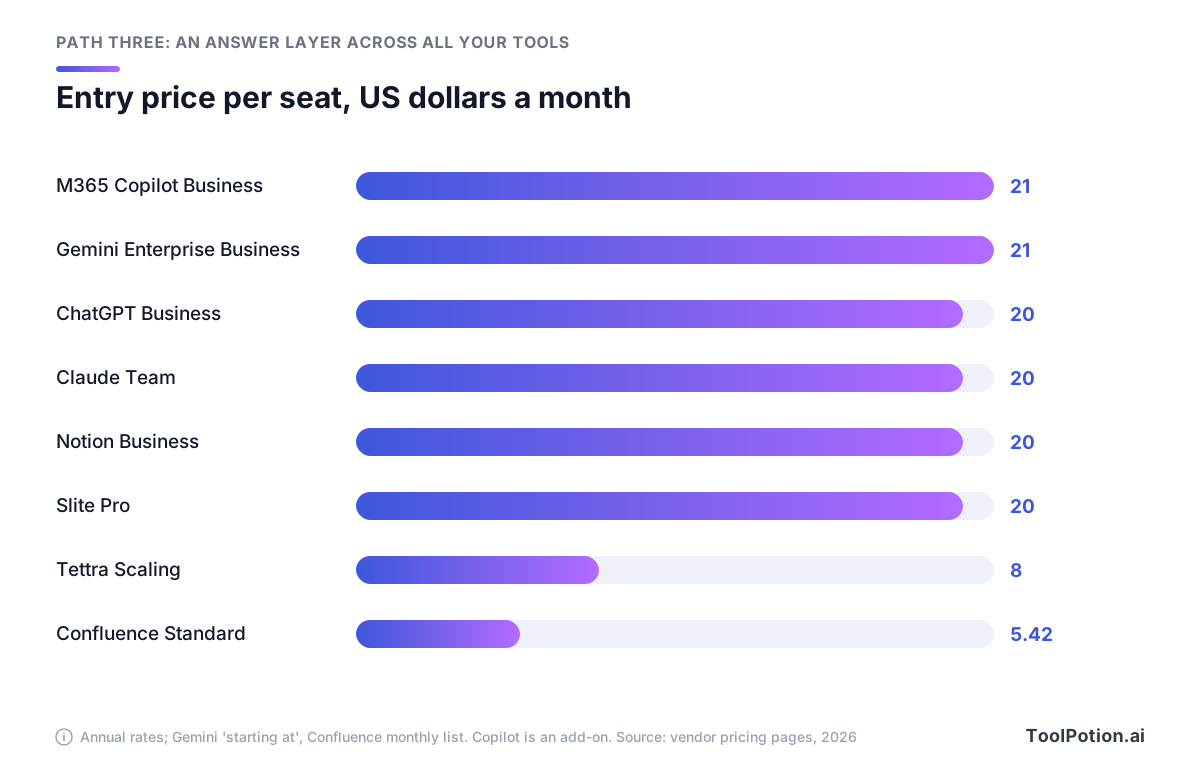
Six des huit offres se situent à 20 ou 21 $ le siège. Tettra est à 8 $, et Confluence Standard à 5,42 $ avec les crédits Rovo inclus. Une entreprise de 50 personnes à 20 $ le siège paie 1 000 $ par mois, soit 12 000 $ par an, et c'est la partie prévisible. Le coût variable, c'est le temps humain pour nettoyer les documents, auditer le partage et relire les réponses, et il est le même quel que soit le fournisseur.
Les éditions business de Gemini Enterprise et de Copilot s'arrêtent toutes deux à 300 sièges : une entreprise de 400 personnes doit donc chiffrer des paliers supérieurs (Gemini Enterprise Standard n'a pas de plafond de sièges). En dessous d'environ 50 personnes avec un seul wiki, passez votre tour sur cette voie. Vous paieriez pour indexer des outils où il y a peu de valeur, et vous hériteriez de chaque erreur de partage qu'ils contiennent.
Pour un panorama plus large que les produits cités ici, le classement des outils de gestion des connaissances IA, mis à jour en continu, classe la catégorie par score ToolRank, et notre comparatif des outils de gestion des connaissances IA passe en revue les leaders plus en détail.
Top 10 des outils de gestion des connaissances IA
- # 1Premier choixNotionApp d’IANotion est un espace de travail AI qui combine documents, wikis, projets et bases de données avec des agents AI personnalisés, une recherche inter-applications et de l'automatisation. Il est conçu pour les individus et les équipes qui souhaitent gérer leur travail à partir d'un seul endroit.90ToolRankÉlite
- # 2Deuxième placeConfluenceApp d’IAConfluence est un espace de travail collaboratif conçu pour que les équipes créent, partagent et gèrent efficacement leurs connaissances. Avec des capacités d'IA, il aide à rédiger, résumer et trouver des informations rapidement, améliorant ainsi la productivité et l'accélération des projets.72ToolRankFort
- # 3Troisième placeGlean – Work AIPlateformeGlean est une plateforme d'IA pour le travail en entreprise qui connecte les connaissances, les systèmes et le contexte. Elle permet aux utilisateurs de trouver, créer et automatiser des tâches dans diverses applications métier, offrant un accès sécurisé et respectueux des permissions, et réduisant le gaspillage de tokens pour un déploiement d'IA plus efficace.66ToolRankFort
- 4RovoApp d’IARovo est le produit GenAI d'Atlassian qui permet aux équipes de tirer parti de la connaissance organisationnelle grâce à Rovo Search, Rovo Chat et des agents Rovo spécialisés, améliorant ainsi la prise de décision et l'efficacité des flux de travail.59ToolRankSolide
- 5AnythingLLMDépôt GitHubAnythingLLM permet aux utilisateurs de posséder leur intelligence plutôt que de la louer. Cet outil fournit tout le nécessaire pour une expérience d'agent robuste en local-first, améliorant la productivité et l'autonomie dans diverses tâches.58ToolRankSolide
- 6Mintlify - Plateforme de Connaissances IntelligenteApp d’IAMintlify est une plateforme de connaissances native à l'IA conçue pour aider les équipes à créer et maintenir une documentation de classe mondiale. Elle intègre l'IA tout au long du cycle de vie de la documentation, de la rédaction et de la révision à la compréhension par l'utilisateur, garantissant que le contenu est accessible aux humains et aux LLM. La plateforme vise à réduire la dette documentaire et à améliorer l'expérience utilisateur.55ToolRankSolide
- 7AnythingLLMApp d’IAAnythingLLM est un assistant IA gratuit et privé qui fonctionne entièrement sur votre propre appareil. Il vous permet de discuter avec des documents, de transcrire des réunions et de créer des agents IA localement sans comptes, clés API ou limites de jetons.55ToolRankSolide
- 8IBM Watson DiscoveryPlateformeIBM Watson Discovery est une plateforme alimentée par l'IA qui améliore la productivité en automatisant la découverte d'informations grâce à un traitement avancé du langage naturel et à un traitement intelligent des documents.54ToolRankSolide
- 9Snowflake CoWork | Agent d'Intelligence d'EntrepriseAgent IASnowflake CoWork est un agent d'intelligence d'entreprise conçu pour les travailleurs du savoir, offrant une analyse gouvernée, de l'automatisation et des actions en un seul endroit. Il permet aux entreprises de bénéficier d'une infrastructure de données sécurisée et évolutive.54ToolRankSolide
- 10ServiceNowPlateformeServiceNow propose une plateforme d'IA conçue pour rationaliser les flux de travail des entreprises, améliorant ainsi la productivité tant pour les clients que pour les employés. Elle offre une solution unifiée pour la transformation numérique des entreprises dans divers secteurs.53ToolRankSolide


Comment fonctionne ToolRank
ToolRank est le moteur de classement propriétaire de ToolPotion.
Il évalue en continu des centaines de signaux issus de tout le web ouvert — trafic réel et popularité, poids de l’audience et de la communauté, autorité et longévité, adoption et engagement — et traite des millions de données pour placer chaque outil à la place qu’il a méritée.
Chaque type d’IA est mesuré par son propre modèle : ce qui prouve l’adoption d’une app SaaS ne vaut pas pour un framework open source ou une chaîne de créateur. L’absence sur une plateforme ne pénalise jamais un outil — ToolRank juge les preuves qui existent.
Aucun placement payant. Aucun chiffre autodéclaré.
Pourquoi les réponses de l'IA sont fausses
Quand un pilote déçoit, regardez les sources avant d'accuser le modèle. Les défaillances sont prévisibles, et la plupart viennent du contenu.
Les pages périmées arrivent en premier. Un modèle ne sait pas distinguer l'ancienne politique de voyage de l'actuelle si la page ne dit pas laquelle est en vigueur ; si les deux sont accessibles, il peut citer la mauvaise avec un aplomb parfait. Les doublons aggravent les choses, car deux versions d'une même politique peuvent produire une réponse qui les mélange et cite les deux.
Le sur-partage est celui qui finit dans un rapport d'incident. Microsoft a créé un contrôle SharePoint, Restricted Content Discovery, pour les organisations qui « ont besoin de temps pour examiner les sites SharePoint, valider les permissions et mettre en place des contrôles de gouvernance » avant que Copilot ne rende le contenu largement découvrable. Microsoft le présente comme temporaire, il ne modifie les permissions de personne, et sur les sites de plus de 500 000 éléments, une mise à jour peut prendre plus d'une semaine. Quand l'éditeur livre une solution de secours pour fichiers sur-partagés, partez du principe que vous en avez.
L'absence de propriétaire transforme de petites erreurs en erreurs permanentes. Si personne ne possède la page citée par une réponse, une erreur signalée n'a nulle part où aller.
Le retard de synchronisation piège les équipes après le lancement. Notion indique que ses connecteurs IA peuvent mettre jusqu'à 36 heures pour ingérer une app connectée, jusqu'à 3 heures pour que du nouveau contenu apparaisse, et que l'intégration remonte en général un an en arrière à partir de sa mise en place (Notion Help). La documentation de Gemini Enterprise précise qu'une synchronisation incrémentale récupère le contenu ajouté et mis à jour, mais pas les données d'identité ni les suppressions, qui attendent une synchronisation complète ou d'identité. Un document que vous avez supprimé ou verrouillé ce matin peut donc rester exploitable dans les réponses pendant un moment. Atlassian affirme que Rovo écoute les changements de permissions et met son index à jour : c'est ce comportement qu'il faut demander à chaque éditeur.
La dernière défaillance est volontaire. Le Top 10 de l'OWASP pour les applications LLM décrit un attaquant qui modifie un document dont s'alimente un système RAG, de sorte que des instructions piégées changent ce que l'IA dit à la personne suivante qui pose une question. Quiconque a des droits d'édition sur une source peut orienter les réponses : gardez donc les droits d'édition plus restreints que les droits de lecture.
Un déploiement sur 30 jours qui commence par vos 50 documents clés
Trente jours suffisent pour un pilote honnête si les deux premières semaines vont aux documents plutôt qu'au logiciel. Cinquante est un chiffre de travail, pas un chiffre magique, et c'est assez petit pour être bouclé en quinze jours.
Dans le plan ci-dessous, le nettoyage commence dès le premier jour et l'IA ne touche aucune source avant la semaine 3.
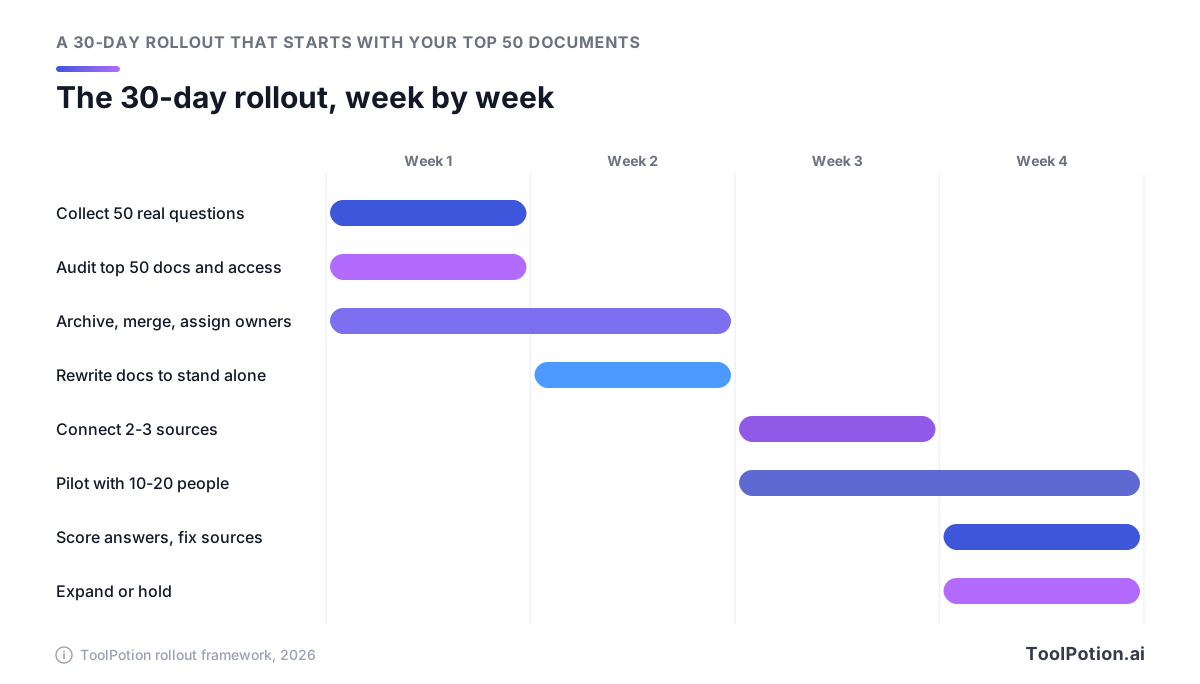
Semaine 1 : collectez de vraies questions, puis trouvez ce qui y répond
Récupérez 50 questions posées récemment, dans les canaux Slack, les tickets du help desk et les points d'accueil des nouveaux arrivants. Gardez leur formulation, fautes de frappe comprises, car c'est ainsi qu'on interrogera l'IA. Pour chaque question, trouvez le document censé y répondre. Cette liste est votre top 50.
Pour chaque document, notez qui en est propriétaire et quand quelqu'un l'a vérifié pour la dernière fois. Ensuite, auditez qui peut le voir. Sur les drives et wikis que vous comptez connecter, traquez le partage « toute personne disposant du lien » et les accès à l'échelle de l'organisation sur les dossiers RH, finance ou juridique. Les espaces appartenant à des personnes qui ont quitté l'entreprise vont sur la même liste.
Semaine 2 : nettoyez les 50 documents
Archivez ou supprimez les doublons pour que chaque question ait une seule réponse à jour, et faites pointer les pages remplacées vers leur remplaçante. Donnez à chaque page un propriétaire nommé et une date de revue. Puis réécrivez pour la recherche. L'IA lit des passages, pas des pages entières : un paragraphe qui dit « la limite est désormais de 50 $ » ne veut plus rien dire une fois détaché de son titre. Nommez la politique, l'équipe, la région et l'année à l'intérieur du passage. Anthropic recommande des noms de fichiers clairs et descriptifs pour les projets Claude, et les titres obéissent à la même logique.
Passez chacun des 50 documents à travers cette fiche avant qu'il n'approche d'un connecteur.
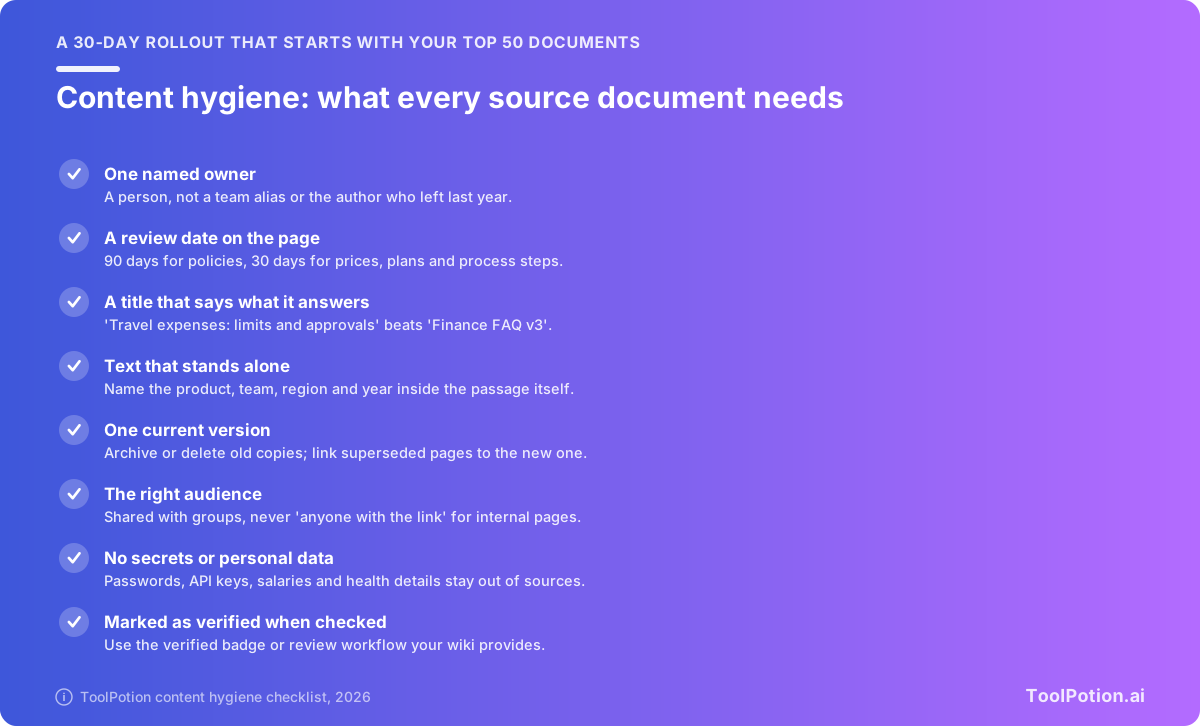
Le dernier point dépend de votre outil. Notion et Slite intègrent la vérification, et Tettra signale les pages périmées et sans propriétaire. Dans un projet ChatGPT ou Claude, une date de revue dans le nom du fichier ou sur la première ligne est le substitut praticable.
Semaines 3 et 4 : connecter, piloter et noter
Connectez deux ou trois sources, pas tout. Laissez les espaces RH, finance et juridique en dehors de la première passe, même si leurs permissions semblent correctes. Choisissez 10 à 20 utilisateurs pilotes dans différentes équipes et demandez-leur d'utiliser l'IA pour leur vrai travail (notre plan de première semaine avec l'IA au travail aide les débutants). Posez vos 50 questions à la fin de la semaine 3, puis de nouveau en semaine 4, et notez-les ainsi :
- Classez chaque réponse comme juste, partiellement juste ou fausse.
- Ouvrez les citations. Une bonne réponse qui cite une page obsolète est un échec en attente.
- Comptez les questions restées sans réponse. Un taux élevé de non-réponses pointe souvent un document manquant plutôt qu'un outil faible.
- Envoyez chaque mauvaise réponse au propriétaire de la page citée et suivez combien sont corrigées dans la semaine.
- N'étendez que si les résultats franchissent un seuil fixé à l'avance, par exemple 45 bonnes réponses sur 50.
Avant de connecter quoi que ce soit, évaluez où vous en êtes. Les éléments à deux points sont les failles qui produisent les pires réponses.
En dessous de 6 points, continuez à nettoyer. Connecter maintenant ferait remonter des fichiers périmés et sur-partagés plus vite que les gens ne peuvent les corriger. À partir de 6, vous pouvez lancer un pilote avec un petit groupe, et à partir de 10, vos sources sont en assez bon état pour étendre par étapes.
Une gouvernance qui garde les réponses justes
Un bon déploiement vous mène au jour du lancement. Garder les réponses justes ensuite demande quelques habitudes peu glamour.
Chaque source a besoin d'un propriétaire nommé, une personne et non un alias d'équipe. Quand quelqu'un part, ses pages sont réaffectées dans la même checklist de départ que celle qui récupère son ordinateur portable. Les pages sans propriétaire doivent sortir des sources de l'IA jusqu'à ce que quelqu'un les réclame.
Fixez les dates de revue selon la vitesse à laquelle le contenu change. Quatre-vingt-dix jours conviennent aux politiques. Les prix, les détails d'offres et les étapes de processus demandent un coup d'œil tous les 30 jours. Une page qui dépasse sa date est vérifiée ou archivée, et dans un outil avec vérification, elle est re-vérifiée ou perd son badge.
Partagez avec des groupes, pas avec des individus, pour que les accès suivent les changements de rôle. Examinez le partage avant de connecter une source, ce qu'Atlassian demande aux clients de Rovo pour chaque app tierce. Et privilégiez les connecteurs où chaque personne se connecte avec son propre compte, car un identifiant partagé donne à tout le monde la même vue.
Certains contenus ne devraient jamais se trouver à portée de l'IA, aussi serrées que paraissent les permissions :
- Mots de passe, clés API et autres identifiants.
- Salaires, données de santé et détails de dossiers RH individuels.
- Données personnelles de clients au-delà de ce dont une équipe a besoin pour servir ce client.
- Documents couverts par le secret professionnel, y compris tout ce qui relève d'un gel de conservation lié à un litige.
- Brouillons non relus qui ressemblent à une politique officielle.
Vérifiez ce que chaque éditeur fait de vos données. OpenAI affirme ne pas entraîner de modèles sur les données des espaces de travail ChatGPT Business par défaut, Claude Team indique aucun entraînement de modèle sur votre contenu par défaut, et Microsoft dit que les données consultées via Microsoft Graph ne servent pas à entraîner les modèles de fondation. La rétention diffère davantage : Notion indique 30 jours de rétention chez ses fournisseurs de LLM sur les offres inférieures et zéro rétention en Enterprise. Notre cadre de confidentialité pour les outils IA détaille les questions à poser.
Enfin, gardez la boucle de retour active. Donnez aux gens un moyen rapide de signaler une mauvaise réponse, faites suivre le signalement au propriétaire de la page, et passez en revue les signalements chaque mois. La boucle du premier schéma ne fonctionne que si quelqu'un la referme.
Questions fréquentes
Faut-il un nouvel outil, ou l'IA de notre wiki suffit-elle ?
Commencez par l'IA du wiki et ses connecteurs. N'ajoutez une couche de réponses que si les questions sans réponse de votre pilote se révèlent vivre dans des outils que le wiki ne peut pas atteindre.
L'IA peut-elle montrer à quelqu'un un document qu'il ne devrait pas voir ?
Pas un document qu'il ne peut pas déjà ouvrir, sur les produits couverts ici. Le risque, ce sont les fichiers qu'il peut ouvrir mais ne devrait pas, comme un dossier partagé à toute l'entreprise par erreur, ainsi que tout ce qui est accessible via un connecteur à identifiants partagés.
Combien coûte une base de connaissances IA pour une équipe de 50 personnes ?
Aux prix catalogue, environ 1 000 $ par mois sur n'importe laquelle des offres à 20 $ : Notion Business, Slite Pro, ChatGPT Business ou Claude Team, toutes en facturation annuelle. Confluence Standard revient à 271 $ par mois avec son allocation Rovo, et Tettra Scaling à 400 $. Prévoyez en plus du temps humain pour le nettoyage.
NotebookLM existe-t-il toujours ?
Oui, sous un nouveau nom. Google l'a renommé Gemini Notebook cette année et affirme qu'il reste un produit autonome. L'ancienne adresse notebooklm.google redirige désormais vers notebook.google, et l'édition Business de Gemini Enterprise inclut Gemini Notebook pour l'entreprise.
Faut-il plutôt construire notre propre système RAG ?
Pour la plupart des entreprises de 10 à 500 personnes, non. Les outils clés en main gèrent déjà la synchronisation des permissions et les citations, qui sont les parties difficiles. Construire a du sens quand les réponses doivent vivre dans votre propre produit ou s'appuyer sur des données qu'aucun éditeur ne connecte, et le classement des bases de données vectorielles et de la recherche est un bon point de départ.