

GitHub indique que, dans l'Artificial Analysis Coding Agent Index, Copilot Fusion Max « a obtenu 60, à moins de deux points de Claude Code avec Opus 5.5 Max » (GitHub changelog). Le titre de The New Stack en a fait un système qui « bat Claude Code pour moitié moins de coût d'API » (The New Stack). Ce ne sont pas les mêmes phrases, et c'est dans l'écart entre les deux qu'une équipe doit réfléchir.
Fusion est disponible en disponibilité générale dans GitHub Copilot, sous la forme d'une nouvelle entrée dans le sélecteur de modèles. Vous ne choisissez pas un modèle. Vous choisissez un niveau d'effort, et Copilot décide quels modèles tournent, et dans quel ordre, pour chaque prompt. C'est une bonne idée, appuyée sur des preuves minces : nous la traiterions d'abord comme une fonctionnalité de maîtrise des coûts, et seulement ensuite comme une promesse de qualité.
Soixante n'est pas soixante-deux
Relisez la formulation de GitHub. Fusion Max est arrivé à moins de deux points de Claude Code sur Opus 5.5 Max, pour environ la moitié du coût moyen d'API par tâche, environ la moitié des tokens et environ 40 % de temps en moins (changelog). C'est un résultat honorable et un argumentaire recevable. Ce n'est pas une victoire, et le corps de l'article de The New Stack parle lui-même de « comparable » sous un titre qui dit « bat ». GitHub a repris l'argument dans son bilan de Universe, où « moitié moins cher » est la version qui circule.
Artificial Analysis publie l'index que cite GitHub. Il combine trois benchmarks, FrontierCode, Terminal-Bench 4.0 et SWE-Atlas-QnA-AA, à poids égal (Artificial Analysis). La vue par défaut de cette page affiche Claude Code sur Opus 5.5 Max à 62, sans entrée Fusion. Activez le bouton « Router models » et GitHub Copilot - Copilot Fusion (Max) apparaît à 60 : le chiffre est donc réel et correspond à ce que GitHub annonce. Le même bouton fait apparaître Devin Fusion CLI de Cognition, qui associe Opus 5.5 Max et GPT-6 Luna, à égalité avec Claude Code à 62. Cela montre que les routeurs, en tant que catégorie, rattrapent leur retard, pas que celui de GitHub est le meilleur. Nous n'avons pas comparé les colonnes de coût de la page au chiffre de « moitié moins cher » de GitHub : sur ce point, il faut donc encore croire GitHub sur parole.
Trois chemins derrière une seule entrée de menu
La documentation décrit Fusion comme « un routeur et orchestrateur de modèles intelligent à l'exécution » (GitHub Docs). Pour chaque prompt, il choisit l'un de trois schémas d'exécution, et des prompts différents d'une même session peuvent emprunter des chemins différents.
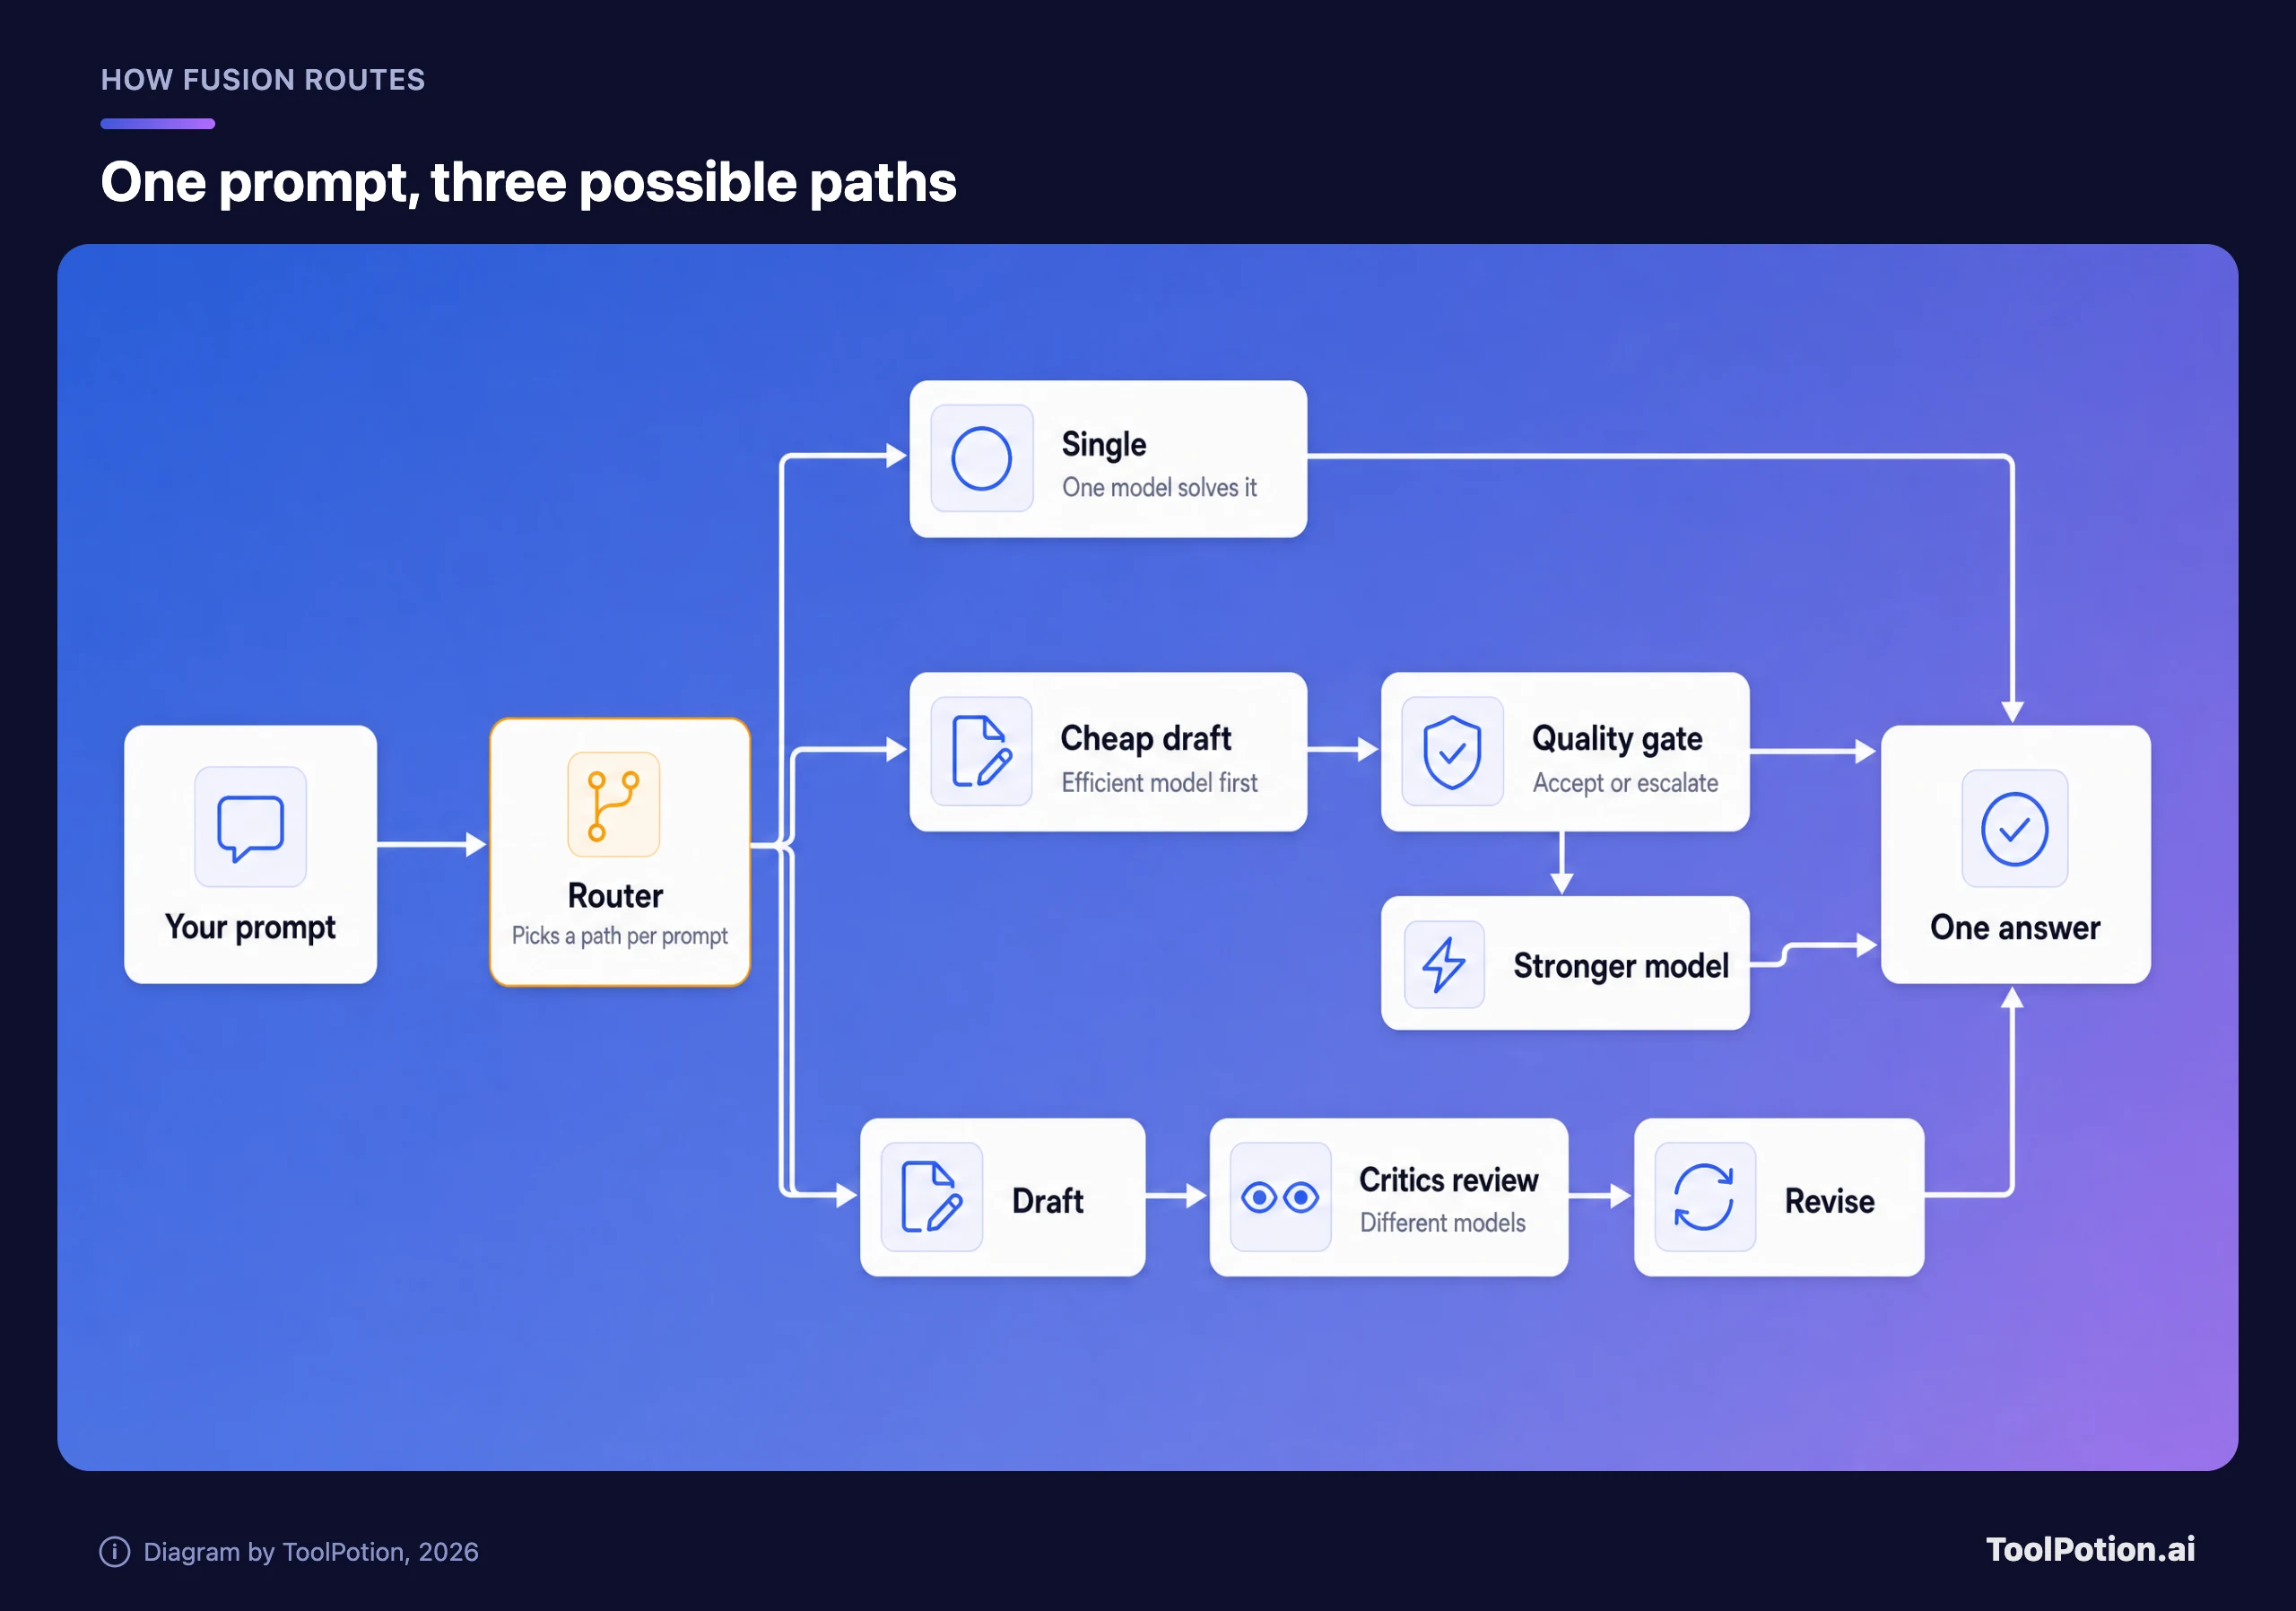
Single : un seul modèle répond directement. Cascade : un modèle économique rédige un brouillon, puis un juge décide de l'accepter ou de passer la main à un modèle plus puissant. Critique : un modèle rédige pendant que d'autres modèles le relisent, puis le rédacteur révise. Les niveaux d'effort règlent l'agressivité du routage : Standard pour le travail courant, High pour les tâches conséquentes, Max pour le raisonnement le plus difficile.
Un détail a changé entre la préversion et le lancement. L'article de GitHub sur la préversion de recherche décrivait « un critique indépendant en lecture seule, issu d'une autre famille de modèles » (GitHub blog). Le changelog de lancement dit « un autre modèle le relit », tandis que la documentation indique que plusieurs modèles critiquent en parallèle et que leurs retours sont agrégés. Notre lecture : l'étape de critique est passée d'un relecteur à plusieurs, mais GitHub ne le dit pas, et le changelog ne signale pas la différence.
Tous les forfaits y ont droit, et vous payez chaque modèle
Selon le changelog, Fusion est disponible sur tous les forfaits Copilot dans VS Code, l'application Copilot, Copilot CLI et les IDE JetBrains, avec d'autres clients à venir. Chaque modèle utilisé est facturé à son tarif standard, sans frais Fusion distincts. Les forfaits payants bénéficient d'une remise de 30 % sur les coûts des modèles pour une durée limitée, et la documentation fixe la fin de cette remise plus tard cette année (docs).
Deux points restent flous. La documentation de Fusion indique qu'il est « disponible avec tous les forfaits GitHub Copilot ». La page des forfaits précise qu'avec Free et Student, l'accès aux modèles passe uniquement par la sélection automatique. GitHub ne concilie pas les deux. Le tableau des niveaux d'effort par forfait dans la documentation signale la disponibilité par des icônes qui se sont affichées comme des cellules vides à la lecture, donc nous ne pouvons pas vous dire quels niveaux sont accessibles sur Free et Student. Vérifiez dans votre propre sélecteur. Et comme High et Max peuvent appeler plusieurs modèles, la documentation prévient elle-même qu'une tâche peut consommer plus de crédits d'IA qu'avec Standard. « Moitié moins cher par tâche » est une affirmation sur Max face à Claude Code, pas une promesse sur votre solde de crédits.
Le benchmark, c'est GitHub qui note GitHub
L'article antérieur sur HydraFusion est plus franc que le lancement. Ses tests utilisaient le même niveau de raisonnement moyen pour tous les modèles, s'appuyaient sur des coûts estimés selon des hypothèses de tarification communes, et comparaient à Opus 5 et GPT-5.6 Sol. GitHub précise aussi avoir réglé sa politique de routage par beam search sur les trois mêmes benchmarks que ceux qu'il a publiés (GitHub blog).
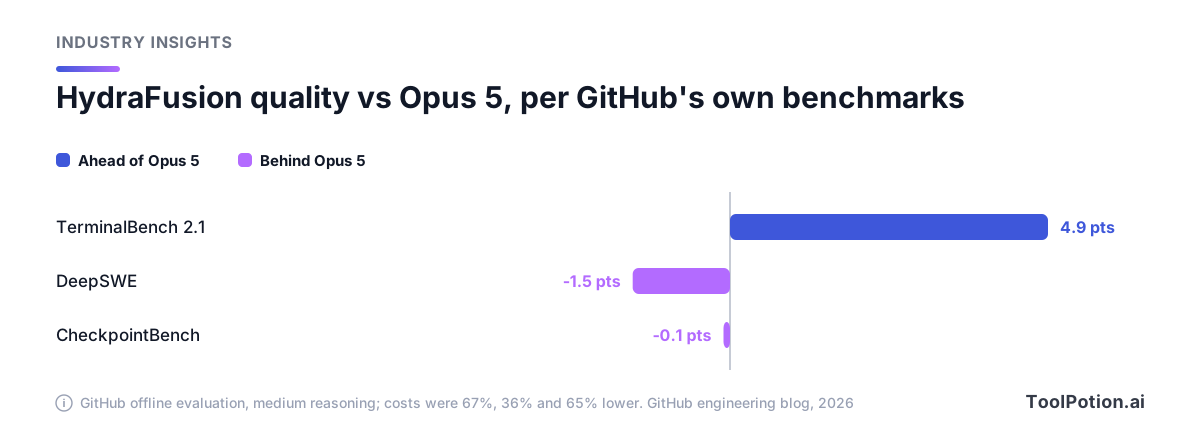
Regardez la forme. Un benchmark montre un gain de 4,9 points. Les deux autres affichent de petites pertes, avec des coûts inférieurs de 36 % à 67 %. C'est une histoire de coûts avec une qualité à peu près maintenue, ce que le texte du lancement a fini par dire aussi.
Sur Hacker News, les développeurs se sont attaqués à la référence de comparaison. Un commentateur a écrit qu'« Opus 5 (en pratique) n'est pas une bonne référence de comparaison » (HN). Un autre doutait du résultat : « Il ne faut pas grand-chose pour battre l'état de l'art sur un benchmark isolé si l'on met du logiciel supplémentaire entre le modèle et le harness » (HN). Un utilisateur de Copilot CLI, dans le même fil, a affirmé que le mode auto « ne change de modèle qu'au début d'une session ou après une compaction » (HN), et un autre a jugé la sélection automatique « pratiquement inutilisable » pour lui (HN). Ce sont des avis isolés, pas des études. Ils montrent en revanche où se situe le scepticisme.
Il y a aussi un décalage de facturation à garder en tête. L'index et la comparaison de GitHub reposent sur le coût d'API à la consommation de tokens. Un développeur abonné à un forfait fixe Claude Code ne voit jamais ce chiffre : « moitié moins cher » ne résonne donc pas de la même façon pour un utilisateur solo que pour une équipe qui suit sa dépense d'API. Artificial Analysis note d'ailleurs que beaucoup d'utilisateurs accèdent à ces outils via des abonnements plutôt qu'au paiement par token. Cette conclusion est notre inférence, pas une affirmation de GitHub, mais elle change le public visé par le titre.
Le seul témoignage client fourni par GitHub est celui de Hari Pokhrel, d'AT&T, cité dans le changelog de GitHub : « Auparavant, les développeurs choisissaient souvent un modèle plus puissant pour une tâche complexe et oubliaient de revenir en arrière pour les activités du quotidien. » C'est l'argument honnête en faveur de Fusion : il évite que l'on laisse un modèle coûteux activé pour le travail de routine.
Votre politique décide qui lit votre diff
C'est la partie que nous lirions avant le benchmark. Fusion n'utilise que les modèles activés dans les politiques de votre entreprise et de votre organisation. Les admins peuvent désactiver certains modèles pour Fusion sans les désactiver partout, et les modèles exclus par les politiques de résidence des données ou FedRAMP sont écartés (docs).
La relecture par un second modèle est le pari de conception, et l'article de préversion précise que ce relecteur vient d'une autre famille de modèles. Si cela signifie un autre éditeur, il voit votre diff : c'est une décision de traitement des données que quelqu'un dans votre équipe doit prendre en connaissance de cause. Après une réponse, vous pouvez survoler l'étiquette de niveau d'effort pour voir quels modèles ont tourné.
La section sur les limites compte aussi. Si Fusion écarte un brouillon, les modifications de fichiers que ce brouillon avait déjà faites ne sont pas annulées automatiquement : relisez donc le diff avant de commiter. Fusion n'a pas non plus de fenêtre de contexte propre : le chiffre affiché correspond au plus petit de ceux de ses modèles.
Où nous le placerions dans un essai en équipe
Nous ferions de Fusion Standard le réglage par défaut d'une équipe Copilot, et nous écarterions Max comme défaut. Son 60 sur l'index indépendant est honorable, mais Max est le niveau qui appelle le plus de modèles et dépense le plus de crédits. Standard est là où se trouve l'histoire d'AT&T et là où le routage économise le plus. Pour les équipes déjà sur Claude Code ou Codex, la question de la dépendance se pose à l'envers : ces outils sont liés aux modèles d'un seul éditeur, alors que Fusion est un routeur que GitHub contrôle et peut rebattre à sa guise. Aucun des deux n'est exempt de dépendance.
Nos comparatifs existants portent sur les outils eux-mêmes : les agents de code en terminal, Cursor face à Copilot et Windsurf, l'association des niveaux de modèles aux tâches et la liste plus large des outils de code. Fusion change la colonne des coûts dans ces comparatifs, pas l'outil que vous choisiriez. Les utilisateurs de Cursor n'ont pas encore de verdict équivalent, et le classement ToolRank des assistants de code est l'endroit où voir comment le secteur se classe aujourd'hui.
Le test qui tranche ne coûte presque rien. Prenez dix vrais tickets, passez-les dans Fusion Standard et dans votre configuration actuelle, puis comptez les changements acceptés et les crédits dépensés. La remise de GitHub prend fin plus tard cette année : mesurez avant. Ensuite, retournez voir la vue Router models sur Artificial Analysis, car ce sont les entrées de routeurs qui risquent le plus de bouger.