

La recherche passe d'une liste de liens à une réponse unique, et les plateformes qui s'interposent entre vous et votre audience redéfinissent qui est payé et qui reçoit des visites. La réponse durable est sobre et efficace : possédez un canal où vos lecteurs peuvent vous retrouver sans dépendre d'aucun algorithme, décidez en connaissance de cause quels crawlers d'IA peuvent utiliser votre travail, et publiez des pages qu'un moteur de réponses peut citer proprement.
Le sujet est d'actualité parce que les annonces sont toutes tombées à quelques jours d'intervalle en 2026. Google rémunère certains éditeurs pour leurs contributions à l'IA, Reddit ferme ses flux ouverts, et Instagram, YouTube et Spotify donnent aux créateurs et aux auditeurs des contrôles IA sur ce qui est mis en avant. Ce guide transforme ces nouvelles en un plan que vous pouvez appliquer dès cette semaine, que vous publiiez une newsletter, une chaîne, un blog de boutique ou un podcast.
C'est un guide pratique, pas une prédiction. Quand un chiffre vient d'un rapport, nous disons de qui il émane. Quand Google, OpenAI ou Perplexity documente un contrôle, nous renvoyons vers la documentation. Pour la partie outillage SEO, notre sélection des meilleurs outils SEO IA passe les logiciels en revue. Cet article traite de la stratégie que ces outils servent.
La recherche s'arrêtait sur votre site
Dans la recherche classique, une personne tapait une requête, parcourait dix liens et en cliquait un. Le clic était le produit. Vos statistiques, vos emplacements publicitaires, votre formulaire d'inscription à la newsletter se trouvaient tous de l'autre côté.
Une réponse d'IA change le milieu de ce parcours. Le lecteur obtient une réponse synthétisée avec quelques sources citées, et le clic devient facultatif. Certains cliquent encore, et Google indique que les pages affichées comme liens de référence dans AI Overviews et AI Mode sont comptabilisées dans votre trafic Web habituel de la Search Console. Mais le lecteur qui clique a souvent déjà l'essentiel, donc la visite est moins nombreuse et l'intention plus chaude.
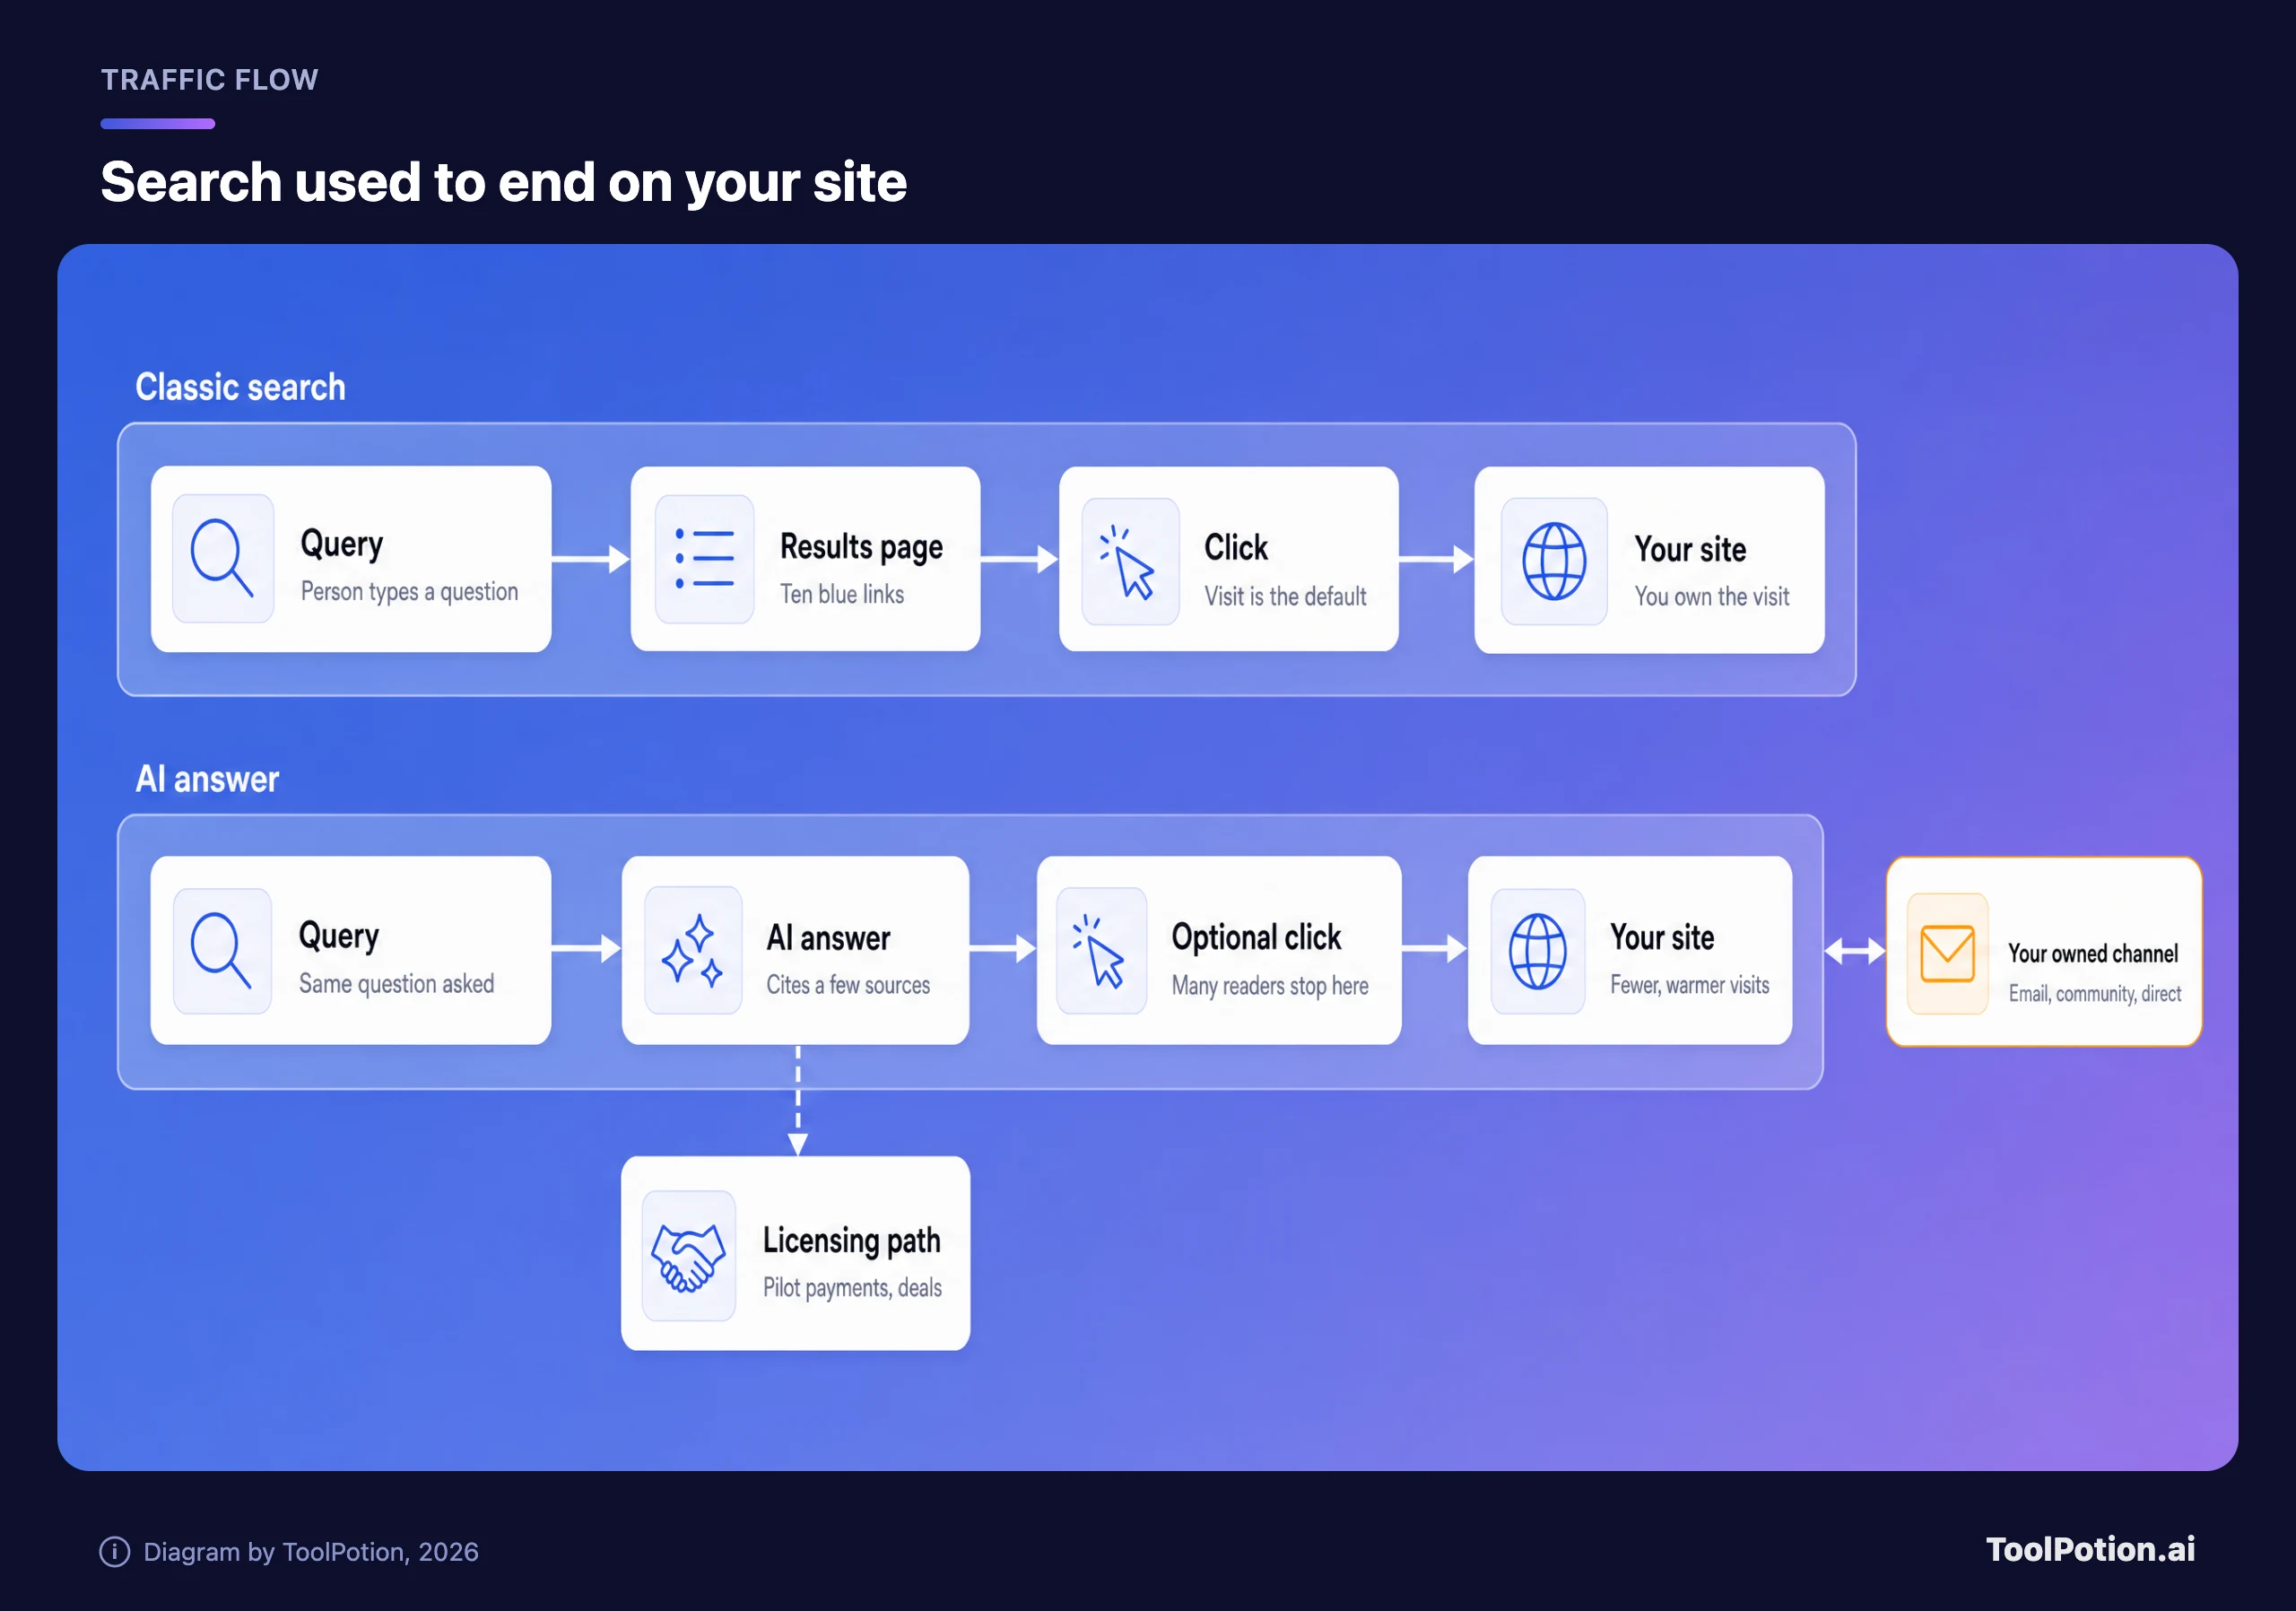
Le schéma montre aussi la voie parallèle qui est nouvelle cette année : la licence. Si votre contenu alimente la réponse, quelqu'un peut vous payer pour cela. Reste à savoir si ce quelqu'un paie suffisamment.
Ce que les plateformes paient, et ce qu'elles ferment
Le programme pilote de Google est le point de repère le plus net. Selon The Information, relayé par The Verge, une centaine d'éditeurs ont rejoint un programme qui rémunère selon la contribution de leur contenu à AI Overviews, AI Mode et au chatbot Gemini. Un éditeur entré dès le lancement aurait gagné plus d'un million de dollars en un an. Un autre, arrivé il y a quelques mois, a perçu environ 50 000 à 60 000 $, d'après le même rapport. À notre connaissance, Google n'a pas publié ces chiffres lui-même.
Ce sont les chiffres encourageants, et ils reposent sur un seul rapport. Les premiers entrants et les suivants touchent des chèques très différents, et personne en dehors du pilote ne peut modéliser le vôtre.
The Verge note aussi que le Royaume-Uni a décidé que Google devait permettre aux éditeurs de refuser d'apparaître dans les fonctions de recherche IA, et que l'Union européenne a ouvert une enquête sur l'impact sur le trafic web. Si ces décisions tiennent, le retrait devient un vrai levier plutôt qu'une option théorique.
Reddit illustre l'autre posture. La plateforme met fin aux flux RSS plus tard cette année et à l'accès public à son API début 2027, rapporte TechCrunch, en invoquant le scraping à grande échelle et les abus automatisés. Le même article indique que les « autres revenus » de Reddit, qui incluent les licences IA, ont progressé de 24 % sur un an pour atteindre 43 millions de dollars, et que les assistants IA qui répondent à partir de contenus Reddit devront conclure des accords commerciaux une fois la porte refermée. Quel qu'en soit le motif, l'effet est le même pour quiconque s'appuyait sur les flux Reddit : le web ouvert se réduit et l'accès devient un produit payant.
La leçon est inconfortable pour un petit éditeur. Vous ne pouvez probablement pas négocier aujourd'hui avec Google ou OpenAI. Vous pouvez en revanche décider de ce que votre propre site autorise, et cesser de dépendre d'un tuyau que quelqu'un d'autre s'apprête à mettre sous compteur.
Les assistants vous guident vers les objectifs de chaque plateforme
Pendant que l'accès se resserre, les plateformes offrent aux créateurs une aide IA. L'application Edits d'Instagram dispose désormais d'un assistant créatif qui exploite les données de votre compte, que The Verge détaille ainsi : mentions J'aime, vues, rétention et partages. Vous pouvez demander pourquoi une vidéo a fonctionné et une autre non, ou quelle accroche utiliser. YouTube vient de mettre à jour son propre tableau de bord IA pour les créateurs, que le même article décrit comme expliquant aux créateurs comment maximiser l'engagement.
C'est utile, mais c'est aussi une boucle fermée. Les deux assistants optimisent l'engagement sur leur plateforme. The Verge soulève l'inquiétude évidente : quand tout le monde optimise les mêmes indicateurs, les contenus convergent et l'avantage de suivre ces conseils s'amenuise.
Côté audience, ça bouge aussi. YouTube permettra aux spectateurs de créer un fil personnalisé à partir d'un prompt grâce à Gemini, épinglé comme un onglet de la page d'accueil à côté des recommandations habituelles. Le Taste Profile de Spotify permet aux abonnés Premium américains de 18 ans et plus de modifier leurs recommandations en langage naturel, l'accueil changeant en quelques heures. Et ChatGPT suggère désormais des applications tierces en pleine conversation, avec 16 partenaires de lancement dont Notion et Vercel, ainsi qu'une marketplace d'entreprise de plus de 30 partenaires.
Pris ensemble, ces éléments montrent une découverte qui se scinde. Votre audience dira de plus en plus à un assistant ce qu'elle veut, et l'assistant décidera de ce qu'il met en avant. Voici comment ces fonctions se comparent.
Le schéma de la dernière colonne est l'enseignement clé. Presque tous les contrôles sont du côté de la plateforme ou du spectateur, et presque aucun de votre côté. C'est pourquoi la stratégie ci-dessous commence par ce que vous maîtrisez.
Classez vos canaux : possédés, loués ou sous licence
Un canal est possédé si vous pouvez joindre la personne demain sans demander la permission à personne. Une liste d'e-mails en fait partie. Un site avec des visiteurs directs aussi, tout comme une communauté que vous animez sur une infrastructure que vous contrôlez. Un canal est loué si une plateforme décide qui voit votre publication. Les fils sociaux, les plateformes vidéo et les marketplaces entrent dans cette catégorie. La licence est la couche la plus récente : des entreprises d'IA ou des moteurs de recherche qui paient pour le droit de réutiliser votre travail.
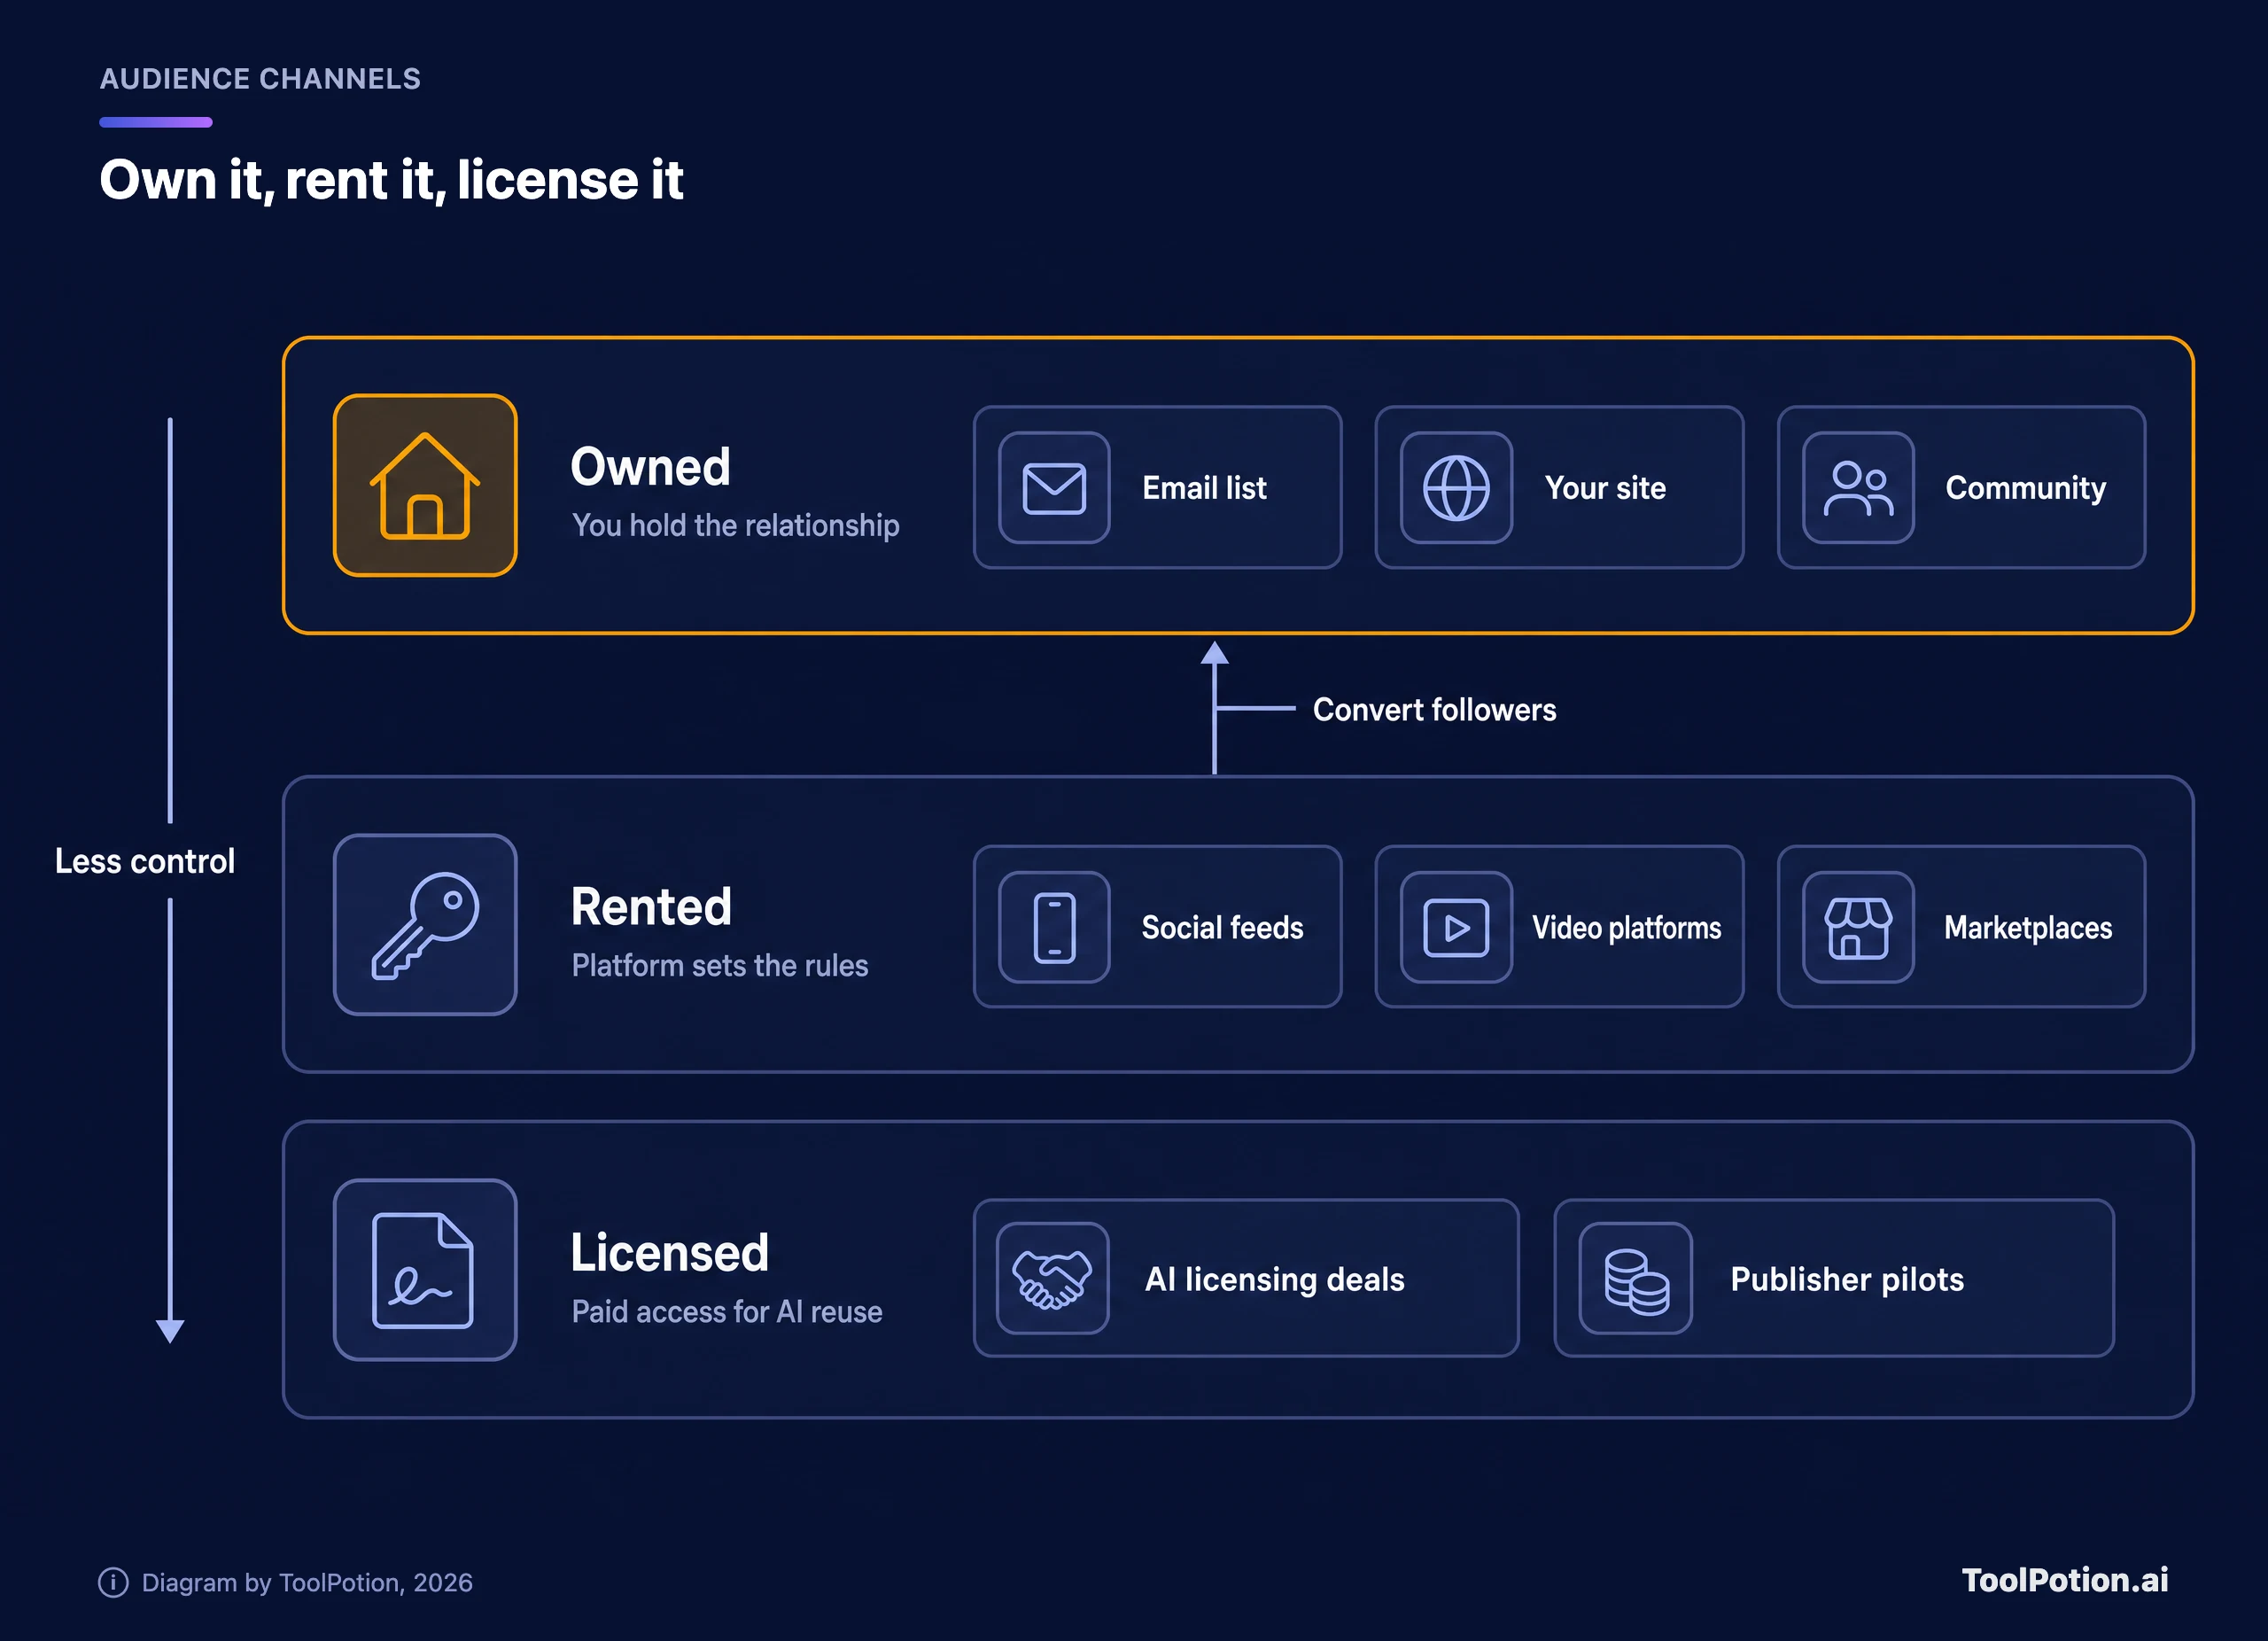
Les canaux loués restent utiles. C'est là que se fait la découverte. L'erreur est de traiter un nombre d'abonnés comme un actif alors que la plateforme peut le rebattre du jour au lendemain. Chaque publication louée doit avoir une mission, et cette mission consiste le plus souvent à amener la personne vers un canal que vous possédez.
Pour l'e-mail, une plateforme comme beehiiv ou Mailchimp est le point de départ habituel, et notre annuaire montre comment des newsletters IA établies comme Superhuman AI et Axios AI+ fidélisent leur audience. Côté communauté, un serveur Discord comme celui de Midjourney montre ce qu'un espace animé par un créateur peut devenir.
Essayez le calculateur ci-dessous avec la répartition de vos propres statistiques. C'est une heuristique, pas une prévision : il additionne les parts de recherche et de réseaux sociaux pour montrer quelle proportion de votre trafic passe par des canaux loués, puis applique une baisse supposée des clics de recherche que vous fixez vous-même.
Si le trafic loué dépasse environ 70 %, un seul changement de politique chez une plateforme peut vous faire très mal. Entre 40 % et 70 %, vous êtes exposé mais pas fragile. Sous 40 %, vous avez déjà une base solide. Ces seuils sont notre règle empirique : ajustez-les à votre tolérance au risque.
Définissez une politique d'accès des bots en connaissance de cause
La plupart des sites n'ont aucune décision écrite concernant les crawlers d'IA. Ils bloquent tout parce que cela semble prudent, ou autorisent tout parce qu'ils n'ont jamais regardé. Dans les deux cas, c'est un choix par défaut. Mieux vaut prendre une décision par bot, en fonction de ce que chacun fait réellement.
OpenAI en exploite trois. Sa documentation sur les crawlers indique qu'OAI-SearchBot fait apparaître les sites dans les fonctions de recherche de ChatGPT et que les sites qui se sont retirés ne seront pas affichés dans les réponses de recherche de ChatGPT. GPTBot collecte du contenu pour entraîner des modèles génératifs. ChatGPT-User gère les actions déclenchées par une personne, et les règles du robots.txt peuvent ne pas s'y appliquer. Chaque réglage est indépendant, et OpenAI précise qu'il peut falloir environ 24 heures après une mise à jour du robots.txt pour que ses systèmes de recherche s'ajustent.
Le jeton Google-Extended de Google détermine si le contenu exploré peut servir à entraîner les futurs modèles Gemini et à l'ancrage (grounding) dans les applications Gemini. Google précise qu'il n'affecte pas l'inclusion dans Google Search et n'a aucune incidence sur le classement. AI Overviews dépend en revanche des contrôles habituels de la Recherche : le guide des fonctions IA cite nosnippet, data-nosnippet, max-snippet et noindex.
La documentation de Perplexity répartit ses bots en deux. PerplexityBot fait apparaître et référence les sites dans les résultats de Perplexity et, selon l'entreprise, n'est pas utilisé pour explorer le web en vue d'entraîner des modèles de fondation. Perplexity-User récupère des pages quand une personne le demande, et Perplexity indique qu'il ignore généralement le robots.txt pour ces requêtes puisqu'elles sont initiées par un utilisateur.
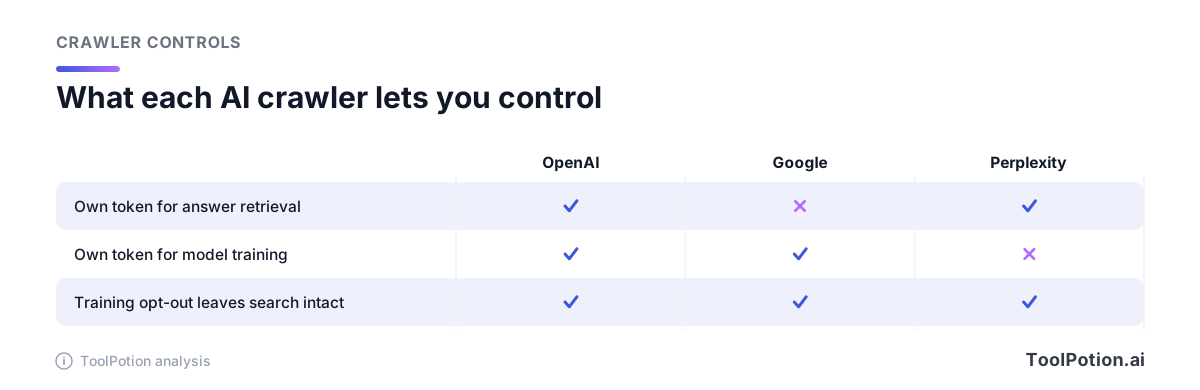
Voici une configuration par défaut raisonnable pour un éditeur qui veut des citations mais pas offrir ses données d'entraînement. Autorisez les bots de recherche (OAI-SearchBot et PerplexityBot), interdisez le jeton d'entraînement (GPTBot) et Google-Extended (entraînement et grounding de Gemini), et ne touchez pas à Googlebot. Un robots.txt correspondant ressemble à ceci.
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# OpenAI model training
User-agent: GPTBot
Disallow: /

# Gemini training and grounding only. Does not affect Search or AI Overviews.
User-agent: Google-Extended
Disallow: /
Remarquez ce que ce fichier ne fait pas. Interdire Google-Extended ne vous retire pas d'AI Overviews ni d'AI Mode, car ceux-ci dépendent de Googlebot et des contrôles de la Recherche. Pour limiter ce que Google affiche d'une page, utilisez plutôt nosnippet, data-nosnippet, max-snippet ou noindex, en sachant que chacun vous coûte de la visibilité.
Une boutique ou une entreprise de services peut préférer l'inverse et tout autoriser, car être nommé dans une réponse est justement le but. Un éditeur à paywall qui vise des accords de licence peut bloquer davantage. Si vous comptez négocier, une politique écrite et des logs serveur propres sont votre preuve de ce que vous contrôlez.
Publiez des pages qu'une réponse d'IA peut citer
Google est catégorique : il n'y a pas d'astuce spéciale. Ses consignes indiquent qu'aucune exigence supplémentaire n'est requise pour apparaître dans AI Overviews ou AI Mode, et que vous n'avez besoin ni de nouveaux fichiers lisibles par les machines ni de balisage propre à l'IA. Une page doit être indexée et pouvoir s'afficher avec un extrait. Le premier audit est donc rébarbatif : vérifiez qu'aucune page que vous voulez voir citée ne porte un noindex ou un nosnippet égaré.
Ensuite, le travail est éditorial. Les moteurs de réponses citent les pages qui énoncent clairement un fait, indiquent d'où il vient et disent qui l'a écrit. Ouvrez chaque section par la réponse, mettez le chiffre et sa source dans la même phrase, et datez vos affirmations. Les données originales valent mieux que la paraphrase, car il n'y a rien d'autre à citer.
Les données structurées aident les machines à lire le contenu de la page, dans certaines limites. Google recommande JSON-LD, précise qu'il ne garantit pas les résultats enrichis et demande de ne pas baliser des informations que les lecteurs ne voient pas. Le type Article de Schema.org fournit author, datePublished, dateModified et publisher, soit les propriétés à soigner sur chaque article. Complet et exact vaut mieux qu'exhaustif.
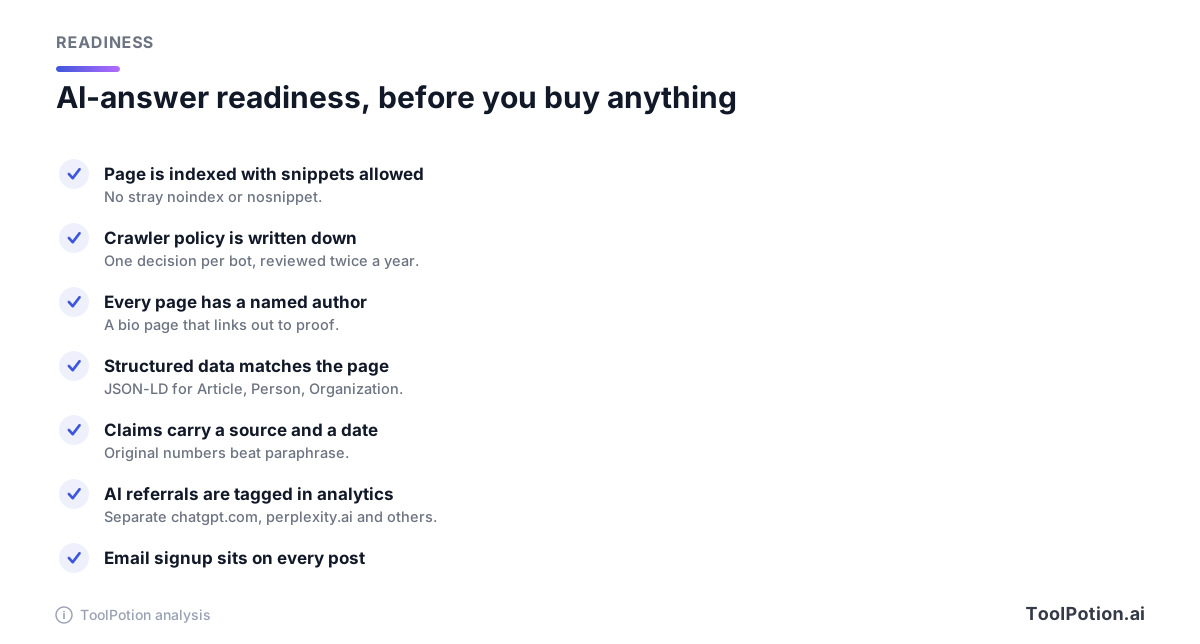
Les pages auteur pèsent plus lourd qu'avant. Une personne nommée, avec une bio qui renvoie à des preuves de son travail, est vérifiable par un lecteur, et c'est la même qualité sur laquelle s'appuie un modèle pour départager des pages quasi identiques. Si vous voulez de l'aide pour rédiger et vérifier tout cela à grande échelle, le classement des outils SEO IA compare les options, et Semrush, Ahrefs et Frase sont des noms bien connus à comparer.
Mesurez les visites IA avant de les optimiser
On ne peut pas piloter ce que ses statistiques rangent dans « direct ». Commencez par isoler les référents que vous pouvez voir. Les assistants conversationnels et les moteurs de réponses envoient du trafic depuis leurs propres domaines, comme chatgpt.com et perplexity.ai : un segment sur ces noms d'hôte vous donne une base de référence en une semaine. Dans la Search Console, selon Google, AI Overviews et AI Mode apparaissent dans le type de recherche Web avec tout le reste, donc n'attendez pas de rapport distinct.
Suivez trois chiffres chaque mois : les visites issues de référents IA, combien d'entre elles atterrissent sur votre inscription à la newsletter, et combien de vos pages cibles sont citées quand vous posez vous-même vos questions. Le troisième est manuel. Ouvrez Perplexity et ChatGPT, posez les dix questions que se posent vos clients et notez quelles pages vous apparaissent. Cela prend une heure et en dit plus long qu'un tableau de bord.
Gardez aussi un œil sur les logs serveur. Si un bot que vous avez interdit continue de récupérer vos pages, c'est une question de politique à soulever. Si un fetcher déclenché par un utilisateur se présente malgré le robots.txt, c'est le comportement attendu selon la documentation des éditeurs citée plus haut, et vous le traiterez au besoin avec des règles de pare-feu plutôt qu'avec le robots.txt.
Choisissez un plan selon votre type d'activité
La même stratégie s'applique différemment selon la façon dont vous gagnez de l'argent.
- Les créateurs indépendants sur YouTube, Instagram ou Spotify devraient voir les assistants des plateformes comme de l'analyse gratuite, rien de plus. Servez-vous-en pour apprendre quelles accroches fonctionnent, puis mettez le lien d'inscription dans chaque description de vidéo et dans votre bio.
- Les éditeurs financés par la publicité devraient d'abord rédiger leur politique de bots, puis observer le pilote de Google et les actions du Royaume-Uni et de l'UE avant de décider de se retirer ou non des fonctions IA. Un retrait coûte de la visibilité, et les paiements observés jusqu'ici varient énormément.
- Les e-commerçants et les entreprises de services veulent être nommés dans les réponses. Autorisez les bots de recherche, gardez les faits sur les produits et les prix sur des pages indexables avec des données structurées cohérentes, et testez si les suggestions d'applications de ChatGPT conviennent à votre catégorie.
- Les éditeurs de newsletters possèdent déjà le meilleur canal. Concentrez vos efforts sur des pages d'archives qui répondent aux questions en langage clair : ce sont elles qui sont citées et qui ramènent de nouveaux lecteurs vers le formulaire d'inscription.
- Les animateurs de communautés sont touchés le plus directement par le cas Reddit. Si votre audience se retrouve sur le forum de quelqu'un d'autre, reproduisez les meilleurs fils dans un espace que vous gérez.
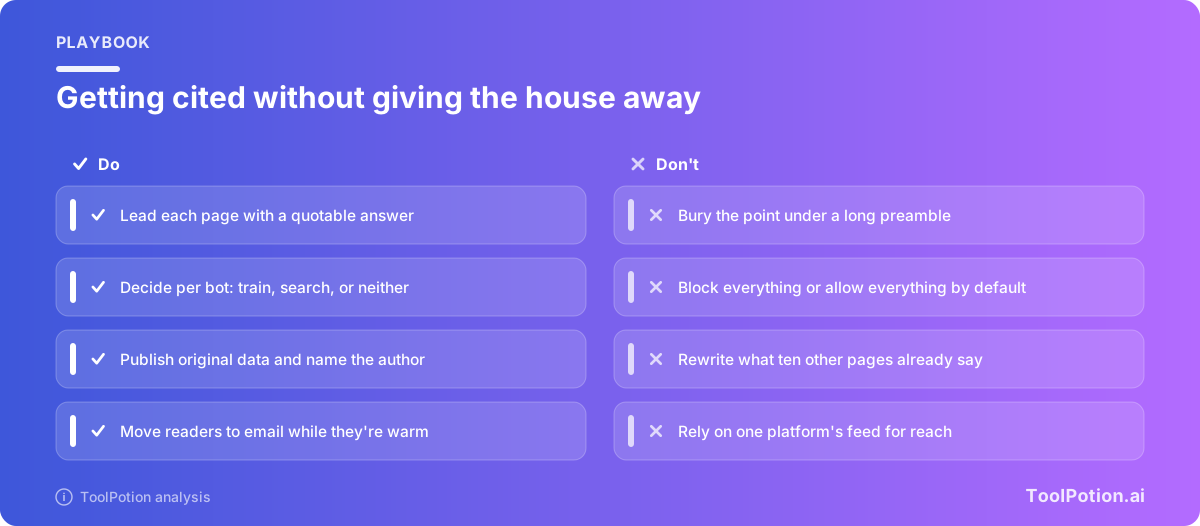
Si vous hésitez par où commencer, commencez par l'e-mail. Ajoutez une inscription à vos cinq pages les plus performantes, envoyez un message utile par semaine et observez la part de trafic qui revient d'elle-même. Notre classement pour créateurs de contenu et le guide des meilleurs outils IA pour créateurs de contenu couvrent les outils côté production, et les lecteurs d'actualités IA montrent comment d'autres installent une habitude chez leur audience. Notre liste des meilleures chaînes YouTube sur l'IA montre à quoi ressemble un canal loué à grande échelle.
Questions fréquentes
Ai-je besoin d'un balisage spécial pour apparaître dans AI Overviews de Google ?
Non. Les consignes de Google indiquent qu'il n'y a aucune exigence supplémentaire ni optimisation spéciale. Votre page doit être indexée et pouvoir s'afficher avec un extrait : vérifiez donc d'abord noindex et nosnippet.
Bloquer Google-Extended me retire-t-il de Google Search ?
Non. Google précise que Google-Extended n'affecte pas l'inclusion dans Search et n'a aucune incidence sur le classement. Il contrôle l'utilisation pour l'entraînement et le grounding de Gemini, et ne vous retire pas d'AI Overviews ni d'AI Mode, qui suivent les contrôles de la Recherche.
Dois-je bloquer GPTBot ?
Cela dépend de votre position sur l'utilisation de votre contenu pour l'entraînement. Bloquer GPTBot est indépendant d'OAI-SearchBot : vous pouvez donc refuser l'entraînement tout en laissant les fonctions de recherche de ChatGPT vous citer.
Puis-je être payé pour l'utilisation de mon contenu par l'IA ?
Peut-être, mais pas de façon fiable. Le pilote de Google concernerait une centaine d'éditeurs avec des paiements très inégaux, et les licences IA de Reddit se glissent dans une ligne de revenus de 43 millions de dollars, selon TechCrunch. Les petits éditeurs devraient partir du principe qu'il n'y a pas de paiement pour l'instant, et garder une politique de bots écrite sous la main.
Comment savoir si les réponses d'IA m'envoient du trafic ?
Segmentez dans vos statistiques les référents chatgpt.com, perplexity.ai et noms d'hôte similaires. Les fonctions IA de Google sont comptabilisées dans votre trafic de recherche Web habituel dans la Search Console : elles n'apparaîtront donc pas sur une ligne à part.
Le calculateur de trafic est-il une prédiction ?
Non, c'est une heuristique approximative. Il additionne vos parts de recherche et de réseaux sociaux pour mesurer l'exposition aux canaux loués, puis applique la baisse de clics de recherche que vous choisissez : le résultat ne vaut donc que ce que vaut votre hypothèse.