

Apple affirme que le nouvel iMac M6 offre jusqu'à 12 fois plus de performances d'IA embarquée pour le traitement des prompts dans LM Studio qu'un iMac M1, et jusqu'à 5 fois plus qu'avec une puce M4. Deux détails de cette phrase déterminent si cela doit vous intéresser. La comparaison se fait avec du vieux matériel, et elle mesure la vitesse à laquelle le modèle lit votre prompt, pas celle à laquelle il écrit la réponse.
Nous avons lu les deux annonces d'Apple sur la puce M6, les fiches techniques et les pages du store. Notre avis : la M6 est une bonne puce, au prix correct, mais pour l'IA locale ce n'est pas là qu'il faut mettre de l'argent en plus. La mémoire est la spec qui compte, et la M6 plafonne à 32 Go.
Ce qu'Apple a réellement lancé
Seules deux machines ont reçu la M6. Le MacBook Pro 14 pouces M6 démarre à 1 999 $ aux États-Unis, et l'iMac M6 à 1 499 $ (10 cœurs) ou 1 699 $ (12 cœurs). Les deux embarquent un Neural Engine 16 cœurs double et des Neural Accelerators dans chaque cœur GPU. Apple annonce des charges d'IA sur le GPU du portable jusqu'à 25 % plus rapides qu'avec la M5, et un Neural Engine jusqu'à 1,9 fois plus rapide.
Le portable est livré avec 16 Go de mémoire unifiée en standard, configurable jusqu'à 32 Go, avec une bande passante de 153 Go/s à 16 Go et de 170 Go/s à 24 ou 32 Go, selon les specs techniques d'Apple. L'iMac est lui aussi annoncé avec une bande passante allant jusqu'à 170 Go/s ; l'annonce d'Apple ne précise pas la mémoire maximale, donc nous n'avançons pas de chiffre.
Shelly Goldberg, vice-présidente de l'ingénierie matérielle chez Apple, est citée dans l'annonce : elle promet « des capacités d'IA embarquée encore plus puissantes ». C'est justifié, dans une certaine mesure. Mais c'est une phrase sur la capacité, et celle qui compte le plus pour qui utilise des modèles locaux, la mémoire, est justement celle qu'Apple a laissée à 32 Go.
Côté tarifs, l'histoire est plus reluisante que côté performances. Les deux machines démarrent au même prix que les modèles qu'elles remplacent, ce que 9to5Mac rappelle après les hausses de début d'année, qui ont fait passer l'iMac de 1 299 $ à 1 499 $ et le MacBook Pro de 1 699 $ à 1 999 $. Le verdict du site : les nouveaux Mac M6 sont « loin d'être bon marché », mais n'ont pas subi de nouvelle hausse.
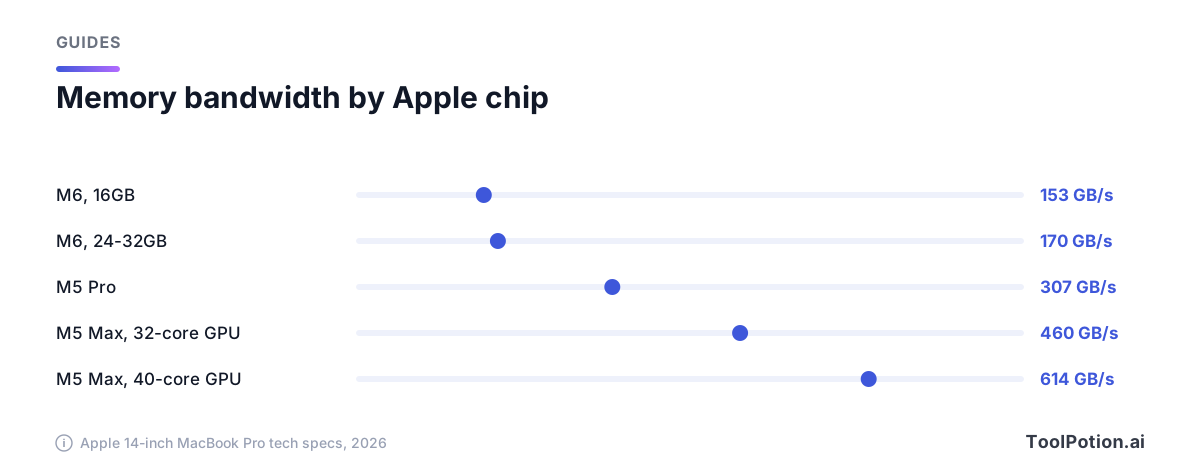
L'autre nouveau MacBook Pro, celui avec écran tactile OLED, n'utilise pas du tout la M6. Il embarque une M5 Pro ou une M5 Max, avec jusqu'à 128 Go de mémoire unifiée sur la Max (64 Go sur la Pro), à partir de 2 899 $ aux États-Unis. Si l'IA locale est votre raison d'acheter, c'est la machine qu'Apple vous désigne. Le communiqué d'Apple affirme qu'avec la M5 Max, les pros peuvent « exécuter des LLM de centaines de milliards de paramètres entièrement sur l'appareil ».
Deux types d'IA embarquée, et un seul demande votre intervention
Apple Intelligence fait tourner un petit modèle sur le Mac pour les outils d'écriture, la dictée, la retouche photo et autres usages du genre, et envoie les requêtes plus lourdes à Private Cloud Compute, le système de serveurs d'Apple. Sa ligne officielle sur la confidentialité : « Apple Intelligence connaît vos informations personnelles sans les collecter. » Vous ne choisissez pas de modèle et ne gérez pas la mémoire. Le ticket d'entrée est un Mac avec puce M3 ou plus récente et au moins 12 Go de mémoire unifiée : une M6 apporte donc de la vitesse, pas l'accès. Notre article sur Siri AI et la place de Gemini traite de la partie cloud.
Apple permet aussi à n'importe quelle application d'appeler ces modèles embarqués via son framework Foundation Models, qui, selon la société, fonctionne hors ligne et sans coût par requête. C'est la raison discrète pour laquelle un Mac avec plus de mémoire devient plus utile avec le temps.
Le second type est celui du benchmark : télécharger un modèle open source et le faire tourner vous-même dans LM Studio (l'article d'Apple sur l'iMac cite aussi LM Studio Bionic parmi les apps optimisées pour Apple silicon) ou Ollama. Rien ne quitte la machine, rien n'est facturé à l'usage, et rien n'égale les plus gros modèles cloud. Quels modèles ouverts méritent la place qu'ils prennent sur le disque est une autre question, traitée dans notre panorama des modèles open-weight.
La mémoire décide de ce qui tourne : lisez d'abord cette ligne
Un modèle doit tenir en mémoire pour tourner, et sur un Mac le CPU et le GPU partagent un seul pool. Un ancien README d'Ollama donnait une règle empirique : au moins 8 Go de RAM pour les modèles 7B, 16 Go pour les 13B et 32 Go pour les 33B. (Cette ligne vient d'une ancienne version taguée et ne figure plus dans le README actuel : prenez-la comme un plancher approximatif tiré de l'histoire de l'outil, pas comme une garantie.) Les prérequis système de LM Studio recommandent 16 Go ou plus, et conseillent aux Mac 8 Go de s'en tenir à des modèles plus petits et à des tailles de contexte modestes.
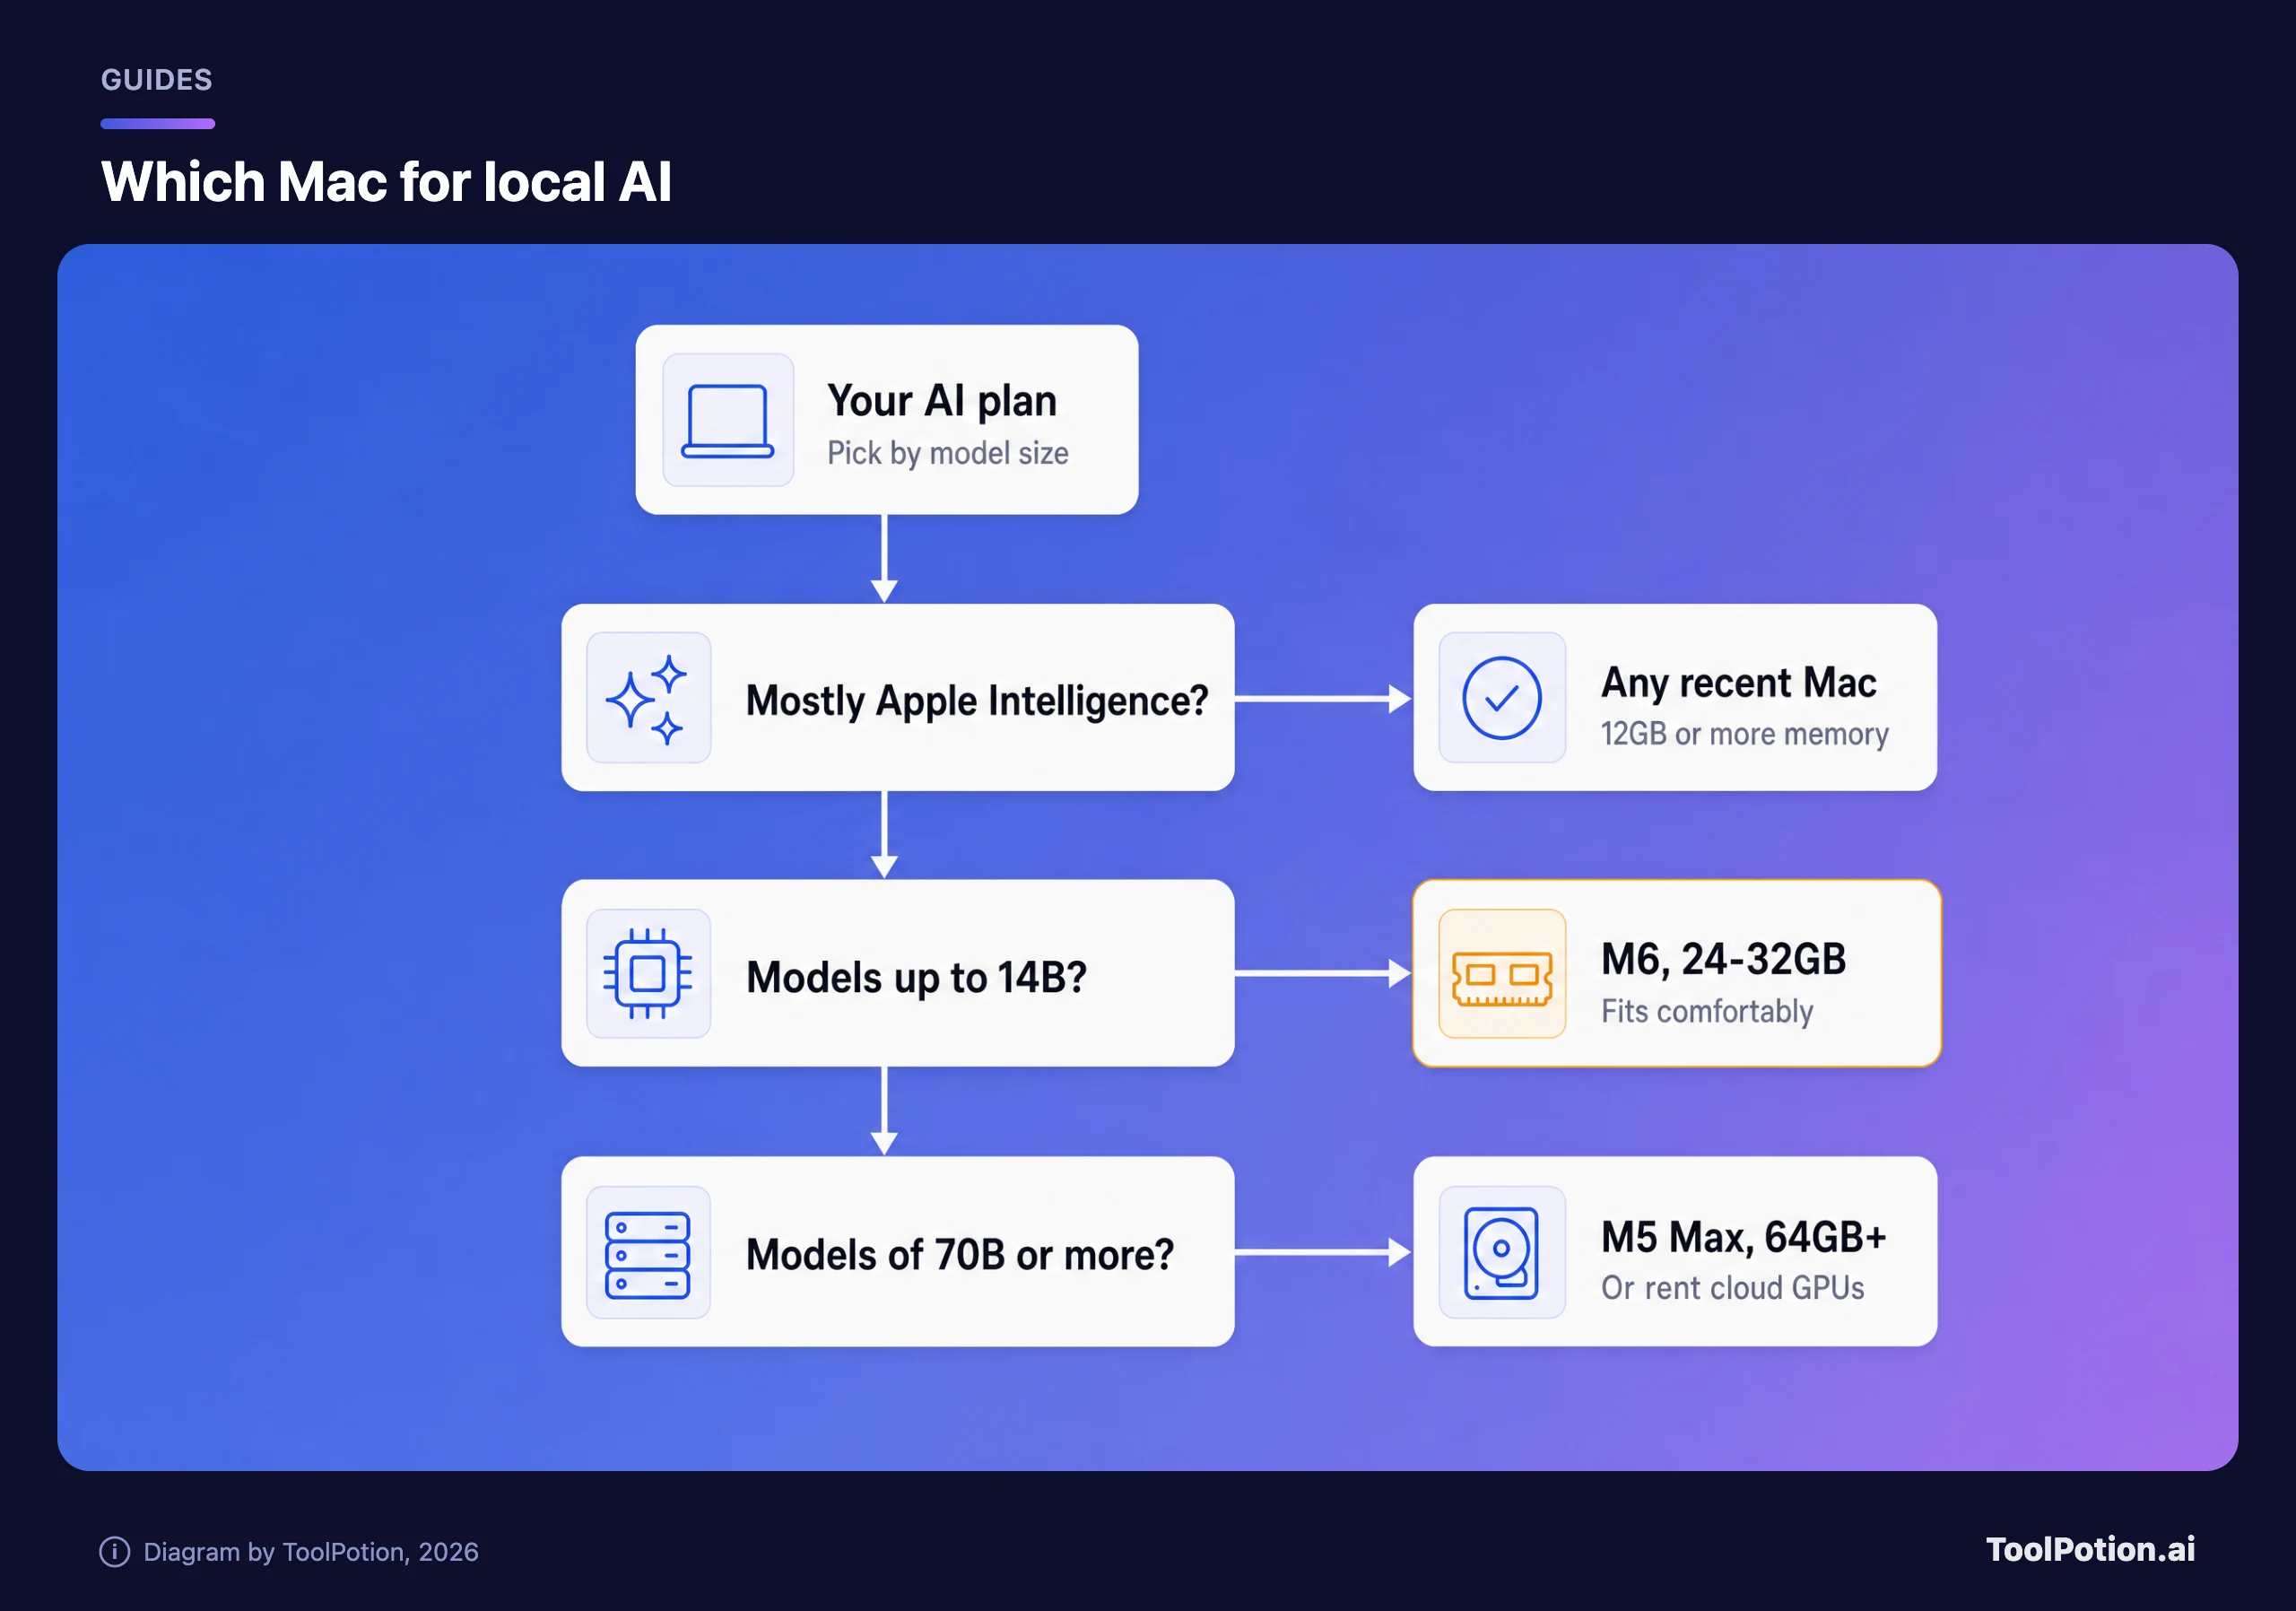
Regardez maintenant un vrai gros modèle. La FAQ d'Ollama montre ollama ps listant llama3:70b à 42 Go. D'après notre déduction à partir de cette taille, il ne tiendra pas sur un Mac 32 Go, quelle que soit la puce ; il lui faudrait 64 Go, donc une M5 Pro ou une M5 Max, pas une M6.
La vitesse est une autre limite. Les promesses d'Apple en IA pour la M6 portent sur le traitement des prompts, comme un temps jusqu'au premier token jusqu'à 1,3 fois plus rapide qu'avec la M5 dans les tests en note de bas de page du portable. Ce sont les chiffres d'Apple, obtenus sur les configurations d'Apple. Selon notre raisonnement, c'est la bande passante mémoire qu'il faut surveiller pour la partie écriture de la réponse, et la M6 occupe les dernières lignes du graphique ci-dessus.
Qui devrait payer pour 32 Go, et qui non
Prenez la M6 avec 24 ou 32 Go si vous voulez faire tourner des modèles d'environ 7B à 14B pour rédiger, résumer des documents privés ou vous faire aider en code, et que vous préférez posséder un portable silencieux à longue autonomie plutôt que louer un GPU. Pour cet usage, la mémoire supplémentaire est le meilleur investissement du configurateur. Nous éviterions les 16 Go du modèle de base à 1 999 $ pour cela. Il fait tourner de petits modèles, mais vous fermerez des applis pour lui faire de la place.
N'achetez pas la M6 pour des modèles de classe 70B, et n'espérez pas un bond spectaculaire par rapport à la puce de l'an dernier sur ce que vous utilisez au quotidien. Si c'est votre objectif, chiffrez une M5 Pro ou Max, puis chiffrez l'alternative, car MacRumors rapporte qu'un Mac Studio avec 512 Go de mémoire démarre à 22 299 $ aux États-Unis. À ce stade, la facture d'un service cloud que vous utilisez quelques heures par semaine paraît dérisoire. Notre comparatif IA locale et IA cloud explique où se situe le seuil de rentabilité, et associer les niveaux de modèles aux tâches vous aidera si l'essentiel de votre travail n'exige pas un modèle de pointe.
Pourquoi garder votre ancien Mac
Les gains mis en avant par Apple se mesurent surtout face à la M1. Face à une M5, le traitement des prompts du portable est jusqu'à 1,3 fois plus rapide : visible dans un benchmark, à peine dans une conversation. Si vous avez un Mac M4 ou M5 avec 24 Go ou plus, gardez-le et mettez l'argent de côté pour prendre plus de mémoire la prochaine fois. Si vous avez un M1 avec 8 Go, le gain est réel, mais un Mac M-series d'occasion ou reconditionné avec 32 Go ferait tourner les mêmes modèles pour moins de 1 999 $. Les nouveaux Mac ont une puce Wi-Fi 7 et une meilleure batterie. Aucun des deux ne fait tourner un modèle.
Une question reste ouverte : Apple n'a pas dit quelle part des 25 % de gain GPU se retrouve dans la génération de tokens, et aucun des articles que nous avons lus ne le dit non plus. Des mesures indépendantes sous LM Studio et Ollama devraient apparaître quand les machines arriveront chez les clients.
Questions fréquentes
Apple Intelligence exige-t-il une M6 ?
Non. Apple liste les Mac avec puce M3 ou plus récente et au moins 12 Go de mémoire unifiée. La M6 le rend plus rapide, pas plus accessible.
16 Go suffisent-ils pour faire tourner des modèles d'IA en local ?
Pour de petits modèles et un contexte modeste, oui. LM Studio recommande 16 Go ou plus, et un ancien README d'Ollama suggérait 16 Go pour les modèles 13B. Il vous restera peu de marge pour les autres applis.
Faut-il attendre des benchmarks indépendants ?
Si vous achetez spécifiquement pour l'IA locale, oui. Les tests d'Apple comparent avec la M1 et la M5 sur ses propres configurations, et ils mesurent le traitement des prompts.