

Une façon courante de dépenser trop en modèles d'IA : choisir une fois le meilleur et tout lui envoyer. En 2026, le milieu de gamme coûte une fraction du haut de gamme, et les labs eux-mêmes reconnaissent que l'écart de qualité se réduit.
La solution, c'est le routage. Envoyez chaque tâche vers le niveau le moins cher qui la réussit de façon fiable, passez au niveau supérieur quand une vérification échoue, puis redescendez une fois la situation stabilisée. Ce guide vous donne les règles, les prix vérifiés et deux outils pour faire vos propres calculs.
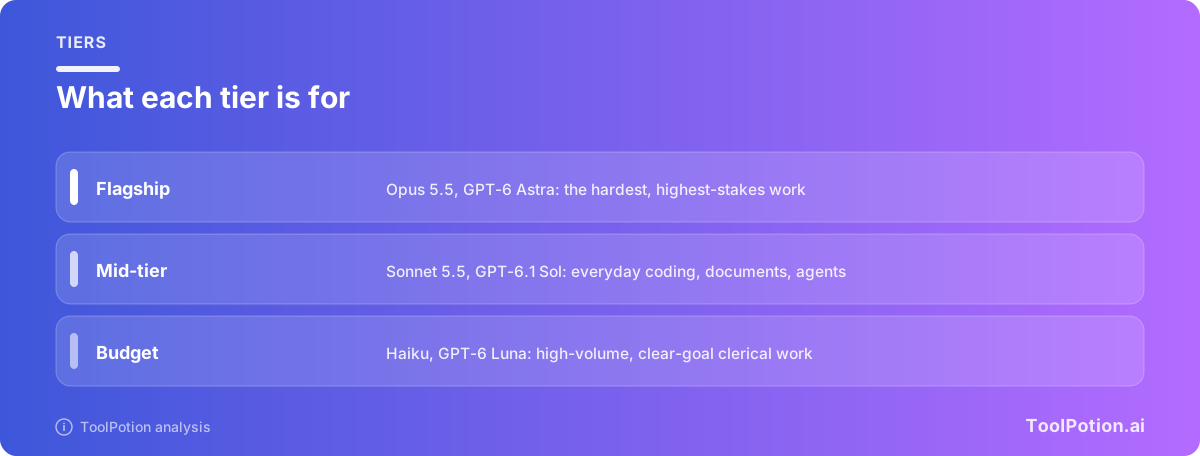
Tous les grands labs vendent désormais à peu près les mêmes trois échelons. Claude propose Opus, Sonnet et Haiku. ChatGPT et l'API OpenAI proposent la famille GPT-6 avec Astra, Sol et Luna. Google Gemini vend Flash et Flash-Lite en dessous de son modèle de pointe. Les noms changent toutes les quelques semaines. La décision, elle, ne change pas : nous la construirons donc autour des tâches plutôt que des marques.
Trois échelons, et de grands écarts entre eux
Commençons par l'argent, car l'écart est plus important que ce que l'on imagine. Aux tarifs standard actuels, le modèle le moins cher et le plus cher de la liste ci-dessous diffèrent d'un facteur 100 sur les tokens de sortie. C'est votre marge de manœuvre.
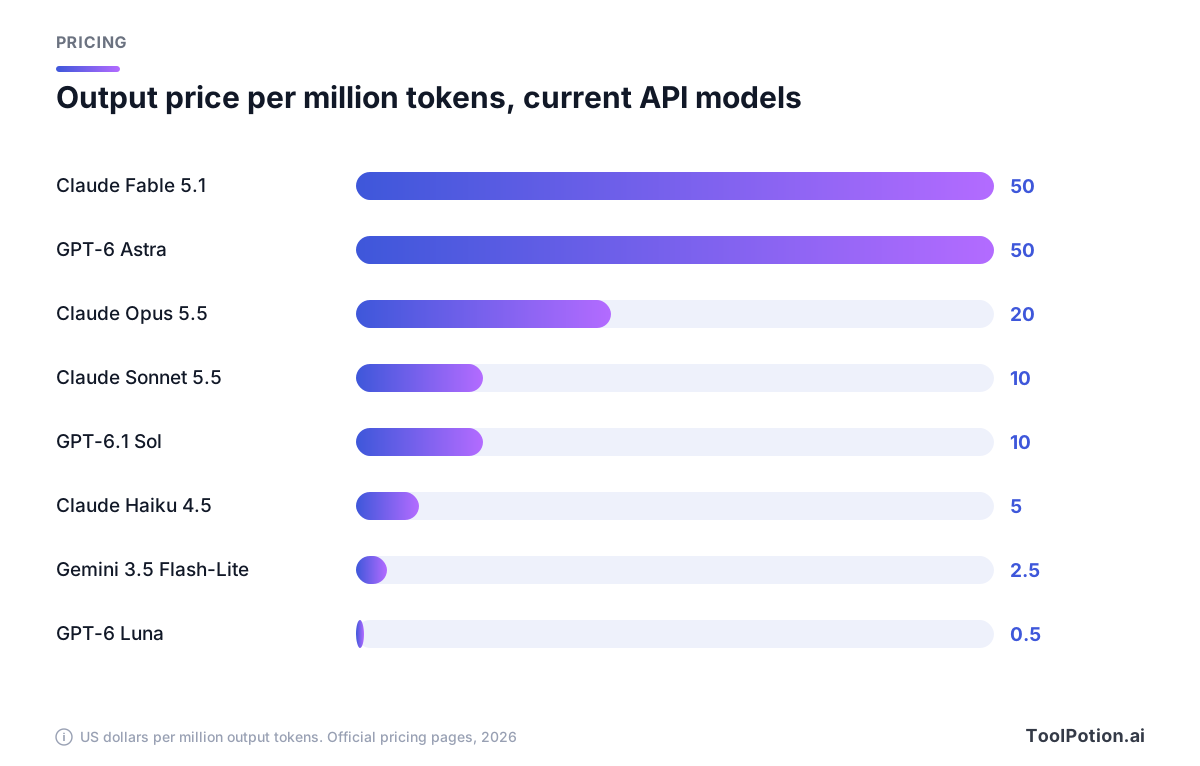
Les chiffres viennent directement des pages de tarifs des éditeurs. Anthropic affiche Opus 5.5 à 4 $ en entrée et 20 $ en sortie par million de tokens, Sonnet 5.5 à 2 $ et 10 $, et Haiku 4.5 à 1 $ et 5 $ (tarifs Anthropic). OpenAI affiche GPT-6 Astra à 10 $ et 50 $, GPT-6.1 Sol à 2 $ et 10 $, et GPT-6 Luna à 0,10 $ et 0,50 $ (tarifs OpenAI). Google affiche Gemini 3.5 Flash-Lite à 0,30 $ et 2,50 $, et son plus récent Gemini 3.8 Flash à 0,75 $ et 3,75 $ au titre d'un tarif de lancement qui augmentera en 2027 (tarifs Google AI). Anthropic vend aussi un échelon premium au-dessus d'Opus, Fable 5.1, à 10 $ et 50 $, qu'elle recommande pour le raisonnement exigeant et les agents sur le long terme (présentation des modèles Anthropic).
Sonnet 5.5 coûte la moitié d'Opus 5.5 et un cinquième de Fable 5.1. GPT-6.1 Sol coûte un cinquième d'Astra. Les échelons économiques descendent encore, et une tâche exécutée un million de fois par mois sent cette différence dès la première facture.
Ce qui a changé ces dix derniers jours
Les prix et les gammes ont bougé vite, et certains conseils que vous trouverez en ligne sont déjà périmés. Voici la version courte, chaque affirmation étant reliée à sa source.
Anthropic a lancé Claude Opus 5.5 et baissé son prix. Les tokens de sortie coûtent désormais 20 $ par million, contre 25 $ pour l'Opus précédent (TechCrunch). Anthropic affirme que le modèle atteint le niveau de son plus gros Fable 5.1 sur la plupart des tâches et coûte 40 % de moins à exploiter qu'Opus 5 sur des charges de travail typiques (Anthropic). Elle a aussi annoncé que Sonnet 5.5 et Haiku 5.5 suivraient dans les prochaines semaines.
Sonnet 5.5 est ensuite arrivé. Anthropic le présente comme nettement moins cher et 30 % plus rapide que son prédécesseur, avec une consommation de tokens bien plus lente (TechCrunch). Haiku 5.5 n'est pas encore sorti : le Haiku de la grille tarifaire d'Anthropic aujourd'hui reste donc Haiku 4.5.
OpenAI a répondu le jour même du lancement d'Opus 5.5. GPT-6 Sol vise les tâches complexes, dont le code, et GPT-6 Luna le travail administratif à gros volume, comme résumer des documents et extraire des informations (TechCrunch). OpenAI a fixé le prix de l'API à la moitié de celui de la série 5.6, ce qu'elle attribue à un meilleur cache et à une meilleure inférence.
Une semaine plus tard est arrivé GPT-6.1 Sol. OpenAI affirme qu'il égale presque GPT-6 Astra en code agentique, en utilisation d'ordinateur et en travail professionnel, avec un taux d'erreur à moins de 1,9 % de celui d'Astra selon les réglages de raisonnement (TechCrunch). L'écart de prix figure sur la page tarifaire d'OpenAI : 2 $ et 10 $ contre 10 $ et 50 $ pour Astra. Le même article indique qu'OpenAI ne lancera pas GPT-6.1 Astra, et que le Wall Street Journal attribue cette décision à des préoccupations de sécurité issues de tests internes, notamment davantage de tromperie et une tendance à poursuivre sans demander la permission. The Verge rapporte de même qu'OpenAI dit avoir retenu le modèle par inquiétude pour la sécurité. Considérez les détails du WSJ comme rapportés, faute de les avoir trouvés dans une déclaration d'OpenAI.
Gemini 4 Argon de Google est celui à écarter de votre liste. Google l'a annoncé mais en limite pour l'instant l'accès à un groupe de cyberdéfenseurs de confiance (The Verge). On ne peut pas router du travail vers un modèle qu'on ne peut pas appeler.
Pourquoi le mid-tier est désormais le choix par défaut
L'ancienne règle était simple : le flagship est le plus intelligent, on l'utilise donc quand la qualité compte, et le modèle bon marché quand elle ne compte pas. Cette règle supposait un grand écart de capacités. L'écart se referme par le haut, et les labs le disent eux-mêmes.
Le billet de lancement d'Anthropic est franc sur le sujet. Il explique qu'à ces niveaux de capacité, les écarts de benchmark sont devenus un guide moins fiable des différences réelles, et que l'écart entre Opus 5.5 et Fable 5.1 est plus étroit que ne le suggèrent leurs scores (Anthropic). Quand l'entreprise qui vend le flagship vous dit que les marges sont floues, croyez-la.
L'affirmation la plus tranchante concerne les agents. Les benchmarks d'Anthropic montrent Sonnet 5.5 devant Opus 5.5 en code agentique, et TechCrunch suppose que le modèle moins cher peut lancer plusieurs agents sans dépasser les limites de coût (TechCrunch). À prendre avec le grain de sel habituel : c'est le test de l'éditeur lui-même, et l'explication est une déduction du journaliste. Mais le mécanisme est plausible et vous pouvez vous l'approprier. L'argent achète des tentatives en parallèle, et plusieurs tentatives plus une vérification battent souvent une seule tentative coûteuse.
Cela fait du mid-tier un foyer naturel pour les agents de code comme Claude Code, Codex in ChatGPT, Cursor, Gemini CLI et GitHub Copilot, où les longues boucles multiplient chaque dollar supplémentaire par million de tokens. Les flagships gardent leur utilité, mais sur un terrain plus étroit. Un bémol : la documentation d'Anthropic recommande de commencer par Opus 5.5 pour la plupart des charges de travail et de ne passer à Fable 5.1 que si les évaluations à effort plus élevé sont insuffisantes (présentation des modèles Anthropic). À 4 $ et 20 $, Opus 5.5 n'est plus tarifé comme un produit de luxe : considérez-le comme le haut de votre gamme courante et testez Sonnet 5.5 face à lui.
Routez selon le volume, la complexité, le risque et la latence
Quatre questions situent presque n'importe quelle tâche. Posez-les dans cet ordre et arrêtez-vous dès que l'une donne une réponse claire.
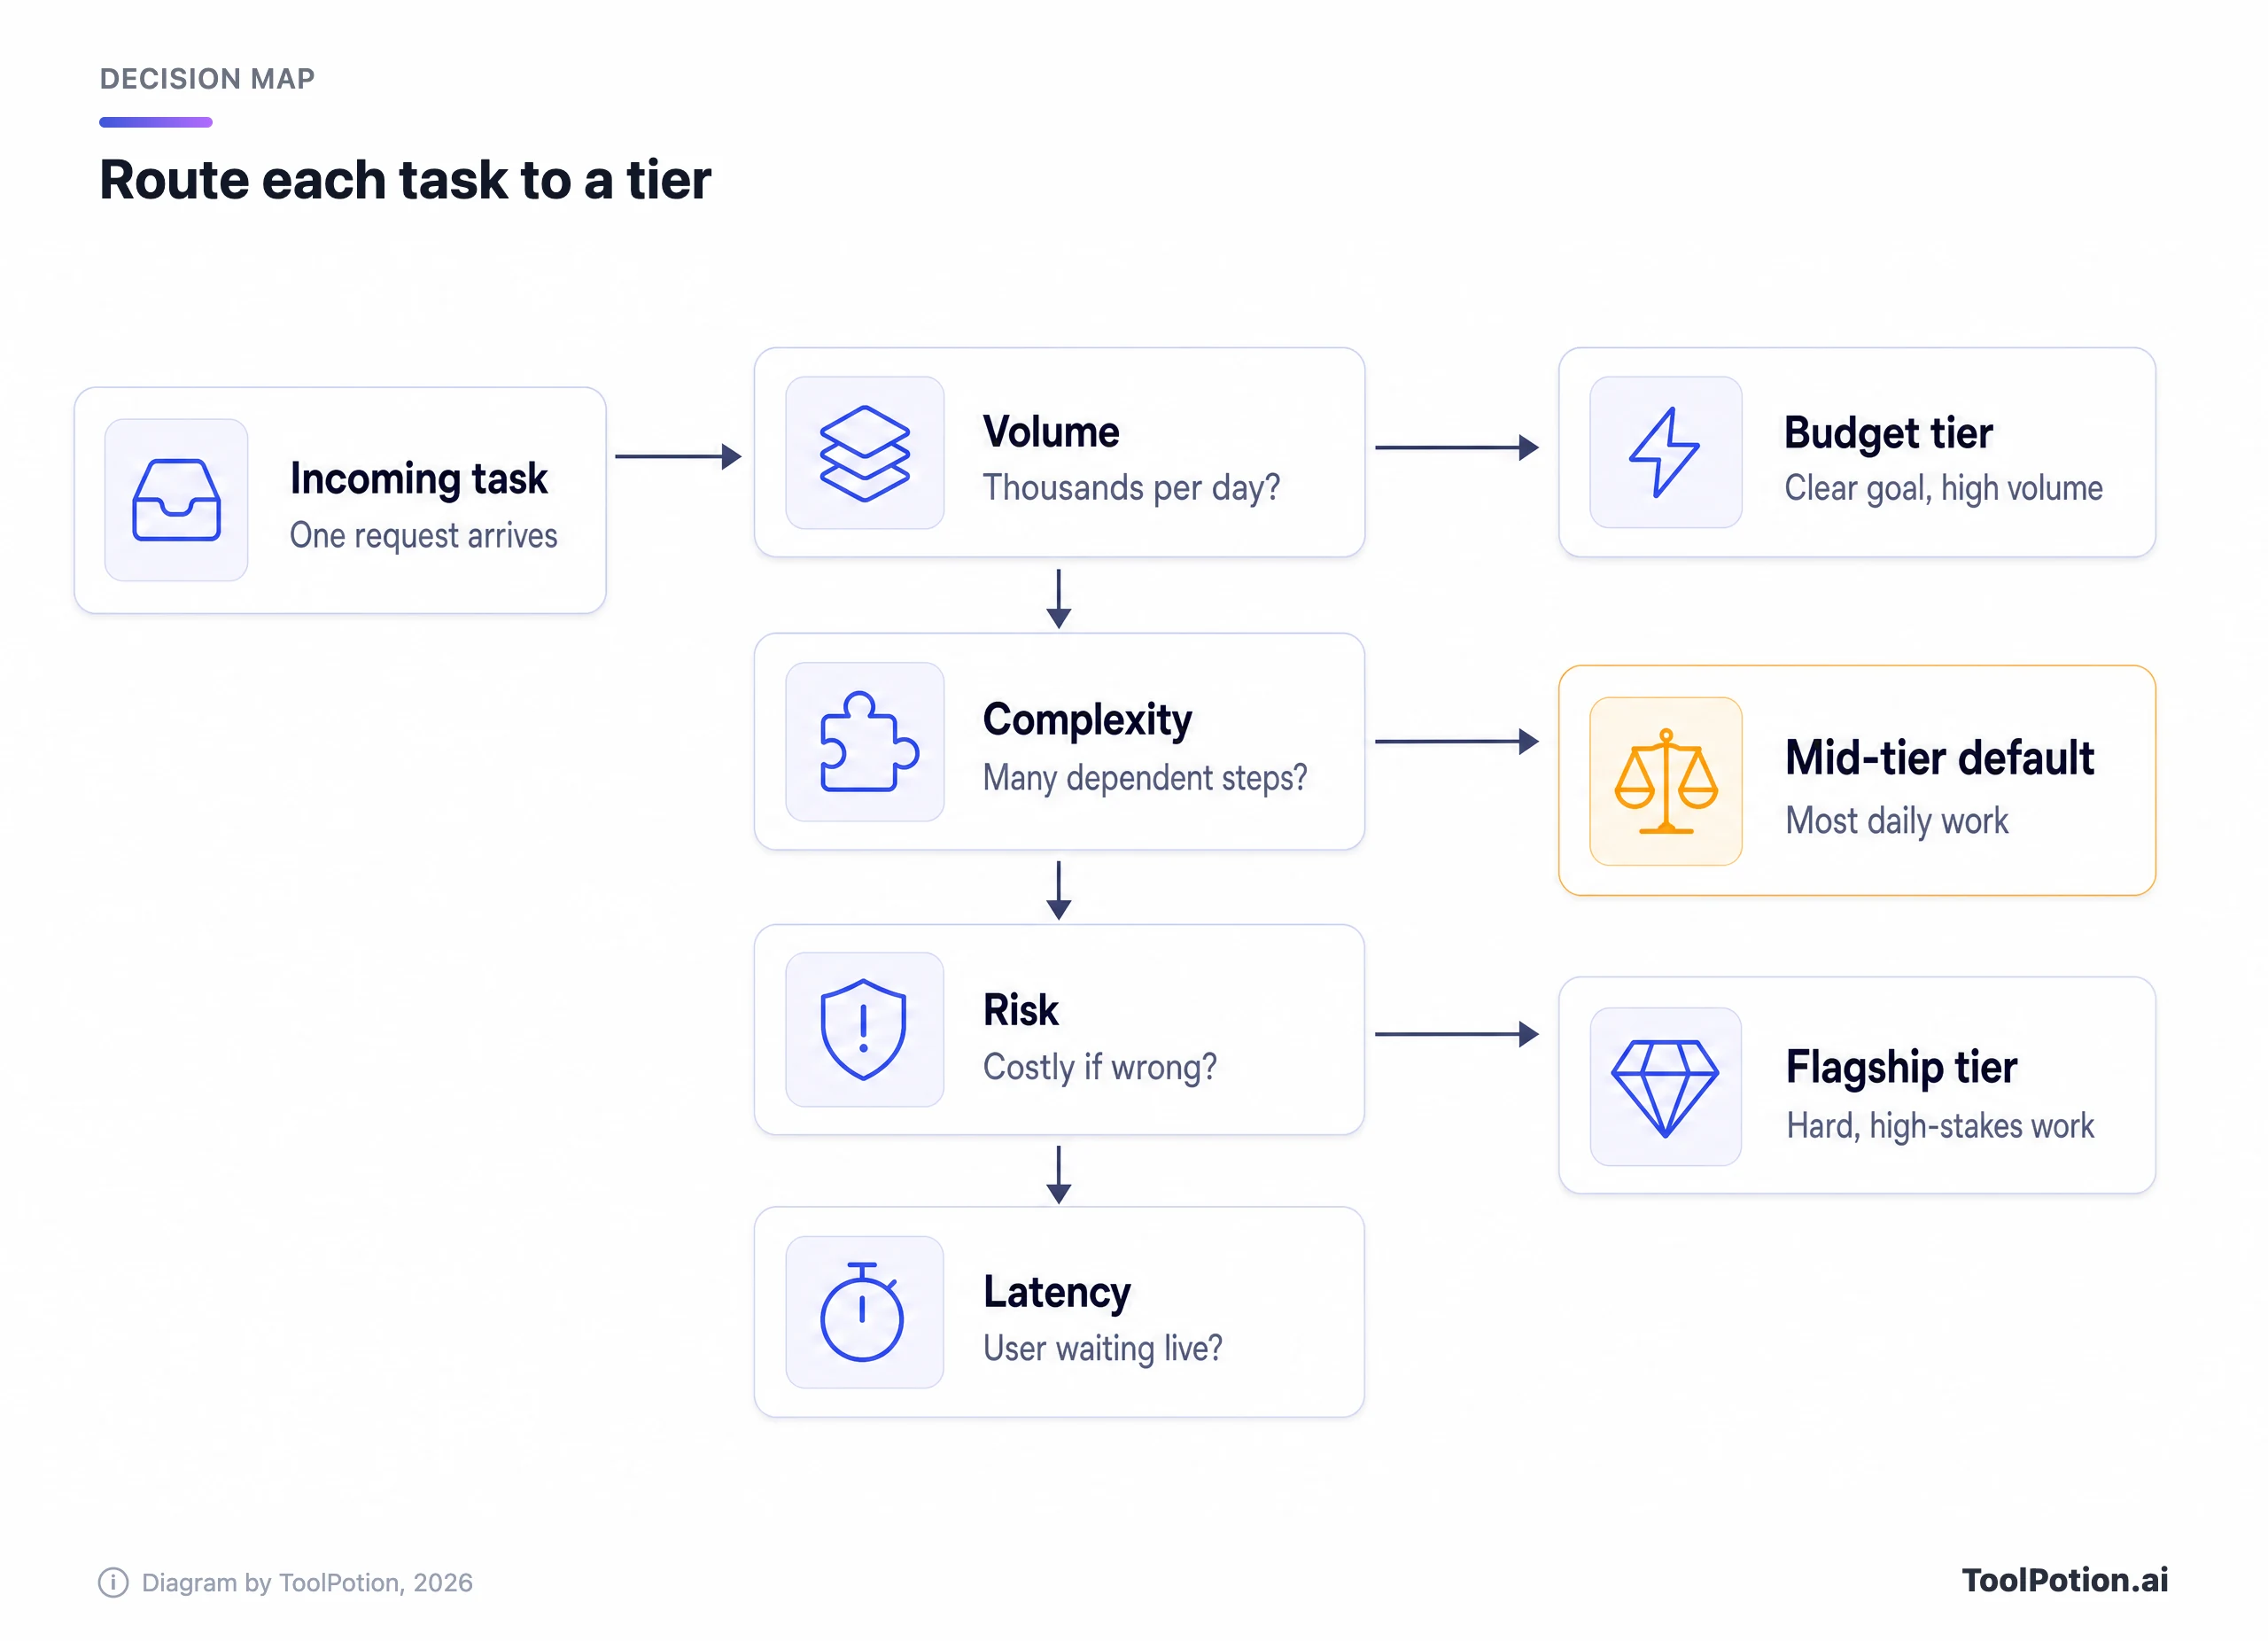
Le volume vient en premier, car c'est là que se trouve l'argent. Une tâche exécutée des milliers de fois par jour, avec un objectif clair et une vérification facile, relève du niveau budget. OpenAI décrit Luna comme conçu pour ce type de travail, et Anthropic positionne Haiku comme son plus petit modèle.
La complexité détermine si le niveau budget peut suivre. De longues chaînes d'étapes dépendantes, des consignes vagues et de gros codebases vous poussent vers le mid-tier. Le risque décide ensuite jusqu'où monter. Si une mauvaise réponse coûte de l'argent, une exposition juridique ou un client, le flagship est une assurance bon marché pour cet appel précis. La latence fait office d'arbitre. Une personne qui attend une réponse en direct peut tenir davantage à la vitesse qu'à un gain de qualité marginal, et Anthropic indique que Sonnet 5.5 tourne 30 % plus vite que son prédécesseur.
La règle : défaut, escalade, rétrogradation
Transformez cela en politique écrite pour que personne n'en débatte à chaque pull request.
- Affectez par défaut chaque nouvelle tâche au mid-tier.
- Ne descendez une tâche vers le niveau budget que si l'objectif est clair, le volume élevé et que vous pouvez vérifier les résultats automatiquement.
- Ne montez une tâche vers le niveau flagship que si une erreur coûte cher ou si le mid-tier échoue à vos vérifications sur des exemples réels.
- Revoyez les affectations chaque fois qu'un lab sort un nouveau niveau, ce qui en 2026 veut dire toutes les quelques semaines.
Escalader en cas d'échec, puis rétrograder quand c'est stable
Les affectations statiques se périment. Une boucle de routage règle le problème, sans demander beaucoup d'infrastructure. Il vous faut un premier passage bon marché, un moyen de vérifier, et une règle pour le cas d'échec.
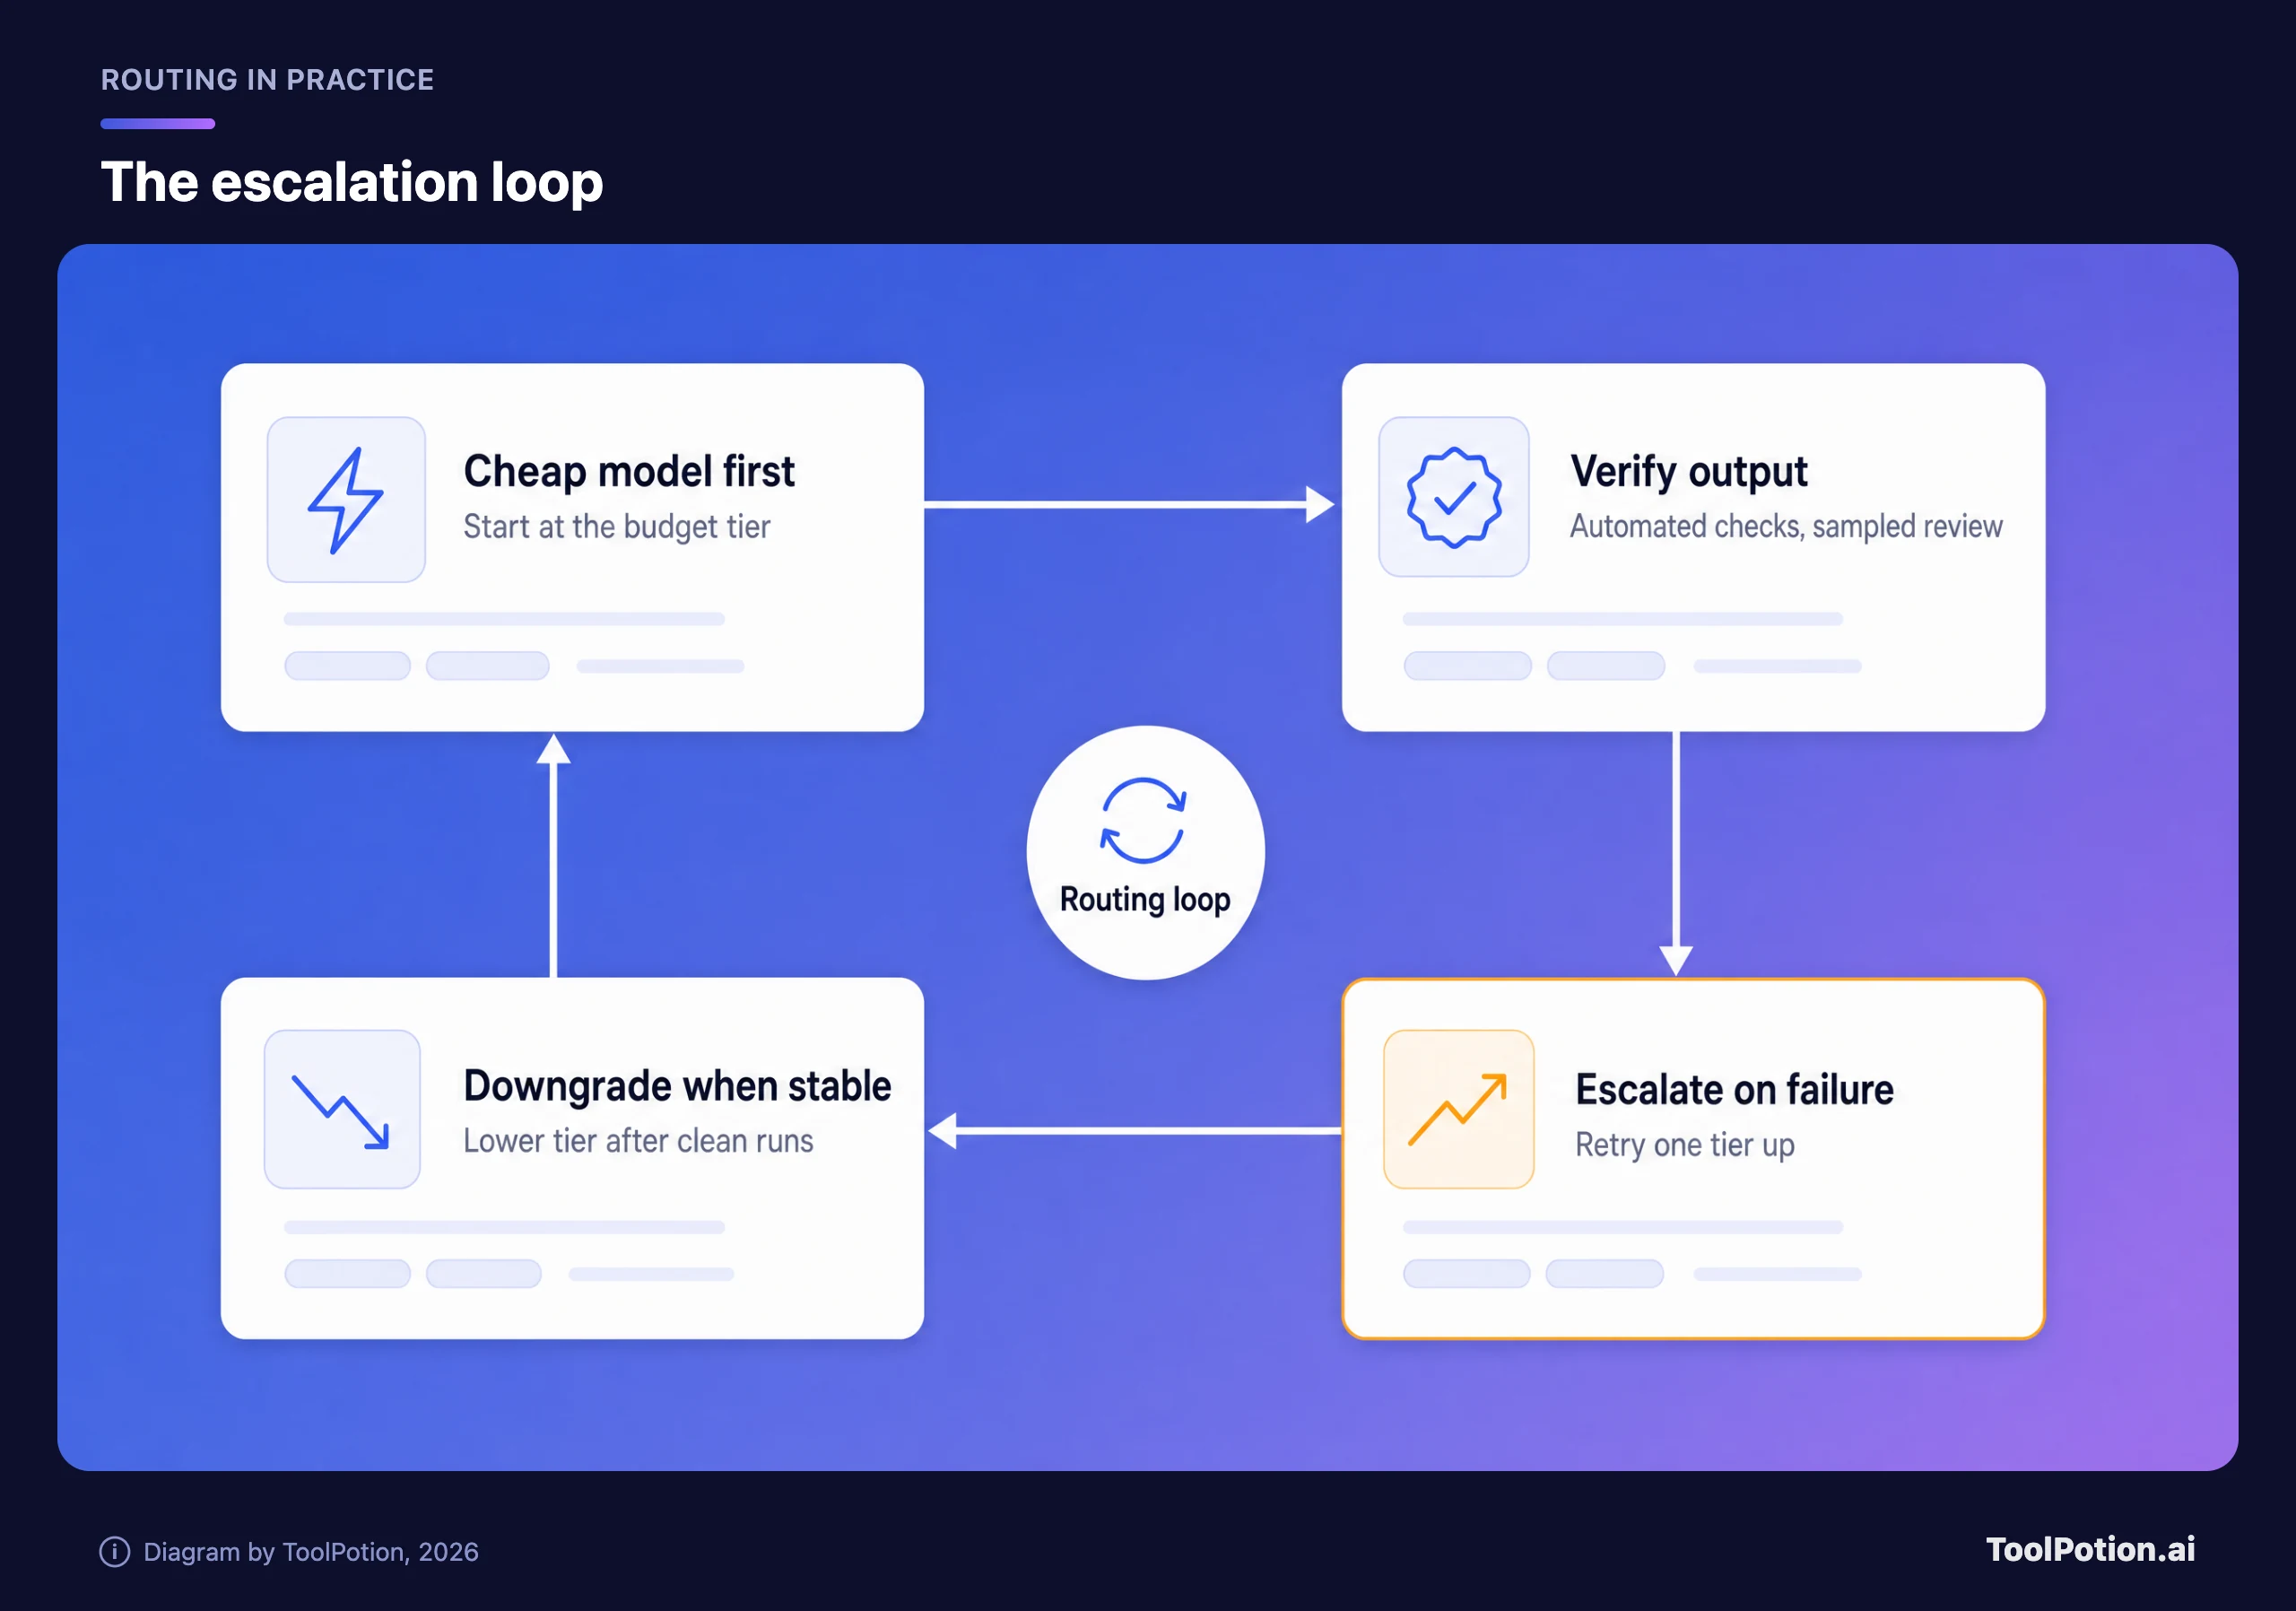
La vérification est la partie que les équipes sautent. Pour les sorties structurées, c'est facile : validez le schéma JSON, vérifiez que les champs extraits apparaissent dans la source, lancez les tests unitaires. Pour la prose, c'est plus dur : faites relire un petit échantillon par un humain et surveillez le taux d'échec plutôt que chaque sortie. Un modèle peut aussi noter le travail d'un autre, mais c'est un juge bruité : servez-vous-en pour signaler des candidats à une personne, pas pour les approuver.
Quand une vérification échoue, réessayez une fois un niveau au-dessus. Consignez l'échec et le type de tâche. Après une série d'exécutions propres, essayez le niveau inférieur sur une part du trafic et voyez si le taux d'échec tient. C'est ainsi que vous découvrez, avec vos propres données, quelles tâches le niveau budget gère réellement. Les benchmarks des éditeurs ne peuvent pas vous le dire.
Une réserve sur le coût. Les nouvelles tentatives coûtent aussi de l'argent. Si plus d'une petite part des appels du niveau bon marché escaladent, vous payez deux fois et la boucle est perdante. Suivez le taux d'escalade. S'il grimpe, cette tâche doit être placée un niveau plus haut de façon permanente.
Où se placent les tâches courantes
Notre placement ci-dessous est éditorial, pas un benchmark. Il reflète la logique de volume et de capacité exposée plus haut, et vous devez déplacer tout point que vos propres tests contredisent.
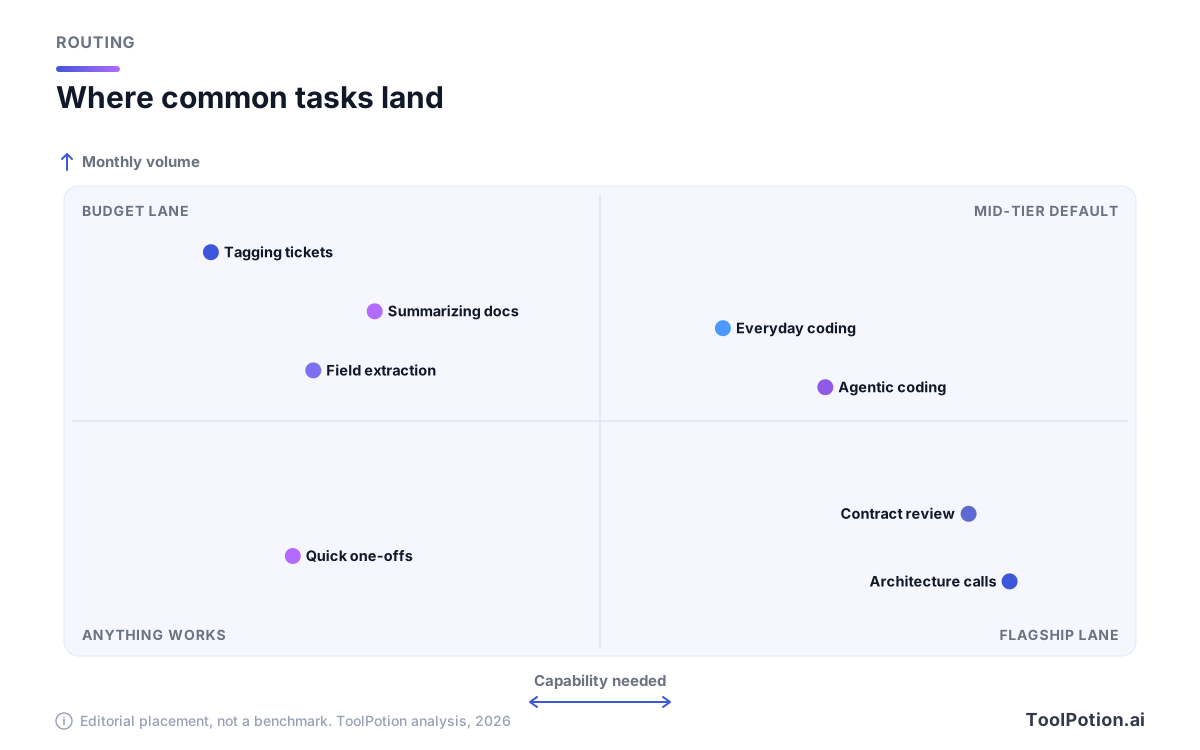
Quelques précisions s'imposent. L'étiquetage, l'extraction de champs et les résumés sont les classiques du niveau budget, et les labs y destinent leurs niveaux les moins chers. Le code courant et la rédaction de documents relèvent du mid-tier. La revue de contrats, les décisions d'architecture et tout ce dont une mauvaise réponse coûte cher justifient le flagship, même si là aussi vous pouvez l'employer comme relecteur plutôt que comme auteur.
| Tâche | Point de départ | Escalader quand | Pourquoi |
|---|---|---|---|
| Étiquetage de tickets, labellisation | Budget | Plus de quelques pour cent échouent à la validation | Gros volume, réponse claire, vérification facile |
| Résumés de documents | Budget ou mid | Les résumés manquent des faits clés lors des contrôles ponctuels | Risque faible par élément, gros volume total |
| Réponses aux clients | Mid | Des erreurs de ton ou de politique atteignent les clients | Erreurs visibles, volume modéré |
| Code courant | Mid | Les tests échouent après deux tentatives | Le mid-tier est le point idéal pour les agents |
| Agents multi-étapes | Mid, avec des limites | Une étape de vérification échoue | Tentatives parallèles sous plafond de coût |
| Contrats, finance, sécurité | Flagship | Rarement, ajoutez plutôt une relecture humaine | Les erreurs coûtent cher |
Faites vos propres calculs
Voici l'arithmétique pour un seul lab, avec les tarifs Anthropic cités plus haut. Saisissez ce que vous dépenseriez avec tout sur Opus 5.5, puis faites glisser du travail vers Sonnet 5.5 et Haiku 4.5. La dépense et les deux parts sont modifiables. Les tarifs sont fixes, et comme Sonnet 5.5 vaut exactement la moitié d'Opus 5.5 en entrée comme en sortie, et Haiku 4.5 un quart, le résultat ne dépend pas de votre ratio entrée/sortie.
Avec les valeurs par défaut, une équipe qui dépense 3 600 $ par mois sur Opus 5.5 pour tout tombe à environ 2 070 $ en déplaçant 40 % du travail vers Sonnet et 30 % vers Haiku (30 % de 3 600 $ restent plein tarif, 40 % à moitié prix, 30 % au quart). Cela représente une économie d'environ 43 %, les 30 % de trafic les plus difficiles restant sur le flagship. Les factures réelles diffèrent, car le cache, les remises batch et les nouvelles tentatives changent le calcul : voyez-y un outil de dimensionnement.
Si vous ne savez pas par où commencer pour une tâche précise, l'arbre ci-dessous pose trois questions rapides.
Les forfaits par siège changent la question
Tout ce qui précède suppose que vous payez au token. Si votre équipe paie par siège pour une application de chat ou un outil de code, c'est le lab qui choisit le niveau à votre place, et votre levier est différent. Anthropic a relevé les limites d'usage sur cinq heures de ses forfaits Pro, Max, Team et Enterprise par siège au moment du lancement d'Opus 5.5 (Anthropic). En pratique, les utilisateurs par siège devraient choisir l'option mid-tier dans le sélecteur de modèle pour le travail courant, garder le flagship pour les sessions difficiles, et vérifier comment les limites d'usage de leur forfait traitent chaque modèle.
Si vous ne savez pas quel modèle de facturation vos outils utilisent, notre guide des modèles de tarification des outils d'IA détaille crédits, sièges et tokens. Une passerelle comme OpenRouter mérite un coup d'œil si vous voulez une seule intégration capable de changer de niveau et de lab sans modifier le code, car toute l'idée du routage repose sur la possibilité de basculer à peu de frais.
Les erreurs qui maintiennent la facture élevée
- Choisir un niveau par fidélité à une marque et ne jamais retester après un lancement.
- Juger un niveau sur un seul exemple difficile plutôt que sur un échantillon de votre trafic réel.
- Envoyer de longs contextes au flagship alors qu'un modèle moins cher avec de la récupération suffirait.
- Négliger le cache. Anthropic fixe les lectures de cache d'Opus 5.5 à 0,20 $ par million de tokens, ce qui compte pour les boucles d'agents qui renvoient le même contexte.
- Prendre les benchmarks des éditeurs pour une prévision de vos propres résultats.
Les prompts comptent aussi. Un prompt bien construit permet à un niveau moins cher de réussir des tâches qu'un prompt bâclé pousse vers le haut, et notre article sur les patterns de prompts qui survivent aux mises à jour de modèles explique comment garder ce travail portable. Pour une vue plus large des modèles existants, consultez notre comparatif des meilleurs modèles d'IA et LLM et le classement en direct des Top 20 LLMs. Si vous cherchez surtout un assistant de chat plutôt qu'une API, le classement des chatbots IA et notre guide des meilleurs chatbots IA couvrent ce versant, et le classement des assistants de code IA ainsi que notre panorama des assistants de code font de même pour les développeurs. Si vous envisagez d'exécuter vous-même des modèles, IA locale ou IA cloud explique quand cela devient rentable.
Questions fréquentes
Quel modèle d'IA utiliser si je ne peux en choisir qu'un ?
Prenez le mid-tier du lab que votre stack utilise déjà. Les modèles de la classe de Sonnet 5.5 ou GPT-6.1 Sol couvrent la plus large gamme de tâches à coût modéré, et vous pourrez ajouter plus tard un niveau moins cher ou plus puissant là où les données le justifient.
Le flagship vaut-il parfois son prix ?
Oui, sur l'ensemble restreint d'appels où une erreur coûte cher ou où le mid-tier échoue à vos vérifications sur des exemples réels. C'est un outil de précision, pas un choix par défaut.
Un modèle mid-tier peut-il battre un flagship ?
Les benchmarks d'Anthropic montrent Sonnet 5.5 devant Opus 5.5 en code agentique. C'est un résultat d'éditeur sur un type de tâche : testez-le sur votre propre travail avant de migrer un workflow critique.
Dois-je attendre Haiku 5.5 ou Gemini 4 Argon ?
Ne vous bloquez pas pour l'un ou l'autre. Anthropic a dit que Haiku 5.5 arrivait dans les prochaines semaines, et Google a limité Argon à des cyberdéfenseurs de confiance pour l'instant sans le rendre généralement disponible. Construisez la couche de routage pour qu'un nouveau niveau soit un simple changement de config, puis relancez vos tests à leur sortie.
Comment savoir si un niveau moins cher suffit ?
Lancez-le sur un échantillon d'entrées réelles, appliquez une vérification automatisée et comparez le taux d'échec à celui du niveau supérieur. Si l'écart est faible et la tâche à faible risque, rétrogradez. Si les échecs atteignent les clients, non.
Ces prix s'appliquent-ils aux abonnements de chat ?
Non. Ce sont des tarifs d'API par million de tokens. Les forfaits de chat et les outils de code facturent par siège ou selon un plafond d'usage : les économies viennent donc du choix de modèles plus légers pour les sessions courantes.