

N'achetez le GPU que si vous le tiendrez occupé. Telle est la réponse courte sur l'IA locale vs l'IA cloud en 2026 : au-delà d'environ 26 % d'utilisation journalière soutenue, un rig local bat le paiement à la jetons. En dessous, vous financez du silicium inactif aux prix de la mémoire 2026, et ces prix sont laids : NVIDIA a fait passer le DGX Spark de 3 999 $ à 4 699 $ en février 2026, invoquant les coûts de la DRAM et du stockage (Notebookcheck).
Pendant ce temps, le cloud est devenu moins cher d'une façon que la plupart des comparaisons ignorent. Les lectures du cache de prompt se facturent à 0,1× le prix d'entrée, et la remise Batch de 50 % s'y ajoute, ramenant Claude Haiku 4.5 à 0,50 $ en entrée / 2,50 $ en sortie par million de tokens (Anthropic).
Voici à quoi ressemble ce calcul, ce que tourne 24 Go, et où se situe la ligne pour vous.
IA locale vs IA cloud : le guide 2026 s'est cassé en quatre endroits
Le calcul du seuil de rentabilité que vous avez lu est erroné, et pas d'une erreur d'arrondi. Il est erroné parce que le matériel a renchéri, que la statistique de capacité a été mal interprétée, que les outils ont changé de camp, et que le tarif cloud a discrètement baissé sous les tableurs de tout le monde.
Les trois hypothèses que toute comparaison continue de formuler
Presque tous les guides local-vs-cloud en première page de résultats reposent sur les mêmes trois affirmations, toutes datées de 2024. Première : le matériel est un coût fixe et décroissant, donc on amortit un GPU à 1 999 $ sur 18 mois et on compare avec la dépense à la jetons. Deuxième : les modèles open-weight accusent un retard de trois à six mois sur les modèles frontier fermés, donc ce qu'on fait tourner chez soi a quelques trimestres de décalage. Troisième : « local » signifie Ollama sur votre machine et « cloud » signifie une API frontier, un combat deux contre deux bien propre.
Les trois étaient raisonnables en 2024. Aucune ne survit au contact de 2026.
Ce qui a changé entre 2024 et aujourd'hui
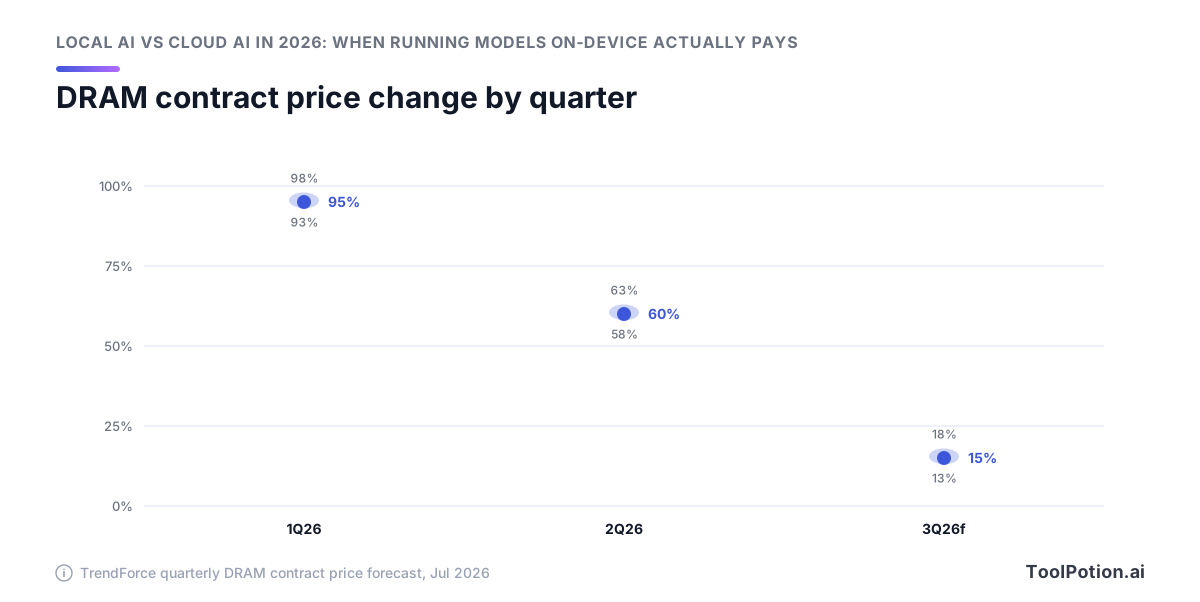
Commençons par le plancher matériel, car il a bougé dans le mauvais sens. NVIDIA a relevé le DGX Spark de 3 999 $ à 4 699 $ en février 2026, une hausse de 700 $ qu'il a attribuée à la flambée des coûts de DRAM et de stockage. Les prix contractuels de la DRAM conventionnelle ont augmenté d'environ 93-98 % d'un trimestre sur l'autre au 1T26 et continuent de grimper de 13-18 % au 3T26. Tout calculateur citant le prix officiel sous-estime votre CapEx de quatre chiffres.
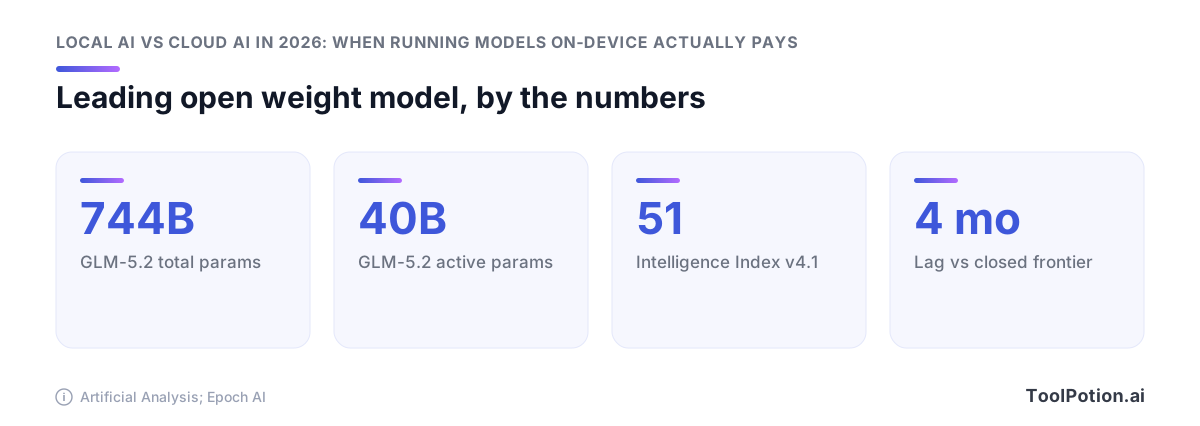
Ensuite, l'écart de capacité. Epoch AI situe le retard à 4 mois, soit 8 points ECI depuis janvier 2026, plus large que la moyenne de 3 mois mesurée de janvier 2023 à octobre 2025. Ce que personne ne cite : le modèle qui porte cette affirmation, GLM-5.2, compte 744 milliards de paramètres au total et 40 milliards actifs. C'est du matériel de salle de serveurs, pas un ordinateur portable.
La troisième rupture est la plus étrange. Le 31 août 2026, Ollama a fait passer ses offres Pro, Max et Team à une tarification cloud à la jetons à 20 $, 100 $ et 500 $ par mois. L'outil « faites-le tourner en local » par défaut vend désormais des jetons, ce qui transforme la comparaison en une course à trois entre votre GPU, des open weights hébergés à bas prix, et les API frontier. Si vous évaluez les options parmi les modèles d'IA que nous référençons, c'est la voie du milieu à étudier en premier.
Et le cloud est devenu moins cher d'une manière qu'aucun calculateur publié ne modélise : lecture du cache de prompt à 0,1× le prix d'entrée de base, une remise Batch API de 50 % qui s'y ajoute, et l'ancrage d'inférence US-only pour un multiplicateur de 1,1×. Ce dernier vous vend la propriété de résidence des données que les gens achètent du matériel pour obtenir, à 10 % de prime au lieu de 4 699 $.
Ce que les modèles locaux gèrent vraiment en 2026
Une carte 24 Go en 2026 fait tourner un bon modèle mixture-of-experts de 20-30 milliards de paramètres, et ce modèle rédige, résume, classe et raisonne sur des problèmes structurés à un niveau que la plupart des équipes jugent acceptable. Il inventera aussi des faits avec assurance sur tout ce qui sort de ses données d'entraînement. Ces deux phrases constituent la carte des capacités, et la plupart des guides sur le seuil de rentabilité omettent la seconde.
Le plafond du matériel grand public est la classe MoE 20-30B
gpt-oss-20b et Qwen3-30B-A3B constituent le plafond pratique pour un seul GPU grand public. Ce sont tous deux des architectures MoE éparses, de sorte que le nombre de paramètres actifs reste assez petit pour qu'une carte 24 Go contienne les poids avec de la place restante pour le contexte. En dessous se trouvent les modèles denses Llama, Mistral et Phi de 7-14B, qui s'intègrent plus confortablement mais au prix de la capacité. Nos listes de LLM open-weight s'orientent fortement vers cette gamme, car c'est ce que les gens peuvent faire tourner chez eux.
Fort en raisonnement, faible en connaissance du monde
Donnez à un modèle local de 30B un document et demandez-lui d'extraire des champs, de respecter un schéma ou de suivre une chaîne d'étapes, et il s'en sort bien. Demandez-lui qui a racheté qui en 2024 et vous obtenez de la fiction plausible.
Le nombre de paramètres est ce qui achète les faits mémorisés, et un modèle de taille grand public en a jeté la plupart. La récupération comble l'écart : mettez les faits dans le contexte et laissez le modèle local faire la partie structurée. Tout ce qui nécessite un rappel large sans couche de récupération derrière appartient à une API frontier.
Pourquoi le titre « les modèles open comblent l'écart » parle de matériel que vous ne possédez pas
Epoch AI situe l'écart à 4 mois, soit 8 points ECI, depuis janvier 2026, légèrement plus large que la moyenne de 3 mois mesurée de janvier 2023 à octobre 2025 (Epoch AI). Le chiffre est solide et ne dit rien de votre ordinateur portable. Le modèle portant la couronne open-weight, GLM-5.2, obtient 51 sur l'Intelligence Index v4.1 d'Artificial Analysis avec 744 milliards de paramètres au total et 40 milliards actifs (Artificial Analysis). C'est du matériel de datacenter. La même mesure montre que GLM-5.2 brûle 43 000 tokens de sortie par tâche, dont 37 000 tokens de raisonnement, soit environ 0,46 $ par tâche contre 0,18 $ pour MiniMax-M3.
Ce que la quantification vous coûte
Q4_K_M est la valeur par défaut pour une raison. Sur Mistral-7B-Instruct-v0.2 sous llama.cpp sur un Apple M1 Pro, il a réduit le modèle de 7,2 Go à 4,1 Go, soit 43,1 % de moins, pour une perte de perplexité de 0,51 % (dasroot). Q2_K est l'endroit où la courbe se brise, avec une perte de perplexité de 7,94 %, et vous le ressentez dans le suivi des instructions bien avant de le voir dans un benchmark. Quantifiez en 4 bits, arrêtez-vous là, et dépensez la mémoire économisée sur la longueur du contexte.
Le plancher matériel a bougé, et dans le mauvais sens
Tout calculateur de seuil de rentabilité que vous trouverez suppose que vous pouvez acheter la machine au prix catalogue. En 2026, c'est rarement le cas, et le prix catalogue lui-même a augmenté.
La crise de la mémoire, en chiffres vérifiables
Les prix contractuels de la DRAM conventionnelle ont augmenté d'environ 93-98 % d'un trimestre sur l'autre au 1T26, encore 58-63 % au 2T26, et TrendForce prévoit une nouvelle hausse de 13-18 % au 3T26 (TrendForce). C'est une décélération, pas un soulagement. Les prix continuent de grimper sur une base qui a déjà doublé. La demande ne vient pas de vous : les datacenters absorbent jusqu'à 70 % de la production mondiale de mémoire en 2026 contre environ 20-30 % en 2022, et la HBM seule a représenté 23 % des plaquettes DRAM cette année contre 8 % en 2024 (IDC). L'inférence locale est un achat de capacité mémoire en concurrence avec ceux qui construisent les clouds que vous essayez d'éviter.
DGX Spark, RTX 5090, et l'écart entre prix officiel et prix réel
NVIDIA a relevé le DGX Spark de 3 999 $ à 4 699 $ en février 2026, une hausse de 700 $ que la société a attribuée à la flambée des coûts de DRAM et de stockage (Notebookcheck). Ses 128 Go de LPDDR5X sont la raison même pour laquelle il est intéressant pour les modèles locaux, et c'est aussi pour cela que son prix suit un marché de matières premières que vous ne contrôlez pas.
Traitez tout prix officiel 2025 cité dans un article comparatif comme de la fiction. Vérifiez ce que la pièce se vend cette semaine, puis faites vos calculs sur ce chiffre.
L'électricité, le poste de dépense que tout le monde oublie
Un GPU est un achat unique qui vous envoie une facture chaque mois. L'électricité résidentielle américaine coûtait en moyenne 18,34 ¢/kWh en juin 2026, en hausse de 5,0 % sur un an, avec des États allant de 8,96 ¢ au Nouveau-Mexique à 28,50 ¢ en Californie (EIA). Le même rig a un coût de fonctionnement qui varie de plus de 3× selon l'endroit où il est branché. En Californie, rien que l'électricité peut rivaliser avec ce que coûteraient les tokens hébergés équivalents. Au Nouveau-Mexique, le calcul est suffisamment différent pour changer la réponse.
Ce que coûte un rig 2026 défendable
Budgétisez la machine au prix réel actuel, ajoutez la consommation électrique à votre tarif réel, et ajoutez les heures que vous passerez sur les frameworks d'inférence locale et le réglage de la quantification qu'un endpoint hébergé ne vous demande pas. Un CapEx à quatre chiffres avec une queue OpEx à trois chiffres annuels est le point de départ honnête, et les deux moitiés ont empiré cette année pour des raisons qui n'ont rien à voir avec la qualité des modèles.
Ollama vs API cloud : la comparaison est désormais à trois
Trois prix comptent maintenant : le GPU que vous achetez, les open weights hébergés, et une API frontier. L'option du milieu l'emporte pour la plupart des charges de travail, et c'est celle qu'aucune formule de seuil de rentabilité publiée n'inclut.
Ollama lui-même est devenu une API cloud le 31 août 2026
L'outil qui a appris à toute une génération de développeurs à faire tourner des modèles sur leur propre machine vend maintenant des jetons. Le 31 août 2026, Ollama a fait basculer ses offres Pro, Max et Team sur une tarification cloud à la jetons : 20 $/mois incluant 60 $ d'usage, 100 $/mois incluant 300 $, et 500 $/mois incluant 1 000 $ partagés entre un nombre illimité d'utilisateurs, sans rétention de données et hébergé aux États-Unis et en Europe (Ollama). Ainsi, « Ollama vs le cloud » ne décrit plus un choix réel.
Open weights hébergés : l'option du milieu que personne ne modélise
| Modèle | Entrée / sortie par MTok | Source |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
Lisez les petits caractères avant de construire une prévision sur ces chiffres. La plupart des tarifs Ollama Cloud doublent entre 12h00 et 18h00 UTC les jours ouvrables (Ollama), ce qui transforme votre facture en une question de planification. Repoussez les travaux en masse aux nuits et week-ends et vous conservez le tarif affiché. Faites tourner un produit interactif pour les utilisateurs européens en après-midi et vous payez le tarif doublé chaque jour ouvrable. Cette variable temporelle mérite plus d'attention que le choix entre deux fournisseurs d'hébergement à prix similaire.
Les API frontier sont moins chères que leur tarif affiché ne le laisse penser
Les lectures de cache se facturent à 0,1× le prix d'entrée de base, la Batch API enlève 50 % sur l'entrée et la sortie, et les deux remises se cumulent (Anthropic). Haiku 4.5 en batch revient à 0,50 $ en entrée et 2,50 $ en sortie par million de tokens, et Sonnet 5 a maintenu son tarif introductif de 2 $/10 $ plutôt que de passer au 3 $/15 $ prévu le 1er septembre 2026 (Anthropic). Les travaux en masse asynchrones sont exactement ce pour quoi on vend les rigs locaux, et c'est la charge de travail où les remises cloud mordent le plus.
La note sur le tokeniseur qui joue en sens inverse
Claude 4.7 et les versions ultérieures utilisent un tokeniseur plus récent qui produit environ 30 % de tokens supplémentaires pour le même texte (Anthropic). Votre vraie facture Sonnet 5 sur un corpus fixe sera environ 30 % au-dessus de ce que la grille 2 $/10 $ implique lorsque vous comparez avec un modèle local disposant d'un ancien tokeniseur. Comptez les tokens sur votre propre texte avec les deux avant de vous engager.
Calculer le seuil : à quel volume votre GPU l'emporte-t-il ?
Le matériel en propre commence à battre les open weights hébergés aux alentours de 26 % d'utilisation journalière soutenue du GPU, soit environ six heures de travail effectif par jour, amortis sur les prix du matériel 2026 et votre tarif d'électricité local. En dessous de ce seuil, la carte reste inactive pendant que le compteur de dépréciation tourne. Évaluez votre propre volume par rapport au tarif hébergé avant d'acheter : deepseek-v4-flash tourne à 0,22 $ en entrée et 0,66 $ en sortie par million de tokens sur Ollama Cloud (Ollama).
Là où le local l'emporte (une liste courte et précise)
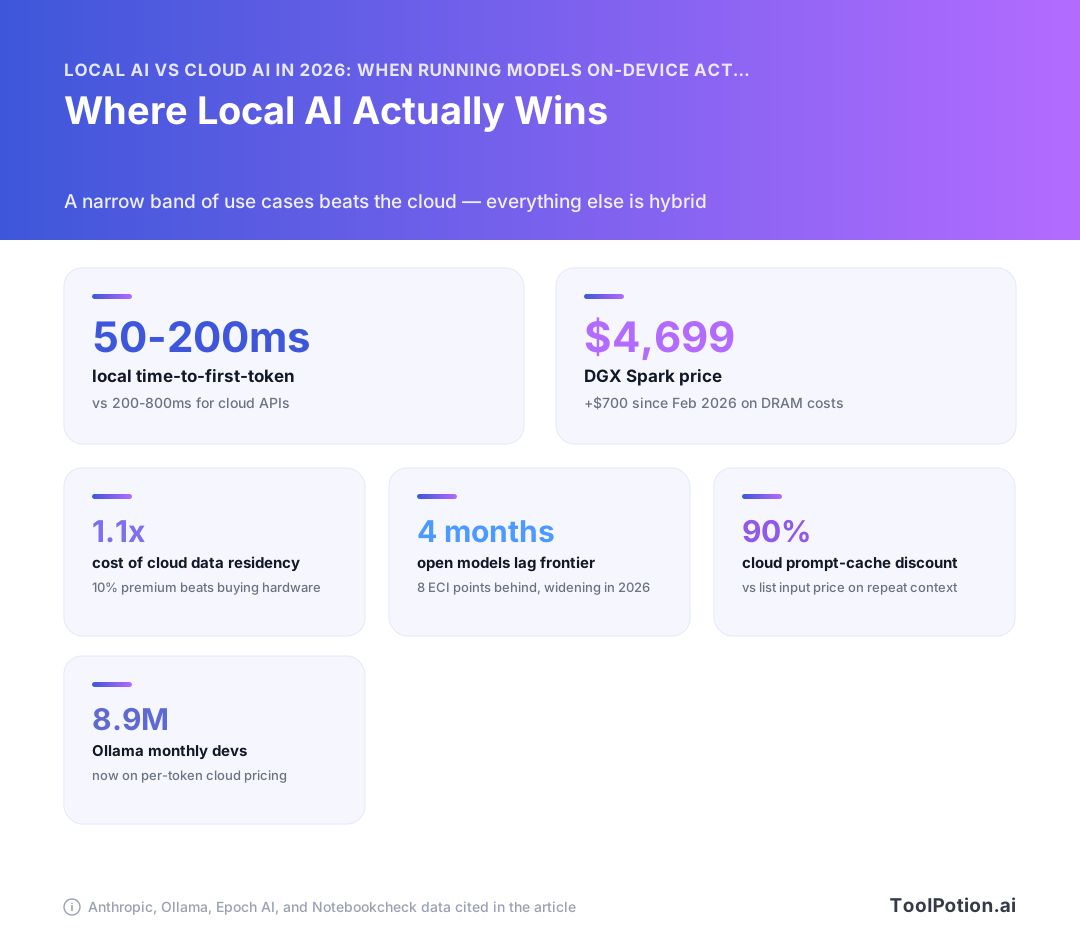
Quatre cas résistent à l'examen. Tout le reste est une configuration hybride où vous routez les requêtes simples vers un modèle local et escaladez le reste.
Travaux en masse à volume élevé et soutenu qui maintiennent la carte occupée
Si votre GPU reste inactif 90 % de la journée, vous avez acheté un radiateur. Le cas d'achat nécessite que la carte travaille plus d'un quart de la journée, chaque jour, et qu'elle survive à la comparaison avec la Claude Batch API, qui réduit les tokens d'entrée et de sortie de 50 % et se cumule avec la mise en cache des prompts (Anthropic). Cela place les travaux Haiku 4.5 en batch à 0,50 $ par million de tokens en entrée et 2,50 $ en sortie. Votre rig local doit battre cela sur le matériel amorti plus l'électricité, et à 18,34 ¢/kWh de prix moyen résidentiel américain en juin 2026 (EIA), une carte sous charge réelle n'est pas gratuite non plus. Faites les calculs avec votre volume de tokens réel avant de les faire avec une fiche technique.
Souveraineté des données stricte, CLOUD Act et pas seulement RGPD
Il existe une vraie catégorie ici, et elle est plus étroite que ce que la plupart affirment. La conformité RGPD est un problème contractuel. L'exigence qu'aucune entité de juridiction américaine ne puisse être contrainte de produire vos données est un problème physique, et les problèmes physiques se résolvent avec du matériel que vous contrôlez.
Boucles interactives où le temps jusqu'au premier token est le produit
L'inférence locale délivre un temps jusqu'au premier token de 50-200 ms contre 200-800 ms pour le cloud, avec Claude Haiku 4.5 mesuré à 597 ms et GPT-4.1 Mini autour de 2 400 ms (Eden AI). Pour une fenêtre de chat, personne ne le remarque. Pour la complétion de code en ligne, ou un agent multi-étapes enchaînant huit appels, cette différence se compose en quelque chose que les utilisateurs ressentent. Si vous construisez dans cette configuration, parcourez les agents IA de notre répertoire et vérifiez combien d'entre eux font un aller-retour par frappe.
Fonctionnement hors ligne et en réseau isolé
Pas d'argument à formuler. Soit le réseau est là, soit il ne l'est pas.
L'argument de confidentialité que le cloud vous revend maintenant
Le contre-argument le plus fort au cas deux est qu'Anthropic vous vend la propriété directement. Sur Claude 4.6 et versions ultérieures, ancrer l'inférence aux États-Unis uniquement avec inference_geo: "us" coûte un multiplicateur de 1,1× sur toutes les catégories de tokens (Anthropic). C'est une prime de 10 % au lieu de 4 699 $ de DGX Spark. Les plans payants d'Ollama, quant à eux, annoncent une rétention de données nulle hébergée aux États-Unis et en Europe depuis le 31 août 2026 (Ollama). Si votre exigence de confidentialité est satisfaite par une garantie contractuelle et un ancrage géographique, vous n'avez pas besoin de matériel.
La configuration hybride sur laquelle la plupart des praticiens s'arrêtent
Routez par difficulté, pas par principe. Un modèle MoE de 20-30B sur votre propre carte gère environ sept requêtes sur dix dans une charge de travail d'assistant ou de traitement de documents typique, et les trois restantes vont vers une API frontier. Cette répartition est l'architecture. Tout le reste est du réglage.
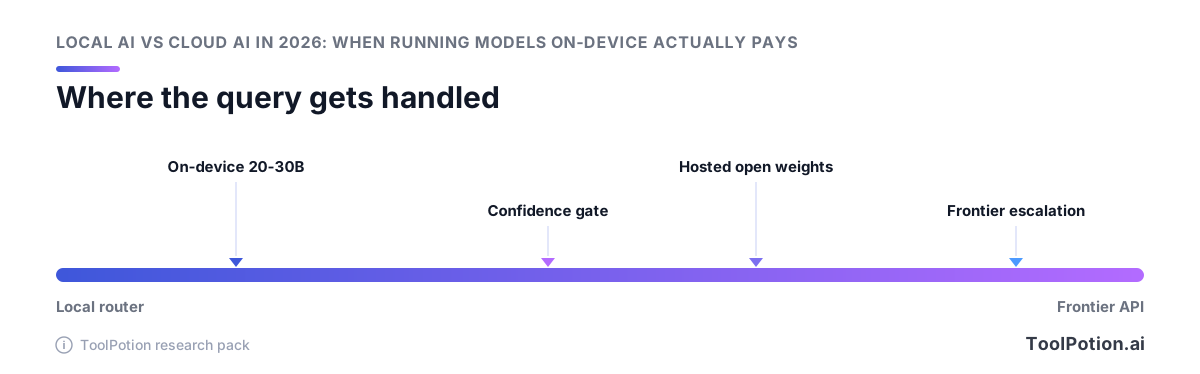
Trois signaux décident de l'escalade, et vous pouvez tous les calculer avant que le modèle local n'ait fini : la propre confiance du modèle (marge log-prob ou un auto-contrôle rapide), si la requête nécessite des connaissances du monde que les poids locaux n'ont pas, et la longueur du contexte. Celui sur les connaissances attrape la plupart de vos échecs. Un modèle de classe 24 Go raisonne bien et rappelle mal, donc tout ce qui ressemble à « qui a racheté qui en 2025 » doit contourner le local entièrement.
Une pile concrète qui fonctionne
Ollama ou LM Studio devant, une API frontier derrière, et un routeur fin entre les deux qui journalise chaque décision.
Envoyez le trafic escaladé vers Claude Haiku 4.5 à 1 $/MTok en entrée et 5 $/MTok en sortie en premier, et n'atteignez Sonnet 5 à 2 $/10 $ que lorsque la réponse de Haiku échoue à votre vérification (tarification Anthropic). Si le travail escaladé est asynchrone, mettez-le en batch : la Batch API divise les deux côtés par deux, donc Haiku arrive à 0,50 $/2,50 $. La plupart des équipes ignorent cela et paient le tarif plein pour des travaux qui auraient pu attendre vingt minutes.
Instrumentez le taux d'escalade ou vous volez à l'aveugle
Journalisez quatre chiffres par requête : quel niveau l'a servie, la confiance du modèle local, les comptages de tokens, et si un humain a retenté la réponse. Le taux de nouvelle tentative est votre vrai signal de qualité. Si l'escalade reste en dessous d'environ 20 %, votre modèle local répond à des choses qu'il ne devrait pas et vous le verrez dans les nouvelles tentatives. Au-dessus de 45 %, le GPU ne gagne pas sa dépréciation.
Pourquoi la frontière change chaque trimestre
Les prix des deux côtés évoluent plus vite que votre architecture. Ollama a repassé les offres Pro, Max et Team à la facturation cloud à la jetons le 31 août 2026 (Ollama), les tarifs Ollama Cloud doublent entre 12h00 et 18h00 UTC les jours ouvrables (tarification Ollama), et les capacités open-weight accusent un retard d'environ 4 mois en moyenne sur les modèles frontier fermés depuis janvier 2026 (Epoch AI). Recalculez vos seuils de routage par rapport aux chiffres en direct une fois par trimestre. Mettez-le au calendrier.
La couche d'outillage est suffisamment stable pour construire dessus
Ollama tourne à 8,9 millions de développeurs actifs mensuels avec une équipe de 14 personnes, est présent dans 85 % du Fortune 500, et a levé 65 M$ mené par Theory Ventures en juillet 2026 (TechCrunch). Ce n'est pas un projet qui disparaît l'année prochaine. La colle de routage autour de lui est la partie que vous possédez, et vous pouvez en emprunter la majorité aux dépôts IA open source qui publient déjà ce pattern.
Décidez en cinq questions
Répondez-y dans l'ordre. La première qui vous donne un oui ferme détermine votre configuration, et vous pouvez vous arrêter là.
Avez-vous une exigence de souveraineté stricte ?
Stricte signifie : réseau isolé, exposition au CLOUD Act que le service juridique a consignée par écrit, ou un contrat qui nomme la machine. Si c'est votre cas, achetez le matériel et arrêtez de lire la section sur les coûts. Si votre exigence est plus souple que cela, Anthropic ancrera l'inférence aux États-Unis uniquement avec inference_geo: "us" sur Claude 4.6 et versions ultérieures pour un multiplicateur de 1,1× sur toutes les catégories de tokens (documentation tarification Anthropic), et les plans payants d'Ollama fonctionnent sans rétention de données aux États-Unis et en Europe (Ollama). Une prime de 10 % bat 4 699 $ de matériel pour presque tout le monde.
Votre travail est-il limité par la latence ou par le débit ?
Les boucles interactives où une personne attend chaque token favorisent le local : 50-200 ms jusqu'au premier token contre 200-800 ms pour le cloud, avec Claude Haiku 4.5 mesuré à 597 ms (Eden AI). Le travail de débit va dans l'autre sens. Mettez-le en batch et prenez la remise de 50 %, ce qui place Haiku 4.5 à 0,50 $/MTok en entrée et 2,50 $ en sortie (Anthropic).
Le GPU restera-t-il occupé plus d'un quart de chaque journée ?
En dessous de ce seuil, votre carte se déprécie au ralenti et les open weights hébergés gagnent sur le coût. Au-dessus, le calcul local commence à fonctionner. Soyez honnête sur le dénominateur, car les nuits et week-ends comptent.
Votre tâche nécessite-t-elle des connaissances du monde ou juste du raisonnement ?
Le raisonnement sur du texte que vous fournissez fonctionne bien sur un modèle MoE de 20-30B. Les questions qui dépendent de faits que le modèle doit déjà connaître appartiennent à une API frontier, ou à GLM-5.2 hébergé, qui compte 744 milliards de paramètres au total et ne tient jamais dans votre ordinateur portable (Artificial Analysis).
Pouvez-vous tolérer un recalibrage chaque trimestre ?
L'écart open-closed est à 4 mois et a évolué depuis une moyenne de 3 mois (Epoch AI), donc votre seuil de routage a une date de péremption. Les équipes qui ne le revisiteront pas devraient se rabattre sur une API frontier avec la mise en cache activée et ne router rien. Celles qui le feront peuvent consulter les études de cas de déploiement réels pour voir quels seuils d'autres personnes ont finalement retenus.
Ce qui changerait ce verdict en 2027
Ce conseil a une date de péremption, et trois chiffres spécifiques la fixent.
Les prix de la mémoire décélèrent, ils ne baissent pas
Les prix contractuels de la DRAM conventionnelle ont augmenté d'environ 93-98 % d'un trimestre sur l'autre au 1T26, puis 58-63 % au 2T26, avec une prévision de 13-18 % pour le 3T26. Cette courbe s'aplatit. Elle pointe toujours vers le haut. Un taux de croissance plus lent ne vous rend pas les 700 $ que NVIDIA a ajoutés au DGX Spark en février 2026, et rien dans les prévisions n'indique que les prix réels baisseront l'année prochaine. Prévoyez que le cas matériel reste faible jusqu'en 2027, sauf si la demande des datacenters se relâche.
Surveillez l'écart open/closed, pas le benchmark de titre
Deux signaux comptent plus que n'importe quelle position au classement. Le premier est l'écart ECI d'Epoch AI, qui était à 4 mois, soit 8 points, depuis janvier 2026. Le second est le nombre de paramètres actifs : GLM-5.2 mène sur les open weights avec 40 milliards actifs sur 744 milliards au total, donc le jour où un modèle de moins de 30B actifs se trouve à quelques points ECI du frontier, la carte 24 Go redevient intéressante. Surveillez aussi si le doublement des tarifs Ollama aux heures de pointe (12h00-18h00 UTC les jours ouvrables) persiste ou se normalise. Nos rapports de tendances IA suivent les sorties de modèles qui feraient bouger tout cela.
Foire aux questions
Est-il moins cher de faire tourner un LLM en local ou d'utiliser une API cloud en 2026 ?
Pour la plupart des gens, le cloud, et l'écart s'est creusé en 2026. Claude Haiku 4.5 est affiché à 1 $ par million de tokens en entrée et 5 $ en sortie, tombe à 0,50 $/2,50 $ via la Batch API, et les lectures du cache de prompt se facturent à 0,1× le taux d'entrée de base (tarification Anthropic). De l'autre côté, un NVIDIA DGX Spark est passé de 3 999 $ à 4 699 $ en février 2026 à cause des coûts de DRAM et de stockage (Notebookcheck), et vous payez toujours l'électricité à une moyenne résidentielle américaine de 18,34 ¢/kWh en juin 2026 (EIA). Le local gagne son argent sur des travaux en masse à volume élevé et soutenu qui maintiennent la carte occupée une grande partie de chaque journée, sur le fonctionnement en réseau isolé, et sur les boucles sensibles à la latence.
De quel matériel ai-je besoin pour faire tourner un LLM en local en 2026 ?
Un GPU 24 Go est le plancher pratique pour le grand public, et il vous limite à la classe mixture-of-experts 20-30B plutôt qu'à quoi que ce soit proche du frontier open-weight. Au-delà, vous achetez une machine 128 Go LPDDR5X comme le DGX Spark, qui coûte maintenant 4 699 $ (Notebookcheck). Budgétisez pour des prix de mémoire qui continuent de grimper : les prix contractuels de la DRAM conventionnelle ont augmenté d'environ 93-98 % d'un trimestre sur l'autre au 1T26 et 58-63 % au 2T26, avec encore 13-18 % prévu au 3T26 (TrendForce). La quantification étend ce qui rentre, et 4 bits est proche de la gratuité : Q4_K_M a réduit Mistral-7B-Instruct-v0.2 de 7,2 Go à 4,1 Go pour une perte de perplexité de 0,51 %, tandis que Q2_K s'est dégradé nettement à 7,94 % (compromis de quantification).
Les modèles locaux sont-ils aussi bons que Claude ou GPT ?
L'écart souvent cité est réel mais il décrit du matériel que vous ne possédez probablement pas. Epoch AI a mesuré un retard des modèles open-weight sur les modèles frontier fermés d'une moyenne de 4 mois, soit 8 points ECI, depuis janvier 2026, légèrement plus large que la moyenne de 3 mois pour la période janvier 2023 à octobre 2025 (Epoch AI). Le modèle portant cette affirmation, GLM-5.2, obtient 51 sur l'Intelligence Index v4.1 d'Artificial Analysis avec 744 milliards de paramètres au total et 40 milliards actifs, ce qui est du matériel de datacenter (Artificial Analysis). Ce qui rentre réellement dans un ordinateur portable ou un seul GPU est fort en raisonnement structuré et faible en connaissance du monde, donc traitez le chiffre de 4 mois comme un plafond que vous ne pouvez pas atteindre chez vous.
Ollama est-il toujours gratuit, et comment la tarification Ollama Cloud se compare-t-elle aux API frontier ?
Le cadre local-vs-Ollama a cessé d'avoir un sens le 31 août 2026, quand Ollama a fait passer ses offres Pro, Max et Team à une tarification cloud à la jetons : 20 $/mois incluant 60 $ d'usage, 100 $/mois incluant 300 $, et 500 $/mois incluant 1 000 $ partagés entre un nombre illimité d'utilisateurs, sans rétention de données hébergé aux États-Unis et en Europe (blog Ollama). Les open weights hébergés sont bon marché là : deepseek-v4-flash tourne à 0,22 $ en entrée et 0,66 $ en sortie par million de tokens, nemotron-3-super à 0,015 $/0,60 $, qwen3.5:397b à 0,60 $/3,60 $, bien que la plupart des tarifs doublent aux heures de pointe de 12h00 à 18h00 UTC les jours ouvrables (tarification Ollama). Comparez cela à Claude Haiku 4.5 à 1 $/5 $ (tarification Anthropic) et la vraie décision est à trois, les open weights hébergés battant votre propre GPU sur le coût pour la plupart des charges de travail. Ollama a la stature pour être pris au sérieux dans les deux cas, avec 8,9 millions de développeurs actifs mensuels et 85 % du Fortune 500 (TechCrunch).
Faire tourner un modèle en local rend-il vraiment mes données plus privées qu'une API cloud ?
Cela vous donne une propriété que rien d'autre ne donne, à savoir que les octets ne quittent jamais votre machine, ce qui compte pour le travail en réseau isolé et pour les exigences strictes de souveraineté des données comme le CLOUD Act. Pour tout ce qui est plus souple que cela, les fournisseurs vendent maintenant la même garantie à moindre coût. Sur Claude 4.6 et versions ultérieures, ancrer l'inférence aux États-Unis uniquement avec inference_geo: "us" coûte un multiplicateur de 1,1× sur toutes les catégories de tokens (tarification Anthropic), et les plans payants d'Ollama fonctionnent sans rétention de données aux États-Unis et en Europe (blog Ollama). Une prime de 10 % est un engagement bien plus modeste que 4 699 $ de matériel (Notebookcheck).
Par quel modèle local commencer sur un GPU 24 Go ?
Commencez par un modèle mixture-of-experts de 20-30B tel que Qwen3-30B-A3B ou gpt-oss-20b, quantifié en Q4_K_M. Cette classe obtient 73-87 % sur AIME 2024 sur un seul RTX 5090, donc le raisonnement tient bien, tandis que le rappel factuel sur le monde est là où il faillit. Q4_K_M est le bon arrêt de quantification : il a réduit un modèle de 7,2 Go à 4,1 Go pour une perte de perplexité de 0,51 %, et Q2_K s'est dégradé nettement à 7,94 % (compromis de quantification). Faites-le tourner comme premier saut et escaladez les requêtes à forte teneur en connaissances vers un modèle cloud.