

Les patterns de prompt engineering qui survivent à une mise à jour de modèle sont ceux qui transmettent des informations que le modèle ne peut pas inférer : un rôle qui définit l'audience, un contexte qu'il n'a pas, une tâche avec une règle de décision, et un contrat de sortie appliqué en dehors du prompt. Tout le reste est du folklore avec une date de péremption.
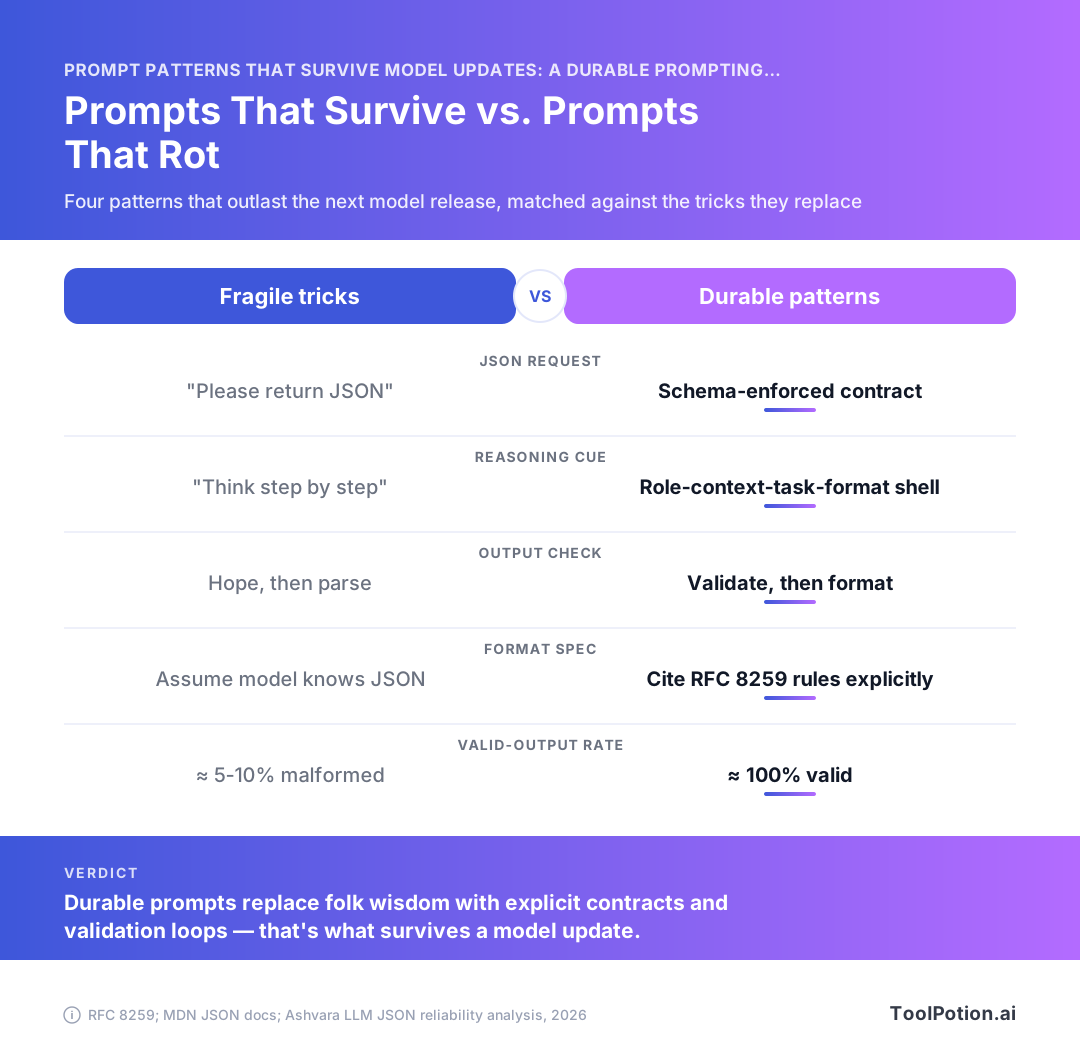
La différence apparaît le plus clairement avec le JSON. Demander poliment à un modèle de retourner du JSON laisse environ 5 à 10 % des sorties malformées, le mode JSON vous amène à environ 95-99 % de validité, et le décodage contraint par schéma atteint pratiquement 100 % (Ashvara). Même intention, trois niveaux d'application, taux d'échec radicalement différents le jour d'une publication.
Ce guide couvre quatre patterns qui continuent de fonctionner avec Claude, GPT et Gemini, les astuces fragiles à supprimer de votre bibliothèque, et une petite suite d'évaluation qui transforme la prochaine sortie de modèle en diff plutôt qu'en incident.
Pourquoi les prompts se dégradent : le mode d'échec que personne ne versionne
Les prompts ne se dégradent pas au hasard. Ils se dégradent selon une ligne prévisible : les parties qui s'appuient sur le comportement d'un modèle spécifique sont invalidées par le checkpoint suivant, et les parties qui énoncent ce que vous voulez y survivent.
Deux types de prompt : ceux qui décrivent l'intention et ceux qui exploitent une particularité
Un prompt d'intention dit ce que la sortie doit être, qui la lit, et ce qui compte comme une erreur. Un prompt de particularité dit ce qui s'est avéré fonctionner le mardi dernier. Uniquement en majuscules ONLY RETURN JSON. Trois répétitions de la même instruction parce que deux ne suffisaient pas. Un préambule magique copié depuis un forum. Ces astuces étaient calibrées sur le comportement de décodage d'un checkpoint précis, et rien en elles ne dit à un futur modèle ce dont vous avez réellement besoin.
Un prompt naïf "please return JSON" produit encore un estimation de 5 à 10 % de sorties malformées (Ashvara), et ce chiffre est une propriété du modèle, pas de votre prompt. Changez le modèle et le chiffre bouge. Vous n'avez jamais écrit le contrat, donc vous n'avez rien pour tenir le nouveau modèle responsable.
Ce qui casse vraiment le jour d'une publication
La casse est rarement bruyante. Votre parseur commence à planter sur une virgule de fin (environ 40 % des erreurs JSON dans une analyse viennent exactement de ça, Flying Fish Space), ou le modèle devient plus bavard et enveloppe une sortie propre dans une phrase de préambule. Entre-temps, le rythme des nouvelles sorties de modèles signifie que le checkpoint sur lequel vous avez travaillé ne sera peut-être plus celui qui sert le trafic le trimestre prochain.
Comparez cela à un appel contraint par schéma, où la génération est limitée à la forme que vous avez fournie et la validité syntaxique est pratiquement 100 % (Ashvara). L'application vit en dehors du texte du prompt. Une mise à jour de modèle peut changer le ton, la verbosité et la profondeur de raisonnement sans la toucher.
Le test de durabilité : ce prompt aurait-il encore du sens pour un modèle plus capable ?
Une question, posée à chaque prompt que vous possédez : si le modèle devenait deux fois plus capable du jour au lendemain, cette instruction ferait-elle encore un travail utile ?
"Retourner un objet avec les clés id, status et confidence, où status est l'une des trois valeurs littérales" passe. RFC 8259 épingle déjà le vocabulaire que vous empruntez : quatre types primitifs, deux types structurés, et exactement trois noms littéraux en minuscules (RFC 8259). Cette instruction est lisible par n'importe quel modèle, maintenant ou plus tard. "Prenez une grande inspiration et réfléchissez étape par étape" échoue, car c'est une compensation pour une faiblesse que la prochaine version n'aura peut-être pas. Supprimez les compensations et gardez les contrats.
Les patterns de prompt engineering qui se transfèrent : rôle, contexte, tâche, format
Restructurez chaque prompt ad hoc en quatre emplacements, et n'y mettez que les informations que le modèle ne peut pas inférer. Rôle, contexte, tâche, format. Le shell survit aux mises à jour de modèles car chaque emplacement porte des faits sur votre problème, pas du folklore sur la façon dont le checkpoint du trimestre dernier répondait à la flatterie.
Les quatre emplacements et ce qui appartient à chacun
Le rôle, c'est pour qui est la sortie et quelle expertise la réponse suppose. "Vous êtes un expert de classe mondiale" fixe une ambiance et ne porte aucune information. "Vous écrivez pour un ingénieur en paiements qui sait déjà ce qu'est une clé d'idempotence" dit au modèle quelles explications il peut sauter.
Le contexte, c'est tout ce que le modèle n'a aucun moyen de savoir : le schéma, le système en amont, les cas limites que vous avez déjà rencontrés en production, le fait que votre parseur rejette un BOM UTF-8. La tâche est le verbe unique et son objet. Le format est le contrat de sortie, et il doit être suffisamment précis pour être validé mécaniquement.
Un emplacement de format qui dit "retourner du JSON" est un vœu pieux. Un emplacement de format qui nomme les clés, leurs types, et ce qui se passe quand une valeur est inconnue est un contrat que vous pouvez tester. JSON vous donne quatre types primitifs (string, number, boolean, null) et deux types structurés, les objets et les tableaux (RFC 8259), donc il existe un petit vocabulaire fini pour être précis. Dites null plutôt que "laissez-le vide", car les noms littéraux true, false et null sont en minuscules et rien d'autre n'est légal (RFC 8259).
Pourquoi le shell se transfère entre Claude, GPT et Gemini
Rien dans les quatre emplacements ne dépend d'un tokenizer, d'une particularité de system prompt, ou d'un feature flag de fournisseur. Chaque modèle doit être informé des champs que vous voulez et de ce que votre code en aval en fait, donc le même shell s'insère dans Claude, GPT et Gemini sans réécriture. Cette portabilité est aussi ce qui le rend améliorable : quand un nouveau checkpoint sort, l'emplacement de contexte est toujours vrai et l'emplacement de format est toujours le contrat que votre validateur applique. Vous changez le modèle, relancez les évaluations, et le diff est vide.
La plupart des 212 outils de prompt engineering qui templatisent cette structure dans notre répertoire vous vendent les emplacements sous forme de formulaire. Vous pouvez obtenir le même effet avec un heredoc et quatre commentaires.
Écrire des contraintes comme des faits, pas des incantations
Il existe un test pour savoir si une ligne appartient à votre prompt : un sous-traitant compétent pourrait-il agir dessus sans poser de question de suivi ? "Soyez minutieux" échoue. "Les noms de propriétés sont entre guillemets doubles, pas de virgule de fin après le dernier élément" passe, et cela correspond à de vrais modes d'échec, car les virgules de fin représentent à elles seules environ 40 % des erreurs JSON dans une analyse (Flying Fish Space).
Une incantation cesse de mériter ses tokens sans jamais échouer bruyamment, tandis qu'un fait énoncé conserve sa signification à travers chaque checkpoint sur lequel vous le pointez.
Un exemple de réécriture avant/après
| Avant (ad hoc) | Après (quatre emplacements) |
|---|---|
| "You are an expert data analyst. Carefully extract the invoice details and return JSON. Be accurate!" | Rôle : la sortie est consommée par un appel Python json.loads, personne ne la lit. Contexte : les factures sont des PDFs OCR ; les noms de fournisseurs sont souvent tronqués ; les montants peuvent porter un symbole de devise. Tâche : extraire vendor, invoice_number, total_cents, issued_date. Format : un objet JSON, clés exactement comme indiqué, total_cents un entier sans zéros non significatifs, valeurs inconnues comme null, aucune prose avant ou après. |
La version après ne dit rien sur la personnalité du modèle et tout sur vos données. Notez que null et {} sont tous deux du JSON valide mais signifient des choses différentes (Jsonic), donc choisissez-en un et écrivez-le. Les zéros non significatifs ne sont pas non plus légaux dans les nombres JSON (MDN), c'est pourquoi l'emplacement de format énonce explicitement la règle des entiers plutôt que de faire confiance au modèle pour se souvenir de la grammaire.
Les scaffolds few-shot calibrés pour le transfert
Choisissez des exemples pour l'ambiguïté qu'ils résolvent. Un bloc few-shot qui démontre quatre cas où un humain hésiterait enseigne quelque chose dont le modèle suivant a encore besoin. Un bloc qui montre quatre cas faciles dans un style de maison enseigne le ton, et le ton est la chose que chaque checkpoint devine de mieux en mieux tout seul.
Des exemples qui enseignent la frontière de décision, pas le vocabulaire
Avant de coller un exemple, demandez ce qui changerait si vous le supprimiez. Si la réponse est "la sortie ressemble légèrement moins à nous", supprimez-le. Si la réponse est "le modèle classerait un remboursement avec expédition partielle comme un retour plutôt qu'un litige", gardez-le, car cet appel n'est pas dérivable de la description de la tâche.
Le même test s'applique à la forme de la sortie. Un exemple montrant un résultat vide comme [] plutôt que null vaut plus que cinq exemples de résultats remplis, puisqu'un tableau vide et null sont tous deux du JSON valide et signifient des choses différentes (Jsonic). Les modèles devinent différemment là-dessus, et un seul exemple règle la question définitivement.
Les cas limites et les négatifs méritent leur coût en tokens
Deux ou trois de vos shots devraient être des cas que vous avez mal gérés en production. Le champ manquant. L'entrée qui est déjà dans le format cible. L'enregistrement où la bonne réponse est "données insuffisantes" et où un modèle serviable va inventer une valeur à la place.
Les négatifs fonctionnent quand vous les associez à la correction plutôt qu'en énonçant une interdiction. Montrez la sortie malformée et la sortie corrigée côte à côte, et la frontière devient concrète. Les instructions "n'utilisez pas de guillemets simples" nues vieillissent mal, et les guillemets simples sont l'un des récidivistes derrière le JSON malformé, aux côtés des virgules de fin, qui représentent environ 40 % des erreurs dans une analyse (Flying Fish Space).
Combien de shots, et quand revenir à zéro
Commencez à zéro. Ajoutez des shots uniquement quand un cas d'évaluation échoue, et ajoutez le plus petit exemple qui corrige ce cas. La plupart des prompts de classification et d'extraction se stabilisent entre trois et six ; au-delà de huit, vous compensez généralement pour une description de tâche que vous n'avez jamais correctement rédigée.
Revenez à zéro chaque fois qu'un schéma fait le travail. Le décodage contraint contre un schéma fourni vous donne essentiellement 100 % de JSON syntaxiquement valide (Ashvara), donc les exemples de format sont du poids mort là. Réservez les shots pour le jugement, utilisez le schéma pour la structure.
L'odeur de surajustement : exemples que le prochain modèle imitera trop littéralement
Surveillez les shots dont les caractéristiques de surface sont accidentelles. Si chaque exemple d'entrée fait environ 40 mots, un modèle plus puissant peut traiter la longueur comme un signal. Si les quatre exemples aboutissent au même label, vous avez biaisé l'a priori. Si vos exemples utilisent des noms d'espaces réservés comme Acme Corp, attendez-vous à ce que ces noms apparaissent dans de vraies sorties un jour.
Relancez votre ensemble few-shot contre un nouveau checkpoint la semaine où il sort et comparez les sorties sur des cas que les exemples ne couvrent pas. C'est là que l'imitation fuit. Les équipes qui publient de vrais comptes rendus de déploiement ont tendance à maintenir l'ensemble d'exemples sous contrôle de version exactement pour cette raison : un exemple que vous ne pouvez pas comparer est un exemple que vous ne pouvez pas supprimer.
Les contrats de sortie qui outlive les modèles
Poussez l'application vers le bas de la pile jusqu'à ce que le format cesse de dépendre de l'humeur d'un checkpoint ce jour-là. Demander poliment du JSON est le niveau le plus faible disponible, et c'est celui sur lequel la plupart du code de production tourne encore.
Trois niveaux de fiabilité : requête en prose, mode JSON, décodage contraint
| Niveau | Comment vous demandez | Ce qui revient |
|---|---|---|
| 1 | "Please return JSON" dans le texte du prompt | Un estimé de 5-10 % des sorties sont malformées (Ashvara) |
| 2 | Mode JSON du fournisseur activé | Environ 95-99 % syntaxiquement valides dans les observations de production (Ashvara) |
| 3 | Génération contrainte par un schéma fourni | Essentiellement 100 % syntaxiquement valide (Ashvara) |
Prenez le niveau 3 partout où votre fournisseur le supporte. La validité vient alors du décodeur plutôt que des poids, donc un changement de modèle ne peut pas régresser. Gardez quand même le contrat au niveau du prompt, car le décodage contraint garantit la forme et ne dit rien sur la justesse des valeurs. Si vous préférez ne pas écrire la plomberie, les frameworks qui encapsulent l'application de schéma dans notre répertoire comptent 128 entrées.
Ce qu'un contrat doit spécifier au-delà de "retourner du JSON"
Nommez les clés, le type derrière chaque clé, et le comportement quand le modèle n'a rien à y mettre.
- Chaque clé orthographiée exactement comme votre parseur l'attend, avec un type tiré des six types JSON : quatre primitifs (string, number, boolean, null) et deux types structurés, objet et tableau (RFC 8259).
- Littéraux en minuscules uniquement. La grammaire en autorise exactement trois : false, null, true (RFC 8259).
- Noms de clés uniques à l'intérieur de chaque objet, ce que RFC 8259 recommande pour que chaque parseur soit d'accord sur le même mappage nom-valeur.
- Si les clés optionnelles sont omises ou émises avec une valeur null, et tout enum attendu, écrit sous forme de chaînes littérales.
Les modes d'échec à coder : virgules de fin, guillemets simples, chaînes non échappées
Une analyse place les virgules de fin à environ 40 % de toutes les erreurs JSON, avec les guillemets simples, les guillemets non échappés à l'intérieur des chaînes, les virgules manquantes et les caractères BOM UTF-8 cachés couvrant la majeure partie du reste (Flying Fish Space). Ces cinq modes d'échec vous coûtent peut-être 25 tokens à interdire explicitement dans l'emplacement de format, et l'interdiction reste correcte à travers chaque modèle sur lequel vous la pointerez. Associez-la à une étape valider-puis-formater de votre côté plutôt que de faire confiance à la chaîne (QuickTinyData).
Objet vide, tableau vide, null : trois réponses différentes
C'est là que les contrats fuient entre les versions de modèles sans que personne ne le remarque. Un objet vide et un tableau vide sont tous deux du JSON valide, et tous deux signifient quelque chose de différent de null (Jsonic). Un checkpoint retourne [] pour l'absence de résultats, le suivant retourne null, et votre code en aval traite l'un d'eux comme une erreur.
Choisissez la représentation, énoncez-la dans le contrat, et validez-la. Votre parseur doit aussi survivre à une valeur brute au niveau supérieur, car toute valeur JSON unique compte comme un document complet, y compris une chaîne autonome ou le nombre 42 (Jsonic).
Les astuces fragiles qui meurent à chaque publication
Ouvrez votre bibliothèque de prompts et cherchez ces quatre patterns. Chaque occurrence est candidate à la suppression, car chacune compensait une faiblesse de modèle qui soit a été corrigée, soit a bougé.
Le générique "réfléchissez étape par étape" en ajout
Ajouter "réfléchissez étape par étape" à un prompt avait du sens quand les modèles sautaient directement à une réponse. Les modèles de raisonnement actuels décomposent déjà par défaut, donc la phrase ajoute des tokens et entraîne parfois une courte tâche de classification dans trois paragraphes de narration que vous devez ensuite supprimer.
Gardez les instructions de raisonnement uniquement quand elles sont spécifiques à la tâche : "listez les clauses conflictuelles avant d'en choisir une" dit au modèle sur quoi raisonner. Le remplacement durable est l'emplacement de tâche de votre shell rôle-contexte-tâche-format, en précisant l'artefact intermédiaire que vous voulez. L'incantation générique va à la poubelle.
Les menaces, les pots-de-vin et la pression par jeu de rôle
"Vous serez licencié si vous vous trompez." "Je vous donnerai un pourboire de 200 $." "Vous êtes le plus grand analyste du monde." Ceux-ci s'appuyaient sur des particularités de checkpoints RLHF spécifiques, et les particularités ne survivent pas au réentraînement. Pire, elles sont non falsifiables : vous ne pouvez pas écrire un test qui prouve que le pourboire est ce qui a corrigé votre sortie, donc la ligne reste dans le prompt pour toujours, non contestée.
Remplacez la pression par des contraintes. Une rubrique contre laquelle le modèle se note lui-même, ou une liste explicite de ce qui compte comme un échec, fait le même travail et continue de fonctionner quand le checkpoint change.
Les hacks de formatage qui luttent contre le tokenizer
Rembourrer les prompts avec des demandes EN MAJUSCULES, des triples points d'exclamation, ou de longues séries de délimiteurs comme ##### est du folklore. La partie délimiteurs avait un noyau de vérité (des limites de section claires aident), mais l'escalade non. Deux sauts de ligne et une balise de type XML battent quarante signes dièse.
Idem pour "pas de balises de code, pas de préambule, pas d'explication, sortir UNIQUEMENT du JSON" empilé trois fois. Dites-le une fois dans l'emplacement de format et mettez ensuite la garantie là où les garanties vivent réellement : contraindre la génération à un schéma fourni est ce qui vous amène à essentiellement 100 % de JSON syntaxiquement valide (Ashvara), et aucun empilement d'interdictions côté prompt n'approche ce chiffre.
Les supplications au niveau du prompt là où un parseur devrait être
Les modes d'échec sont ennuyeux et structurels : virgules de fin après le dernier élément, clés non quotées, caractères de guillemets invalides, virgules manquantes, accolades non correspondantes (QuickTinyData). Les virgules de fin seules représentent environ 40 % des erreurs JSON dans un ensemble de données d'erreurs (Flying Fish Space), et elles sont interdites par le format lui-même (MDN). Aucune quantité de demandes polies ne comble cet écart.
Supprimez les supplications. Mettez un schéma et un validateur à la place, et laissez le prompt dire ce que signifient les champs.
Les boucles d'évaluation traitent les prompts comme des artefacts versionnés
Construisez vingt cas de test avant de construire quoi que ce soit d'intelligent. Un prompt sans ensemble d'évaluation est un prompt que vous ne pouvez pas mettre à jour, car vous n'avez aucun moyen de savoir si le nouveau modèle l'a amélioré ou a cassé le seul cas qui compte pour votre plus gros client sans vous le dire.
Vingt n'est pas un chiffre de compromis. C'est suffisant pour attraper les classes d'échec que vous connaissez déjà, assez petit pour que vous l'écriviez dans un après-midi, et assez bon marché pour le relancer à chaque checkpoint sans penser à la facture.
L'évaluation minimale viable : 20 cas, une assertion chacun
Une assertion par cas, et faites-en un booléen : la sortie a-t-elle été parsée, contenait-elle le champ requis, a-t-elle refusé quand elle aurait dû refuser. Les rubriques, les modèles juges et les scores de similarité peuvent venir plus tard, une fois que le booléen est vert. Les cas avec trois assertions deviennent des cas que vous ne pouvez pas déboguer, et une exécution rouge ne vous dit rien sur lequel des trois a cassé.
Choisissez vos vingt depuis le trafic réel, pondéré vers le côté laid. Cinq chemins heureux, cinq entrées ambiguës, cinq adversariales ou vides, cinq qui ont cassé en production à un moment donné. Stockez-les à côté du prompt dans le même dépôt, dans le même commit. Si le prompt change et que les cas ne changent pas, c'est un commentaire de revue.
Valider d'abord, puis formater : emprunter le workflow de débogage JSON
Le monde JSON a réglé cet argument il y a des années. Le guide de dépannage de QuickTinyData recommande de valider d'abord et de formater ensuite, car la mise en forme d'un document cassé cache l'erreur structurelle exacte que vous cherchez : virgules de fin, clés non quotées, mauvais caractères de guillemets, virgules manquantes, accolades non correspondantes (QuickTinyData).
Lancez votre évaluation de la même manière. Affirmez la validité avant d'affirmer la qualité. Une sortie de modèle qui échoue à json.loads ne devrait pas avancer vers le contrôle sémantique, et elle ne devrait pas non plus obtenir de crédit partiel. Votre suite d'évaluation a besoin de deux colonnes, taux de parsing et taux de passage, et la deuxième ne compte que les lignes où la première a réussi.
Connaître la distribution des erreurs vous dit quoi affirmer. Une analyse place les virgules de fin à environ 40 % des erreurs JSON, avec les guillemets simples, les guillemets non échappés à l'intérieur des chaînes, les virgules manquantes et les caractères BOM UTF-8 cachés constituant l'essentiel du reste (Flying Fish Space). Celui du BOM vaut une assertion dédiée, car il est invisible dans chaque éditeur que vous utiliserez pour inspecter la sortie.
Exécutions de régression le jour d'une publication
Un nouveau checkpoint sort. Vous lancez les vingt, vous obtenez un diff, vous décidez. C'est toute la procédure, et cela prend environ quatre minutes si vous avez bien construit la suite.
- Fixez l'ancien modèle et relancez la suite pour confirmer que votre baseline se reproduit encore. Si ce n'est pas le cas, le problème est dans votre configuration de test plutôt que dans la publication.
- Lancez la suite contre le nouveau checkpoint et enregistrez séparément le taux de parsing et le taux de passage.
- Lisez chaque cas qui a changé, dans les deux sens. Un cas qui a commencé à passer peut être de la chance, et il mérite autant d'attention qu'une régression.
- Publiez, revenez en arrière, ou corrigez le prompt. Puis commitez les nouveaux chiffres de baseline à côté du fichier de prompt.
Cela importe le plus dans les stacks d'agents où un seul mauvais parsing se propage, car l'échec remonte trois appels d'outil plus loin comme quelque chose qui ne ressemble en rien à un bug de formatage.
Fixer les versions, et que faire quand vous ne pouvez pas
Fixez des identifiants de modèle datés partout où vous pouvez, et traitez un alias comme une dépendance flottante que vous avez choisi de ne pas verrouiller. Certains fournisseurs ne vous donnent pas de pin, ou vont déprécier celui sur lequel vous êtes avec une courte fenêtre. Dans ce cas, votre suite d'évaluation est ce qui se trouve entre un changement de comportement silencieux et un ticket de support que vous ne pouvez pas reproduire.
Lancez la suite selon un calendrier contre l'endpoint non fixé. Hebdomadaire, c'est bien. Vous trouverez la dérive avant que vos utilisateurs ne vous la narrent dans un rapport de bug.
Porter un prompt entre Claude, GPT et Gemini
Environ 80 % d'un prompt bien construit se porte sans changement. Le reste est une couche d'adaptateur que vous écrivez une fois par fournisseur et que vous oubliez ensuite en grande partie. Si vous réécrivez tout pour chaque vendeur, votre prompt portait un comportement spécifique au fournisseur qu'il n'avait jamais besoin de porter.
Ce qui reste identique : le shell, les exemples, le contrat
Le shell à quatre emplacements se déplace entre fournisseurs sans aucune modification. Rôle, contexte, tâche, format décrivent le travail, et le travail ne change pas quand vous changez de checkpoint. Idem pour votre bloc few-shot : les exemples qui résolvent une vraie ambiguïté dans votre domaine enseignent la même chose à chaque modèle, car l'ambiguïté vit dans vos données, pas dans le décodeur.
Votre contrat de sortie reste identique aussi, et il le doit. Quelle que soit la sortie d'un fournisseur, elle doit satisfaire le même parseur : noms de propriétés entre guillemets doubles, pas de virgules de fin, pas de NaN ou Infinity, et seulement quatre caractères d'espacement légaux (espace, tabulation, saut de ligne, retour chariot) (MDN). Écrivez le schéma une fois. Validez les trois sorties avec le même validateur, et comparez les échecs.
Gardez aussi votre ensemble d'évaluation neutre vis-à-vis des fournisseurs. Vingt cas qui passent sur Claude et échouent sur Gemini vous disent quelque chose d'utile. Vingt cas écrits contre les particularités de Claude ne vous disent rien.
Ce que vous recalibrez par fournisseur : le poids du system message, les délimiteurs, l'API d'application
Trois choses obtiennent un adaptateur. Quelle quantité de votre instruction va dans le system message par rapport au tour utilisateur, car les fournisseurs pondèrent ceux-ci différemment. Ce que vous utilisez pour délimiter les blocs, les balises de type XML ou les en-têtes markdown. Et quelle API d'application vous appelez.
Ce dernier point est la partie délicate. Le mode JSON de toute saveur vous achète la syntaxe et s'arrête là : les observations de production le placent à environ 95-99 % syntaxiquement valide, tandis que contraindre la génération à un schéma fourni est essentiellement 100 % (Ashvara). Aucun niveau ne dit quoi que ce soit sur le fait que les clés soient celles que vous avez demandées, donc le contrôle de schéma reste dans votre code quel que soit le fournisseur. Si vous choisissez des cibles, cela vaut la peine de comparer les modèles eux-mêmes avant de vous engager, et les plateformes multi-fournisseurs dans notre répertoire absorberont une partie de ce travail d'adaptateur pour vous.
Une liste de contrôle de portabilité avant de publier
- Supprimez chaque phrase qui nomme un modèle, une version, ou un comportement connu d'un modèle. Ce sont les lignes qui cassent en premier.
- Lancez le même ensemble d'évaluation contre les trois fournisseurs et enregistrez les taux de passage par cas, pas seulement une moyenne.
- Confirmez que le validateur de schéma s'exécute sur chaque réponse, que le fournisseur revendique ou non un décodage contraint.
- Relisez les docs d'application de chaque fournisseur quand vous câblez l'adaptateur, et gardez tout libellé ou indicateur requis dans l'adaptateur plutôt que dans le prompt partagé.
- Journalisez quel adaptateur s'est déclenché. Quand un checkpoint sort et que la qualité change, vous voulez savoir si c'est le prompt ou l'adaptateur qui a changé sous vous.
Si un prompt échoue à cette liste de contrôle sur un seul fournisseur, le bug est presque toujours dans l'adaptateur, pas dans le shell.
Foire aux questions
Dois-je réécrire mes prompts à chaque fois qu'un nouveau modèle sort ?
Non, et si vous le faites, votre prompt portait probablement des hacks spécifiques au modèle plutôt que des instructions. Les parties qui survivent aux mises à jour sont celles liées à quelque chose en dehors du modèle : une description de tâche, des données d'entrée, et un contrat de sortie comme un schéma JSON. Le décodage contraint contre un schéma fourni produit essentiellement 100 % de JSON syntaxiquement valide quel que soit le modèle derrière, car la contrainte vit dans le décodeur. Ce que vous devriez réécrire lors d'un changement de modèle, c'est rien. Ce que vous devriez relancer, c'est votre ensemble d'évaluation.
"Réfléchissez étape par étape" fonctionne-t-il encore sur les modèles actuels ?
C'est majoritairement du poids mort maintenant. Cette phrase était une solution de contournement pour les modèles qui sautaient directement à une réponse, et les modèles actuels décomposent déjà le travail en plusieurs étapes sans y être invités. Pire, l'ajouter à un prompt qui exige une sortie JSON stricte invite le modèle à émettre de la prose de raisonnement autour de l'objet, ce qui est exactement la classe d'échec qui pousse les prompts naïfs à un taux estimé de 5 à 10 % de JSON malformé. Si vous voulez du raisonnement, donnez-lui un champ nommé dans votre schéma et laissez le parseur le garder séparé de la charge utile.
Le mode JSON est-il suffisant, ou ai-je besoin d'un schéma ?
Utilisez le schéma. Le mode JSON vous amène à environ 95-99 % de sortie syntaxiquement valide, ce qui semble bien jusqu'à ce que vous fassiez dix mille appels par jour et absorbiez une centaine d'échecs. Le décodage contraint par schéma amène la validité syntaxique à essentiellement 100 %, et il fixe aussi vos noms de clés, ce qui importe car RFC 8259 traite un objet JSON comme une collection non ordonnée de paires nom-valeur et recommande seulement des noms uniques. La validité syntaxique n'est pas la correction sémantique, donc continuez à valider l'objet parsé contre vos propres règles dans tous les cas.
Combien d'exemples few-shot un prompt durable devrait-il inclure ?
Deux à quatre, et choisissez-les pour la couverture des cas limites plutôt que pour le volume. Les exemples qui montrent le même chemin heureux à répétition n'enseignent rien au modèle qu'il ne fait pas déjà ; les exemples qui fixent les cas délicats sont ceux qui se transfèrent entre modèles. Pour les sorties structurées, consacrez au moins un exemple à la distinction entre un conteneur vide et une valeur manquante, car [un objet vide {} et un tableau vide [] sont tous deux du JSON valide mais sémantiquement différents de null](https://jsonic.io/guides/json-examples). Si vos exemples contiennent du formatage qu'un parseur strict rejetterait, vous enseignez l'échec : les virgules de fin seules représentent environ 40 % des erreurs JSON dans une analyse.
Quelle taille doit avoir un ensemble d'évaluation de prompt avant d'être utile ?
Trente à cinquante cas étiquetés attraperont la plupart des régressions, et vingt c'est mieux que le zéro avec lequel la plupart des équipes travaillent. La taille importe moins que la composition : pondérez l'ensemble vers les modes d'échec que vous avez réellement vus en production, comme les clés non quotées, les guillemets simples, les guillemets non échappés à l'intérieur des chaînes, les virgules manquantes et les caractères BOM UTF-8 cachés, qui apparaissent tous dans les analyses d'erreurs JSON documentées. Lancez la validation avant le formatage pour attraper les casses structurelles plutôt que de les masquer, ce qui est le workflow que QuickTinyData recommande. Versionnez l'ensemble à côté du prompt et relancez-le le jour où un nouveau modèle arrive.
Le même prompt peut-il vraiment tourner sans changement sur Claude, GPT et Gemini ?
Le corps des instructions se porte proprement. La couche d'application de la sortie ne se porte pas, car le mode JSON et le décodage contraint par schéma se configurent différemment par fournisseur, donc prévoyez un prompt et trois adaptateurs minces. Garder le contrat dans un format sur lequel chaque fournisseur s'accorde déjà aide : RFC 8259 est indépendant du langage et définit quatre types primitifs plus les objets et les tableaux, avec les minuscules true, false et null comme seuls noms littéraux. Si vous cherchez des outils pour gérer les prompts entre fournisseurs, notre répertoire liste 212 outils de prompt engineering et 324 entrées sous modèles IA.