

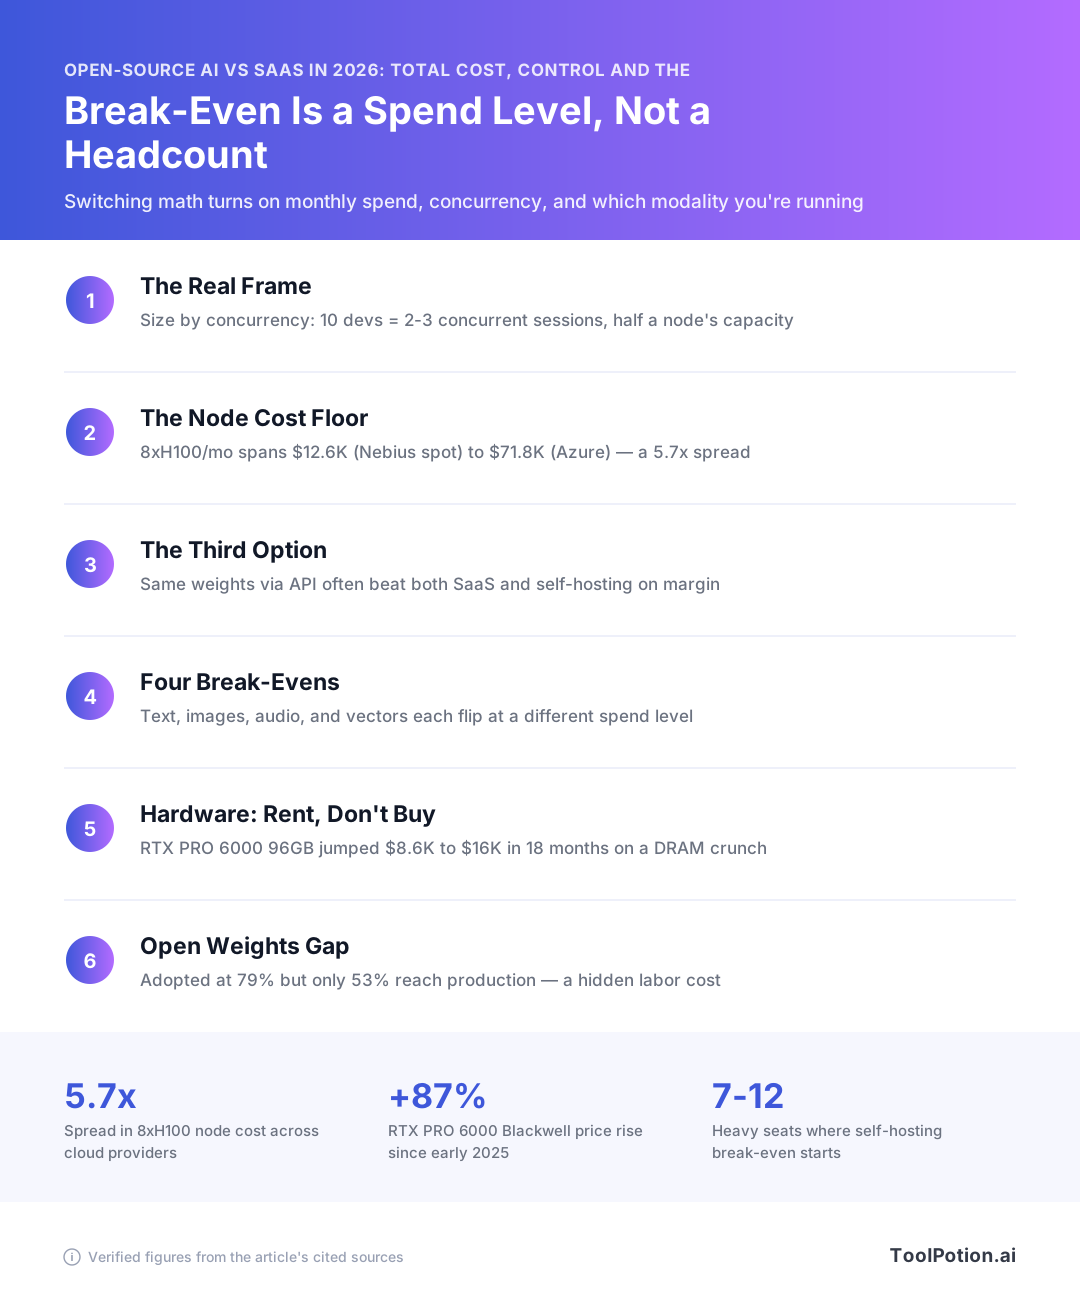
La décision IA open source vs SaaS repose sur deux chiffres : votre dépense mensuelle et votre profil de concurrence. L'effectif est un mauvais indicateur pour les deux. Les ingénieurs de DoiT dépensent en moyenne $2 200 par développeur par mois sur Claude Code à facturation à l'usage, ce qui rend un nœud à 15 000–25 000 $ rentable à environ 7 à 12 postes intensifs. Mais seulement 10 à 20 % d'une équipe a une requête en cours à un instant donné, donc dix développeurs représentent deux ou trois sessions simultanées et un demi-nœud inactif.
Et avant même de regarder le prix des GPU, vérifiez la troisième option que personne ne compare : DeepInfra sert Llama-3.3-70B à $0,10 entrée / $0,32 sortie par million de tokens. Les mêmes poids, avec des marges multi-locataires que vous ne pouvez pas égaler. Le calcul ci-dessous est effectué quatre fois, pour le texte, les images, la transcription et la couche vectorielle.
Le seuil de rentabilité est un niveau de dépenses et un profil de concurrence
Deux chiffres déterminent si vous devriez auto-héberger, et l'effectif n'en fait pas partie. Le premier est ce que vous dépensez par mois en IA en ce moment. Le second est le nombre de requêtes en cours au même instant. Tout le reste, y compris le choix du modèle, découle de ces deux données.
Les deux chiffres qui tranchent avant tout choix de modèle
Un nœud GPU coûte la même chose que vous le saturiez ou le laissiez inactif à 3h du matin. C'est l'asymétrie sur laquelle repose toute la comparaison : le SaaS vous facture par token, un nœud vous facture par heure. La question est donc de savoir si votre facture mensuelle a dépassé le coût fixe d'une machine que vous pouvez garder occupée.
L'équipe d'ingénieurs de DoiT dépense en moyenne environ 2 200 $ par développeur par mois sur la tarification Enterprise de Claude Code à l'usage, ce qui situe le seuil de rentabilité de l'auto-hébergement à 15 000–25 000 $/mois à environ 7 à 12 postes IA intensifs. C'est un seuil bien plus bas que la règle des « centaines d'ingénieurs » que répètent la plupart des guides TCO. Il s'agit d'un seuil de dépenses plutôt que d'un seuil de personnes. Douze développeurs qui utilisent peu un assistant n'y arrivent pas, tandis que sept qui font tourner des agents toute la journée, oui.
La concurrence est le deuxième chiffre, et c'est celui que les équipes calculent mal. L'argument de DoiT est qu'à tout moment, seulement 10 à 20 % d'une équipe de développeurs a une requête en cours, donc dix développeurs représentent deux ou trois sessions simultanées, soit au mieux la moitié de la capacité d'un nœud. Vous payez pour huit H100 et en utilisez trois ou quatre. Dimensionnez selon les requêtes concurrentes en pic et le débit de tokens cible, puis vérifiez si cela tient sur un seul nœud avant de chiffrer quoi que ce soit.
Pourquoi « nous avons 50 ingénieurs » est le mauvais déclencheur
L'effectif ne se corrèle avec les dépenses que si l'usage par personne est uniforme, ce qui n'est jamais le cas. Une équipe de 50 personnes où 8 font tourner des agents de codage en continu et 42 utilisent le chat occasionnellement a les mêmes besoins en nœuds qu'une équipe de 8 utilisateurs intensifs, et à peu près la même facture. Comptez les postes intensifs.
Calculez ces deux chiffres avant de comparer les modèles open-weight répertoriés dans notre annuaire avec quoi que ce soit. Choisissez le modèle après avoir déterminé si un nœud peut rester occupé, car un modèle 6 points derrière la frontière est un bon compromis sur une machine saturée et une erreur coûteuse sur une machine tournant au quart de charge.
IA open source vs SaaS : ce que coûte l'auto-hébergement en 2026
Commencez par la grille tarifaire, car c'est le seul chiffre que vous pouvez consulter. Tout le reste dans un budget d'auto-hébergement est une estimation que vous défendez dans un tableur.
Grilles tarifaires GPU en location : un écart de ~7x sur le silicium capable d'inférence
La tarification publique de RunPod liste le H100 SXM 80GB à 3,29 $/h sur Secure Cloud et 2,69 $/h sur Community Cloud, le H200 141GB à 4,59 $/3,59 $, l'A100 PCIe 80GB à 1,39 $/1,19 $, le L40S 48GB à 0,99 $/0,79 $, et le B200 180GB à 6,79 $/5,98 $ (RunPod). C'est environ 7x entre la carte la moins chère et la plus chère pouvant servir de l'inférence. Si votre charge de travail est un modèle 7B ou 8B avec un contexte modeste, la ligne L40S est celle à prendre en référence, et la plupart des articles TCO n'en parlent jamais.
Lambda facture 4,29 $/h pour un H100 SXM unique à la demande, descendant à 3,99 $/h par GPU sur un nœud 8x, avec le H100 PCIe à 3,29 $/h et le B200 SXM6 à 6,69–6,99 $/h (Lambda). Un nœud 8xH100 à ce tarif revient à environ 31,92 $/h, soit environ 23 300 $ pour un mois de 730 heures à 100 % de disponibilité. Personne ne tourne à 100 % de disponibilité, ce qui fait tout l'intérêt du chiffre suivant.
La remise sur engagement est le levier le plus puissant que vous contrôlez. Together AI facture 3,99 $/GPU-h à la demande pour HGX H100 et 3,19–3,69 $/GPU-h sur des termes réservés de 7 à 180+ jours (Together AI). Comptez environ 20 % de réduction, disponible uniquement si vous êtes suffisamment confiant dans votre charge pour signer sur la durée.
Le multiplicateur fournisseur : de 12 600 $ à 71 800 $ pour le même mois de 8xH100
DoiT a évalué le coût d'un nœud 8xH100 identique pour un mois de 730 heures chez différents fournisseurs : environ 12 600 $ sur Nebius spot, 22 500 $ sur Nebius à la demande, 40 200 $ sur AWS, 64 100 $ sur GCP et 71 800 $ sur Azure (DoiT). Même silicium, écart de 5,7x. Votre choix de fournisseur fait plus bouger le calcul du changement que votre choix de modèle, donc si vous faites cette évaluation aux tarifs catalogue des hyperscalers parce que c'est là que vivent vos engagements de dépenses, vous comparez la pire version de l'auto-hébergement face au SaaS.
| Fournisseur / carte | Tarif horaire | Notes |
|---|---|---|
| RunPod L40S 48GB | $0,99 / $0,79 | Secure vs Community Cloud |
| RunPod H100 SXM 80GB | $3,29 / $2,69 | Secure vs Community Cloud |
| Lambda H100 SXM (nœud 8x) | $3,99 par GPU | ~$23 300 / mois de 730 h |
| Together AI HGX H100 | $3,99 à la demande, $3,19–$3,69 réservé | Termes de 7 à 180+ jours |
Les postes que personne ne chiffre : heures d'inactivité, redondance et main-d'œuvre de maintenance
Un nœud loué est facturé à l'horloge murale. Votre facture API suit les tokens, tandis que votre facture GPU suit les heures que vous n'utilisez peut-être pas. Si votre trafic est aux heures de bureau en semaine, vous payez environ 168 heures de capacité utile sur 730 et absorbez le reste, donc multipliez votre coût effectif par token par quatre avant de le comparer à une facture API. Ajoutez un second nœud ou une clé API de secours si le service est orienté client, car un nœud unique n'a pas de basculement. Ajoutez l'ingénieur qui patche vLLM, fait tourner les versions de modèles, surveille la pression du cache KV et reçoit des alertes à 2h du matin. Les fournisseurs dans notre annuaire de plateformes de machine learning géreront une partie de ça pour une marge, généralement moins cher que le demi-poste que vous dépenseriez autrement.
Un chiffre mensuel défendable est donc : heures de nœud au tarif réel de votre fournisseur, divisées par votre disponibilité réelle, plus la redondance, plus le temps d'ingénierie chargé. Exécutez les quatre avant de comparer quoi que ce soit.
La troisième option qui ruine la plupart des cas d'auto-hébergement
Presque tous les articles comparant l'open source au SaaS placent une facture GPU à côté d'une facture API frontière et déclarent un gagnant. Cette comparaison ignore l'option que la plupart des équipes devraient choisir : quelqu'un d'autre exécute les poids open source pour vous, en multi-locataire, et facture par token.
DeepInfra sert Llama-3.3-70B-Instruct-Turbo à 0,10 $ entrée / 0,32 $ sortie par million de tokens, et Meta-Llama-3.1-8B à 0,02 $/0,04 $ (DeepInfra). Les mêmes checkpoints que vous téléchargeriez. Les mêmes conditions de licence. La différence est que leurs H100 tournent proche de la saturation sur des milliers de clients, et les vôtres tournent à ce que représente votre trafic à 3h du matin un dimanche.
Les mêmes poids open, la courbe d'occupation de quelqu'un d'autre
Faites le calcul face au niveau dédié de DeepInfra et l'écart devient embarrassant. Un H100 80GB dédié coûte 2,20 $/h là-bas (DeepInfra), soit 1 606 $ pour un mois de 730 heures. À 0,32 $ par million de tokens en sortie, ces 1 606 $ achètent environ cinq milliards de tokens en sortie sur le point de terminaison serverless. Répartis sur les 43 800 minutes du mois, votre H100 unique devrait soutenir environ 115 000 tokens de sortie par minute, chaque minute, juste pour égaler l'API en termes de prix. Un déploiement réel passe une grande partie de ces minutes à l'arrêt.
Vous achetez une capacité dédiée pour des raisons autres que le coût unitaire : résidence des données, aucune rétention par un tiers, planchers de latence que vous contrôlez, LoRAs personnalisés, modèles que personne n'héberge. Ce sont des raisons réelles. Ce sont des raisons d'approvisionnement plutôt que des raisons de tableur, et vous devriez le dire clairement quand vous le défendez.
Quand la location des poids cesse d'être moins chère
Le marché des petits modèles s'est effondré sur lui-même. GPT-5-nano tourne à 0,05 $/0,40 $ par million de tokens et GPT-5 à 1,25 $/10,00 $ (OpenAI), ce qui signifie qu'un modèle propriétaire est maintenant moins cher que ce que vous paieriez pour garder un modèle open 8B au chaud sur votre propre matériel. Les APIs open-weight bon marché et les APIs propriétaires bon marché se concurrencent sur le même axe, et l'auto-hébergement perd face aux deux.
Choisissez soigneusement votre référence, car c'est elle qui détermine la réponse. La gamme d'Anthropic va de 10 $/50 $ par million pour Fable 5.1 jusqu'à 1 $/5 $ pour Haiku 4.5 (Anthropic). Comparez l'auto-hébergement au haut de cette gamme et ça ressemble à une aubaine. Comparez-le à Haiku, ou à Llama de DeepInfra, et le nœud GPU doit se justifier par le contrôle plutôt que par le coût.
Quatre modalités, quatre seuils de rentabilité complètement différents
Une équipe qui auto-héberge la transcription n'auto-héberge presque jamais l'inférence de texte, et la raison est arithmétique. Chaque charge de travail a son propre prix plancher SaaS, son propre schéma de charge GPU et ses propres règles de licence. Appliquez un seul modèle de seuil de rentabilité à toutes les quatre et vous obtiendrez une mauvaise réponse trois fois sur quatre.
Inférence de texte : le point de bascule le plus large et le moins prévisible
C'est la modalité où le point de bascule bouge le plus, car le prix de l'API que vous comparez couvre un ordre de grandeur. Anthropic facture 2 $/10 $ par million de tokens entrée/sortie pour Sonnet 5 et 1 $/5 $ pour Haiku 4.5 (tarification Claude), tandis qu'OpenAI liste GPT-5-mini à 0,25 $/2,00 $ et GPT-5-nano à 0,05 $/0,40 $ (tarification API OpenAI). Choisissez votre niveau de référence et le seuil de rentabilité oscille entre quelques centaines de millions de tokens par mois et plusieurs milliards.
Un H100 dédié à 2,20 $/h sur DeepInfra tourne à environ 1 606 $ par mois en disponibilité continue (tarification DeepInfra). Face au tarif mixte de GPT-5-nano, il faudrait atteindre des volumes que la plupart des équipes n'atteignent jamais. Face à Fable 5.1 à 10 $/50 $ par million (tarification Claude), le même nœud s'amortit bien plus tôt. Décidez de quel niveau votre charge de travail a besoin avant de modéliser quoi que ce soit, et parcourez l'annuaire des modèles et LLMs si vous êtes encore en train de sélectionner des poids open.
Génération d'images : la licence tranche avant le GPU
Ici, le calcul GPU est la partie facile et la licence est le piège. Il est largement rapporté que les poids FLUX.1 [dev] sont livrés sous une licence non commerciale, ce qui placerait une licence Black Forest Labs payante entre vous et un produit commercial, donc lisez les conditions vous-même avant de budgétiser le matériel. Personne qui compare les modèles d'image open à Midjourney ne le mentionne, et c'est le poste qui peut faire basculer la décision.
Le travail d'image en rafale est ce qui échoue au test. Une équipe marketing qui génère par lots le mardi laisse la carte inactive le reste de la semaine, et les heures d'inactivité sont facturées au même tarif que les heures actives. Un L40S à 0,79 $/h sur RunPod Community Cloud (tarification RunPod) est suffisamment bon marché pour que les traitements batch continus passent le seuil confortablement, c'est pourquoi les pipelines planifiés sont la forme qui fonctionne ici. Il y a 727 outils de génération d'images dans notre annuaire, et les conditions de licence varient plus que la qualité de sortie.
Transcription : la modalité qui bascule le plus tôt
Sauf qu'en général elle ne le fait pas, et la raison c'est AssemblyAI. OpenAI facture 0,006 $/minute pour Whisper et gpt-4o-transcribe, et 0,003 $/minute pour gpt-4o-mini-transcribe, soit 0,36 $ et 0,18 $ par heure audio (tarification API OpenAI). Face à 0,36 $/heure, un L40S à 0,79 $/h atteint le seuil de rentabilité à quelques centaines d'heures audio par mois, en supposant un débit batch plus rapide que le temps réel. C'est un seuil genuinement bas. Puis AssemblyAI propose Universal-2 à 0,15 $/heure et Universal-3.5 Pro à 0,21 $/heure (tarification AssemblyAI), et votre seuil de rentabilité monte de plus de 2x.
Le seul endroit où l'auto-hébergement gagne haut la main, c'est le streaming. AssemblyAI facture le streaming par durée de session WebSocket, y compris le temps de connexion inactif (tarification AssemblyAI). Si vous maintenez des sockets ouverts pour des réunions où les gens ne parlent pas, vous payez pour le silence. Un point de terminaison auto-hébergé vous facture des secondes GPU plutôt que de l'horloge murale.
RAG et la couche vectorielle fonctionnent sur le volume de requêtes
Le seuil de rentabilité de la recherche vectorielle se compte en requêtes par mois, et le chiffre qui circule se situe quelque part autour de 60 à 80 millions de requêtes avant que l'auto-hébergement ne batte la tarification gérée. Considérez cela comme une règle empirique plutôt qu'une grille tarifaire, car il évolue avec la taille de l'index, le nombre de réplicas et le budget de latence que vous êtes prêt à dépenser. En dessous de cette plage, vous payez un ingénieur pour surveiller un index qu'un service géré ferait tourner pour moins que son salaire. La génération d'embeddings est un calcul séparé, et c'est la chose la moins chère à auto-héberger parmi tout ce qui est discuté ici, car le modèle est petit et le travail se prête parfaitement au traitement par lots.
Quatre charges de travail, quatre seuils, et aucune raison de les migrer toutes en même temps.
Acheter le matériel ? La crise mémoire de 2026 dit : louez
Tout calcul de retour sur investissement que vous avez lu et qui a été écrit avant mi-2026 tourne sur des prix qui n'existent plus. Le conseil était raisonnable à l'époque : achetez une machine, amortissez-la sur trois ans, battez le tarif de location au 14ème mois. Puis le marché de la mémoire s'est effondré.
Une hausse de ~87 % sur un GPU inchangé
La RTX PRO 6000 Blackwell 96GB de NVIDIA est l'exemple le plus clair car le produit n'a pas changé. Elle était listée à 8 565 $ chez un revendeur début 2025 (avec un bas de précommande à 7 673 $), a atteint 13 250 $ en juin 2026, et 16 000 $ en août 2026 (igor'sLAB). C'est environ 87 % en 18 mois, et NVIDIA n'a fourni aucune explication officielle.
Faites tourner ça dans un tableur de 2025 et le mois de retour sur investissement double à peu près. Un poste de travail monocarte que vous aviez estimé à 12 000 $ tout compris est maintenant plus proche de 20 000 $ avant même d'acheter la RAM.
Pourquoi la HBM a absorbé l'approvisionnement en DRAM
La demande de GPU n'est que la moitié de l'histoire. Ce qui importe, c'est ce que cette demande a fait aux fabs de mémoire : la mémoire à haute bande passante représente désormais environ 23 % de la capacité mondiale de wafers DRAM, contre 8 % en 2024, car la HBM rapporte 3 à 5 fois plus de revenus par wafer que la DDR5 conventionnelle (DatacenterDisk). Les fabs ont déplacé les wafers là où se trouve l'argent. Les prix des DDR5 ECC RDIMM serveur ont augmenté d'environ 100 % à 116 % entre le T1 2025 et le T1 2026 en conséquence, donc la mémoire hôte autour de vos GPU a été aussi touchée que les accélérateurs. Vous le ressentez deux fois dans une seule construction : la carte, et le To de RAM système qui est dessous.
Ce qu'un plan d'amortissement écrit en 2026 devrait supposer
Supposez que la distorsion survivra à votre décision d'achat. Goldman Sachs a prévu en mai 2026 un déficit mondial de DRAM de 4,9 % pour l'année, le pire en 15 ans, plus un déficit d'approvisionnement en HBM de 5,1 %, et la plupart des analystes n'attendent pas d'amélioration significative avant fin 2027 (Wccftech). Un plan d'amortissement sur trois ans commencé aujourd'hui passe ses deux premières années dans la pénurie.
Estimez donc le cas d'achat aux coûts d'acquisition d'août 2026 plutôt qu'aux chiffres de 2025 qui figurent encore dans les pages de classement, et ne supposez pas un renouvellement moins cher en année deux. Si les chiffres ne fonctionnent qu'avec les prix du matériel de 2025, louez. Louer, c'est garder l'option d'acheter en 2028 plutôt.
Contrôle et conformité : la partie que le tableur rate
Certaines garanties ne s'obtiennent qu'en exécutant les poids vous-même. La plupart de celles que les équipes citent comme raison de s'auto-héberger, vous pouvez maintenant les acheter.
Ce que l'auto-hébergement achète vraiment, et ce qu'il semble seulement acheter
Exécuter votre propre inférence vous donne quatre choses qu'aucune clause contractuelle ne peut reproduire : des poids de modèle qui ne changent pas sous vous selon le calendrier de dépréciation d'un fournisseur, aucune donnée par requête ne quittant votre VPC, aucune limite de débit imposée par la planification de capacité de quelqu'un d'autre, et la capacité de fine-tuner ou de quantifier sans demander la permission. Si votre registre des risques comporte une ligne sur une version de modèle retirée en cours d'audit, c'est un vrai argument pour posséder l'artefact.
La liste de ce que l'auto-hébergement semble seulement acheter est plus longue. Résidence des données, chiffrement au repos, engagements de non-entraînement sur vos données, preuves SOC 2, journaux d'audit, traitement régional : tout cela s'achète comme clauses contractuelles plus un sélecteur de région, et c'est disponible depuis un moment. Payer une prime GPU pour cela revient à acheter deux fois. L'exposition qui alimente ces discussions est le calcul des pénalités, et le calcul des pénalités n'est pas lié à qui installe le matériel. Les régulateurs ont émis 7,1 milliards d'euros en 2 245 amendes RGPD jusqu'au début 2026, avec une exposition RGPD atteignant 4 % du chiffre d'affaires mondial et une exposition au règlement sur l'IA allant jusqu'à 7 %. Un modèle auto-hébergé mal configuré échoue à un audit exactement aussi vite qu'un modèle hébergé.
La réinitialisation réglementaire de 2026 a changé les délais que vous planifiez
Vérifiez la date du calendrier de conformité sur lequel votre équipe travaille. Les obligations à haut risque du règlement européen sur l'IA ont été repoussées par le Digital Omnibus de 2026, donc la date limite du 2 août 2026 que plusieurs pages de comparaison largement citées affichent encore a été dépassée, et vous devriez confirmer les dates actuelles auprès de votre propre conseiller juridique avant de dépenser en conséquence. Si vous avez approuvé un budget d'auto-hébergement début 2026 pour respecter cette date, l'urgence sur laquelle il était basé a disparu et la dépense mérite un second examen.
C'est là que ça compte le plus dans les secteurs réglementés. Les équipes qui recherchent des outils IA pour la santé et les sciences de la vie sont celles les plus susceptibles d'avoir tarifé un déploiement privé contre une échéance qui a bougé.
Le cloud souverain géré est la voie intermédiaire
L'argument de résidence s'est affaibli en 2026. Les régions cloud souveraines dotées de personnel et gouvernées au sein de l'UE sont désormais une option gérée qui n'existait pas quand la plupart des comparaisons open source vs SaaS que vous trouverez ont été rédigées, donc vérifiez ce que votre hyperscaler préféré propose en région avant de chiffrer un nœud. Vous pouvez obtenir un traitement des données exclusivement en UE sans embaucher quelqu'un pour surveiller vLLM à 2h du matin.
L'ordre de priorité qui tient est le suivant. Si votre exigence est la résidence, achetez du cloud souverain géré. Si c'est la permanence des poids ou le fine-tuning sans restriction, auto-hébergez. Si c'est une ligne dans un questionnaire disant « les données ne doivent pas quitter notre contrôle », allez d'abord lire ce que votre auditeur acceptera avant de signer pour un nœud.
De combien les poids open sont-ils vraiment en retard ?
Quatre mois. C'est le retard mesuré, et c'est le chiffre qui devrait remplacer tout ce que vous croyez actuellement sur le fait que les modèles open sont en retard d'une génération.
Quatre mois et six points d'index
Epoch AI l'a chiffré en suivant la meilleure version open-weight face à la frontière fermée sur l'Epoch Capabilities Index entre le 1er janvier et le 28 mai 2026 : un retard de 4 mois, soit 8 points ECI avec un intervalle de confiance à 90 % de 7 à 11. Artificial Analysis mesure la même chose différemment et aboutit au même endroit. Les leaders open scorent 52 à 54 sur son Intelligence Index contre 60 pour GPT-5.5, un écart de 6 points qui était de 13 points il y a douze mois.
L'écart est donc réel et il se referme. Pour la plupart des charges de travail en production (classification, extraction, résumé, réponses assistées par récupération, premier jet de code), une frontière vieille de quatre mois convient. Pour la queue dure du raisonnement, non, et aucun travail de prompt ne comble 8 points ECI. Choisissez votre charge de travail avant de choisir votre camp. Les versions open-weight suivies dans notre annuaire se renouvellent assez vite pour qu'un modèle que vous avez évalué en mars ne soit pas celui que vous déploieriez aujourd'hui.
L'écart adoption-production qui coûte de l'argent réel aux équipes
Les modèles open perdent sur la mise en production plutôt que sur les capacités. L'enquête 2026 State of Open Source AI (N=1 410) a constaté que 79 % des développeurs IA adoptent des modèles open mais seulement 53 % les mettent en production, contre 71 % d'adoption et 63 % de mise en production pour les modèles fermés. Ils sont plus essayés et moins déployés.
Cet écart de 26 points représente du temps d'ingénierie que vous payez et que vous ne capturez pas dans votre tableur TCO. Et ça empire avec la taille plutôt que de s'améliorer : les taux de mise en production des modèles fermés passent de 54 % dans les petites entreprises à 73 % dans les grandes, tandis que l'open reste presque stable entre 53 % et 57 %. Les organisations avec le plus d'ingénieurs de plateforme sont celles qui abandonnent le plus souvent les déploiements open, ce qui est l'opposé de ce que prédit l'argumentaire de l'auto-hébergement. Budgétisez pour les tentatives qui n'aboutissent pas.
Chemins de migration : ce que le changement implique vraiment
La migration elle-même est peu coûteuse. Ce qui coûte, c'est le travail d'évaluation que vous avez ignoré avant la migration, que vous payez ensuite en incidents de production.
Le changement d'URL de base, et les exceptions documentées qui méritent d'être nommées
vLLM embarque un serveur compatible OpenAI, donc pour une simple complétion de chat, la migration se résume à une URL de base et un alias de modèle. Pointez votre client existant vers votre point de terminaison, changez model de gpt-5-mini vers ce que vous servez, gardez le reste du code. C'est la partie que chaque concurrent traite comme une boîte noire et c'est honnêtement la moitié facile.
Les exceptions sont là où les équipes perdent une semaine. Les sorties structurées et l'application stricte des schémas JSON se comportent différemment selon les piles de service, donc tout ce qui repose sur des arguments de fonction garantis valides doit être testé sur de vrais payloads plutôt que sur un test de fumée. Les appels d'outils parallèles sont un écart courant. La mise en cache des prompts est spécifique au fournisseur, et si votre modèle de coût supposait des tarifs d'entrée mis en cache du côté SaaS, cette remise ne vous suit pas. Le comportement long-contexte se dégrade à des points différents de ce qu'annonce la fenêtre de contexte, et les tokeniseurs diffèrent aussi, ce qui signifie que vos budgets basés sur le nombre de tokens et votre logique de troncature doivent tous deux être recalibrés.
Construisez le harnais d'évaluation avant la bascule, pas après
Si vous ne pouvez pas mesurer la qualité sur votre propre trafic, vous ne pouvez pas savoir si un retard de capacité de quatre mois est important pour votre cas d'usage ou non. Capturez quelques centaines de vraies requêtes de production avec leurs sorties, notez-les selon les critères de votre activité, puis faites tourner le modèle open candidat sur le même ensemble. Faites ça avant de provisionner un GPU.
- Enregistrez 200 à 500 vraies requêtes avec réponses et tout signal aval que vous suivez déjà (pouces, modifications, réessais, escalades).
- Notez la sortie SaaS en place pour établir votre référence. Vous avez besoin du chiffre que vous défendez, pas d'une impression.
- Faites tourner le candidat open-weight via une API d'abord, car DeepInfra sert Llama-3.3-70B à 0,10 $ entrée / 0,32 $ sortie par million de tokens (DeepInfra) et ne vous coûte rien en infrastructure pour tester.
- Seulement si la qualité tient et que le volume le justifie, passez à la capacité dédiée.
La valeur par défaut hybride : router par classe de requête plutôt que remplacer en bloc
Divisez le trafic selon ce que vaut chaque requête. Classification, extraction, résumé et reformulation de récupération fonctionnent bien sur un modèle 8B à 0,02 $/0,04 $ par million de tokens (DeepInfra), et la queue dure du raisonnement va sur Sonnet 5 à 2 $/10 $ (Anthropic). Si 80 % de vos appels appartiennent à la classe bon marché, vous avez réduit l'essentiel de la facture sans miser la qualité sur un seul modèle.
Le routage vous donne aussi un chemin de secours, ce qu'un remplacement en bloc ne permet pas. Les piles de service et les routeurs représentent une bonne partie des 128 frameworks IA dans notre annuaire, et les dépôts IA open source par où commencer sont ceux avec une surface compatible OpenAI, car c'est ce qui réduit votre rollback à un seul changement de configuration.
Qui devrait changer en 2026 — et qui ne devrait pas
Trois profils ont l'arithmétique de leur côté. Trois ne l'ont pas, et aucun enthousiasme de votre équipe de plateforme ne corrige ça.
Trois profils où l'auto-hébergement gagne clairement
Transcription à volume élevé et charge constante. Si vous traitez plus de quelques milliers d'heures audio par mois via un pipeline qui tourne sur un calendrier, vous pouvez garder une carte occupée et battre le plancher de 0,15 $/heure d'AssemblyAI (AssemblyAI). Le travail par lots est la forme idéale ici car vous contrôlez quand la file se vide, ce qui fait de l'alimentation de la carte un problème de planification plutôt qu'un espoir.
Données réglementées qui ne peuvent pas quitter votre périmètre, où l'exigence est contractuelle plutôt qu'une préférence. L'optimisation des coûts n'est pas l'objectif dans ce cas. Vous achetez une réponse d'audit, et la facture GPU est son prix.
Cinquante développeurs et plus sur des assistants de codage à facturation à l'usage. À environ 50 développeurs, la facture avoisine 110 000 $ par mois face à un nœud que vous pouvez garder saturé, soit une prime de 3 à 9x, et à ~100 développeurs (~220 000 $/mois) le matériel en propriété est amorti en environ un an (DoiT).
Trois où ça perd sur l'arithmétique seule
Les équipes de moins d'une dizaine de développeurs. À ~22 000 $/mois la facture d'assistant est à égalité avec un nœud que ces 10 personnes ne peuvent pas garder occupé (DoiT), et une égalité ne vaut pas une rotation d'astreinte.
Quiconque a une charge de travail de trafic consommateur en rafale. Les GPU inactifs sont facturés à plein tarif, et une courbe diurne irrégulière signifie que vous payez pour le pic en ne l'utilisant qu'à environ 20 % en moyenne. Les APIs de modèles open serverless écrasent ce profil.
Les équipes dont le niveau de qualité se situe à la frontière. Si vos évaluations ne passent qu'avec Fable 5.1 à 10 $/50 $ par million de tokens (Anthropic), un modèle open auto-hébergé est un produit différent à un niveau de qualité différent, et les économies vous achètent une rétrogradation.
Le test de 90 jours à effectuer avant d'engager du capital
- Semaines 1–2 : instrumentez la concurrence, pas les dépenses. Enregistrez les requêtes en cours par minute et trouvez votre p95. Si c'est inférieur à 4, arrêtez-vous ici.
- Semaines 3–6 : pointez 10 % du trafic vers les points de terminaison open-weights de DeepInfra et exécutez votre suite d'évaluation existante. C'est un changement d'URL de base et un alias de modèle pour la plupart des piles.
- Semaines 7–12 : louez, n'achetez pas. Un H100 à 2,20 $/h dédié (DeepInfra) vous donne un vrai chiffre d'utilisation pour moins de 1 700 $ par mois, et c'est le chiffre que votre DAF vous demandera.
Si la carte reste inactive plus de 60 % du temps à la fin de ça, la réponse est l'API open-weights gérée, et vous avez passé un trimestre à l'apprendre plutôt que trois ans à l'amortir.
Questions fréquemment posées
L'auto-hébergement de l'IA open source est-il vraiment moins cher que les sièges ChatGPT Business ou Claude Team ?
Aux prix catalogue des sièges, non. Claude Team coûte 20 $ par siège par mois avec facturation annuelle (25 $ mensuel), avec des sièges premium à 100 $/125 $, et Enterprise est à 20 $ par siège annuellement plus l'usage aux tarifs API (tarification Anthropic). Aucun GPU loué n'approche 20 $ par tête, donc les abonnements à tarif fixe sont ce qui est le plus difficile à battre avec votre propre matériel en IA. L'auto-hébergement commence à être compétitif uniquement quand votre équipe est sur une facturation à l'usage, où les ingénieurs de DoiT dépensent en moyenne environ 2 200 $ par développeur par mois (DoiT).
À quel niveau de dépenses mensuelles l'auto-hébergement d'un LLM atteint-il le seuil de rentabilité en 2026 ?
Environ 15 000 à 25 000 $ par mois de dépenses API à l'usage, ce qui à raison de 2 200 $ par développeur par mois observés par DoiT correspond à environ 7 à 12 postes intensifs (DoiT). Le chiffre bouge plus avec votre fournisseur cloud qu'avec votre modèle : le même nœud 8xH100 pour un mois de 730 heures coûte environ 12 600 $ sur Nebius spot, 22 500 $ sur Nebius à la demande, 40 200 $ sur AWS, et 71 800 $ sur Azure (DoiT). L'effectif est de toute façon la mauvaise unité. Seulement 10 à 20 % d'une équipe de développeurs a une requête en cours à tout moment, donc dix développeurs représentent deux ou trois sessions simultanées, au mieux la moitié de la capacité d'un nœud (DoiT).
De combien d'heures GPU ai-je besoin pour battre les 0,36 $ par heure audio de l'API Whisper ?
Le débit tranche la question, et les heures n'ont d'importance qu'à travers le tarif auquel elles sont facturées. OpenAI facture 0,006 $/minute pour Whisper et gpt-4o-transcribe, soit 0,36 $ par heure audio, et 0,003 $/minute (0,18 $/heure) pour gpt-4o-mini-transcribe (OpenAI). Sur un RunPod L40S 48GB à 0,79 $/h Community Cloud (RunPod), il faut un débit mieux que 2,2x le temps réel pour battre 0,36 $, environ 4,4x pour battre le niveau mini, et environ 5,3x pour battre le tarif de 0,15 $/heure Universal-2 d'AssemblyAI (AssemblyAI). Le temps d'inactivité du GPU compte contre vous, donc le déploiement ne gagne qu'avec une file continue plutôt qu'un trafic diurne en rafale.
L'IA open source est-elle libre d'utilisation commerciale ?
Non, et ce sont les modèles d'images où les équipes se font piéger. Il est rapporté que les poids FLUX.1 [dev] comportent une licence non commerciale, ce qui placerait une licence Black Forest Labs payante entre vous et un déploiement commercial, donc lisez les conditions avant de les inclure dans vos plans. Même avec des poids entièrement permissifs, le calcul n'est pas gratuit : DeepInfra sert Llama-3.3-70B-Instruct-Turbo à 0,10 $ entrée et 0,32 $ sortie par million de tokens, et Meta-Llama-3.1-8B à 0,02 $/0,04 $ (DeepInfra), ce qui est moins cher que ce que la plupart des équipes peuvent faire tourner les mêmes poids sur un H100 dédié à 2,20 $/h.
Dois-je auto-héberger pour être conforme au RGPD et au règlement européen sur l'IA ?
Non. La conformité concerne la localisation des données, les accords de traitement et la documentation, rien de tout ça n'exige que vous possédiez la pile d'inférence. Les enjeux sont réels (les régulateurs ont émis 7,1 milliards d'euros en 2 245 amendes RGPD jusqu'au début 2026, et l'exposition atteint 4 % du chiffre d'affaires mondial sous le RGPD plus jusqu'à 7 % sous le règlement sur l'IA, selon Kiteworks), mais les options d'hébergement géré et souverain en région UE couvrent désormais la plupart de ce qu'un responsable de la protection des données demande. Auto-hébergez quand un contrat ou un régulateur interdit spécifiquement le traitement par un tiers, pas comme couverture générale.
Devrais-je acheter ou louer des GPU pendant la pénurie de mémoire de 2026 ?
Louez, sauf si vous avez une charge de travail pluriannuelle qui maintient les cartes occupées. La RTX PRO 6000 Blackwell 96GB de NVIDIA est passée d'un prix catalogue revendeur de 8 565 $ début 2025 à 13 250 $ en juin 2026 et 16 000 $ en août 2026, soit environ 87 % de plus pour un produit inchangé (igor'sLAB). La cause est la mémoire : la HBM représente désormais environ 23 % de la capacité mondiale de wafers DRAM contre 8 % en 2024, et les prix des DDR5 ECC RDIMM serveur ont augmenté d'environ 100 à 116 % entre le T1 2025 et le T1 2026 (DataCenterDisk). Goldman Sachs a prévu un déficit mondial de DRAM de 4,9 % pour 2026, le pire en 15 ans, avec un rétablissement peu probable avant fin 2027 (Wccftech), donc prévoyez des prix d'achat élevés et profitez de l'écart du marché locatif, de 2,20 $/h pour un H100 dédié sur DeepInfra à 4,29 $/h sur Lambda.