

Vos sorties sont médiocres parce que vos entrées sont surchargées, périmées ou mal ordonnées. Pas parce que vous avez mal formulé votre invite. La documentation officielle d'Anthropic le dit sans détour : « plus de contexte n'est pas automatiquement mieux. À mesure que le nombre de tokens augmente, la précision et le rappel se dégradent, un phénomène connu sous le nom de context rot » (Claude Platform docs). L'ingénierie du contexte est la solution, et Anthropic la définit comme la sélection de « l'ensemble optimal de tokens (informations) lors de l'inférence LLM » (Anthropic Engineering).
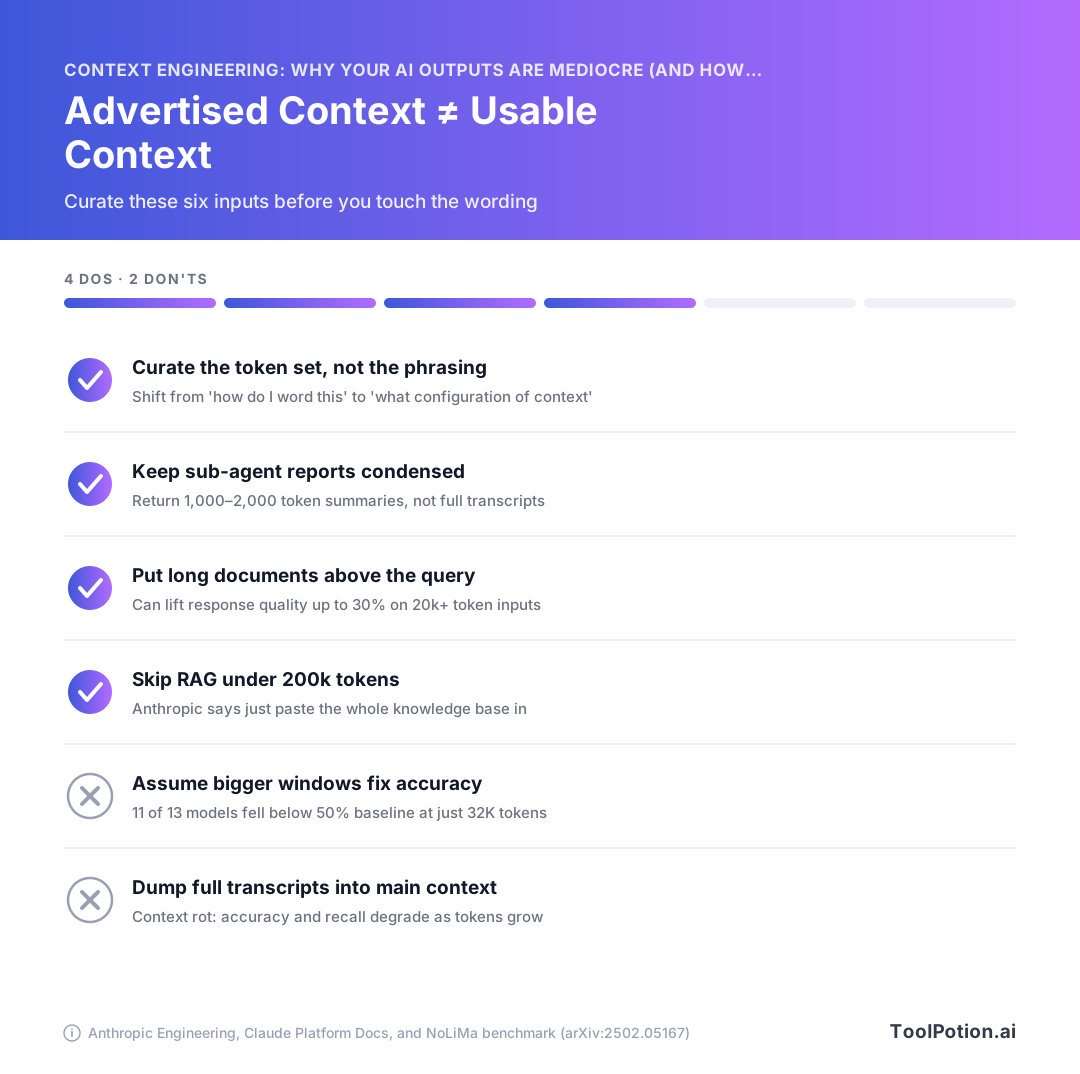
Les chiffres sont impitoyables pour l'habitude maximaliste. Sur NoLiMa, 11 des 13 modèles qui annoncent tous plus de 128K de contexte sont tombés en dessous de la moitié de leur score en contexte court dès 32K tokens (arXiv:2502.05167).
Ceci est un guide pratique pour les personnes qui utilisent ChatGPT, Claude, Gemini et Copilot plutôt que de construire des frameworks d'agents : quel réglage ajuster, dans quel produit, et ce que ça vaut.
L'ingénierie du contexte a remplacé la magie des invites
Si vos sorties sont médiocres, la formulation de votre invite est rarement le problème. L'ingénierie du contexte est la pratique qui y remédie : Anthropic la définit comme « l'ensemble des stratégies pour sélectionner et maintenir l'ensemble optimal de tokens (informations) lors de l'inférence LLM, y compris toutes les autres informations susceptibles de s'y trouver en dehors des invites », et la présente comme la progression naturelle de l'ingénierie des invites (Anthropic Engineering). La question est passée de « comment formuler cela ? » à « quelle configuration de contexte est la plus susceptible de produire le comportement désiré du modèle ? »
De « comment formuler cela ? » à « que faut-il mettre dans la fenêtre ? »
La formulation compte encore à la marge. Elle a simplement cessé d'être là où se trouve l'effet de levier. Une question parfaitement formulée face à une fenêtre surchargée et peu pertinente perd face à une question directe dans une fenêtre propre — et la suite de cet article en est largement la démonstration.
La plupart des 212 outils d'ingénierie des invites que nous répertorions optimisent la phrase que vous tapez. Presque aucun ne touche aux cinq autres éléments qui partagent la fenêtre avec elle.
Les cinq entrées que vous contrôlez vraiment
Chaque requête assemble une fenêtre à partir de parties que vous pouvez voir et modifier :
- Les instructions système, qu'il s'agisse du champ d'instructions d'un GPT personnalisé, de la description d'un Projet Claude, ou d'un fichier CLAUDE.md dans votre dépôt.
- La mémoire : ce que le produit a enregistré sur vous entre les sessions, généralement sans vous montrer le texte complet.
- Les documents attachés et leur qualité d'extraction, qui est la variable la plus sous-estimée de toute la pile.
- Les chunks récupérés, si l'outil fait de la récupération, ainsi que ce que le moteur de récupération a jugé pertinent.
- Les tours précédents de la conversation, y compris chaque impasse abandonnée vingt messages plus tôt.
- Les définitions d'outils, qui coûtent des tokens qu'un outil soit appelé ou non.
Ça fait six, et vous les contrôlez tous depuis l'interface du produit. Sans framework, sans clé API.
C'est donc un guide centré sur les entrées, écrit pour les personnes qui utilisent ChatGPT, Claude, Gemini et Copilot plutôt que de construire des systèmes d'agents par-dessus. Quel réglage ajuster, dans quel produit, et ce que les chiffres 2026 disent que ça vaut.
Fenêtre de contexte IA : taille annoncée vs taille utilisable
Le chiffre sur la fiche technique est une limite de stockage, pas une garantie de performance. Un modèle qui accepte un million de tokens les acceptera volontiers — puis répondra moins bien qu'avec 3 000. Considérez la fenêtre annoncée comme le plafond d'une pièce, pas comme la surface du bureau sur lequel vous travaillez.
Ce qui compte vraiment dans la fenêtre
Plus que vous ne le pensez. Chaque partie d'une requête API occupe le même budget : le système d'invite, chaque message du fil y compris les résultats d'outils, les images et les PDF, les définitions d'outils elles-mêmes, et la sortie propre du modèle incluant le raisonnement étendu (Claude Platform docs). Les préfixes mis en cache occupent également la fenêtre. La mise en cache des invites modifie ce que vous payez pour ces tokens, pas s'ils comptent.
Ainsi, une conversation qui paraît courte peut transporter 40 000 tokens de PDF attaché, de schémas d'outils et de raisonnement préalable que vous ne voyez jamais. C'est ce que les pages encyclopédiques omettent.
La falaise des 32K que personne ne met sur la fiche technique
Le benchmark NoLiMa a éliminé les chevauchements littéraux de mots entre la question et la réponse enfouie dans la botte de foin, puis a testé 13 modèles qui revendiquent tous 128K de contexte ou plus. En dessous de 1K tokens, ils s'en sortaient bien. À 32K, 11 des 13 étaient tombés en dessous de la moitié de leur propre référence en contexte court, et Llama 3.1 70B est passé de 94,3 % à 42,7 % (NoLiMa, arXiv:2502.05167). Ce preprint date de février 2025, antérieur à tous les modèles du tableau ci-dessous. La nature du résultat a été confirmée par des travaux plus récents, mais les pourcentages spécifiques sont des preuves vieillissantes, pas un classement actuel.
Ce que valent vraiment les fenêtres actuelles (chiffres 2026)
| Modèle | Fenêtre de contexte | Sortie maximale | Images/pages PDF par requête |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (et Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M tokens, par défaut, tarification standard | 128k | 600 |
| Claude Sonnet 4.5 et versions antérieures | 200k | — | 100 |
| OpenAI GPT-5.4 | 1 050 000 tokens | 128 000 | — |
Anthropic livre cette fenêtre de 1M sans en-tête bêta ni supplément (Claude Platform docs). Celle d'OpenAI est nominalement plus grande et tarifée différemment : dépassez 272K tokens d'entrée sur GPT-5.4 et toute la session est facturée à 2x l'entrée et 1,5x la sortie (OpenAI API docs). La surcharge y est une ligne de facturation, pas seulement une pénalité de qualité.
Si vous comparez les capacités entre fournisseurs, consultez la page de spécifications du modèle plutôt qu'un comparatif : les fenêtres ont changé deux fois en 2026 à elles seules, et les tableaux périmés sont partout. Notre répertoire de 324 modèles IA est un point de départ pour trouver la bonne page.
La dégradation du contexte : pourquoi en ajouter plus détériore généralement les sorties
La dégradation a un mécanisme, et il n'est pas mystérieux. Un transformer doit modéliser n² relations par paires sur n tokens, donc chaque token ajouté fait concurrencer un peu plus chaque autre token pour l'attention du modèle. L'équipe d'ingénierie d'Anthropic appelle cela un budget d'attention fini, analogue à la mémoire de travail humaine, et dit que l'attention devient « étalée trop mince » à mesure que le contexte grandit. Leur prescription est directe : trouver « le plus petit ensemble possible de tokens à fort signal qui maximise la probabilité d'un résultat souhaité ».
Le problème du budget d'attention
La documentation officielle d'Anthropic concède le point plutôt que de le minimiser. « Plus de contexte n'est pas automatiquement mieux », indique la documentation de la plateforme. « À mesure que le nombre de tokens augmente, la précision et le rappel se dégradent, un phénomène connu sous le nom de context rot. » C'est le fournisseur qui vous vend une fenêtre de 1M tokens qui vous dit de ne pas la remplir.
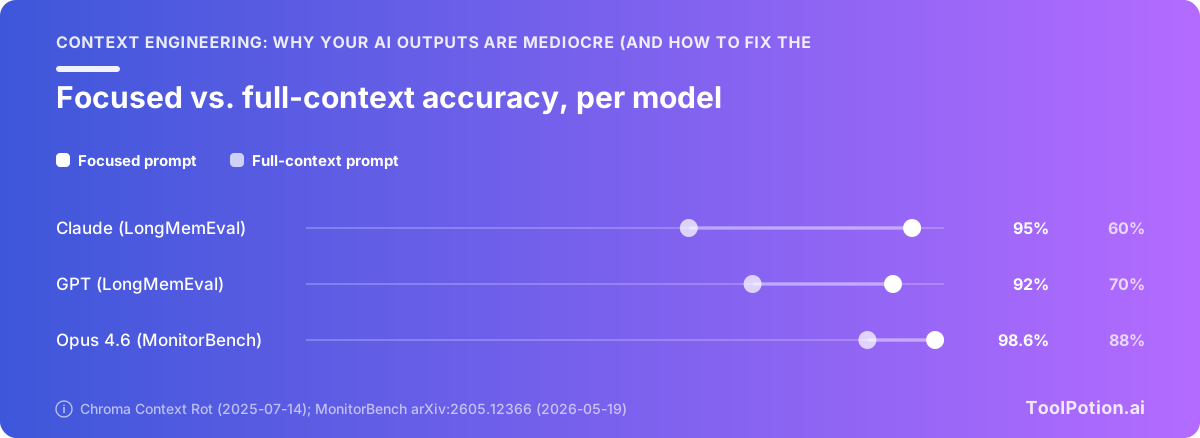
Même question, même réponse, 375 fois plus de bruit
Chroma a testé 18 modèles, dont GPT-4.1, Claude 4, Gemini 2.5 et Qwen3, et a constaté que la fiabilité diminue avec des entrées plus longues même sur des tâches triviales comme la récupération et la réplication de mots (Chroma). L'exécution LongMemEval est celle à retenir. Chaque famille de modèles a obtenu de bien meilleurs résultats sur des invites ciblées d'environ 300 tokens contenant uniquement les tours pertinents que sur des invites complètes d'environ 113k tokens portant l'intégralité de l'historique de conversation, les modèles Claude affichant le plus grand écart. Même question. Même réponse présente dans le contexte dans les deux cas. La seule variable était la quantité de matière non pertinente qui l'entourait.
Chroma a également constaté que les modèles obtenaient de meilleurs scores sur des bottes de foin mélangées que sur des documents logiquement cohérents, et ce pour l'ensemble des 18. Un texte environnant cohérent offre au modèle davantage d'endroits plausibles où atterrir. Ce rapport a été publié le 14 juillet 2025, il a donc plus d'un an et est antérieur à la génération de modèles actuelle.
L'effet n'a pas disparu. Sur MonitorBench, l'ajout de 800K tokens d'actions bénignes et non pertinentes en préfixe a fait chuter le rappel d'Opus 4.6 de 98,6 % à 88 % (arXiv:2605.12366). La tâche n'avait en rien changé. Seul le rembourrage avait changé.
Là où ça vous affecte dans un usage normal
Vous l'avez déjà vécu sans le nommer. La conversation qui a parfaitement cerné votre brief au message 12 et qui produit du remplissage générique au message 90, parce que le brief est désormais enfoui sous 78 messages d'ébauches à moitié abandonnées. Le notebook NotebookLM dans lequel vous avez ajouté 40 sources par souci d'exhaustivité et où vous obtenez des réponses plus vagues qu'avec huit. La session de codage où le modèle oublie une contrainte énoncée une heure plus tôt et la réécrit avec assurance autour d'elle.
Rien de tout cela n'est le modèle qui devient paresseux. C'est vous qui dépensez le budget d'attention sur des tokens qui ne méritent pas leur place.
Préparation des documents : l'étape que presque tout le monde saute
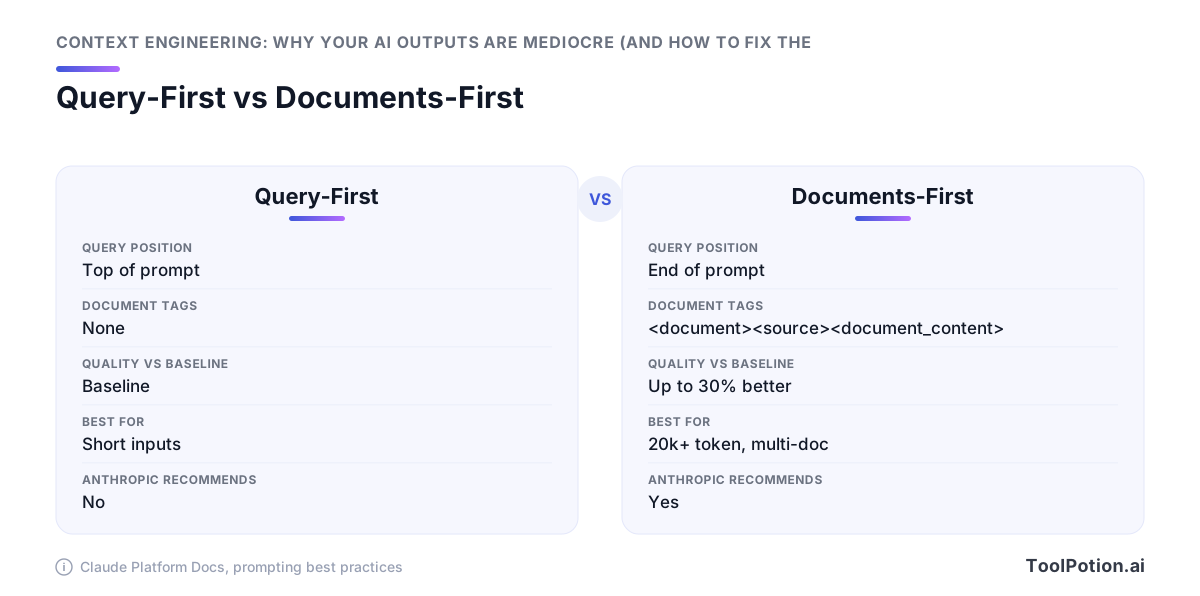
L'endroit où vous placez un document dans l'invite change la réponse que vous obtenez. Pour des entrées de plus de 20 000 tokens, la documentation d'invite d'Anthropic vous demande de placer les données longues en haut, au-dessus de votre requête, de vos instructions et de vos exemples : « placer les requêtes à la fin peut améliorer la qualité des réponses jusqu'à 30 % dans les tests, en particulier avec des entrées complexes à plusieurs documents » (Claude Platform docs). La plupart des gens font l'inverse. Ils tapent la question, puis collent le rapport en dessous.
Mettez les éléments longs en haut
La même documentation vous donne un gabarit qui vaut la peine d'être copié mot pour mot : enveloppez chaque document dans des balises <document> avec des sous-balises <source> et <document_content>, afin que le modèle puisse distinguer où un fichier se termine et où le suivant commence (Claude Platform docs). Demandez-lui ensuite de citer les passages pertinents avant de répondre. Cette seule ligne force le modèle à localiser des preuves dans le texte plutôt qu'à les reconstruire à partir de ce qu'il se rappelle à moitié, et elle vous donne quelque chose de vérifiable quand la réponse semble incorrecte.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
Balisez vos sources pour que le modèle puisse les citer
Une mise en garde avant de standardiser ceci : les fournisseurs ne sont pas d'accord. Anthropic place les données longues en premier ; les recommandations de Google font l'inverse, vous demandant de clore avec vos instructions. Ainsi, un gabarit d'invite repris d'un tutoriel Gemini et collé dans Claude peut sous-performer sans jamais paraître cassé. Exécutez le même jeu de documents dans les deux sens sur le modèle que vous payez réellement, dix questions chacun, et gardez l'ordre qui gagne. C'est vingt minutes de travail pour un gain potentiel revendiqué de 30 %.
Le choix du parseur décide de ce que le modèle voit réellement
Rien de tout cela ne sauve une extraction manquée. Une table de facture numérisée qui ressort en une seule ligne continue, un article en deux colonnes entrelacé ligne par ligne, une note de bas de page insérée en milieu de phrase : le modèle lit fidèlement ces données corrompues et y répond. Votre étape d'extraction fixe le plafond de précision, et tout ce qui suit en est limité. Traitez le parseur comme une décision de qualité et testez-en deux ou trois sur votre fichier réel le plus difficile avant de vous engager. Notre répertoire liste 217 outils IA de traitement de documents et PDF, et l'écart entre les bons et les mauvais se voit dans vos sorties, pas dans leurs pages marketing.
Hygiène de récupération : moins de chunks, mais meilleurs, l'emportent sur plus de chunks
Avant de construire une couche de récupération, vérifiez si vous en avez besoin. Les recommandations d'Anthropic elles-mêmes indiquent que si votre base de connaissances fait moins de 200 000 tokens (environ 500 pages), vous pouvez simplement inclure l'intégralité dans l'invite sans aucune récupération (Anthropic Engineering). La plupart des wikis internes, manuels produits et ensembles de politiques rentrent sous cette limite.
Avez-vous vraiment besoin de récupération ?
Si votre corpus rentre, évitez la base de données vectorielle. Vous éviterez les décisions de chunking, la dérive des embeddings et toute une classe de défaillances silencieuses où le bon paragraphe n'arrive jamais dans l'invite. Associez cela à la mise en cache des invites pour ne pas payer le plein tarif pour les mêmes 200k tokens à chaque appel.
Au-delà de cette taille, la récupération cesse d'être optionnelle et la qualité devient une pile de petites corrections qui se composent.
Les trois corrections qui se composent
Anthropic les a benchmarkées une par une. Ajouter en préfixe un contexte spécifique au chunk avant l'embedding a réduit les échecs de récupération top-20 de 5,7 % à 3,7 %, soit une réduction d'environ 35 %. L'ajout d'une recherche hybride BM25 contextuelle a ramené les échecs à 2,9 %, une réduction de 49 %. L'ajout d'un passage de reranking par-dessus a porté le résultat à 1,9 %, une réduction totale de 67 % (Anthropic Engineering). Chaque étape est peu spectaculaire prise isolément, et les trois ensemble triplent à peu près l'amélioration obtenue par la première.
Réduire les définitions d'outils compte aussi
Les schémas d'outils sont du contexte. Si vous donnez à un modèle quarante définitions d'outils et qu'il en a besoin de deux, vous avez payé pour trente-huit distracteurs. Le travail RAG-MCP ne récupère que les schémas pertinents au lieu de les lister tous et a réduit les tokens d'invite de plus de moitié, tandis que la précision de sélection des outils est passée de 13,62 % à 43,13 % (arXiv:2505.03275). C'est la même discipline que la sélection de chunks, appliquée une couche plus haut.
Le pattern de sous-agents d'Anthropic l'étend encore : des agents spécialisés effectuent le travail de recherche et retournent des résumés condensés d'environ 1 000 à 2 000 tokens à un agent coordinateur, de sorte que le contexte principal ne voit jamais les transcriptions brutes de recherche (Anthropic Engineering). Si vous choisissez des composants plutôt que de les écrire, notre répertoire liste 550 agents IA et un ensemble de frameworks de récupération et d'agents qui implémentent ces patterns prêts à l'emploi.
Fonctionnalités mémoire : quel réglage ajuster dans chaque outil
Chaque produit IA grand public injecte désormais des éléments dans votre contexte que vous n'avez pas tapés. Faits enregistrés, conversations précédentes, activité des applications, fichiers de projet téléversés. Vous ne pouvez pas faire d'ingénierie du contexte dans une appli de chat sans savoir ce qui est déjà dans la fenêtre avant votre premier mot.
Une mauvaise mémoire coûte plus cher qu'aucune mémoire. C'est un texte d'apparence très significative que le modèle traite comme un fait, et il se place près de vos instructions là où l'attention est la plus forte. Des titres de poste périmés, un ancien nom de client, une préférence définie une fois pour une tâche ponctuelle : chacun biaise silencieusement toutes les réponses qui suivent.
ChatGPT : deux bascules indépendantes
La mémoire de ChatGPT repose sur deux mécanismes, pas un. Les souvenirs enregistrés sont des faits stockés discrets que vous pouvez lire et supprimer individuellement, tandis que la référence à l'historique des conversations pioche dans vos conversations précédentes via un chemin de récupération séparé (Embrace The Red). Désactiver l'un laisse l'autre actif. Si vos sorties sentent encore le projet du mois dernier après que vous avez effacé les souvenirs enregistrés, c'est la bascule d'historique que vous avez manquée.
Claude : connaissance de projet et écriture de mémoire en cours de conversation
Depuis l'unification Cowork du 25 août 2026, Claude écrit des mémoires en cours de conversation plutôt qu'uniquement aux limites de session, donc ce que vous dites dans le chat se retrouve dans les sessions ultérieures (TechCrunch). Cela signifie qu'un aparté informel peut devenir un contexte durable.
La connaissance de projet est le meilleur levier, car c'est un corpus que vous avez choisi. Gardez-la sous la règle empirique des 200 000 tokens d'Anthropic (environ 500 pages) et elle peut être embarquée en entier sans qu'une couche de récupération doive deviner quels chunks importent (Anthropic). Élagez-la comme une liste de lecture, pas comme une archive.
Gemini : trois systèmes superposés où « désactiver » ne signifie pas « supprimer »
Gemini superpose le contexte personnel, les informations enregistrées que vous avez vous-même saisies, et l'activité des applications Google connectées. Désactiver une source arrête les nouvelles écritures. Cela ne supprime pas ce qui est déjà stocké, donc un audit signifie visiter chaque contrôle séparément et supprimer, pas simplement tout désactiver.
NotebookLM : l'alternative à sources limitées
NotebookLM plafonne le nombre de sources qu'un notebook peut contenir, et ce plafond joue en votre faveur. Il impose la sélection que les trois autres vous permettent d'éviter, ce qui correspond à la même discipline qu'Anthropic prescrit : trouver le plus petit ensemble de tokens à fort signal qui produit le résultat souhaité (Anthropic). Quand une question nécessite huit documents et non quatre-vingts, commencez par là.
Choisissez un seul outil comme assistant porteur de mémoire et gardez les autres propres. Parmi les 13 174 applis IA de notre répertoire, celles qui rendent la mémoire auditable par élément valent plus que celles qui promettent de tout retenir.
Les instructions au niveau projet sont un contexte réutilisable
Le contexte le moins coûteux que vous écrirez jamais est celui que vous écrivez une seule fois. Chaque outil IA sérieux dispose désormais d'un emplacement pour des instructions permanentes injectées dans chaque session : AGENTS.md et CLAUDE.md dans un dépôt, Claude Projects, les instructions personnalisées de ChatGPT, les fichiers d'instructions Copilot. La plupart des gens laissent ces emplacements vides et retapent ensuite les mêmes trois paragraphes de contexte dans chaque nouveau chat.
Pourquoi un fichier d'instructions permanent est préférable à réexpliquer
Une étude portant sur 10 dépôts et 124 pull requests a mesuré ce qu'un fichier AGENTS.md au niveau du dépôt fait au comportement d'un agent, et le résultat n'est pas seulement une question de correction. Le temps d'exécution médian a chuté de 28,64 %, passant de 98,57 secondes à 70,34 secondes, et les tokens de sortie ont baissé de 16,58 % à des taux de complétion comparables (arXiv:2601.20404). L'agent a cessé d'explorer pour découvrir des choses que vous saviez déjà.
C'est l'argument en une phrase. Un bon contexte permanent rend le modèle plus rapide et moins coûteux, pas seulement plus précis, parce que la plupart de ce qu'un agent brûle en tokens consiste à redécouvrir vos conventions. Si vous choisissez parmi les 260 assistants de codage IA de notre répertoire, le fait que l'outil lise un fichier d'instructions de projet est un meilleur filtre que la plupart des comparaisons de fonctionnalités.
Ce qui mérite vraiment d'y figurer
Gardez-le assez court pour que vous le lisiez vous-même. Cinq choses méritent leur place :
- Les conventions que le code n'annonce pas, comme quel test runner est réel et lequel est mort.
- Votre vocabulaire. Si « compte » et « tenant » signifient des choses différentes ici, dites-le une fois.
- La forme de sortie voulue, dans le format souhaité (un diff, un tableau, cinq bullets).
- Une courte liste d'interdictions. Ne touchez pas aux fichiers générés, n'ajoutez pas de dépendances sans demander.
- Où se trouve la source de vérité, pour que le modèle l'interroge plutôt que de la deviner.
Laissez de côté tout ce que l'outil peut lire par lui-même. Arborescences de répertoires, listes de fichiers, signatures de fonctions reformulées, un résumé de votre README. Ce sont des tokens dépensés à dupliquer quelque chose que l'agent peut récupérer en un seul appel, et ils concurrencent pour l'attention les instructions qui comptent. Réécrivez le fichier quand il commence à être ignoré, ce qui signifie généralement qu'il est devenu trop long.
La surcharge de contexte a un prix
Un contexte négligé coûte de l'argent sur la facture, pas seulement de la qualité dans la sortie. Deux mécanismes de tarification le rendent concret, et tous deux récompensent la même discipline : un préfixe petit, stable et ordonné.
La fonction en escalier à 272K sur GPT-5.4
GPT-5.4 d'OpenAI propose une fenêtre de contexte de 1 050 000 tokens avec jusqu'à 128 000 tokens de sortie, mais les invites dépassant 272K tokens d'entrée sont « tarifées à 2x l'entrée et 1,5x la sortie pour la session complète » (OpenAI API docs). Lisez cela attentivement. Franchir la ligne une fois ne vous coûte pas un peu plus sur le dépassement. Cela retarifie toute la session, sortie comprise, donc un seul collé imprudent d'un dump de 300K tokens double votre facture d'entrée pour chaque tour qui suit.
Vous payez double pour les tokens les plus susceptibles de dégrader votre réponse.
La mise en cache récompense un préfixe stable
L'API Claude facture les lectures de cache à 0,1x l'entrée de base, soit une réduction de 90 %, tandis que les écritures de cache coûtent 1,25x pour le TTL de 5 minutes ou 2x pour le TTL d'une heure (Claude Platform docs). Leur exemple chiffré : 100k tokens réutilisés dix fois reviennent à 1,075 $ contre 5,00 $ sans cache, soit une économie de 78,5 %.
Cette réduction ne s'applique que si le préfixe correspond octet par octet. La mise en cache repose sur un préfixe exact, donc si vous réordonnez vos documents, insérez un horodatage dans le système d'invite, ou mélangez les définitions d'outils entre les tours, vous payez à nouveau le prix d'écriture plutôt que le prix de lecture. L'habitude qui maintient le cache chaud est la même que celle qui maintient le rappel élevé : placez le matériel stable en premier dans un ordre fixe, et laissez uniquement la requête changer à la fin.
Un audit de contexte que vous pouvez faire cette semaine
Rien ici ne nécessite une clé API ou un ticket d'ingénierie. Chaque élément est un réglage que vous avez déjà.
Six vérifications avant votre prochaine longue session
- Ouvrez un nouveau chat plutôt que de prolonger celui d'hier. Les invites ciblées de Chroma (~300 tokens de tours pertinents) l'emportent sur les historiques complets de 113k tokens pour chaque famille de modèles testée, Claude affichant le plus grand écart (Chroma).
- Lisez vos souvenirs enregistrés et supprimez les périmés. Les faits enregistrés sont injectés qu'ils aident ou non.
- Attachez trois bons documents plutôt que douze médiocres, et enveloppez chacun dans des balises
<document>avec une sous-balise<source>pour que le modèle puisse les distinguer (Claude docs). - Placez le matériel long au-dessus de votre question. Sur des entrées de plus de 20k tokens, cet ordre vaut jusqu'à 30 % de meilleures réponses dans les tests d'Anthropic (Claude docs).
- Écrivez les instructions permanentes une seule fois. Un AGENTS.md au niveau du dépôt a réduit le temps d'exécution médian de 28,64 % et les tokens de sortie de 16,58 % sur 124 PRs (arXiv).
- Gardez ce préfixe identique d'un tour à l'autre. Les préfixes stables atteignent le cache à 0,1x le prix d'entrée (Claude docs).
L'unique habitude qui corrige la plupart des mauvaises sorties
Avant de réécrire l'invite, regardez ce qui est déjà dans la fenêtre et retirez-en quelque chose. La documentation d'Anthropic le dit elle-même : « plus de contexte n'est pas automatiquement mieux » (Claude docs). Changez ce que vous donnez au modèle avant de changer comment vous le lui demandez.
Foire aux questions
Qu'est-ce que l'ingénierie du contexte, et en quoi diffère-t-elle de l'ingénierie des invites ?
Anthropic définit l'ingénierie du contexte comme « l'ensemble des stratégies pour sélectionner et maintenir l'ensemble optimal de tokens (informations) lors de l'inférence LLM, y compris toutes les autres informations susceptibles de s'y trouver en dehors des invites » (Anthropic Engineering). L'ingénierie des invites demande comment formuler une requête. L'ingénierie du contexte demande quelle configuration de contexte est la plus susceptible de produire le comportement souhaité, et elle couvre tout ce qui occupe la fenêtre : le système d'invite, chaque message y compris les résultats d'outils, les images et les PDF, les définitions d'outils elles-mêmes, et la sortie propre du modèle incluant le raisonnement étendu (Claude Platform docs). Anthropic la présente comme la progression naturelle de l'ingénierie des invites plutôt que comme un remplacement.
Une fenêtre de contexte plus grande signifie-t-elle toujours une meilleure sortie IA ?
Non. Le contexte annoncé et le contexte utilisable sont deux chiffres différents : le benchmark NoLiMa a testé 13 modèles qui revendiquent tous 128K de support ou plus, et à 32K tokens 11 des 13 ont obtenu un score inférieur à la moitié de leur propre référence en contexte court, Llama 3.1 70B passant de 94,3 % à 42,7 % (arXiv:2502.05167, février 2025). La documentation officielle d'Anthropic le dit clairement : « plus de contexte n'est pas automatiquement mieux. À mesure que le nombre de tokens augmente, la précision et le rappel se dégradent » (Claude Platform docs). Remplir la fenêtre coûte également de l'argent par paliers plutôt qu'en ligne droite, puisqu'OpenAI facture les invites GPT-5.4 dépassant 272K tokens d'entrée à 2x l'entrée et 1,5x la sortie pour la session complète (OpenAI API docs).
Qu'est-ce que la dégradation du contexte et comment l'éviter ?
La dégradation du contexte (context rot) est la détérioration de la précision et du rappel à mesure que le nombre de tokens dans une requête augmente, et Anthropic la nomme dans sa propre documentation (Claude Platform docs). L'étude Context Rot de Chroma a testé 18 modèles dont GPT-4.1, Claude 4, Gemini 2.5 et Qwen3, et a constaté que la fiabilité diminue avec des entrées plus longues même sur des tâches triviales de récupération et de réplication de mots ; dans son test LongMemEval, chaque famille de modèles a obtenu de meilleurs résultats sur une invite ciblée d'environ 300 tokens que sur la même question enfouie dans environ 113k tokens d'historique de conversation, les modèles Claude affichant le plus grand écart (Chroma, juillet 2025). Évitez-la en ne collant que les passages qui comptent, en ouvrant de nouveaux chats pour de nouveaux sujets plutôt que de prolonger les anciens, et en ayant des agents spécialisés qui retournent des résumés condensés de 1 000 à 2 000 tokens à un agent coordinateur plutôt que des transcriptions complètes (Anthropic Engineering).
Dois-je désactiver la mémoire de ChatGPT, Claude ou Gemini ?
Cela dépend de la tâche, car la mémoire injecte des tokens que vous n'avez pas choisis dans une fenêtre où tout compte dans le total (Claude Platform docs). Pour la rédaction de routine où le modèle connaît votre rôle, votre style et votre stack et vous évite de les retaper, laissez-la activée. Pour l'analyse à enjeux élevés d'un document spécifique, commencez un chat propre avec la mémoire désactivée, puisque Chroma a constaté que chaque famille de modèles répondait mieux à partir d'une invite ciblée d'environ 300 tokens qu'à partir de la même réponse entourée d'environ 113k tokens d'historique non lié (Chroma). Traitez la mémoire comme un système d'invite permanent pour lequel vous payez à chaque tour, et élagez-la comme vous élagueriez un système d'invite.
Ai-je besoin de RAG, ou puis-je simplement coller mes documents dans l'invite ?
Les recommandations d'Anthropic indiquent que la récupération est souvent inutile à petite échelle : « Si votre base de connaissances fait moins de 200 000 tokens (environ 500 pages de matériel), vous pouvez simplement inclure l'intégralité de la base de connaissances dans l'invite » (Anthropic Engineering, septembre 2024). Au-delà, l'hygiène de récupération se compose dans le benchmark d'Anthropic : ajouter un contexte spécifique au chunk avant l'embedding a réduit les échecs de récupération top-20 de 5,7 % à 3,7 %, l'ajout d'une recherche hybride BM25 contextuelle les a portés à 2,9 %, et un passage de reranking les a amenés à 1,9 %, soit une réduction totale de 67 %. Si votre corpus rentre, coller est le meilleur défaut, et la mise en cache des invites rend la réutilisation bon marché avec des lectures de cache tarifées à 0,1x l'entrée de base (Claude Platform docs).
Où placer les documents longs dans une invite — avant ou après ma question ?
Pour Claude, placez les données longues en haut, au-dessus de votre requête, de vos instructions et de vos exemples. La documentation d'invite d'Anthropic en fait une règle concrète pour les entrées de 20k tokens ou plus et indique que « placer les requêtes à la fin peut améliorer la qualité des réponses jusqu'à 30 % dans les tests, en particulier avec des entrées complexes à plusieurs documents » (Claude Platform docs). La même documentation recommande d'envelopper chaque document dans des balises <document> avec des sous-balises <source> et <document_content>, et de demander au modèle de citer les passages pertinents avant de répondre. Les fournisseurs ne s'accordent pas sur l'ordre, donc un gabarit copié depuis le cookbook d'un fournisseur peut sous-performer sur le modèle d'un autre, et il vaut la peine d'essayer les deux ordres une fois sur votre propre tâche.