

Quatre flux de travail IA en finance passent la barre en 2026 : le rapprochement, la prévision, la catégorisation des dépenses et la préparation à l'audit. Tout le reste est un pilote avec une bonne démo.
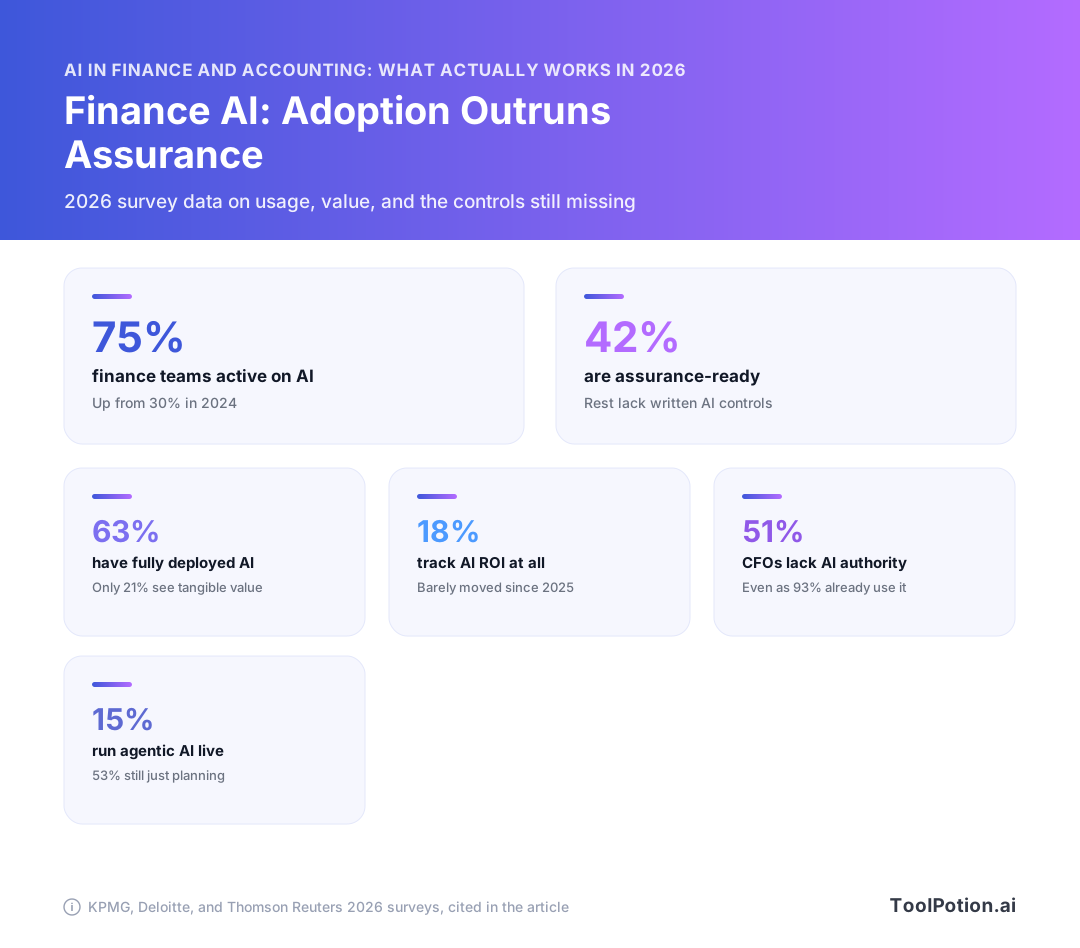
Les chiffres d'adoption ne vous aideront pas à choisir. KPMG indique que l'utilisation active de l'IA dans la fonction finance a atteint 75 % en 2026, contre 30 % en 2024. L'enquête Finance Trends de Deloitte auprès de 1 326 dirigeants révèle que 63 % ont un déploiement complet mais seulement 21 % constatent une valeur tangible. Thomson Reuters constate que 18 % suivent le ROI d'une quelconque façon. Ce ne sont pas des contradictions, mais trois définitions du mot « adoption ».
Cet article filtre donc sur les contrôles : ce que la guidance GenAI du COSO de février 2026 exige, ce que mesure réellement la note de bas de page d'un fournisseur, et lesquels des 309 outils finance et banque de notre répertoire survivent aux deux tests.
Les chiffres d'adoption 2026 se contredisent : lisez-les à la lumière de leur définition
Quand une enquête annonce 93 % et une autre 14 %, les deux peuvent avoir raison. Elles comptent des choses différentes, et presque aucune ne le précise dans le titre.
Utilisation en pilote, déploiement et utilisation en flux de travail central sont trois questions distinctes
L'étude Global AI in Finance 2026 de KPMG révèle que l'utilisation active de l'IA dans la fonction finance a plus que doublé, passant de 30 % en 2024 à 75 % en 2026, avec 71 % des responsables finance affirmant que l'IA atteint ou dépasse les attentes en matière de ROI. L'« utilisation active » y désigne tout ce qui tourne, y compris un contrôleur qui colle des commentaires sur les écarts dans une fenêtre de chat. Thomson Reuters, interrogeant sur l'utilisation GenAI à l'échelle de l'organisation, obtient 40 %, en hausse par rapport à 22 % un an plus tôt, et seulement 15 % pour l'IA agentique, avec 53 % qui la planifient ou l'envisagent. Même année, même profession, écart d'un facteur trois. C'est la formulation des questions qui produit cela, pas le marché.
Avant donc de citer un chiffre, trouvez la définition : compte-t-il toute personne ayant essayé un outil, toute entreprise en ayant acheté un, ou un flux de travail ayant survécu à une clôture de fin de mois sous le regard d'un auditeur ? Seul le troisième vous dit quelque chose sur votre propre feuille de route.
L'écart déploiement-valeur que personne ne réconcilie
L'enquête Finance Trends 2026 de Deloitte auprès de 1 326 dirigeants financiers mondiaux est celle à conserver, car elle a posé les deux questions. 63 % ont un déploiement complet de l'IA en finance, 21 % estiment que ces investissements ont livré une valeur tangible, et 14 % ont pleinement intégré des agents IA. Le déploiement est environ trois fois supérieur à la valeur. Cet écart est l'état réel de l'IA financière en 2026, et c'est le chiffre à retenir lors de tout appel avec un fournisseur.
Presque personne ne mesure le ROI
Voici ce qui rend chaque graphique d'adoption plus fragile qu'il n'y paraît : seulement 18 % des répondants savaient que leur organisation suivait le ROI de l'IA d'une quelconque façon, à peu près stable d'une année sur l'autre, et la plupart de ceux qui le suivent mesurent des indicateurs opérationnels internes plutôt que des résultats business. La satisfaction déclarée sur des dépenses non mesurées est une humeur, pas une preuve.
Deux habitudes aident. Lisez chaque statistique à l'aune de la définition propre à l'enquête avant de la répéter, et traitez tout chiffre issu d'une étude sponsorisée par un fournisseur comme une affirmation marketing jusqu'à ce que vous trouviez la note de bas de page. Nous appliquons le même filtre aux 309 outils IA finance et banque de notre répertoire et aux rapports sur les tendances IA que nous suivons, c'est pourquoi la liste courte de la prochaine section est courte.
Rapprochement : le taux d'auto-correspondance que vous obtiendrez réellement
Planifiez sur 60 % à 80 % de comptes auto-certifiés, et construisez votre business case sur la borne basse de cette fourchette. Le chiffre du fournisseur que vous entendrez en démo est « jusqu'à 98 % » d'auto-certification avec 99 % de précision de correspondance. Les déploiements réels chez des clients s'établissent entre 43 % et 85 %, ce qui fait de 60–80 % l'hypothèse de planification honnête (Numeric). Si votre modèle de staffing à la clôture ne fonctionne qu'à 90 %, le projet échoue avant le premier mois de clôture.
Plafond marketing versus plage observée chez les clients
Ce plancher de 43 % et ce plafond de 85 % correspondent au même logiciel. L'écart vient de vos données, pas du modèle du fournisseur.
Un résultat de 98 % est atteignable sur une tranche étroite : comptes à volume élevé et faible variance comme la trésorerie bancaire et le clearing de cartes de crédit, avec une correspondance propre un-à-un et un seuil de matérialité fixé généreusement. Étendez le même outil aux charges payées d'avance, aux intercompagnies, aux passifs courus et aux stocks, et le pourcentage certifié chute fortement car ces comptes nécessitent du jugement, pas de la correspondance. Demandez à chaque fournisseur quels types de comptes couvre le pourcentage de son client de référence. Si la réponse est « trésorerie et comptes clients », vous venez d'apprendre que le chiffre est un taux partiel, pas un taux de portefeuille.
Ce qui crée l'écart : hygiène des données, couverture des sous-registres, seuils de matérialité
Trois éléments déterminent où vous vous situez, et vous les contrôlez tous avant de signer quoi que ce soit. La couverture des sous-registres vient en premier : les comptes dont le détail de support se trouve dans un tableur ou un système sans API ne peuvent pas être auto-certifiés avec une précision quelconque, comptez-les donc et soustrayez-les de votre dénominateur dès maintenant. L'hygiène des données vient en deuxième, ce qui signifie des identifiants de référence cohérents, un nommage stable des fournisseurs et un flux bancaire qui ne retraite pas les périodes antérieures. Les seuils de matérialité viennent en troisième, et c'est le levier que les gens actionnent discrètement pour faire bonne figure sur le tableau de bord.
Relevez votre seuil d'auto-certification de 500 $ à 5 000 $ et votre taux s'améliore sans la moindre progression de la correspondance sous-jacente. Votre auditeur le remarquera. Fixez le seuil à partir de votre documentation SOX existante et laissez-le en place pour le pilote, puis mesurez. Les études de cas IA avec résultats divulgués de notre répertoire méritent d'être lues avec le même filtre : vérifiez si le taux déclaré mentionne les types de comptes et le seuil, car la plupart ne le font pas.
Les critères d'acceptation à inscrire dans votre pilote
Inscrivez-les dans le bon de commande, pas dans le deck de lancement. Réalisez une clôture complète de trimestre, les trois mois, sur l'ensemble de votre portefeuille de comptes réels.
- Taux d'auto-certification d'au moins 65 % sur tous les comptes du bilan en périmètre, mesuré à votre seuil de matérialité actuel avec le seuil gelé pour la durée du pilote.
- Taux de fausse certification nul sur les comptes au-dessus du seuil de matérialité, une fausse certification étant le fait que l'outil a certifié un solde qu'un réviseur a dû rouvrir. C'est ce chiffre qui met fin au pilote, pas le taux de correspondance.
- Chaque certification produit une piste d'audit exportable montrant les pièces sources mises en correspondance, la règle ou la version du modèle appliquée, et la personne qui a approuvé la file d'exceptions.
- Pourcentage d'override suivi mensuellement et rapporté, afin de voir la dérive avant votre auditeur.
Si le fournisseur refuse de s'engager sur un taux mesuré sur vos données, valorisez l'opération comme si vous obtiendrez 43 %.
Prévision : gains de vitesse réels, gains de précision très inégaux
Achetez l'IA FP&A pour le cycle time, pas pour un meilleur chiffre. L'enquête KPMG de mars 2026 auprès de 1 013 hauts responsables financiers dans 20 pays révèle que la vitesse de prise de décision s'est améliorée pour 71 % et la qualité des décisions pour 70 %, tandis que la précision des prévisions s'est améliorée pour 64 % (KPMG). Ce 64 % est le plus fragile des trois, et il masque un écart suffisamment large pour briser un business case.
La vitesse de décision s'améliore plus sûrement que la précision des prévisions
Les gains de vitesse et de qualité proviennent de travaux que l'IA réalise bien : extraire les données réelles de quatre systèmes dans une vue d'écart unique, rédiger le commentaire, relancer un scénario en quelques minutes plutôt qu'en une journée. Rien de cela n'exige que le modèle prédise quoi que ce soit. Cela exige qu'il assemble et explique, ce qu'il fait bien.
Rédigez donc vos critères de succès en jours, pas en points de base. Délai de transmission de la clôture à la prévision, nombre de scénarios exécutés par cycle, heures d'analyste consacrées à l'assemblage des données. Si votre seul test d'acceptation est l'erreur de prévision, vous pariez sur le plus faible des trois résultats mesurés par KPMG.
Pourquoi la banque atteint 71 % et la santé 44 %
Les gains de précision des prévisions vont de 71 % dans la banque à 44 % dans la santé dans les mêmes données KPMG (KPMG). L'écart reflète la quantité d'historique propre, à haute fréquence et structuré disponible dans chaque secteur. La banque dispose de données de transactions quotidiennes sur des décennies, valorisées et horodatées. La prévision en santé dépend du mix payeurs, des conditions contractuelles et des délais de remboursement qui se trouvent dans des textes et changent au gré des contrats.
Demandez à votre fournisseur de quel monde proviennent ses clients de référence. Un résultat de 71 % dans un secteur riche en données ne vous apprend presque rien sur votre prévision de chiffre d'affaires si vos données d'entrée sont des PDF contractuels.
Là où les copilotes FP&A s'arrêtent : la couche des hypothèses reste humaine
Le modèle peut extrapoler votre tendance de réservations. Il ne peut pas décider que le nouveau palier de tarification modifie le churn, que le plan d'embauche du T3 glisse de six semaines, ou qu'un client renégociant en novembre doit subir une décote de 30 %. Ces hypothèses pilotent la prévision, et elles viennent de personnes qui parlent aux équipes commerciales et opérations.
Limitez l'outil à tout ce qui se situe en dessous de la ligne des hypothèses et conservez les hypothèses dans un registre révisable avec un responsable et une date pour chacune.
Catégorisation des dépenses : le flux de travail le plus proche d'un problème résolu
Si vous pilotez un seul flux de travail IA en finance ce trimestre, faites-le sur le codage des transactions et la vérification des politiques de dépenses. La tâche est étroite, la vérité terrain est consignée dans votre propre document de politique, et chaque décision que l'agent prend laisse une piste révisable.
Pourquoi les contrôles de politique conviennent mieux à un agent que le jugement
Un contrôle de politique est une consultation des règles que vous avez rédigées. Ce dîner de 340 $ a-t-il un reçu, un objet professionnel et des participants sous le plafond par personne ? C'est du raisonnement déterministe sur des champs structurés plus une image de reçu, et les modes d'échec sont visibles pour un réviseur en quelques secondes. Comparez cela à une prévision, où personne ne peut vous dire si le chiffre était faux avant la clôture du trimestre. Le codage se rapproche davantage de l'extrémité politique : commerçant, montant, département, compte comptable, avec le codage historique comme ensemble d'étiquettes.
Le volume aide aussi. Vous obtenez des milliers de décisions quasi-identiques par mois, ce qui est exactement la forme qui rend un taux de précision significatif plutôt qu'anecdotique.
Ce que mesure réellement la définition de précision du fournisseur
Ramp publie une réduction d'environ 85 % des révisions manuelles à une précision de 99 %+ pour son agent de politique, et il définit la précision en note de bas de page : les approbations recommandées par l'agent que les réviseurs humains ont également approuvées, d'après une analyse interne datée du 01/07/25 (Ramp Support). Lisez cette définition deux fois avant qu'elle n'entre dans un business case. Elle mesure l'accord sur le chemin d'approbation, donc elle ne dit rien sur les dépenses que l'agent a signalées à tort, et rien sur les violations qu'il a approuvées et qu'un réviseur a laissées passer. La méthodologie divulguée place Ramp en avance sur la plupart du secteur, qui publie surtout un pourcentage sans dénominateur. Demandez la même note de bas de page à chaque fournisseur de votre liste, et traitez un refus comme une réponse.
Conception avec supervision humaine pour les exceptions restantes
Dirigez les 15 % que l'agent ne validera pas vers un réviseur nommé, journalisez le taux d'override et fixez un seuil déclenchant un ré-entraînement quand les overrides augmentent. Ce pourcentage d'override est l'un des KPI de dérive que le COSO préconise dans sa guidance GenAI de février 2026 (Deloitte Heads Up). Parmi les 550 agents IA référencés dans notre répertoire, ceux qui méritent votre temps sont ceux qui vous fournissent ce journal sans ticket de support.
Préparation à l'audit : des preuves que votre auditeur peut réellement tester
Posez une seule question à tout fournisseur de préparation à l'audit avant de regarder la démo : à quoi ressemble l'export quand mon équipe d'audit demande comment ce chiffre a été produit ? Si la réponse est une transcription de chat, vous achetez un outil de productivité, pas un outil de préparation à l'audit.
Pas de norme PCAOB spécifique à GenAI, mais AS 1105 et AS 2301 s'appliquent déjà
Il n'existe pas de norme PCAOB écrite pour l'IA générative. Ce n'est pas un vide dans lequel vous pouvez vous installer. Les normes existantes sur les preuves d'audit et l'évaluation des risques fixent déjà la barre pour les travaux assistés par IA (Fieldguide), ce qui signifie qu'un tableau produit par l'IA est évalué sur la suffisance et l'adéquation exactement comme une feuille de calcul qu'un collaborateur a construite manuellement. Votre auditeur n'a pas besoin d'une nouvelle règle pour le rejeter.
Le COSO a complété la partie gouvernance le 23 février 2026, avec la première extension formelle de son Cadre intégré de contrôle interne à l'IA, classant les cas d'usage GenAI en huit types de capacités dont l'ingestion, la transformation, la saisie et le jugement (Journal of Accountancy). L'ingestion et la transformation sont les plus faciles à défendre. Le jugement est là où les questions s'allongent.
Ce que signifie « preuve suffisante et appropriée » quand un modèle l'a produite
Cela signifie que la sortie doit être traçable jusqu'à un document source que votre auditeur peut ouvrir. L'extraction est le flux de travail où cela tient le mieux, car le PDF ou la facture sous-jacent reste la preuve et le modèle est une paire d'yeux plus rapide dessus. Si vous cherchez dans cette couche, notre répertoire recense 217 outils d'extraction de documents et PDF, et ceux qui méritent votre temps vous montreront une référence de page et de coordonnées pour chaque champ extrait, pas une réponse résumée.
Sebastian Stöckle, responsable mondial de l'innovation en audit et de l'IA chez KPMG International, a formulé le test clairement : « L'IA ne livre de vraie valeur que lorsqu'elle peut être expliquée et contrôlée » (KPMG).
Conservation, journalisation et reproductibilité à spécifier dès le départ
Inscrivez-les dans le contrat, car les ajouter après le déploiement est coûteux. Demandez l'identifiant du modèle et de la version horodaté sur chaque exécution, l'invite ou la configuration utilisée, la traçabilité immuable du champ de sortie jusqu'au document source et à la page, un journal exportable de qui a révisé et approuvé chaque élément avec un horodatage, et une fenêtre de conservation correspondant à votre politique de rétention d'audit plutôt qu'aux valeurs par défaut du fournisseur. Demandez ce qui arrive à vos journaux quand le fournisseur met à niveau le modèle sous-jacent en cours d'année.
Puis continuez à les surveiller. La guidance du COSO demande une surveillance continue des performances du modèle avec des KPI comme le volume de transactions, la taille des transactions et les pourcentages d'override, car les contrôles paramétrés et oubliés ne détectent pas la dérive (Deloitte). Le taux d'override est celui à afficher sur un tableau de bord. Si vos réviseurs corrigent discrètement le modèle sur 30 % des éléments, vous avez un constat de contrôle en attente d'être rédigé et un business case qui n'a jamais atterri.
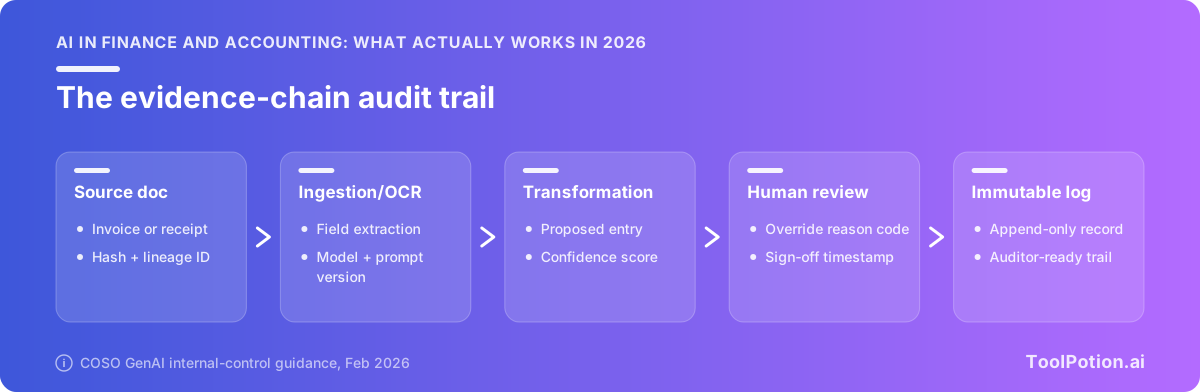
La liste de contrôle qui filtre votre sélection de fournisseurs
Remettez-la à chaque fournisseur avant la deuxième démo. La plupart provient directement du document du COSO « Achieving Effective Internal Control Over Generative AI », publié le 23 février 2026 comme première extension formelle du Cadre de contrôle interne intégré (2013) à la gouvernance de l'IA (Journal of Accountancy). C'est ce qui se rapproche le plus d'une norme écrite, et les fournisseurs vendant en finance devraient déjà la connaître.
Les huit types de capacités GenAI du COSO, et lesquels votre cas d'usage touche
Le COSO classe les cas d'usage GenAI en huit types de capacités : ingestion, transformation, saisie, orchestration, jugement, surveillance, veille réglementaire et interaction humain-IA (Journal of Accountancy). Faites dire au fournisseur, par écrit, lesquelles son produit réalise.
La ligne qui compte est la saisie et le jugement. Un outil qui se contente d'ingérer des documents et de les transformer en brouillon est un problème de contrôle différent de celui qui écrit dans le grand livre ou décide si une exception est acceptable. Le codage des dépenses touche généralement l'ingestion, la transformation et le jugement. L'auto-certification du rapprochement touche la saisie. Si la réponse d'un fournisseur est « les huit », c'est qu'il ne l'a pas lu non plus.
De l'assurance ponctuelle à la surveillance continue
Votre ancien walkthrough de type SOC ne couvre pas un modèle qui dérive entre les trimestres. La guidance du COSO préconise une surveillance continue des performances du modèle plutôt qu'une assurance statique et ponctuelle, avec des KPI prioritaires autour du volume de transactions, de la taille des transactions et des pourcentages d'override pour détecter la dérive. Les contrôles paramétrés et oubliés sont explicitement insuffisants (Deloitte Heads Up).
Le taux d'override et les KPI de dérive à exiger dans le contrat
- Taux d'override par utilisateur et par type de transaction, exportable mensuellement, pas seulement visible dans un tableau de bord.
- Historique des versions du modèle avec les dates, afin de pouvoir rattacher un changement de taux d'erreur à une version spécifique plutôt que de le deviner.
- Précision mesurée sur vos données pendant une période de run parallèle que vous définissez, avec le dénominateur consigné.
- Un seuil nommé qui déclenche une révision. Choisissez un chiffre maintenant (par exemple, taux d'override supérieur à 8 % au cours d'un mois) et inscrivez-le dans le contrat.
L'état de préparation à l'assurance est la variable qui prédit les résultats
KPMG a constaté que seulement 42 % des organisations sont pleinement prêtes pour l'assurance, et l'écart de résultats n'est pas subtil : ces entreprises déclarent des améliorations de réduction des erreurs de 33 % contre 6 % pour leurs pairs non prêts, et une confiance dans le déploiement de l'IA de 42 % contre 14 % (KPMG).
L'IA ne livre de vraie valeur que lorsqu'elle peut être expliquée et contrôlée. L'état de préparation à l'assurance distingue la performance durable du risque caché. — Sebastian Stöckle, responsable mondial de l'innovation en audit et de l'IA, KPMG International
Appliquez la liste de contrôle avant de présélectionner, pas après. Notre catégorie finance et banque compte 309 références, et la liste de contrôle réduit cela à une poignée plus vite que n'importe quelle comparaison de fonctionnalités.
Lisez chaque affirmation de précision à l'aune de sa propre note de bas de page
Chaque chiffre de performance dans une démo IA en finance est une mesure, et une mesure sans sa population, sa définition du correct et sa date est un actif marketing. Les notes de bas de page sont généralement publiées. Presque personne ne les lit.
Trois questions qui dégonflent la plupart des chiffres
Posez-les dans l'ordre, par écrit, avant la deuxième démo.
- Quelles transactions ont été comptées ? Pas le volume total, le sous-ensemble sur lequel le chiffre a été calculé.
- Qu'est-ce qui rendait une réponse correcte ? Quelqu'un a défini une vérité terrain. Obtenez cette définition verbatim.
- Quand a-t-il été mesuré, et sur les données de qui ? Une seule analyse interne de l'année dernière n'est pas un niveau de service.
Dénominateurs, dates et comparaisons auto-sélectionnées
L'agent de politique de Ramp publie une réduction d'environ 85 % des révisions de notes de frais manuelles à une précision de 99 %+, et sa propre documentation définit cette précision comme les approbations recommandées par l'agent que les réviseurs humains ont également approuvées, d'après une analyse interne datée du 01/07/25 (Ramp Support). C'est une mesure d'accord sur le chemin d'approbation. Elle ne dit rien sur les dépenses que l'agent a signalées à tort et qu'un réviseur a dû annuler, ce qui est le type d'erreur qui préoccupe votre contrôleur.
Les affirmations de rapprochement échouent différemment. Le chiffre d'auto-certification est énoncé comme un plafond, « jusqu'à 98 % », tandis que les déploiements réels chez les clients s'établissent dans une plage de 43 % à 85 % (Numeric). Un plafond est un fait sur le meilleur compte du meilleur mois chez le meilleur client.
À quoi ressemble une divulgation crédible
Elle nomme la taille de l'échantillon, la règle de notation et la date, comme le fait Ramp, et elle rapporte le taux de fausse approbation aux côtés du taux de précision. Demandez le chiffre calculé sur votre propre dernier trimestre de données pendant le pilote. Un fournisseur qui refuse de faire ce test vous a dit ce que sa note de bas de page dirait.
Pourquoi les démos échouent à la clôture de fin de mois, et la conception du pilote qui l'empêche
Une démo tourne sur un extrait curé. Le sous-registre propre du trimestre dernier, une douzaine de factures bien formées, pas d'intercompagnie, pas d'écriture manuelle publiée par l'équipe fiscale à 23h le troisième jour. La clôture est la population inverse, et chaque mode d'échec qu'un ingénieur commercial exclurait d'un appel apparaît en même temps, dans le délai, devant votre contrôleur.
La construction de la récupération domine la précision plus que le choix du modèle
Échangez un modèle frontier contre un autre sur le même ensemble de questions financières et les réponses changent un peu. Modifiez la façon dont les documents sont découpés, quel fichier de quelle période est extrait, et si les notes de bas de page voyagent avec le tableau, et les réponses changent beaucoup. La plupart des mauvaises réponses dans les Q&A financières sont des échecs de récupération dans une phrase fluide : l'outil a trouvé le tableau FY24 quand vous avez posé une question sur FY25, et la prose se lit parfaitement dans les deux cas.
La guidance du COSO de février 2026 traite l'ingestion et la transformation comme des types de capacités distincts du jugement, chacun portant ses propres contrôles (Journal of Accountancy). Testez le pipeline sur vos propres fichiers sources imparfaits. L'ensemble d'échantillons du fournisseur ne vous apprend presque rien.
Les réviseurs expérimentés captent l'essentiel du gain
Mettez l'outil devant vos deux meilleurs seniors avant de le déployer auprès du staff. La recherche terrain quantifiant les gains de temps de l'IA pour les CPA va dans le même sens : les heures atterrissent chez les personnes qui savent déjà à quoi ressemble une bonne réponse et peuvent repérer une mauvaise en quelques secondes (Journal of Accountancy).
Supprimez la couche de révision et vous obtenez le résultat Deloitte : un remboursement de plus de 60 000 $ au gouvernement australien à cause d'un rapport contenant des erreurs générées par l'IA (CFO Dive).
Le coût, la valeur floue et les contrôles de risque faibles tuent les projets agentiques
La capacité du modèle est rarement ce qui bloque ces programmes. L'enquête Finance Trends de Deloitte auprès de 1 326 responsables financiers révèle que 63 % ont un déploiement complet de l'IA en finance tandis que seulement 21 % ont constaté une valeur tangible, et 14 % ont pleinement intégré des agents (CFO Dive). Thomson Reuters situe l'adoption agentique à 15 % contre 53 % qui la planifient ou l'envisagent (Thomson Reuters). Dans l'enquête CFO Signals T2 2026 de Deloitte, 59 % des CFO ont cité l'équilibre entre pression de déploiement et risque comme leur principal défi, et 51 % ont déclaré manquer d'autorité de gouvernance (Deloitte).
Un pilote de 90 jours avec les chiffres consignés avant de commencer
- Choisissez un flux de travail et une entité. Le rapprochement pour une filiale unique vaut mieux qu'un déploiement à l'ensemble de la finance que vous ne pouvez pas mesurer.
- Établissez la référence sur deux clôtures avant que l'outil ne touche quoi que ce soit : heures passées, nombre d'exceptions, taux de reprise, jours jusqu'à la certification.
- Convenez du seuil d'acceptation par écrit avec votre contrôleur et le partenaire responsable de votre auditeur externe, et fixez une date.
- Surveillez les taux d'override chaque semaine, ainsi que le volume de transactions et la taille des transactions, qui est le signal de dérive sur lequel repose l'exigence de surveillance continue du COSO (Deloitte Heads Up).
- Rédigez le critère d'arrêt dès le premier jour. Quelque chose comme : si l'auto-certification est inférieure à 55 % au jour 90, ou si l'override des réviseurs dépasse 15 % pendant trois semaines consécutives, nous stoppons et renégocions.
Puis publiez le résultat en interne, chiffres inclus, comme le font les équipes qui documentent leurs déploiements réels dans notre répertoire. Seulement 18 % des organisations suivent le ROI de l'IA d'une quelconque façon (Thomson Reuters), donc un seul référentiel écrit vous place devant quatre acheteurs sur cinq au moment du renouvellement.
Questions fréquemment posées
L'IA est-elle suffisamment fiable pour faire la comptabilité sans réviseur humain en 2026 ?
Non, et les cadres de contrôle supposent désormais que vous conserverez un réviseur. KPMG situe l'utilisation active de l'IA dans la fonction finance à 75 % en 2026, contre 30 % en 2024, mais seulement 42 % des organisations sont pleinement prêtes pour l'assurance, et celles qui le sont déclarent des gains de réduction des erreurs de 33 % contre 6 % pour les autres (KPMG, 11 mai 2026). La guidance du COSO de février 2026 traite les contrôles « paramétrés et oubliés » comme explicitement insuffisants et préconise une surveillance continue des performances du modèle (Deloitte Heads Up). La sortie non révisée a déjà un prix : Deloitte a remboursé plus de 60 000 $ au gouvernement australien à cause d'un rapport contenant des erreurs d'IA (CFO Dive).
Quel taux d'auto-correspondance dois-je attendre d'un logiciel de rapprochement IA ?
Planifiez sur 60 % à 80 % d'auto-certification, pas sur le chiffre de la diapositive. Les fournisseurs de rapprochement commercialisent « jusqu'à 98 % » d'auto-certifié avec 99 % de précision de correspondance, tandis que les résultats réels chez les clients s'établissent dans une plage de 43 % à 85 % (Numeric). Inscrivez le taux dans vos critères d'acceptation et mesurez-le sur votre propre grand livre historique pendant le pilote, pas sur des données de démo, puis remessurez après trois clôtures car la qualité de la correspondance dérive au fur et à mesure que votre mix de transactions change (Deloitte Heads Up sur COSO).
Que requiert la guidance COSO de février 2026 pour l'IA utilisée dans le reporting financier ?
Le COSO a publié « Achieving Effective Internal Control Over Generative AI » le 23 février 2026, première extension formelle de son Cadre de contrôle interne intégré 2013 à la gouvernance de l'IA, classant les cas d'usage GenAI en huit types de capacités : ingestion, transformation, saisie, orchestration, jugement, surveillance, veille réglementaire et interaction humain-IA (Journal of Accountancy). L'exigence opérationnelle est un passage de l'assurance ponctuelle à la surveillance continue, avec des KPI comme le volume de transactions, la taille des transactions et les pourcentages d'override pour détecter la dérive du modèle (Deloitte Heads Up). Classifiez chaque outil que vous utilisez par type de capacité, fixez un seuil pour chaque KPI et journalisez les overrides dès le premier jour, car un outil de saisie ou de jugement porte des exigences de contrôle bien plus lourdes qu'un outil d'ingestion.
Mon auditeur acceptera-t-il des papiers de travail préparés avec l'IA générative ?
Oui, si vous pouvez montrer comment la sortie a été produite et qui l'a vérifiée. Le PCAOB n'a pas émis de norme sur l'IA générative, et ses normes existantes sur les preuves d'audit et l'évaluation des risques fixent déjà la barre pour la suffisance, l'adéquation et la révisabilité (Fieldguide). Conservez l'invite, les documents sources que l'outil a récupérés, le modèle et la version, la date, et les signatures du préparateur et du réviseur, afin que le papier de travail se tienne seul sans que personne n'ait à relancer le modèle. Attendez-vous à des questions plus pointues : PwC a demandé au PCAOB de faire de l'IA en audit sa priorité absolue (Big4 News).
Comment calculer le ROI d'un outil IA en finance quand seulement 18 % des organisations le suivent ?
Captez la référence avant le démarrage du pilote, car vous ne pourrez pas la reconstituer ensuite. Seulement 18 % des professionnels savaient que leur organisation suivait le ROI de l'IA d'une quelconque façon en 2026, à peu près inchangé par rapport à 2025, et la plupart de ceux qui le suivent mesurent des indicateurs opérationnels internes plutôt que des résultats business (Thomson Reuters, 9 févr. 2026). L'écart créé est visible dans l'enquête Finance Trends de Deloitte auprès de 1 326 responsables financiers : 63 % ont un déploiement complet de l'IA en finance et 21 % estiment qu'il a livré une valeur tangible (CFO Dive). Suivez quatre chiffres sur une fenêtre fixe : heures jusqu'à la clôture, taux d'exceptions, cycle time par transaction, et coût complet incluant le temps de révision que l'outil génère. Le constat de KPMG que 71 % des responsables finance disent que l'IA atteint ou dépasse les attentes en matière de ROI mesure des attentes, ne le substituez donc pas à vos propres chiffres (KPMG).
Quel flux de travail financier devrais-je automatiser en premier ?
La catégorisation des dépenses et la vérification des politiques, principalement parce que c'est le seul flux de travail où un fournisseur publie ce que signifie son chiffre de précision : Ramp déclare environ 85 % de révisions manuelles en moins à une précision de 99 %+, définie comme les approbations recommandées par l'agent que les réviseurs humains ont également approuvées, d'après une analyse interne datée du 01/07/25 (Ramp). Le rapprochement vient en deuxième, car le taux de correspondance atteignable est bien inférieur au taux commercialisé et nécessite un pilote payant sur vos données (Numeric). La prévision vient ensuite : 44 % des CFO d'entreprises de plus d'1 Mrd$ utilisent déjà l'IA pour la planification et la budgétisation (Deloitte Q2 2026 CFO Signals), mais les gains de précision varient fortement selon le secteur, de 71 % dans la banque à 44 % dans la santé (KPMG). Affinez la sélection avant de faire quelque démo que ce soit, car notre répertoire seul compte 550 agents IA et très peu ont été conçus pour une clôture contrôlée.