

Votre pipeline multimodal n'échouera pas parce qu'un modèle hallucine. Il échouera parce que l'URL de téléchargement de Sora a expiré 61 minutes après la fin du rendu, ou parce que votre podcast de 90 minutes a atteint le plafond de transcription de 25 Mo d'OpenAI alors qu'AssemblyAI aurait accepté le fichier entier de 5 Go en une seule requête.
Chaque passage entre les modèles est un contrat : un format de fichier exact, un niveau de plan qui le déverrouille, une fenêtre d'expiration, et une solution de repli pour quand le fournisseur supprime le modèle. La plupart des guides ignorent ces quatre éléments.
Celui-ci vous donne les contrats, trois pipelines concrets, et le plan de migration dont vous avez besoin avant qu'OpenAI ferme l'API Videos et les deux modèles Sora 2 le 24 septembre 2026, sans successeur désigné. Il reste 19 jours.
Pourquoi les pipelines multimodaux cassent aux transferts, pas aux modèles
Chaque modèle de votre chaîne fonctionne. La transcription est précise, l'image est correcte, la voix sonne humaine, la vidéo se génère. Ce qui casse, c'est le moment où la sortie d'un modèle doit devenir l'entrée du suivant, et personne n'a écrit à quoi cette sortie était censée ressembler.
Version concrète : les URL de téléchargement des actifs générés par Sora restent valides pendant un maximum d'une heure après la génération, et la sortie arrive sous forme de MP4 accompagné d'une miniature WebP et d'une feuille de sprites JPG (OpenAI). Si votre pipeline met le rendu en file d'attente et passe à l'étape de copie 90 minutes plus tard, le rendu est perdu. Le modèle a parfaitement fait son travail.
Le contrat de transfert : format, niveau, expiration, solution de repli
Traitez chaque passage comme un contrat à quatre termes que vous notez avant de construire quoi que ce soit.
Le format est la spécification exacte du fichier que le passage suivant exige, jusqu'au taux d'échantillonnage et aux dimensions en pixels, pas un ratio d'aspect et un espoir. Le niveau est le plan ou le paramètre API unique qui déverrouille ce format, car beaucoup des formats dont vous avez besoin sont verrouillés derrière un abonnement payant ou un nom de modèle hérité. L'expiration est la durée pendant laquelle l'artefact reste récupérable chez le fournisseur avant que vous assumiez la perte. La solution de repli est ce que vous substituez quand le fournisseur supprime le modèle, ce qui en ce moment n'est pas hypothétique.
Notez ces quatre lignes par passage et la plupart des déboguages disparaissent avant même de commencer.
Quatre modes de défaillance qui tuent un pipeline en cours d'exécution
- Le passage amont émet un format que le passage aval dégrade silencieusement ou rejette complètement.
- Une fonctionnalité que vous supposiez disponible dans l'API se trouve en réalité derrière un niveau de plan supérieur ou une ancienne version du modèle.
- L'artefact expire sur le stockage du fournisseur pendant que votre tâche est encore en file d'attente.
- Le modèle sur lequel vous avez construit reçoit une date de fermeture, et le fournisseur ne liste aucun successeur recommandé.
Les trois pipelines qui suivent sont tous des instances du même contrat : podcast vers notes d'émission, script vers vidéo narrée, et photo produit vers campagne publicitaire. Chacun nomme le format, le niveau, l'expiration et la solution de repli à chaque passage.
Ce texte est destiné à quelqu'un qui livre un résultat concret, pas à quelqu'un qui compare des architectures de fusion. Vous pouvez choisir les outils individuels parmi les 18 982 outils IA actifs dans notre répertoire. Les connecter entre eux, c'est la partie que personne ne documente.
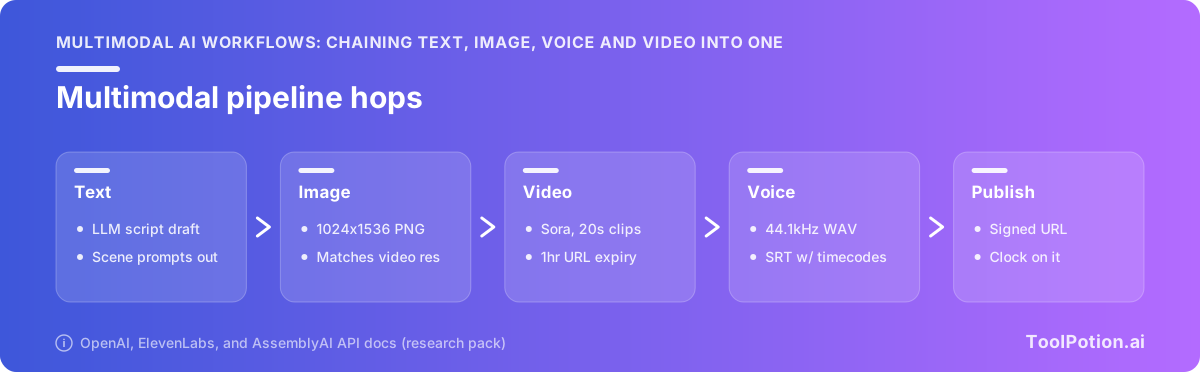
Pipeline 1 : article de blog vers vidéo narrée
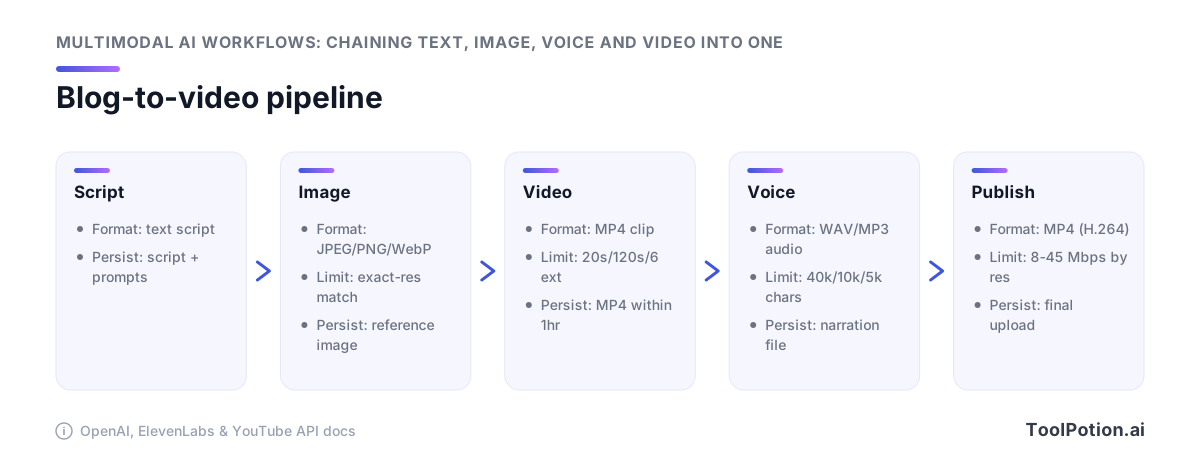
Partez d'un article de 1 200 mots et vous voulez obtenir une vidéo narrée de deux minutes. Quatre passages : découper le texte, générer des images fixes, les animer, les narrer. Chacun de ces passages a une spécification que le passage précédent doit respecter, et vous fixez la plupart de ces spécifications avant de faire un seul appel API.
Segmentation du script avant tout appel de génération
La segmentation n'est pas une étape de mise en forme que vous faites à la fin. C'est le paramètre dont tout ce qui suit hérite, parce que le modèle de voix que vous choisissez plafonne ce que vous pouvez envoyer par requête. Eleven Flash v2.5 prend 40 000 caractères, Multilingual v2 en prend 10 000, et v3 s'arrête à 5 000 (ElevenLabs). Choisissez v3 pour une narration expressive et votre script de 1 200 mots tient en un seul appel. Choisissez-le pour un explicatif de 9 000 mots et vous découpez en deux, avec une jointure à masquer.
Segmentez sur les frontières de scène, pas sur les comptes de phrases. Chaque segment a besoin d'une idée visuelle, d'une durée cible en secondes, et d'une résolution cible en pixels attachée comme métadonnée. C'est ce dernier champ que le passage image lit.
Passage image : correspondre exactement aux dimensions en pixels du passage vidéo
Le chemin image-vers-vidéo de Sora exige que l'image de référence corresponde exactement à la résolution vidéo cible, en image/jpeg, image/png ou image/webp (OpenAI). Exactement signifie en pixels, pas « 16:9 ». Un générateur d'images chargé de produire une image grand format vous donnera volontiers du 1792x1024 alors que l'appel vidéo veut du 1280x720, et la tâche échoue à la soumission plutôt qu'au rendu. Ainsi, le modèle de prompt image porte la largeur et la hauteur en entiers littéraux tirés de la configuration du passage vidéo, et vous validez les dimensions et le type MIME du fichier retourné avant de mettre quoi que ce soit en file d'attente. Parmi les 324 modèles IA référencés dans notre répertoire, ceux qui vous permettent de spécifier des dimensions en pixels arbitraires plutôt que des préréglages nommés sont ceux qui méritent d'être intégrés ici.
Passage vidéo : clips de 16 et 20 secondes, enchaînés
Sora-2 et sora-2-pro génèrent des clips de 16 ou 20 secondes. Chaque extension ajoute jusqu'à 20 secondes, plafonnée à six extensions et 120 secondes au total (OpenAI). Votre segment de deux minutes représente six appels enchaînés.
La continuité entre ces six appels est votre problème. Le modèle ne se souvient pas de l'arc narratif entre l'extension 3 et l'extension 4, donc le prompt de chaque appel doit rappeler le cadre, le sujet et le comportement de caméra. Prévoyez des nouvelles tentatives sur les jointures.
Passage voix et le multiplexage
Générez la narration par segment, pas par vidéo, pour qu'une mauvaise prise ne coûte qu'un seul appel. Puis alignez : l'audio du segment 4 doit s'adapter au clip de 20 secondes que vous avez rendu pour le segment 4, ce qui signifie généralement couper du texte plutôt qu'étirer l'audio. Multiplex avec ffmpeg, un segment à la fois, puis concaténez.
Pipeline 2 : épisode de podcast vers clips et notes d'émission
Un WAV de 58 minutes entre. En sortent une transcription, des chapitres horodatés, six clips verticaux avec sous-titres incrustés, et une page de notes d'émission. L'audio ne change jamais de format après le premier passage, ce qui rend ce pipeline plus simple que celui de la vidéo. Ce qui détermine si cela fonctionne, c'est vers quel fournisseur de transcription vous routez et quels trois paramètres vous fixez sur la requête.
Le mur des 25 Mo et comment le contourner
L'endpoint de transcription d'OpenAI plafonne les uploads à 25 Mo et accepte mp3, mp4, mpeg, mpga, m4a, wav et webm (OpenAI). Un WAV 48 kHz de 58 minutes fait environ 300 Mo. Vous devez donc soit transcoder en MP3 à faible débit et croiser les doigts, soit découper le fichier — et découper l'audio à des limites d'octets arbitraires coupe les mots en deux et décale chaque horodatage après la jointure.
AssemblyAI accepte jusqu'à 5 Go par requête sur /v2/transcript (2,2 Go si vous uploadez des fichiers locaux via /v2/upload) et gère des durées allant de 160 ms à 10 heures (AssemblyAI). C'est environ 200 fois le plafond. Pour l'audio long format, envoyez l'épisode entier là-bas et gardez votre fournisseur LLM pour les passages de raisonnement en aval.
Les horodatages au niveau du mot sont la primitive de découpe de clips
Vous ne pouvez pas découper des clips automatiquement à partir d'une transcription qui n'a que des frontières de paragraphe. Vous devez savoir que le mot « bon » commence à 00:41:12.340 pour que la coupe tombe avant lui, pas à travers lui.
Deux problèmes côté OpenAI. La sortie SRT et VTT ainsi que le paramètre timestamp_granularities[] ne fonctionnent que sur whisper-1, pas sur gpt-transcribe ni gpt-4o-transcribe (OpenAI). Si votre pipeline incruste des sous-titres ou coupe sur timecode, vous gardez l'ancien modèle dans la chaîne intentionnellement et arrêtez de le traiter comme une dette technique. ElevenLabs Scribe v2 vous donne des horodatages au niveau du mot, la diarisation et la détection d'entités dans plus de 90 langues en une seule réponse (ElevenLabs), ce qui est le choix le plus propre si vous les payez déjà pour le passage TTS.
La diarisation ne fonctionne que si vous la demandez
Les labels de locuteur nécessitent que chunking_strategy soit réglé sur auto pour tout audio de plus de 30 secondes, et gpt-4o-transcribe-diarize fait uniquement l'identification du locuteur (OpenAI). Omettez le paramètre et la requête réussit. Vous obtenez un mur de texte propre, fluide et complètement sans label, et rien dans la réponse ne vous indique qu'une interview à deux voix vient de se réduire à une seule. Vérifiez les champs de locuteur à votre étape de validation, pas à l'œil.
De la transcription aux notes d'émission, chapitres et textes pour les réseaux sociaux
Une transcription avec horodatages de mots se décline en quatre artefacts sans aucun traitement audio supplémentaire : des marqueurs de chapitres à partir des changements de sujet, un paragraphe de résumé avec liste de liens pour la page de notes d'émission, des candidats au clip classés selon la densité des citations, et les coupes verticales elles-mêmes rendues à partir de ces points d'entrée et de sortie. Alimentez la même transcription pour chacun, en parallèle, avec des prompts différents. Si vous cherchez des références de format avant de construire, 201 podcasts IA dans notre répertoire publient sur cette pile environ.
Pipeline 3 : photos produit vers variantes publicitaires
Une photo studio d'une chaussure devient douze images de marque, puis quatre publicités vidéo de 8 secondes pour les réseaux sociaux payants. Les passages sont : image en entrée, image en sortie, vidéo en sortie, et la partie technique intéressante se situe entre les passages deux et trois, où un modèle de vision examine ce que le générateur d'images a produit et décide si c'est publiable.
Examen par modèle de vision comme porte de contrôle qualité
Les images produit générées échouent de manière ennuyeuse. Mauvais placement du logo, six œillets au lieu de cinq, une ombre qui contredit la lumière principale. Vous ne voulez pas qu'un humain examine 120 variantes à l'œil, donc vous les envoyez à un modèle de vision avec la photo source et un brief de marque rédigé, et demandez un résultat succès/échec plus une chaîne de raison.
Claude accepte jusqu'à 100 images par requête sur les modèles à contexte de 200k et 600 sur les autres modèles, avec 20 par message sur claude.ai, plafonné à 8000x8000 px et 10 Mo par image (Claude Docs). Ce ne sont pas ces chiffres qui vont vous piéger.
C'est la limite de taille de requête standard de 32 Mo. Douze PNG 4K la dépassent bien avant d'atteindre 100 images, c'est pourquoi Anthropic recommande d'uploader via l'API Files et de référencer chaque image par file_id plutôt que d'inliner du base64 (Claude Docs). Construisez le passage de revue ainsi dès le premier jour. Le refactoriser une fois que vos tailles de batch ont augmenté signifie réécrire le constructeur de requête et la logique de nouvelles tentatives en même temps.
L'échantillonnage de frames est un levier de coût direct
Claude facture les images en tokens visuels de 28x28 pixels, calculés comme ⌈largeur/28⌉ × ⌈hauteur/28⌉. Un frame 3840x2160 coûte 4 784 tokens visuels sur le niveau haute résolution et 1 560 après réduction d'échelle sur le niveau standard, soit environ 23,92 $ par millier de frames 4K au tarif d'entrée de 5 $/M tokens de Claude Opus 5 (Claude Docs). Réduisez l'échelle avant d'envoyer, sauf si la vérification QC dépend de détails fins comme la couture ou les petits textes.
La même arithmétique gouverne le passage d'analyse vidéo. Examiner quatre publicités de 8 secondes à 24fps représente 768 frames si on est naïf. Échantillonnez à 2fps, vérifiez 64 frames, et votre facture de revue chute d'un facteur douze sans manquer un seul changement de scène.
Grouper les images sans atteindre le plafond de requête
Groupez par octets de charge utile, pas par nombre d'images. Triez les variantes en groupes qui restent sous environ 25 Mo de références, gardez la photo source dans chaque batch comme ancre de comparaison, et renvoyez les échecs individuellement à pleine résolution pour que la chaîne de raison vaille la peine d'être lue. Notre répertoire liste 727 générateurs d'images et 342 éditeurs photo parmi les outils IA image et photo de notre répertoire, et presque aucun n'expose la mécanique de batch dont vous avez besoin ici. Cette partie reste votre code.
La fiche de spécification de transfert : ce qu'exiger à chaque passage
Rédigez le contrat avant d'écrire le code. Chaque passage dans une chaîne a trois choses à fixer : le format de sortie exact que vous demandez, le niveau de plan ou le paramètre qui le déverrouille, et combien de temps l'artefact vit avant de disparaître. Faites-vous tromper là-dessus et l'échec se manifeste deux passages plus loin comme une plainte de qualité que personne ne peut retracer.
Audio : le niveau qui conditionne la sortie de qualité diffusion
ElevenLabs met pcm_44100, pcm_48000, wav_44100 et wav_48000 derrière un abonnement Pro, et mp3_44100_192 derrière Creator (référence API ElevenLabs). Donc sur un plan gratuit ou d'entrée de gamme, votre éditeur vidéo reçoit un MP3 avec perte à 128 kbps ou moins, peu importe la qualité du modèle de voix. C'est un plafond de qualité défini par la facturation, pas par l'inférence.
Si votre livrable est un podcast qui doit atteindre -16 LKFS avec un pic réel à ou en dessous de -1 dBFS (Apple Podcasts), vous voulez du sans perte en entrée et un seul encodage à la fin. Normaliser un MP3 à 128 kbps et le ré-encoder empile deux générations avec perte. Budgétisez le niveau Pro comme un coût de production, pas une mise à niveau.
Vidéo : URL expirantes et actifs annexes
Sora ne vous donne pas un seul fichier. Un rendu terminé vous donne un MP4, une miniature WebP et une feuille de sprites JPG, et les URL de téléchargement restent valides pendant un maximum d'une heure (guide vidéo OpenAI). Votre travail à ce passage est une copie vers votre propre stockage objet, déclenchée par l'événement de fin, pas par un batch nocturne. Ratez la fenêtre et le rendu est irrécupérable.
Texte et timing : les champs requis par les étapes en aval
Les étapes en aval exigent des champs spécifiques, et ceux qui nécessitent du timing sont ceux qui échouent silencieusement. La sortie SRT et VTT ainsi que timestamp_granularities[] ne fonctionnent que sur whisper-1, pas sur les nouveaux modèles de transcription (OpenAI speech to text). Tout ce qui découpe des clips ou incruste des sous-titres a besoin d'horodatages au niveau du mot dans le contrat.
| Passage | Exiger cette sortie | Ce qui le déverrouille | Expiration |
|---|---|---|---|
| Texte vers parole | wav_48000 ou pcm_44100 | Niveau Pro ; Creator pour mp3_44100_192 | Pas d'expiration, stocker à l'écriture |
| Parole vers texte | Horodatages au niveau du mot, labels de locuteur | whisper-1 pour SRT/VTT ; chunking_strategy: auto au-dessus de 30s pour la diarisation | Pas d'expiration |
| Image vers vidéo | MP4 avec miniature et feuille de sprites | Image de référence correspondant exactement à la résolution vidéo | 1 heure sur les URL de téléchargement |
| Vidéo vers texte | Frames échantillonnées à un taux fixe | Le niveau standard vs haute résolution change le coût en tokens visuels d'environ 3x | Pas d'expiration |
Quel que soit l'orchestrateur que vous choisissez parmi les 128 frameworks IA dans notre répertoire, testez-le d'abord sur les passages binaires. Passer du JSON entre les modèles, c'est la partie facile.
Plateforme d'automatisation ou glue manuelle
La règle est simple : laissez la plateforme décider de ce qui se passe et quand, et laissez votre propre code déplacer les octets. Tout ce qui touche un gros fichier ou court contre une fenêtre d'expiration appartient à un script avec du stockage objet derrière.
Là où une plateforme gagne
Les déclencheurs, les nouvelles tentatives sur les étapes bon marché, les portes d'approbation, et la distribution finale. Zapier propose plus de 9 000 intégrations d'applications connectées dans des Zaps, Tables, Forms et Zapier MCP, et ce catalogue est la vraie raison de l'utiliser. Acheminer les notes d'émission finalisées vers votre CMS et les liens de clips vers un calendrier de contenu, c'est du travail de connecteur, et écrire ces connecteurs vous-même ne vous rapporte rien.
L'humain dans la boucle appartient ici aussi. Un Zap qui poste quatre variantes publicitaires dans Slack, attend un pouce levé, puis déclenche l'étape de publication représente vingt minutes de configuration, et c'est la seule chose qui se dresse entre une affirmation produit hallucinée et votre budget social payant.
Là où les médias binaires le défont
Les nœuds sans code passent bien le JSON mais mal les fichiers. Un WAV de 58 minutes doit être découpé en morceaux de 25 Mo ou moins avant que l'endpoint de transcription d'OpenAI ne l'accepte (OpenAI). Un rendu Sora de deux minutes représente jusqu'à six appels d'extension enchaînés de 20 secondes chacun (OpenAI), et l'URL de téléchargement est valide pendant un maximum d'une heure après la génération (OpenAI). La logique de nouvelles tentatives sur six appels avec un compte à rebours sur l'artefact, c'est un programme, pas un canvas.
Deux plateformes gèrent les médias. n8n conserve les fichiers comme données binaires entre les nœuds au lieu de forcer des allers-retours en base64, et son nœud de code se trouve juste à côté des nœuds agents (n8n). Descript expose la transcription, les clips et les sous-titres via une API plutôt qu'une interface graphique (Descript).
La voie du milieu : plateforme pour le flux de contrôle, code pour les octets
Chaque passage écrit dans votre propre bucket et retourne une clé. La plateforme passe des clés et des codes de statut, jamais le fichier. Organiser le travail ainsi réduit aussi le calcul : le système OnePiece rapporte une diminution de 16x de la consommation GPU pour Wan2.1 image-vers-vidéo une fois qu'un pipeline monolithique est décomposé en services étagés (arXiv).
Si vous choisissez des composants, notre répertoire suit 550 agents IA et outils d'orchestration aux côtés de 301 dépôts IA open source. Les dépôts sont là où la glue qui déplace les octets vit généralement, parce qu'aucun fournisseur ne vend cette partie.
Spécifications de livraison : rencontrer la plateforme là où elle publie
Votre dernier passage n'est pas le rendu. C'est l'upload, et l'upload a aussi une fiche de spécifications.
Vidéo : cibles de débit et d'audio pour l'upload
YouTube publie les débits de livraison recommandés par résolution : 8 Mbps pour la 1080p SDR, 16 Mbps en 1440p, et 35–45 Mbps en 4K, avec l'audio livré en AAC-LC, Opus ou Eclipsa à 48 kHz et 384 kbps stéréo (Aide YouTube). Si votre passage vidéo vous remet un fichier bien en dessous de ces chiffres, ne remontez pas le débit à l'export. Vous passerez du temps d'encodage à rembourrer des artefacts de compression. Ce que vous devriez faire, c'est que l'étape d'encodage lise la résolution source et choisisse la cible correspondante, pour qu'un rendu Sora en 1080p ne soit pas forcé dans une échelle 4K parce que quelqu'un l'a codé en dur dans une config il y a six mois.
La cible audio compte plus que la vidéo pour le contenu narré. Une piste AAC à 48 kHz 384 kbps depuis une source à 44,1 kHz implique un rééchantillonnage quelque part, et vous voulez que ce rééchantillonnage se produise une fois, dans votre propre appel ffmpeg, là où vous pouvez le voir.
Audio : préconditionnement de la sonie avant l'encodage
Apple Podcasts demande -16 dB LKFS ±1 dB avec un pic réel à ou en dessous de -1 dB FS, mesuré selon ITU-R BS.1770-5, et précise que l'audio doit être préconditionné à cette cible avant l'encodage (Apple Podcasts for Creators). C'est un ordre des opérations, pas une préférence. Normaliser un MP3 terminé signifie que vous poussez du gain à travers des artefacts avec perte qui ont été cuits à un niveau différent, et le pic réel sur un MP3 décodé peut déjà dépasser ce que l'encodeur a vu. Mettez le passage de sonie sur le WAV, puis encodez.
C'est pourquoi le niveau de format TTS mentionné plus tôt dans la chaîne reste important. Donner à votre normaliseur un MP3 à 128 kbps est un moins bon point de départ que lui donner du PCM, et aucun soin en aval ne le corrige.
Provenance et étiquetage des actifs générés
Décidez de la provenance pendant que vous concevez le pipeline, pas après qu'une plateforme vous le demande. Le filigrane SynthID de Google marque les médias générés au moment de la création, ce qui signifie qu'il voyage avec l'actif seulement si votre pipeline ne le supprime pas ou ne le ré-encode pas. Chaque passage ffmpeg entre la génération et l'upload est une occasion de perdre ce signal, donc tracez quel passage a introduit le fichier et gardez un enregistrement du modèle, du prompt et de l'horodatage dans votre propre magasin de métadonnées plutôt que de compter sur le conteneur pour le porter.
Construire pour le remplacement : la falaise de dépréciation sous chaque passage vidéo
Si votre passage vidéo appelle Sora, il vous reste 19 jours. OpenAI a annoncé le 24 mars 2026 que l'API Videos et les modèles sora-2 et sora-2-pro s'arrêtent le 24 septembre 2026, instantanés sora-2-2025-10-06, sora-2-2025-12-08 et sora-2-pro-2025-10-06 inclus, sans modèle de remplacement recommandé listé (déprécations OpenAI). Une colonne de remplacement vide signifie que vous choisissez le successeur vous-même, et vous le choisissez avant la date limite, pas après.
Abstraire le passage pour qu'un remplacement soit un changement de configuration
La correction est un adaptateur mince par passage génératif. Votre pipeline remet à l'adaptateur une tâche normalisée : prompt, chemin d'image de référence, résolution cible, durée en secondes, clé de bucket de sortie. L'adaptateur possède tout ce qui est spécifique au fournisseur. La règle de Sora selon laquelle l'image de référence doit correspondre exactement à la résolution vidéo, ses clips de 16 et 20 secondes étendus par étapes de 20 secondes jusqu'à un plafond de 120 secondes, son expiration de téléchargement d'1 heure (génération vidéo OpenAI). Rien de tout cela ne fuite dans votre code d'orchestration.
Alors changer de fournisseur est une valeur de configuration, pas une réécriture. Validez un deuxième adaptateur contre la documentation des modèles Runway maintenant, faites tourner les deux sur les dix mêmes prompts, et gardez le perdant en veille.
Les familles image et audio ont leurs propres dates, alors traitez cela comme une maintenance récurrente plutôt qu'une urgence ponctuelle. Notre répertoire existe en partie pour vous permettre de suivre les sorties et suppressions de modèles parmi 324 modèles référencés.
Une liste de contrôle de migration pour les pipelines en production aujourd'hui
- Grep chaque dépôt et JSON de workflow pour
sora-2,sora-2-proet le chemin de base de l'API Videos. Incluez les tâches cron et les scripts ponctuels, c'est là que vivent les appels oubliés. - Enveloppez chaque occurrence dans un adaptateur avec votre propre schéma de tâche avant de changer de fournisseur, pour que le remplacement et le refactoring ne soient pas le même commit.
- Faites tourner le fournisseur alternatif sur dix vrais prompts et comparez les sorties sur la résolution, la durée des clips et la qualité du mouvement.
- Épinglez un rappel calendrier deux semaines avant chaque date de suppression publiée, par fournisseur, par famille de modèles.
- Loggez l'ID du modèle et l'instantané sur chaque rendu pour pouvoir répondre à « qu'est-ce qui a généré cet actif » après la disparition du modèle.
Questions fréquemment posées
Qu'est-ce qu'un workflow IA multimodal, en termes pratiques ?
C'est une chaîne d'appels API où le fichier de sortie d'un modèle devient le fichier d'entrée du suivant, et chaque passage a un contrat de format que vous devez respecter. Une chaîne typique va de la transcription au script, puis à l'image fixe, à la vidéo, à la voix off, au rendu final, et chaque flèche est un endroit où une mauvaise résolution ou un codec incorrect casse l'exécution. Le passage image-vers-vidéo de Sora est un bon exemple de la littéralité de ces contrats : l'image de référence doit correspondre exactement à la résolution vidéo cible et être en image/jpeg, image/png ou image/webp, donc l'étape image en amont a besoin des dimensions en pixels de l'étape vidéo, pas seulement d'un ratio d'aspect (documentation de génération vidéo OpenAI). Pensez au pipeline comme un ensemble de transferts plutôt qu'un ensemble d'outils.
Comment enchaîner les outils IA sans perdre de qualité entre les étapes ?
Fixez la spécification de sortie à chaque passage en fonction de ce que la dernière étape de la chaîne a besoin, puis travaillez à rebours. La perte de qualité vient généralement d'un niveau tarifaire ou d'un paramètre par défaut plutôt que du modèle : ElevenLabs met pcm_44100, pcm_48000, wav_44100 et wav_48000 derrière un abonnement Pro et mp3_44100_192 derrière le niveau Creator, donc un compte d'entrée de gamme remet à votre éditeur un MP3 avec perte que vous le vouliez ou non (référence de création de parole ElevenLabs). Copiez chaque artefact généré dans votre propre stockage objet immédiatement, car les URL de téléchargement de Sora sont valides pendant un maximum d'une heure après la génération (documentation de génération vidéo OpenAI). Le taux d'échantillonnage est aussi un levier de coût, pas seulement de qualité : Claude facture un frame 4K à 4 784 tokens visuels sur le niveau haute résolution contre 1 560 en standard, soit environ 23,92 $ par millier de frames 4K au tarif d'entrée de 5 $/M de Opus 5 (documentation vision Claude).
Quel format audio dois-je transmettre d'une étape texte-vers-parole à un éditeur vidéo ?
Du WAV ou PCM non compressé à 48 kHz, ce qui sur ElevenLabs signifie wav_48000 ou pcm_48000 et un abonnement Pro ou supérieur (référence de création de parole ElevenLabs). Remettre à un éditeur un MP3 à 128 kbps cuit des artefacts de compression qui survivent à chaque encodage ultérieur. Si la destination est YouTube, la cible de livraison finale est AAC-LC, Opus ou Eclipsa à 48 kHz et 384 kbps stéréo (paramètres d'encodage d'upload YouTube), et si c'est un flux de podcast, Apple veut la sonie préconditionnée à -16 dB LKFS ±1 dB avec un pic réel à ou en dessous de -1 dB FS, mesuré selon ITU-R BS.1770-5, avant l'encodage (exigences audio Apple Podcasts). Vous ne pouvez pas atteindre l'une ou l'autre cible de manière fiable à partir d'un intermédiaire avec perte.
Pourquoi ma transcription de podcast échoue-t-elle sur les épisodes complets ?
L'endpoint de transcription d'OpenAI plafonne les uploads à 25 Mo et accepte mp3, mp4, mpeg, mpga, m4a, wav et webm, donc tout ce qui dépasse environ une demi-heure à un débit correct doit être découpé en morceaux de 25 Mo ou moins (documentation speech-to-text OpenAI). C'est pourquoi les pipelines long format routent généralement la transcription loin du fournisseur LLM : AssemblyAI accepte jusqu'à 5 Go par requête sur /v2/transcript (2,2 Go pour les uploads locaux) et des fichiers de 160 ms à 10 heures, environ 200 fois le plafond d'OpenAI (documentation audio pré-enregistré AssemblyAI). Deux autres modes d'échec ressemblent à un succès : la diarisation des locuteurs retourne silencieusement du texte sans label sauf si vous réglez chunking_strategy sur 'auto' pour l'audio de plus de 30 secondes, et la sortie SRT/VTT ainsi que timestamp_granularities[] ne fonctionnent que sur whisper-1, pas sur gpt-transcribe ou gpt-4o-transcribe (documentation speech-to-text OpenAI). Si vous avez besoin d'horodatages au niveau du mot pour la découpe automatique de clips, ElevenLabs Scribe v2 les fournit dans plus de 90 langues avec la diarisation (modèles ElevenLabs).
Dois-je construire un pipeline de contenu IA dans n8n ou Zapier, ou écrire le code moi-même ?
Écrivez du code pour tout passage qui déplace des médias binaires, et utilisez une plateforme d'automatisation pour les déclencheurs, approbations et notifications autour. La force de Zapier est sa largeur, avec plus de 9 000 intégrations d'applications déclarées par le fournisseur en plus des Zaps, Tables, Forms et Zapier MCP (plateforme développeur Zapier), ce qui est exactement ce que vous voulez pour « nouvelle ligne dans Airtable, lancer le rendu, poster le lien dans Slack ». C'est le mauvais niveau pour un MP4 de 200 Mo avec une URL expirante d'une heure. n8n se situe entre les deux, puisque ses nœuds agents et sa gestion de passage binaire vous permettent de garder les fichiers dans le workflow (documentation Tools Agent n8n), et il y a un vrai argument d'infrastructure pour diviser la chaîne en étapes plutôt qu'un seul monolithe : le paper OnePiece rapporte une diminution de 16x de la consommation GPU en décomposant un pipeline AIGC en microservices étagés pour Wan2.1 image-vers-vidéo (arXiv).
Qu'est-ce qui remplace Sora dans un pipeline vidéo après la fermeture de septembre 2026 ?
OpenAI a annoncé le 24 mars 2026 que l'API Videos et les modèles sora-2 et sora-2-pro (instantanés sora-2-2025-10-06, sora-2-2025-12-08 et sora-2-pro-2025-10-06) s'arrêtent le 24 septembre 2026, et ne liste aucun modèle de remplacement recommandé (déprécations OpenAI). Au 5 septembre 2026, il reste 19 jours, donc la démarche pratique est de mettre votre passage vidéo derrière une interface mince aujourd'hui et de le pointer vers un autre fournisseur, avec l'API Runway comme le remplacement le plus direct à évaluer (documentation des modèles Runway). Prévoyez aussi une réécriture de votre logique de découpage, car les limites de Sora ont façonné beaucoup de pipelines : clips de 16 et 20 secondes, jusqu'à 20 secondes ajoutées par extension, et un maximum de 120 secondes sur jusqu'à six extensions, ce qui a rendu un segment narré de deux minutes en six appels enchaînés (documentation de génération vidéo OpenAI). Si vous cherchez des alternatives, notre répertoire suit actuellement 452 outils sous Générateurs Vidéo IA.