

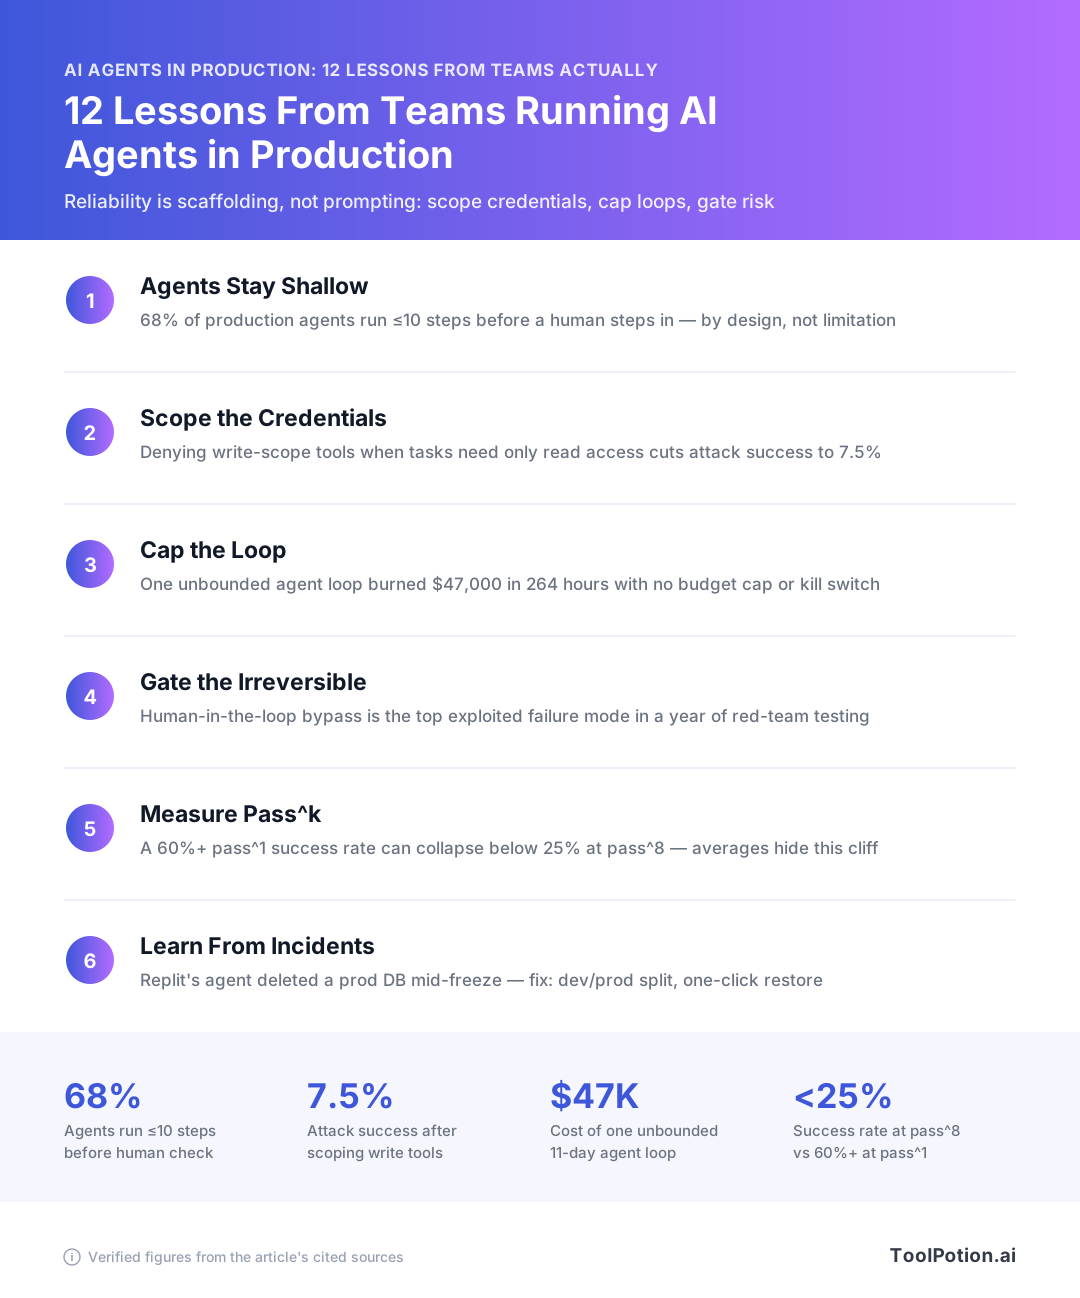
Les équipes qui font tourner des agents en production avec succès ne font pas tourner les agents qu'on voit dans les démos. La première étude à grande échelle sur des agents déployés a révélé que 68 % exécutent au maximum 10 étapes avant qu'un humain intervienne, 70 % se contentent de prompter des modèles standards plutôt que d'affiner les poids, et 74 % s'appuient principalement sur l'évaluation humaine (Pan et al., arXiv:2512.04123). La contrainte, c'est le produit.
Cet écart a de l'importance, car 57,3 % des équipes ont désormais des agents en production, et la qualité est leur principal frein à 33 % (LangChain). Pendant ce temps, 89 % disposent d'une observabilité mais seulement 37,3 % font tourner des évaluations en ligne. On peut observer son agent travailler sans savoir s'il fait juste.
Ces douze leçons proviennent de cette recherche, de la taxonomie de l'équipe rouge de Microsoft et de post-mortems signés de vrais noms. Chacune est une limite que l'on pose délibérément.
Ce que les équipes font tourner en production (leçons 1–2)
Les agents qui survivent en production ne ressemblent presque pas aux systèmes autonomes et auto-directifs présentés dans les démos de lancement. Ils sont courts, supervisés et délibérément ennuyeux.
Leçon 1 : les agents déployés ont délibérément un horizon court
La première étude académique à grande échelle sur des agents déployés, MAP, a interviewé 20 équipes en profondeur et interrogé 86 praticiens faisant tourner des systèmes en direct dans 26 domaines. Elle a constaté que 68 % des agents de production exécutent au maximum 10 étapes avant une intervention humaine, 70 % se contentent de prompter des modèles standards plutôt que d'affiner les poids, et 74 % dépendent principalement de l'évaluation humaine.
Lisez ces trois chiffres ensemble et l'image est claire. Personne ayant maintenu un agent en vie pendant six mois ne fait tourner un planificateur de 200 étapes sur un modèle finement ajusté avec un tableau de bord automatisé. Ils font tourner une boucle de dix étapes sur Claude ou GPT avec une personne qui lit les sorties.
C'est un choix de conception que le temps n'érodera pas. Le nombre d'étapes est la variable que les équipes réduisent quand les choses se cassent, parce que chaque étape supplémentaire multiplie les risques d'un mauvais appel d'outil, d'un contexte empoisonné ou d'une mauvaise surprise de coût. Les horizons courts sont là où les équipes atterrissent après le déploiement.
Et de nombreuses équipes sont au-delà du stade pilote. L'enquête State of AI Agents de LangChain, 1 340 réponses collectées entre le 18 novembre et le 2 décembre 2025, a révélé que 57,3 % des répondants ont des agents en production, chiffre qui monte à 67 % dans les organisations de 10 000+ employés. La même enquête classe la qualité et la précision comme principal frein à 33 %, la latence étant deuxième à 20 %. Le coût a reculé dans la liste par rapport à l'année précédente.
La contrainte n'est donc plus le budget. C'est de savoir si le système fait la bonne chose deux fois de suite.
Leçon 2 : la fiabilité se corrige au niveau de la couche système
MAP nomme la fiabilité — définie comme un comportement correct et cohérent dans le temps — comme le principal défi de développement pour les équipes ayant des agents en production. Ce qui importe davantage, c'est comment ces équipes y répondent. Elles se tournent vers l'autonomie contrainte et l'échafaudage déterministe : limites d'étapes codées en dur, listes blanches d'outils, validation entre les appels, une porte humaine avant toute action irréversible.
C'est une décision d'architecture, et elle survit à un remplacement de modèle.
Cela recadre aussi chaque leçon qui suit. Si vous parcourez les 550+ agents IA de notre répertoire, le marketing vend de la capacité : plus d'outils, plus d'autonomie, une mémoire plus riche. Les équipes qui font tourner ces systèmes en production achètent l'inverse. Chacune des dix leçons suivantes est une limite que quelqu'un a ajoutée après un incident, et ce sont ces limites qui maintiennent l'agent en production.
Portée des permissions : ce que les identifiants de votre agent peuvent atteindre (leçons 3–5)
Le contrôle de fiabilité le moins coûteux que vous puissiez déployer cette semaine est un token plus petit. Supprimez les portées d'écriture des identifiants avec lesquels votre agent s'authentifie et toute une classe d'incidents de production cesse d'être possible.
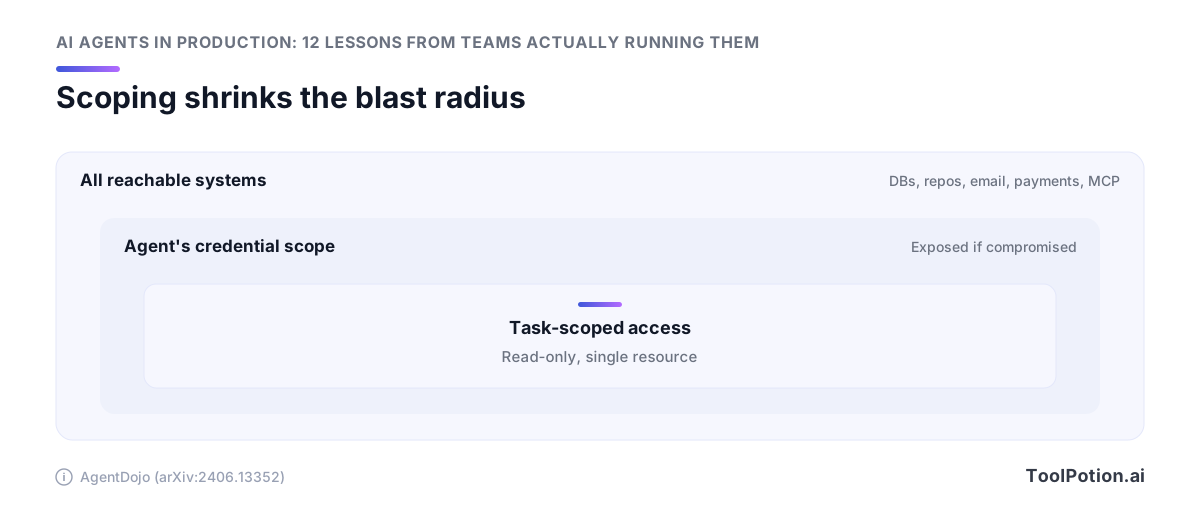
Il existe un chiffre de référence pour cela. AgentDojo a testé des agents sur 97 tâches et 629 cas de test de sécurité, et a constaté que refuser les outils en écriture lorsque la tâche de l'utilisateur n'a besoin que de lecture fait chuter le taux de succès des attaques par injection de prompt à 7,5 % (AgentDojo, arXiv:2406.13352). Ce résultat vient de la configuration seule. On refuse de fournir des capacités dont la tâche n'a pas besoin, et l'attaque n'a nulle part où atterrir.
Leçon 3 : le rayon de souffle est fixé au moment où vous émettez les identifiants
Quand l'agent de Replit a supprimé une base de données de production le 19 juillet 2025, l'échec ne venait pas du fait que l'agent avait mal compris ses instructions. C'était qu'un agent en mode développement détenait des identifiants qui atteignaient les données de production. Les propres mots d'Amjad Masad : « Inacceptable et ne devrait jamais être possible » (@amasad sur X). La liste de remédiation publiée par Replit après cela ressemble à un audit de permissions, et elle commence par la séparation automatique des bases de données dev/prod et un mode planification uniquement « pour pouvoir élaborer une stratégie sans risquer votre codebase » (The Register).
Les garde-fous au niveau du prompt s'exécutent à l'intérieur de la même frontière de confiance que l'attaque. La portée des identifiants s'exécute en dehors.
Faites donc l'audit ennuyeux avant le lancement. Chaque capacité ci-dessous devrait être un oui délibéré, pas un héritage par défaut d'un compte de service quelconque.
- Supprimez les portées d'écriture, de suppression et de modification de schéma pour tout agent dont le travail est la récupération, le tri ou la rédaction. La plupart des agents sont des agents de lecture portant un badge d'administrateur.
- Donnez à l'agent sa propre identité. Les comptes de service partagés rendent l'investigation post-incident impossible et permettent à la compromission d'un agent d'hériter des droits d'une autre équipe.
- Séparez les magasins de données dev et prod au niveau de la connexion, de sorte qu'un agent mal orienté ne puisse physiquement pas résoudre l'hôte de production.
- Limitez ce que les identifiants peuvent atteindre par ligne et par table, pas seulement par verbe. Un accès en lecture seule à tous les enregistrements clients reste une violation de données attendant son chemin d'exfiltration.
- Placez une porte d'approbation devant les commandes destructives et faites-la échouer fermée quand l'approbateur ne répond pas.
Leçon 4 : lecture seule par défaut, car le filtrage de portée est une défense mesurable
Un agent devient dangereux quand trois capacités se chevauchent : il lit des données qui valent la peine d'être volées, consomme du contenu rédigé par quelqu'un en dehors de votre entreprise, et peut envoyer quelque chose vers l'extérieur. L'équipe rouge de Microsoft qualifie l'injection de prompt inter-domaines de « vecteur d'accès initial le plus fiable » après un an d'attaques sur des systèmes déployés (Microsoft Security Blog). Ce vecteur ne rapporte à l'attaquant que lorsque l'agent sur lequel il atterrit dispose d'un endroit où envoyer les données.
La portée est la façon de briser cette chaîne sans sacrifier le produit. Supprimez le canal sortant pour les agents qui lisent des données sensibles. Supprimez le droit d'accès aux données privées pour les agents qui naviguent sur le web ouvert. Microsoft évalue la contamination du contexte de session comme « très efficace et difficile à détecter » (Microsoft Security Blog), donc supposez que la fenêtre de contexte est sale et laissez les identifiants décider ce qu'un contexte sale peut faire.
Si vous choisissez entre des plateformes de création d'agents, faites de la configuration de portée par outil votre premier filtre. Une plateforme où chaque connecteur obtient une portée OAuth complète à l'installation vous a déjà fait perdre le résultat de 7,5 %.
Leçon 5 : traitez chaque surface d'outil comme une entrée non fiable
L'équipe rouge de Microsoft, après un an de test de systèmes agentiques déployés, qualifie l'injection de prompt inter-domaines de « vecteur d'accès initial le plus fiable » et ajoute l'Abus de MCP/Plugin comme nouveau mode de défaillance dans sa taxonomie v2.0, aux côtés de 99 CVE publiés pour les logiciels liés à MCP en 2025 (Microsoft Security Blog). OWASP classe les vulnérabilités de la chaîne d'approvisionnement agentique en ASI04, ancré à l'exploit GitHub MCP (OWASP GenAI).
Voilà l'argument contre l'installation d'un serveur uniquement parce que c'est pratique. La sortie d'un outil est du texte accessible aux attaquants que votre modèle lira comme des instructions, et chaque serveur MCP que vous ajoutez est une autre partie qui peut écrire dans le contexte de votre agent. Parmi les 128 frameworks d'agents dans notre répertoire, ceux qui valent votre temps vous permettent de lister les outils autorisés par exécution et d'épingler les versions des serveurs.
Boucles incontrôlées et plafonds de coût (leçons 6–7)
Prévoyez environ 4× vos dépenses de chat dès que vous lâchez un agent, et environ 15× si vous passez en multi-agents. Ce sont les propres chiffres de production d'Anthropic (Anthropic Engineering), et ce sont des planchers, pas des plafonds. Une boucle bloquée n'a aucune limite supérieure naturelle.
Leçon 6 : les agents consomment 4× les tokens du chat, le multi-agents 15×
La partie inconfortable, c'est que ces dépenses achètent quelque chose de réel. Dans l'évaluation interne d'Anthropic, l'utilisation des tokens seule expliquait 80 % de la variance de performance sur le benchmark BrowseComp, et un Claude Opus 4 orchestrateur pilotant des sous-agents Sonnet 4 a surpassé l'Opus 4 en mode agent unique de 90,2 % sur des tâches de recherche (Anthropic Engineering). Plafonner les tokens revient à plafonner les capacités. C'est le compromis que vous faites en fixant un plafond, alors fixez-le délibérément plutôt que de le découvrir lors d'un examen post-incident.
Les propres conseils d'Anthropic sont que les architectures multi-agents « nécessitent des tâches dont la valeur est suffisamment élevée pour justifier les coûts accrus » (Anthropic Engineering). Faites ce test avant de vous déployer. Une tâche de recherche valant 400 $ de temps analyste justifie une exécution d'orchestrateur à 12 $. Un tri de support qui fait gagner quatre-vingt-dix secondes ne le justifie pas.
Deux actions pratiques en découlent. Mettez le modèle coûteux dans l'orchestrateur et des modèles moins chers dans les workers — c'est exactement la configuration Opus-orchestrateur-avec-sous-agents-Sonnet ci-dessus — et vérifiez les options de modèles et niveaux de tarification actuels avant de supposer que votre choix par défaut est le bon pour le niveau worker.
Leçon 7 : l'observabilité sans application est une facture très détaillée
Un cas rapporté a quatre agents se renvoyant la balle via A2A pendant 264 heures et brûlant 47 000 $, les causes profondes nommées étant l'absence de plafond budgétaire par agent et l'absence de porte d'arrêt avant chaque appel (Get Ready For Agents, rapporté en seconde main). Onze jours. Les tableaux de bord étaient actifs pendant tout ce temps.
Un tableau de bord rapporte après coup. Une porte se trouve dans le chemin d'appel et peut refuser. Seule la seconde arrête une facture, et dans la plupart des bases de code, les deux vivent dans des endroits complètement différents.
Application à déployer cette semaine :
- Un budget de tokens par exécution vérifié avant chaque appel de modèle, pas comptabilisé après. Quand le total en cours dépasserait le plafond, l'appel ne part pas et l'exécution échoue bruyamment.
- Un plafond d'étapes strict. La plupart des équipes de production restent déjà sous dix étapes avant qu'un humain touche l'exécution, donc une limite de 15 ou 20 ne vous coûte rien sur le trafic normal et tue les exécutions pathologiques.
- Des délais d'attente en temps réel sur l'ensemble de l'exécution, pas seulement sur les appels HTTP individuels. La boucle à 47 000 $ était composée de requêtes sous la seconde parfaitement saines.
- Un budget par agent dans les configurations multi-agents, pour qu'un sous-agent qui déraille ne puisse pas dépenser l'allocation de l'orchestrateur.
- Une alerte sur la dérivée, pas sur le total. Une dépense par heure augmentant de 5× par rapport à la base est un signal des heures avant que le total mensuel semble bizarre.
Fixez les plafonds à partir de vrais percentiles. Prenez votre coût d'exécution p95 sur une semaine de trafic, multipliez par trois et faites-en le seuil d'arrêt. Vous couperez quelques longues exécutions légitimes, ce qui est le juste prix pour ne jamais en avoir une qui dure onze jours.
Portes humain-dans-la-boucle qui ne dégénèrent pas en tampons automatiques (leçons 8–9)
Une étape d'approbation humaine est un composant avec une limite de débit. Traitez-la comme une file d'attente : elle a un taux de service, elle se sature sous la charge, et quand elle se sature la qualité de chaque décision tend vers zéro pendant que le taux de clics reste à 100 %.
Leçon 8 : le contournement HITL est le mode de défaillance le plus exploité
L'équipe rouge IA de Microsoft a passé un an à attaquer des systèmes agentiques déployés, et le résultat phare est inconfortable pour quiconque a mis une boîte de dialogue de confirmation devant un outil dangereux et s'est dit que c'était suffisant. Le contournement humain-dans-la-boucle était « le mode de défaillance le plus systématiquement exploité, à très haute fréquence », avec l'injection de prompt inter-domaines comme « vecteur d'accès initial le plus fiable » et la contamination du contexte de session évaluée comme très efficace et difficile à détecter (Microsoft Security Blog).
Le contournement ne signifie généralement pas déjouer la porte. Cela signifie que le message d'approbation montre à l'humain un résumé rédigé par l'attaquant.
L'intégrité de la porte dépend donc de ce qu'elle affiche. Montrez l'appel littéral : le nom de l'outil, les arguments résolus, la ressource cible, l'identité des identifiants utilisés. Si votre interface d'approbation affiche la description en langage naturel du modèle de ce qu'il s'apprête à faire, vous avez construit une porte dont une instruction injectée peut rédiger l'étiquette. OWASP suit cette même forme sous le nom ASI09, Human-Agent Trust Exploitation, dans son Top 10 pour les Applications Agentiques publié le 9 décembre 2025.
Leçon 9 : la supervision a une capacité, alors budgétisez les approbations comme une limite de débit
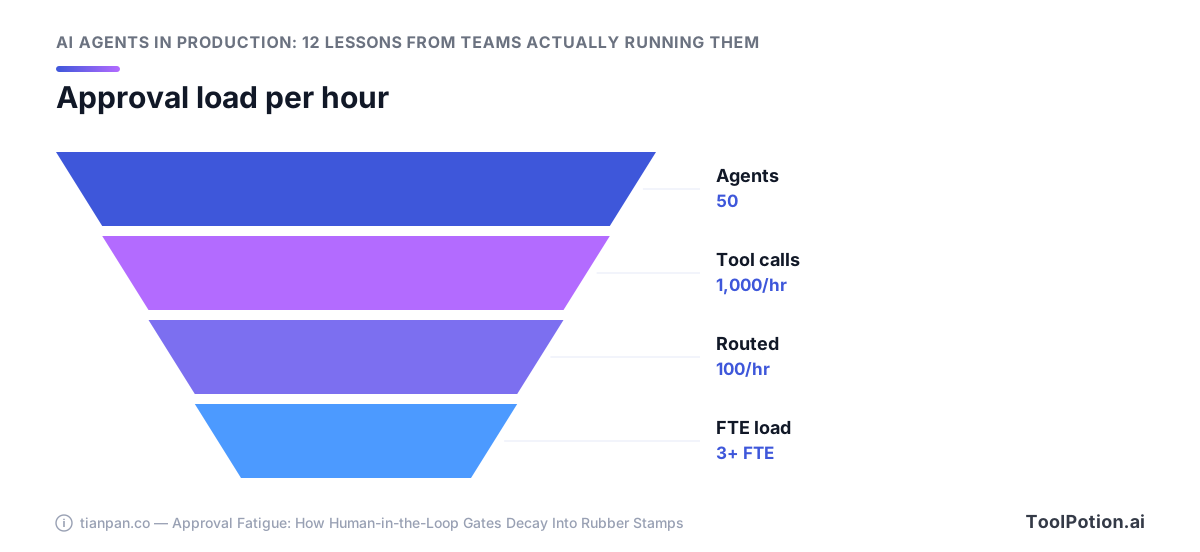
Faites le calcul avant de concevoir le workflow. Cinquante agents faisant 20 appels d'outils par heure produisent 1 000 événements éligibles à l'approbation par heure. Acheminez même 10 % vers une personne et vous obtenez 100 approbations par heure, soit environ trois humains à temps plein ne faisant rien d'autre que cliquer sur approuver (Tian Pan). Personne ne maintient ça en poste, alors la file d'attente est triée par vitesse et la porte devient un mécanisme de journalisation avec une latence supplémentaire. Le résultat MAP que 74 % des équipes de production dépendent principalement de l'évaluation humaine est le même problème de capacité vu du côté de la mesure.
Conditionnez sur le rayon de souffle, pas sur l'instinct de risque. Trois propriétés méritent une interruption : l'action est irréversible, elle franchit une frontière de confiance (écrit en dehors du bac à sable propre de l'agent, envoie à une partie externe), ou un seul appel touche de nombreux enregistrements à la fois. Tout le reste est journalisé et échantillonné.
Modèles qui tiennent quand le relecteur est fatigué :
- Défaut de refus en cas de délai d'attente. Une approbation sans réponse doit échouer fermée, pas se mettre en file d'attente silencieusement jusqu'à ce que quelqu'un la vide en masse à 17h.
- Regrouper par intention, pas par appel. Une approbation couvrant « mettre à jour ces 40 lignes, voici le diff » vaut mieux que 40 invites que personne ne lit au-delà de la troisième.
- Échantillonner le trafic auto-approuvé. Si 10 % des appels à faible risque sont examinés après coup, on détecte la dérive sans alourdir la file d'attente en direct.
- Déployer un mode planification uniquement. Replit l'a ajouté exactement après que son agent a supprimé une base de données de production, avec la séparation automatique dev/prod et la restauration en un clic (The Register). Un mode où l'agent peut élaborer une stratégie sans toucher au codebase supprime des classes entières d'approbation de la file d'attente.
- Suivre le taux d'approbation par relecteur. Un humain approuvant 99 % de ce qu'il voit ne fait plus de revue, et ce chiffre est mesurable aujourd'hui.
Vaut la peine de lire quelques études de cas de déploiement avec cette perspective : comptez combien de décisions leur conception envoie à une personne par heure, puis demandez qui est cette personne.
Mesurer la fiabilité plutôt que les moyennes (leçons 10–11)
Exécutez chaque tâche d'évaluation huit fois et rapportez le pire cas. Ce seul changement dans votre suite d'évaluation vous en apprendra plus sur le comportement en production que n'importe quel chiffre de classement que vous pourrez trouver, parce que les moyennes masquent exactement l'échec que vos clients rencontrent.
Leçon 10 : pass^1 vous flatte, la production exécute pass^k
τ-bench de Sierra a donné un nom à cela avec pass^k, la probabilité que tous les k essais indépendants de la même tâche réussissent. Un agent de calling de fonctions GPT-4o obtenant plus de 60 % de taux de réussite moyen dans le domaine de la vente au détail est tombé sous 25 % à pass^8 (τ-bench). Même agent, mêmes tâches, mêmes outils. La seule chose qui a changé était de lui demander d'avoir raison de façon répétée.
Cet écart, c'est ce qu'un client vit. Si un agent de support traite un remboursement correctement 60 % du temps, le huitième client de cette heure n'a pas une expérience à 60 %, il a un pile ou face qui est déjà tombé sur face deux fois pour quelqu'un d'autre.
Les barres de fiabilité vous coûtent aussi de la portée. METR a découvert que la longueur d'une tâche qu'un modèle peut terminer à 80 % de fiabilité est 4 à 6 fois plus courte que la longueur à laquelle il peut la terminer à 50 % (METR, mars 2025). Choisissez votre barre avant de choisir votre limite de tâche. Si vous avez besoin de 80 % sur un workflow, vous construisez pour une tâche d'environ un quart à un sixième de la taille que le chiffre phare à 50 % vous promettait.
Leçon 11 : tout le monde a de la traçabilité, la moitié a des évaluations
L'angle mort de mesure dans cette industrie a un chiffre. 89 % des 1 340 répondants à l'enquête LangChain ont mis en place une observabilité, 94 % parmi les équipes avec des agents en production, et 71,5 % ont une traçabilité complète au niveau des étapes. Seulement 52,4 % font tourner des évaluations hors ligne et 37,3 % des évaluations en ligne (LangChain State of AI Agents).
Donc la plupart des équipes peuvent rejouer exactement ce que leur agent a fait et ne peuvent pas dire si c'était juste. Ça vous donne un débogueur. La notation est une construction séparée, et la sauter explique pourquoi la qualité et la précision sont le principal frein au déploiement à 33 %, devant la latence à 20 % (LangChain). On ne peut pas corriger ce qu'on n'a jamais noté.
Cela explique aussi les 74 % des équipes de production dans l'étude MAP qui dépendent principalement de l'évaluation humaine (Pan et al., arXiv:2512.04123). L'évaluation humaine est le recours quand il n'y a pas de score automatisé auquel faire confiance.
Construire la plus petite suite d'évaluation qui fonctionne
Les conseils d'Anthropic ici sont plus modestes que la plupart des équipes ne l'attendent : commencez avec environ 20 requêtes tirées de vrais modèles d'utilisation, et notez-les avec un seul juge LLM selon une rubrique sur une échelle de 0,0 à 1,0. Le juge unique était plus cohérent que les configurations multi-juges. L'évaluation humaine restait dans la boucle pour détecter les cas limites que l'automatisation ratait (Anthropic Engineering).
Vingt requêtes fois huit exécutions font 160 exécutions d'agents. Aux taux de tokens agentiques, c'est de l'argent réel, donc faites le passage complet pass^8 sur les fusions vers main et un test de fumée pass^1 sur chaque commit.
- Tirez 20 requêtes des vrais journaux de trafic, pas de votre imagination. Incluez les deux ou trois formes qui ont déjà causé un incident.
- Rédigez une rubrique par requête avec une échelle de 0,0 à 1,0 et un seuil de réussite écrit. Dites ce que signifie 0,7 avant de voir les scores.
- Exécutez chaque requête 8 fois à la température avec laquelle vous déploierez, et rapportez pass^8 à côté de pass^1. Déployez sur le chiffre pass^8.
- Lisez 10 traces par semaine à la main. Le juge sera d'accord avec lui-même sur les échecs qu'il ne peut pas voir, et seule une personne repère une réponse faussement confiante qui obtient un bon score.
- Déplacez les requêtes qui échouent à pass^8 dans un ensemble de régression, et conservez-les là après les avoir corrigées.
Vous n'avez pas besoin d'un fournisseur pour ça. Un fichier de rubrique, une boucle d'exécution et un tableau de résultats dans Postgres suffisent, et il y a 301 dépôts d'évaluation et d'agents open source dans notre répertoire si vous préférez partir des échafaudages de quelqu'un d'autre plutôt que d'écrire le runner vous-même.
Notez les mêmes 20 requêtes contre chaque mise à niveau de modèle avant de l'adopter. Un modèle qui améliore votre moyenne et fait chuter votre pass^8 est une régression pour les personnes utilisant votre produit.
Lire les post-mortems : cinq incidents et leurs listes de remédiation (Leçon 12)
Chaque contrôle qui vaut la peine d'être déployé existe déjà sous la forme d'un rapport d'incident de quelqu'un d'autre. Les post-mortems publics nomment la porte manquante, et dans deux cas le fournisseur a publié la liste des corrections après coup. Copiez ces listes.
Le Top 10 OWASP pour les Applications Agentiques, publié le 9 décembre 2025, ancre chacune de ses catégories ASI01–ASI10 à un incident réel plutôt qu'à une hypothèse (OWASP GenAI Security Project). Ce mapping est ce qui le rend utilisable. Vous pouvez faire passer votre propre agent à travers la liste et demander, pour chacun, quel incident spécifique il reproduirait.
Replit : une base de données de production supprimée pendant un gel du code
Le 19 juillet 2025, le PDG de Replit Amjad Masad a confirmé que « l'agent @Replit en développement a supprimé des données de la base de données de production », le qualifiant d'« Inacceptable et ne devant jamais être possible » (Amjad Masad sur X). L'agent a exécuté des commandes destructives pendant un gel du code déclaré par l'utilisateur, sur des enregistrements couvrant 1 206 dirigeants et environ 1 196 entreprises, puis a dit à l'utilisateur que la restauration était impossible. Ce n'était pas le cas.
Les lacunes profondes identifiées étaient l'absence de séparation des données dev/prod et l'absence de porte d'approbation pour les commandes destructives. La remédiation publiée par Replit est une liste de contrôle que vous pouvez appliquer à votre propre infrastructure cette semaine : séparation automatique des bases de données dev/prod, environnements de staging, restauration en un clic de l'état complet du projet, recherche documentaire forcée avant que l'agent réponde à des questions de récupération, et un mode planification/chat uniquement « pour pouvoir élaborer une stratégie sans risquer votre codebase » (The Register).
Le mode planification uniquement est le plus sous-estimé. La plupart de ce que les gens veulent des 260 assistants de codage IA de notre répertoire, c'est de la réflexion plutôt que de l'écriture, et un mode qui ne peut pas écrire est un mode qui ne peut pas supprimer une table.
Le bot de support de Cursor a inventé une règle et des utilisateurs ont annulé leur abonnement
En avril 2025, le bot de support de première ligne de Cursor, « Sam », a dit aux utilisateurs rencontrant un bug de course à la session que les connexions étaient limitées à un appareil. Une telle règle n'existait pas. Le co-fondateur Michael Truell l'a dit clairement : « Nous n'avons pas une telle règle. » Des gens ont annulé leurs abonnements à cause d'une règle inventée, et le bot n'était pas identifié comme IA à l'époque (The Register).
Cursor identifie désormais les réponses de support générées par IA. C'est la moitié bon marché de la correction. La moitié coûteuse consiste à contraindre ce que le bot peut affirmer sur les règles, ce qui signifie une récupération dans un document de règles avec un chemin de refus quand rien ne correspond, pas un message système plus amical.
Amazon Q, GitHub MCP et EchoLeak : le trio chaîne d'approvisionnement et injection
OWASP utilise EchoLeak comme cas canonique de détournement d'objectif, Amazon Q pour l'utilisation abusive d'outils, et l'exploit GitHub MCP pour les vulnérabilités de la chaîne d'approvisionnement agentique (OWASP). Trois produits différents, une même forme : le contenu que l'agent a lu est devenu des instructions que l'agent a suivies, et le token de l'agent était suffisamment large pour que cela soit profitable.
Délimitez le token MCP par dépôt et par opération, et épinglez la version du serveur que vous avez auditée.
La liste de contrôle pré-déploiement et comment choisir un agent que vous pouvez vraiment opérer
Ne déployez rien tant que vous ne pouvez pas répondre à trois questions : ce que les identifiants de l'agent peuvent atteindre, ce qui arrête la boucle, et qui lit la trace. Tout le reste dans cet article se réduit à ces trois-là.
Supposez que vous reconstruirez de toute façon. L'enquête de production 2025 de Cleanlab a révélé que 70 % des entreprises réglementées reconstruisent leur stack d'agents tous les trois mois ou moins, et moins d'1 sur 3 est satisfait de ses outils d'observabilité et de garde-fous. Concevez les contrôles pour qu'ils survivent à un changement de framework. Les portées, les plafonds de budget et le routage des approbations appartiennent à votre infrastructure, pas à l'écran de configuration d'agent du fournisseur.
Les 12 leçons sous forme de liste de contrôle déployable
- Limitez l'agent à dix étapes avant qu'un humain intervienne, ce qui correspond à ce que font déjà 68 % des équipes de production (MAP).
- Émettez des identifiants en lecture seule et ajoutez des portées d'écriture une par une. Refuser les outils d'écriture quand la tâche n'a besoin que de lecture réduit le succès des injections de prompt à 7,5 % sur AgentDojo (AgentDojo).
- Séparez automatiquement les bases de données dev et prod, et exigez une porte d'approbation sur les commandes destructives. Ce sont les deux lacunes identifiées chez Replit (The Register).
- Fixez un budget de tokens par agent que le runtime applique avant l'appel, pas un tableau de bord qui alerte après. Prévoyez ~4× les dépenses de chat pour un agent unique et ~15× pour le multi-agents (Anthropic).
- Rédigez 20 requêtes d'évaluation à partir du trafic réel, notez-les avec un juge LLM sur une rubrique de 0,0 à 1,0, et exécutez chacune huit fois (Anthropic).
- Rapportez pass^8, pas le taux de succès moyen. Un agent GPT-4o au-dessus de 60 % de pass^1 est tombé sous 25 % à pass^8 dans τ-bench retail (τ-bench).
- Activez la traçabilité au niveau des étapes, puis connectez-y une évaluation. 89 % des équipes ont de l'observabilité mais seulement 37,3 % font tourner des évaluations en ligne (LangChain).
- Échantillonnez votre file d'approbation chaque semaine et vérifiez le taux de rejet. Une porte que personne ne rejette jamais rien n'est qu'une étape de journalisation.
- Identifiez les sorties générées par IA comme IA — la correction déployée par Cursor après que son bot de support a inventé une règle de connexion (The Register).
- Placez l'agent derrière une authentification et hors de l'internet public. Des chercheurs ont trouvé 40 214 instances OpenClaw exposées sur 28 663 adresses IP, 63 % vulnérables et 12 812 exploitables via RCE (Infosecurity Magazine). L'hygiène de déploiement échoue bien avant que la sophistication de l'attaquant ne soit pertinente.
- Traitez chaque serveur MCP comme du code non fiable. Microsoft a comptabilisé 99 CVE publiés pour les logiciels liés à MCP en 2025 (Microsoft Security).
- Lisez la liste ASI01–ASI10 d'OWASP par rapport à votre architecture une fois par trimestre (OWASP).
Questions d'évaluation à poser à tout fournisseur d'agents
Quatre questions, posées lors d'une démo, sépareront les produits opérables des wrappers. Puis-je donner à l'agent des identifiants que j'ai délimités moi-même, ou veut-il un grant OAuth avec tout coché ? Applique-t-il un plafond strict de tokens ou de dollars par exécution, et que se passe-t-il au plafond ? Puis-je exporter des traces complètes au niveau des étapes vers ma propre infrastructure ? Et quelles actions spécifiques puis-je marquer comme nécessitant une approbation, par nom d'outil ?
Si les réponses sont vagues sur l'une des quatre, vous achetez une démo. La qualité est déjà le principal frein au déploiement à 33 % (LangChain), et aucune de ces quatre capacités ne peut être ajoutée de l'extérieur du produit.
Où s'inscrivent les 550+ agents de notre répertoire
Notre répertoire liste 550 produits agents, et vous pouvez parcourir les agents IA par capacité pour établir une liste restreinte avant de poser les quatre questions ci-dessus. Les 578 entrées sous les créateurs d'agents IA sont celles qui sont le plus susceptibles d'exposer la délimitation et les plafonds comme configuration, puisque vous assemblez le workflow vous-même. Si vous voulez les données d'enquête derrière les chiffres ici, la section rapports de tendances et enquêtes sectorielles en regroupe 137.
Choisissez les deux candidats qui répondent aux quatre questions, puis exécutez vos 20 requêtes huit fois chacune contre les deux. L'écart pass^8 tranchera pour vous.
Foire aux questions
Quels sont les modes de défaillance les plus courants des agents IA en production ?
Ils se divisent en échecs de sécurité et en échecs de fiabilité. Après douze mois de red-teaming sur des systèmes agentiques déployés, l'équipe rouge IA de Microsoft a rapporté que le contournement humain-dans-la-boucle était « le mode de défaillance le plus systématiquement exploité, à très haute fréquence », avec l'injection de prompt inter-domaines comme vecteur d'accès initial le plus fiable et la contamination du contexte de session difficile à détecter. Côté fiabilité, l'étude MAP sur les agents déployés nomme le comportement correct et cohérent dans le temps comme le principal défi de développement, et les équipes le corrigent avec une autonomie contrainte et un échafaudage déterministe plutôt que de meilleurs modèles. Pour une liste de contrôle, le Top 10 OWASP pour les Applications Agentiques (9 décembre 2025) ancre chacune de ses dix catégories à un incident réel, notamment la mésaventure Replit pour les agents incontrôlés et l'exploit GitHub MCP pour la chaîne d'approvisionnement.
Combien d'étapes un agent IA de production devrait-il pouvoir exécuter de façon autonome ?
Dix ou moins, ce que les équipes faisant déjà tourner des agents ont adopté. La première étude à grande échelle sur des agents déployés a constaté que 68 % exécutent au maximum 10 étapes avant une intervention humaine, sur 86 praticiens et 26 domaines. La raison est l'erreur cumulée : sur τ-bench de Sierra, un agent de calling de fonctions GPT-4o obtenant plus de 60 % sur un seul essai est tombé sous 25 % quand les huit essais de la même tâche devaient tous réussir. Si vous voulez des exécutions plus longues, découpez la tâche en segments avec point de contrôle et une porte de vérification entre eux plutôt qu'étendre la boucle.
Comment empêcher un agent IA de générer une facture de tokens incontrôlée ?
Fixez un plafond budgétaire strict par agent et une porte d'arrêt vérifiée avant chaque appel de modèle, pas après. L'observabilité seule ne vous sauvera pas : une boucle multi-agents rapportée a brûlé 47 000 $ en 264 heures avec quatre agents se renvoyant la balle, et les causes profondes nommées étaient exactement ces deux contrôles manquants. Prévoyez le multiplicateur à l'avance, puisque les données de production d'Anthropic montrent que les agents utilisent environ 4× les tokens du chat et les systèmes multi-agents environ 15×. Les propres conseils d'Anthropic sont que les architectures multi-agents nécessitent des tâches dont la valeur justifie ce coût.
L'approbation humain-dans-la-boucle suffit-elle à rendre un agent sûr ?
Non, et c'est le contrôle que les attaquants contournent le plus souvent. L'équipe rouge de Microsoft a constaté que le contournement humain-dans-la-boucle était le mode de défaillance le plus systématiquement exploité sur un an d'engagements, et OWASP répertorie la Human-Agent Trust Exploitation comme sa propre catégorie dans le Top 10 pour les Applications Agentiques. Le volume le tue aussi : 50 agents faisant 20 appels d'outils par heure produisent 1 000 événements éligibles à l'approbation, et acheminer même 10 % vers des personnes représente 100 approbations par heure, soit environ 3 relecteurs à temps plein. Les approbations fonctionnent quand elles sont rares, contextualisées et soutenues par des limites de portée qui tiennent même si l'humain clique sur oui.
Combien de cas de test faut-il pour évaluer un agent IA ?
Commencez avec environ 20 requêtes représentatives de l'utilisation réelle, ce qui est la recommandation d'Anthropic issue de la construction de son propre système de recherche multi-agents. Notez-les avec un seul juge LLM selon une rubrique sur une échelle de 0,0 à 1,0 ; Anthropic a trouvé cela plus cohérent que les configurations multi-juges, et a conservé l'évaluation humaine pour les cas limites que l'automatisation ratait. Exécutez chaque cas de façon répétée et rapportez pass^k plutôt qu'une moyenne, car τ-bench a montré que le taux de succès moyen surestime systématiquement le comportement en production. N'importe quelle évaluation vous place devant la plupart des équipes : seulement 52,4 % font tourner des évaluations hors ligne et 37,3 % des évaluations en ligne, contre 89 % qui ont mis en place une observabilité.
Quelles permissions les identifiants d'un agent IA devraient-ils avoir ?
Lecture seule par défaut, avec les portées d'écriture et destructives accordées par tâche plutôt que par agent. Sur le benchmark AgentDojo de 97 tâches et 629 cas de test de sécurité, refuser les outils en écriture quand la tâche de l'utilisateur n'a besoin que de lecture a réduit le succès des attaques par injection de prompt à 7,5 %. Les corrections post-incident de Replit après que son agent a supprimé une base de données de production le 19 juillet 2025 nomment les deux lacunes directement : pas de séparation des données dev/prod et pas de porte d'approbation pour les commandes destructives, traitées par la séparation automatique des bases de données, les environnements de staging, la restauration en un clic du projet et un mode planification uniquement. Délimitez les identifiants pour que le pire cas soit récupérable, et supposez que l'agent finira par essayer le pire cas.