

Les modèles open-weight sont désormais assez proches des meilleurs modèles fermés pour que, dans bien des cas, la vraie question ne soit plus la qualité. Ce qui compte, c'est qui fait tourner le modèle, où vont vos données et ce que la licence vous permet de faire. Selon Bloomberg Intelligence, l'écart entre le meilleur modèle chinois et le meilleur modèle américain est d'environ 3 % sur un benchmark majeur, contre environ 15 % plus tôt cette année (AI Weekly, citant Bloomberg).
Ce changement concerne surtout les développeurs, les startups et les équipes soumises à des règles de confidentialité. Vous pouvez aujourd'hui récupérer un modèle sur Hugging Face, le faire tourner sur du matériel que vous contrôlez et obtenir en code et en agents des résultats qui, il y a un an, nécessitaient une API payante. Ou bien vous passez outre le matériel et appelez les mêmes poids via un hébergeur bon marché.
Tout n'est pas rose pour autant. « Open » recouvre des licences qui vont du « faites ce que vous voulez » au « lisez les petites lignes », certains des plus gros modèles exigent une armoire de GPU, et quelques-uns traînent de vrais problèmes de sécurité et de censure. Ce guide classe les leaders actuels, détaille leur coût et donne des règles pour choisir. Pour un panorama plus large des modèles fermés et ouverts, notre classement Top 25 LLMs fait le suivi.
L'écart s'est réduit, et le paysage a changé
L'écart de benchmark fait la une, voyons ce qu'il y a derrière. D'après les relevés de Bloomberg, le meilleur modèle chinois accusait environ 15 % de retard plus tôt cette année, environ 9 % à la mi-année et environ 6 % un mois plus tard, un plus bas historique à l'époque (The Next Web). Le dernier relevé donne environ 3 %. Le point de données le plus récent est DeepSeek V4.1 Flash, qui a obtenu 81,1 sur LiveBench contre 83,4 pour un modèle de pointe d'Anthropic, et qui domine le sous-test de code agentique de ce benchmark : 77,3 contre 66,1.
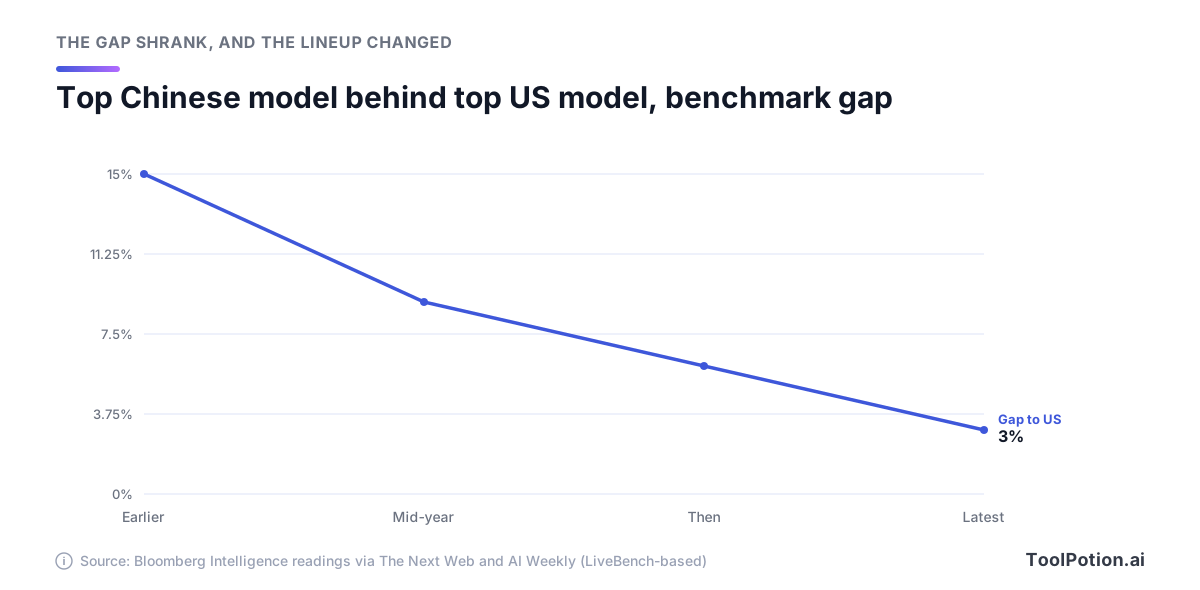
Gardez les réserves en tête. Seules trois des quinze premières entrées de LiveBench sont chinoises : c'est une histoire de pointe de la frontière, pas un raz-de-marée. L'écart reflète aussi le point de vue d'un seul benchmark sur le meilleur modèle de chaque camp, et aucune des deux sources ne dit qu'il se limite aux modèles ouverts. La direction n'en reste pas moins claire, et le modèle qui a comblé l'écart, DeepSeek V4.1 Flash, est open-weight.
Deux autres choses ont changé cette année. D'abord, Qwen a publié pour la première fois un modèle de classe Max en open weights, selon sa propre fiche modèle pour Qwen3.8-2.4T-A95B. Ensuite, les publications ouvertes de Meta ont évolué. Les modèles Llama les plus récents sur la page Hugging Face de Meta sont toujours la famille Llama 4 de 2025, comme Llama 4 Scout. Le site développeur de Meta met désormais en avant ses modèles hébergés Muse Spark et présente Muse Glimmer, un modèle open-weight de 30B pour agents locaux, comme le modèle ouvert.
Mistral est l'autre actualité. L'entreprise vient d'annoncer Mistral Large 4, un modèle de 1 000 milliards de paramètres dont 52 milliards actifs, et en a mis un aperçu sur son API. Elle indique que les poids suivront d'ici la fin du mois (Mistral). Au moment de la rédaction, ils n'étaient pas téléchargeables et Mistral n'avait publié aucune licence : considérez donc Large 4 comme promis, pas comme publié. Ne bâtissez rien dessus tant que les poids et la licence ne sont pas sur Hugging Face.
Les modèles open-weight à connaître
Voici les leaders actuels en un coup d'œil. Les tailles et licences viennent de la fiche Hugging Face de chaque modèle, les prix de la page tarifaire de chaque éditeur. « Active » désigne le nombre de paramètres activés par token dans un modèle à mélange d'experts, ce qui détermine la vitesse.
| Modèle | Licence | Taille (active) | Contexte | API de l'éditeur, $ par M de tokens en entrée / sortie |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B à 16B) | 1M | 0,30 / 1,20 en pointe |
| DeepSeek V4-Pro | MIT | 1,7T | 1M | 1,32 / 3,96 en pointe |
| Kimi K3 | Kimi K3 License | 2,8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B dense | 262K | version hébergée à venir |
| gpt-oss-120b | Apache 2.0 | 117B (5,1B) | n/d | aucune API éditeur listée |
| Gemma 4 31B | Apache 2.0 | 31B dense | 256K | aucune API éditeur listée |
| Muse Glimmer | Apache 2.0 | 30B dense | 131K+ | aucune API éditeur listée |
| Mistral Large 4 | non publiée | 1T (52B) | n/d | 1,36 / 4,18 en préversion |
DeepSeek est le choix sûr côté coût. Les poids de V4.1 Flash sont sous licence MIT, le prix de l'API est le plus bas des gros modèles, et les heures creuses à moitié prix le font baisser encore (documentation DeepSeek). Ne vous fiez pas au nom : « Flash » est ici un modèle de 763B, avec un téléchargement de 510 Go (fiche modèle). V4-Pro-0813 est encore plus gros, à environ 1,7T.
Kimi K3 est celui qui fait les gros titres. Avec 2,8 trillions de paramètres dont 104 milliards actifs, il affiche 93,5 sur GPQA Diamond et 91,2 sur BrowseComp sur sa propre fiche. Ce sont les chiffres de Moonshot, lisez-les donc comme des affirmations. L'API de Moonshot est aussi la plus chère du groupe open, ce qui surprend (plus de détails ci-dessous).
GLM-5.3 de Z.ai est le spécialiste du code. Il partage un modèle de base avec GLM-5.2, et Z.ai affirme que tous les gains viennent du post-entraînement, dont un bond de 50 % sur son benchmark de code interne (fiche modèle). C'est une mesure de l'éditeur. Son cousin économique, GLM-5.3-Flash, est listé à 0,15 $ en entrée et 0,50 $ en sortie.
Qwen offre la gamme la plus large. Qwen3.8-27B est un modèle dense de 27B sous Apache 2.0, avec vision, un contexte natif de 262K et un score rapporté de 61,7 sur SWE-bench Pro (fiche modèle). Pour une seule station de travail, c'est le meilleur premier essai en code et en agents, et pour la plupart des petites équipes, c'est le modèle par lequel commencer. Le gros Qwen3.8-2.4T relève d'une licence distincte, traitée plus bas. Vous pouvez aussi essayer Qwen via son appli.
gpt-oss-120b d'OpenAI est vieillissant mais reste utile. Il est sous Apache 2.0, compte 5,1B de paramètres actifs et, selon OpenAI, tourne sur un seul GPU de 80 Go (fiche modèle). Il a été publié en 2025, et aucune version gpt-oss plus récente n'est apparue sur la page Hugging Face d'OpenAI. Gemma 4 est la famille actuelle de Google ; le modèle 31B est sous Apache 2.0, offre une fenêtre de 256K et existe en versions quantifiées pour Ollama et llama.cpp (fiche modèle). Muse Glimmer est le petit : Meta indique qu'une version d'environ 4 bits pèse moins de 20 Go et tient dans une enveloppe de 24 ou 32 Go, avec environ 1 % de perte de qualité dans la configuration la plus serrée (fiche modèle).
L'Europe propose deux options aujourd'hui. Mistral Medium 3.5 est un modèle dense de 128B avec une fenêtre de 256K sous licence MIT modifiée, que Mistral décrit comme ouverte à l'usage commercial, sauf pour les entreprises à gros chiffre d'affaires. Mistral Small 4, à 119B, et l'ancien Mistral Large 3 sont sous Apache 2.0 sur Hugging Face.
« Open » peut quand même cacher des conditions
Seuls les modèles Apache 2.0 et MIT sont ouverts au sens où la plupart des développeurs l'entendent. Plusieurs des plus puissants ne le sont pas. Lisez le fichier de licence, pas le titre.
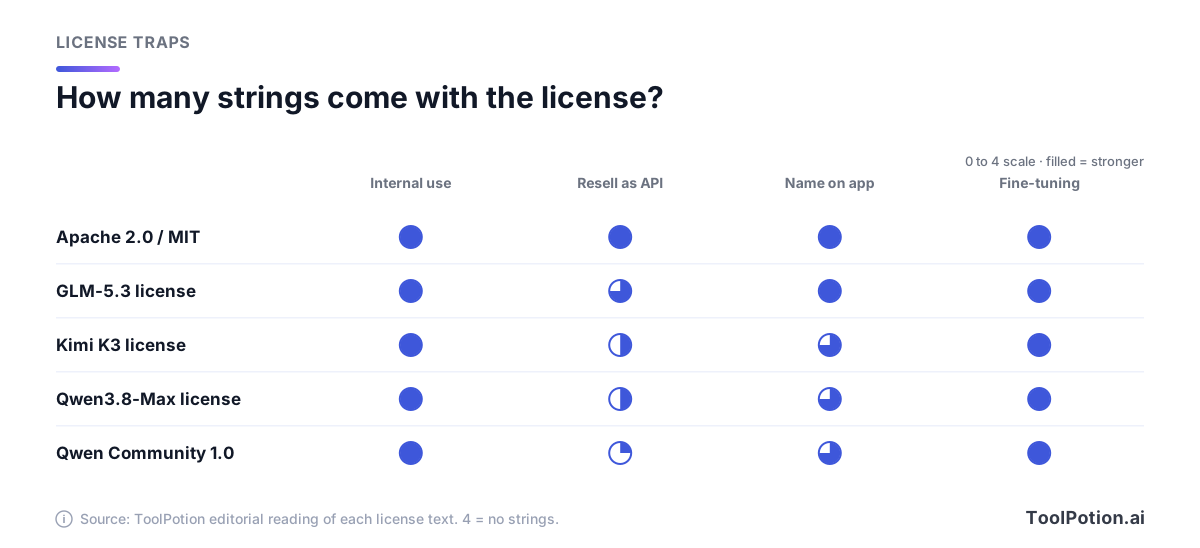
Le schéma est le même pour toutes les licences personnalisées. Vous pouvez utiliser, modifier et affiner librement. Les conditions portent sur la vente du modèle à d'autres, généralement sous forme d'API, dès qu'on dépasse un seuil de chiffre d'affaires. La licence de Moonshot, par exemple, impose à un opérateur « Model as a Service » qui gagne plus de 20 millions de dollars sur 12 mois de conclure un accord séparé avant tout usage commercial. Les produits comptant 100 millions d'utilisateurs mensuels ou 20 millions de dollars de revenu mensuel doivent afficher « Kimi K3 » dans l'interface (texte de la licence). L'usage interne est exempté.
La licence de Z.ai est plus souple. Le seul verrou est une revue de sécurité pour les opérateurs Model-as-a-Service dépassant 10 milliards de dollars de chiffre d'affaires. Les licences de Qwen sont les plus strictes du groupe. La Qwen Community License de Qwen3.8-Flash-Next stipule que toute entreprise exploitant une activité Model-as-a-Service ou « AI Work Assistant » doit d'abord obtenir une licence distincte de Qwen, sauf pour un usage interne (texte de la licence). La licence Max du modèle 2.4T relève ce seuil à 50 millions de dollars de revenu.
Si vous construisez une appli par-dessus l'un de ces modèles, vous ne risquez presque certainement rien. Si votre produit est « une API qui sert ce modèle », faites relire la licence par un juriste avant le lancement. Si vous voulez zéro doute, restez sur Apache 2.0 ou MIT. Cela veut dire DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4 et Muse Glimmer.
Ce que coûtent les API hébergées
Open weights ne veut pas dire API bon marché. Le tableau change selon qui héberge le modèle.
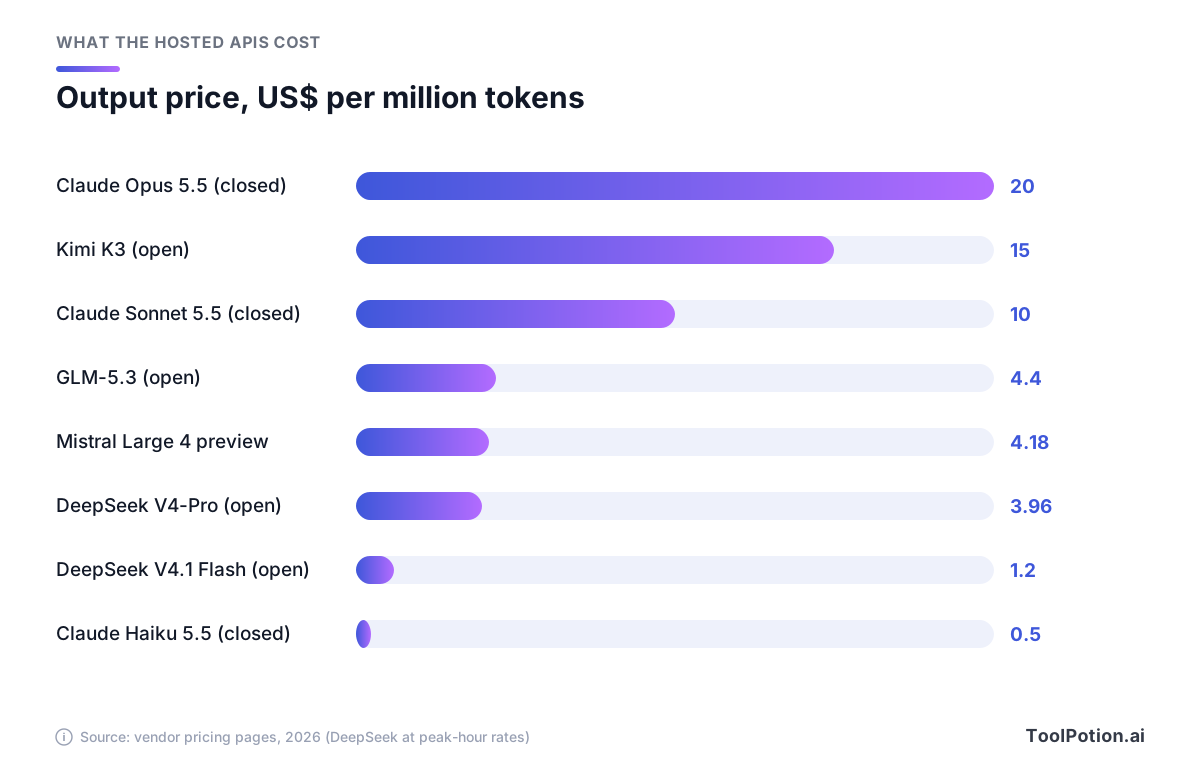
Moonshot facture Kimi K3 3 $ en entrée et 15 $ en sortie par million de tokens, d'après sa page tarifaire. C'est plus que Claude Sonnet 5.5 d'Anthropic à 2 $ et 10 $, et Sonnet est un modèle fermé. DeepSeek est l'inverse : la sortie de V4-Pro coûte 3,96 $ en pointe et 1,98 $ en heures creuses. GLM-5.3 de Z.ai est à 1,40 $ en entrée et 4,40 $ en sortie.
Les petits modèles fermés cassent les prix de la plupart des flagships ouverts. Claude Haiku 5.5 est listé à 0,10 $ en entrée et 0,50 $ en sortie, comme GPT-6 Luna d'OpenAI, selon la page tarifaire de chaque éditeur. Le « passons à l'open pour économiser » ne tient donc que face aux paliers fermés coûteux, et seulement si vous choisissez un hébergeur open bon marché.
La voie la moins chère est souvent un tiers qui sert les mêmes poids. La liste publique de modèles d'OpenRouter affiche gpt-oss-120b à environ 0,04 $ en entrée et 0,17 $ en sortie par million de tokens ; les prix y varient selon le fournisseur et changent souvent. OpenRouter, Together AI, Fireworks AI et Groq revendent tous des modèles ouverts derrière un même format d'API : changer de fournisseur revient à changer l'URL de base.
Faire tourner soi-même ou passer par un hébergeur
Il y a quatre façons de faire tourner un modèle ouvert, et chacune vous donne un peu plus de contrôle et un peu plus de travail.
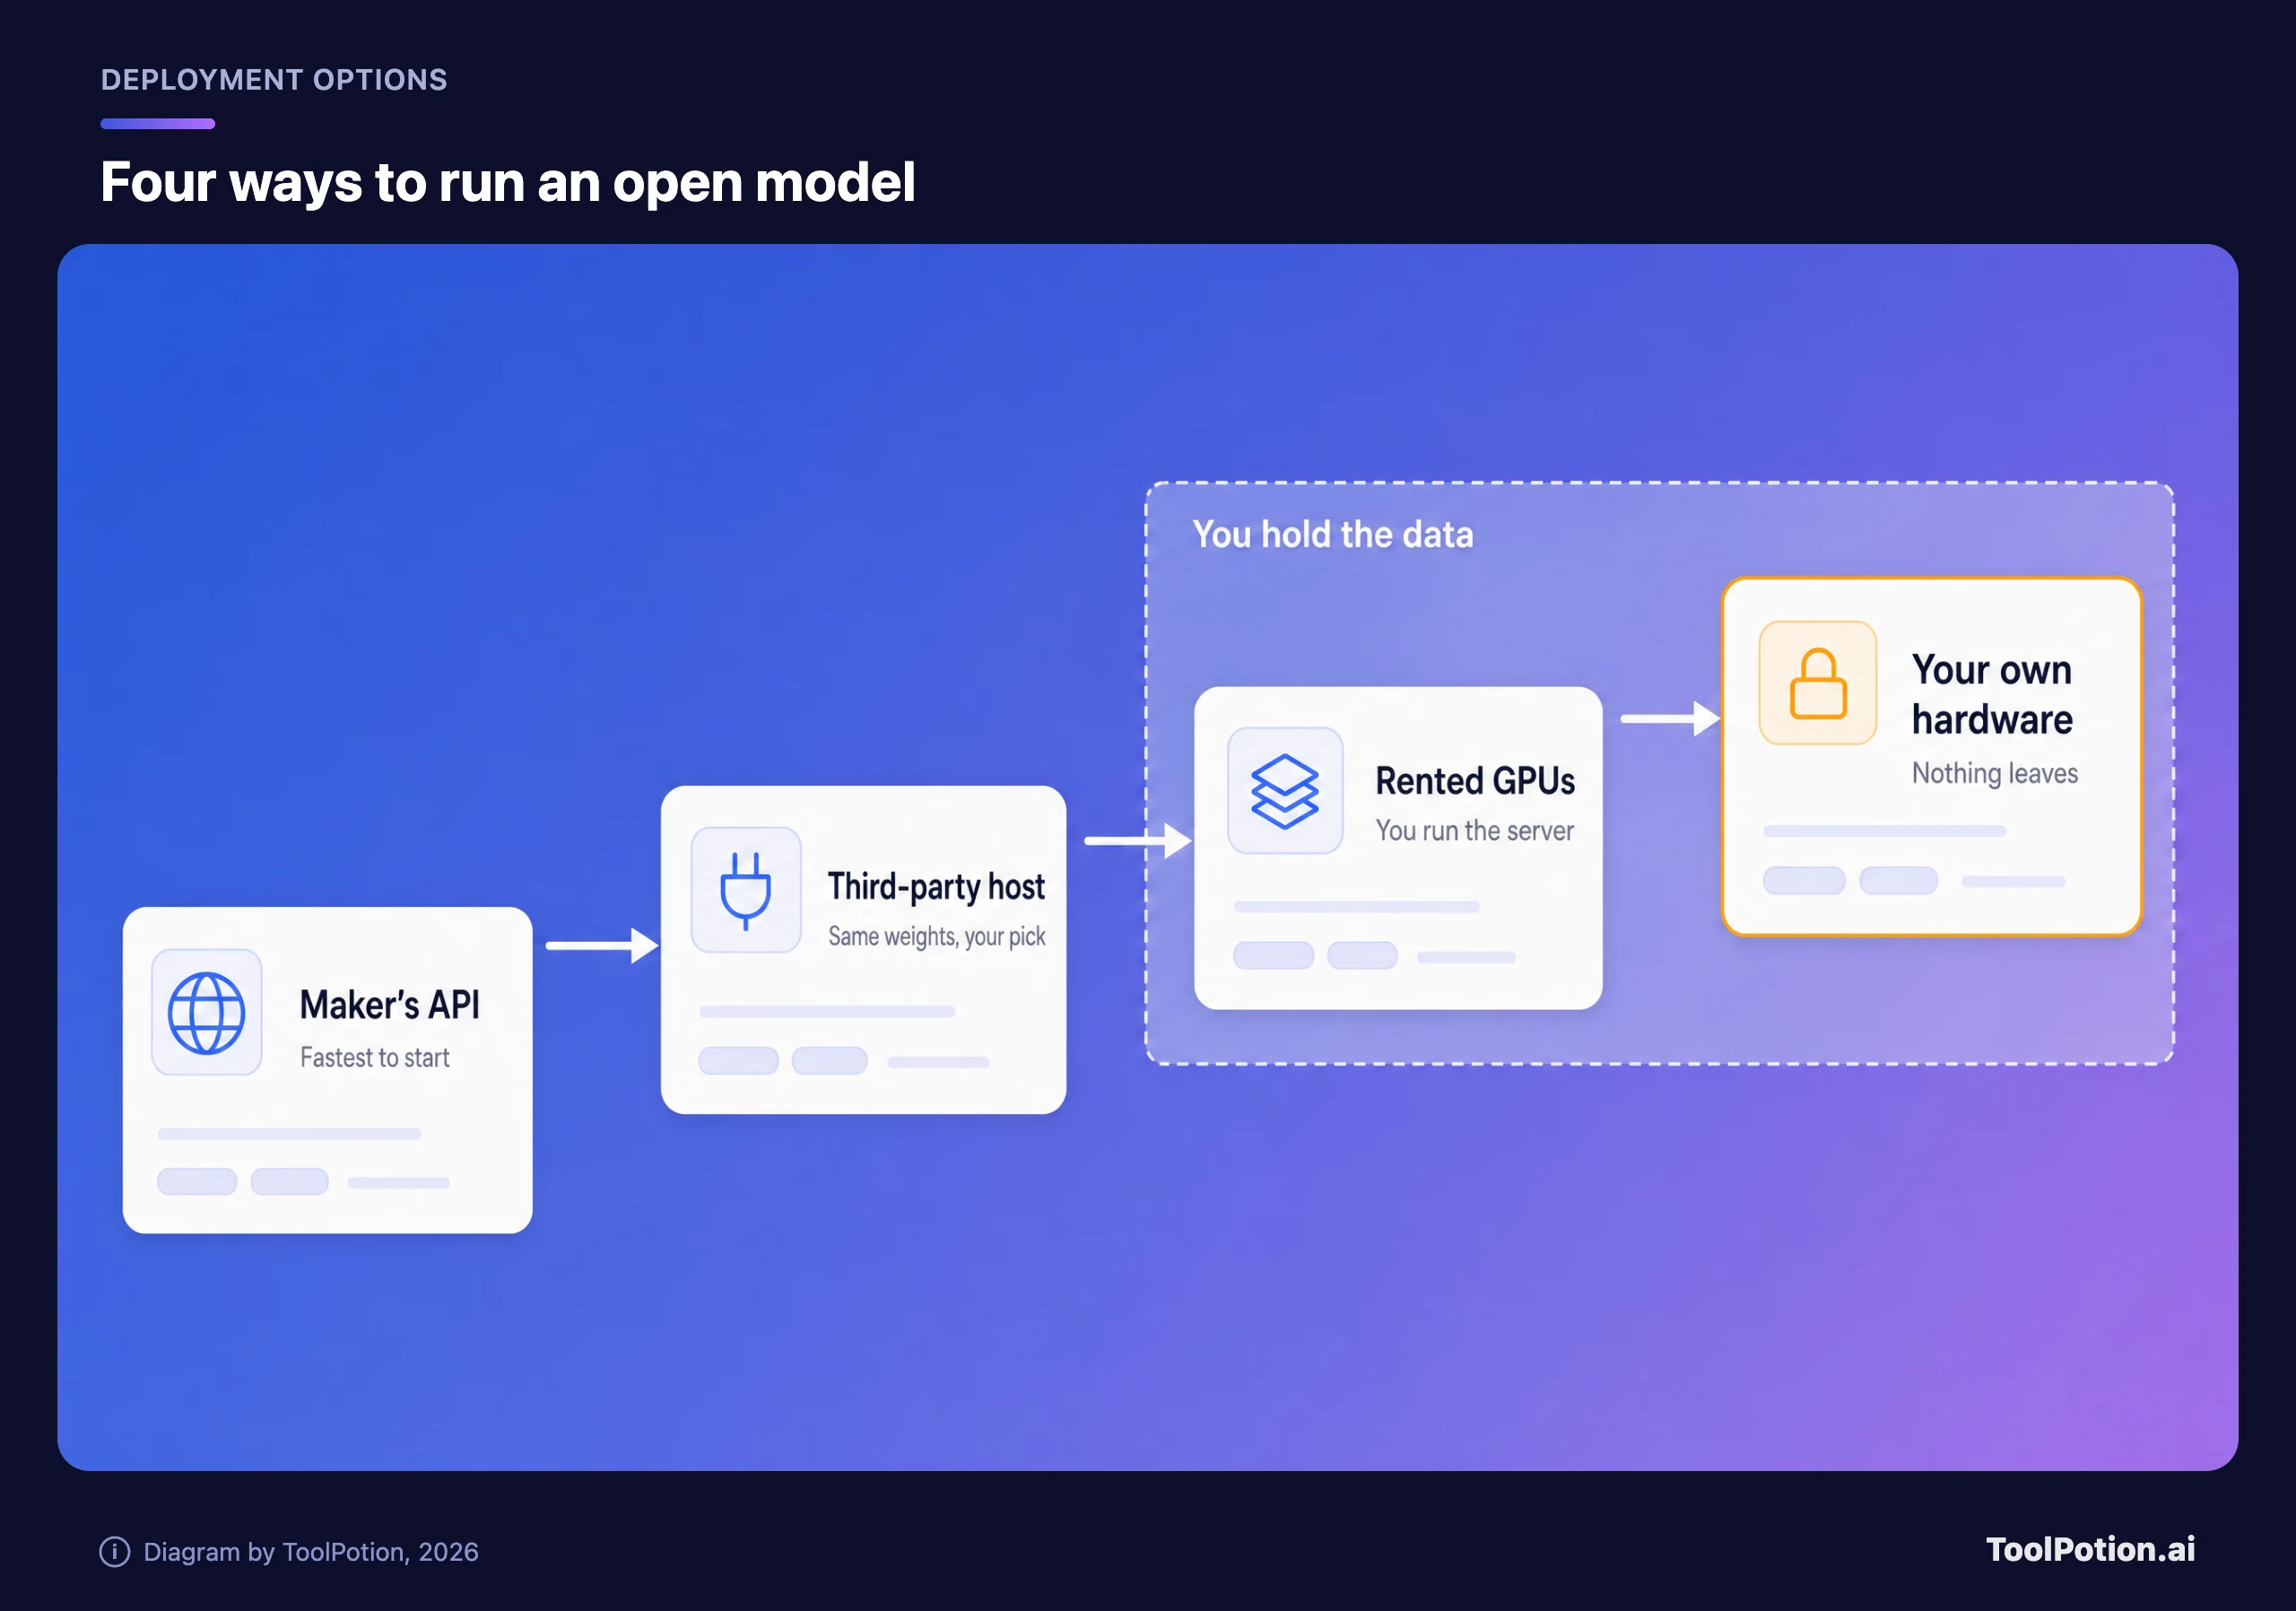
Les deux premières sont managées. Vous envoyez des tokens à l'éditeur ou à un hébergeur, et vos données transitent par le réseau de quelqu'un d'autre. Les deux dernières placent le modèle sur des machines que vous contrôlez, ce qui est le but si un contrat ou un régulateur interdit que les données sortent. Des poids qui ne tiennent pas sur votre matériel sont l'obstacle habituel : commencez donc par la taille.
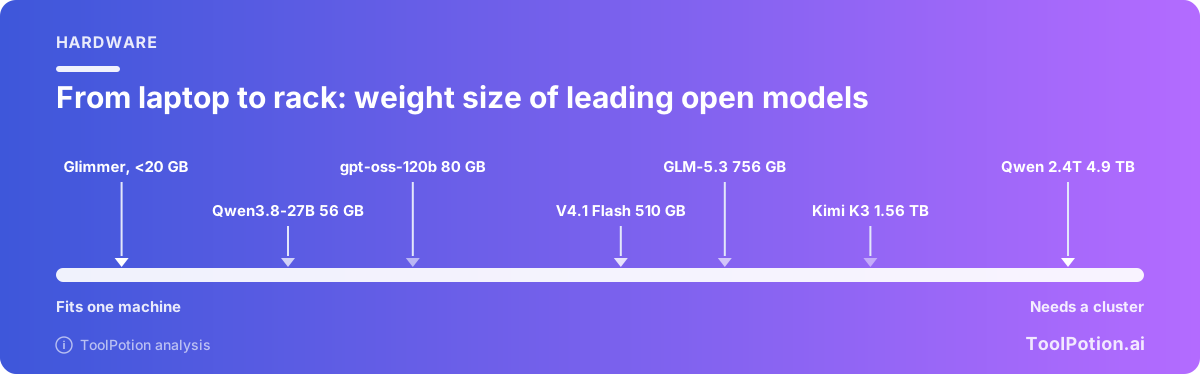
La plupart des modèles en vue sont bien trop gros pour une seule machine. Les poids de Kimi K3 seuls font 1,56 To, soit plus que les 1,44 To d'un nœud de huit GPU B200 de 180 Go. DeepSeek V4-Pro et GLM-5.3 réclament chacun des centaines de gigaoctets. Les modèles qui tiennent sur une seule machine sont de la classe 20B à 120B. Utilisez l'estimateur pour vérifier un modèle et une précision par rapport à votre matériel.
Essayez les valeurs par défaut. gpt-oss-120b en 4 bits demande environ 70 Go avec la surcharge, il tient donc sur un GPU de 80 Go. Passez à Kimi K3 et le même estimateur réclame dix GPU de 180 Go. Dix GPU, cela fait deux nœuds de huit GPU. Au tarif à la demande de Lambda de 6,69 $ par heure de B200, d'après la page tarifaire de Lambda, ces 16 GPU qui tournent tout le mois coûtent environ 78 000 $. C'est le prix d'un modèle ouvert de pointe en auto-hébergement, avant même d'y affecter quelqu'un.
Le bas de gamme est bien plus clément. Lambda propose un GPU de 80 Go à partir de 3,99 $ de l'heure, soit environ 2 900 $ par mois s'il tourne en continu. Savoir si c'est plus rentable qu'une API dépend entièrement du volume.
À 300 millions de tokens de sortie par mois et un prix d'API de 10 $, les deux factures s'équilibrent à peu près. En dessous, l'API gagne. Au-dessus, la location gagne, à condition que le GPU soit bien occupé et que le modèle suffise à la tâche. La comparaison honnête se fait pourtant avec un hébergeur bon marché. Au prix hébergeur listé de gpt-oss-120b, environ 0,17 $ par million de tokens de sortie, 2 900 $ achètent environ 17 milliards de tokens de sortie : un seul GPU loué ne bat presque jamais un hébergeur sur le seul coût. Louez pour la confidentialité, le contrôle et une latence prévisible. Ne louez pas pour économiser sur un petit modèle.
Voici un exemple chiffré avec un volume inventé mais plausible. Imaginons une équipe support qui résume 20 000 tickets par jour, chacun de 1 500 tokens en entrée et 300 en sortie. Cela fait environ 900 millions de tokens en entrée et 180 millions en sortie par mois. Sur Claude Sonnet 5.5 à 2 $ et 10 $ par million, la facture est de 3 600 $. Sur DeepSeek V4.1 Flash à ses tarifs de pointe, elle est de 486 $ au maximum, et moitié moins en heures creuses. Sur gpt-oss-120b aux prix d'hébergeur listés, elle est d'environ 64 $. Un GPU de 80 Go loué coûte 2 913 $ quoi que vous lui envoyiez. L'hébergeur bon marché l'emporte largement, et le modèle fermé coûte environ sept fois plus cher que le modèle ouvert au tarif de l'éditeur.
Deux raccourcis aident avant de dépenser quoi que ce soit. Pour un portable ou une station de travail, Ollama et llama.cpp font tourner des versions quantifiées de Gemma 4, Qwen3.8-27B et Muse Glimmer en une seule commande. Pour un serveur de production, vLLM est le moteur de service que les fiches de Kimi K3 et de Qwen3.8 indiquent toutes deux comme pris en charge.
Comment choisir
Partez de votre contrainte, pas du classement. Trois questions règlent la plupart des cas.
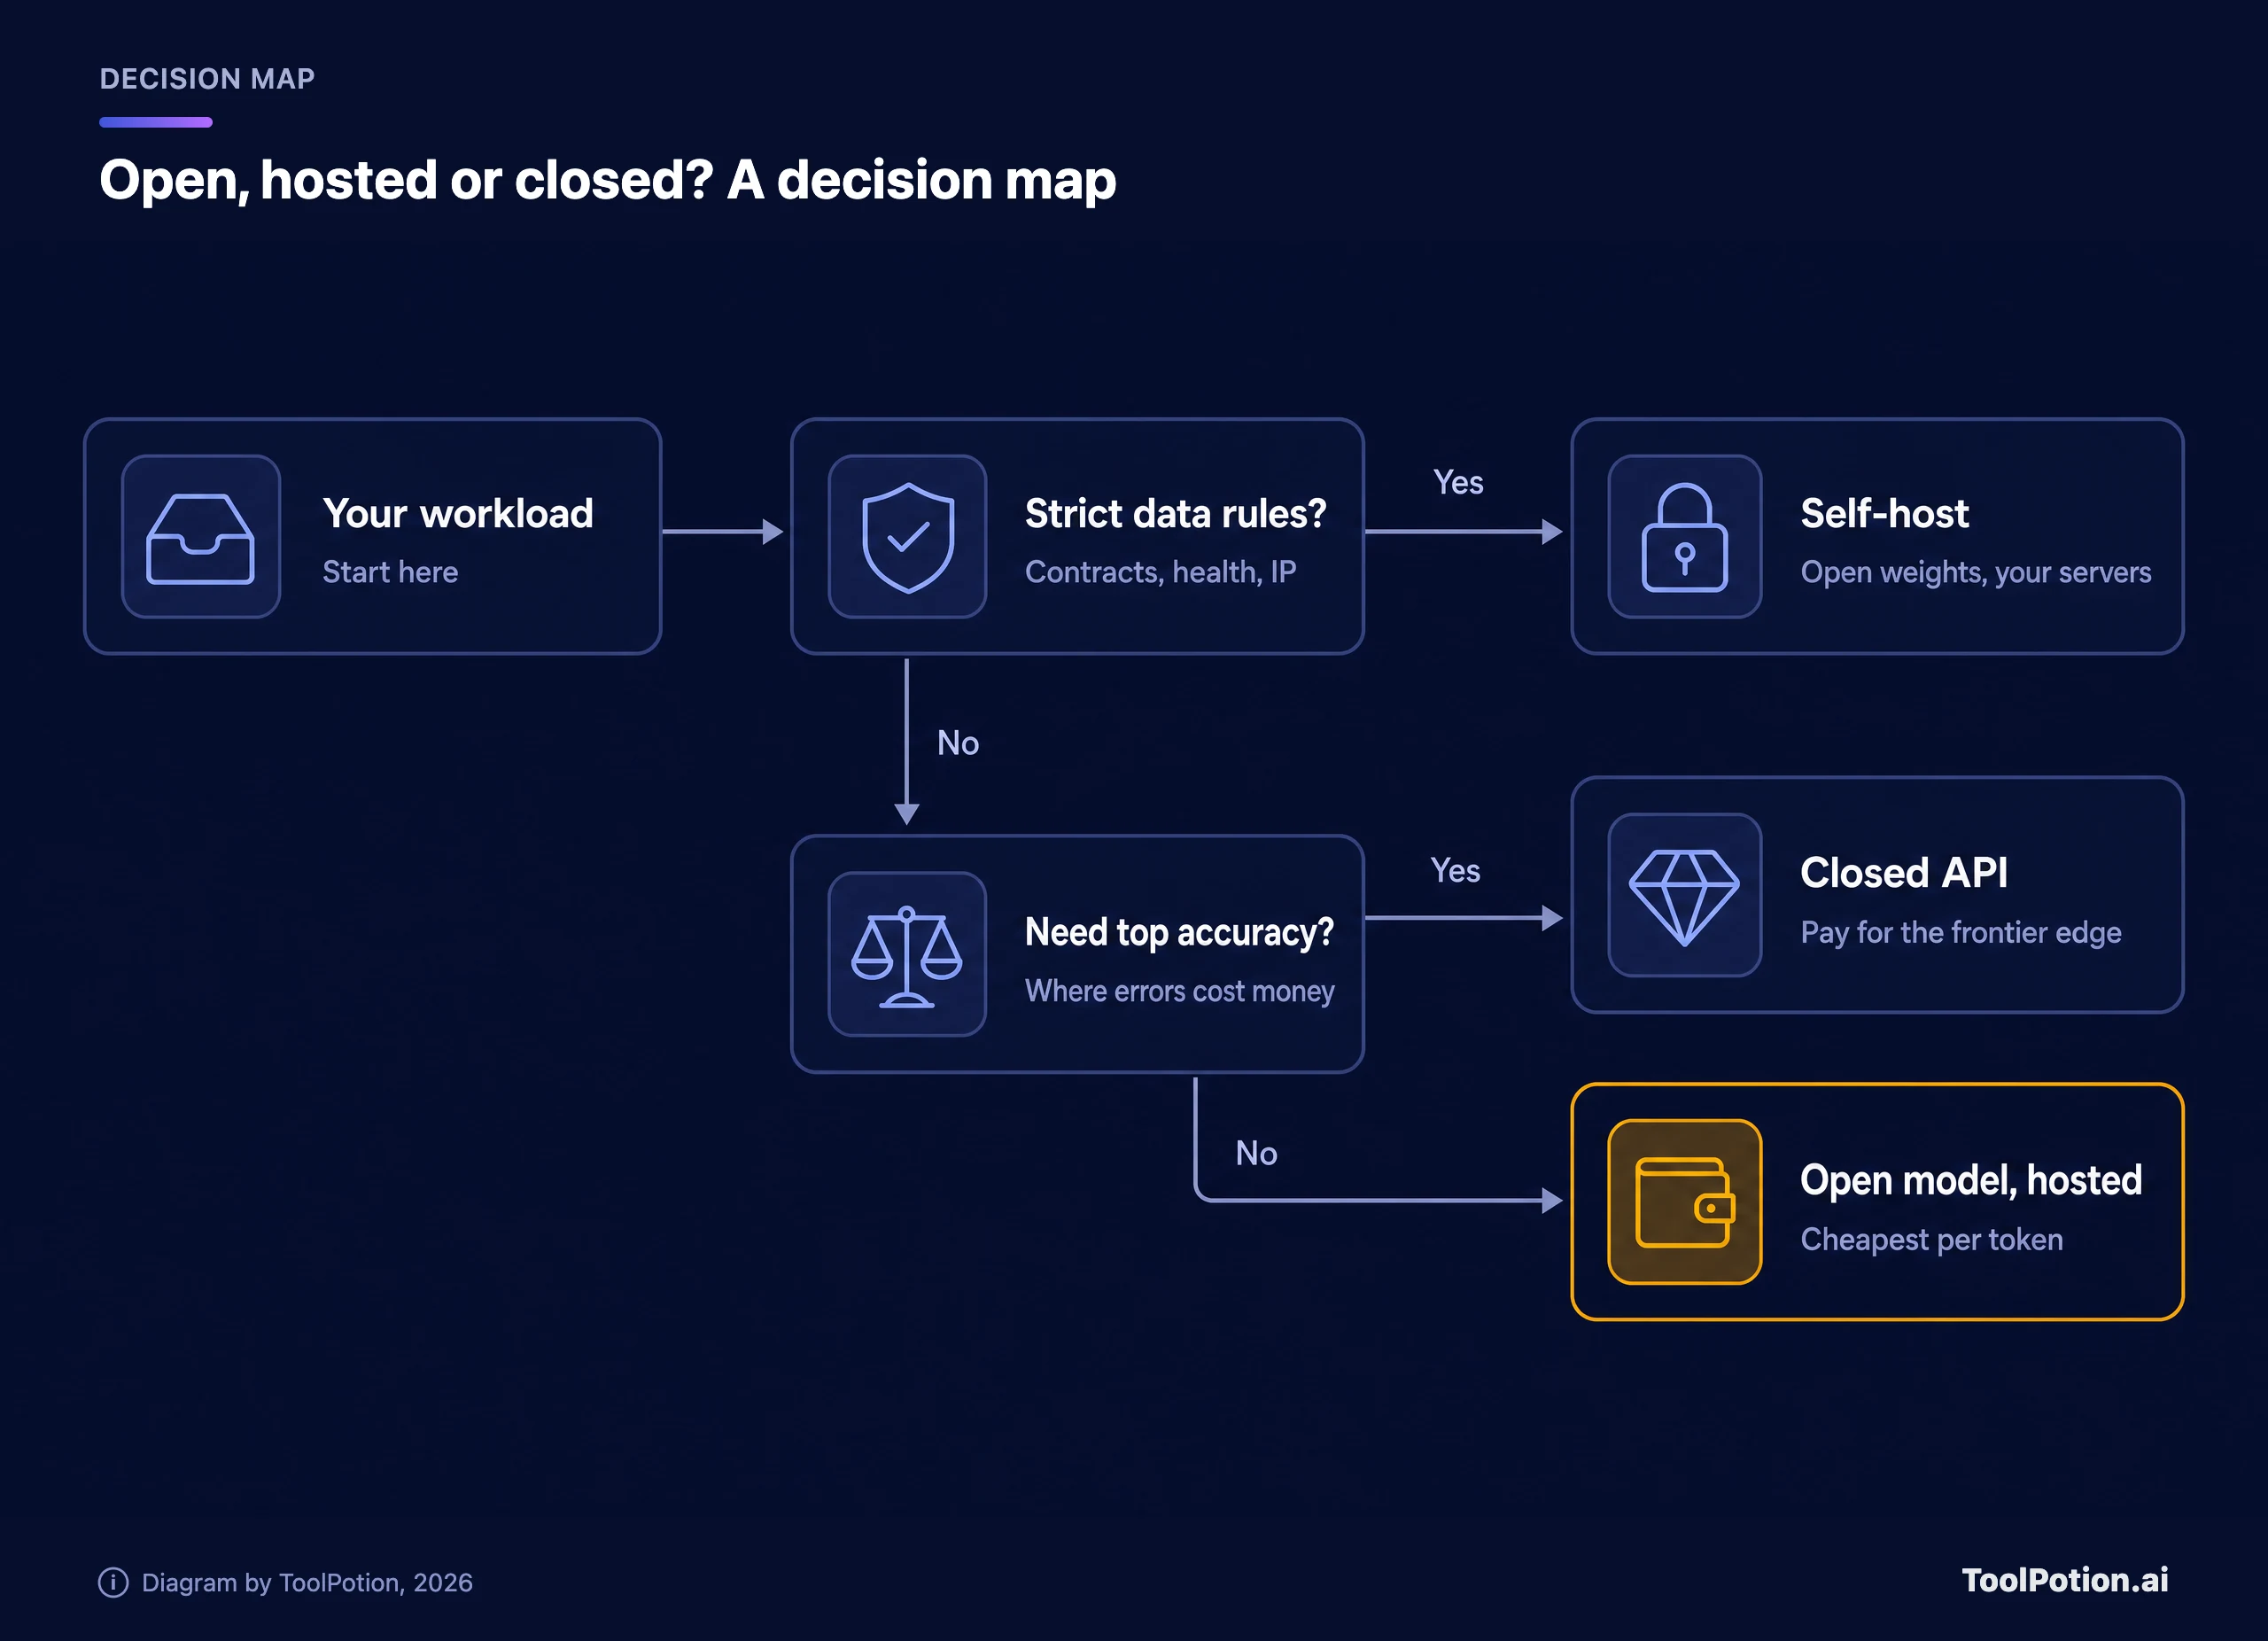
Si vos données ne peuvent pas quitter votre contrôle, vous auto-hébergez, et le modèle doit tenir sur votre matériel. Avec cette contrainte :
- Un GPU ou une station de travail : Qwen3.8-27B pour le code et les agents, gpt-oss-120b si vous voulez un modèle occidental, Muse Glimmer ou Gemma 4 pour un portable.
- Un serveur multi-GPU : DeepSeek V4.1 Flash ou GLM-5.3 si vous pouvez vous offrir huit grosses cartes et quelques centaines de gigaoctets de poids.
- Un cluster : Kimi K3 ou Qwen3.8-2.4T, mais seulement si vous avez une équipe dont l'inférence est le métier.
Si vos données peuvent sortir, demandez-vous si les erreurs coûtent cher. Quand c'est le cas (brouillons juridiques, analyse financière, code livré sans relecture), payez un modèle fermé de pointe et vérifiez-le sur vos propres exemples. Quand ce n'est pas le cas (résumés, étiquetage, extraction, recherche interne, code de premier jet), un modèle ouvert via un hébergeur bon marché offre le meilleur prix que vous trouverez.
Passez cette liste en revue dans l'ordre avant de choisir :
1. Notez la contrainte qui ne peut pas bouger : localisation des données, budget mensuel ou seuil de qualité.
2. Vérifiez la licence pour votre usage. Un produit construit sur le modèle passe presque partout. C'est la revente du modèle qui pose des conditions.
3. Vérifiez la mémoire : poids en Go face au matériel que vous achèteriez ou loueriez réellement.
4. Chiffrez la même charge de travail sur une API éditeur, un hébergeur tiers et un GPU loué.
5. Passez 50 de vos propres tâches dans deux ou trois candidats et gardez le gagnant.
Testez avant de vous engager. Les benchmarks cités ici viennent des éditeurs eux-mêmes et portent sur des suites différentes : un 90 sur un classement en dit donc peu sur un 88 ailleurs. Prenez 50 tâches réelles de votre charge de travail, passez-les dans deux ou trois candidats et notez les résultats. Un après-midi de ce travail vaut mieux qu'une semaine à lire des fiches modèles.
Les risques que personne ne met sur la fiche modèle
Sécurité. Des poids ouverts ne rendent pas un modèle sûr. Dans son évaluation 2025 d'anciens modèles DeepSeek, le NIST, l'organisme américain, a constaté que le meilleur d'entre eux, R1-0528, répondait à 94 % des requêtes ouvertement malveillantes avec des jailbreaks courants, contre 8 % pour les modèles américains de référence. Les agents de DeepSeek étaient aussi 12 fois plus susceptibles de suivre des instructions malveillantes cachées dans le contenu qu'ils traitaient (NIST CAISI). Ce sont des modèles antérieurs à la gamme V4 actuelle, et aucune évaluation publique équivalente des versions actuelles n'est apparue dans les sources de cet article. Voyez-y une raison de tester, surtout avant de donner à un modèle des outils et un accès en écriture.
Censure. Le NIST a aussi constaté que les modèles DeepSeek reprenaient quatre fois plus de discours inexacts du PCC que les modèles américains de référence. Un rapport distinct du NIST sur Kimi K2 Thinking a relevé une forte censure en chinois, mais un modèle relativement peu censuré en anglais, en espagnol et en arabe. Si vos utilisateurs posent des questions de politique ou d'histoire en chinois, testez cela directement. Si c'est du code et des tableurs, le sujet se pose rarement.
Résidence des données. Celui qui héberge le modèle décide où vont vos données. La politique de confidentialité de DeepSeek indique qu'elle collecte, traite et stocke les données personnelles en République populaire de Chine (politique de confidentialité de DeepSeek). Cela vaut pour son appli et son API, pas pour les poids sous licence MIT que vous faites tourner ailleurs. Mistral tient le discours inverse : l'entreprise dit avoir entraîné Large 4 dans ses propres datacenters en Europe et exploiter l'aperçu comme un déploiement européen soumis au droit européen. Pour tout hébergeur, demandez où tourne l'inférence et ce qui est journalisé avant d'envoyer des données clients.
Obsolescence. Les modèles ouverts se périment en quelques mois. Les poids de gpt-oss ont un an, le Llama le plus récent de Meta date de 2025, et Qwen comme DeepSeek ont chacun sorti plusieurs versions rien qu'en 2026. Figez la version exacte du modèle que vous avez testée, et retestez à chaque mise à niveau.
Qui doit encore payer une API fermée
L'écart de 3 % est la lecture d'un seul benchmark. Les modèles fermés gardent l'avantage tout en haut, et les labos qui les vendent ajoutent sans cesse des outils et des fonctions managées que les poids ouverts n'incluent pas.
Payez Claude ou ChatGPT si vous avez besoin de la meilleure précision sur un travail difficile à fort enjeu, si personne ne peut gérer l'infrastructure, ou si le volume est trop faible pour que la moindre solution d'hébergement compte. Une équipe qui fait quelques milliers d'appels par jour dépensera moins en temps d'ingénieur qu'elle n'économise en tokens. Payez aussi si vous voulez qu'un seul fournisseur réponde de la disponibilité, de la sécurité et du support.
Mixez, ne basculez pas. Une configuration courante envoie le gros du travail routinier à un modèle ouvert via un hébergeur et fait remonter les cas difficiles vers un modèle fermé. Les règles de routage de notre guide sur l'adéquation entre paliers de modèles et tâches s'appliquent directement : par défaut le moins cher, on monte en cas d'échec.
Questions fréquentes
Quelle différence entre open-weight et open source ?
Open-weight signifie que vous pouvez télécharger le modèle entraîné. L'open source, au sens strict, inclurait aussi les données d'entraînement et le code sous une licence approuvée. Presque rien dans cette liste n'atteint ce niveau. Les modèles Apache 2.0 et MIT s'en rapprochent le plus en pratique. Les licences personnalisées comme celles de Kimi et de Qwen ajoutent des conditions.
Puis-je utiliser ces modèles à des fins commerciales ?
Oui pour construire des produits dessus, avec toutes les licences abordées ici. Les conditions mordent quand vous vendez le modèle lui-même comme service, et dans quelques cas quand votre produit est énorme. Les modèles Apache 2.0 et MIT n'imposent aucune condition de revenu.
Quel modèle ouvert est le meilleur pour le code ?
Selon les chiffres des éditeurs, GLM-5.3, Kimi K3 et DeepSeek V4.1 Flash sont en tête, et tous trois exigent du matériel de classe serveur. Pour une seule machine, Qwen3.8-27B est le choix pratique. Faites vos propres tests sur votre propre base de code, car les suites de benchmarks diffèrent.
DeepSeek est-il sûr pour les données d'entreprise ?
Cela dépend de la façon dont vous le faites tourner. L'appli et l'API DeepSeek stockent les données en Chine selon la politique citée plus haut. Les poids MIT, exécutés sur vos propres serveurs ou chez un hébergeur de confiance, n'envoient rien à DeepSeek. Les risques distincts liés au comportement du modèle, relevés par l'ancienne évaluation du NIST, restent valables.
De combien de mémoire GPU ai-je besoin ?
Environ le nombre de paramètres multiplié par le nombre de bits, divisé par huit, plus environ 20 % pour le cache et l'exécution. Un modèle de 27B en 8 bits pèse autour de 33 Go avec la surcharge. Un modèle de 117B en 4 bits, autour de 70 Go. L'estimateur ci-dessus fait les calculs pour vous.
Quand Mistral Large 4 sera-t-il ouvert ?
Mistral a promis les poids peu après l'annonce, mais n'a pas publié les termes de la licence. Consultez sa page Hugging Face avant de planifier quoi que ce soit.