

Pour la plupart des développeurs en 2026, le vrai choix se fait entre Claude Code et Codex, et sur le benchmark public le plus exigeant pour le travail en terminal, ils sont à égalité dans la marge d'erreur. Gemini CLI, le troisième nom de toutes les comparaisons de l'an dernier, n'est plus disponible pour les utilisateurs gratuits et grand public : Google l'a remplacé plus tôt cette année par un outil propriétaire baptisé Antigravity CLI.
Cela change la donne. Les deux premiers se repassent la tête de classement à chaque version, donc la qualité du modèle départage mal. Ce qui distingue ces outils aujourd'hui, c'est ce que l'agent peut faire sur votre machine sans demander, comment vous payez, et si un responsable d'équipe peut contrôler les deux. Codex propose les réglages par défaut les plus sûrs et un client open source. Claude Code offre la boîte à outils la plus riche pour les équipes qui veulent le scripter et l'étendre. Le CLI de GitHub Copilot convient aux organisations déjà installées dans GitHub qui veulent les modèles de plusieurs labos sur une seule facture, et OpenCode est le bon choix si vous voulez de l'open source et le modèle de votre choix.
Les prix et fonctionnalités ci-dessous proviennent des documentations et pages tarifaires des éditeurs, et chaque chiffre de benchmark cite sa source.
Ce qui a changé cette année pour les agents terminal
Quatre évolutions comptent si vous avez regardé cette catégorie pour la dernière fois il y a un an.
Google a retiré Gemini CLI pour la plupart des gens. Lors de Google I/O, l'entreprise a annoncé que Gemini CLI cesserait de traiter les requêtes des utilisateurs gratuits et des abonnés Google AI Pro et Ultra, avec ses extensions d'IDE désactivées le même jour (Google Developers Blog). Son remplaçant, Antigravity CLI, est écrit en Go et repose sur le même socle d'agent que la nouvelle application de bureau Antigravity 2.0 de Google. Les organisations sur Gemini Code Assist Standard ou Enterprise, et les développeurs qui paient via des clés API Gemini, conservent Gemini CLI.
GitHub a rendu Copilot CLI généralement disponible, puis a basculé tous les forfaits Copilot vers des crédits IA à l'usage : les sessions en terminal puisent désormais dans une enveloppe mesurée à 0,01 $ le crédit (GitHub Docs).
Anthropic a changé ce qui se passe à l'ouverture d'une session. Depuis Claude Code v2.1.283, les sessions interactives en terminal démarrent en mode auto : un second modèle, que Anthropic appelle le classifieur, examine les actions au lieu de vous demander confirmation pour chacune (Claude Code docs).
OpenAI a mis à jour le CLI de Codex cette semaine avec le contrôle vocal, une vue /agents pour suivre les tâches en parallèle et des environnements cloud réutilisables qu'une équipe peut partager avec des réglages et des permissions validés (TechCrunch). Pendant ce temps, Aider, l'option open source historique, n'a rien publié depuis une version corrective mineure en début d'année, et sa dernière version avec nouveautés date de l'an dernier (PyPI).
La boucle que tout agent terminal exécute
Débarrassés de leur marque, tous ces outils font le même travail. Vous décrivez une tâche en langage naturel. L'agent lit les fichiers concernés, établit un plan, modifie autant de fichiers que nécessaire, lance votre build et vos tests, et reboucle sur les échecs jusqu'à pouvoir vous présenter un diff.
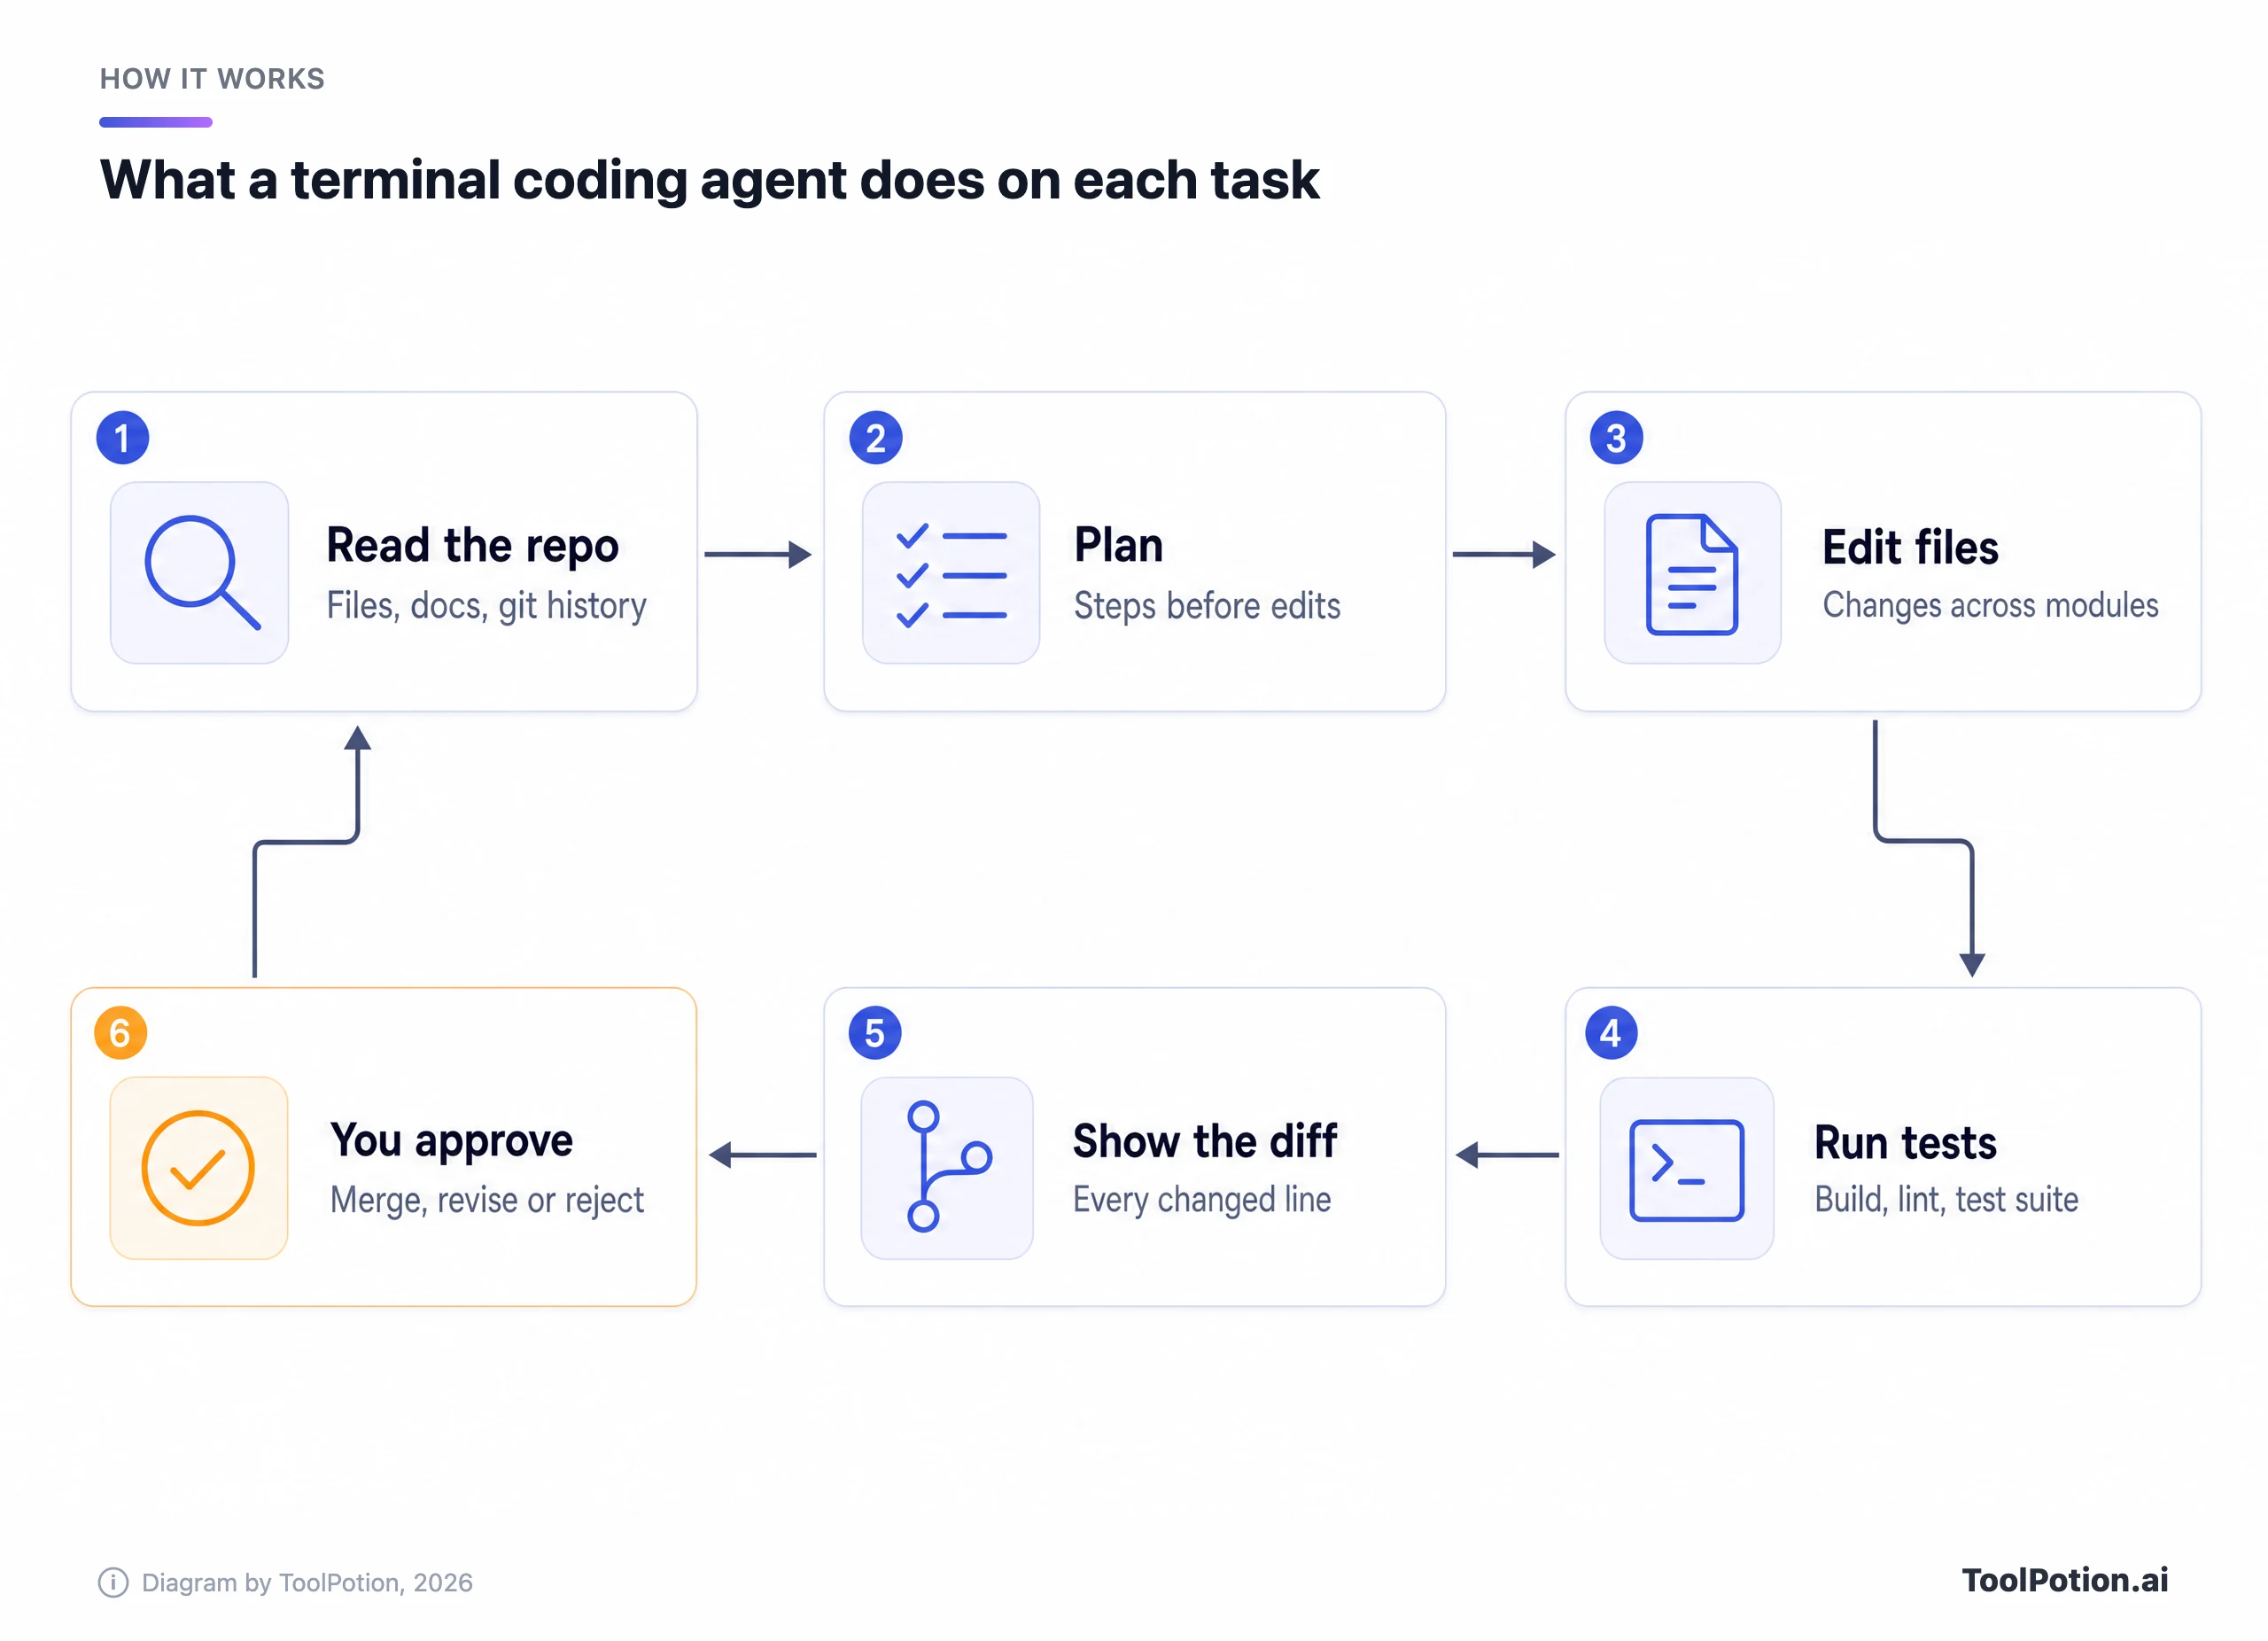
L'étape mise en avant est celle autour de laquelle il faut concevoir votre usage, car l'approbation est l'endroit où se logent votre jugement et votre politique de sécurité. Les outils diffèrent sur trois points autour de cette boucle : les modèles qui la pilotent, ce que l'agent peut faire avant votre approbation, et où il s'exécute (votre portable, un bac à sable de l'OS ou le cloud de l'éditeur). Les modèles font les gros titres, mais les deux autres points décident si toute une équipe peut l'utiliser.
Claude Code vs Codex, face à face
Ces deux-là sont les choix par défaut, et pour de bonnes raisons. Tous deux tournent sous macOS, Linux et Windows, lisent un fichier AGENTS.md, prennent en charge les serveurs MCP, les skills, les hooks, les plugins et les sous-agents, peuvent envoyer une tâche dans le cloud, et proposent chacun un forfait à 20 $ par mois. Les différences se nichent dans les détails.
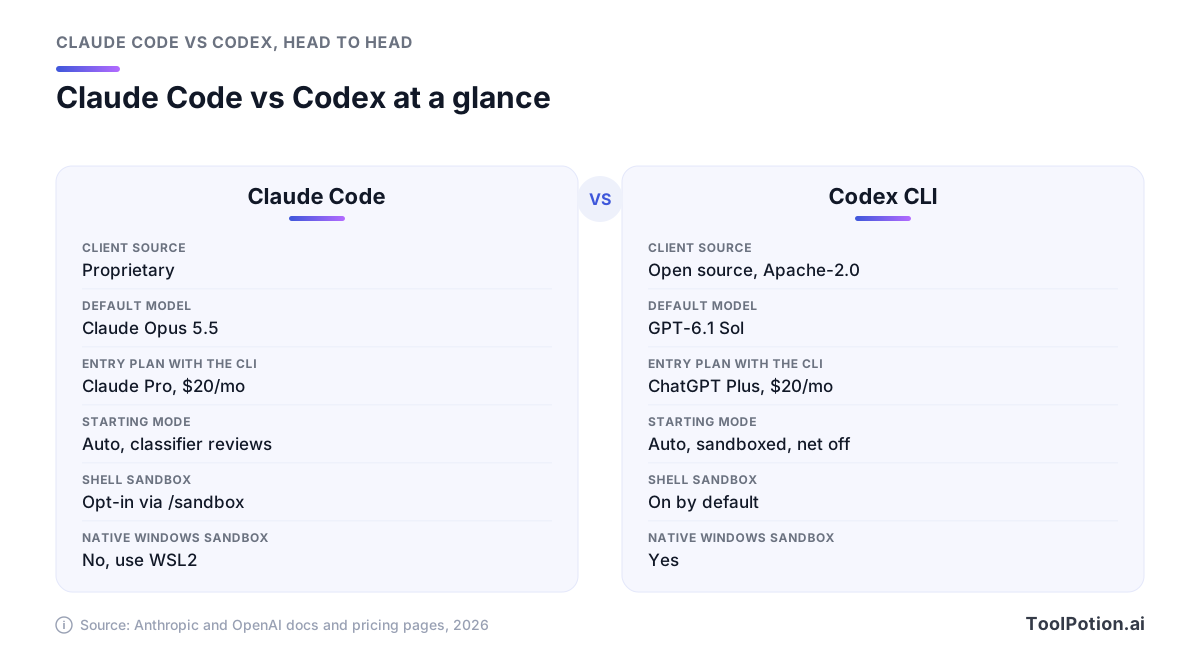
Commençons par les modèles. Claude Code n'exécute que les modèles d'Anthropic et utilise par défaut Claude Opus 5.5 sur tous les forfaits, avec Sonnet 5.5 et Haiku comme options moins chères, et Fable 5.1, le modèle le plus performant de Claude Code, en option explicite que certains forfaits facturent en crédits d'usage supplémentaires. Codex utilise par défaut GPT-6.1 Sol, qu'OpenAI présente comme presque équivalent à son modèle phare GPT-6 Astra en code agentique, pour un cinquième du prix API. Le client Codex est open source sous Apache-2.0 (le dépôt openai/codex est écrit en Rust), alors que la licence de Claude Code indique tous droits réservés.
Les réglages de sécurité par défaut marquent la différence la plus nette. Dans un dépôt git, Codex démarre dans un préréglage appelé Auto : il peut lire, modifier et exécuter des commandes dans l'espace de travail, mais un bac à sable au niveau de l'OS (Seatbelt sur macOS, bubblewrap plus seccomp sur Linux, un bac à sable natif sous Windows) bloque l'accès au réseau et à tout ce qui est hors du projet tant que vous n'avez pas approuvé. Hors d'un dépôt git, il repasse en lecture seule (OpenAI docs).
Claude Code prend l'autre voie. Son bac à sable du shell est désactivé par défaut, et sa première ligne de défense est le classifieur du mode auto plus des règles de refus, qui bloquent dans tous les modes. Lorsque vous activez le bac à sable, il n'enveloppe que les commandes shell, et celles-ci peuvent encore lire l'essentiel de la machine, y compris ~/.ssh et ~/.aws/credentials, tant que vous n'ajoutez pas de règles de refus (Claude Code docs). Sous Windows natif, il n'y a aucun bac à sable, et Anthropic vous renvoie vers WSL2.
Claude Code l'emporte en profondeur. Les plugins regroupent skills, sous-agents, hooks et serveurs MCP, et s'installent depuis des marketplaces que les admins peuvent autoriser ou bloquer. Les routines exécutent des tâches planifiées dans le cloud d'Anthropic, les intégrations GitHub Actions et GitLab CI/CD gèrent la revue et le tri, et l'Agent SDK permet de construire des agents sur les mêmes outils. Codex couvre l'essentiel du même terrain avec moins de cérémonie (hooks, skills, plugins, codex exec pour les scripts, une GitHub Action), et sa revue de code automatique couvre les pull requests GitHub et les merge requests GitLab.
Alors, où chacun est-il le plus faible ? Claude Code vous attache à un seul labo et s'appuie sur le jugement d'un modèle plutôt que sur une frontière au niveau de l'OS tant que vous ne changez pas un réglage, ce que certaines équipes de sécurité n'accepteront pas. Codex est lui aussi lié à un seul labo, et le modèle phare y est sévèrement rationné sur le forfait à 20 $ : OpenAI estime entre 5 et 45 messages locaux par tranche de cinq heures avec GPT-6 Astra sur Plus, contre 15 à 160 avec GPT-6.1 Sol (OpenAI pricing).
Antigravity CLI a remplacé Gemini CLI pour la plupart des gens
Cherchez Gemini CLI aujourd'hui et vous trouverez toujours le dépôt Apache-2.0, qui publie encore des versions (la v0.62.0 est sortie cette semaine). Sa documentation affiche en revanche une bannière indiquant aux utilisateurs gratuits et Google One que Gemini CLI a été remplacé. Ceux qui peuvent continuer à l'utiliser sont les organisations disposant de licences Gemini Code Assist Standard ou Enterprise et les développeurs avec des clés API payantes Gemini ou Gemini Enterprise Agent Platform.
Le CLI qui l'a remplacé au sein de Google Antigravity est un produit d'une autre nature. Il est propriétaire, et Tech Times rapporte que son dépôt public ne contient aucun code source, un point sensible pour un projet qui, selon le décompte de Google lui-même, a fusionné 6 000 pull requests. Google reconnaît qu'il n'y a pas encore de parité 1:1 des fonctionnalités, même si les skills, hooks, sous-agents et extensions (désormais appelées plugins) ont suivi.
Il y a aussi de vrais avantages. Le menu des modèles d'Antigravity propose Gemini 3.8 Flash et Gemini 3.1 Pro à côté de Claude Sonnet 5.5, Claude Opus 5.5 et du modèle à poids ouverts GPT-OSS-120b : un seul abonnement Google donne donc accès aux modèles de deux labos, même si la disponibilité varie selon l'offre. Son préréglage par défaut sur macOS et Linux est aussi, sur le papier, au moins aussi strict que celui de Codex : les commandes de terminal s'exécutent dans un bac à sable sans réseau, l'accès aux fichiers s'arrête à l'espace de travail et aux dossiers temporaires, ~/.ssh et les fichiers .env sont bloqués, et les actions MCP et web demandent d'abord confirmation (Antigravity docs). Sous Windows, ce bac à sable est désactivé par défaut.
Le hic, c'est le quota. L'offre Individual gratuite affiche des limites hebdomadaires de base, très loin des 1 000 requêtes gratuites par jour que Gemini CLI accordait aux comptes personnels. La capacité payante repose sur les forfaits Google AI Pro et Ultra, et Google a redistribué ces offres au lancement d'Antigravity : consultez donc les limites actuelles sur la page des forfaits de Google avant de vous engager. Choisissez Antigravity CLI si vous vivez sur Google Cloud, si vous voulez des modèles Claude sans contrat Anthropic distinct, ou si vous voulez des réglages de bac à sable stricts dès l'installation. Passez votre chemin si un client open source compte pour vous.
Copilot CLI, Cursor, OpenCode et les autres
Copilot CLI est l'option la plus sous-estimée pour les entreprises. Il fait tourner des modèles d'Anthropic, d'OpenAI et de Google sur une seule facture, et dispose de l'outillage moderne : un mode plan, un mode autopilot, des agents intégrés pour explorer et relire le code, MCP, plugins, skills, hooks, et un préfixe & qui confie une tâche à l'agent de code cloud de GitHub (GitHub Changelog). Tous les forfaits l'incluent : Free, Pro à 10 $ par mois, Pro+ à 39 $ et Max à 100 $, plus Business à 19 $ et Enterprise à 39 $ par siège (GitHub Docs).
Son point faible, ce sont les permissions. Copilot vous demande de faire confiance à un dossier, puis approuve les outils un par un ou pour toute la session, et la documentation de GitHub avertit elle-même qu'approuver rm pour une session lui permet de supprimer n'importe quel fichier de cette arborescence sans rien demander. Le bac à sable local est optionnel via /sandbox enable, et un drapeau --yolo désactive toutes les vérifications.
Voici comment se comparent les quatre plus gros noms sur des critères que vous pouvez vérifier dans leurs docs et leurs licences plutôt que dans leur marketing.
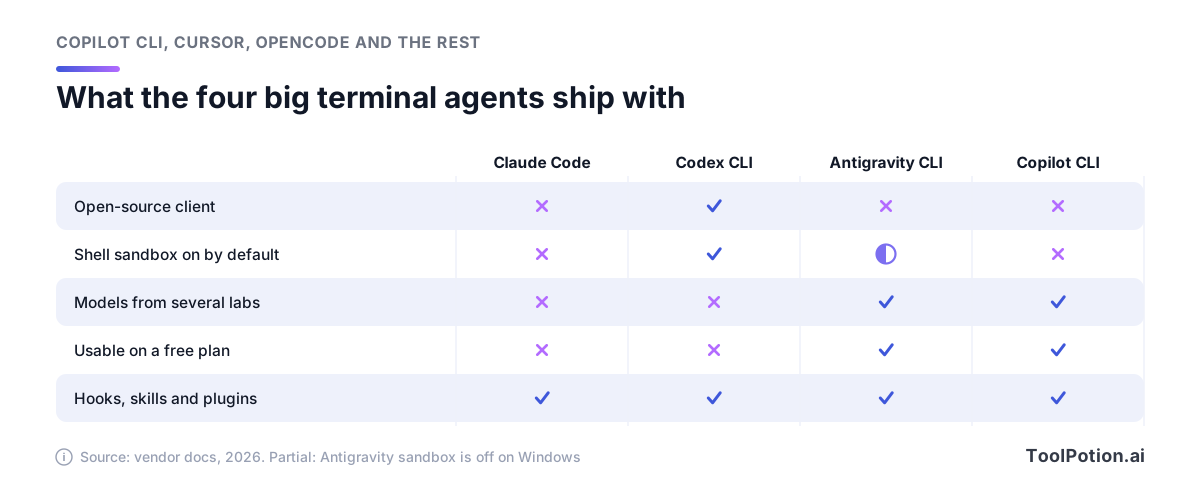
Seul Codex associe un client open source à un bac à sable activé partout par défaut. Antigravity et Copilot sont les deux qui mélangent les modèles de plusieurs labos sans bricolage supplémentaire. L'extensibilité a convergé, puisque les quatre acceptent hooks, skills et plugins.
Cursor amène son agent d'éditeur dans le terminal avec les modes agent, plan et ask, un mode print pour les scripts et la CI, et le même relais & vers un agent cloud. C'est le complément évident si votre équipe paie déjà Cursor (Individual à partir de 20 $ par mois, Teams à 40 $ par utilisateur) et un argument difficile à défendre sinon.
OpenCode est l'open source qui sort du lot : sous licence MIT, plus de 211 000 étoiles GitHub, et branché sur plus de 75 fournisseurs de modèles, y compris des modèles locaux. Vous pouvez vous connecter avec un compte GitHub Copilot ou ChatGPT Plus ou Pro au lieu de payer deux fois. Méfiez-vous toutefois de ses réglages par défaut. OpenCode laisse l'agent modifier des fichiers et exécuter des commandes shell sans demander, sauf si vous écrivez des règles, il n'a pas de bac à sable au niveau de l'OS, et ses garde-fous intégrés ne couvrent que les fichiers .env, les chemins hors du projet et un agent qui tourne en boucle sur lui-même (OpenCode docs).
Trois autres méritent une ligne chacun. Amp répercute les coûts des modèles aux tarifs des fournisseurs, sans marge pour les particuliers, mélange GPT-5.6 et Claude Fable 5.1 sous le capot, et propose une offre gratuite et un forfait à 20 $. Warp est désormais un terminal agentique sous licence AGPL avec son propre agent, tarifé du gratuit à 20 $ pour Build et 200 $ pour Max, et affirme fonctionner avec n'importe quel agent de code compatible MCP. Aider a toujours la meilleure gestion de git, en commitant chaque modification avec un message que vous pouvez comparer et annuler, mais son rythme de publication a calé : vérifiez donc qu'il prend en charge le modèle voulu avant de vous engager. Pour un panorama plus large, notre classement des assistants de code IA et notre classement des agents IA suivent l'évolution des rangs.
Les benchmarks placent Claude Code et Codex à égalité
Le repère public le plus utile pour cette catégorie est Terminal-Bench, hébergé par Stanford, Harbor et le Laude Institute, qui note des paires agent-modèle sur des tâches difficiles dans un vrai terminal. Sur son classement 4.0 actuel, Codex avec GPT-6 Astra au niveau de raisonnement maximal mène à 58,2 %, et Claude Code avec Fable 5.1 à l'effort maximal est à 57,9 % (Terminal-Bench). Chaque entrée repose sur 330 essais avec un intervalle de confiance d'environ trois points dans chaque sens : considérez que c'est une égalité.
Le plus intéressant, c'est le curseur d'effort. Comparez chaque paire à son réglage de raisonnement le plus bas et le plus haut.
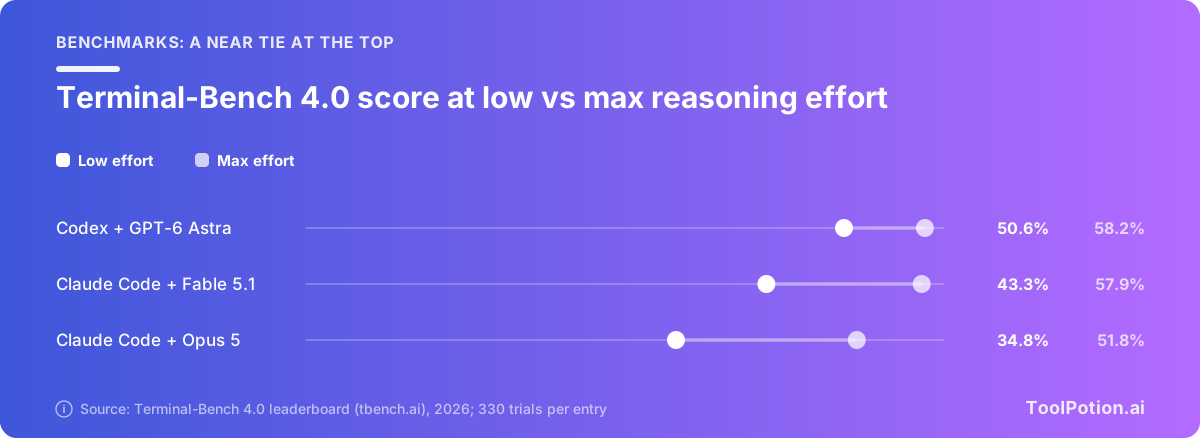
Passer de l'effort maximal à l'effort faible coûte moins de 8 points à Codex avec Astra et près de 15 à Claude Code avec Fable 5.1. Claude Code avec l'ancien Opus 5 en perd 17. Le réglage que vous laissez par défaut peut compter autant que la marque sur la boîte.
Le coût raconte une seconde histoire. Le classement consigne ce que chaque exécution a dépensé : 3 267 $ pour Codex avec Astra à effort maximal contre 6 244 $ pour Claude Code avec Fable 5.1, soit environ 9,90 $ contre 18,90 $ par tâche pour le même score. Ce sont des coûts aux tarifs API pour des tâches longues et difficiles, pas ce que paie un abonné. Aucun agent Google n'apparaît au classement, si bien que la meilleure entrée utilisant un modèle Gemini est un agent tiers avec Gemini 3.8 Flash à 19,1 %. Les affirmations des éditeurs, comme celle d'Anthropic selon laquelle Sonnet 5.5 bat Opus 5.5 en code agentique, proviennent de leurs propres tests.
Les modes de permission, de la lecture seule au plein automatique
Tous les outils proposent désormais la même échelle d'autonomie sous des noms différents. Le barreau que vous choisissez détermine la fréquence des interruptions, et les dégâts qu'une mauvaise instruction (ou une injection de prompt cachée dans un README) peut causer.
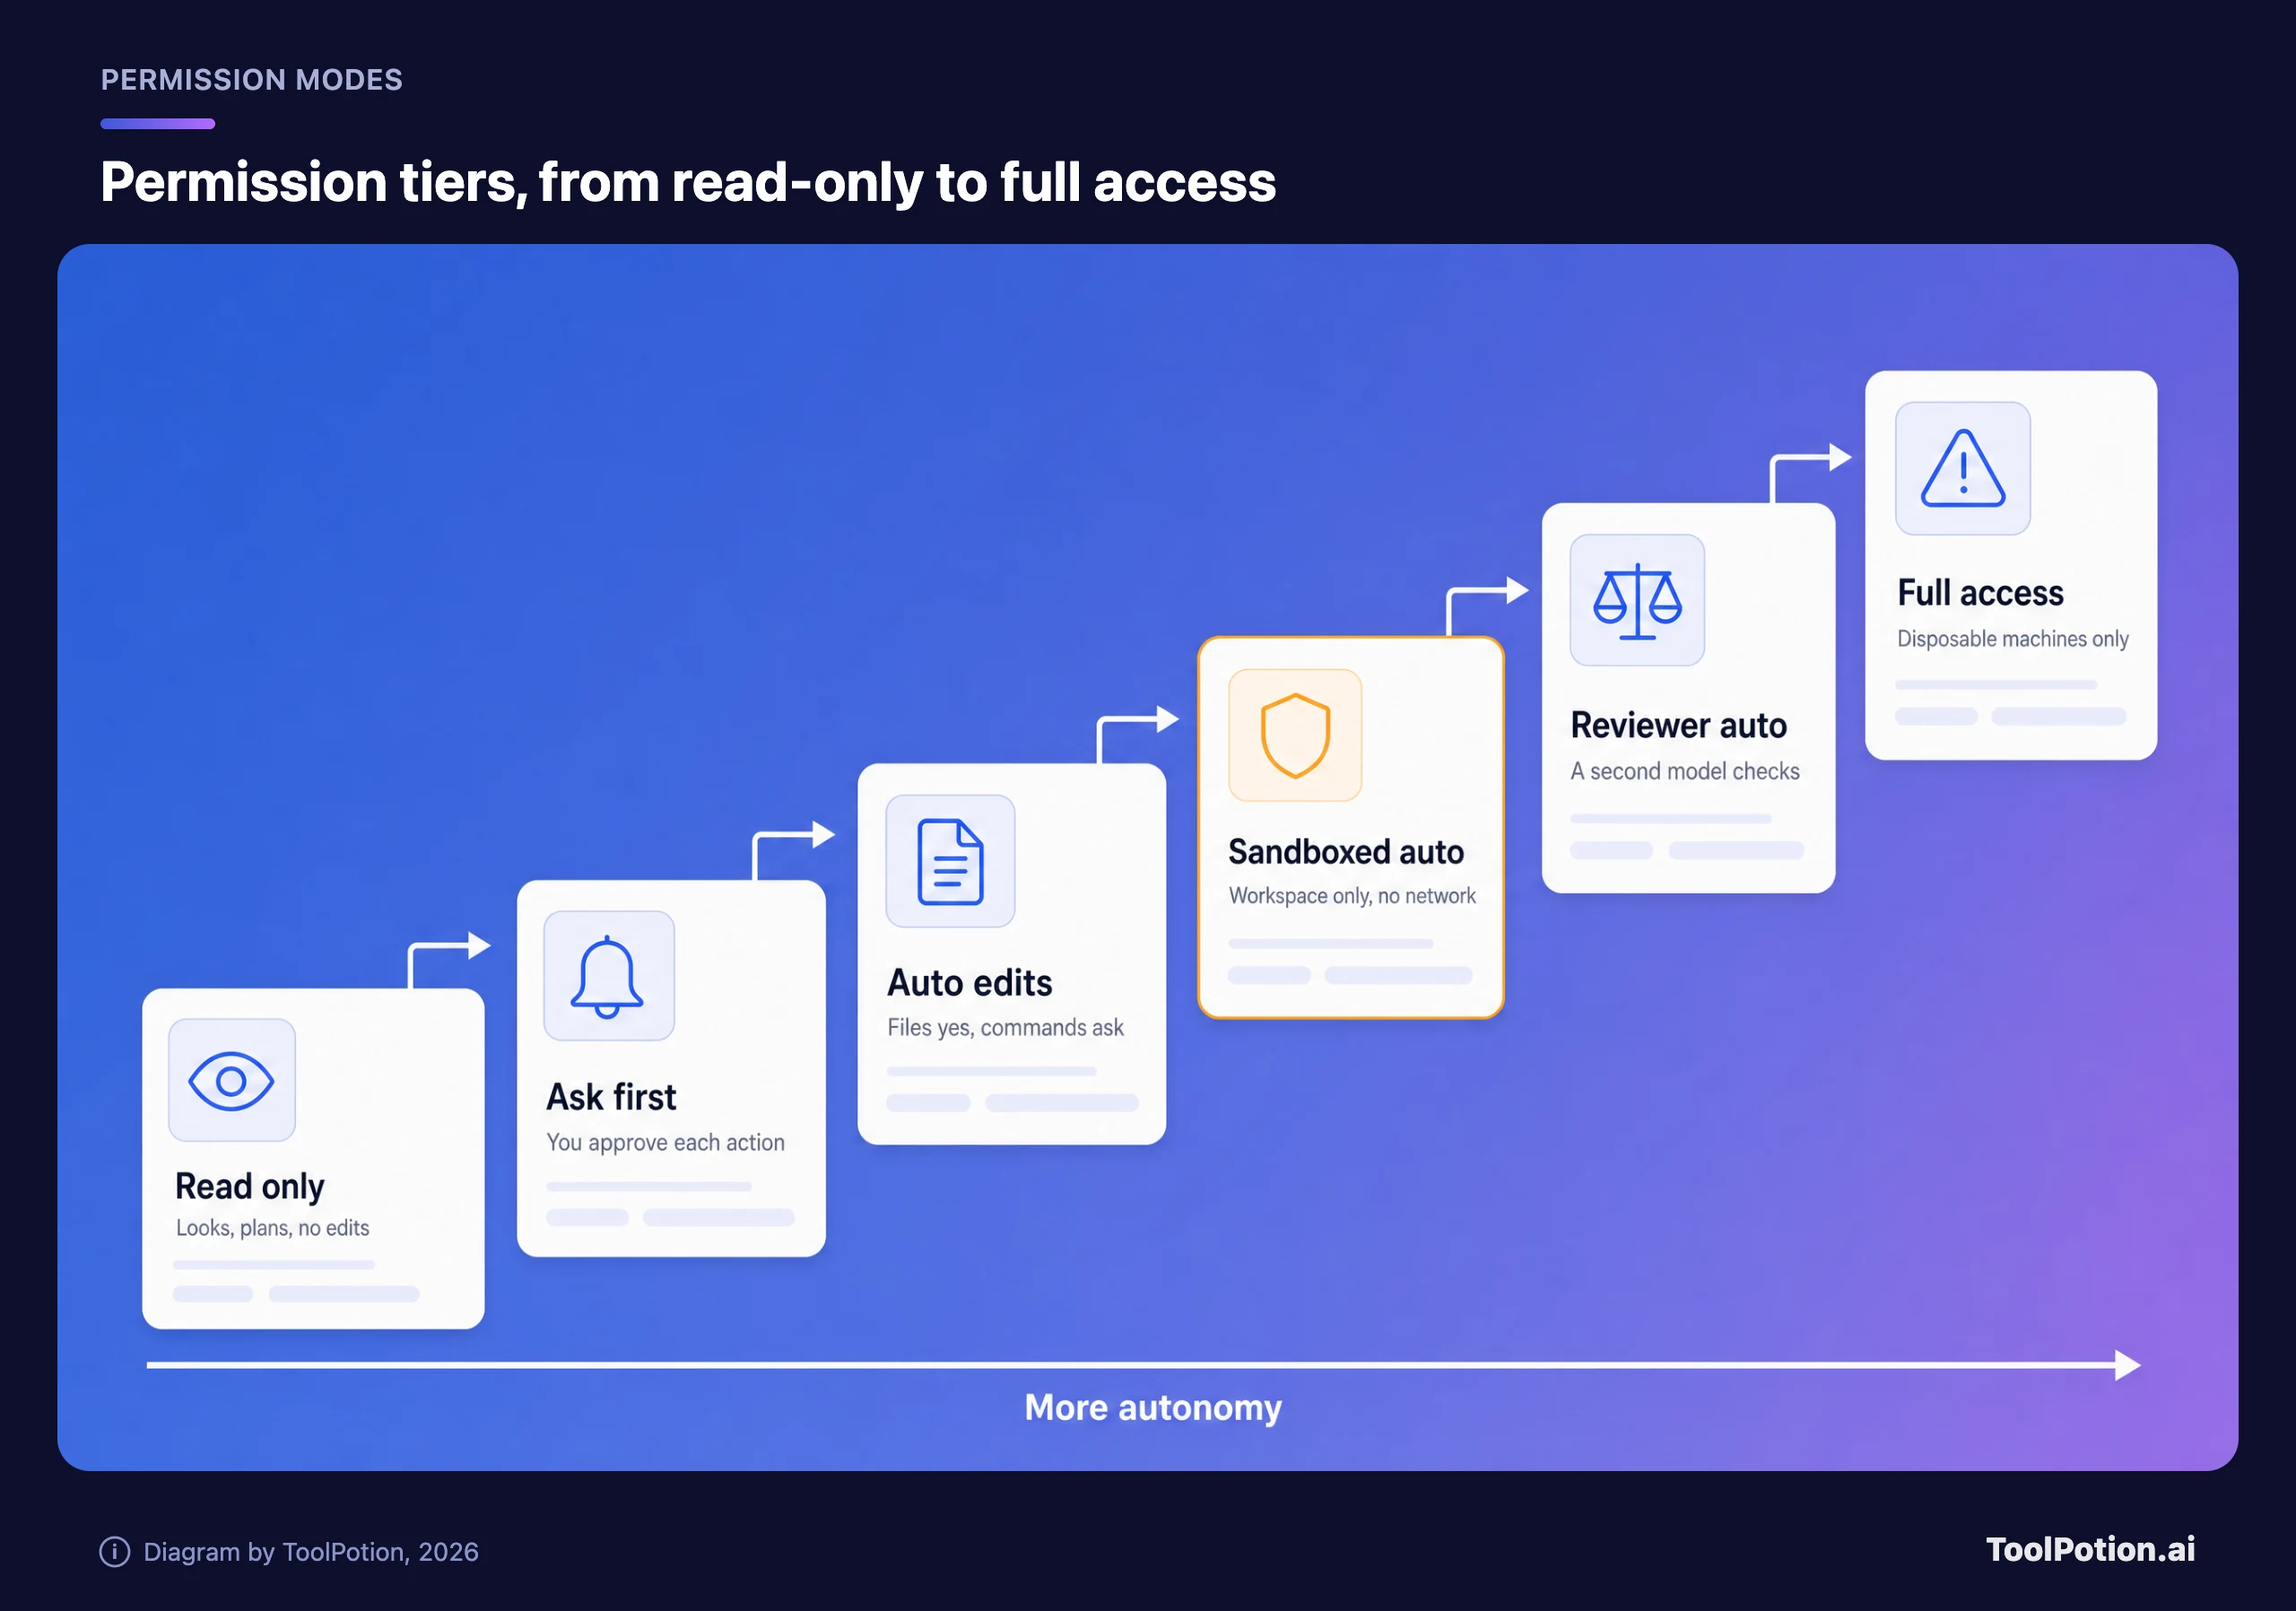
L'auto en bac à sable est le bon réglage quotidien. L'agent modifie et exécute des commandes librement dans le projet, sans réseau et sans accès à votre répertoire personnel. L'auto avec relecteur réduit encore les confirmations, mais s'en remet au jugement d'un modèle. L'accès complet a sa place dans des conteneurs et des VM jetables, ce que la documentation d'Anthropic dit aussi de bypassPermissions. Voici comment s'appelle chaque barreau dans les quatre principaux outils.
| Niveau | Claude Code | Codex CLI | Antigravity CLI | Copilot CLI |
|---|---|---|---|---|
| Lecture seule | plan | read-only | Mode plan | Mode plan |
| Demander d'abord | default (Manual) | Approbations granulaires | Request Review | Confirmation par outil |
| Modifications auto | acceptEdits | Aucun | Accept-Edits | Approuver l'outil pour la session |
| Auto en bac à sable | /sandbox auto-allow | Auto (par défaut dans les dépôts git) | Préréglage par défaut | /sandbox enable |
| Auto avec relecteur | auto (par défaut) | Auto-review (optionnel) | Aucun | Aucun |
| Accès complet | bypassPermissions | danger-full-access | Turbo | --yolo |
Deux réglages par défaut se démarquent. Codex et Antigravity vous placent dans un bac à sable dès le départ, alors que Claude Code et Copilot vous placent dans des modes qui reposent sur des confirmations ou sur la relecture d'un modèle. Si vous utilisez Claude Code, activer le bac à sable est le changement de réglage le plus utile que vous puissiez faire.
Forfaits ou clés API : combien vous allez payer
Chaque éditeur propose deux voies d'accès. Un forfait mensuel fixe plafonne votre facture, mais vous mesure avec des limites sur cinq heures et sur la semaine que les éditeurs décrivent en multiples, pas en tokens. Une clé API facture chaque token au tarif public, sans plafond.
| Agent | Forfait d'entrée | Paliers supérieurs | Équipes |
|---|---|---|---|
| Claude Code | Claude Pro, 20 $/mois (17 $ en facturation annuelle) | Max 5x 100 $, Max 20x 200 $ | Sièges Team 25 $ ou 125 $/mois ; Enterprise : siège à 20 $ plus usage au tarif API |
| Codex | ChatGPT Plus, 20 $/mois (le CLI n'est pas inclus dans Free ni Go) | Pro à 100 $, 200 $ ou 500 $ | Business 20 $/utilisateur (annuel) |
| Copilot CLI | Pro 10 $/mois (Free inclut un petit quota) | Pro+ 39 $, Max 100 $ | Business 19 $, Enterprise 39 $ par siège |
| Antigravity CLI | Offre Individual gratuite | Google AI Pro et Ultra | Business à partir de 30 $/siège via Google Cloud |
| Cursor CLI | Individual 20 $/mois | Paliers individuels supérieurs | Teams 40 $/utilisateur |
Les prix proviennent de la page tarifaire de chaque éditeur, dont celle d'Anthropic. Si le calcul des forfaits vous perd, notre guide des modèles de tarification des outils IA explique les crédits, les sièges et les tokens.
La voie API compte surtout pour les gros utilisateurs et la CI. Anthropic facture 4 $ par million de tokens en entrée et 20 $ par million en sortie pour Opus 5.5, et 2 $ et 10 $ pour Sonnet 5.5. OpenAI facture 2 $ et 10 $ pour GPT-6.1 Sol, et 10 $ et 50 $ pour GPT-6 Astra (OpenAI pricing). Le cache pèse plus sur la facture que les tarifs affichés, car les boucles d'agent renvoient sans cesse le même contexte. Dans l'exécution Terminal-Bench ci-dessus, environ 96 % des tokens d'entrée de Codex étaient des lectures de cache, qu'OpenAI facture au dixième du tarif d'entrée d'Astra.
Entrez vos propres chiffres ci-dessous. Les valeurs par défaut reprennent la répartition de tokens de l'une de ces tâches de benchmark (environ 10 $ la tâche sur Astra), et les exécutions de benchmark sont longues et difficiles : remplacez-les donc par les chiffres de votre propre tableau de bord d'usage avant de bâtir un budget dessus.
Avec les valeurs par défaut, un développeur qui lance 40 de ces tâches par mois sur Opus 5.5 dépenserait environ 126 $ via une clé API : Claude Pro et Max 5x reviennent donc moins cher tous les deux, si leurs limites tiennent. Passez le modèle sur GPT-6 Astra et la même charge coûte environ 401 $. Cet écart explique pourquoi les utilisateurs de Codex gagnent à réserver le modèle phare aux problèmes qui l'exigent et à laisser GPT-6.1 Sol faire le reste.
Comment choisir et déployer sans risque
Partez de l'endroit où vivent déjà votre code et vos contrats, puis laissez les réglages de sécurité trancher en cas d'égalité.
- Si votre équipe paie déjà ChatGPT, ou si vous voulez un client open source avec un bac à sable activé par défaut, commencez par Codex.
- Si vous voulez la personnalisation la plus poussée et que les modèles Claude vous conviennent, prenez Claude Code et activez son bac à sable avant toute chose.
- Si votre organisation tourne sur GitHub et veut les modèles Claude, GPT et Gemini sous un seul budget avec des plafonds par utilisateur, Copilot CLI est la solution la plus fluide.
- Les structures qui travaillent sur Google Cloud devraient essayer Antigravity CLI.
- Choisissez OpenCode quand il vous faut de l'open source de bout en bout ou des modèles locaux, et acceptez d'écrire vous-même les garde-fous.
Toujours hésitant ? Pondérez ci-dessous ce qui compte pour vous. Les scores sont notre lecture éditoriale de la documentation et des tarifs de chaque éditeur, pas des résultats de tests.
Avec la sécurité pondérée au maximum, Codex mène et Copilot CLI arrive deuxième. Placez l'administration d'équipe et les plafonds de dépenses en tête et Copilot prend l'avantage, tandis qu'en poussant au maximum le choix de modèles et l'open source, OpenCode passe premier. Claude Code remonte dès que l'extensibilité pèse plus que des réglages par défaut sûrs.
Un déploiement sûr en équipe
- Pilotez un seul agent avec quelques développeurs sur un seul dépôt, pour comparer des résultats plutôt que des outils.
- Définissez le réglage de permission par défaut de façon centralisée. Dans Claude Code, cela passe par des paramètres gérés avec le bac à sable activé et des règles de refus pour les push et les déploiements, et les admins peuvent désactiver le mode auto pour toute l'organisation. Dans Codex, gardez workspace-write sans réseau et réservez danger-full-access aux exécutions de CI jetables.
- Gardez les secrets hors de portée. N'exécutez pas d'agents dans des shells qui détiennent des identifiants de production, interdisez la lecture de ~/.ssh, des fichiers d'identifiants cloud et de .env, et rappelez-vous que les hooks de Claude Code et les serveurs MCP locaux s'exécutent hors de son bac à sable, avec tous vos droits.
- Relisez les diffs de l'agent comme la pull request d'une nouvelle recrue. Les agents peuvent ouvrir des branches et des PR, mais c'est une personne qui fusionne. Un relecteur automatisé comme Claude Code Security Review ou la revue de code de Codex est un second contrôle, jamais un substitut.
- Plafonnez les dépenses avant de passer à l'échelle. Copilot prend en charge des budgets par utilisateur et par centre de coûts, et son usage supplémentaire est activé par défaut : plafonnez-le ou désactivez-le. Le forfait Enterprise d'Anthropic facture l'usage aux tarifs API en plus du siège, et les forfaits business d'Antigravity offrent des plafonds de dépenses couvrant l'usage API et abonnement.
- Examinez les plugins et serveurs MCP comme des dépendances. La documentation d'Anthropic précise qu'un plugin que vous installez exécute du code avec vos privilèges d'utilisateur : mettez donc les marketplaces sur liste d'autorisation plutôt que de laisser chacun ajouter les siennes.
- Donnez à la CI une liste d'autorisation exacte. Le mode dontAsk de Claude Code avec des outils nommés, ou Codex dans un bac à sable read-only ou workspace-write, rend les exécutions sans surveillance prévisibles.
Les équipes qui font déjà tourner des agents dans d'autres domaines de l'entreprise reconnaîtront l'essentiel de ce qui précède dans notre article sur les agents IA en production. Pour un tour d'horizon plus large des outils centrés sur l'éditeur, consultez notre comparatif des assistants de code IA.
Questions fréquentes
Gemini CLI est-il toujours disponible ?
Oui, pour les organisations sur Gemini Code Assist Standard ou Enterprise et pour les développeurs qui utilisent des clés API Gemini payantes. Les utilisateurs Free, Google AI Pro et Ultra ont été basculés vers Antigravity CLI. Le code Apache-2.0 reste sur GitHub, donc n'importe qui peut encore le forker.
Puis-je utiliser Claude Code avec un abonnement ChatGPT, ou Codex avec un forfait Claude ?
Non. Chaque forfait couvre l'agent de son propre éditeur. Si vous voulez un seul client pour plusieurs éditeurs, OpenCode se connecte avec des comptes ChatGPT Plus ou Pro et GitHub Copilot, tandis que Copilot CLI et Antigravity CLI regroupent les modèles de plusieurs labos dans un seul abonnement.
Quel agent terminal est le moins cher pour un développeur solo ?
Copilot Pro à 10 $ par mois est l'entrée payante la moins chère. ChatGPT Go à 8 $ n'inclut pas le CLI Codex, qui démarre à Plus. Copilot Free et l'offre gratuite d'Antigravity ne coûtent rien mais s'accompagnent de petits quotas. Pour un usage plus intensif, comparez Claude Pro et ChatGPT Plus à 20 $ avec votre facture API prévisionnelle.
Ai-je besoin d'un bac à sable si je relis chaque diff ?
Oui. La relecture du diff repère le mauvais code, mais elle intervient après que l'agent a déjà exécuté des commandes. Un bac à sable limite ce que ces commandes peuvent toucher pendant leur exécution, y compris les appels réseau qui pourraient envoyer un secret là où il ne devrait pas aller.
Terminal-Bench est-il fiable pour choisir ?
C'est le meilleur repère public pour le travail en terminal, mais il mesure des paires agent-modèle à des niveaux d'effort fixes sur des tâches difficiles. Des écarts de quelques points restent dans les intervalles de confiance : considérez-les comme des égalités et lancez un court pilote sur vos propres dépôts.