

"إذا كان عملك لا يستفيد من أدوات الذكاء الاصطناعي الحالية، فهذه نتيجة وليست إخفاقًا." بهذه العبارة خاطبت أمازون مهندسي البرمجيات لديها في مذكرة نقلتها CNBC. إنها جملة غير معتادة من شركة تبيع الذكاء الاصطناعي لشركات أخرى، ومن السهل اختزالها في عنوان: أمازون تطلب من مهندسيها استخدام ذكاء اصطناعي أقل.
المذكرة أكثر حذرًا من هذا العنوان، والجدل الدائر حولها أهم منها. فالـ tokens صارت بندًا في ميزانيات الهندسة، ويُسأل المديرون في كل مكان السؤال الذي أجابت عنه أمازون علنًا للتو: كيف تعرف أن هذا الإنفاق يشتري شيئًا فعلًا؟ فيما يلي ما تقوله المذكرة وما تغفله، وكم يكلّف المقعد فعلًا في أربع أدوات رئيسية، وأين يفيد وضع حد للإنفاق وأين يضر.
Tokenmaxxing مشكلة لوحات المتصدرين
تعرّف CNBC الـ tokenmaxxing بأنه استخدام المطورين للذكاء الاصطناعي "بأقصى قدر ممكن دون اكتراث بالمخرجات". وللمصطلح تاريخ صغير داخل أمازون. فبحسب CNBC، أغلقت الشركة هذا العام لوحة متصدرين داخلية بعد أن اكتشفت أن الموظفين يمارسون الـ tokenmaxxing لتسلّق الترتيب. أما رواية I-Programmer، التي تستند إلى تقارير Financial Times، فتقول إن اللوحة كانت تسمى Kirorank، وعملت بضعة أسابيع فقط ولم تحظَ باعتماد رسمي. اخترع الناس مهام تافهة لتشغّلها وكلاء الذكاء الاصطناعي، ودفعت أمازون ثمن الـ tokens.
ولم تكن أمازون وحدها. يقول التقرير نفسه إن Meta أغلقت هذا العام لوحة بناها موظفوها كانوا يتنافسون فيها على ألقاب مثل Token Legend، بحسب عدد الـ tokens التي أحرقوها في Claude Code. ويذكّر كذلك برسالة مسرّبة سابقة من نائب الرئيس الأول في أمازون Dave Treadwell يطلب فيها من الموظفين التوقف عن "استخدام الذكاء الاصطناعي لمجرد الاستخدام".
لم يكن على أحد أن يكون غير أمين كي يحدث هذا. ضع رقمًا على الشاشة ورتّب الناس بحسبه، فيرتفع الرقم.
ما الذي تقوله المذكرة وما الذي لا تقوله
بحسب CNBC، جرى تداول المذكرة داخليًا قبل أن تنشرها أمازون على موقعها. وهي تعدّل طريقة وصف الشركة لوظيفة مهندسي تطوير البرمجيات ومديريهم. ونتيجتها الأساسية تتعلق بالقياس. فاستخدام الـ tokens ومعدل اعتماد أدوات الذكاء الاصطناعي وأعداد تغييرات الكود أو المراجعات، كلها تبقى بحسب المذكرة طرقًا "معيبة جدًا" للحكم على استخدام الفريق للذكاء الاصطناعي، لأنها قد تدفع إلى تكاليف أعلى وتعقيد مفرط.
لكنها لا تذهب إلى حظر هذه الأرقام. فينبغي قراءتها "بعناية وبحكمة" إلى جانب بيانات أخرى، ومعيارها المفضل مذكور بوضوح: "نعتقد أن الأفضل أن نقيس، وأن نُقاس، بالنتائج بعيدة المدى".
قال متحدث باسم أمازون لـ CNBC إن الشركة لم تفرض حدودًا على استخدام الـ tokens. وهذا مهم، لأن "استخدموا ذكاءً اصطناعيًا أقل" تتجاوز ما نُشر فعلًا. فلا شيء في التغطية التي اطلعنا عليها يصف حصة محددة أو ميزانية لكل مهندس أو مبلغًا بالدولار. ولم تذكر أمازون كم تنفق، ولم يستطع أي من التقارير ذلك.
قدّم Marc Brooker، نائب الرئيس والمهندس المتميز في AWS، لـ CNBC منطق الأمر في شقين. فالشركة تنظر إلى أمور مثل سرعة إنجاز الميزات (كم عدد الإطلاقات وكم تغييرًا ناجحًا في الإنتاج) وتعامل الإنفاق على أنه استثمار. أما ما لا تريده فهو "الجهد المهدر" في مشكلات لا تهم، واعترف بأن من الصعب أحيانًا معرفة أيها كذلك، ولهذا يبقى هامش للتجريب.
بهذه القراءة، تبدو المذكرة أقرب إلى سياسة لتقييم الأداء منها إلى سياسة لخفض التكاليف. والسطر الذي نضع تحته خطًا هو المقتبس في البداية. فالمهندس الذي يستطيع أن يشرح أين لا يفيد الذكاء الاصطناعي بعد "يُظهر الحكمة التي نطلبها"، بحسب عبارة المذكرة. إنها شركة تطلب من المديرين ألا يعاقبوا الناس على إيقاف أداة.
لماذا تتراجع شركة تبيع الذكاء الاصطناعي
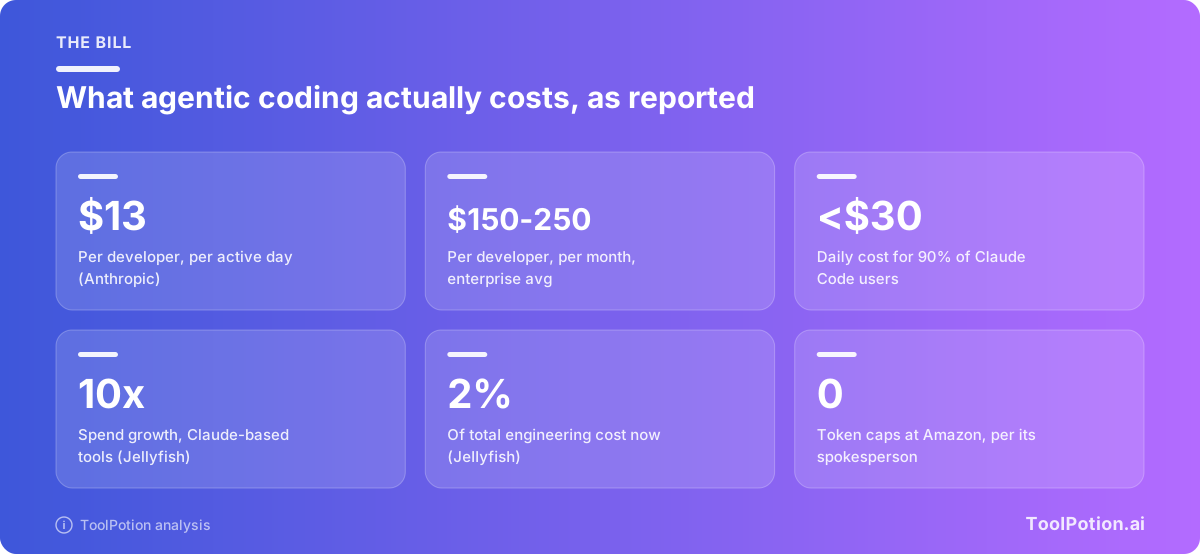
التكلفة هي الجواب الواضح، والأرقام تنمو أسرع من الميزانيات. نشرت Jellyfish، التي تصنع أدوات لفرق الهندسة، تقريرًا عن أدوات البرمجة الوكيلية غطّته TechCrunch. فعند عملاء Jellyfish، ارتفع الإنفاق على Claude Code وغيره من الأدوات المبنية على نماذج Anthropic عشرة أضعاف منذ بداية العام، ويعادل الآن نحو 2% من إجمالي تكلفة الهندسة. اثنان في المئة رقم صغير، لكن كبير العلماء في Jellyfish، Nicholas Arcolano، قال لـ TechCrunch إن "هذا النمو بعشرة أضعاف لم يخطط له معظم المديرين الماليين".
وتضع وثائق Anthropic نفسها حدًّا أدنى للرقم الفردي. ففي عمليات النشر المؤسسية، يبلغ متوسط تكلفة Claude Code نحو 13 دولارًا لكل مطور في اليوم النشط و150 إلى 250 دولارًا لكل مطور في الشهر، ويبقى 90% من المستخدمين دون 30 دولارًا في اليوم (وثائق Claude Code). وهذا متوسط لعملاء الشركة المزودة نفسها، فاعتبر تجربتك التجريبية الرقم الحقيقي.
سببان آخران هما استنتاج منا، ولا يذكرهما شيء مما نُشر. فالمقياس المبني على تغييرات الكود والمراجعات قد يدفن المراجعين تحت مخرجات لم يطلبها أحد. والمهندس الذي يطارد رقم استخدام لا يجد سببًا يذكر ليسأل هل كانت المهمة تحتاج إلى نموذج أصلًا. ولا تذكر تغطية المذكرة ولا التقارير المحيطة بها الأمن دافعًا، فلن ندّعي أنه كان كذلك.
تسريحات Microsoft الطوعية ومزوّد يبيع العدّاد
وصلت مذكرة أمازون في الأسبوع نفسه الذي ظهرت فيه قصص أخرى عن شركات توفّق بين الذكاء الاصطناعي ودفاترها، وهي ليست القصة نفسها. فقد عرضت Microsoft حزم تسريح طوعي على مجموعة تضم نحو 60,000 موظف مؤهل، أي نحو 27% من قوتها العاملة، بينما توازن بين بناء مكلف لبنية الذكاء الاصطناعي التحتية وكفاءة رأس المال. وتربط CNBC ذلك بالبنية التحتية والتدفق النقدي، لا باستخدام أي أحد للـ tokens. لكن المقال نفسه يقول إن Microsoft تحاول أن تحاسب العملاء بحسب مقدار ما يستخدمونه فعلًا من الذكاء الاصطناعي، وهذا هو العدّاد وقد انقلب.
ثم هناك الشركة صاحبة أكبر مصلحة في أن تنفق أكثر. فقد أطلقت Anthropic أدوات تقارير تتيح للمدير أن يرى ما أنتجه الفريق خلال فترة زمنية، وكم كلّف، وأين تعطلت مسارات العمل، إضافة إلى ميزانيات جماعية مشتركة تساعد الفرق على إدارة إنفاق الـ tokens. وتصف TechCrunch ذلك بأنه محاولة واضحة لإثبات العائد على الاستثمار. ومهما كان رأيك في الدافع، يُظهر المنتج ما بات المشترون يطلبونه: تكلفة لكل نتيجة بدل تكلفة لكل مقعد.
اعرف كم يكلّف المقعد فعلًا
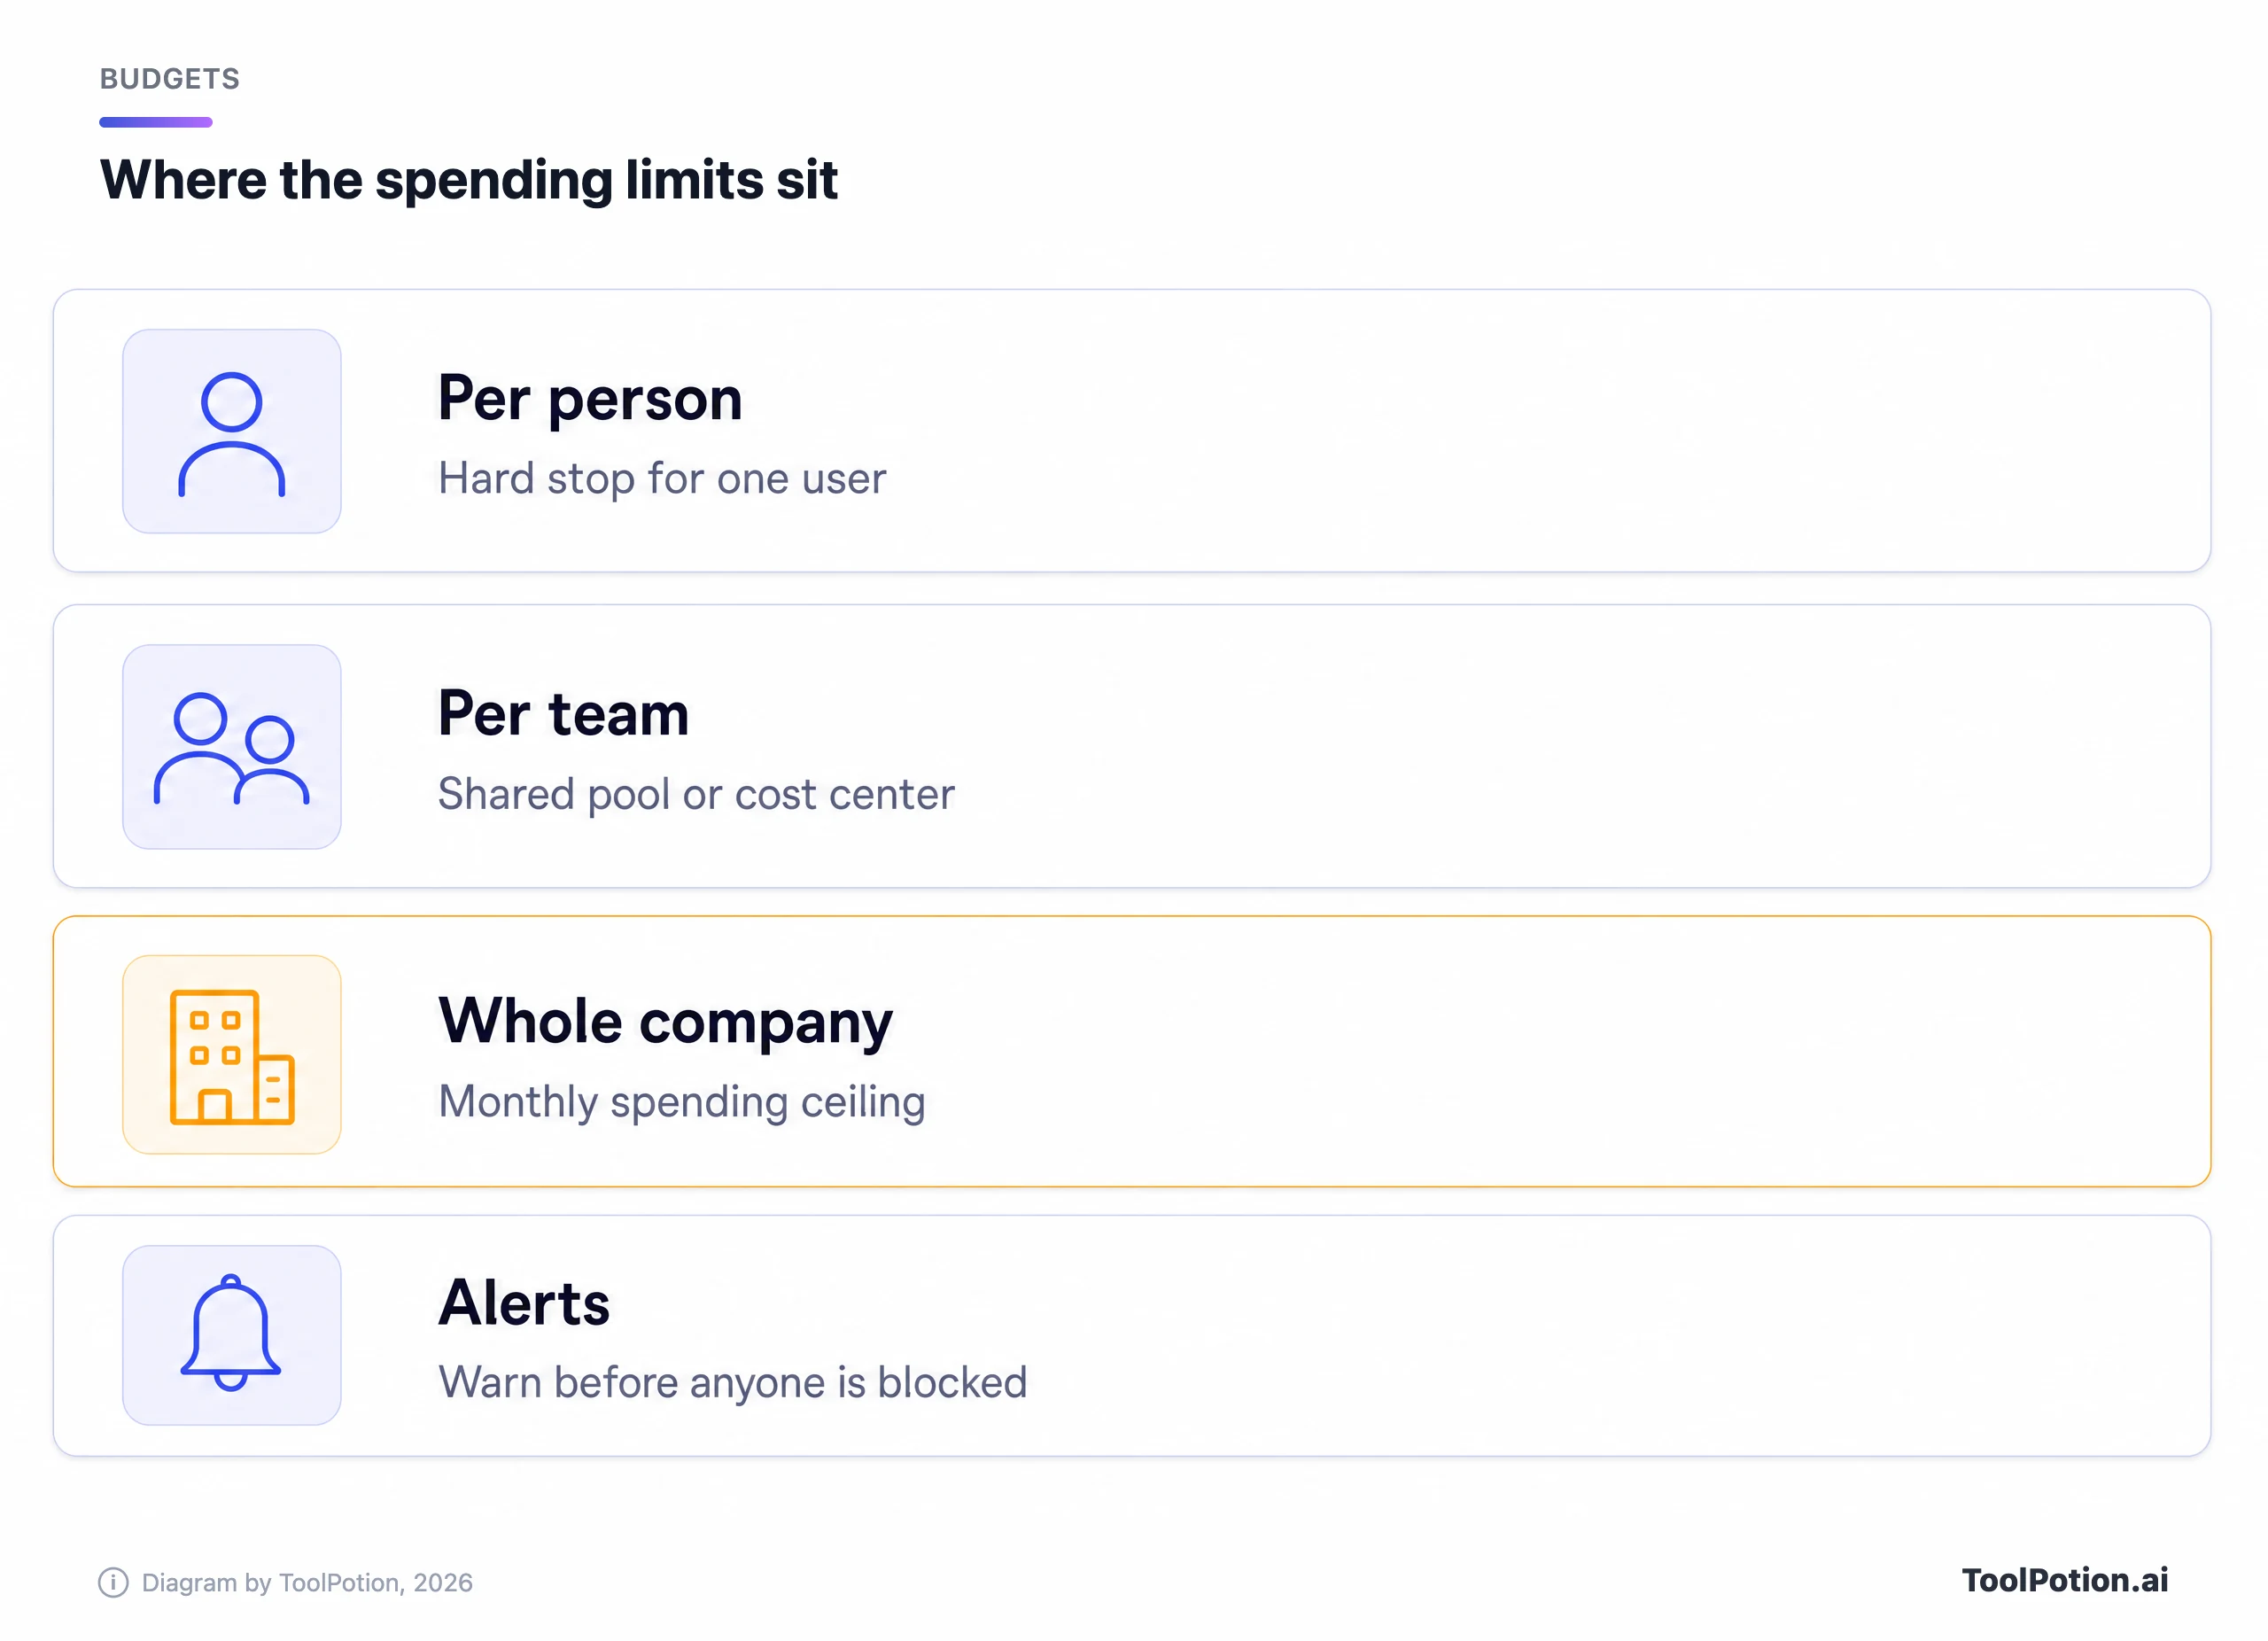
ابدأ بمجموعة تجريبية وخط أساس، وافعل ذلك قبل أن يكتب أحد أي حد للإنفاق. لقد اتجه المزودون جميعًا نحو الاستخدام المقيس، فصار سعر المقعد المعلن يخبرك بأقل كل سنة. وهذا ما تقيسه كل أداة رئيسية، من صفحات المزودين أنفسهم.
| الأداة | ما يُقاس | أين تضع الحد |
|---|---|---|
| GitHub Copilot | Tokens تُحوَّل إلى أرصدة ذكاء اصطناعي بسعر 0.01 دولار للرصيد. تجمّع Business 1,900 رصيد لكل مستخدم شهريًا، وEnterprise 3,900 | ميزانيات بالدولار على مستوى المستخدم ومركز التكلفة والمؤسسة |
| Cursor (Teams) | حصة أسبوعية لكل مقعد مدفوع لنماذج Cursor نفسها. أما نماذج الأطراف الثالثة فتُحاسَب من رصيد مدفوع مسبقًا مشترك | حد شهري للفريق، إضافة إلى حدود افتراضية وحدود لكل عضو |
| Claude Code | API tokens. تعتمد Teams وEnterprise على مخصصات المقاعد | حدود إنفاق في إعدادات المسؤول، أو حدود مساحة العمل في Console |
| Codex (ChatGPT) | مخصص مشترك مع ChatGPT Work، ثم أرصدة | أرصدة تشتريها، ولوحة الاستخدام لمراقبة الوتيرة |
هذه بعض التفاصيل وجدناها في الوثائق ولن تخبرك بها صفحة الأسعار. سياسة الاستخدام المدفوع في Copilot مفعّلة افتراضيًا في Business وEnterprise، فيستمر الإنفاق بعد تجاوز الأرصدة المشتركة ما لم يعطّلها المسؤول صراحةً (وثائق GitHub). وتبقى الإكمالات المضمنة غير محدودة حتى مع ميزانية قدرها 0 دولار. أما مراجعة الكود في Copilot فتُسعَّر بحسب مستوى الجهد: تقدّر GitHub من 0.05 إلى 1 دولار لمستوى Lite ومن 1.50 إلى 25 دولارًا لمستوى Max، بمتوسط نحو 10 دولارات، إضافة إلى دقائق Actions (نماذج GitHub وأسعارها). وهذه تقديرات، وتقول الوثائق إن حجم الـ pull request يغيّرها.
إذا كنت تقارن بين المحررات نفسها، فإن Cursor vs GitHub Copilot vs Windsurf يغطي ذلك. تبيع خطة Teams من Cursor مقاعد Premium وSuper وUltra بسعر 30 و100 و200 دولار شهريًا، ولكل منها حصة أسبوعية خاصة بنماذج Cursor نفسها لا تنتقل بين الزملاء. أما نماذج الأطراف الثالثة، ومنها Claude، فليست ضمن الحصة: إذ تُحاسَب من رصيد مدفوع مسبقًا مشترك بسعر قائمة الـ API مضافًا إليه رسم Cursor البالغ 0.25 دولار لكل مليون token (وثائق Cursor). وخطة Claude Enterprise بسعر 20 دولارًا للمقعد شهريًا إضافة إلى الاستخدام المحاسَب بأسعار الـ API (أسعار Claude). وتقول صفحة أسعار Codex بوضوح إن أسعار API tokens منفصلة عن استخدام الاشتراك ولا ينبغي استخدامها لتقدير المهام المشمولة.
وجّه العمل الروتيني إلى نموذج أرخص
أكبر رافعة في الوثائق ليست حدًّا للإنفاق. إنها النموذج. في قائمة أسعار API من Anthropic، يكلّف Claude Haiku 5.5 0.50 دولار لكل مليون output token للمطالبات حتى 100,000 token (ويرتفع إلى 2.50 دولار بعد ذلك)، وSonnet 5.5 10 دولارات، وOpus 5.5 20 دولارًا، وFable 5.1 50 دولارًا. هذا فارق مئة ضعف بين أدنى التشكيلة الواحدة وأعلاها، وجداول GitHub وCursor تُدرج أسعار الـ output نفسها.
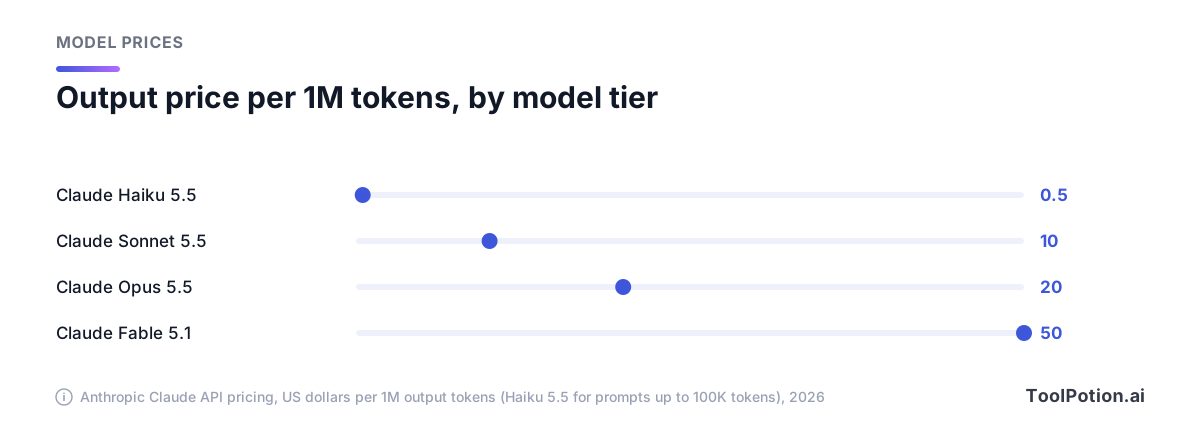
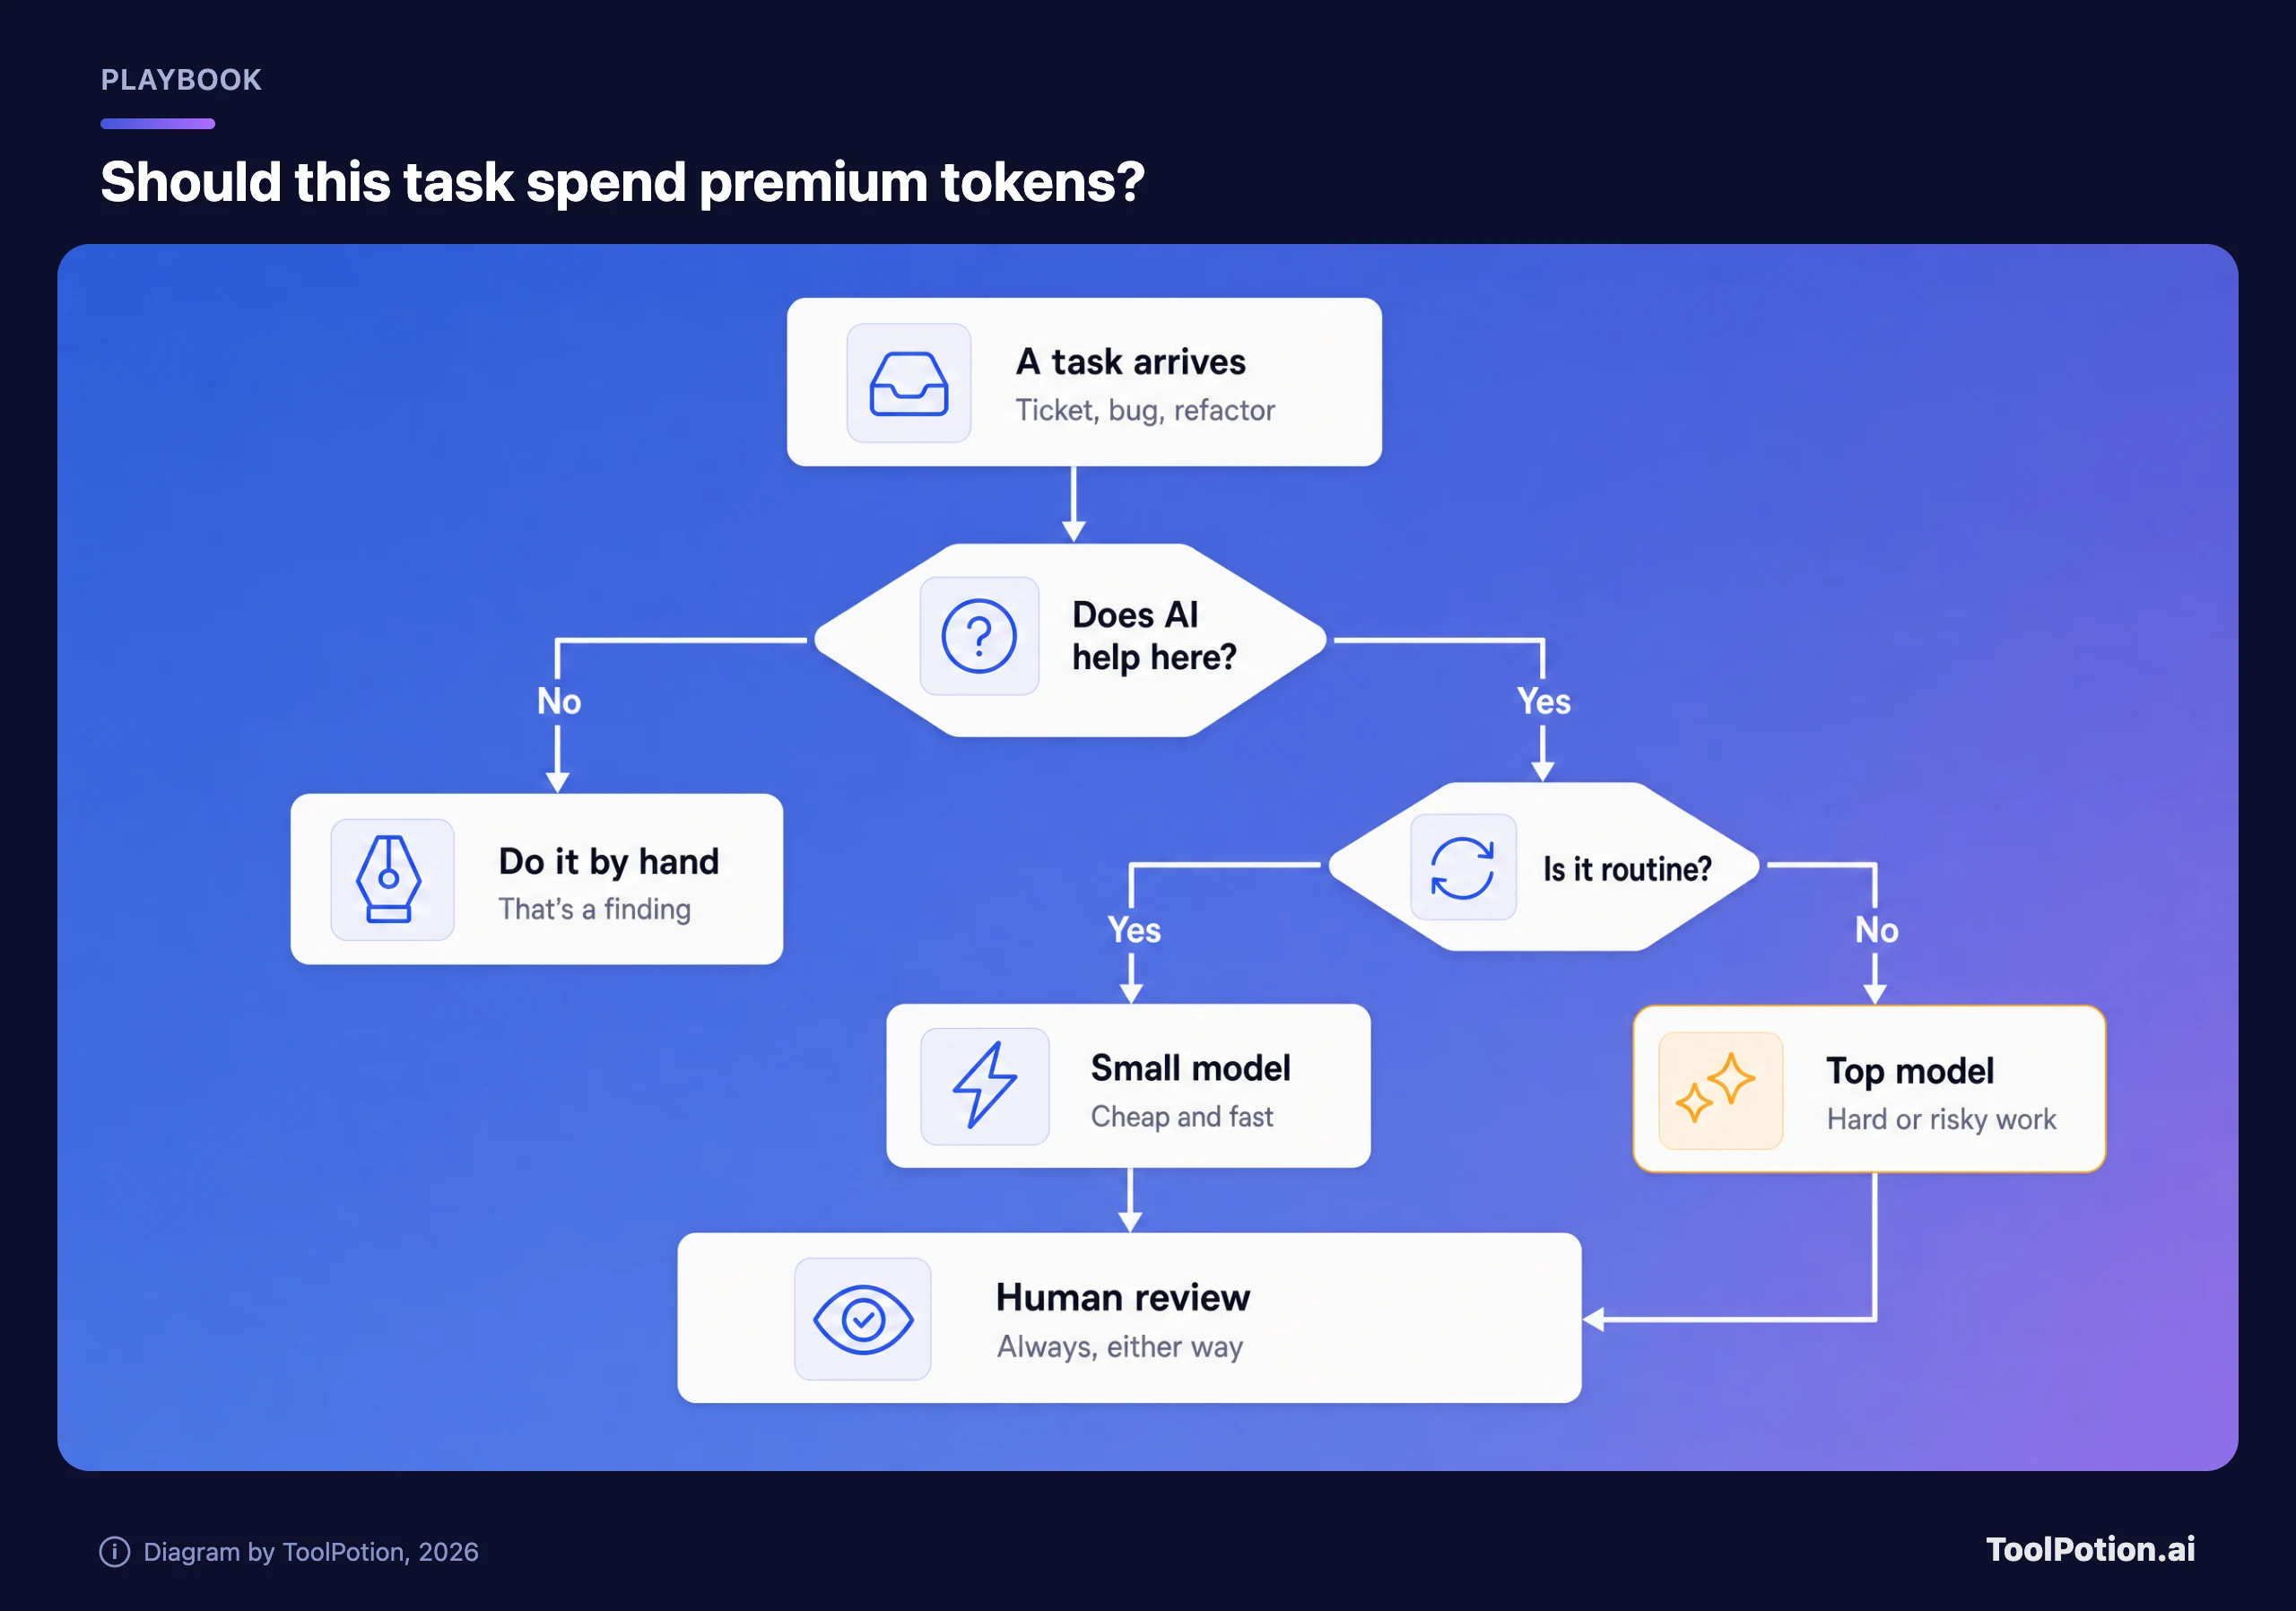
وإرشادات Anthropic نفسها بشأن التكلفة تتفق مع الحساب. فتقول إن Sonnet "يتعامل مع معظم مهام البرمجة جيدًا وتكلفته أقل من Opus"، وإن Opus يُحتفظ به للقرارات المعمارية أو الاستدلال متعدد الخطوات، وإن model: haiku للمهام البسيطة في الوكلاء الفرعيين (وثائق Claude Code). ولدينا رأي أطول في مواءمة المستويات مع المهام في أي مستوى نموذج لأي مهمة، وتُقارَن وكلاء الطرفية في Claude Code vs Codex vs Gemini CLI.
هذا هو التوفير بأسعار القائمة، مع افتراض حصة العمل التي يستطيع نموذج صغير تولّيها من تخمينك أنت. الأسعار هي أسعار قائمة Anthropic للمطالبات القصيرة.
الـ output tokens ليست إلا جزءًا من الفاتورة، وحصة النموذج الصغير افتراض عليك أن تكسبه بمهامك أنت. وإعادة تسمية المتغيرات وكتابة هياكل الاختبارات ربما تصلح. أما خطة ترحيل لخدمة مدفوعات فربما لا.
حدود الإنفاق، بالترتيب الذي نضعها به
- فعّل تقارير الاستخدام لمجموعة تجريبية واقرأ أسبوعين منها قبل اختيار أي رقم.
- ابدأ بالتنبيهات. تستطيع GitHub إرسال بريد وإظهار شريط تنبيه عند 75% و90% و100% من الميزانية (وثائق GitHub).
- أضف سقفًا شهريًا على مستوى الشركة تستطيع تحمّله لو استنفد كل مقعد حصته، كي تكلّف حلقة وكيل خارجة عن السيطرة مبلغًا معلومًا.
- بعد ذلك فقط أضف حدود الفريق أو الفرد، واجعلها مرنة حيثما تسمح الأداة. فميزانية GitHub على مستوى المستخدم توقف الاستخدام دائمًا بشكل صارم، وتحذر وثائقها من أن تداخل الميزانيات قد يمنع الناس من أداة يعتمدون عليها.
- أنزل النماذج الافتراضية مستوى واحدًا للعمل الروتيني، واجعل النموذج الأعلى خيارًا مقصودًا.
تقدّم وثائق Claude Code كذلك نقاط بداية لحدود المعدل لكل مستخدم بحسب حجم الفريق، مثل 15,000 إلى 20,000 token في الدقيقة لكل مستخدم لمن بين 100 و500 مستخدم. وهذه قيود على المعدل لا ميزانيات، وتصفها الوثائق بأنها توصيات قابلة للتعديل.
متى يكون الترشيد ذكيًا ومتى يكون توفيرًا زائفًا
نرشّد الهدر ولا نرشّد المحاولات أبدًا. الحد الذي يجعل المطور يفكر مرتين قبل لصق مستودع كامل في النموذج الأعلى يؤدي وظيفته. أما الحد الذي يجعل المطور نفسه يتخطى تشغيل الاختبارات المولَّدة بالذكاء الاصطناعي، أو يتجنب الوكيل في إعادة الهيكلة الصعبة حيث يعطي أفضل مردود، فيكلّف أكثر مما يوفر.
احسبها. إذا كانت الأدوات الوكيلية تعادل نحو 2% من تكلفة الهندسة، كما تذكر Jellyfish، فإن خفض الفاتورة إلى النصف يوفر 1% من تكلفة الهندسة. ومهندس تباطأ بنسبة 1% يردّ هذا التوفير. لا ينجح الترشيد إلا حين يزيل إنفاقًا لم ينتج شيئًا، وهذا بالضبط ما تقوله أمازون عن الجهد المهدر.
الترشيد ذكي في الأتمتة الخلفية التي لا يقرؤها أحد، وفي استخدام النموذج الأعلى للمهام الروتينية، وفي لوحات المتصدرين الفردية. وهو توفير زائف في مراجعة الكود والاختبارات وتأهيل الموظفين الجدد. فإذا كانت خطوة المراجعة بالذكاء الاصطناعي هي ما يلتقط الدمج السيئ، فإن خنقها رهان ضد شبكة الأمان التي لديك، ويُظهر دليلنا لأدوات مراجعة الكود بالذكاء الاصطناعي ولوحة ToolRank للمراجعة والاختبار كم من البدائل موجود قبل أن تقطع أي شيء.
ما لن نقطعه
تبقى المراجعة البشرية أيًّا كان النموذج الذي كتب الكود. تحذّر مذكرة أمازون من قياس أعداد المراجعات، لكنها لا تقترح تخطيها. ويبقى التدريب أيضًا، لأن من يعرف متى يلجأ إلى النموذج الرخيص هو من أُطلع على وظيفة كل نموذج. ويبقى التجريب، لأن اعتراف Brooker نفسه أن أحدًا لا يستطيع أن يعرف مسبقًا أي المشكلات مهمة.
تتبّع النتائج كما تفعل المذكرة: الإطلاقات، والتغييرات الناجحة في الإنتاج، والزمن من الطلب إلى الدمج. مكان الـ tokens الخام هو عمود التكلفة، وليس قرب أي تقييم أداء. وإذا لم تكتب بعد ما يُسمح لفريقك بتغذية هذه الأدوات به وما لا يُسمح، فإن قالب سياسة استخدام الذكاء الاصطناعي لدينا بداية جيدة، ويغطي شرح نماذج التسعير وتدقيق حزمة الأدوات جانب الاشتراكات.
بعد قراءة صفحات الأسعار لـ GitHub Copilot وCursor وClaude Code وCodex نخرج بقاعدة واحدة: سعر المقعد ليس إلا رسم الدخول. اسحب استخدام شهر حديث لكل شخص من الأداة التي تشغّلها، ورتّبه، وانظر إلى الصفوف الخمسة الأولى. فإن كانوا أفضل مهندسيك فاتركهم. وإن كان سكربتًا واحدًا في حلقة، فقد وجدت حدّك.