

تقول GitHub إن Copilot Fusion Max في مؤشر Artificial Analysis لوكلاء البرمجة "سجّل 60 نقطة، أي ضمن نقطتين من Claude Code مع Opus 5.5 Max" (GitHub changelog). أما عنوان The New Stack فحوّل ذلك إلى نظام "يتفوق على Claude Code بنصف تكلفة API" (The New Stack). هاتان جملتان مختلفتان، وفي الفجوة بينهما ينبغي أن يعمل تفكير الفريق.
Fusion متاح للجميع في GitHub Copilot كخيار جديد في قائمة اختيار النماذج. أنت لا تختار نموذجًا، بل تختار مستوى الجهد، ويقرر Copilot أي النماذج تعمل وبأي ترتيب لكل prompt. فكرة جيدة لكن الأدلة عليها قليلة، ولذلك نتعامل معها كميزة لضبط التكلفة أولًا، وكادعاء بالجودة ثانيًا.
60 ليست 62
أعد قراءة صياغة GitHub نفسها. اقترب Fusion Max من Claude Code على Opus 5.5 Max بفارق نقطتين، بنحو نصف متوسط تكلفة API للمهمة، ونحو نصف عدد الـ tokens، وبوقت أقل بنحو 40% (changelog). هذه نتيجة محترمة وعرض عادل، لكنها ليست فوزًا، ونص The New Stack نفسه يقول "مماثل" تحت عنوان يقول "يتفوق". كررت GitHub الادعاء في ملخص Universe، حيث تصبح عبارة "نصف التكلفة" هي النسخة التي تنتشر.
تنشر Artificial Analysis المؤشر الذي تستشهد به GitHub. وهو يجمع ثلاثة مقاييس هي FrontierCode وTerminal-Bench 4.0 وSWE-Atlas-QnA-AA بوزن متساوٍ (Artificial Analysis). يعرض العرض الافتراضي للصفحة Claude Code على Opus 5.5 Max عند 62 دون أي إدخال لـ Fusion. فإذا فعّلت مفتاح "Router models" ظهر GitHub Copilot - Copilot Fusion (Max) عند 60، فالرقم حقيقي ويقع حيث قالت GitHub. ويُظهر المفتاح نفسه أيضًا Devin Fusion CLI من Cognition، الذي يجمع Opus 5.5 Max مع GPT-6 Luna، متعادلًا مع Claude Code عند 62، وهذا يعني أن الموجّهات كفئة تلحق بالركب، لا أن موجّه GitHub هو الذي يصعب تجاوزه. لم نقارن أعمدة التكلفة في الصفحة برقم "نصف التكلفة" عند GitHub، فهذا الجزء يبقى من كلام GitHub وحدها.
ثلاثة مسارات خلف خيار واحد في القائمة
تصف الوثائق Fusion بأنه "موجّه ومنسّق نماذج ذكي وقت التشغيل" (GitHub Docs). يختار لكل prompt واحدًا من ثلاثة أنماط تنفيذ، ويمكن أن تسلك prompts مختلفة في الجلسة الواحدة مسارات مختلفة.
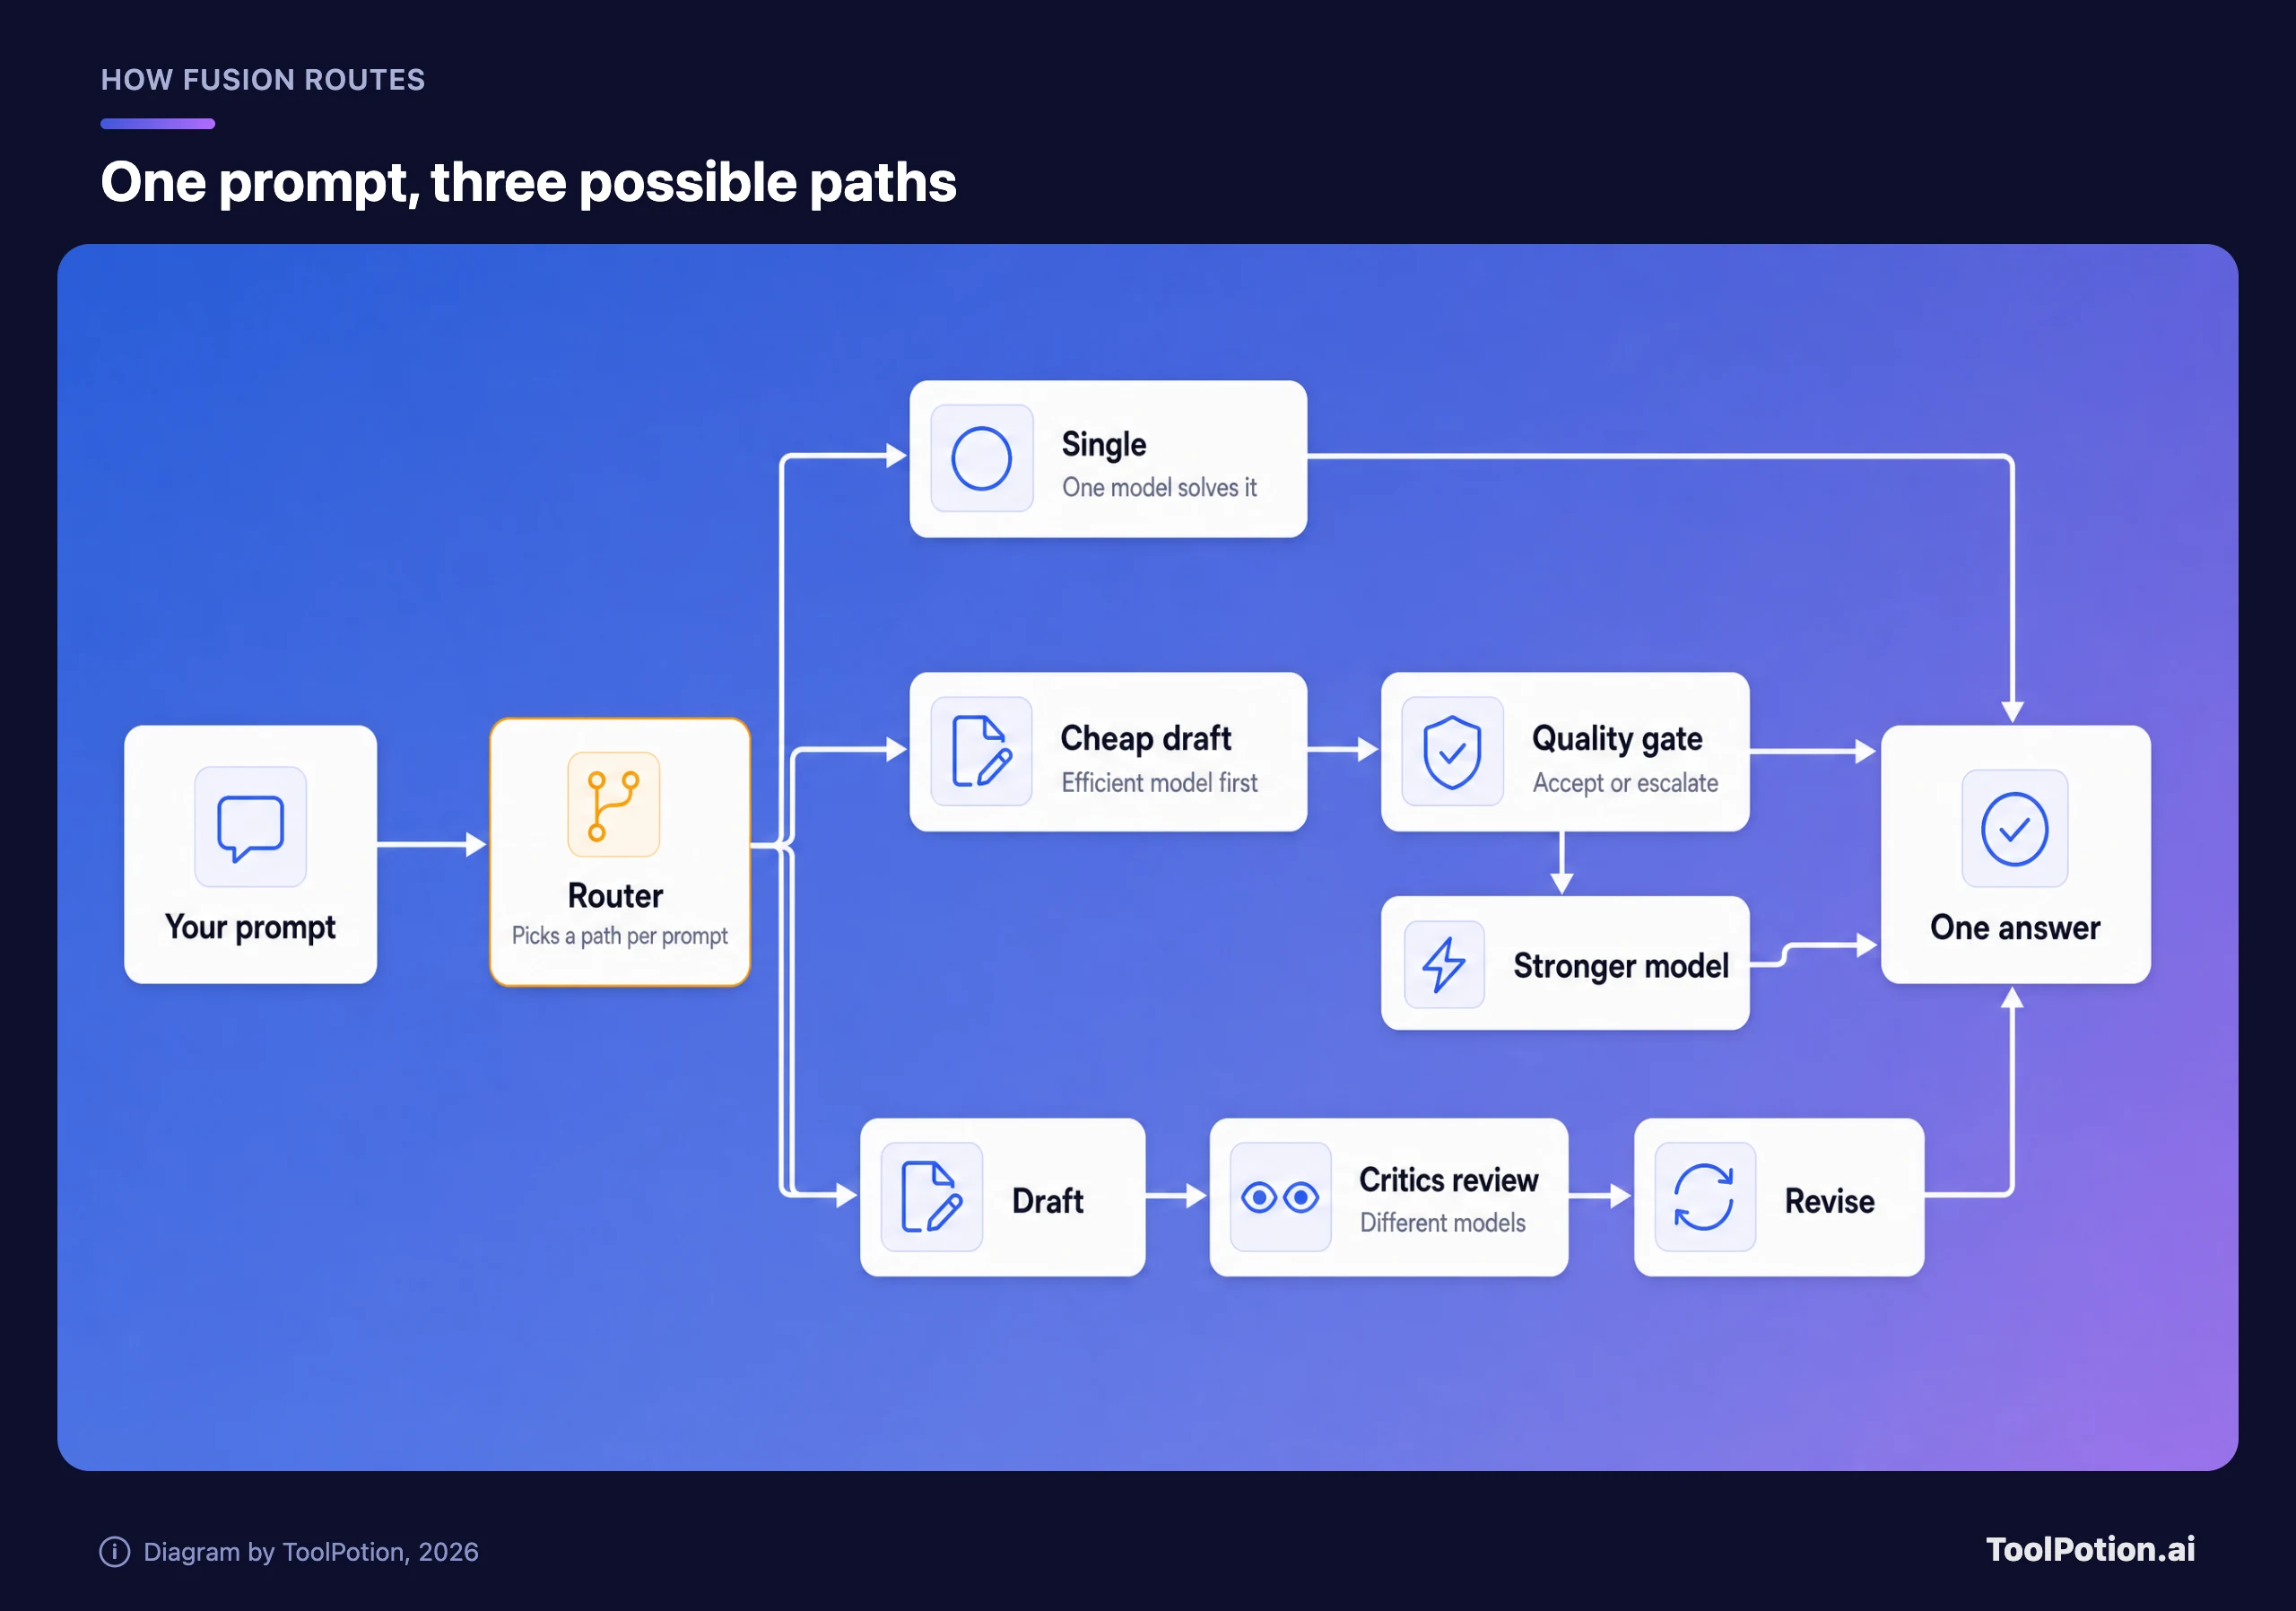
في النمط Single يجيب نموذج واحد مباشرة. وفي Cascade يكتب نموذج كفء مسودة، ثم يقرر حَكَم هل يقبلها أم يصعّدها إلى نموذج أقوى. وفي Critique يكتب نموذج مسودة بينما تراجعها نماذج أخرى، ثم يعدّلها كاتب المسودة. أما مستويات الجهد فتحدد مدى جرأة التوجيه: Standard للعمل اليومي، وHigh للمهام الكبيرة، وMax لأصعب مسائل الاستدلال.
تغيّر تفصيل واحد بين المعاينة والإطلاق. وصف منشور GitHub السابق للمعاينة البحثية "ناقدًا مستقلًا للقراءة فقط من عائلة نماذج مختلفة" (GitHub blog). أما changelog الإطلاق فيقول "نموذج آخر يراجعها"، بينما تقول الوثائق إن عدة نماذج تنقد بالتوازي ويُجمَّع ما تقدمه من ملاحظات. قراءتنا أن خطوة النقد توسعت من مراجع واحد إلى عدة مراجعين، لكن GitHub لا تقول ذلك، ولا ينبّه الـ changelog إلى هذا الفرق.
كل الخطط تحصل عليه، وتدفع لكل نموذج
يقول الـ changelog إن Fusion متاح في جميع خطط Copilot ضمن VS Code وتطبيق Copilot وCopilot CLI وبيئات JetBrains، ومعه عملاء آخرون قريبًا. تُحاسَب على كل نموذج يستخدمه بسعره القياسي، دون رسوم منفصلة لـ Fusion. تحصل الخطط المدفوعة على خصم 30% على تكلفة النماذج لفترة محدودة، وتضع الوثائق نهاية هذا الخصم في وقت لاحق من هذا العام (docs).
هناك نقطتان معلّقتان. تقول وثائق Fusion إنه "متاح مع جميع خطط GitHub Copilot". أما صفحة الخطط فتقول إن الوصول إلى النماذج في خطتي Free وStudent يتم عبر الاختيار التلقائي للنماذج فقط. ولا توفّق GitHub بين الكلامين. وجدول مستويات الجهد حسب الخطة في الوثائق يشير إلى التوفر بأيقونات ظهرت خلايا فارغة عندما قرأناه، فلا نستطيع أن نخبرك أي المستويات تحصل عليها مقاعد Free وStudent. تحقق من قائمة الاختيار عندك. ولأن High وMax قد يستدعيان عدة نماذج، تحذر الوثائق نفسها من أن المهمة قد تستهلك أرصدة AI أكثر مما تستهلكه على Standard. نصف التكلفة للمهمة ادعاء عن Max مقابل Claude Code، وليس وعدًا بشأن رصيدك.
المقياس هنا GitHub تقيّم GitHub
منشور HydraFusion السابق أكثر صراحة من الإطلاق. فقد أُجريت اختباراته عند مستوى استدلال متوسط واحد لكل النماذج، واستخدمت تكاليف مقدّرة بافتراضات تسعير مشتركة، وقارنت مع Opus 5 وGPT-5.6 Sol. وتقول GitHub أيضًا إنها ضبطت سياسة التوجيه ببحث الحزمة (beam search) على المقاييس الثلاثة نفسها التي أعلنت نتائجها (GitHub blog).
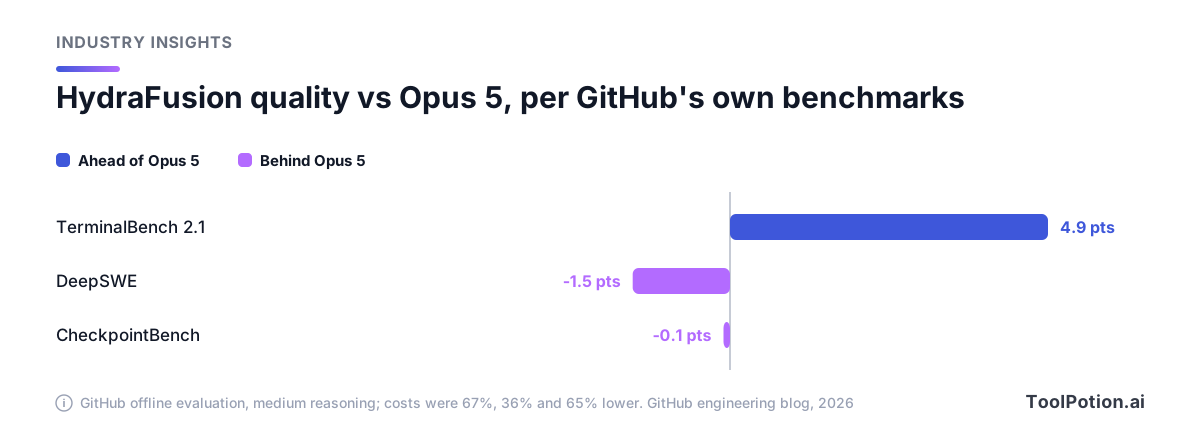
انظر إلى الشكل العام. مقياس واحد يُظهر مكسبًا قدره 4.9 نقطة، والآخران يُظهران خسارة صغيرة، مع تكاليف أقل بنسبة 36% إلى 67%. هذه قصة تكلفة مع بقاء الجودة عند المستوى نفسه تقريبًا، وهذا ما انتهى إليه نص الإطلاق أيضًا.
هاجم المطورون على Hacker News خط الأساس. كتب أحد المعلقين أن "Opus 5 (عمليًا) ليس خط أساس جيدًا للمقارنة" (HN). وشكك آخر في النتيجة قائلًا "لا يتطلب الأمر الكثير لتجاوز النماذج الرائدة في مقاييس منفردة إذا وُضع برنامج إضافي بين النموذج والـ harness" (HN). وقال مستخدم Copilot CLI في النقاش نفسه إن الوضع التلقائي "لا يغيّر النماذج إلا في بداية الجلسة أو بعد الضغط (compaction)" (HN)، ووصف آخر الاختيار التلقائي بأنه "غير قابل للاستخدام تقريبًا" بالنسبة له (HN). هؤلاء معلقون أفراد وليسوا دراسات، لكنهم يبيّنون أين يقع الشك.
وهناك أيضًا تباين في الفوترة يجب أخذه في الحسبان. فالمؤشر ومقارنة GitHub يستخدمان تكلفة API بالدفع لكل token. أما المطور المشترك باشتراك ثابت في Claude Code فلا يرى هذا الرقم أبدًا، فيصل "نصف التكلفة" إلى مستخدم منفرد بشكل مختلف عن وصوله إلى فريق يراقب إنفاق API. وتشير Artificial Analysis نفسها إلى أن كثيرًا من المستخدمين يصلون إلى هذه الأدوات عبر الاشتراكات لا عبر الدفع لكل token. هذا الاستنتاج من عندنا وليس ادعاءً من GitHub، لكنه يغيّر الجهة التي يستهدفها العنوان.
صوت العميل الوحيد الذي تقدمه GitHub هو Hari Pokhrel من AT&T، مقتبسًا في الـ changelog الخاص بها: "في السابق، كان المطورون يختارون غالبًا نموذجًا أقوى لمهمة معقدة وينسون العودة عنه في الأنشطة اليومية". هذه هي الحجة الصادقة لصالح Fusion: فهو يمنع الناس من ترك نموذج غالٍ يعمل في المهام الروتينية.
سياستك تحدد من يقرأ الـ diff الخاص بك
هذا هو الجزء الذي نقرؤه قبل المقياس. يستخدم Fusion فقط النماذج المفعّلة في سياسات مؤسستك ومنظمتك. ويستطيع المسؤولون تعطيل نماذج بعينها لـ Fusion دون تعطيلها في كل مكان، وتُستبعد النماذج التي تقصيها سياسات إقامة البيانات أو FedRAMP (docs).
المراجعة بنموذج ثانٍ هي رهان التصميم، ويقول منشور المعاينة إن هذا المراجع يأتي من عائلة نماذج مختلفة. وإذا كان ذلك يعني مزوّدًا آخر، فهو يرى الـ diff الخاص بك، وهذا قرار يتعلق بمعالجة البيانات ينبغي أن يتخذه أحد في فريقك عن قصد. وبعد كل استجابة يمكنك تمرير المؤشر فوق تسمية مستوى الجهد لمعرفة النماذج التي عملت.
قسم القيود مهم أيضًا. إذا تخلّى Fusion عن مسودة، فإن تعديلات الملفات التي أجرتها تلك المسودة لا تُتراجع تلقائيًا، فراجع الـ diff قبل الالتزام (commit). كما أنه لا يملك نافذة سياق خاصة به: الرقم المعروض هو الأصغر بين نماذجه.
أين نضعه في تجربة الفريق
سنشغّل Fusion Standard كخيار افتراضي لفريق Copilot، ونتجنب Max كخيار افتراضي. نتيجته 60 في المؤشر المستقل محترمة، لكن Max هو المستوى الذي يستدعي أكبر عدد من النماذج ويستهلك أكبر قدر من الأرصدة. أما Standard ففيه تقع قصة AT&T، وفيه يوفّر التوجيه أكثر. وبالنسبة للفرق التي تستخدم بالفعل Claude Code أو Codex، فسؤال الارتهان يسير في الاتجاه المعاكس: تلك الأدوات مرتبطة بنماذج مزوّد واحد، بينما Fusion موجّه تتحكم فيه GitHub ويمكنها إعادة ترتيبه. ولا يخلو أي منهما من الاعتماد.
مقارناتنا الحالية تغطي الأدوات نفسها: وكلاء البرمجة في الطرفية، وCursor مقابل Copilot وWindsurf، ومطابقة فئات النماذج مع المهام، وقائمة أدوات البرمجة الأوسع. يغيّر Fusion عمود التكلفة في هذه المقارنات، لا الأداة التي ستختارها. أما مستخدمو Cursor فليس لديهم حكم مماثل بعد، ولوحة ToolRank لمساعدي البرمجة هي المكان الذي ترى فيه كيف يترتب المجال حاليًا.
الاختبار الذي يحسم الأمر رخيص. خذ عشر تذاكر حقيقية، ومرّرها عبر Fusion Standard وعبر إعدادك الحالي، ثم عدّ التغييرات المقبولة والأرصدة المنفقة. خصم GitHub ينتهي في وقت لاحق من هذا العام، فقِس قبل أن ينتهي. ثم راجع عرض Router models على Artificial Analysis مرة أخرى، فإدخالات الموجّهات هناك هي الأرجح أن تتحرك.