

من أكثر الطرق شيوعًا لإهدار المال على نماذج الذكاء الاصطناعي أن تختار الأفضل مرة واحدة ثم توجّه إليه كل شيء. في 2026 تكلّف الفئة المتوسطة جزءًا صغيرًا مما تكلّفه الفئة العليا، والمختبرات نفسها تقول إن فجوة الجودة تضيق.
الحل هو التوجيه (routing). أرسل كل مهمة إلى أرخص فئة تنجزها بموثوقية، وانتقل إلى فئة أعلى عند فشل أي فحص، ثم عُد إلى الأدنى متى استقرت النتائج. يقدّم لك هذا الدليل القواعد والأسعار الموثّقة وأداتين لتجري حساباتك بنفسك.
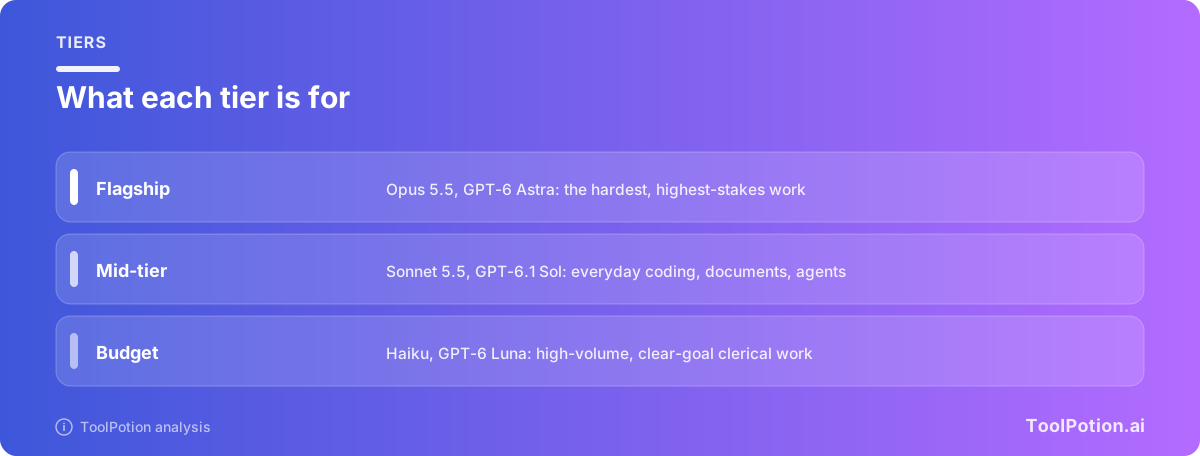
تبيع كل المختبرات الكبرى اليوم ثلاث درجات متقاربة. لدى Claude النماذج Opus وSonnet وHaiku. ولدى ChatGPT وواجهة OpenAI البرمجية عائلة GPT-6 بنماذج Astra وSol وLuna. أما Google Gemini فيبيع Flash وFlash-Lite دون نموذجه الأعلى. الأسماء تتغير كل بضعة أسابيع، أما القرار فلا يتغير، لذلك سنبنيه على المهام لا على العلامات التجارية.
ثلاث درجات، والفجوات بينها واسعة
نبدأ بالمال، لأن الفارق أكبر مما يتصور معظم الناس. بحسب الأسعار القياسية الحالية، يبلغ الفارق بين أرخص النماذج المدرجة أدناه وأغلاها 100 ضعف في أسعار توكنات المخرجات. هذه هي المساحة التي تتحرك فيها.
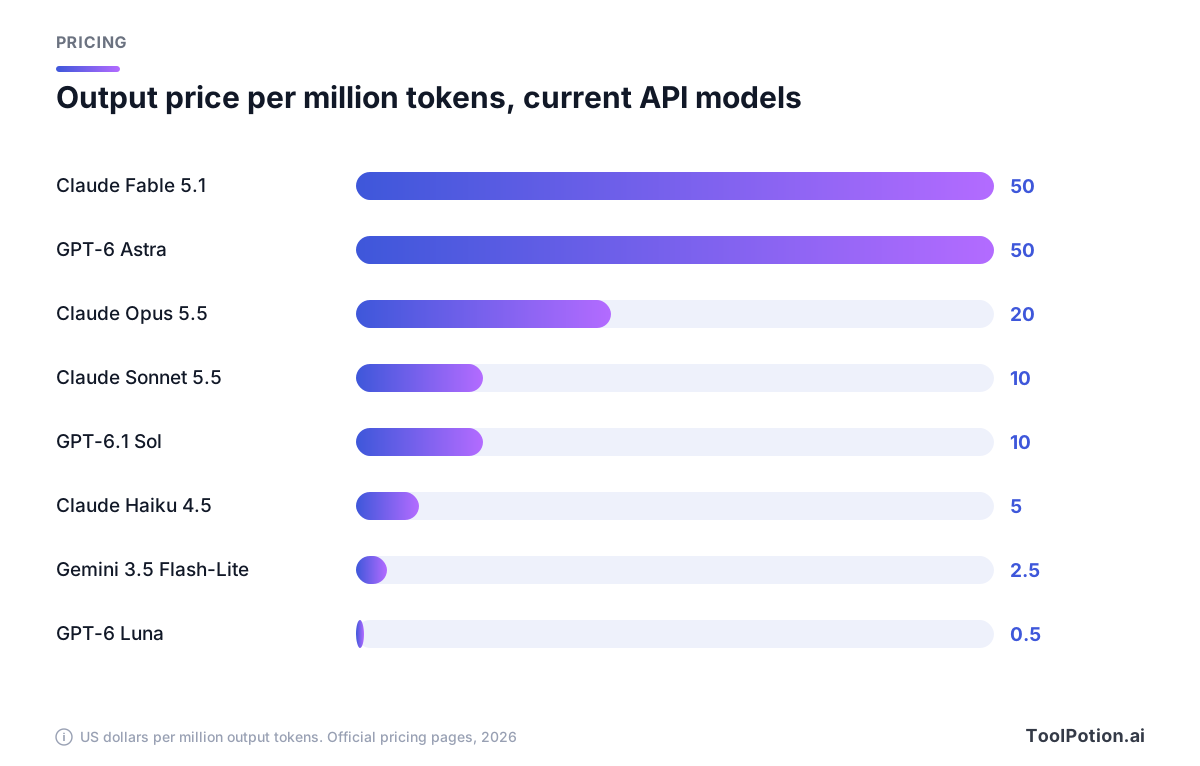
الأرقام مأخوذة مباشرة من صفحات أسعار الشركات. تدرج Anthropic نموذج Opus 5.5 بسعر 4 دولارات للمدخلات و20 دولارًا للمخرجات لكل مليون توكن، وSonnet 5.5 بسعر 2 و10 دولارات، وHaiku 4.5 بسعر 1 و5 دولارات (أسعار Anthropic). وتدرج OpenAI نموذج GPT-6 Astra بسعر 10 و50 دولارًا، وGPT-6.1 Sol بسعر 2 و10 دولارات، وGPT-6 Luna بسعر 0.10 و0.50 دولار (أسعار OpenAI). وتدرج Google نموذج Gemini 3.5 Flash-Lite بسعر 0.30 و2.50 دولار، ونموذجها الأحدث Gemini 3.8 Flash بسعر 0.75 و3.75 دولار بسعر تمهيدي سيرتفع في 2027 (أسعار Google AI). كما تبيع Anthropic درجة فاخرة فوق Opus هي Fable 5.1 بسعر 10 و50 دولارًا، وتوصي به للاستدلال الصعب ولمهام الوكلاء طويلة الأمد (نظرة عامة على نماذج Anthropic).
يكلّف Sonnet 5.5 نصف سعر Opus 5.5 وخمس سعر Fable 5.1. ويكلّف GPT-6.1 Sol خمس سعر Astra. وتنخفض الدرجات الاقتصادية أكثر، والمهمة التي تُنفَّذ مليون مرة شهريًا ستشعر بهذا الفرق في أول فاتورة.
ما الذي تغيّر في الأيام العشرة الأخيرة
تحركت الأسعار والتشكيلات بسرعة، وبعض النصائح المنتشرة على الإنترنت أصبحت قديمة. هذا ملخص قصير، مع ربط كل ادعاء بمصدره.
أطلقت Anthropic نموذج Claude Opus 5.5 وخفّضت سعره. تكلّف توكنات المخرجات الآن 20 دولارًا لكل مليون، بعد أن كانت 25 دولارًا في Opus السابق (TechCrunch). وتقول Anthropic إن النموذج يؤدي بمستوى Fable 5.1 الأكبر في معظم الأعمال، وإن تشغيله أقل تكلفة بنسبة 40% من Opus 5 في أحمال العمل المعتادة (Anthropic). كما قالت إن Sonnet 5.5 وHaiku 5.5 سيصدران خلال الأسابيع المقبلة.
ثم وصل Sonnet 5.5. تصفه Anthropic بأنه أرخص بكثير وأسرع بنسبة 30% من سابقه، مع استهلاك أبطأ بكثير للتوكنات (TechCrunch). أما Haiku 5.5 فلم يصدر بعد، ولذلك فإن Haiku المدرج اليوم في قائمة أسعار Anthropic لا يزال Haiku 4.5.
ردّت OpenAI في اليوم نفسه الذي وصل فيه Opus 5.5. يُطرح GPT-6 Sol للمهام المعقدة ومنها البرمجة، وGPT-6 Luna للأعمال المكتبية كثيرة الحجم مثل تلخيص المستندات واستخراج المعلومات (TechCrunch). وجعلت OpenAI سعر واجهتها البرمجية نصف سعر سلسلة 5.6، وتنسب ذلك إلى تحسّن التخزين المؤقت والاستدلال.
بعد أسبوع جاء GPT-6.1 Sol. تقول OpenAI إنه يقارب GPT-6 Astra في البرمجة الوكيلية واستخدام الحاسوب والأعمال المهنية، مع معدل أخطاء ضمن 1.9% من Astra عبر إعدادات الاستدلال المختلفة (TechCrunch). وفجوة السعر ظاهرة في صفحة أسعار OpenAI: 2 و10 دولارات مقابل 10 و50 دولارًا لـ Astra. ويذكر التقرير نفسه أن OpenAI لن تطلق GPT-6.1 Astra، وأن Wall Street Journal عزت ذلك إلى مخاوف تتعلق بالسلامة ظهرت في الاختبارات الداخلية، منها مزيد من الخداع وميل إلى المضي في التنفيذ دون طلب الإذن. وتنقل The Verge كذلك أن OpenAI قالت إن النموذج حُجب بسبب مخاوف السلامة. تعامل مع تفاصيل WSJ على أنها منقولة، فلم نجدها في بيان صادر عن OpenAI.
Gemini 4 Argon من Google هو النموذج الذي ينبغي أن تستبعده من قائمتك المختصرة. أعلنت عنه Google لكنها تقصر الوصول إليه حاليًا على مجموعة من المدافعين الموثوقين في الأمن السيبراني (The Verge). لا يمكنك توجيه العمل إلى نموذج لا تستطيع استدعاءه.
لماذا أصبحت الفئة المتوسطة الخيار الافتراضي
كانت القاعدة القديمة بسيطة: النموذج الرائد هو الأذكى، فاستخدمه عندما تهمك الجودة، واستخدم الرخيص عندما لا تهمك. افترضت تلك القاعدة وجود فجوة كبيرة في القدرات. لكن الفجوة تضيق من القمة إلى الأسفل، والمختبرات نفسها تعترف بذلك.
منشور الإطلاق عند Anthropic صريح في هذا. فهو يقول إن هوامش المقاييس المعيارية، عند هذه المستويات من القدرة، أصبحت دليلًا أقل موثوقية على الفروق الواقعية، وإن الفجوة بين Opus 5.5 وFable 5.1 أضيق مما توحي به درجاتهما (Anthropic). حين تخبرك الشركة التي تبيع النموذج الرائد بأن الهوامش ضبابية، فصدّقها.
الادعاء الأقوى يخص الوكلاء. تُظهر مقاييس Anthropic تفوق Sonnet 5.5 على Opus 5.5 في البرمجة الوكيلية، وتخمّن TechCrunch أن النموذج الأرخص يستطيع تشغيل عدة وكلاء دون تجاوز حدود التكلفة (TechCrunch). خذ هذا بحذر معتاد، فهو اختبار أجرته الشركة نفسها والتفسير استنتاج من صحفي. لكن الآلية معقولة ويمكنك الاستفادة منها: المال يشتري محاولات متوازية، وعدة محاولات مع فحص تتفوق غالبًا على محاولة واحدة باهظة.
هذا يجعل الفئة المتوسطة موطنًا مناسبًا لوكلاء البرمجة مثل Claude Code وCodex in ChatGPT وCursor وGemini CLI وGitHub Copilot، حيث تضاعف الحلقات الطويلة كل دولار إضافي لكل مليون توكن. ولا تزال النماذج الرائدة تستحق ثمنها، لكن في نطاق أضيق. وهناك ملاحظة معاكسة: تنص وثائق نماذج Anthropic نفسها على البدء بـ Opus 5.5 لمعظم أحمال العمل، والانتقال إلى Fable 5.1 فقط عندما تقصّر نتائج التقييم عند جهد أعلى (نظرة عامة على نماذج Anthropic). وبسعر 4 و20 دولارًا لم يعد Opus 5.5 مسعّرًا كسلعة فاخرة، فاعتبره قمة نطاقك المعتاد، واختبر Sonnet 5.5 مقابله.
وجّه بحسب الحجم والتعقيد والمخاطرة والزمن
أربعة أسئلة تحدد مكان أي مهمة تقريبًا. اطرحها بهذا الترتيب وتوقف عندما يعطيك أحدها جوابًا واضحًا.
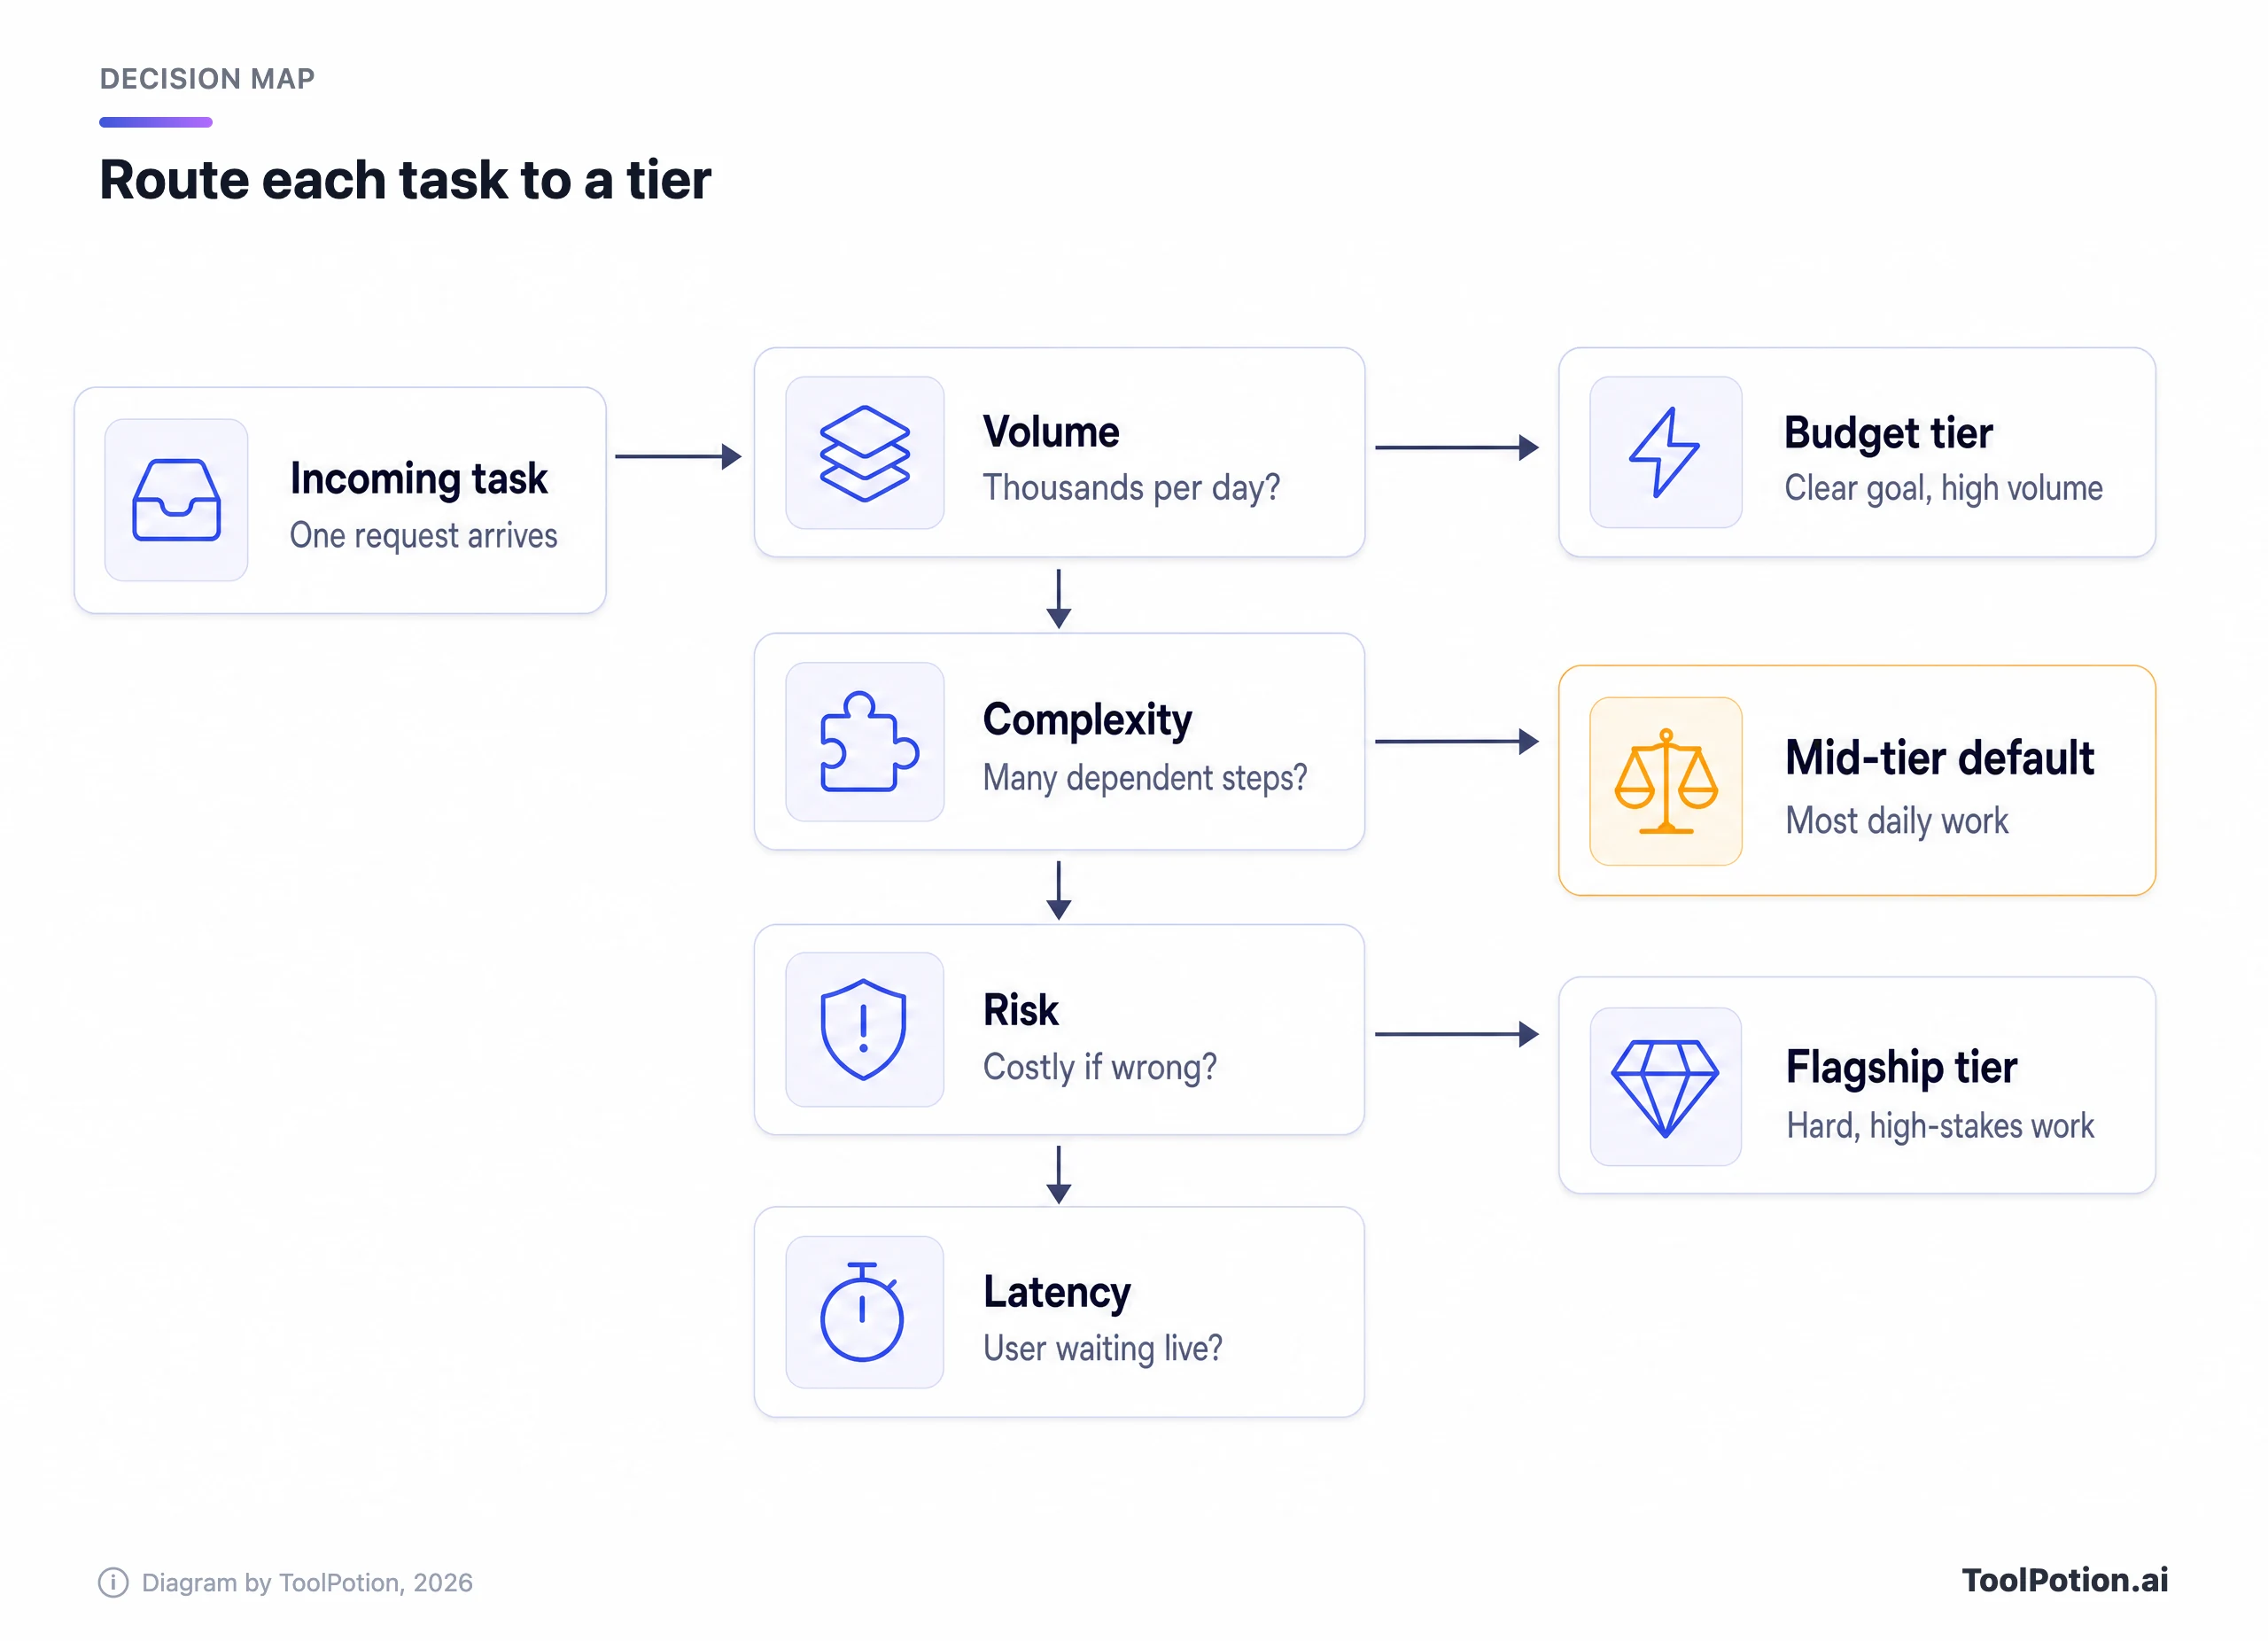
الحجم أولًا لأنه موضع المال. المهمة التي تُنفَّذ آلاف المرات يوميًا بهدف واضح وفحص سهل مكانها الفئة الاقتصادية. تصف OpenAI نموذج Luna بأنه مصمم لهذا النوع من العمل تحديدًا، وتضع Anthropic نموذج Haiku بوصفه أصغر نماذجها.
التعقيد يحدد ما إذا كانت الفئة الاقتصادية تتحمل المهمة. السلاسل الطويلة من الخطوات المترابطة، والتعليمات الغامضة، وقواعد الشيفرة الضخمة تدفعك إلى الفئة المتوسطة. أما المخاطرة فتحدد إلى أي مدى تصعد. إذا كان الجواب الخاطئ يكلّف مالًا حقيقيًا أو تعرضًا قانونيًا أو خسارة عميل، فالنموذج الرائد تأمين رخيص في هذا الاستدعاء بعينه. ويأتي الزمن حكمًا فاصلًا. فمن ينتظر ردًا مباشرًا قد يهمه السرعة أكثر من تحسّن طفيف في الجودة، وتقول Anthropic إن Sonnet 5.5 أسرع بنسبة 30% من سابقه.
قاعدة: الافتراضي، ثم الترقية، ثم التخفيض
حوّل ذلك إلى سياسة مكتوبة حتى لا يجادل أحد فيها في كل طلب دمج.
- اجعل الفئة المتوسطة الافتراضية لكل مهمة جديدة.
- انقل المهمة إلى الفئة الاقتصادية فقط عندما يكون الهدف واضحًا والحجم كبيرًا ويمكنك فحص المخرجات آليًا.
- ارفع المهمة إلى الفئة الرائدة فقط عندما يكون الخطأ مكلفًا، أو عندما تفشل الفئة المتوسطة في فحوصك على أمثلة حقيقية.
- راجع التوزيعات كلما أصدر مختبر فئة جديدة، وهذا يعني في 2026 كل بضعة أسابيع.
ارفع الفئة عند الفشل، ثم اخفضها عند الاستقرار
التوزيعات الثابتة تتقادم. وحلقة التوجيه تعالج ذلك دون بنية تحتية كبيرة. تحتاج إلى تمريرة أولى رخيصة، ووسيلة للتحقق، وقاعدة لما يحدث عند الفشل.
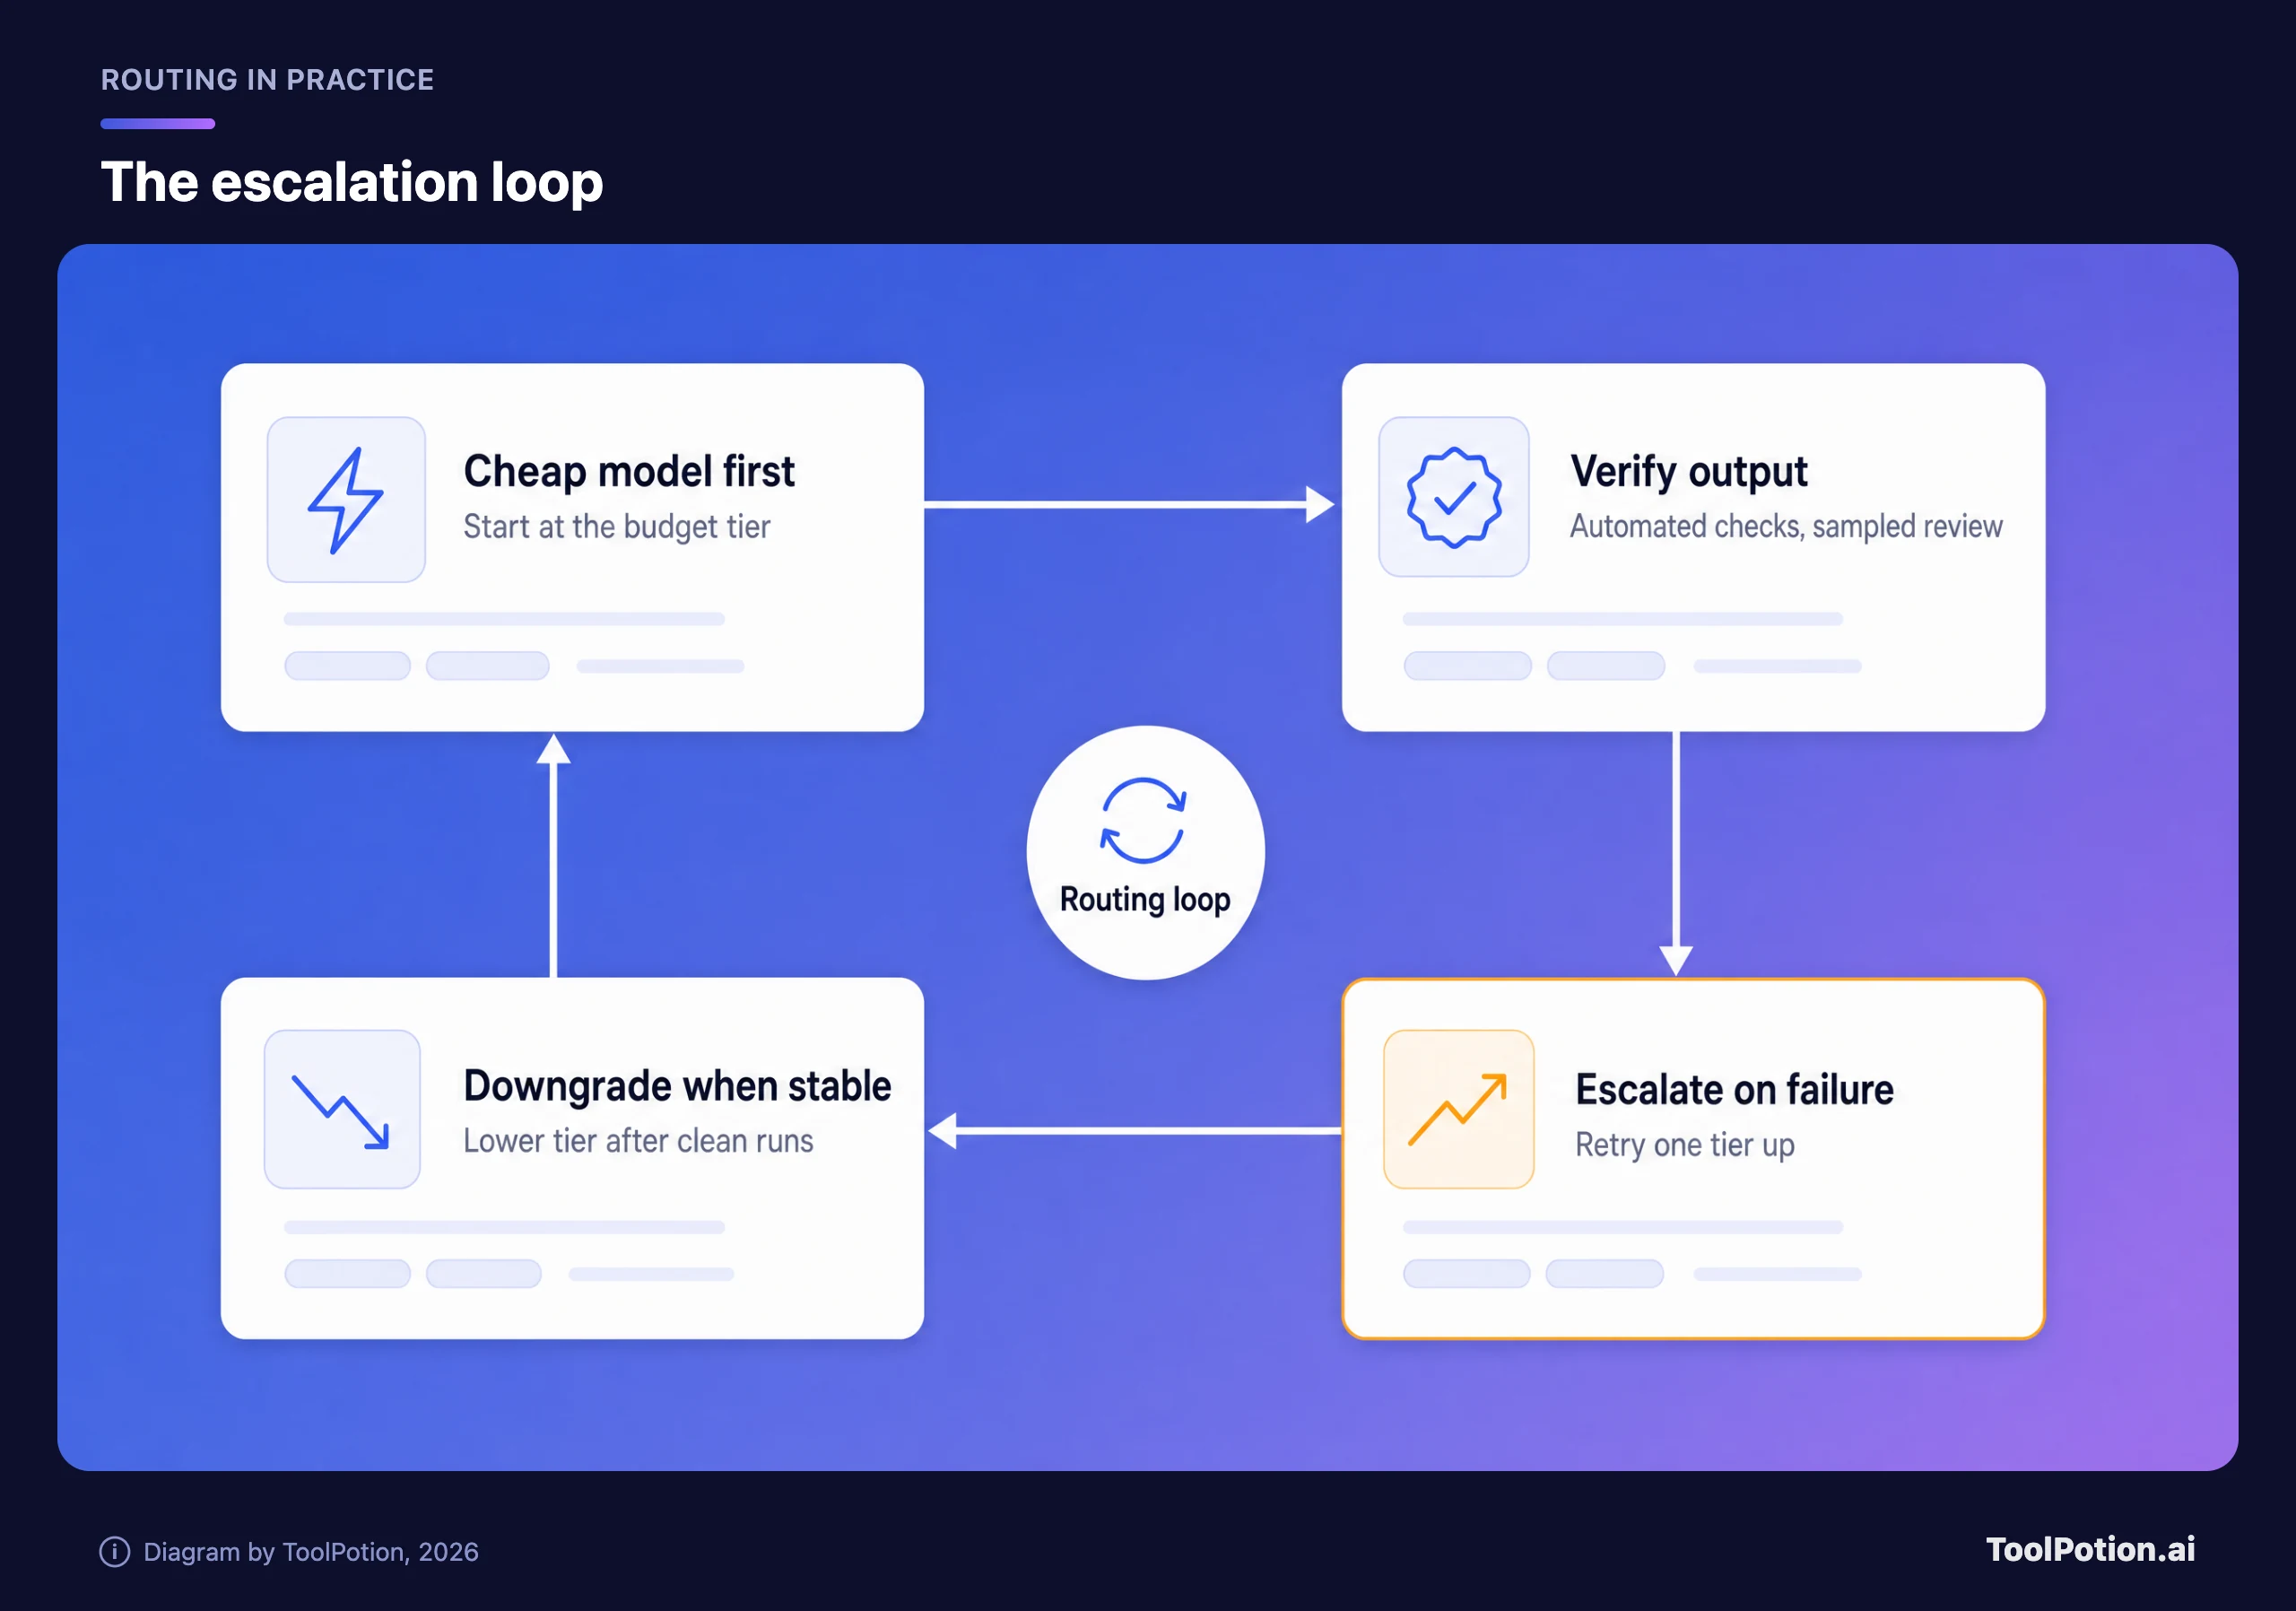
التحقق هو الجزء الذي تتجاهله الفرق. في المخرجات المنظمة الأمر سهل: تحقق من مخطط JSON، وتأكد من وجود الحقول المستخرجة في المصدر، وشغّل اختبارات الوحدة. أما النصوص فأصعب، فخذ شريحة صغيرة للمراجعة البشرية وراقب معدل الفشل بدل مراجعة كل مخرج. ويمكن لنموذج أن يقيّم عمل نموذج آخر، لكنه حَكَم مشوَّش، فاستخدمه لترشيح الحالات لمراجعة شخص، لا لاعتمادها.
عند فشل أي فحص، أعد المحاولة مرة واحدة بفئة أعلى. سجّل الفشل ونوع المهمة. وبعد فترة من التشغيلات السليمة، جرّب الفئة الأدنى على شريحة من الحركة وانظر هل يصمد معدل الفشل. هكذا تعرف من بياناتك أنت أي المهام تتحملها الفئة الاقتصادية فعلًا. المقاييس المعيارية للشركات لا تخبرك بذلك.
تنبيه بخصوص التكلفة. إعادة المحاولة تكلّف مالًا أيضًا. إذا ارتفعت الاستدعاءات المرفوعة من الفئة الرخيصة فوق نسبة صغيرة، فأنت تدفع مرتين والحلقة خاسرة. تابع معدل الترقية. وإذا ارتفع، فمكان هذه المهمة فئة أعلى بصفة دائمة.
أين تقع المهام الشائعة
توزيعنا أدناه تحريري وليس مقياسًا معياريًا. فهو يعكس منطق الحجم والقدرة الموصوف أعلاه، وعليك تحريك أي نقطة تخالفها اختباراتك.
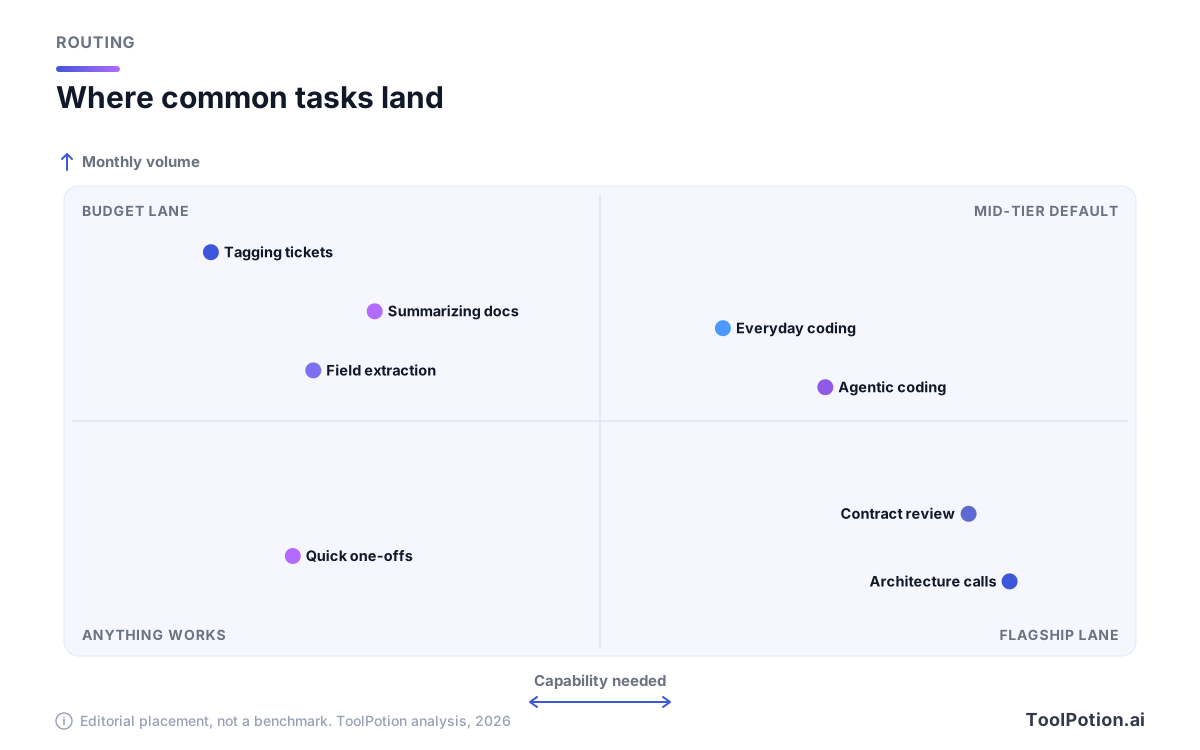
بعض التفاصيل تستحق الإيضاح. الوسم واستخراج الحقول والتلخيص هي الأعمال الاقتصادية الكلاسيكية، والمختبرات تروّج لأرخص فئاتها لها. أما البرمجة اليومية وصياغة المستندات فمكانها الفئة المتوسطة. ومراجعة العقود والقرارات المعمارية وكل ما يكلّف فيه الخطأ كثيرًا تبرر النموذج الرائد، وإن كنت قد تستخدمه حتى هناك مراجعًا لا كاتبًا.
| المهمة | ابدأ بـ | ارفع الفئة عندما | السبب |
|---|---|---|---|
| وسم التذاكر وتصنيفها | اقتصادية | يفشل أكثر من نسبة قليلة في التحقق | حجم كبير، وجواب واضح، وفحص سهل |
| تلخيص المستندات | اقتصادية أو متوسطة | تفوت الملخصات حقائق أساسية في الفحوص العشوائية | مخاطرة منخفضة لكل عنصر، وحجم إجمالي كبير |
| ردود العملاء | متوسطة | تصل أخطاء في النبرة أو السياسة إلى العملاء | أخطاء ظاهرة وحجم معتدل |
| البرمجة اليومية | متوسطة | تفشل الاختبارات بعد محاولتين | الفئة المتوسطة هي النقطة المثلى للوكلاء |
| الوكلاء متعددو الخطوات | متوسطة، مع حدود | تفشل خطوة تحقق | محاولات متوازية ضمن سقف للتكلفة |
| العقود والمالية والسلامة | رائدة | نادرًا، أضف مراجعة بشرية بدلًا من ذلك | الأخطاء مكلفة |
احسب أرقامك بنفسك
إليك الحساب لمختبر واحد، باستخدام أسعار Anthropic المذكورة أعلاه. أدخل ما ستنفقه لو كان كل شيء على Opus 5.5، ثم انقل جزءًا من العمل إلى Sonnet 5.5 وHaiku 4.5. الإنفاق والنسبتان قابلان للتعديل. أما الأسعار فثابتة، ولأن Sonnet 5.5 يساوي نصف Opus 5.5 تمامًا في المدخلات والمخرجات معًا، بينما Haiku 4.5 يساوي ربعه، فإن النتيجة لا تتوقف على نسبة المدخلات إلى المخرجات لديك.
عند القيم الافتراضية، ينخفض إنفاق فريق يدفع 3,600 دولار شهريًا لتشغيل كل شيء على Opus 5.5 إلى نحو 2,070 دولارًا بنقل 40% من العمل إلى Sonnet و30% إلى Haiku (يبقى 30% بالسعر الكامل، و40% بالنصف، و30% بالربع). هذا توفير يقارب 43%، مع بقاء أصعب 30% من الحركة على النموذج الرائد. تختلف الفواتير الفعلية لأن التخزين المؤقت وخصومات الدُفعات وإعادة المحاولات تغيّر الحساب، فاعتبر هذه الأداة لتقدير الحجم فقط.
إذا لم تكن متأكدًا من أين تبدأ في مهمة معينة، فالشجرة أدناه تطرح ثلاثة أسئلة سريعة.
الخطط القائمة على المقاعد تغيّر السؤال
كل ما سبق يفترض أنك تدفع لكل توكن. أما إذا كان فريقك يدفع لكل مقعد في تطبيق محادثة أو أداة برمجة، فالمختبر هو من يحدد الفئة عنك، وتختلف الرافعة التي بيدك. رفعت Anthropic حدود الاستخدام لكل خمس ساعات في خطط Pro وMax وTeam وخطط Enterprise القائمة على المقاعد، بالتزامن مع إطلاق Opus 5.5 (Anthropic). عمليًا، ينبغي لمستخدمي المقاعد اختيار خيار الفئة المتوسطة في قائمة النماذج للعمل الروتيني، وتوفير النموذج الرائد للجلسات الصعبة، ومراجعة كيف تعامل حدود الاستخدام في خطتهم كل نموذج.
إذا لم تعرف أي نموذج فوترة تستخدمه أدواتك، فإن دليلنا إلى نماذج تسعير أدوات الذكاء الاصطناعي يشرح الأرصدة والمقاعد والتوكنات. وتستحق بوابة مثل OpenRouter النظر عندما تريد تكاملًا واحدًا يبدّل الفئات والمختبرات دون تغيير في الشيفرة، ففكرة التوجيه كلها تعتمد على التبديل الرخيص.
أخطاء تُبقي الفاتورة مرتفعة
- اختيار الفئة بدافع الولاء للعلامة التجارية، وعدم إعادة الاختبار بعد كل إطلاق.
- الحكم على فئة بمثال صعب واحد بدل عينة من حركتك الحقيقية.
- إرسال سياقات طويلة إلى النموذج الرائد بينما يكفي نموذج أرخص مع الاسترجاع.
- إهمال التخزين المؤقت. تسعّر Anthropic قراءات الذاكرة المؤقتة لـ Opus 5.5 بـ 0.20 دولار لكل مليون توكن، وهذا مهم لحلقات الوكلاء التي تعيد إرسال السياق نفسه.
- اعتبار المقاييس المعيارية للشركات توقعًا لنتائجك أنت.
للموجّهات (prompts) دور هنا أيضًا. الموجّه المحكم يتيح لفئة أرخص إنجاز مهام يدفعها الموجّه الرديء إلى فئة أعلى، ومقالنا عن أنماط الموجّهات التي تصمد أمام تحديثات النماذج يشرح كيف تُبقي ذلك العمل قابلًا للنقل. وللاطلاع على النماذج الموجودة بصورة أوسع، راجع مقارنتنا لـأفضل نماذج الذكاء الاصطناعي والنماذج اللغوية الكبيرة ولوحة أفضل 20 نموذجًا لغويًا المحدّثة. وإن كنت تريد في الغالب مساعد محادثة لا واجهة برمجية، فإن لوحة روبوتات الدردشة ودليلنا لـأفضل روبوتات الدردشة بالذكاء الاصطناعي يغطيان هذا الجانب، وتفعل لوحة مساعدي البرمجة وملخص مساعدي البرمجة الأمر نفسه للمطورين. وإن كنت تفكر في تشغيل النماذج بنفسك، فإن الذكاء الاصطناعي المحلي مقابل السحابي يبيّن متى يجدي ذلك.
الأسئلة الشائعة
أي نموذج ذكاء اصطناعي أستخدم إذا كان بإمكاني اختيار واحد فقط؟
اختر الفئة المتوسطة من المختبر الذي تعتمد عليه بنيتك أصلًا. نماذج من فئة Sonnet 5.5 أو GPT-6.1 Sol تتعامل مع أوسع نطاق من الأعمال بتكلفة معتدلة، ويمكنك لاحقًا إضافة فئة أرخص أو أقوى حيث تبرر البيانات ذلك.
هل يستحق النموذج الرائد أن أدفع ثمنه؟
نعم، في مجموعة ضيقة من الاستدعاءات التي يكون فيها الخطأ مكلفًا، أو التي تفشل فيها الفئة المتوسطة في فحوصك على أمثلة حقيقية. إنه أداة دقة، وليس خيارًا افتراضيًا.
هل يمكن لنموذج متوسط أن يتفوق على نموذج رائد؟
تُظهر مقاييس Anthropic تقدم Sonnet 5.5 على Opus 5.5 في البرمجة الوكيلية. هذه نتيجة من الشركة نفسها لنوع واحد من المهام، فاختبرها على عملك قبل أن تنقل أي سير عمل حرج.
هل أنتظر Haiku 5.5 أو Gemini 4 Argon؟
لا تعلّق عملك على أي منهما. قالت Anthropic إن Haiku 5.5 قادم خلال الأسابيع المقبلة، وحصرت Google نموذج Argon حاليًا في المدافعين الموثوقين في الأمن السيبراني ولم تتحه للجميع. ابنِ طبقة التوجيه بحيث يكون إضافة فئة جديدة تغييرًا في الإعدادات، ثم أعد تشغيل اختباراتك عند صدورها.
كيف أعرف أن الفئة الأرخص كافية؟
شغّلها على عينة من مدخلات حقيقية، وطبّق فحصًا آليًا، وقارن معدل الفشل بالفئة الأعلى. إذا كان الفارق صغيرًا والمهمة منخفضة المخاطرة، فانزل بالفئة. وإذا كانت الأخطاء تصل إلى العملاء، فلا تفعل.
هل تنطبق هذه الأسعار على اشتراكات المحادثة؟
لا. هذه أسعار الواجهة البرمجية لكل مليون توكن. أما خطط المحادثة وأدوات البرمجة فتُحاسب بحسب المقعد أو سقف الاستخدام، لذلك يأتي التوفير من اختيار نماذج أخف للجلسات الروتينية.