

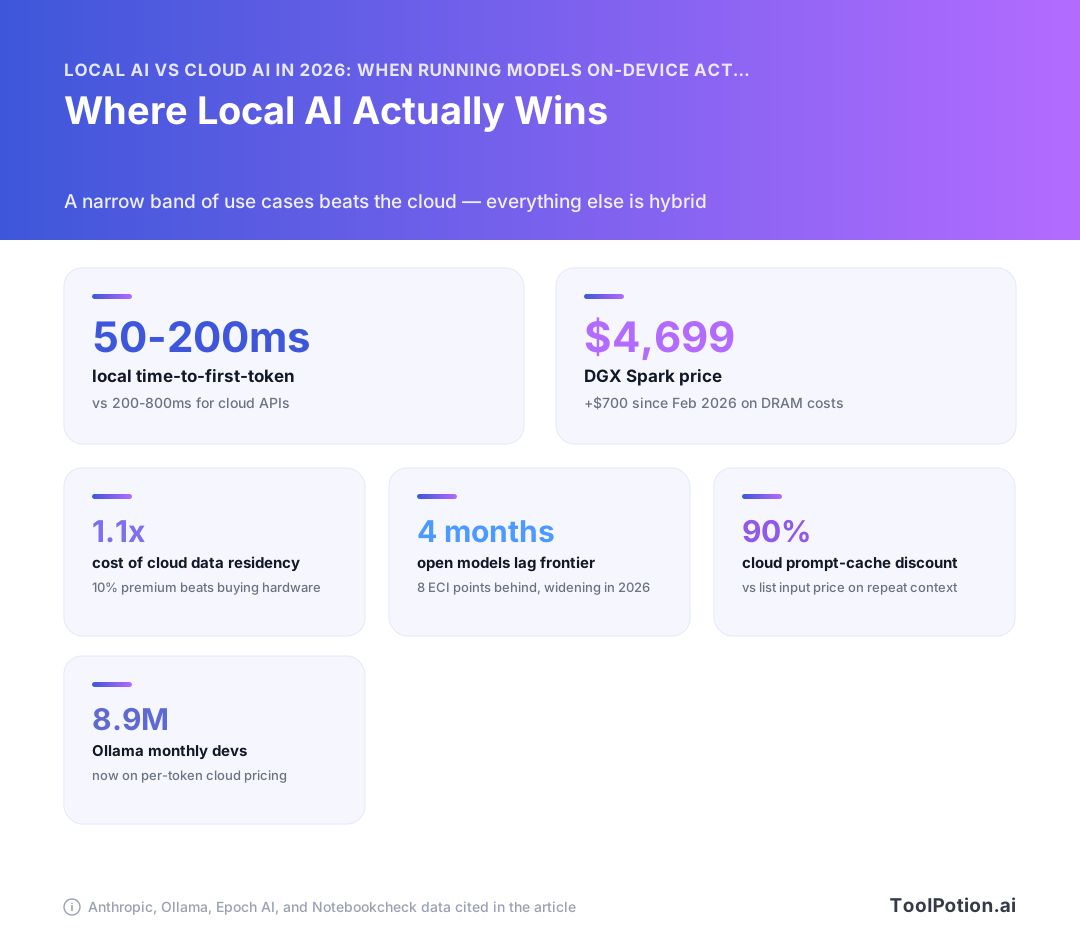
اشترِ وحدة معالجة الرسومات فقط إذا كنت ستُشغّلها باستمرار. هذه هي الإجابة المختصرة على سؤال الذكاء الاصطناعي المحلي مقابل السحابي في 2026: إذا تجاوزت نسبة الاستخدام اليومي المستدام نحو 26%، فإن منصة محلية تتفوق على الدفع لكل رمز. أما دون ذلك، فأنت تموّل شريحة معالجة خاملة بأسعار ذاكرة 2026، وهذه الأسعار مرتفعة بالفعل: رفعت NVIDIA سعر DGX Spark من $3,999 إلى $4,699 في فبراير 2026، مُحيلةً السبب إلى تكاليف DRAM والتخزين المتصاعدة (Notebookcheck).
في المقابل، تراجعت تكاليف الجانب السحابي بطرق تتجاهلها معظم المقارنات. قراءات ذاكرة التخزين المؤقت للطلبات تُحتسب بمعدل 0.1x من سعر الإدخال، وتُضاف إليها خصم Batch API بنسبة 50%، ما يُخفّض Claude Haiku 4.5 إلى $0.50 إدخالاً و$2.50 إخراجاً لكل مليون رمز (Anthropic).
إليك ما تبدو عليه هذه الحسابات، وما تستوعبه بطاقة 24 جيجابايت، وأين تقع نقطة الفاصل بالنسبة لك.
الذكاء الاصطناعي المحلي مقابل السحابي: دليل 2026 انكسر في أربعة مواضع
حسابات نقطة التعادل التي قرأتَها خاطئة، وليس بفارق تقريب بسيط. إنها خاطئة لأن الأجهزة باتت أغلى، وأُسيء قراءة إحصاء القدرة، وانقلبت أدوات العمل، وانخفض سعر الخدمة السحابية بصمت تحت جداول حسابات الجميع.
الافتراضات الثلاثة التي تعتمدها كل مقارنة حتى الآن
تستند تقريباً كل دليل مقارنة بين المحلي والسحابي يظهر في الصفحة الأولى من نتائج البحث على ثلاثة ادعاءات، جميعها تعود إلى عام 2024. الأول: تكلفة الأجهزة ثابتة ومتراجعة، فتستهلك قيمة بطاقة $1,999 على 18 شهراً وتقارنها بالإنفاق لكل رمز. الثاني: النماذج مفتوحة الأوزان تتخلف عن النماذج الحدية المغلقة بثلاثة إلى ستة أشهر، فما تشغّله في المنزل يتأخر ربعين دراسيين. الثالث: «المحلي» يعني Ollama على جهازك، و«السحابي» يعني واجهة برمجية حدية، معركة ثنائية واضحة.
الثلاثة كانت معقولة في 2024. لا يصمد أيٌّ منها أمام واقع 2026.
ما الذي تغيّر بين 2024 والآن
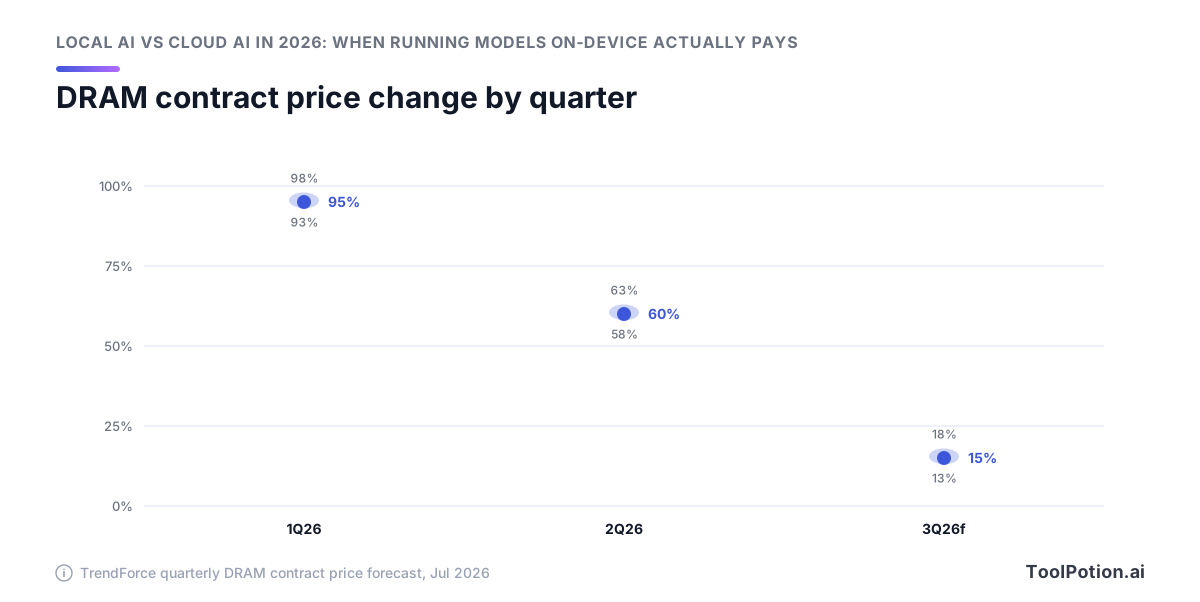
ابدأ بأرضية الأجهزة، لأنها تحركت في الاتجاه الخطأ. رفعت NVIDIA سعر DGX Spark من $3,999 إلى $4,699 في فبراير 2026، بزيادة $700 عزتها إلى ارتفاع حاد في تكاليف DRAM والتخزين. ارتفعت أسعار عقود DRAM التقليدية بنحو 93-98% ربعاً بربع في الربع الأول من 2026 ولا تزال ترتفع 13-18% في الربع الثالث من 2026. كل آلة حاسبة تستشهد بسعر MSRP تُقلّل من تقديرك الرأسمالي بأربعة أرقام.
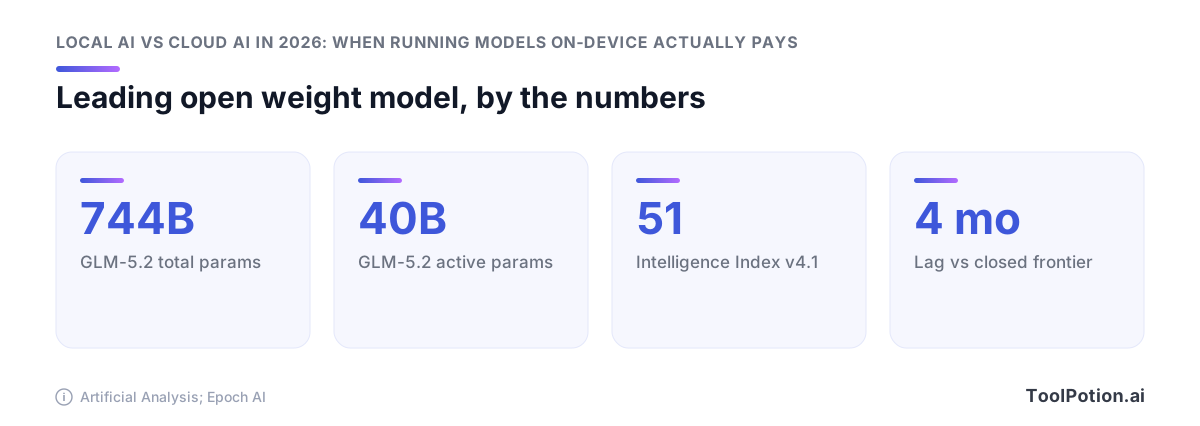
ثم فجوة القدرة. تُقدّر Epoch AI التأخر بـ4 أشهر، أو 8 نقاط ECI منذ يناير 2026، وهو أوسع من متوسط 3 أشهر الذي قاسته من يناير 2023 حتى أكتوبر 2025. ما لا يُقتبس: النموذج الحامل لهذا الادعاء، GLM-5.2، يبلغ 744B إجمالياً و40B معاملاً نشطاً. هذا خادم مركز بيانات، لا حاسوب محمول.
الكسر الثالث هو الأغرب. في 31 أغسطس 2026، انتقلت Ollama بخطط Pro وMax وTeam إلى تسعير سحابي لكل رمز بمعدلات $20 و$100 و$500 شهرياً. الأداة المرجعية لتشغيل النماذج محلياً باتت تبيعك رموزاً، مما يحوّل المقارنة إلى سباق ثلاثي بين وحدة معالجة الرسوم الخاصة بك، والأوزان المفتوحة المستضافة بسعر زهيد، وواجهات API الحدية. إذا كنت تقيّم الخيارات عبر نماذج الذكاء الاصطناعي التي نتابعها، فالمسار الأوسط هو ما يجب تسعيره أولاً.
والجانب السحابي أرخص بطرق لا تُنمذجها أي آلة حاسبة منشورة: قراءات ذاكرة التخزين المؤقت بـ0.1x من سعر الإدخال الأساسي، وخصم Batch API بنسبة 50% يتراكم فوقه، وربط الاستدلال بالولايات المتحدة حصراً بمعامل 1.1x. هذا الأخير يمنحك خاصية الإقامة للبيانات التي يشتريها الناس الأجهزة من أجلها، بعلاوة 10% بدلاً من $4,699.
ما تتعامل معه النماذج المحلية فعلاً في 2026
بطاقة بسعة 24 جيجابايت في 2026 تشغّل نموذج mixture-of-experts جيداً بحجم 20-30B، وسيصيغ هذا النموذج ويلخّص ويُصنّف ويستدل عبر المشكلات المنظّمة بجودة تجدها معظم الفرق مقبولة. كما سيخترع الحقائق بثقة حول أي شيء خارج بيانات تدريبه. هاتان الجملتان هما خريطة القدرة، وتتجاهل معظم أدلة التعادل الجملةَ الثانية.
السقف لأجهزة المستهلكين: فئة MoE بحجم 20-30B
gpt-oss-20b وQwen3-30B-A3B هما السقف العملي لوحدة معالجة رسومات واحدة للمستهلك. كلاهما تصاميم MoE خفيفة، لذا يبقى عدد المعاملات النشطة صغيراً بما يكفي لاستيعاب بطاقة 24 جيجابايت للأوزان مع بقاء مساحة للسياق. دون ذلك تأتي نماذج Llama وMistral وPhi الكثيفة بحجم 7-14B، التي تناسب الجهاز بشكل أريح وتتنازل عن بعض القدرة مقابل ذلك. قوائم نماذج اللغة مفتوحة الأوزان لدينا تتركز بشدة في هذه الفئة، لأنها ما يمكن للناس تشغيله في المنزل.
قوي في الاستدلال، ضعيف في معرفة العالم
أعطِ نموذجاً محلياً بحجم 30B مستنداً واطلب منه استخراج حقول أو اتباع مخطط أو المرور عبر سلسلة من الخطوات، فسيتعامل معها بكفاءة. اسأله من استحوذ على من في 2024 وستحصل على رواية معقولة لكنها مختلقة.
عدد المعاملات هو ما يشتري الحقائق المحفوظة، ونموذج بحجم المستهلك قد تخلّى عن معظم تلك المعاملات. الاسترداد يُقلّص الفجوة: ضع الحقائق في السياق ودع النموذج المحلي يتولى الجزء المنظّم. أما ما يحتاج إلى استذكار واسع بلا طبقة استرداد خلفه، فمحله واجهة API حدية.
لماذا عنوان «النماذج المفتوحة تلحق بالركب» يتحدث عن أجهزة لا تملكها
تُقدّر Epoch AI الفجوة بـ4 أشهر، أو 8 نقاط ECI، منذ يناير 2026، وهي أوسع قليلاً من متوسط 3 أشهر الذي قاسته من يناير 2023 إلى أكتوبر 2025 (Epoch AI). الرقم دقيق ولا يعني شيئاً بشأن حاسوبك المحمول. النموذج الحامل لتاج الأوزان المفتوحة، GLM-5.2، يسجّل 51 على مؤشر الذكاء الصناعي v4.1 بـ744B معاملاً إجمالياً و40B نشطاً (Artificial Analysis). هذا أجهزة مركز بيانات. القياس ذاته يُظهر أن GLM-5.2 يستهلك 43,000 رمز إخراج لكل مهمة، 37,000 منها رموز استدلال، ما يُترجم إلى نحو $0.46 لكل مهمة مقابل $0.18 لـMiniMax-M3.
ما يكلّفك إياه التكميم
Q4_K_M هو الافتراضي لسبب وجيه. على Mistral-7B-Instruct-v0.2 تحت llama.cpp على Apple M1 Pro، خفّض النموذج من 7.2 جيجابايت إلى 4.1 جيجابايت، أصغر بنسبة 43.1%، مقابل 0.51% فقط في خسارة الحيرة (dasroot). Q2_K هو المكان الذي تنكسر فيه المنحنى، بخسارة 7.94% في الحيرة، وتشعر بذلك في اتباع التعليمات قبل أن تراه في أي معيار اختبار. كمّم إلى 4 بت وتوقف هناك، وأنفق الذاكرة التي وفّرتها على زيادة طول السياق.
أرضية الأجهزة تحركت، وتحركت في الاتجاه الخطأ
كل آلة حاسبة لنقطة التعادل ستجدها تفترض أنك تستطيع شراء الجهاز بالسعر المُدرج. في 2026 لا تستطيع في الغالب، والسعر المُدرج نفسه ارتفع.
أزمة الذاكرة، بأسعار يمكنك التحقق منها
ارتفعت أسعار عقود DRAM التقليدية بنحو 93-98% ربعاً بربع في الربع الأول من 2026، ثم 58-63% في الربع الثاني، وتتوقع TrendForce ارتفاعاً إضافياً بنسبة 13-18% في الربع الثالث من 2026 (TrendForce). هذا تباطؤ، لا تراجع. الأسعار لا تزال ترتفع من قاعدة تضاعفت مسبقاً. الطلب لا يأتي منك: مراكز البيانات تستوعب ما يصل إلى 70% من إنتاج الذاكرة العالمي في 2026 مقابل نحو 20-30% في 2022، وHBM وحده استهلك 23% من رقائق DRAM هذا العام مقابل 8% في 2024 (IDC). الاستدلال المحلي عملية شراء لطاقة ذاكرة تتنافس مع من يبني السحابات التي تحاول تجنّبها.
DGX Spark وRTX 5090 والفجوة بين سعر MSRP والسوق
رفعت NVIDIA سعر DGX Spark من $3,999 إلى $4,699 في فبراير 2026، بزيادة $700 عزتها الشركة إلى ارتفاع حاد في تكاليف DRAM والتخزين (Notebookcheck). ذاكرة LPDDR5X بسعة 128 جيجابايت هي السبب الذي يجعله جديراً بالاهتمام للنماذج المحلية، وهي أيضاً السبب الذي يجعل سعره يتتبع سوق السلع الذي لا تتحكم فيه.
عامِل أي سعر MSRP من 2025 تراه مُقتبساً في منشور مقارنة على أنه خيال. تحقق من سعر القطعة هذا الأسبوع، ثم احسب أرقامك على هذا الرقم.
الكهرباء: البند الذي ينساه الجميع
وحدة معالجة الرسومات شراء لمرة واحدة ترسل لك فاتورة كل شهر. بلغ متوسط الكهرباء السكنية في الولايات المتحدة 18.34 سنتاً/كيلوواط في يونيو 2026، بارتفاع 5.0% سنوياً، وتتراوح الولايات بين 8.96 سنت في نيومكسيكو و28.50 سنت في كاليفورنيا (EIA). الجهاز ذاته له تكلفة تشغيل تتفاوت بأكثر من 3x تبعاً لمكان توصيله. إذا كنت في كاليفورنيا، قد تضاهي الكهرباء وحدها تكلفة الرموز المستضافة المكافئة. في نيومكسيكو الحساب مختلف بما يكفي لتغيير الإجابة.
ما يكلّفه إعداد قابل للدفاع عنه في 2026
قدّر الجهاز بسعر السوق الحالي، وأضف استهلاك الطاقة بمعدل الكهرباء الفعلي لديك، وأضف الساعات التي ستقضيها في إعداد أطر الاستدلال المحلي وضبط التكميم التي لا تطلبها منك نقطة نهاية مستضافة. رقم رأسمالي بأربعة أرقام مع ذيل تشغيلي سنوي بثلاثة أرقام هو نقطة البداية الأمينة، وكلا النصفين ازدادا سوءاً هذا العام لأسباب لا علاقة لها بجودة النماذج.
Ollama مقابل تكلفة واجهة API السحابية: المقارنة صارت ثلاثية الأطراف
ثلاثة أسعار تهم الآن: وحدة المعالجة التي تشتريها، والأوزان المفتوحة المستضافة، وواجهة API حدية. الخيار الوسط يتفوق لمعظم أحمال العمل، وهو الذي تغفله كل معادلة تعادل منشورة تقريباً.
Ollama نفسها أصبحت واجهة API سحابية في 31 أغسطس 2026
الأداة التي علّمت جيلاً من المطورين تشغيل النماذج على أجهزتهم باتت تبيع رموزاً. في 31 أغسطس 2026 انتقلت Ollama بخطط Pro وMax وTeam إلى تسعير سحابي لكل رمز: $20/شهراً بما يتضمن $60 من الاستخدام، و$100/شهراً بما يتضمن $300، و$500/شهراً بما يتضمن $1,000 مشتركة بين مستخدمين غير محدودين، مع صفر احتفاظ بالبيانات واستضافة في الولايات المتحدة وأوروبا (Ollama). لذا فإن «Ollama مقابل السحابة» لم يعد يصف خياراً حقيقياً.
الأوزان المفتوحة المستضافة: الخيار الوسط الذي لا يُنمذجه أحد
| النموذج | الإدخال / الإخراج لكل مليون رمز | المصدر |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
اقرأ الملاحظات الدقيقة قبل أن تبني توقعات على هذه الأرقام. معظم أسعار Ollama Cloud تتضاعف بين الساعة 12:00 و18:00 UTC أيام الأسبوع (Ollama)، ما يحوّل فاتورتك إلى مسألة جدولة. ادفع مهام الدُفعات إلى الليل وعطل نهاية الأسبوع وستحتفظ بالسعر الأصلي. شغّل منتجاً تفاعلياً لمستخدمين أوروبيين في فترة بعد الظهر وستدفع السعر المضاعف كل يوم عمل. متغير التوقيت هذا يستحق اهتماماً أكبر من الاختيار بين مزوّدَي استضافة متقاربَي السعر.
واجهات API الحدية أرخص مما يوحي به سعرها الأساسي
تُحتسب قراءات ذاكرة التخزين المؤقت بـ0.1x من سعر الإدخال الأساسي، وتأخذ Batch API 50% خصماً على الإدخال والإخراج معاً، والخصمان يتراكمان (Anthropic). Haiku 4.5 المُدفَّع يبلغ $0.50 إدخالاً و$2.50 إخراجاً لكل مليون رمز، وحافظ Sonnet 5 على سعره التمهيدي $2/$10 بدلاً من الانتقال إلى $3/$15 المجدولة في 1 سبتمبر 2026 (Anthropic). الأعمال الضخمة غير المتزامنة هي بالضبط ما يُروَّج للمنصات المحلية من أجله، وهي العبء الذي تعضّ فيه الخصومات السحابية بأشد قوة.
هامش المُرمِّز الذي يُقلّب الحساب
يستخدم Claude 4.7 وما بعده مُرمِّزاً أحدث يُنتج نحو 30% رموزاً إضافية للنص ذاته (Anthropic). فاتورة Sonnet 5 الفعلية على مجموعة نصوص ثابتة أعلى بنحو 30% مما يوحي به سعر $2/$10 حين تقارنه بنموذج محلي يستخدم مُرمِّزاً أقدم. أحصِ الرموز على نصوصك الخاصة بكليهما قبل أن تلتزم.
حساب نقطة التقاطع: عند أي حجم تتفوق وحدة المعالجة الخاصة بك؟
يبدأ الجهاز المملوك بالتفوق على الأوزان المفتوحة المستضافة عند نحو 26% من استخدام وحدة المعالجة اليومي المستدام، أي نحو ست ساعات يومياً من العمل الفعلي كل يوم، مُطفَّأ على أسعار أجهزة 2026 ومعدل الكهرباء المحلي لديك. دون هذا الخط تجلس البطاقة خاملة بينما تدور ساعة الاستهلاك. قيّم حجمك الخاص مقابل المعدل المستضاف قبل الشراء: deepseek-v4-flash يبلغ $0.22 إدخالاً و$0.66 إخراجاً لكل مليون رمز على Ollama Cloud (Ollama).
أين يتفوق المحلي (قائمة قصيرة وقابلة للتسمية)
أربعة حالات تصمد أمام التدقيق. كل شيء آخر إعداد هجين تُوجَّه فيه الاستعلامات السهلة إلى نموذج محلي وتُصعَّد الباقية.
أعمال الدُّفعات الضخمة المستمرة التي تُشغّل البطاقة باستمرار
إذا كانت وحدة معالجة الرسومات خاملة 90% من اليوم، فقد اشتريت مدفأة. حجة الشراء تحتاج البطاقة تعمل أكثر من ربع اليوم، كل يوم، وأن تصمد في المقارنة مع Claude Batch API التي تخفّض رموز الإدخال والإخراج بنسبة 50% وتتراكم مع التخزين المؤقت للطلبات (Anthropic). ما يضع عمل Haiku 4.5 المُدفَّع عند $0.50 لكل مليون رمز إدخال و$2.50 إخراجاً. منصتك المحلية عليها أن تتفوق على ذلك بالأجهزة المُطفَّأة بالإضافة إلى الكهرباء، وعند متوسط 18.34 سنتاً/كيلوواط للكهرباء السكنية الأمريكية في يونيو 2026 (EIA)، البطاقة تحت الحمل الفعلي ليست مجانية أيضاً. احسب الأرقام بحجم رموزك الفعلي قبل احتساب المواصفات التقنية.
السيادة الصارمة على البيانات، CLOUD Act وليس GDPR فحسب
ثمة فئة حقيقية هنا، وهي أضيق مما يدّعيه معظم الناس. الامتثال لـGDPR مشكلة عقود. متطلب ألا تستطيع أي جهة خاضعة للقضاء الأمريكي إلزامك بتسليم بياناتك مشكلة فيزيائية، والمشاكل الفيزيائية تُحلّ بأجهزة تتحكم فيها.
الحلقات التفاعلية حيث يكون وقت أول رمز هو المنتج
يُوصّل الاستدلال المحلي أول رمز في 50-200 ملي ثانية مقابل 200-800 ملي ثانية للسحابة، مع قياس Claude Haiku 4.5 بـ597 ملي ثانية وGPT-4.1 Mini بنحو 2,400 ملي ثانية (Eden AI). في نافذة محادثة لا يلاحظها أحد. في إكمال الكود المضمّن، أو وكيل متعدد الخطوات يسلسل ثماني مكالمات، يتراكم هذا الفارق إلى شيء يشعر به المستخدمون. إذا كنت تبني بهذا الشكل، تصفّح وكلاء الذكاء الاصطناعي في دليلنا وتحقق كم منها يقوم برحلة ذهاباً وإياباً لكل ضغطة مفتاح.
التشغيل دون اتصال ومعزول عن الشبكة
لا جدال هنا. إما أن تكون الشبكة متاحة أو لا.
حجة الخصوصية التي باتت السحابة تبيعها مجدداً
أقوى ردّ على الحالة الثانية أن Anthropic ستبيعك هذه الخاصية مباشرة. على Claude 4.6 وما بعده، ربط الاستدلال بالولايات المتحدة حصراً عبر inference_geo: "us" يكلّف معامل 1.1x على جميع فئات الرموز (Anthropic). هذه علاوة 10% بدلاً من $4,699 من DGX Spark. وخطط Ollama المدفوعة تُعلن صفر احتفاظ بالبيانات مع استضافة في الولايات المتحدة وأوروبا اعتباراً من 31 أغسطس 2026 (Ollama). إذا كان متطلب الخصوصية لديك يُرضيه ضمان تعاقدي وتثبيت جغرافي، فليس لديك متطلب للأجهزة.
الإعداد الهجين الذي يصل إليه معظم الممارسين
وجّه حسب الصعوبة، لا حسب المبدأ. نموذج MoE بحجم 20-30B على بطاقتك يتعامل مع نحو سبع من كل عشر استعلامات في حمل عمل مساعد أو معالجة مستندات نموذجي، والثلاث الباقية تذهب إلى واجهة API حدية. هذا التقسيم هو المعمارية. كل شيء آخر ضبط دقيق.
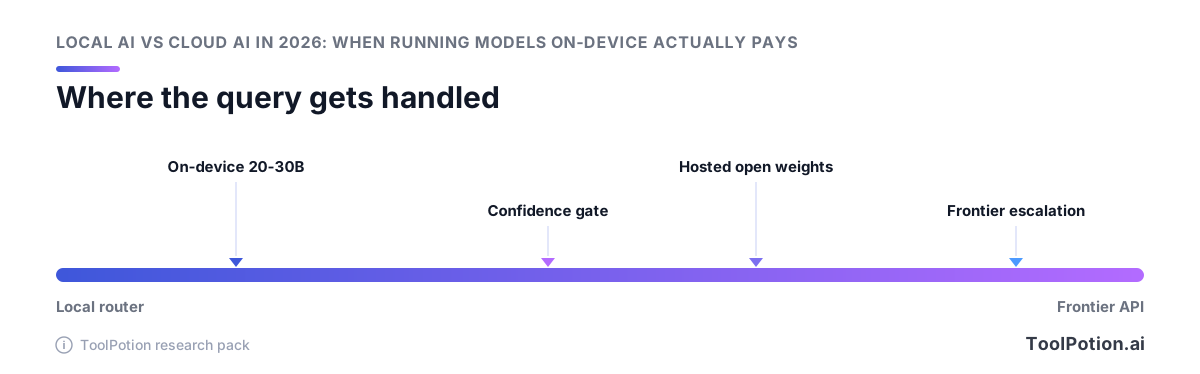
ثلاثة إشارات تحدد التصعيد ويمكنك حسابها جميعاً قبل أن ينتهي النموذج المحلي: ثقة النموذج بنفسه (هامش log-prob أو فحص ذاتي سريع)، وما إذا كان الاستعلام يحتاج معرفة عالمية لا تمتلكها الأوزان المحلية، وطول السياق. إشارة المعرفة تلتقط معظم إخفاقاتك. نموذج بفئة 24 جيجابايت يستدل جيداً ويتذكر بشكل رديء، لذا فأي شيء يبدو كـ«من استحوذ على من في 2025» يجب تخطّي المحلي كلياً.
تكديس ملموس يعمل
Ollama أو LM Studio في الأمام، وواجهة API حدية واحدة خلفها، وموجّه رفيع بينهما يسجّل كل قرار.
أرسل الحركة المصعَّدة إلى Claude Haiku 4.5 بـ$1/مليون رمز إدخال و$5/مليون رمز إخراج أولاً، ولا تصل إلى Sonnet 5 بـ$2/$10 إلا حين يفشل إجابة Haiku في فحصك (تسعير Anthropic). إذا كان العمل المصعَّد غير متزامن، دفّعه: تُخفّض Batch API كلا الجانبين، فيبلغ Haiku $0.50/$2.50. معظم الفرق تتخطى هذا وتدفع السعر الكامل على عمل كان يمكنه الانتظار عشرين دقيقة.
قِس معدل التصعيد وإلا أنت تطير أعمى
سجّل أربعة أرقام لكل طلب: أي مستوى خدمه، وثقة النموذج المحلي، وعدد الرموز، وما إذا أعاد إنسان المحاولة على الإجابة. معدل إعادة المحاولة هو إشارة الجودة الحقيقية. إذا بقي التصعيد دون نحو 20%، فنموذجك المحلي يُجيب عن أشياء لا ينبغي له وستراه في إعادات المحاولة. فوق 45% ووحدة المعالجة لا تكسب استهلاكها.
لماذا تتحرك الحدود كل ربع
الأسعار على كلا الجانبين تتحرك أسرع من معماريتك. أعادت Ollama تسعير خطط Pro وMax وTeam إلى فواتير سحابية لكل رمز في 31 أغسطس 2026 (Ollama)، وتتضاعف أسعار Ollama Cloud بين 12:00 و18:00 UTC أيام الأسبوع (تسعير Ollama)، وتتأخر قدرة الأوزان المفتوحة عن النماذج الحدية المغلقة بنحو 4 أشهر في المتوسط منذ يناير 2026 (Epoch AI). أعد احتساب عتبات توجيهك مقابل الأرقام الحية مرة كل ربع. ضعها في التقويم.
طبقة الأدوات مستقرة بما يكفي للبناء عليها
تعمل Ollama مع 8.9 مليون مطور نشط شهرياً بفريق مكوّن من 14 شخصاً، وتتواجد في 85% من شركات Fortune 500، وجمعت $65M بقيادة Theory Ventures في يوليو 2026 (TechCrunch). هذا ليس مشروعاً يختفي العام القادم. غراء الموجّه حولها هو الجزء الذي تملكه، ويمكنك استعارة معظمه من مستودعات الذكاء الاصطناعي مفتوحة المصدر التي تنشر هذا النمط بالفعل.
قرّر في خمسة أسئلة
أجب عنها بالترتيب. أول سؤال يعطيك نعم قاطعة يُحدد إعدادك ويمكنك التوقف عنده.
هل لديك متطلب سيادة صارم؟
الصارم يعني معزولاً عن الشبكة، أو تعرّضاً لـCLOUD Act وثّقه الفريق القانوني خطياً، أو عقداً يُسمّي الجهاز. إذا كان هذا ينطبق عليك، اشترِ الأجهزة وأوقف قراءة قسم التكلفة. إذا كان متطلبك أخف من ذلك، ستربط Anthropic الاستدلال بالولايات المتحدة حصراً عبر inference_geo: "us" على Claude 4.6 وما بعده بمعامل 1.1x على جميع فئات الرموز (وثائق تسعير Anthropic)، وخطط Ollama المدفوعة تعمل بصفر احتفاظ بالبيانات في الولايات المتحدة وأوروبا (Ollama). علاوة 10% تتفوق على $4,699 من الأجهزة لمعظم الناس.
هل عملك محدود بالكمون أم بالإنتاجية؟
الحلقات التفاعلية حيث ينتظر شخص كل رمز تفضّل المحلي: 50-200 ملي ثانية لأول رمز مقابل 200-800 ملي ثانية للسحابة، مع قياس Claude Haiku 4.5 بـ597 ملي ثانية (Eden AI). عمل الإنتاجية يسير في الاتجاه المعاكس. دفّعه وخذ الخصم 50%، ما يضع Haiku 4.5 عند $0.50/مليون رمز إدخال و$2.50 إخراجاً (Anthropic).
هل ستبقى وحدة المعالجة مشغولة أكثر من ربع اليوم؟
دون هذا الخط بطاقتك تستهلك بينما هي خاملة والأوزان المفتوحة المستضافة تتفوق على التكلفة. فوقه تبدأ الحسابات المحلية بالعمل. كن صادقاً بشأن المقام، إذ تُحتسب الليالي وعطل نهاية الأسبوع.
هل تحتاج مهمتك معرفة عالمية أم مجرد استدلال؟
الاستدلال على نص تُوفّره يعمل بشكل جيد مع نموذج MoE بحجم 20-30B. الأسئلة التي تعتمد على حقائق يجب أن يعرفها النموذج مسبقاً تنتمي إلى واجهة API حدية، أو إلى GLM-5.2 المستضاف بـ744B معاملاً إجمالياً والذي لن يناسب حاسوبك المحمول أبداً (Artificial Analysis).
هل تتحمّل إعادة الضبط كل ربع؟
الفجوة بين المفتوح والمغلق تقف عند 4 أشهر وانتقلت من متوسط 3 أشهر (Epoch AI)، لذا لعتبة توجيهك تاريخ انتهاء صلاحية. الفرق التي لن تُراجعها يجب أن تعتمد افتراضياً واجهة API حدية مع تخزين مؤقت نشط ولا توجّه شيئاً. التي ستراجع يمكنها الاطلاع على دراسات حالات النشر الفعلية لترى ما انتهت إليه عتبات الآخرين.
ما الذي سيغيّر هذا الحكم في 2027
هذه النصيحة لها تاريخ انتهاء، وثلاثة أرقام محددة تُحدده.
أسعار الذاكرة تتباطأ، لا تتراجع
ارتفعت أسعار عقود DRAM التقليدية بنحو 93-98% ربعاً بربع في الربع الأول من 2026، ثم 58-63% في الربع الثاني، مع توقعات بـ13-18% في الربع الثالث من 2026. هذا المنحنى يتسطّح. لا يزال مشيراً إلى الأعلى. معدل ارتفاع أبطأ لا يُعيد لك الـ$700 التي أضافتها NVIDIA إلى DGX Spark في فبراير 2026، ولا يقول التوقع أن أسعار السوق ستنخفض العام القادم. خطّط على أن حجة الأجهزة تبقى ضعيفة حتى 2027 ما لم يتراجع طلب مراكز البيانات.
راقب فجوة المفتوح/المغلق، لا المعيار الرئيسي
إشارتان تهمان أكثر من أي مرتبة على لوحة الصدارة. الأولى فجوة ECI لدى Epoch AI، التي كانت 4 أشهر، أو 8 نقاط، منذ يناير 2026. الثانية عدد المعاملات النشطة: GLM-5.2 يتصدر الأوزان المفتوحة بـ40B نشطاً من أصل 744B إجمالية، لذا اليوم الذي يهبط فيه نموذج بأقل من 30B معاملاً نشطاً ضمن نقاط ECI قليلة من الحدي، تصبح بطاقة 24 جيجابايت مثيرة للاهتمام مجدداً. راقب أيضاً ما إذا كان تضاعف أسعار Ollama خلال الذروة (12:00-18:00 UTC أيام الأسبوع) يثبت أم يتطبّع. تقارير اتجاهات الذكاء الاصطناعي لدينا تتابع إصدارات النماذج التي قد تُحرّك أياً من هذه.
الأسئلة الشائعة
هل تشغيل نموذج لغوي كبير محلياً أرخص من استخدام واجهة API سحابية في 2026؟
لمعظم الناس، السحابة، والفجوة اتّسعت في 2026. Claude Haiku 4.5 سعره $1 لكل مليون رمز إدخال و$5 لكل مليون إخراج، ويهبط إلى $0.50/$2.50 عبر Batch API، وقراءات ذاكرة التخزين المؤقت تُحتسب بـ0.1x من معدل الإدخال الأساسي (تسعير Anthropic). في الجانب الآخر، ارتفع NVIDIA DGX Spark من $3,999 إلى $4,699 في فبراير 2026 بسبب تكاليف DRAM والتخزين (Notebookcheck)، ولا تزال تدفع الكهرباء بمتوسط 18.34 سنتاً/كيلوواط للمسكن الأمريكي في يونيو 2026 (EIA). المحلي يكسب أمواله على أعمال الدُّفعات الضخمة المستمرة التي تُشغّل البطاقة حصة كبيرة من كل يوم، وعلى التشغيل المعزول عن الشبكة، وعلى الحلقات الحساسة للكمون.
ما الأجهزة التي أحتاجها لتشغيل نموذج لغوي كبير محلياً في 2026؟
بطاقة 24 جيجابايت هي الحد الأدنى العملي للمستهلك، وتحصرك في فئة mixture-of-experts بحجم 20-30B بعيداً عن أي شيء قريب من حدود الأوزان المفتوحة. فوق ذلك تشتري صندوقاً بـ128 جيجابايت LPDDR5X كـDGX Spark الذي يبلغ الآن $4,699 (Notebookcheck). ضع في الميزانية أسعار الذاكرة التي تواصل ارتفاعها: ارتفعت أسعار عقود DRAM التقليدية نحو 93-98% ربعاً بربع في الربع الأول من 2026 و58-63% في الربع الثاني، مع توقعات بـ13-18% إضافية للربع الثالث من 2026 (TrendForce). التكميم يمدّد ما يناسب الجهاز، والتكميم بـ4 بت يكاد يكون مجانياً: Q4_K_M قلّص Mistral-7B-Instruct-v0.2 من 7.2 جيجابايت إلى 4.1 جيجابايت مقابل 0.51% في خسارة الحيرة، بينما انهار Q2_K عند 7.94% (مقايضات التكميم).
كيف تقارن النماذج المحلية بـClaude أو GPT؟
الفجوة المُستشهد بها على نطاق واسع حقيقية لكنها تصف أجهزة لا تمتلكها على الأرجح. قاست Epoch AI تأخر النماذج مفتوحة الأوزان عن النماذج الحدية المغلقة بمتوسط 4 أشهر، أو 8 نقاط ECI، منذ يناير 2026، أوسع قليلاً من متوسط 3 أشهر لفترة يناير 2023 حتى أكتوبر 2025 (Epoch AI). النموذج الحامل لهذا الادعاء، GLM-5.2، يسجّل 51 على مؤشر الذكاء الصناعي v4.1 بـ744B إجمالياً و40B معاملاً نشطاً، وهو أجهزة مركز بيانات (Artificial Analysis). ما يناسب فعلاً حاسوباً محمولاً أو وحدة معالجة واحدة قوي في الاستدلال المنظّم وضعيف في معرفة العالم، لذا عامِل رقم الـ4 أشهر على أنه سقف لا تستطيع الوصول إليه في المنزل.
هل Ollama لا تزال مجانية، وكيف يقارن تسعير Ollama Cloud بواجهات API الحدية؟
إطار المقارنة «محلي مقابل Ollama» توقف عن المنطق في 31 أغسطس 2026، حين انتقلت Ollama بخططها Pro وMax وTeam إلى تسعير سحابي لكل رمز: $20/شهراً بما يتضمن $60 من الاستخدام، و$100/شهراً بما يتضمن $300، و$500/شهراً بما يتضمن $1,000 مشتركة بين مستخدمين غير محدودين، بصفر احتفاظ بالبيانات واستضافة في الولايات المتحدة وأوروبا (مدونة Ollama). الأوزان المفتوحة المستضافة رخيصة هناك: deepseek-v4-flash بـ$0.22 إدخالاً و$0.66 إخراجاً لكل مليون رمز، وnemotron-3-super بـ$0.015/$0.60، وqwen3.5:397b بـ$0.60/$3.60، وإن كانت معظم الأسعار تتضاعف خلال ساعات الذروة من 12:00 إلى 18:00 UTC أيام الأسبوع (تسعير Ollama). قارن ذلك بـClaude Haiku 4.5 بـ$1/$5 (تسعير Anthropic) والقرار الحقيقي ثلاثي، مع الأوزان المفتوحة المستضافة التي تتفوق على وحدة المعالجة الخاصة بك تكلفةً لمعظم أحمال العمل. Ollama لها الثقل اللازم لتؤخذ بجدية على أي حال، بـ8.9 مليون مطور نشط شهرياً و85% من Fortune 500 (TechCrunch).
هل تشغيل نموذج محلياً يجعل بياناتي أكثر خصوصية من واجهة API سحابية؟
يمنحك خاصية لا يوفّرها شيء آخر، وهي أن البايتات لا تغادر جهازك أبداً، وهذا مهم للعمل المعزول عن الشبكة ولمتطلبات السيادة الصارمة على البيانات كـCLOUD Act. لكل ما هو أخف من ذلك، يبيع المزودون الآن الضمان ذاته بسعر زهيد. على Claude 4.6 وما بعده، ربط الاستدلال بالولايات المتحدة حصراً عبر inference_geo: "us" يكلّف معامل 1.1x على جميع فئات الرموز (تسعير Anthropic)، وخطط Ollama المدفوعة تعمل بصفر احتفاظ بالبيانات في الولايات المتحدة وأوروبا (مدونة Ollama). علاوة 10% أقل تكلفة بكثير من $4,699 من الأجهزة (Notebookcheck).
ما النموذج المحلي الذي أبدأ به على بطاقة 24 جيجابايت؟
ابدأ بنموذج mixture-of-experts بحجم 20-30B كـQwen3-30B-A3B أو gpt-oss-20b، مكمَّماً إلى Q4_K_M. هذه الفئة تسجّل 73-87% على AIME 2024 على RTX 5090 واحد، فالاستدلال يصمد جيداً، بينما الاستذكار الواقعي عن العالم هو نقطة ضعفه. Q4_K_M هو نقطة التكميم الصحيحة: قلّص نموذجاً من 7.2 جيجابايت إلى 4.1 جيجابايت مقابل 0.51% في خسارة الحيرة، وتدهور Q2_K بشكل حاد عند 7.94% (مقايضات التكميم). شغّله كأول خطوة وصعّد الاستعلامات الثقيلة بالمعرفة إلى نموذج سحابي.