

Lance Fortnow는 20년 넘게 계산 복잡도 블로그를 운영해 온 사람으로, 쉽게 호들갑을 떠는 성격이 아닙니다. 이번 주장을 다룬 그의 글도 신중한 문장으로 끝납니다. "증명을 직접 검증하지는 못했지만, 이제 지수 시간 가설은 끝났다고 봐도 무방합니다" (Computational Complexity).
이 주장은 두 연구소에서 나왔습니다. ChatGPT를 만든 OpenAI는 자사 모델이 지수 시간 가설(보통 ETH로 줄여 부릅니다)을 반증했다고 밝혔습니다. 몇 시간 뒤에는 Claude를 만든 Anthropic도 자체 반증을 공개했습니다(두 어시스턴트는 여기서 비교했습니다). 이후 언론은 이 소식을 수학자들 사이의 다툼, 그리고 전 세계 암호화에 대한 우려와 엮어 보도했습니다. 저희는 두 연구소의 발표문과 전문가 논평, 뉴스 보도를 모두 읽어 보았고, 결론은 분명합니다. 이 결과는 아마도 사실이고 이론 연구자들에게 중요하지만, 데이터를 보호하는 방식을 바꿀 이유는 아닙니다. 세 가지 헤드라인 중 둘은 서로 다른 분쟁을 다루고 있고, 나머지 하나는 추세에 관한 이야기입니다.
지수 시간 가설이란 무엇일까요? 쉽게 설명하면
3-SAT이라는 퍼즐에서 시작해 보겠습니다. n개의 참/거짓 스위치에 대한 긴 조건 목록이 주어지고, 각 조건은 "A 또는 B가 아님 또는 C" 같은 형태입니다. 모든 조건을 만족하는 스위치 설정을 찾아야 합니다. 어떤 설정이 맞는지 확인하는 것은 빠릅니다. 어려운 건 그 설정을 찾는 일입니다. 완성된 스도쿠는 검증하기 쉽지만 빈 칸투성이 스도쿠는 풀기 어려운 것과 비슷합니다.
ETH는 1999년 Russell Impagliazzo와 Ramamohan Paturi(Francis Zane 공저)가 제안했으며, 3-SAT을 푸는 모든 알고리즘은 어떤 고정된 상수 c > 0에 대해 2의 c·n제곱에 비례하는 시간이 필요하다고 말합니다(Fortnow). 다이얼이 하나 늘 때마다 작업량이 1.3배처럼 일정한 배수로 늘어나는 자물쇠를 떠올려 보세요. ETH는 이 배수를 줄일 수는 있어도 1까지 줄일 수는 없다고 주장합니다.
이번 반증은 공식이 커질수록 그 배수가 1에 가까워진다고 말합니다. Fortnow에 따르면 OpenAI의 논문이 제시한 실행 시간은 대략 2의 (n·log log n / √log n)제곱입니다. 그래도 빠르다고 할 수는 없습니다. 어떤 고정된 배수보다 느리게 증가한다는 것뿐입니다. Anthropic의 발표문도 이 점을 분명히 합니다. "이 결과는 순전히 점근적인 것이며, 실제 공식을 푸는 일에 대해서는 아무것도 말해 주지 않습니다" (Anthropic).
이론 연구자들은 왜 이렇게 관심을 가질까요? ETH는 수백 편의 논문에서 "이 문제는 훨씬 더 빠르게 풀 수 없다"는 근거로 쓰여 왔기 때문입니다(OpenAI). 가설이 거짓이라면 그런 어려움 논증은 다시 점검해야 합니다. 다만 Fortnow는 "ETH와 SETH가 틀렸다고 해서 그 함의까지 틀린 것은 아니다"라고 짚습니다.
평소보다 많이 검증되었지만, 확정되기에는 이릅니다
지금까지의 검증은 보통 획기적인 성과가 첫 주에 받는 것보다 많습니다. OpenAI에 따르면 자사 모델은 발표 열흘 전에 반증을 찾아냈고, 이를 Lean으로 형식화했습니다. Lean은 검증 가능한 단계만 받아들이는 증명 검사기입니다(OpenAI). Anthropic은 내부 Claude 모델이 자사 버전을 찾아냈고, Lean 파일은 AI 모델이 작성했다고 밝혔습니다(Anthropic).
이후 사람들도 합류했습니다. 카네기멜런대의 Ryan O'Donnell은 증명을 다시 쓴 해설문을 올렸고, Fortnow에 따르면 Shiva Kintali도 또 다른 해설을 올렸습니다. 둘 다 최상의 한계보다 단순함을 목표로 했습니다. Timothy Gowers는 "이것이 거짓이라니 매우 놀랍고 파급력이 큽니다"라고 평했습니다(Business Insider).
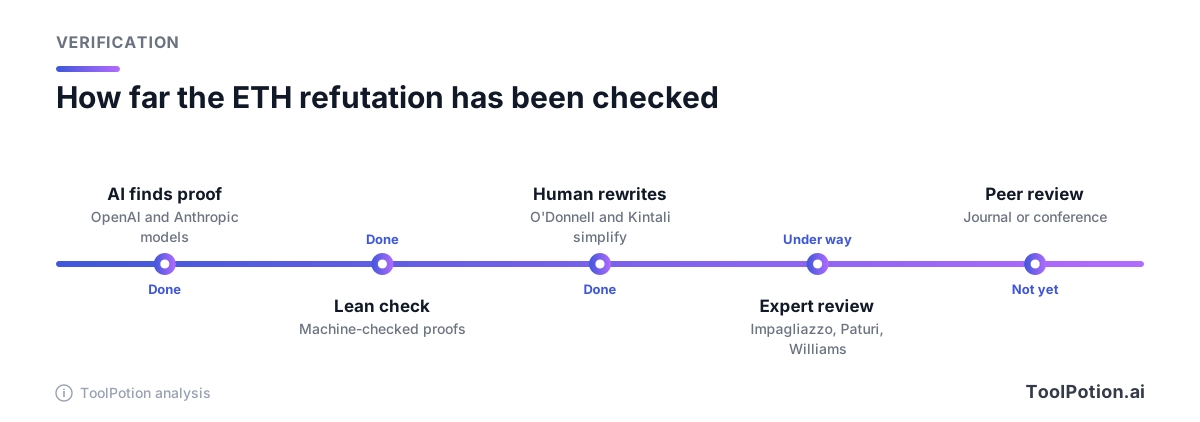
이를 검증하도록 공식 지정된 사람은 Impagliazzo, Paturi, 그리고 MIT의 Ryan Williams입니다. Williams는 TechCrunch에 증명의 일부는 평범하지만 "낯설어 보이는 부분이 두세 군데 있다"고 말했습니다. Business Insider는 Williams가 이 결과를 보증하지 않았으며, 해당 그룹도 자신들의 참여가 지지 표명은 아니라고 밝혔다고 전합니다. Anthropic 저장소에서 한 가지 더 주의할 점이 있습니다. Lean은 증명을 검사하지만 "이 파일이 논문에서 말하는 내용을 실제로 말하고 있는지는 어떤 기계도 검사하지 않기" 때문에, 사람이 짧은 명제 파일을 직접 읽어야 합니다. 그래서 그 파일을 짧게 유지했다고 합니다.
저희 판단은 이렇습니다. 두 연구소의 주장, 기계로 검증된 증명, 며칠 만에 나온 사람의 재작성이 함께 있다는 것은 이례적으로 강력합니다. 그래도 전문가 그룹과 학술지가 확인해 주기 전까지는 어디까지나 주장입니다.
수학자들의 다툼은 이 결과를 둘러싼 것일까요?
대부분 아닙니다. BBC가 말한 "수학자들 간의 충돌"은 다른 문제에 관한 것입니다. 해당 기사는 나비에-스토크스 분쟁을 다룹니다. NYU의 Tristan Buckmaster가 OpenAI의 Codex 도구에 저장해 둔 자신의 초안이 OpenAI 자체 연구에 쓰였을 가능성이 있는지 물은 사건입니다. OpenAI는 내부의 누구도 상대 팀의 작업을 본 적이 없으며, 그의 프롬프트가 "시스템에 어떤 식으로도 영향을 줄 수 없었다"고 밝혔습니다.
Scientific American의 "선수를 쳤다(scooped)"는 헤드라인은 물리학 문제인 양-밀스 이론에 관한 것입니다. 이 매체는 OpenAI가 먼저 증명을 해낸 것으로 보인다고 전하는데, 상대는 Anthropic의 Levent Alpöge와 함께 연구한 Ethan Sussman입니다. Alpöge는 X에서 이의를 제기했습니다. 이 중 어느 것도 3-SAT 알고리즘이 작동하는지와는 관련이 없습니다.
ETH를 둘러싼 논란은 절차에 관한 것입니다. Williams는 OpenAI의 이전 발표를 "수학자들을 향한 DDoS 공격"이라고 불렀지만(X), 이번에는 돕기로 했습니다. Scientific American에 따르면 OpenAI가 세 결과 중 두 건에서 취한 방식은 AI와 수학에 관한 자사 전문가 자문단의 명확화 성명을 위반한 것이며, 그 바탕이 된 프롬프트와 사고 과정(chain-of-thought)은 아직 비공개입니다. ETH에 대해서는 OpenAI가 증명을 공개하고 학회 개최를 후원하기로 했습니다.
RSA나 제 휴대폰의 암호화가 깨질까요?
아니요, 적어도 이 경로로는 아닙니다. 이유가 구체적이기 때문에 단언할 수 있습니다. 첫째, 이 알고리즘은 k-SAT을 풉니다. Fortnow는 이것이 "부분집합 합(Subset Sum)이나 외판원 문제(Traveling Salesman)에는 새로운 것을 주지 않는다"고 강조합니다. 이런 문제를 3-SAT으로 바꾸면 변수의 수가 지나치게 불어나기 때문입니다. 둘째, RSA는 거대한 수를 두 소수로 쪼개는 어려움에 기반합니다(Financial Times는 이 방식을 이름 없이 설명합니다). 이는 논리식을 만족시키는 문제와는 다른 문제이며, 저희가 읽은 어떤 자료도 새 알고리즘이 여기에 미친다고 말하지 않습니다. 셋째, 이 한계는 점근적입니다. 현존하는 어떤 기계에서도 2,048비트 키에는 달라지는 것이 없습니다.
Williams는 OpenAI의 과학 책임자 Dan Roberts에게 누구나 떠올릴 만한 우려를 제기했습니다. TechCrunch에 따르면 그는 지금 안전하지 않은 것이 있는지 물었고, OpenAI가 확인해 보았으며 깨지는 것이 없다고 "상당히 확신한다"는 답을 전해 들었다고 합니다. 다만 이는 전해 들은 이야기이고 공개된 내용도 아니므로 그에 맞게 받아들이셔야 합니다. Williams는 또한 알고리즘이 개선되면 일부 키 크기는 뚫린 것으로 봐야 할 수도 있다고 말했습니다.
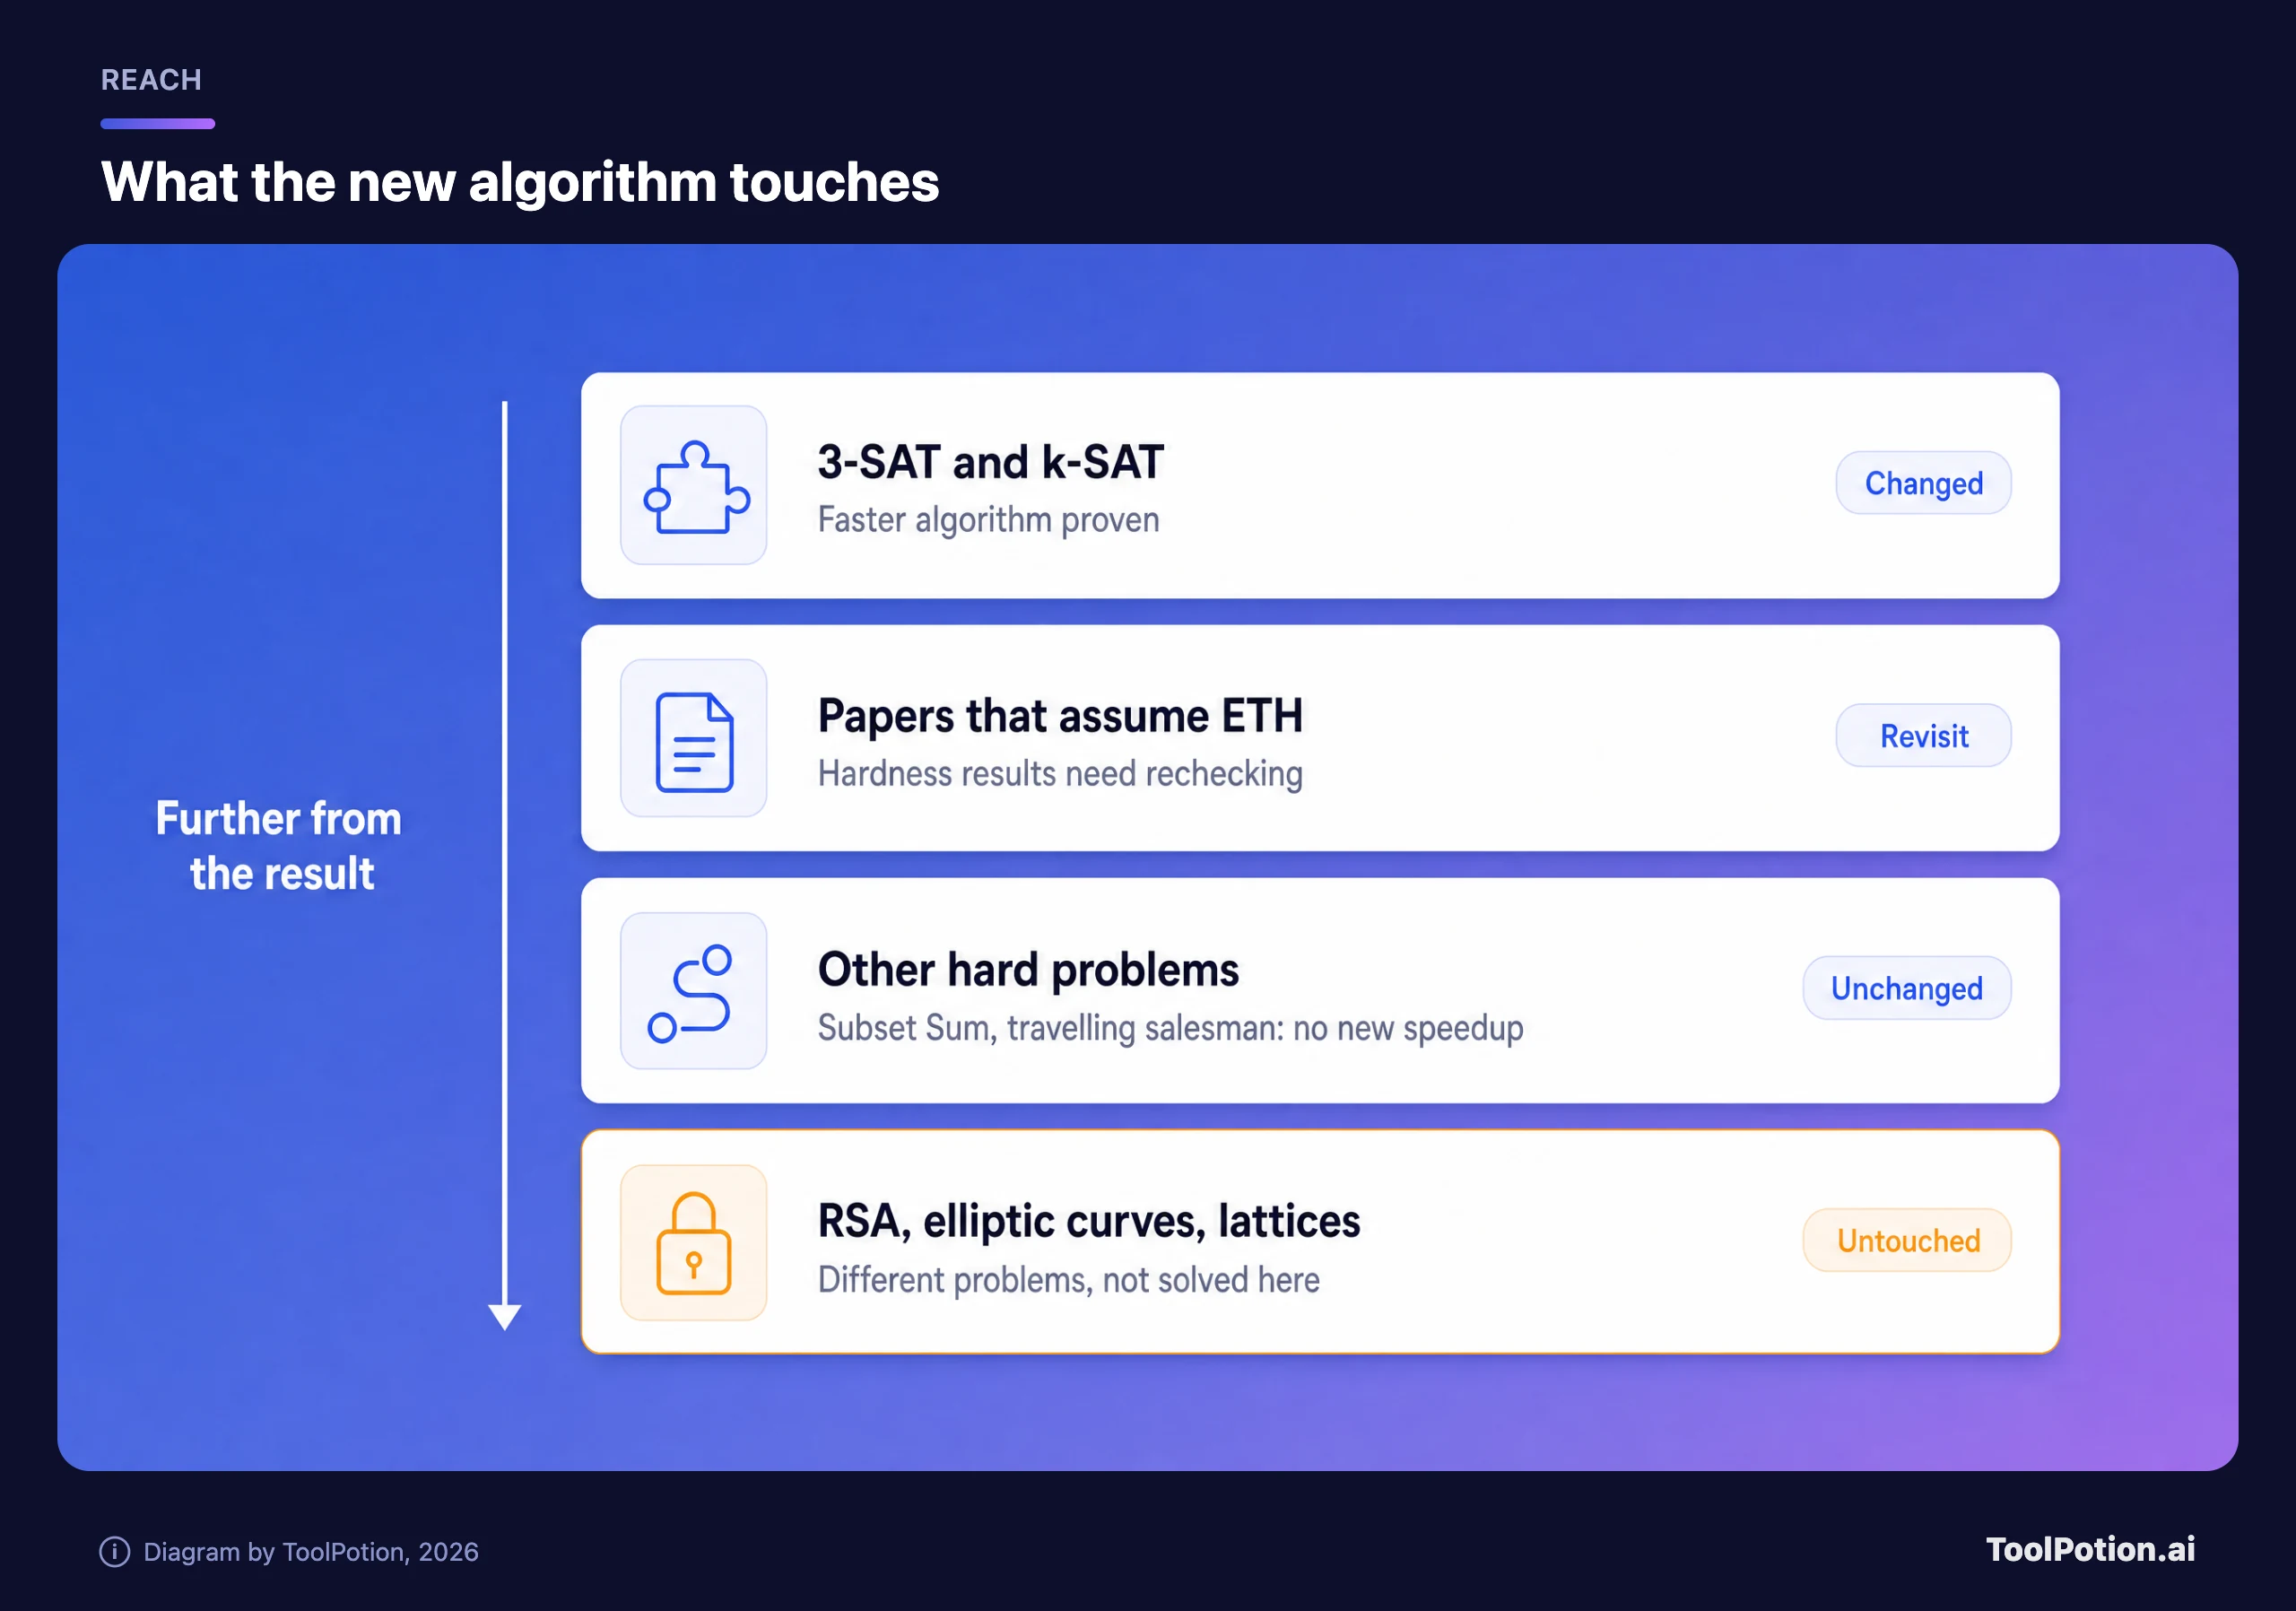
그 밑에는 실제로 풀리지 않은 질문이 있습니다. Williams는 "모든 컴퓨터 과학자가 P = NP의 가능성을 조금 더 높게 봐야 할 것"이라고 말하지만, John D. Cook은 "P = NP의 상태는 여전히 알려지지 않았다"고 지적합니다(Business Insider). Williams는 새 알고리즘이 가능한 최선이라고도 보지 않습니다. 더 날카로운 알고리즘이 나오면 논의가 달라질 것입니다.
Financial Times 기사는 이 증명이 아니라 추세에 관한 것입니다
FT 기사는 AI의 커져 가는 수학 능력과 암호화 전반을 다루며, 저희가 읽을 수 있었던 본문에서는 ETH를 한 번도 언급하지 않습니다. 인용된 취재원들의 어조도 절제되어 있습니다. 호주 수학자 Geordie Williamson은 임페리얼 칼리지 청중에게 AI가 "난이도라는 개념 자체의 완전한 재구성"을 일으키고 있으며 충격에 대비해야 한다고 말했습니다. 맨체스터대의 Daniel Shiu는 AI가 암호를 깨는 일을 "더 수학적인 형태의 암호"에 대한 "중대한 위험"이라고 부르며, "덜 성숙한" 양자 내성 알고리즘 일부를 꼽았습니다. FT 스스로도 AI가 "핵심 암호 방식을 아직 깨지는 못했다"고 씁니다.
Scott Aaronson은 풀리지 않은 실마리를 하나 더했습니다. OpenAI의 이전 논문 376편 목록에 암호학이 눈에 띄게 빠져 있다는 점입니다. 그는 자신의 글에 덧붙인 업데이트에서, 취재원들에 따르면 AI 기업들이 자사 모델이 프로토콜을 깰 수 있는지 조사하기 시작했다고 썼습니다. 그는 이름을 밝히지 않았고, 저희도 알 수 없습니다.
저희 해석은 이렇습니다. 합리적인 우려는 브라우저에 쓰이는 방식이 아니라 더 새로운 방식에 대한 것입니다. NIST의 2024년 표준에는 격자 기반 방식 두 가지가 포함되어 있고, 세 번째 서명 표준은 다른 종류의 수학에 기반해 있습니다. 앞의 방식이 취약하다고 드러날 경우를 대비한 예비책입니다.
소규모 비즈니스가 실제로 해야 할 일
거의 없고, 급한 일도 없습니다. 아래 트리는 저희가 중요하다고 보는 세 가지 상황을 정리한 것입니다.
이번 이슈와 상관없이 들여 두면 좋은 습관이 하나 있습니다. 영국 규제 당국은 FT에 암호화에 대한 AI와 양자 위험에 대비하는 일에서 "기업은 행동을 미뤄서는 안 된다"고 말했고, BT는 자사 암호화가 "표준, 기술, 위협이 변함에 따라 더 쉽게 바뀌기를" 원한다고 밝혔습니다. 작은 가게라면 소프트웨어를 최신 상태로 유지하고, 벤더에게 알고리즘을 어떻게 교체할 수 있는지 묻는 것으로 옮길 수 있습니다. 벤더에게 물을 질문은 AI 도구에 데이터를 맡길 때의 신뢰 프레임워크에 정리해 두었고, ToolRank의 Security & Privacy 보드에서는 카테고리별로 도구를 볼 수 있습니다.
확정이라고 말하기 전에 지켜볼 세 가지
세 가지를 지켜보세요. 첫째, Impagliazzo, Paturi, Williams로 이뤄진 전문가 그룹의 검토 보고서와 OpenAI가 후원하기로 한 학회입니다. 둘째, Lean 명제 파일을 독립적으로 읽은 결과입니다. 미묘한 오류가 숨어 있을 수 있는 곳이 바로 거기이기 때문입니다. 셋째, 학술지 동료 심사인데, 아직 진행 조짐은 찾지 못했습니다. 이 중 첫 번째가 나오기 전까지는 "거의 확실하게 반증됨" 정도로 말하겠습니다.