

"업무가 현재의 AI 도구로 이득을 보지 못한다면, 그것은 결함이 아니라 하나의 발견입니다." Amazon이 소프트웨어 엔지니어들에게 보낸 메모의 한 구절로, CNBC가 보도했습니다. AI를 다른 기업에 파는 회사에서 나온 문장치고는 이례적이고, "Amazon, 엔지니어에게 AI를 덜 쓰라고 지시"라는 헤드라인으로 줄이기도 쉽습니다.
하지만 메모는 그 헤드라인보다 훨씬 신중하고, 메모를 둘러싼 논쟁이 메모 자체보다 더 중요합니다. 토큰은 이제 엔지니어링 예산의 한 항목이 되었고, 어느 회사의 관리자든 Amazon이 방금 공개적으로 답한 질문을 받고 있습니다. 그 지출이 실제로 무언가를 사 오고 있다는 걸 어떻게 아느냐는 질문입니다. 이 글에서는 메모가 말하는 것과 말하지 않는 것, 주요 도구 네 가지에서 시트 하나의 실제 비용, 그리고 상한이 도움이 되는 곳과 해가 되는 곳을 다룹니다.
토큰맥싱은 리더보드의 문제입니다
CNBC는 토큰맥싱을 개발자가 "결과물은 거의 신경 쓰지 않고 AI를 최대한 많이 쓰는 것"으로 정의합니다. 이 단어는 Amazon 안에서 나름의 전사(前史)가 있습니다. CNBC에 따르면 Amazon은 직원들이 순위를 올리려고 토큰맥싱을 하고 있다는 사실을 알게 된 뒤 올해 초 사내 리더보드를 닫았습니다. Financial Times 보도를 토대로 한 I-Programmer의 기사에 따르면 이 보드의 이름은 Kirorank였고, 몇 주밖에 운영되지 않았으며 공식 승인을 받은 적도 없습니다. 사람들은 AI 에이전트가 돌릴 하찮은 작업을 만들어 냈고, 그 토큰 비용은 Amazon이 냈습니다.
Amazon만의 일은 아니었습니다. 같은 보도에 따르면 Meta도 올해 초 직원들이 만든 보드를 닫았는데, 직원들이 Claude Code에서 태운 토큰 수로 순위를 매겨 Token Legend 같은 칭호를 두고 경쟁하던 곳입니다. 또 Amazon 수석 부사장 Dave Treadwell이 직원들에게 "AI를 쓰기 위해서 쓰는 일"을 멈추라고 요청한, 앞서 유출된 메시지도 함께 언급됩니다.
이런 일이 벌어지는 데 누가 부정직할 필요는 없었습니다. 화면에 숫자를 띄우고 그 숫자로 사람들의 순위를 매기면, 숫자는 올라갑니다.
메모가 말하는 것, 말하지 않는 것
CNBC에 따르면 이 메모는 Amazon이 웹사이트에 게시하기 전에 사내에서 먼저 돌았습니다. 소프트웨어 개발 엔지니어와 그 관리자의 역할을 Amazon이 설명하는 방식을 고친 내용입니다. 핵심은 측정에 관한 것입니다. 토큰 사용량, AI 도구 도입률, 코드 변경이나 리뷰 건수는 모두 팀의 AI 활용을 판단하는 데 "심각한 결함이 있는" 방식으로 남아 있다고 메모는 말합니다. 비용 상승과 과도한 복잡성을 부를 수 있기 때문입니다.
그렇다고 이 수치들을 금지하지는 않습니다. 다른 데이터와 함께 "신중하게, 판단력을 갖고" 읽어야 한다는 것이고, 메모가 선호하는 잣대는 분명하게 적혀 있습니다. "장기적인 성과로 측정하고, 또 그것으로 측정받는 것이 최선이라고 믿습니다."
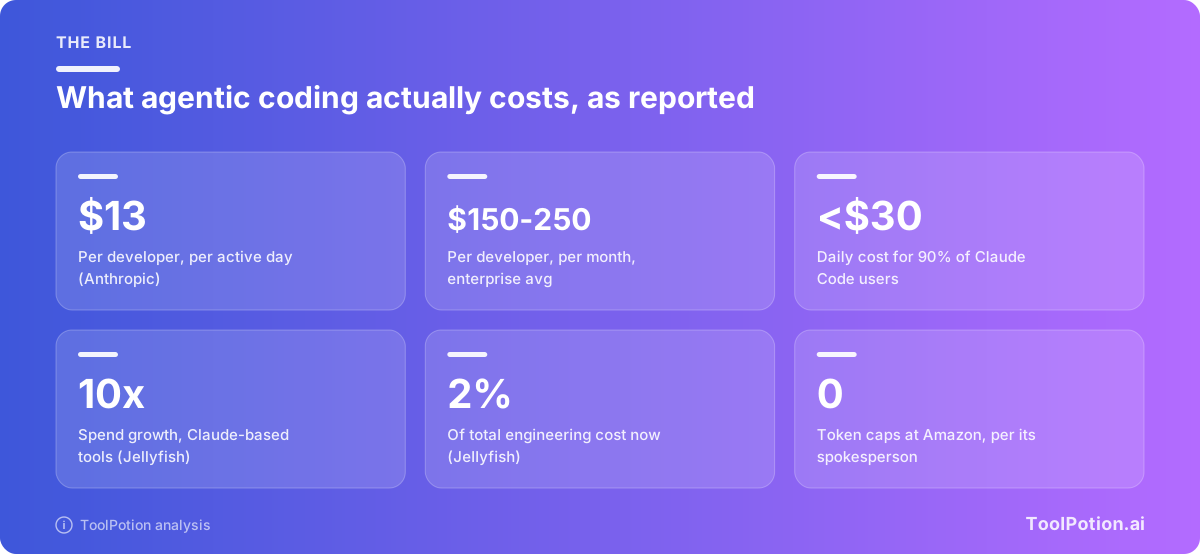
Amazon 대변인은 CNBC에 회사가 토큰 사용량에 상한을 도입하지 않았다고 밝혔습니다. 이 점이 중요한 이유는 "AI를 덜 쓰라"는 표현이 보도된 내용보다 과장이기 때문입니다. 우리가 읽은 보도 어디에도 할당량, 엔지니어당 예산, 금액이 나오지 않습니다. Amazon은 얼마를 쓰는지 밝히지 않았고, 어떤 보도도 그 액수를 알려 주지 못했습니다.
AWS의 부사장이자 distinguished engineer인 Marc Brooker는 CNBC에 두 부분으로 논리를 설명했습니다. 회사는 기능 개발 속도(출시 건수, 프로덕션에서 성공한 변경 건수) 같은 것을 보고, 그 지출을 투자로 본다는 것입니다. 반대로 원하지 않는 것은 중요하지 않은 문제에 쓰는 "낭비되는 노력"이라고 했습니다. 다만 어떤 문제가 그런지 알기 어려울 때도 있어서 실험하려는 의욕은 어느 정도 남겨 둔다고 인정했습니다.
이렇게 읽으면 이 메모는 비용 절감 정책보다 성과 평가 정책에 가깝습니다. 우리가 밑줄을 긋고 싶은 건 맨 위에 인용한 문장입니다. AI가 아직 도움이 되지 않는 곳을 설명할 수 있는 엔지니어는 메모의 표현대로 "우리가 요구하는 판단력을 보여 주고 있는" 것입니다. 도구를 꺼 뒀다고 사람을 벌하지 말라고 회사가 관리자들에게 말하는 셈입니다.
AI를 파는 회사가 왜 고삐를 쥘까요
가장 쉬운 답은 비용이고, 그 수치는 예산보다 빠르게 늘고 있습니다. 엔지니어링 팀용 도구를 만드는 Jellyfish가 에이전틱 코딩 도구에 관한 보고서를 냈고, TechCrunch가 이를 다뤘습니다. Jellyfish 고객사에서 Claude Code 등 Anthropic 모델 기반 도구에 쓰는 비용은 연초 이후 10배 늘었고, 지금은 전체 엔지니어링 비용의 약 2%에 해당합니다. 2%는 작은 숫자지만, Jellyfish의 최고 과학자 Nicholas Arcolano는 TechCrunch에 "그 10배 성장은 대부분의 CFO가 계획에 넣지 않았던 성장"이라고 말했습니다.
Anthropic 자체 문서는 개인 단위 비용의 기준선을 제시합니다. 엔터프라이즈 도입 사례 전체에서 Claude Code의 평균 비용은 개발자 1인당 활성 일 기준 약 $13, 월 $150~$250이며, 사용자의 90%는 하루 $30 아래에 머뭅니다(Claude Code 문서). 벤더 자사 고객의 평균이므로, 실제 수치는 여러분의 파일럿으로 확인하셔야 합니다.
나머지 두 가지 이유는 우리의 추론이며, 보도에는 나오지 않습니다. 코드 변경과 리뷰 건수를 기준으로 삼은 지표는 아무도 요청하지 않은 산출물에 리뷰어를 파묻히게 할 수 있습니다. 그리고 사용량 숫자를 쫓는 엔지니어는 그 작업에 애초에 모델이 필요했는지 따져 볼 이유가 거의 없습니다. 메모 보도에도, 그 주변 보도에도 보안이 원인이라는 언급은 없으므로 그랬던 것처럼 말하지는 않겠습니다.
Microsoft의 희망퇴직, 그리고 계량기를 파는 벤더
Amazon의 메모는 기업들이 AI와 장부를 맞춰 가는 다른 소식들과 같은 주에 나왔지만, 이들은 같은 이야기가 아닙니다. Microsoft는 값비싼 AI 인프라 구축과 자본 효율 사이에서 균형을 잡는 가운데, 전체 직원의 약 27%인 약 6만 명의 대상자에게 희망퇴직을 제안했습니다. CNBC는 이를 누군가의 토큰 사용이 아니라 인프라와 현금흐름에 연결합니다. 같은 기사에는 Microsoft가 고객이 AI를 실제로 쓰는 만큼 요금을 부과하려 한다는 내용도 있는데, 이는 계량기를 반대로 돌려 놓은 셈입니다.
그리고 여러분이 더 많이 쓸수록 가장 이득을 보는 회사도 있습니다. Anthropic은 리포팅 도구를 출시했습니다. 관리자가 특정 기간 동안 팀이 무엇을 만들었는지, 비용은 얼마였는지, 워크플로가 어디서 막혔는지 볼 수 있고, 팀이 토큰 지출을 관리할 수 있도록 그룹 예산을 공유하는 기능도 있습니다. TechCrunch는 이를 투자 대비 효과를 입증하려는 분명한 시도라고 평합니다. 동기를 어떻게 보든, 이 제품은 구매자들이 이제 무엇을 요구하는지를 보여 줍니다. 시트당 비용이 아니라 성과당 비용입니다.
시트 하나의 실제 비용부터 확인하세요
파일럿 그룹과 기준선부터 잡으세요. 상한을 정하기 전에 해야 합니다. 벤더들이 모두 종량제로 옮겨 가면서 시트의 표시 가격이 알려 주는 정보는 해마다 줄고 있습니다. 주요 도구가 각각 무엇을 계량하는지 벤더 공식 페이지 기준으로 정리했습니다.
| 도구 | 계량 대상 | 상한 설정 위치 |
|---|---|---|
| GitHub Copilot | 토큰을 AI 크레딧($0.01 단위)으로 환산. Business는 사용자당 월 1,900크레딧, Enterprise는 3,900크레딧을 공유 | 사용자·코스트센터·조직 단위의 달러 예산 |
| Cursor (Teams) | 유료 시트당 주간 풀(Cursor 자체 모델용). 서드파티 모델은 공유 선불 잔액에서 차감 | 팀 월 한도, 기본 한도 및 멤버별 한도 |
| Claude Code | API 토큰. Teams와 Enterprise는 시트 허용량에서 차감 | 관리자 설정의 지출 한도 또는 Console 워크스페이스 한도 |
| Codex (ChatGPT) | ChatGPT Work와 허용량을 공유한 뒤 크레딧 | 구매한 크레딧, 그리고 소진 속도를 보는 사용량 대시보드 |
가격 페이지에는 나오지 않지만 문서에서 찾은 세부 사항이 몇 가지 있습니다. Copilot의 유료 사용 정책은 Business와 Enterprise에서 기본값이 켜져 있어서, 관리자가 명시적으로 끄지 않는 한 공유 크레딧을 넘는 지출이 계속됩니다(GitHub 문서). 인라인 자동완성은 예산이 $0이어도 계속 무제한입니다. Copilot 코드 리뷰는 노력 수준에 따라 가격이 매겨집니다. GitHub는 Lite가 $0.05~$1, Max가 $1.50~$25로 평균 약 $10이며 여기에 Actions 분(minutes)이 추가된다고 추산합니다(GitHub 모델 및 가격). 어디까지나 추정치이고, 문서에도 풀 리퀘스트의 크기에 따라 달라진다고 되어 있습니다.
에디터 자체를 비교하고 싶다면 Cursor vs GitHub Copilot vs Windsurf를 참고하세요. Cursor의 Teams 플랜은 Premium, Super, Ultra 시트를 월 $30, $100, $200에 판매하며, 각 시트는 Cursor 자체 모델용 주간 풀이 따로 있고 팀원 간에 옮길 수 없습니다. Claude를 포함한 서드파티 모델은 이 풀에 들어가지 않고, API 정가에 100만 토큰당 $0.25의 Cursor 요율을 더해 공유 선불 잔액에서 차감됩니다(Cursor 문서). Claude의 Enterprise 플랜은 시트당 월 $20에 API 요율로 청구되는 사용량이 더해집니다(Claude 가격). Codex 가격 페이지는 API 토큰 가격은 구독 사용량과 별개이며 포함된 작업량을 추정하는 데 쓰면 안 된다고 분명히 밝힙니다.
반복 업무는 더 저렴한 모델로 보내세요
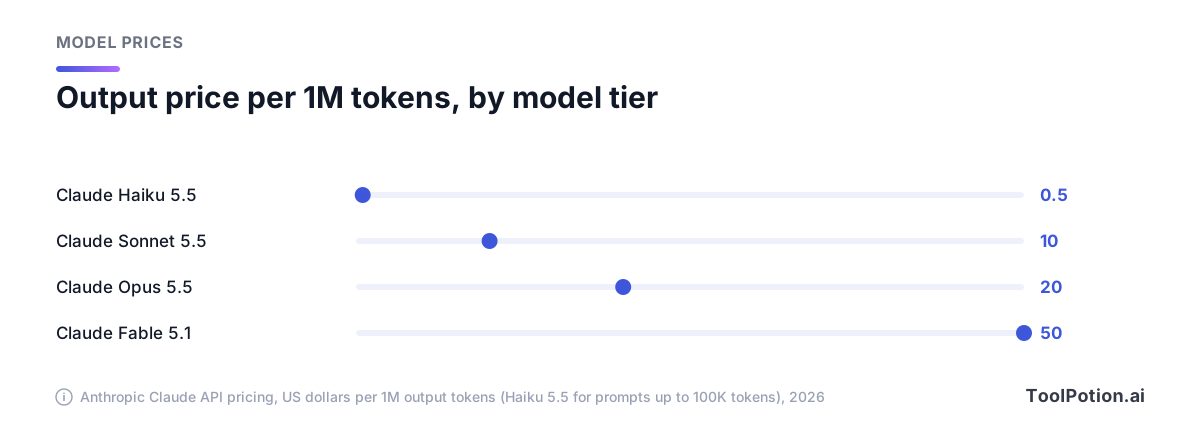
문서에서 가장 큰 레버는 상한이 아니라 모델입니다. Anthropic의 API 가격표를 보면 프롬프트 10만 토큰 이하 기준으로 출력 토큰 100만 개당 Claude Haiku 5.5는 $0.50(그 이상은 $2.50), Sonnet 5.5는 $10, Opus 5.5는 $20, Fable 5.1은 $50입니다. 한 라인업 안에서 가장 싼 모델과 가장 비싼 모델의 격차가 100배이고, GitHub와 Cursor의 표에도 같은 출력 가격이 올라 있습니다.
Anthropic 자체의 비용 가이드도 같은 계산에 동의합니다. Sonnet은 "대부분의 코딩 작업을 잘 처리하면서 Opus보다 비용이 적게 들고", Opus는 아키텍처 결정이나 다단계 추론용으로 남겨 두며, 단순한 서브에이전트 작업에는 model: haiku를 쓰라고 합니다(Claude Code 문서). 작업에 맞는 티어를 고르는 문제는 which AI model tier for which task에서 더 길게 다뤘고, 터미널 에이전트 비교는 Claude Code vs Codex vs Gemini CLI에 있습니다.
아래는 정가 기준 절감액이며, 작은 모델이 맡을 수 있는 작업 비중은 직접 추정해서 넣으시면 됩니다. 가격은 짧은 프롬프트 기준 Anthropic 정가입니다.
출력 토큰은 청구서의 일부일 뿐이고, 작은 모델의 비중은 여러분의 실제 작업으로 검증해야 하는 가정입니다. 변수 이름 바꾸기나 테스트 뼈대 작성은 아마 해당될 겁니다. 결제 서비스 마이그레이션 계획은 아마 아닐 겁니다.
상한은 이 순서로 정하겠습니다
- 파일럿 그룹에 사용량 리포팅을 켜고, 어떤 숫자를 정하기 전에 2주 치를 읽어 보세요.
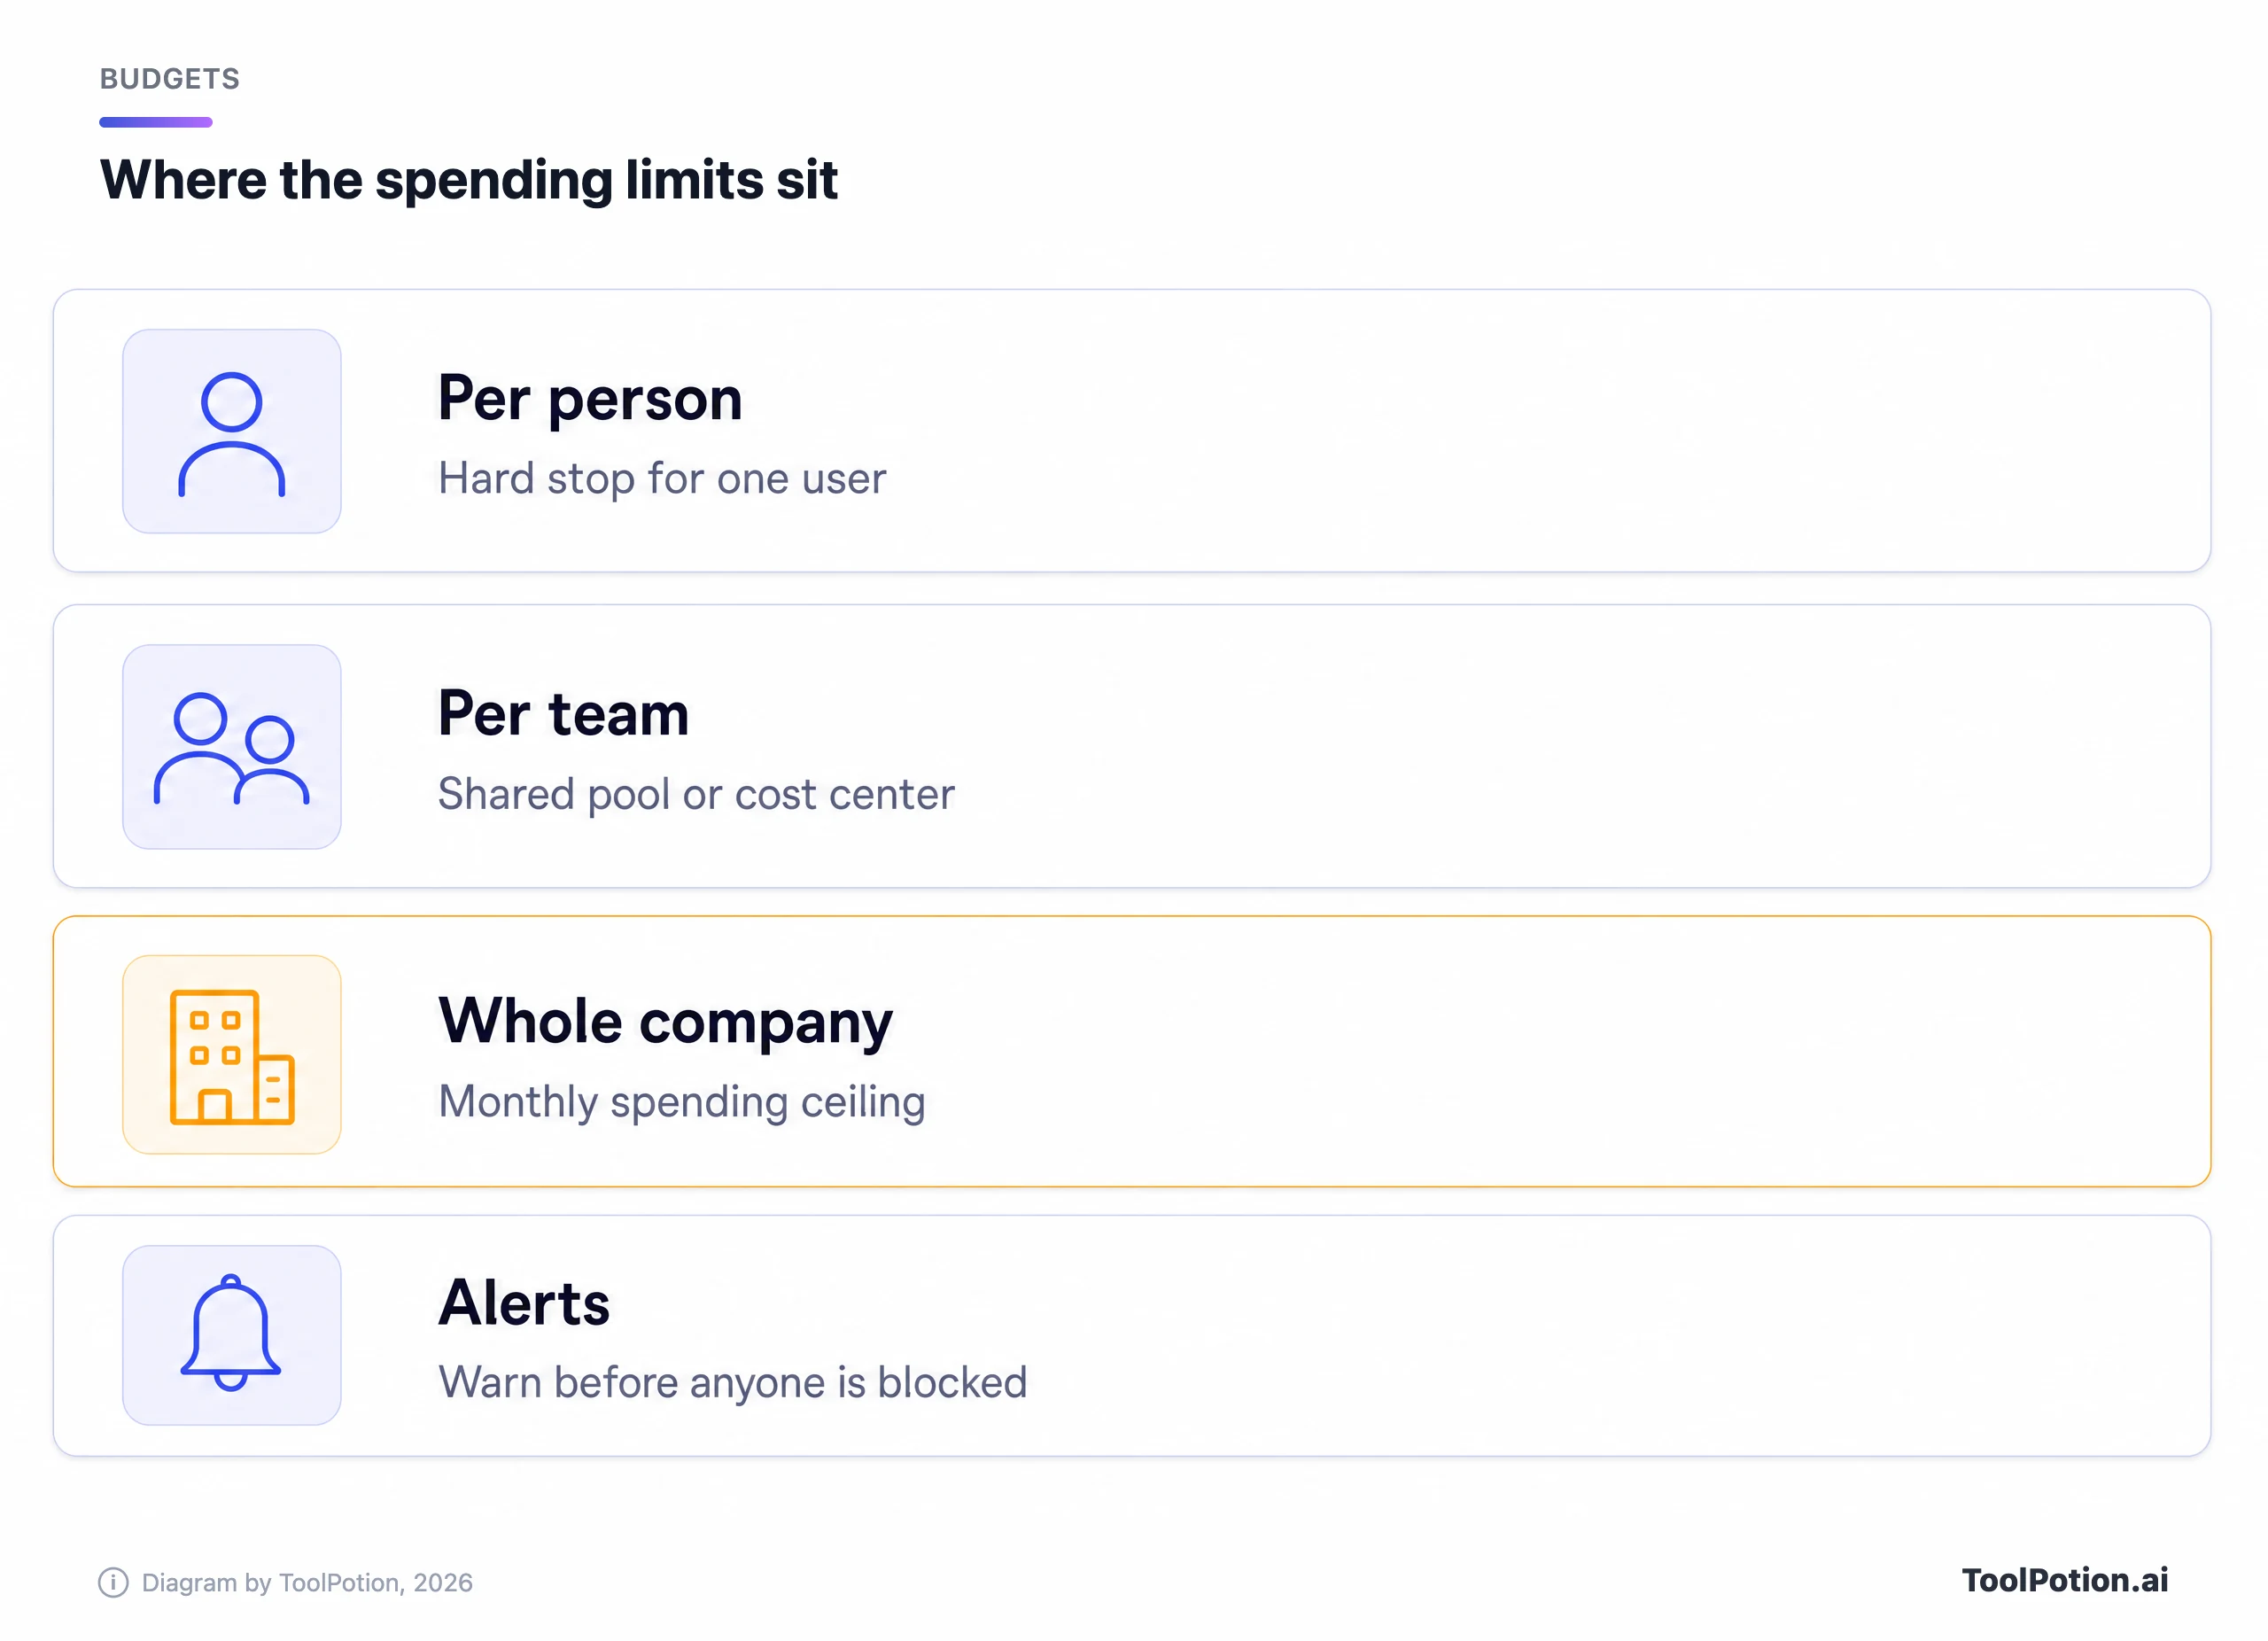
- 알림부터 설정하세요. GitHub는 예산의 75%, 90%, 100%에서 이메일과 배너를 띄울 수 있습니다(GitHub 문서).
- 모든 시트가 한도까지 쓰이더라도 감당할 수 있는 전사 월 상한을 추가해서, 에이전트가 루프에 빠져 폭주해도 비용이 정해진 범위에 머물게 하세요.
- 그다음에야 팀이나 개인 한도를 추가하고, 도구가 허용하는 곳에서는 소프트 한도로 두세요. GitHub의 사용자 단위 예산은 항상 하드 스톱이며, 문서도 예산이 겹치면 사람들이 의존하는 도구를 쓰지 못하게 될 수 있다고 경고합니다.
- 반복 업무의 기본 모델은 한 티어 낮추고, 프리미엄 모델은 의도적으로 선택하는 것으로 만드세요.
Claude Code 문서는 팀 규모별 사용자당 속도 제한의 시작점도 제시합니다. 예를 들어 사용자 100~500명이면 사용자당 분당 15,000~20,000 토큰입니다. 이는 예산이 아니라 스로틀이며, 문서도 조정이 필요한 권장값이라고 말합니다.
절제가 현명할 때, 그리고 잘못된 절약일 때
우리는 낭비를 줄이되 시도를 줄이지는 않겠습니다. 개발자가 저장소 전체를 최상위 모델에 붙여 넣기 전에 한 번 더 생각하게 만드는 상한은 제 역할을 하는 것입니다. 하지만 같은 개발자가 AI가 생성한 테스트 실행을 건너뛰게 하거나, 에이전트가 가장 효과를 내는 어려운 리팩터링에서 에이전트를 피하게 만드는 상한은 절약하는 것보다 더 많은 비용을 치르게 합니다.
계산해 보세요. Jellyfish가 보고한 대로 에이전틱 도구가 엔지니어링 비용의 약 2%라면, 청구서를 절반으로 줄여도 엔지니어링 비용의 1%를 아끼는 셈입니다. 엔지니어 생산성이 1%만 떨어져도 그 절감분은 사라집니다. 절제가 이기는 경우는 아무것도 만들어 내지 못한 지출을 없앨 때뿐이고, 이것이 바로 낭비되는 노력에 대한 Amazon의 요점입니다.
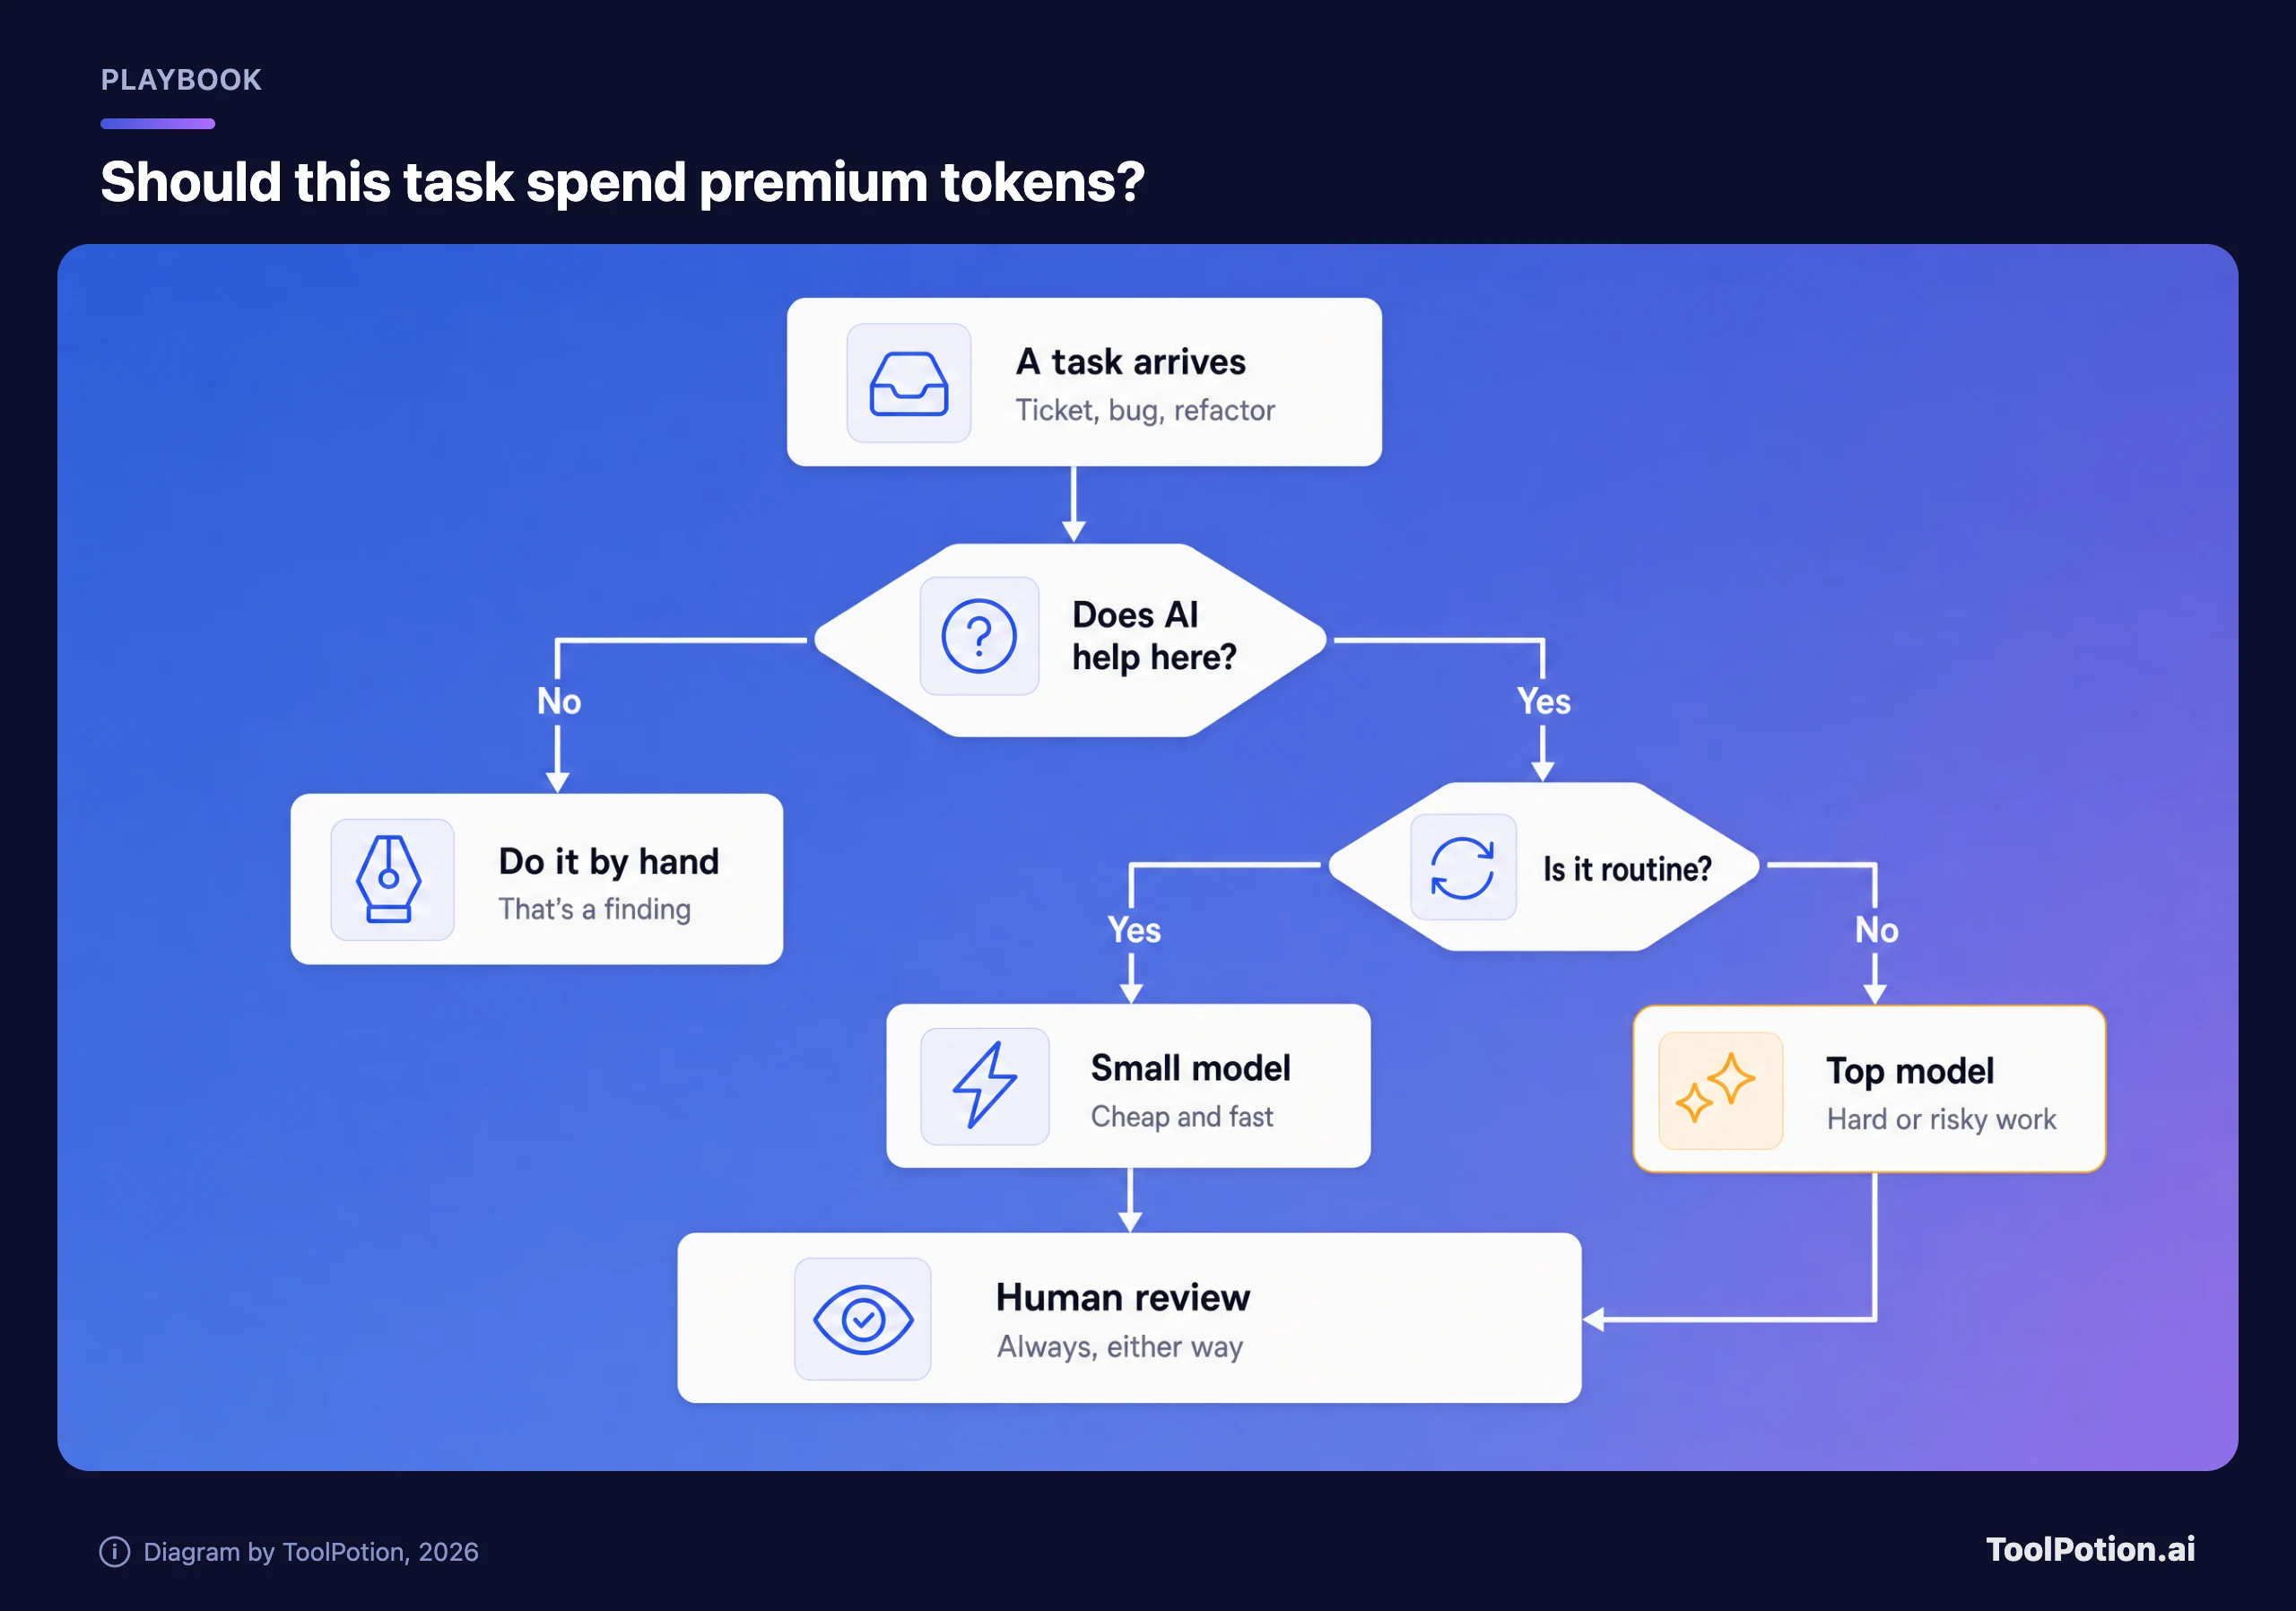
아무도 읽지 않는 백그라운드 자동화, 반복 업무에 쓰는 최상위 모델, 개인별 리더보드는 절제가 현명한 영역입니다. 코드 리뷰, 테스트, 온보딩은 잘못된 절약이 되는 영역입니다. 잘못된 머지를 잡아내는 것이 AI 리뷰 단계라면, 그것을 조이는 것은 자기 안전망을 상대로 내기를 거는 일입니다. 뭔가를 줄이기 전에 AI 코드 리뷰 도구 가이드와 리뷰·테스트 부문 ToolRank 보드에서 대안이 얼마나 많은지 확인해 보세요.
우리가 줄이지 않을 것들
어떤 모델이 코드를 썼든 사람의 리뷰는 유지합니다. Amazon의 메모는 리뷰 건수로 측정하는 것을 경계하지만, 리뷰를 건너뛰라고 하지는 않습니다. 교육도 유지합니다. 저렴한 모델을 언제 써야 하는지 아는 사람은 각 모델의 용도를 배운 사람이기 때문입니다. 실험도 유지합니다. 어떤 문제가 중요한지 미리 알 수 없다는 것이 Brooker 본인의 인정이기 때문입니다.
성과는 메모처럼 추적하세요. 출시 건수, 프로덕션에서 성공한 변경, 요청부터 머지까지의 시간입니다. 원시 토큰 수는 비용 열에 넣을 것이고, 성과 평가에는 절대 가까이 두지 마세요. 팀이 이 도구에 무엇을 넣어도 되고 안 되는지 아직 문서로 정리하지 않으셨다면 AI 사용 정책 템플릿이 출발점이 됩니다. 구독 측면은 가격 모델 해설과 스택 점검에서 다룹니다.
GitHub Copilot, Cursor, Claude Code, Codex의 가격 페이지를 읽고 나면 규칙은 하나로 남습니다. 시트 가격은 입장료일 뿐이라는 것입니다. 쓰고 계신 도구에서 최근 한 달 치 사용자별 사용량을 뽑아 정렬하고, 상위 다섯 줄을 보세요. 그들이 가장 뛰어난 엔지니어들이라면 그대로 두세요. 루프에서 도는 스크립트 하나라면, 상한을 둘 곳을 찾으신 겁니다.