

Anthropicのエンジニアたちは以前、リードエージェントに「半導体不足を調べて」といった短い指示でサブエージェントへ作業を振らせていました。サブエージェントはこれを誤解します。1つは2021年の自動車向けチップ危機を調べ、残り2つは2025年のサプライチェーンで作業を重複させたのです(Anthropic Engineering)。何かが壊れたわけではありません。どのエージェントも、複数の読み方ができるあいまいな依頼に対して、それぞれ筋の通った動きをしただけです。
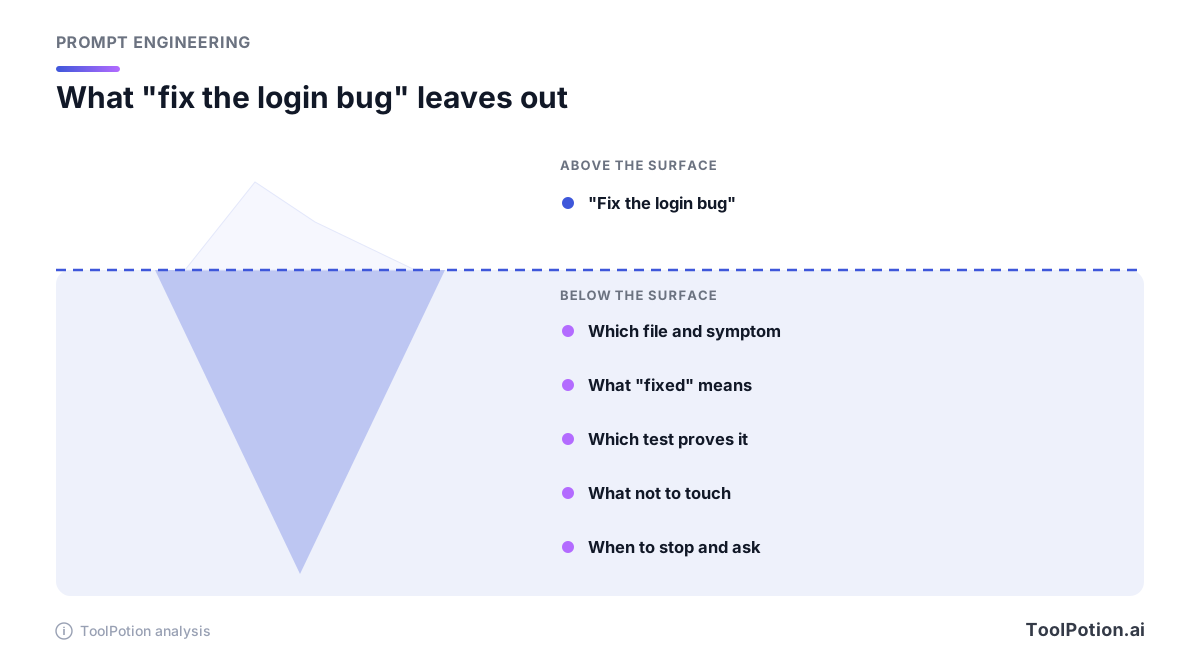
私たちの多くも、ChatGPT、Claude、Gemini CLI、あるいはターミナル型コーディングエージェントに仕事を任せるとき、同じ失敗を繰り返しています。タスクを1行打ち込んで、それを指示書と呼んでしまうのです。この記事では、指示書に必要な6つの要素、そのまま使える書き換え例3つ、テンプレート、そして指示書が失敗するパターンの一覧を紹介します。私たちの主張は一貫しています。完了条件を最初に書くこと。「迷ったら聞いて」をやめて、確認が必要な行動を具体的に列挙すること。大文字だらけの強調は削ること。引用するベンダーのドキュメントはこの主張の一部を裏づけていますが、すべてをカバーしているわけではありません。どこまでが裏づけられていて、どこからがそうでないのかも、その都度書いていきます。
タスクは指示書ではない
タスクは作業の名前を挙げるだけです。指示書は、作業する人が本来なら推測するしかない情報をすべて渡します。Anthropicのプロンプトガイドは、これを新入社員にたとえています。「Claudeは、優秀だがあなたの規範やワークフローについての文脈を持たない新入社員だと考えてください」(Anthropic docs)。OpenAIもモデルの種類で似た線引きをしています。reasoningモデルは目標を渡せば細部を自分で詰められる「シニアの同僚」のようなもので、GPTモデルは「明確な指示によって特定の出力を作らせる」ときに最も力を発揮する「ジュニアの同僚」のようなものだというのです(OpenAI docs)。
OpenAIはreasoningモデルが高レベルの指針でもうまく動くと言っていますが、数十ステップに及び、副作用のある作業になると、そこまで信用するのは控えたいところです。シニアの同僚でも、あなたにとっての「完了」が何を意味するかは知りようがありません。それに、ジュニアが推測を外しても被害はメール1通で済みます。エージェントは、最初の読み違いに基づいて以降のすべてのステップを実行します。Anthropicのリードエージェントがまさにそうでした。
Anthropicは、2分で済むので気に入っているテストを挙げています。「タスクについての文脈をほとんど持たない同僚にプロンプトを見せ、それに従ってもらってください。その人が戸惑うなら、Claudeも戸惑います」(Anthropic docs)。あなたのメッセージだけでは、外部の担当者が5つ質問しないと作業を始められないとしたら、エージェントはその5つの質問に黙って自分で答えてしまい、あなたは結果を見て初めてそれに気づきます。
何よりも先に完了条件を書く
Claude Codeのベストプラクティスのページは、こう言い切っています。「Claudeは、作業が終わったように見えた時点で止まる」。作業が完了したかどうかを示す、実行できる何かがなければ、とページは続けます。「実際には、あなたがテストスイートの役を担うことになり、あらゆるミスはあなたがたまたま気づくまで放置されます」(Claude Code docs)。
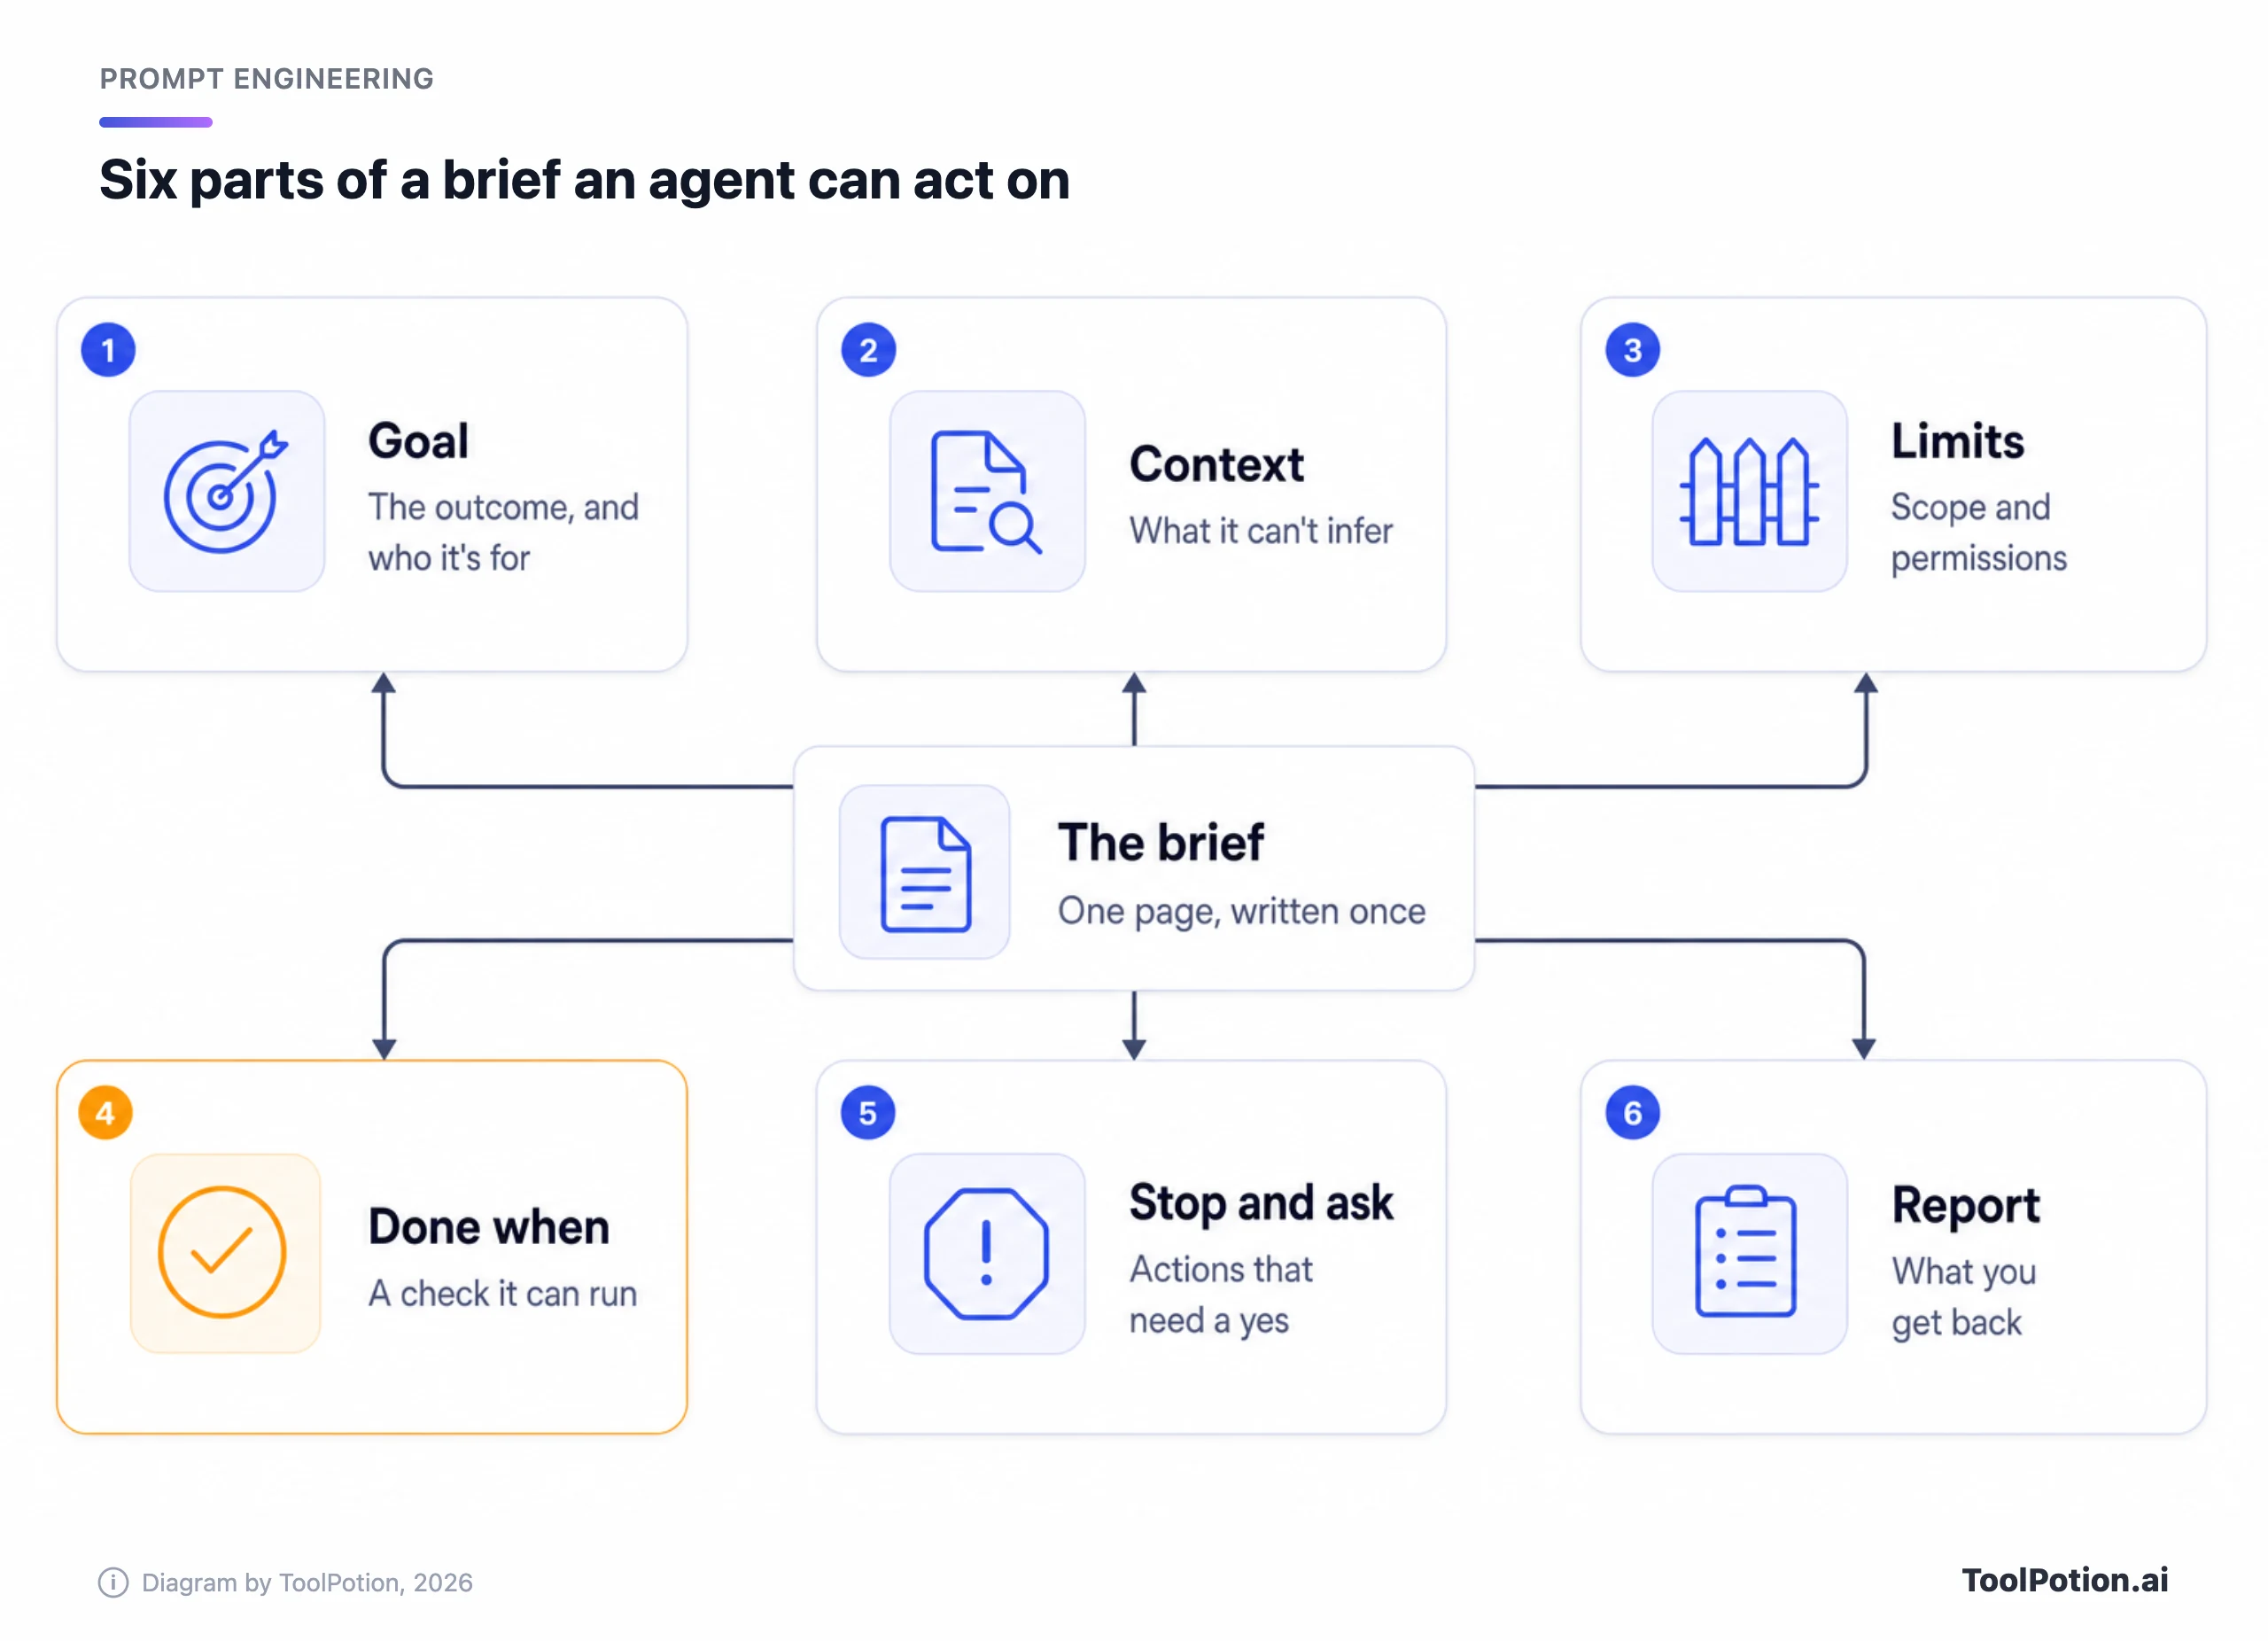
OpenAIのCodexのガイダンスも、反対側から同じ考え方にたどり着いています。プロンプトに入れる4つの要素として、目標、背景、制約、そして「Done when(完了条件)」を挙げています。完了条件は、タスクが終わる前に何が真であるべきかを問う形で書くもので、「テストが通る、挙動が変わる、バグが再現しなくなる、など」と説明されています(OpenAI Codex docs)。2つのベンダー、2つのプロダクトで、骨組みは同じです。私たちはここに独自の2要素(確認ルールとレポート)を足します。完成した指示書の中では4番目に来ますが、書くのは完了条件が最初です。書くことで、自分が何を求めているのかがはっきりするからです。
コード以外でも、チェックの中身を変えれば同じ一文が使えます。「12社分の表で、すべての価格の横に出典リンクを付け、非公開の価格にはフラグを立てる」は、エージェントが数えて確かめられます。「徹底的な比較」は、エージェントには感じ取ることしかできません。
指示書の6つの要素(上から順に)
目的は、成果物とその使い手を示す
1〜2文で書きます。最終的に何が欲しいのか、それが何に使われるのかを伝えてください。2人のパートナーが5分で読む提案、金曜にリリースする修正、購入候補のショートリスト、といった具合です。行き先が変われば、エージェントが何を含め、何を削るかも変わります。「価格を調べて」だと出てくるのは量です。「1席あたり15ドル以下のツールを1つ推薦して」なら、出てくるのは判断です。
背景は、エージェントが自力では見つけられない情報
Claude Codeのドキュメントには、使えるフィルターが載っています。「コードを読めば見つかる情報か。実際に探しに行くか。両方イエスなら、書かなくてよい」(Claude Code docs)。残すべきなのは、リポジトリに反映されなかった会議での決定、エージェントが使うべきアカウント、すでに試してやめたツール、読み手のレベルなどです。
ルールには理由も添えてください。Anthropicのガイドは、指示の背景や動機を伝えると「Claudeがあなたの目標をより多く理解でき、的を絞った回答を出しやすくなる」と述べています。弱い書き方の例として挙げているのは、理由のない「NEVER use ellipses」です(Anthropic docs)。
制約は、対象範囲と立ち入り禁止を示す
エージェントは、頼まれた以上のことをしがちです。Anthropicのガイドによると、Claude Opus 4.5と4.6には「余計なファイルの作成、不要な抽象化、頼まれていない柔軟性の作り込み」に走る傾向があり、サンプルの指示として「頼まれた範囲を超えて、機能追加やリファクタリング、『改善』をしないこと」といった一文を挙げています(Anthropic docs)。ガイドはこの癖をその2モデルに結びつけているので、使っているモデルで確かめてください。どのモデルでも、この一文は借りる価値があります。そのうえで、自分用のリストを足しましょう。触ってよいフォルダ、使ってよい情報源、ログインしてはいけないアカウントなどです。
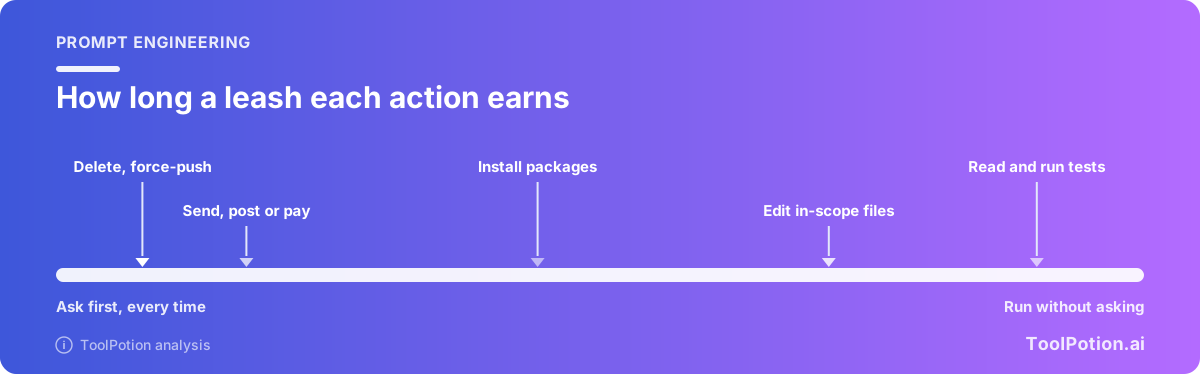
GoogleのGeminiガイドは、リスク評価をエージェント向けプロンプトで制御できる設定の1つに挙げ、リスクの低い探索的な行動(読み取り)と、リスクの高い状態変更(書き込み)を明示的に区別できると述べています(Google AI docs)。役に立つのはこの区別です。読み取りやテスト実行に許可証は要りません。削除、送信、支払いには要ります。
これらに頼る前に、注意点があります。指示書に書いた言葉は、あくまでお願いです。サンドボックス、読み取り専用トークン、権限ルールは強制力のあるものであり、両者は代わりになりません。強制の側についてはAIエージェントの封じ込めのガイドで扱っています。この記事では、あくまで書く内容に絞ります。
完了条件は、実行できるチェックにする
コマンド、件数、ファイルを名指ししてください。「テストが通る」は出発点にすぎません。「pnpm testが通り、1分間に101回目のリクエストが429を返すことを示す新しいテストがある」ならチェックになります。リサーチなら、何件、どの項目か、見つからない項目には何を書くかを指定します。チェックが失敗しうるなら、次に何をするかを伝え、回数に上限を設けてください。Googleのガイドは「高い粘り強さは成功率を上げるが、トークンコストの増加やループのリスクもある」と述べています。ですから「失敗するテストは2回まで再試行し、それでもだめなら止めて報告する」と書くほうが、何も書かないよりずっとよい指示です(Google AI docs)。
確認ルールは、気分ではなく行動のリスト
「迷ったら聞いて」では、エージェントに判断を委ねることになります。そして、やる気のあるエージェントが迷うことはめったにありません。代わりに行動を列挙してください。Anthropicのガイドには、まさにこの目的のサンプルプロンプトがあります(Claude Opus 4.6向けに書かれています)。「元に戻すのが難しい、共有システムに影響する、または破壊的になりうる」行動は、「実行前にユーザーに確認する」というもので、例としてファイルやブランチの削除、git push --force、メッセージの送信が挙げられています(Anthropic docs)。どのモデルを使うにしても、このリストの部分は真似する価値があります。
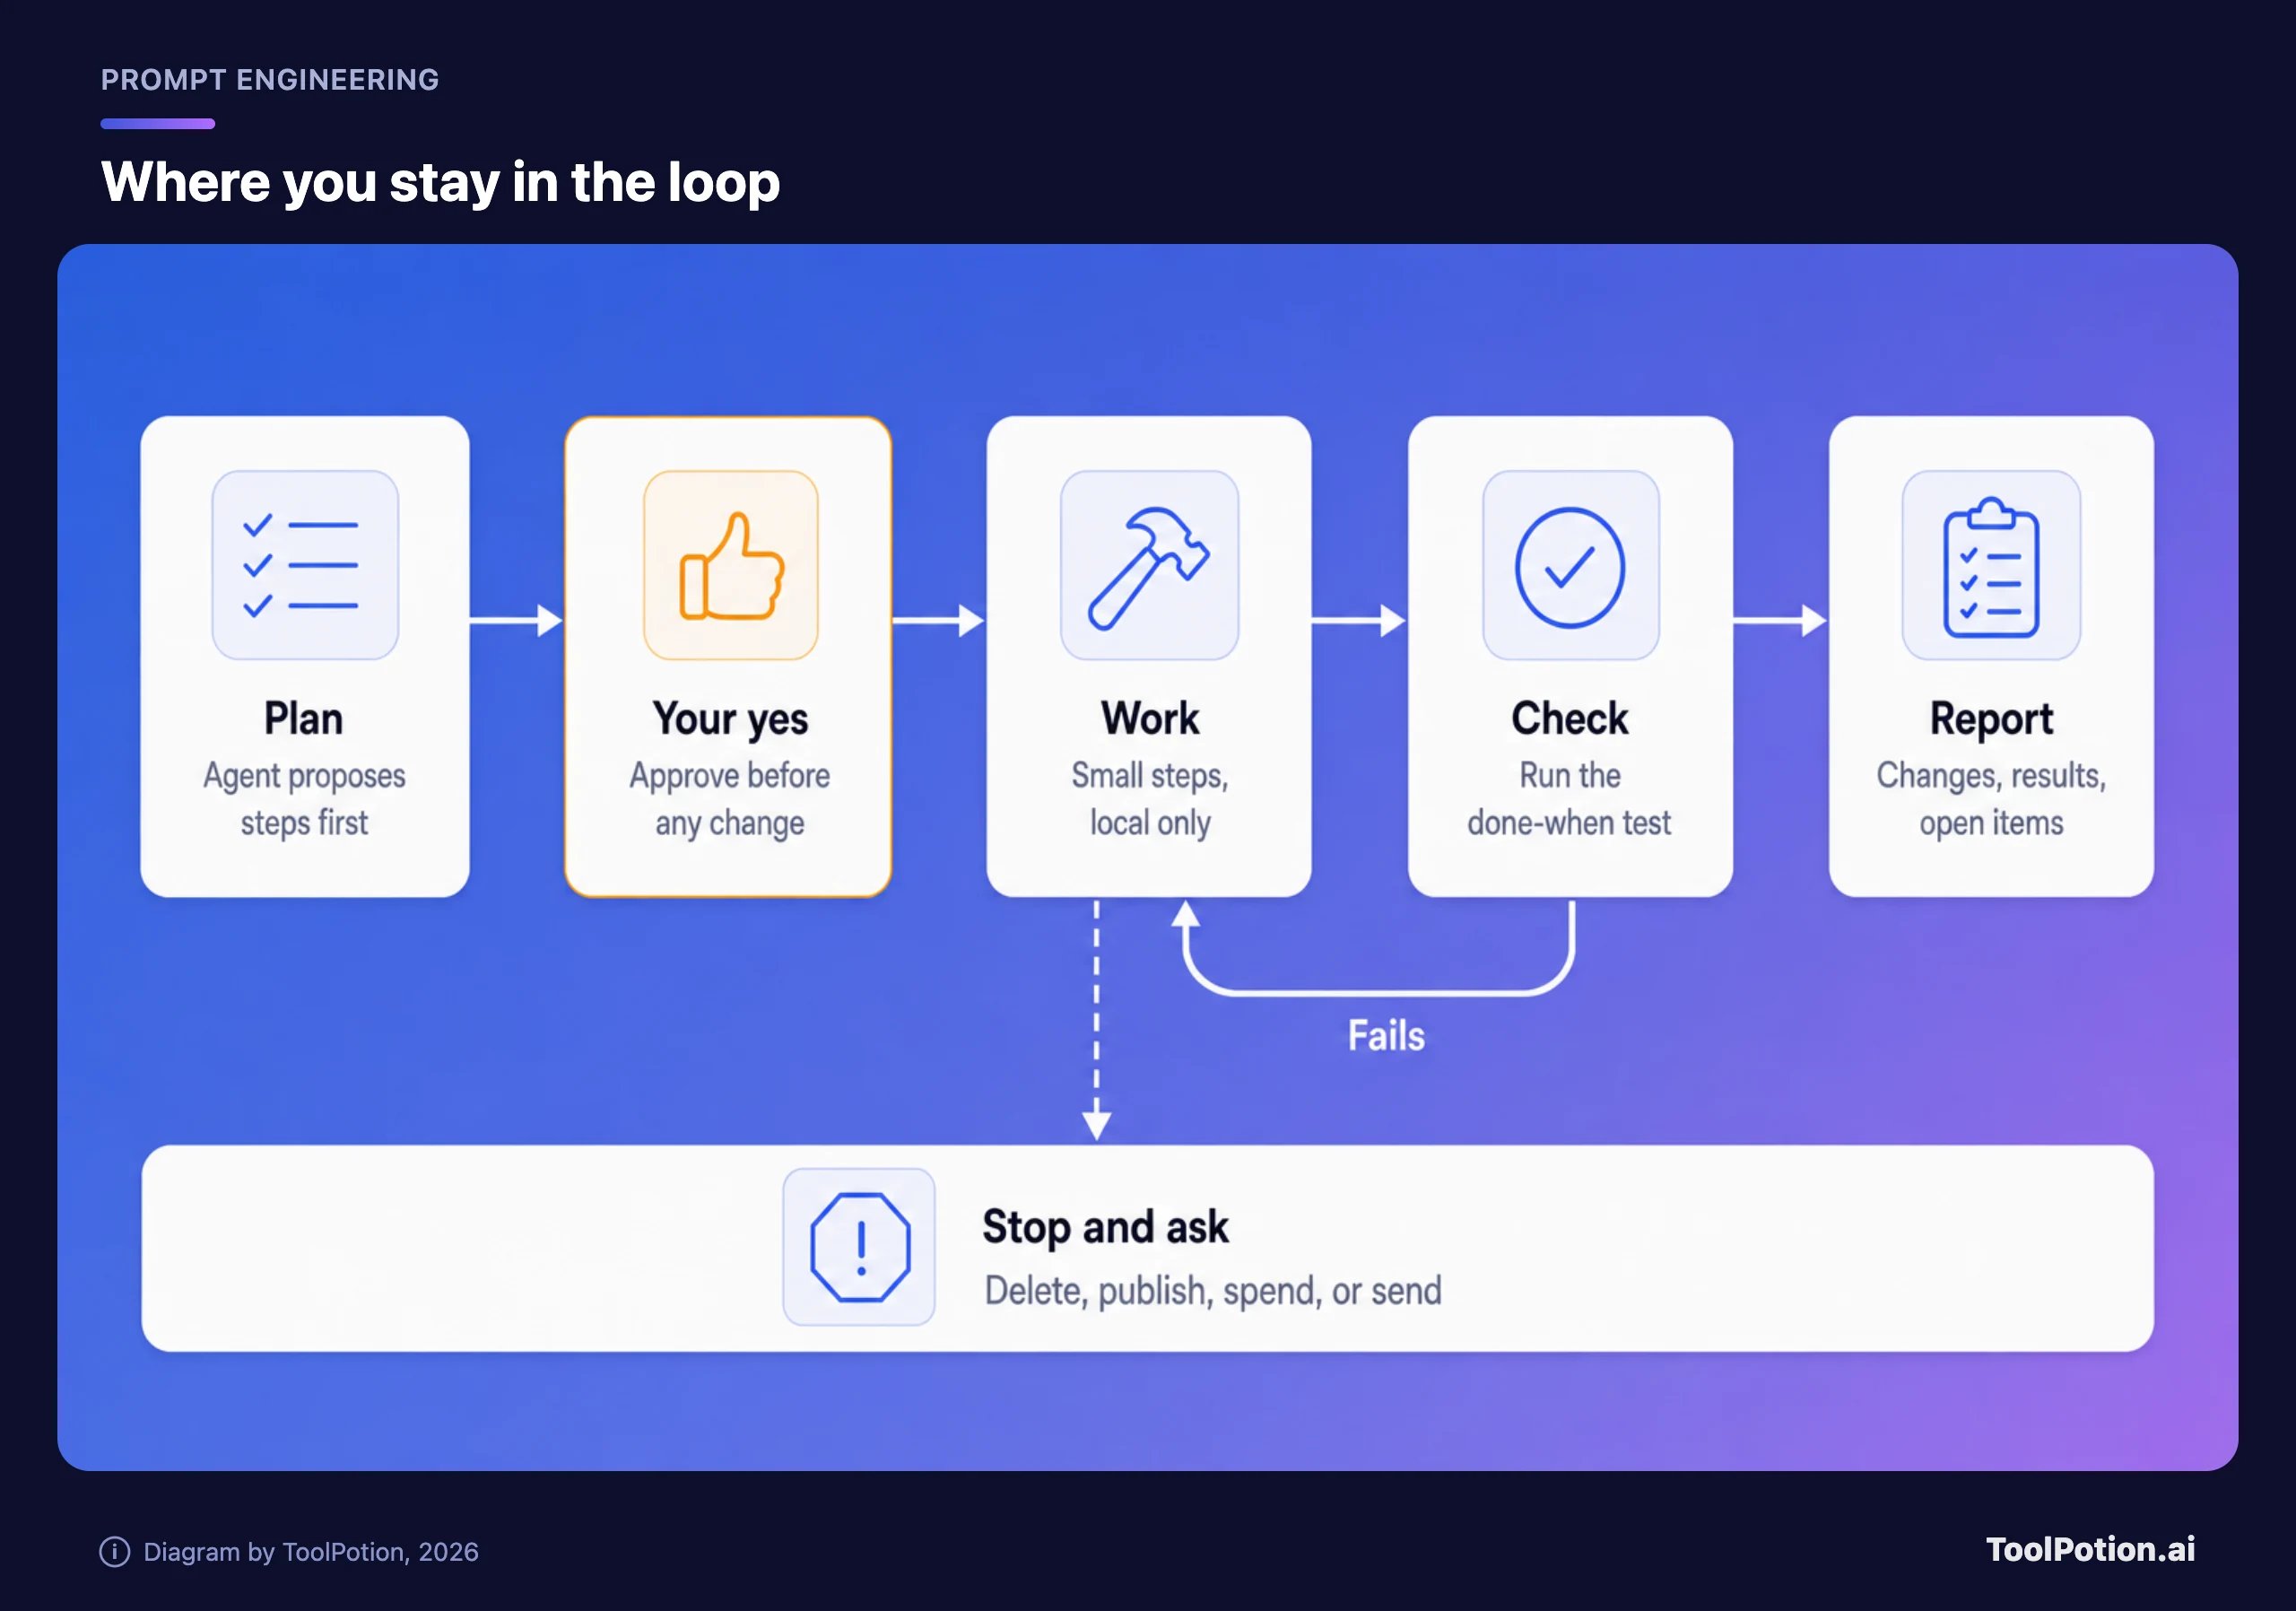
Anthropicのエージェント設計に関するエッセイは、このパターンをこう説明しています。エージェントは「チェックポイントや障害に遭遇したときに、人間のフィードバックを求めて一時停止できる」(Anthropic Engineering)。最初のチェックポイントは計画にしましょう。変更を加える前にステップを出してもらい、読んでから「進めて」と伝えます。往復は1回増えるだけで、私たちはこれが最も安いチェックポイントだと考えています。
レポートでは、何を返してほしいかを伝える
行った変更、実行したチェックとその結果、エージェントが置いた前提、あえてやらなかったこと、を求めてください。最後の項目は忘れられがちです。ここで、スキーマには触るなと言われたのでマイグレーションは見送った、といったことをエージェントが伝えてくれます。
Before/Afterで見る指示書3例
以下の書き換えは、どれも120〜150語ほどです。普通のプロンプトより長く、みなさんが恐れるほどは長くありません。3つの指示書はいずれも私たちが作った例です。タスク、ツール、数字は説明用に作ったもので、ベンダーや実在のプロジェクトのものではありません。
リサーチエージェント(架空の例)
Before:
Find the best project management tool for a ten-person design agency.After:
Goal: Recommend one project-management tool for a ten-person design agency that bills by the hour. Two partners will read the result in five minutes.
Context: We use Google Workspace and Slack. Our shared spreadsheet fails at time tracking and client approvals. The ceiling is $15 per seat per month, billed monthly.
Limits: Use vendor pricing pages and documentation only. Skip review sites and "best tools" lists. Don't sign up for anything or enter our email anywhere.
Done when: A table of at most six tools with price per seat, billing basis, a link to the pricing page, and whether time tracking and client approvals are built in. Write "not public" for any price you can't find. End with one recommendation and the one reason it could be wrong.
Stop and ask: If fewer than three tools fit the budget, tell me before widening it.
Report: The table, your recommendation, and a list of what you assumed.コーディングエージェント(架空の例)
Claude Codeのドキュメントにも、Before/Afterの例があります。「カレンダーウィジェットを追加して」を、既存のウィジェットファイルのパターンに従い「新しいライブラリは使わない」という依頼に書き換えるものです(Claude Code docs)。同じ手法を、もっと大きな仕事に使った例が以下です。Claude CodeやCodex向けに書いています。
Before:
Add rate limiting to the public API.After:
Goal: Add per-API-key rate limiting (100 requests a minute) to the public REST endpoints so one noisy client can't slow the rest.
Context: Endpoints live in src/api/public/. Follow the middleware pattern in src/api/middleware/auth.ts. Limits belong in config/limits.yaml. Redis is available through src/lib/redis.ts.
Limits: Touch only src/api/ and config/. No new dependencies. Don't change the auth middleware or any existing test. Work on a new branch.
Done when: pnpm test passes, pnpm typecheck is clean, and a new test shows the 101st request in a minute returns 429 with a Retry-After header. If a test fails twice, stop and report.
Stop and ask: Before adding a dependency, changing a database schema, or pushing anything.
Report: Files changed, commands run with results, and any decision I should review.受信トレイエージェント(架空の例)
これは、メールに触れさせるあらゆるアシスタント向けです。ManusやClaude Coworkといったエージェント製品が想定している種類の仕事ですね。メールでは、「整理して」が気づかないうちに「削除した」になりかねません。
Before:
Clean up my inbox.After:
Goal: Reduce my inbox to messages that need a reply. Newsletters and receipts should end up under labels.
Context: Receipts come from stripe.com, paypal.com and amazon.com. Newsletters always carry an unsubscribe link. Anything from my accountant or the school stays where it is.
Limits: Create labels and move messages into them. Never delete, send, unsubscribe or reply.
Done when: The inbox holds only unread messages from people and anything from the last seven days.
Stop and ask: Show me the list of senders you plan to label before you move anything, and wait for my yes.
Report: Counts per label, and every sender you couldn't classify.BeforeとAfterで、Goalの行はほとんど変わりません。重みがあるのは最後の4行です。チェック、停止条件、レポート、そしてエージェントが絶対にしてはいけないことを示す制約です。
貼り付け用テンプレート
当てはまらない行は削除して構いませんが、意図して削除してください。
Goal: <the result, and who or what uses it>

Context: <files, links, accounts, decisions and past attempts it can't see>

Limits: <in scope> / <off limits> / <sources or tools allowed>

Done when: <a command, a count or a file that proves it>. If the check fails twice, stop and report.

Stop and ask before: <delete / publish / send / spend / install / change shared systems>

Report: <changes made, checks run and results, assumptions, things you chose not to do>
自分の下書きをこれで採点しましょう。はい・いいえで答える8問、所要30秒です。
指示書が失敗するパターンと、私たちならこう直す
| 失敗 | 見えるもの | 直し方 |
|---|---|---|
| 目的が作業の名前になっている | 大量の出力だけで、判断がない | 出力が何に使われるかを書く |
| 完了条件がない | 「終わったように見えた」時点で止まるか、止まらない | 実行できるチェックと再試行の上限を足す |
| 対象範囲を書いていない | 余計なファイル、リファクタリング、頼んでいない改善 | 立ち入り禁止を列挙する |
| 理由のない警告 | NEVERだらけで、無視されるか過剰に適用される | 理由を一節で添える |
| 承認が暗黙のまま | 自分の判断で削除、プッシュ、送信をしてしまう | 行動を列挙し、先に計画を出してもらう |
| 修正が積み重なっている | 指示が互いに矛盾する | 指示書を書き直し、新しく始める |
このうち2つは、もう少し説明が必要です。1つ目は、大文字の山です。強調を増やせば理由の欠落が補えたためしはない、と私たちは考えていますし、Anthropicのガイドも同じ方向を指しています。理由のない「NEVER use ellipses」が弱い例として挙がっていました。Claude Codeのドキュメントはさらに、「think step by stepやbe thoroughといった言い回しは、キーワードではなく普通のプロンプトの文章にすぎない」と述べています(Claude Code docs)。そのため、私たちは「徹底的に」といった決まり文句は削ります。Anthropicのガイドは、1文だけでもClaudeに役割を与えることを勧めているので、役割づけを禁止はしません。ただ、「世界トップクラスの専門家」といったペルソナは省きます。6つの要素のほうが、肩書きよりも多くのことをエージェントに伝えるからです。
2つ目は、その逆の問題です。OpenAIのガイドにあるサンプルのエージェントプロンプト(gpt-6-astraモデル向けで、ルールではなくサンプルとして示されています)は、モデルに「ユーザーのクエリが完全に解決されるまで続けること」と指示し、「依頼の一部しか完了していない状態で止まらないこと」と述べています(OpenAI docs)。明確なゴールがある仕事ならこれで問題ありませんが、ゴールがない仕事では罠になります。目標があいまいなまま粘り強いエージェントは、ループの中でトークンを使い続けることがあります。Googleのガイドも、高い粘り強さについて同じことを述べています。Anthropicのエッセイは、制御を保つために「停止条件(最大反復回数など)」を含めるのはよくあることだと述べています(Anthropic Engineering)。
もう1つ、やめたい習慣があります。すでに10回の修正が入っているスレッドに指示書を貼り付けることです。エージェントには11組の指示があるのに、それらに優先順位をつける手段がありません。
最初の1分を見て、書き直す
Claude Codeのドキュメントはこうアドバイスしています。「最初の1分を見守り、Claudeがずれた瞬間にEscを押し、2回修正して直らなければ/clearを実行して、3回目の修正をするのではなく、より良いプロンプトを書く」(Claude Code docs)。これはどのエージェントにも当てはまります。最初の計画と最初の数アクションを見れば、指示書が意図どおりに読まれたかどうかがわかります。
まだ指示書を書けないときは、エージェントにインタビューさせましょう。Claude Codeのドキュメントは「仕様を書けるようになるまで私にインタビューして、それをSPEC.mdに書いて」といったプロンプトを提案し、Codexのガイダンスは、先に質問してもらい「前提に異議を唱えて」もらうよう頼むことを勧めています(Claude Code docs、OpenAI Codex docs)。そのあと、書き上げた仕様から新しいセッションを始めます。
2回使える指示書には、置き場所を用意してあげましょう。常時守るルール(テストの実行方法、触ってはいけないもの)は、AGENTS.mdやCLAUDE.mdに入れます。OpenAIは「短く正確なAGENTS.mdは、あいまいなルールだらけの長いファイルより役に立つ」と述べています(OpenAI Codex docs)。繰り返す手順はスキルにできます。これについてはプロンプトからスキルへで扱っています。そもそもセッションに何を読み込ませるかは、コンテキストエンジニアリングの記事のテーマです。モデルのリリースをまたいでプロンプトを機能させる習慣は、モデル更新に強いプロンプトパターンにまとめています。こうした委任を前提にしたツールについては、AIエージェント、エージェント構築タスク、プロンプトエンジニアリングツールのボードをご覧ください。
よくある質問
指示書はどのくらいの長さにすべきですか?
6つの要素を収められる長さです。たいていの仕事なら100〜200語になります。普段の好みはルールファイルに置いて、指示書ごとにはこのタスクの内容だけを書くようにしましょう。指示書が1ページを超えるなら、その仕事は2つに分けたほうがよいはずです。
ChatGPT、Claude、Geminiで指示書は変える必要がありますか?
骨組みは同じです。OpenAIのCodexガイダンスにある4つの要素、Anthropicの「背景を渡し、リスクのある行動の前に確認させる」というアドバイス、Googleのエージェントの観点(あいまいさへの対処、リスク評価、粘り強さ)は、1つの同じニーズを別の言葉で説明しています。書式は少し違います。Googleのガイドは、XML風のタグかMarkdownの見出しを勧め、「1つの形式を選び、一貫して使うこと」と述べています(Google AI docs)。どのアシスタントがどの仕事に向くかは別の問いで、ChatGPT vs Claude vs Gemini in 2026で取り上げています。
エージェントが迷ったとき、どうするよう伝えればいいですか?
適用できるルールを渡してください。「元に戻せるものは前提を置いて進め、レポートに書く。元に戻せないものは先に確認する」のほうが、「迷ったら聞いて」よりうまくいきます。Googleのガイドも同じ選択を、モデルがいつ前提を置いてよく、いつ確認や許可を求めて止まるべきか、という形で捉えています。
よい指示書があれば、エージェントは安全になりますか?
いいえ。指示書はミスを減らしますが、どれも防げるわけではありません。Anthropicは「サンドボックス環境での徹底的なテストと、適切なガードレール」を勧めており(Anthropic Engineering)、権限と監査証跡については私たちの封じ込めガイドで扱っています。
それでもエージェントが間違えました。どうすればいいですか?
最初に軌道を外れたステップを見つけ、そのステップについて指示書に何と書いてあったかを確認します。それを防げたはずの一文を足して、新しいセッションからやり直してください。