

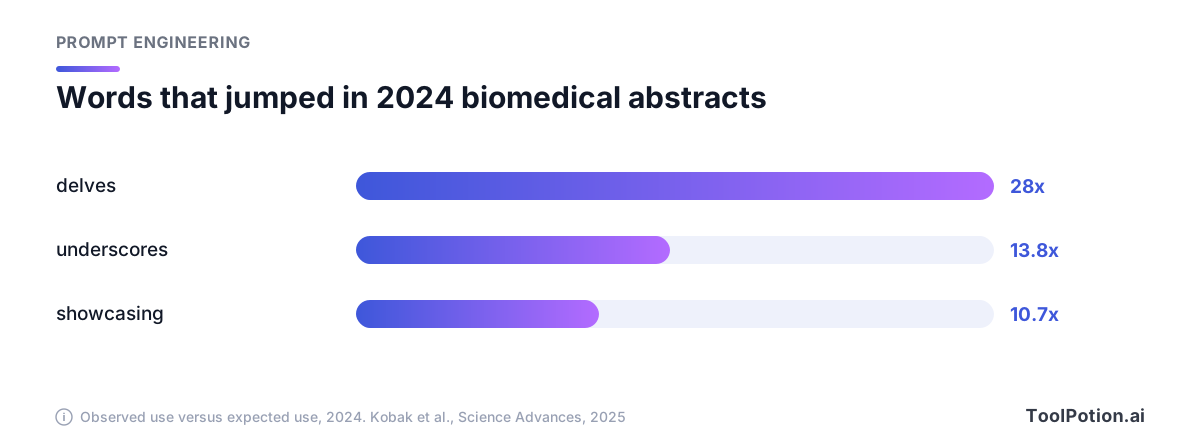
研究者たちは、PubMedにある1,500万件超の生物医学論文の要旨を調べ、ChatGPTの登場後に出現頻度が急増した単語を探しました。ある動詞(論文のタイトルにも使われている単語です)は、2024年の要旨で、それまでの傾向から予測される頻度の28倍も使われていました。ほかの2語は13.8倍と10.7倍です。Dmitry Kobak氏らは、この語彙の変化だけを根拠に、2024年の要旨の少なくとも13.5%がLLMで処理されており、分野によっては最大40%に達すると推定しました(Science Advances、全文はPubMed Centralでも読めます)。
この単語を見ても、その科学者たちに伝えたいことがあったかどうかは分かりません。分かるのは、機械が文に手を入れ、そのあと誰も読み直さなかったことだけです。
このガイドのテーマは、下書きを自分の文章らしくすること、そしてもっと大事なのは、自分の言いたいことをきちんと伝えることです。AI検出ツールをすり抜ける方法ではありません。学校、学術誌、職場などでAIの利用が禁止されている、または開示が必要な場合は、そのルールに従ってください。AIが認められない場面で機械の文章を人の文章として通す手助けはしませんし、以下の内容はポリシーを回避する手段ではありません。それ以外の場面(メール、投稿、レポート、提案書など)で私たちが使うワークフローを紹介します。土台にしたのは、Wikipediaの編集者によるAI文章の特徴カタログ、語彙に関する研究、各社のヘルプページです。
なぜデフォルトの下書きは、どれも同じ人が書いたように聞こえるのか
Wikipediaのボランティア編集者は、チャットボットの文章を直すことが日常になっていて、彼らのフィールドガイドはその仕組みをうまく説明しています。言語モデルは「平均への回帰」を起こす、と彼らは書いています。出力は、最も幅広いケースで統計的にもっとも起こりやすいものに寄っていくのです。さらに追加の訓練を重ねると、「もっとも広く受け入れられやすい文章」に調整されます。
その結果は具体的に表れます。珍しい事実が、ありふれた描写に置き換わるのです。編集者たちは例を挙げています。「連結器(列車の連結装置)の最初の発明者」という非常に具体的な説明が、「産業界の革命的な巨人」になってしまう。彼らの表現を借りれば、被写体は鮮明な写真からぼんやりしたスケッチへと変わり、そのぶん称賛だけが大きくなっていきます。
あなたらしさは、まさに平均化で消されてしまう部分に宿っています。中途半端な数字、固有名詞、持っているのが少し恥ずかしい意見、長い文のあとに置く短い一文などです。
単語リストを軸に対策を組み立てないほうがいい理由は、もうひとつあります。単語は移り変わるからです。同じWikipediaのページによると、先ほどの動詞は2023〜2024年にChatGPTが使いすぎることで有名でしたが、2025年には急激に減りました。また、モデルの世代ごとに別の「お気に入り」の語がリストアップされています。みんなが犯人扱いしたエムダッシュについては、他の特徴と組み合わさったときに最も有効な手がかりになると書かれており、新しいチャットボットの中にはこれを抑えるよう作られたものもあるそうです。単語ではなく、文章の型を探してください。
人間は、これを見抜くのが得意ではありません。このページが引用する2025年の研究では、人の判定精度は偶然と変わりませんでした。ドイツ語の学位論文を対象にした別の研究では、読者が正しく見分けられたのはAI文章の57%、人間の文章の64%でした。一方、2025年のプレプリントでは、専門のアノテーター集団がAI文章の90%を見つけ出したとも書かれています。
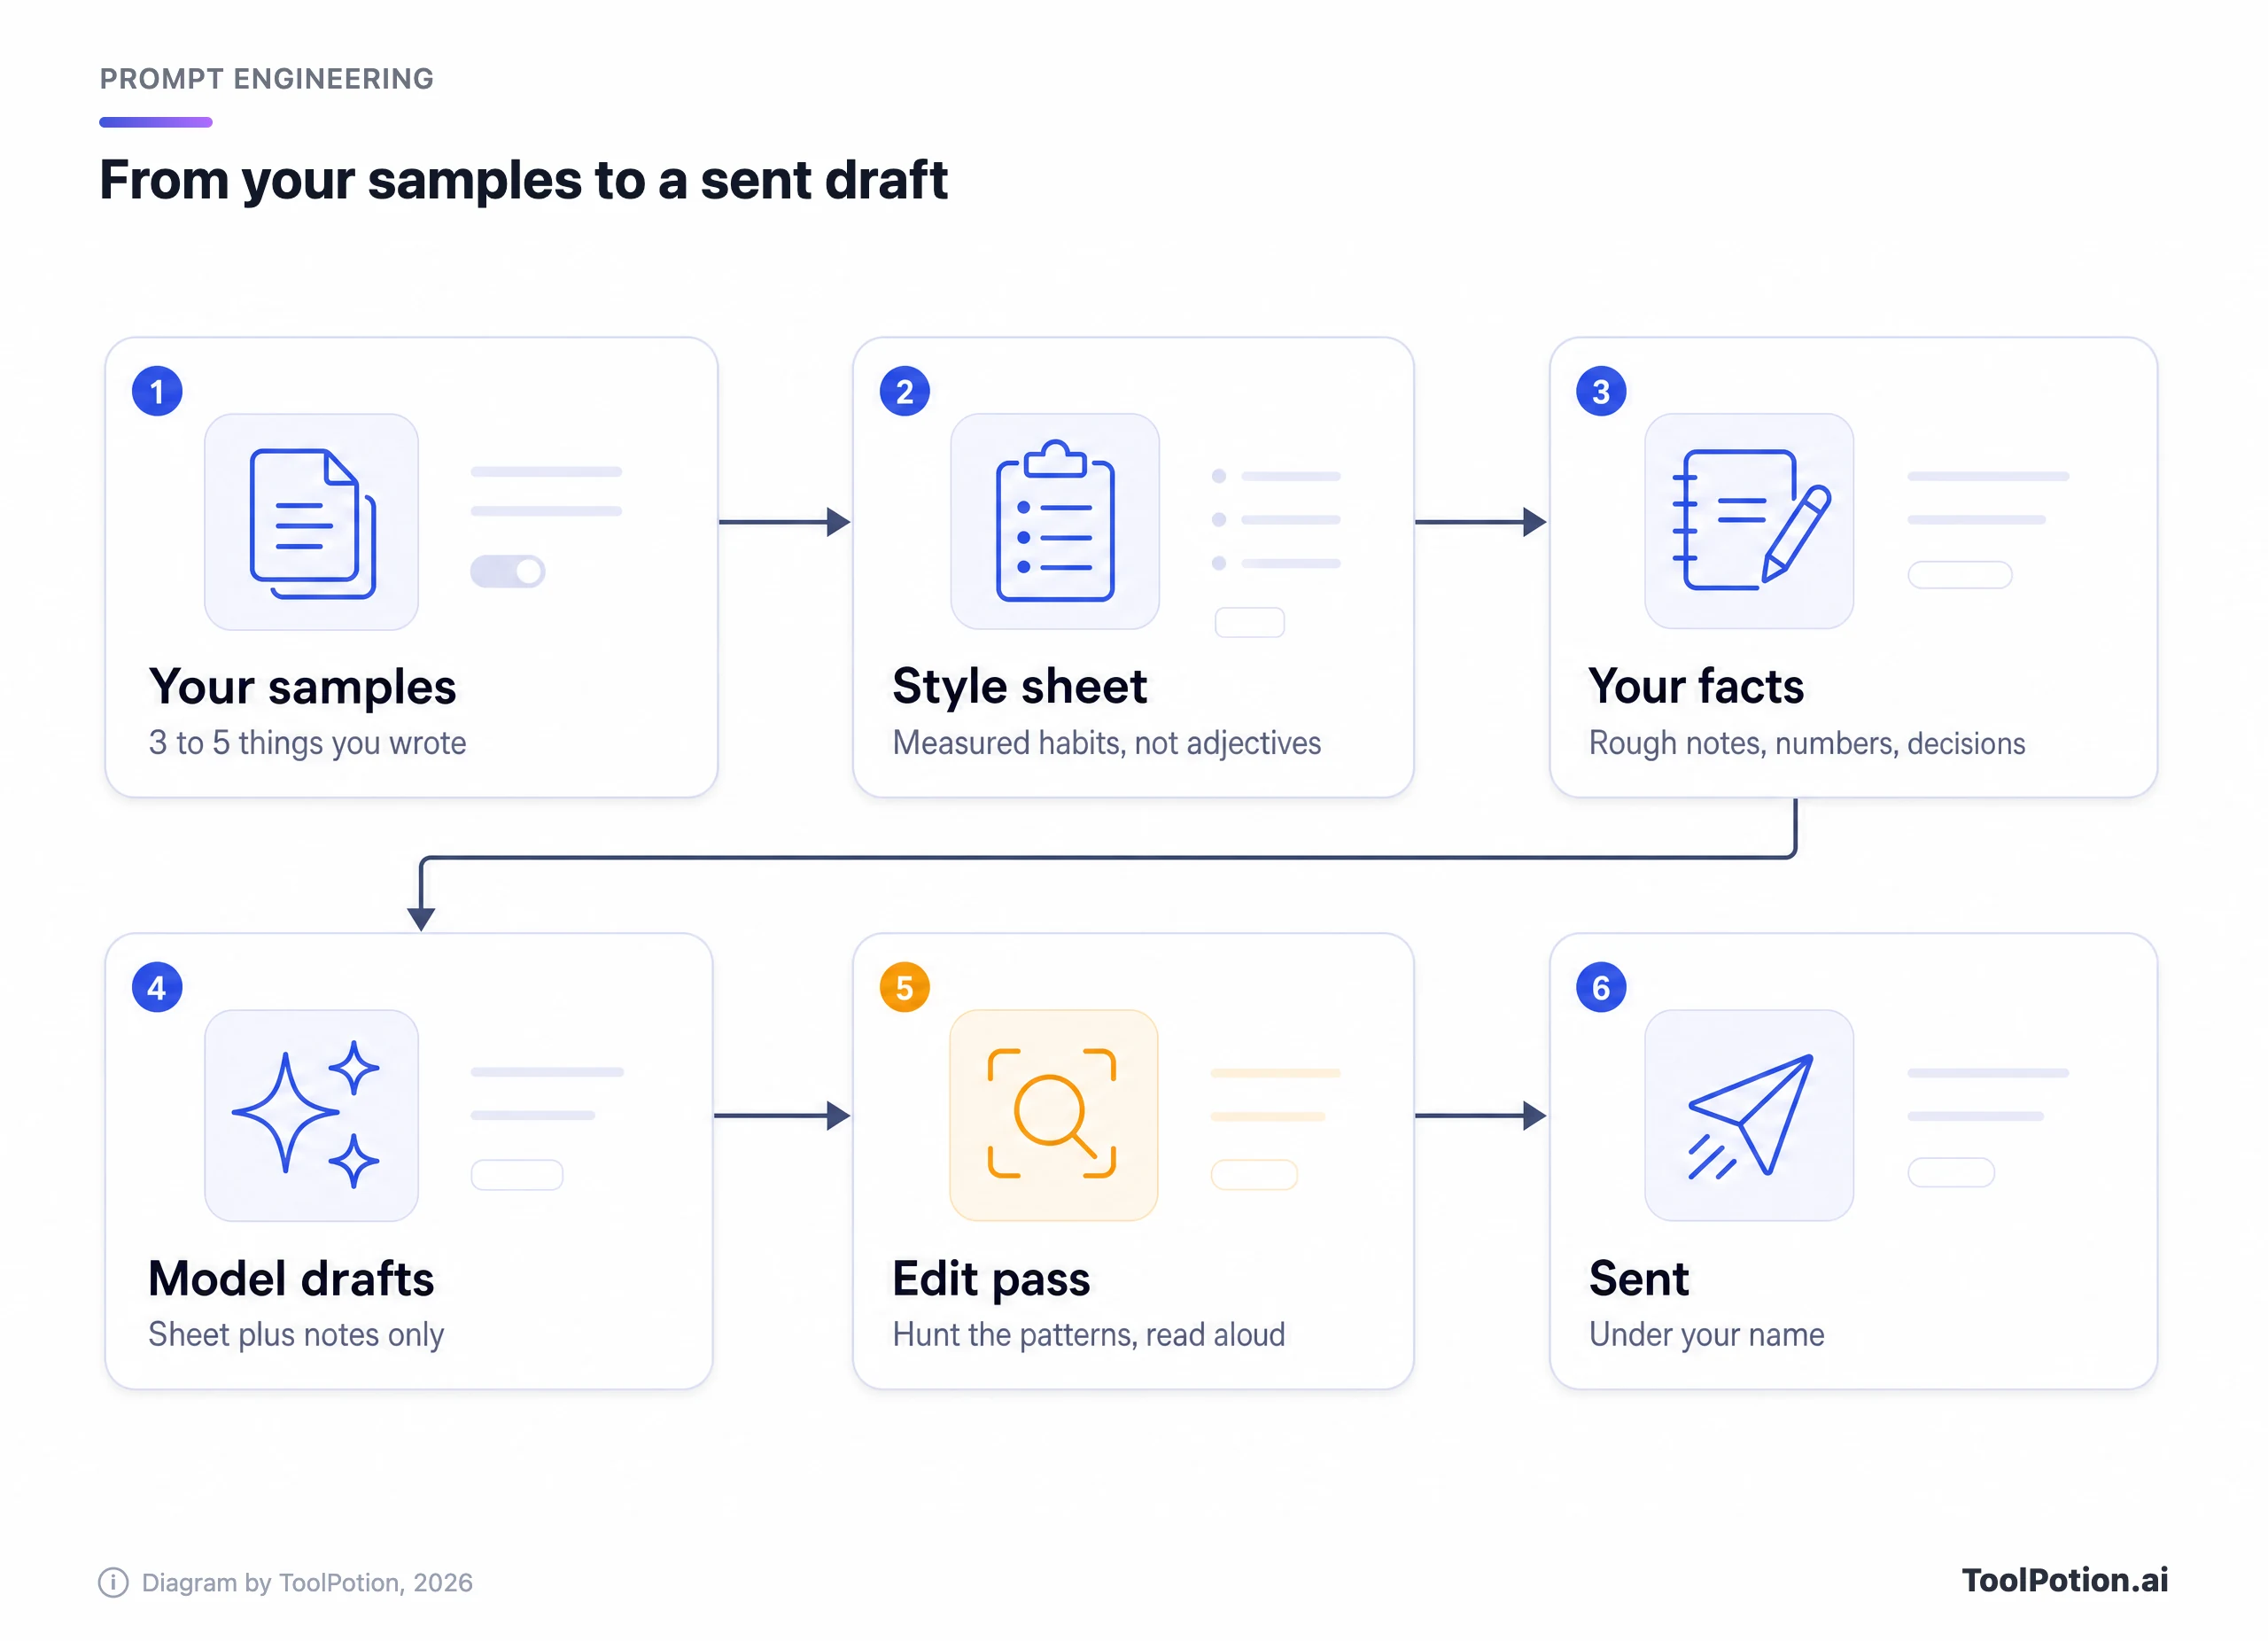
まず、自分で書いた文章を5本集める
自分で書いた文章を3〜5本選んでください。実際の読み手に向けて、モデルを使わずに書いたものです。同僚へのメール、満足できた投稿、新人に何かを説明したSlackメッセージなどを、1本300〜600語ほど集めます。何本あれば十分かは、私たちが読んだヘルプページのどれにも書かれていません。私たちの目安は、クセが2回出てくる程度の量です。
選ぶなら、気軽に書いた、整えすぎていないものがおすすめです。親しい同僚にさっと書いたメモのほうが、顧客向けに苦労して仕上げた段落よりも向いています。AIの下書きを整えただけのものは外してください。モデルに、モデル自身のクセを教え返すことになるからです。
貼り付ける前に、名前や機密情報を取り除きます。そのうえで、他人になったつもりで一度全体を読み通してください。デフォルトの下書きには絶対に出てこない、あなたのクセを探します。
スタイルシートに書くのは、形容詞ではなく習慣
スタイルシートとは、あなたの文章についての観察を1ページにまとめたもので、それを読めば誰かがあなたの真似ができるくらい具体的なものです。形容詞は使えません。「温かみがありつつプロフェッショナル」は、何百万人にも当てはまります。あなたを表すのは、数値と習慣です。書き留めておく価値があるのは、次の6つです。
- 文の長さ。いくつかの段落で数えてみましょう。平均が約14語で、3語から35語まで幅があるなら、そう書きます。長い文のあとに短い文が来ることも書いてください。
- 使わない言葉やフレーズ。自分の文章サンプルを見直して、自分なら絶対に打たない企業的な決まり文句を挙げ、没にした下書きで見つけたものも加えます。
- 書き出し方。答えから入るのか、数字か、質問か、お詫びか。実際の書き出しを2つ引用してください。
- 締め方。単に書き終える人も、次のアクションと名前で終える人も多いものです。自分の場合を書き、要約はしないとも書きます。
- モデルがならしてしまうクセ。体言止めや断片的な文、かっこ書き、「そして」で始まる文、一人称、乾いたひとこと、正確な数字を挙げる習慣などです。
- 書式。箇条書きを使うかどうか、段落の長さ、見出しの書き方、口語的な短縮形を使うか(たいていの人は使います)。
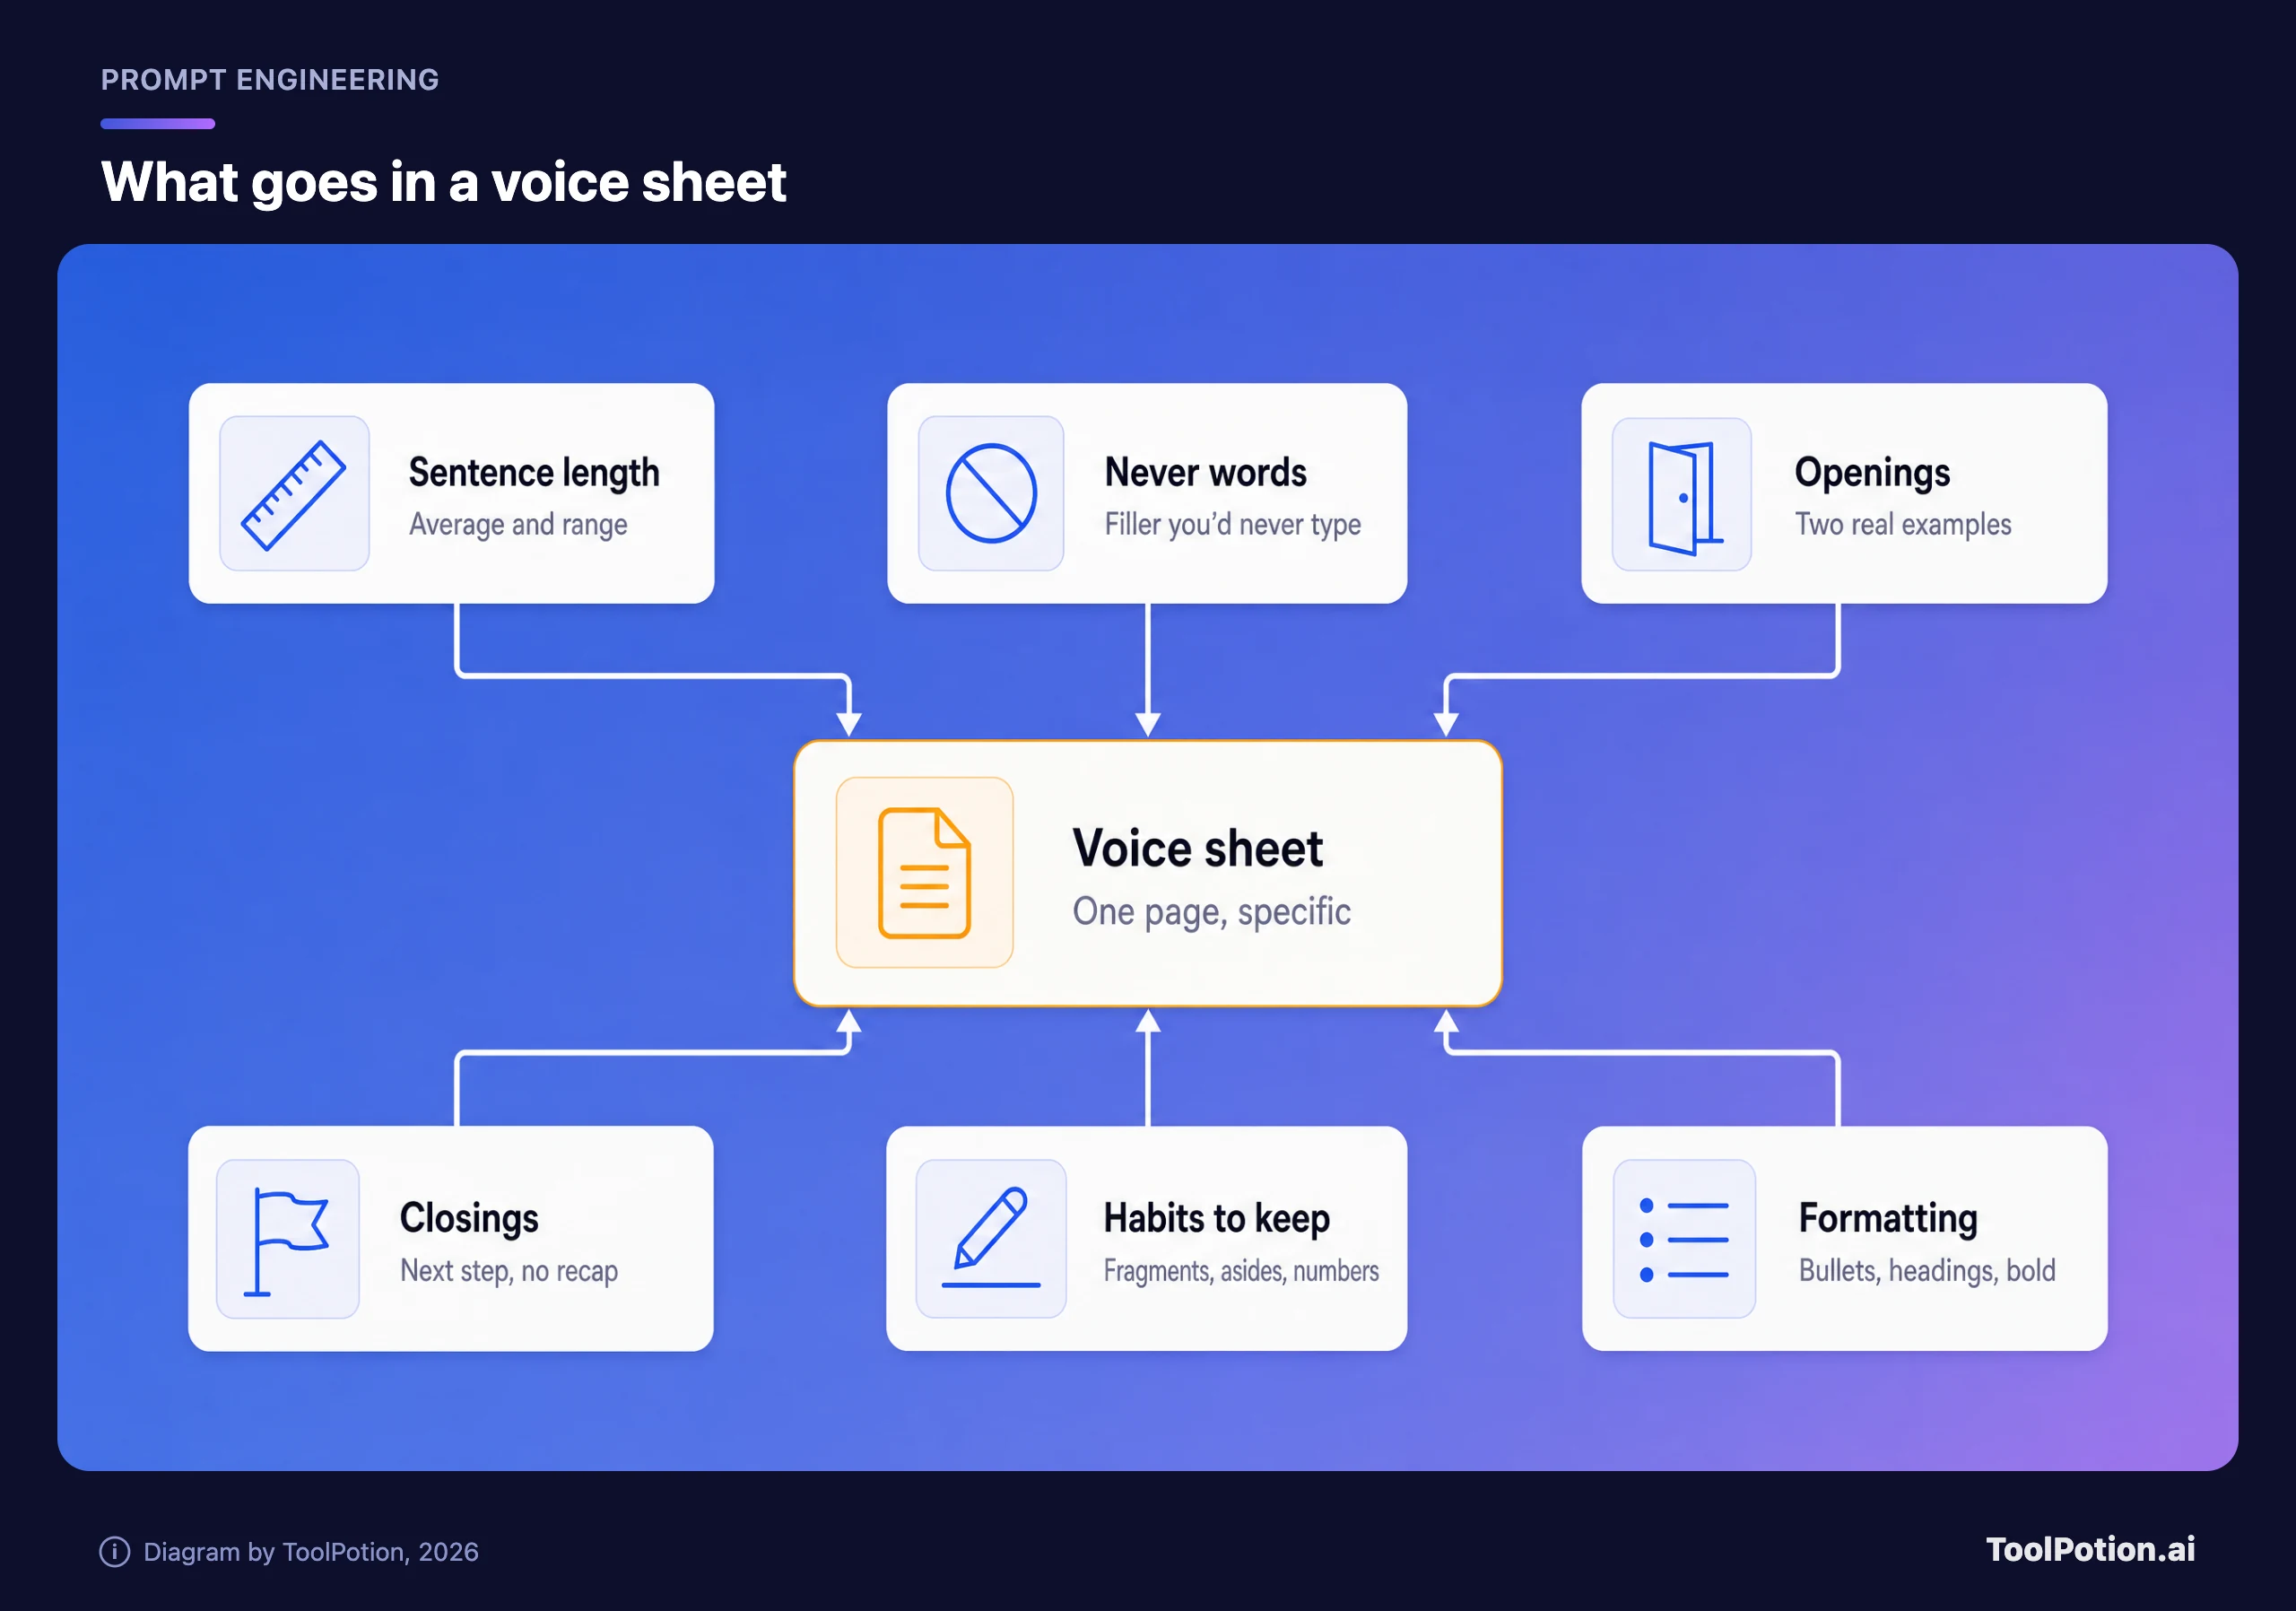
実際に自分が書いた文を2〜3文、例として加えてください。モデルは説明よりも例のほうをうまく真似します。
ここでは、架空のオペレーションマネージャー、Danaのために書いた簡略版のシートを紹介します。形式の参考用です。そのままコピーしないでください。あなたのシートは違うはずだからです。
VOICE SHEET: Dana
Sentences: average 14 words, range 3 to 35. A short one after every long one.
Openings: the answer first, or the number. Never a greeting line, never "I wanted to".
Closings: the next step and who does it. No recap, no offer to help further.
Contractions always. First person plural for the team, "I" for opinions.
Parentheses for asides, maybe one per email. Fragments are fine.
Never writes: "touch base", "circle back", "moving forward", "going forward", "leverage", "stakeholders", "ensure".
Numbers as digits, with units. Dates as "Thursday the 12th".
No bullets in emails under 200 words. No bold. No headings.
Examples of my sentences:
- "The vendor took nine days, not two."
- "We can cut invoices from this release. Nothing else can slip safely."
- "Not great, but fixable."
サンプルからモデルにシートの下書きを作らせることもできますが、各行を自分の実際の文と照らして確認してください。モデルは書き手を「平均的な人」として描写しがちです。自分の文のどれにも当てはまらないルールは、削除しましょう。
ツールごとのシートの置き場所
主要なアシスタントにはどれも、常時有効な指示を置く場所があります。入る文字数はそれぞれ違い、例を含めたシートの全文だと、収まらないものもあります。
| ツール | 自分の文体を置く場所 | ベンダーのページの記載 | 注意点 |
|---|---|---|---|
| ChatGPT | 設定 → パーソナライズ → カスタム指示 | すべてのチャットにすぐ適用。上限はFreeとGoが1,500文字、Plus、Pro、Business、Enterprise、Educationが5,000文字 | 短縮版のシートを入れ、例文はチャットの冒頭に貼る |
| Claude | 設定 → Your Claude → 指示、またはプロジェクトの指示 | アカウント全体の指示、プロジェクト単位の指示、そして「自分の文章に基づくコミュニケーションパターン」のためのスキル | Anthropicのパーソナライズのページには、指示、プロジェクトの指示、スキルが載っていて、独立したスタイル機能はない |
| Google Gemini | Gem:名前、指示、任意のナレッジファイル | Gemini自身にGemの指示を書き直させることができる | Googleによると、個人アカウントのGemはまもなくスキルに移行する |
| Grammarly Humanizer | 文章サンプルを貼って、カスタムボイスを作成 | 4つのプリセットスタイルに加え、サンプルから学習したカスタムボイスを今後のリライトに使える | すでにある文章を書き直すツール。書き漏らした事実は補えない |
出典:OpenAI、Anthropic、Google、Grammarly。
私たちのおすすめは地味なものです。マスターコピーは自分で管理できるプレーンテキストのファイルに置き、必要な場所に貼り付けて使ってください。ベンダーはこうした機能の名称を変えたり廃止したりします(Googleは、個人アカウントのGemをスキルに移行すると言っています)。どこにでも貼れるシートなら、それでも使い続けられます。プロンプトを再利用できる形にする方法は再利用できるAI指示、巧みな言い回しよりコンテキストが重要な理由はコンテキストエンジニアリングをご覧ください。
Grammarlyのサンプルベースのカスタムボイスは、考え方として正しいものですが、「AI humanizer」として売られています。Grammarly自身のFAQには、このツールは「AI検出ツールを回避するためのものではない」と書かれていて、学術や仕事の場面ではAIの支援を明示するよう勧めています。私たちも同じ使い方をします。つまり、あなたのクセを学んでくれる校正者として使うのです。AIヒューマナイザーのカテゴリの他の製品は、別のことをうたっているかもしれないので、それぞれの利用規約を確認してください。より幅広いツールについては、AIライティングアシスタントのまとめとGrammarlyとQuillBotの比較をご覧ください。
自分の事実を渡してから、下書きを頼む
シートが整えるのは表面です。中身は自分から出す必要があります。下書きを頼む前に、材料を自分のごちゃごちゃした言葉で書き出してください。何があったか、数字、決定事項、読み手にしてほしいこと。ラフな10行で十分です。そのうえでモデルに、その材料だけを使うこと、事実が足りないときは埋めずに自分に質問すること、シートに従うことを指示します。
いちばん大事なのは「聞き返せ」という指示です。推測を許されたモデルは推測します。その推測は、一般的で、持ち上げるような、もっともらしいものになります。こうした指示の出し方の仕組みはプロンプトエンジニアリングガイドで、メールへの応用はメールガイドで解説しています。
ある進捗報告のビフォーアフター
以下の2つのバージョンは、違いを示すために私たち自身で書いたものです。1つ目は、チャットボットに「遅延についてクライアントにプロジェクトの進捗報告を書いて」と頼んだときの、典型的なデフォルトの下書きです。2つ目は、Danaが10行のメモとシートをモデルに渡し、さらに編集して送るメールです。
| 典型的なAIの下書き(私たちの例示) | スタイルシートを使って編集した下書き(こちらも私たちの創作例) |
|---|---|
| 件名:プロジェクトの進捗について。いつもお世話になっております。プロジェクトのスケジュールについて、ご報告の機会をいただければと存じます。弊社チームは高品質な成果物をお届けするべく尽力しており、透明性を大切にしております。しかしながら、予期せぬ課題が発生し、スケジュールに影響が出ております。今後も明確なコミュニケーションと連携を重視してまいります。ご不明な点がございましたら、お気軽にご連絡ください。 | 件名:1週間遅れます。決済プロバイダーのテストアカウントの承認に、聞いていた2日ではなく9日かかり、チェックアウトのテストを月曜まで始められませんでした。今は動いています。新しい日程は12日(木)です。プレスの解禁日に間に合わなくなる場合はお電話ください。今回のリリースから請求書機能を外します。ほかに影響せず、遅らせられるのはそこだけです。Dana |
何が変わったか数えてみてください。2つ目のほうが短いですが、重要なのはそこではありません。9日、2日、月曜、木曜、そしてクライアントが動ける決定事項があることです。どれもモデルから出てきたものではなく、出せたはずもありません。改善の大半は事実で、文体はその上に乗せたものです。1つ目の下書きには、嘘は一つもありません。でも、誰が誰に何についてでも送れる文面です。
編集時に探したい8つのパターン
この部分は印刷しておいてください。これらのパターンは、記事、下書き、トークページの実例に基づくWikipediaのカタログから取ったものです。中央の列では各パターンを説明し、ページ自体が示すフレーズもいくつか載せています。
| 特徴 | どんな見た目か | どうするか |
|---|---|---|
| 意義の水増し | ごく普通の事実を、転換点、遺産、より大きな潮流の中での役割として描く(「marking a pivotal moment」「reflects broader」) | その文を削るか、膨らませていた素の事実に置き換える |
| 分詞の尻尾 | 文末が「-ing」の解説で、事実の意味を読み手に教えてしまう | 文を分ける。主張は独立した一文にするか、裏付けられないなら削る |
| 否定の並列 | 「It's not just X, it's Y」と、その仲間の「not X, but Y」 | Yだけを言う |
| あいまいな出典 | 名前のない専門家、レポート、観察者を根拠に、誰も追えない主張をする | 誰が言ったかを明記してリンクするか、削除する |
| 3点セット | 反射的に並べる3つの形容詞や3つの並列節 | 本当に当てはまる1〜2個だけ残す |
| 思考を装った書式 | すべての箇条書きの冒頭に太字のラベル、見出しはタイトルケース、箇条書きの記号に絵文字 | 普通の文で書く。リストは項目が別々のときだけ使う |
| きれいにまとめた展望の段落 | 「課題と今後の展望」の節で、記事の内容を繰り返す | 最後の具体的な論点か、次のアクションで終える |
| アシスタントの残りもの | 冒頭の挨拶、末尾の修正提案、本文に残ったかっこ付きのプレースホルダー | すべて削除し、そのあとでかっこを検索する |
このリストの使い方について、2点あります。まず、このリストはWikipediaの編集者が、開示されていないAI文章を見つけるために作ったもので、彼ら自身、これらの兆候そのものを問題として扱わないよう注意しています。彼らの言葉では、「これらの兆候を、直すべき問題としてだけ扱わないでください。検出がかえって難しくなるだけかもしれません」。私たちはこのリストを、中身のない文を見つけるための編集の補助として使います。大げさな表現は、たいてい言うことがなかったことを意味します。だから直すべきなのは言葉ではなく、事実です。
次に、このページには「効果のない指標」のリストもあります。完璧な文法、フォーマルとカジュアルが混ざった文体、出典のない内容は、人間の文章にもよく見られるものです。シートに書いた、自分の書き方と違う点だけを直し、自分のクセは残してください。
下書きを一度声に出して読み、引っかかった箇所すべてに印を付けます。次に上の表を順にチェックします。それから、残った各文がどんな事実、名前、数字を運んでいるかを自問します。何もなければ削ります。
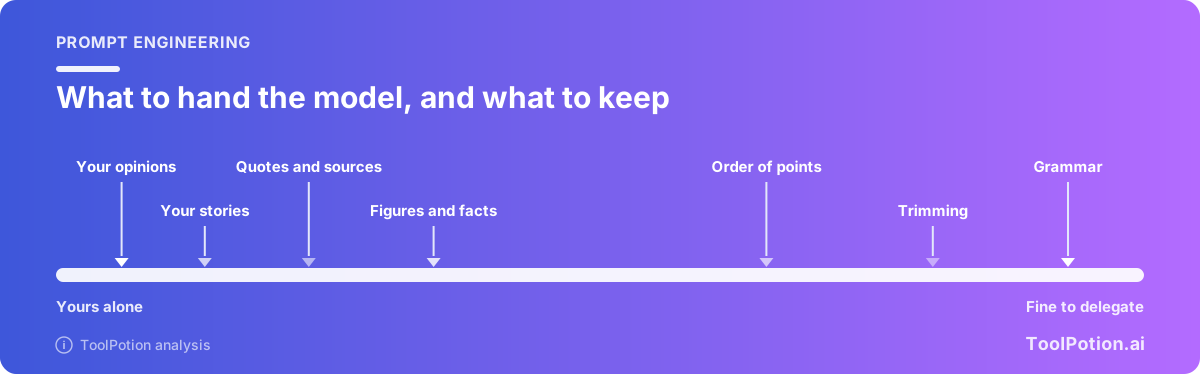
モデルに任せてはいけない3つのこと
スタイルシートがカバーするのは言い回しです。モデルが何も知らない領域に踏み込ませたくなる誘惑もありますが、私たちは次の3つについては、はっきり線を引きます。
持っていない意見。強い主張を求められたモデルは、あなたの口調で自信満々の文を書きます。それは無難な文よりたちが悪いものです。まだ決めていないなら、「まだ決めかねています」と書いてください。
実際にはなかった体験談。「最近クライアントに言われたのですが」は、現実についての主張です。作り話なら、一人称で嘘をついたことになります。モデルはこの手の一文を実に簡単に書きます。
誰も言っていない引用や、存在しない出典。Wikipediaのページには、いかにもそれらしいのにどこにもつながらない参考文献リストが記録されていて、中には「この文のために追加された参考文献が存在しなかった」編集もありました。下書きに入っている数字、引用、リンクはすべて、誰が打ったものであれ、確認する責任はあなたにあります。
それ以外ならモデルが役に立ちます。メモへの問いかけ、順序の検討、削る作業、段落の書き出しの案出しなどです。案の中から、自分なら書いただろうものを拝借してください。
よくある質問
これでAI検出ツールをすり抜けられますか?
そのための方法ではありませんし、約束もしません。Wikipediaの編集者によると、GPTZeroやPangramなどの検出ツールは「偶然よりは高い精度」ですが、「無視できない誤判定率」があり、スコアが高いだけでは証拠になりません。かといって、スコアが低くても何の証拠にもなりません。学校や職場がAIの利用を禁じているなら、答えはそのルールに従うことです。
AIを使ったことは伝えるべきですか?
その文章を出す先のルールに従ってください。AIの手を借りたメールを気にしない職場は多いですが、学術誌や授業、一部のクライアントは気にします。迷ったら聞いてみましょう。
モデルが変わっても、このシートは使えますか?
型のレベルのルールは、たいてい生き残ります。単語レベルのルールはすぐ古くなります。Wikipediaのページにはモデルの世代ごとに別のお気に入りの語が載っているので、数か月に一度は「使わない言葉」の行を見直し、新しいデフォルトの下書きと比べてみてください。
クライアントの仕事をスタイルツールに貼り付けても大丈夫ですか?
まずベンダーのデータ利用規約を確認してください。たとえばOpenAIのページには、オプトアウトしない限り、カスタム指示の利用から得られた情報がモデルの性能向上に使われることがあると書かれています。いずれにしても、サンプルからは名前や機密情報を取り除いてください。