

AI の出力をファクトチェックするときに、検証作業に溺れないコツは、すべての文を確認しようとしないことです。主張を抜き出し、間違っていた場合に何が崩れるかでランク付けし、記事の根幹を支える主張だけを元の情報源に当たって確認します。整った引用も、モデル自身の「確かです」という返答も、何の証明にもならないからです。
このステップを省くコストは増え続けています。AI が生成した虚偽の内容が絡む裁判所の判断を集めた公開データベースには、執筆時点で2,125件が記録されており、そのうち1,193件は今年だけで登録されたものです(AI Hallucination Cases database)。今年はKPMGも、AI のハルシネーションとみられる問題を理由に公開済みのレポートを取り下げました。レポートで AI 活用について言及された組織が、その主張を「事実と異なる、または誤解を招く」と指摘したためです(TechCrunch)。
ハルシネーションはなくなっていません。むしろ見つけにくくなっています。周囲の文章が流暢で、偽の参考文献が本物そっくりに見えるからです。この記事では、誤りが特に多い主張の種類、自己チェックでは足りない理由、そのまま使えるプロンプト付きのリスク別ワークフロー、そして Gemini Notebook(旧 NotebookLM)、Perplexity、Consensus といったグラウンディング系ツールの実力を率直に取り上げます。
偽の引用は、いまや法廷の「お決まりパターン」
この問題に最初に直面したのは弁護士で、しかも公の場でした。Damien Charlotin 氏のデータベースには、当事者がハルシネーションを含む内容(多くは架空の判例)に依拠したと、裁判所や審判機関が認定した、あるいはそれをうかがわせた判断が記録されています。これまでに提出された偽の引用をすべて数えようとするものではなく、裁判所や審判機関が書面で言及したものだけが対象です。この狭い条件でも、増加の勢いは急です。
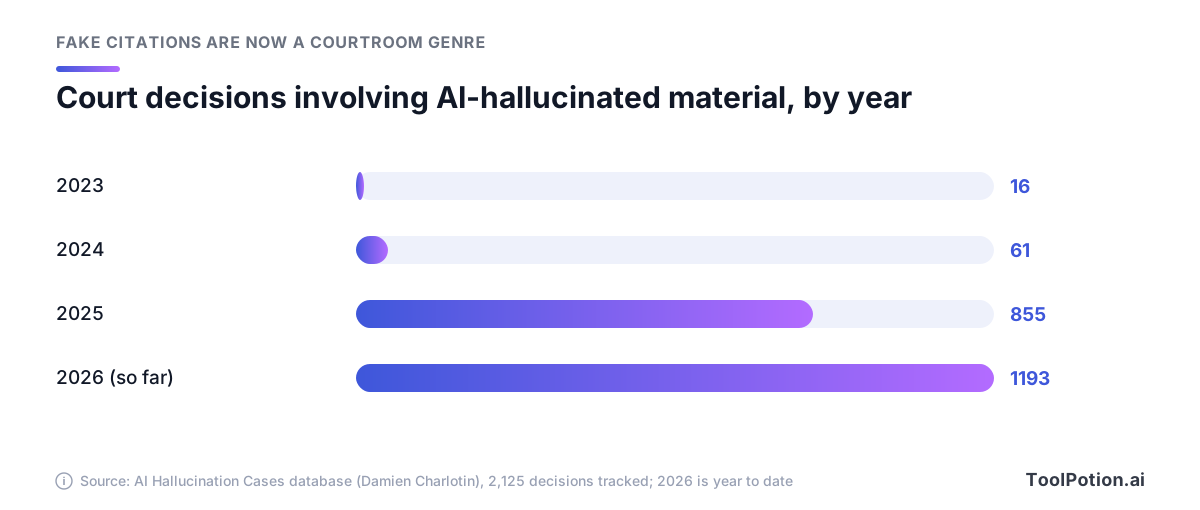
2026年の棒は年の途中までの数字にもかかわらず、すでに2025年を上回っています。記録された判断のうち、本人訴訟の当事者によるものが1,227件、弁護士によるものが840件で、ハルシネーションを含む内容が裁判官側から出たケースも33件あります。国別では米国が1,459件で突出し、カナダの223件、オーストラリアの112件が続きます。
すべての始まりとなった事件は、今でも最良の教訓です。2023年の Mata v. Avianca では、ニューヨークの連邦裁判所の事件を担当していた弁護士が、ChatGPT に、先ほど挙げてもらった判例の一つが実在するのかと尋ねました。ChatGPT は実在すると答え、さらに問い詰められると、その判例は「確かに存在し、Westlaw や LexisNexis などの法律調査データベースで見つけられる」と述べました(CNN)。実際にはその判例は存在せず、裁判所は弁護士と所属事務所に5,000ドルの罰金を科しました。弁護士は宣誓供述書で、「その内容が虚偽である可能性があるとは知らなかった」と述べています。
その後、代償は大きくなっています。Couvrette v. Wisnovsky では、オレゴンの連邦裁判所が、原告側の準備書面に15件の捏造された引用と7件の誤った引用を認定しました。裁判所は書面を却下し、請求を再訴不可として棄却したうえで、制裁金と費用として110,204ドルを命じました。データベース中の米国の事件では最高額です。法務で AI を使うなら、より安全な使い方をまとめた法務向け AI の活用ガイドも参考にしてください。
法廷は、最も目立つ舞台にすぎません。Deloitte は、オーストラリア政府向けの44万ドルのレビュー報告書で、大学教授が書いたとされる実在しないレポートを引用し、実際の判決についても架空の言及を含めていたため、一部返金に応じました。同社はその後、Azure OpenAI の GPT-4o を組み込んだツールチェーンを使っていたと明らかにしています(The Guardian)。EYも今年、偽の脚注を含むとみられるロイヤルティプログラムのレポートを取り下げました。KPMGを報じた TechCrunch の同じ記事によるものです。さらに2025年には、Chicago Sun-Times が配信記事の夏の読書リストを掲載しましたが、15冊のうち10冊が実在しない本だったと NPR が報じています。
AI の出力はどこで間違えるのか
今のモデルはスペルをほとんど間違えません。OpenAI の研究者は、誤りが別の場所に移った理由を説明しています。スペルは大規模モデルが学習できるパターンに従いますが、「ペットの誕生日のような、出現頻度の低い恣意的な事実は、パターンだけでは予測できず、ハルシネーションにつながる」というのです(OpenAI)。研究者たちが、広く使われているチャットボットに、論文の著者の一人の博士論文のタイトルを尋ねたところ、3回とも違う答えが返ってきました。どれも正解ではありませんでした。
ここから見えてくる地図があります。誤りは数種類の主張に集中しており、最も危険なのは「証拠の顔をしたもの」です。
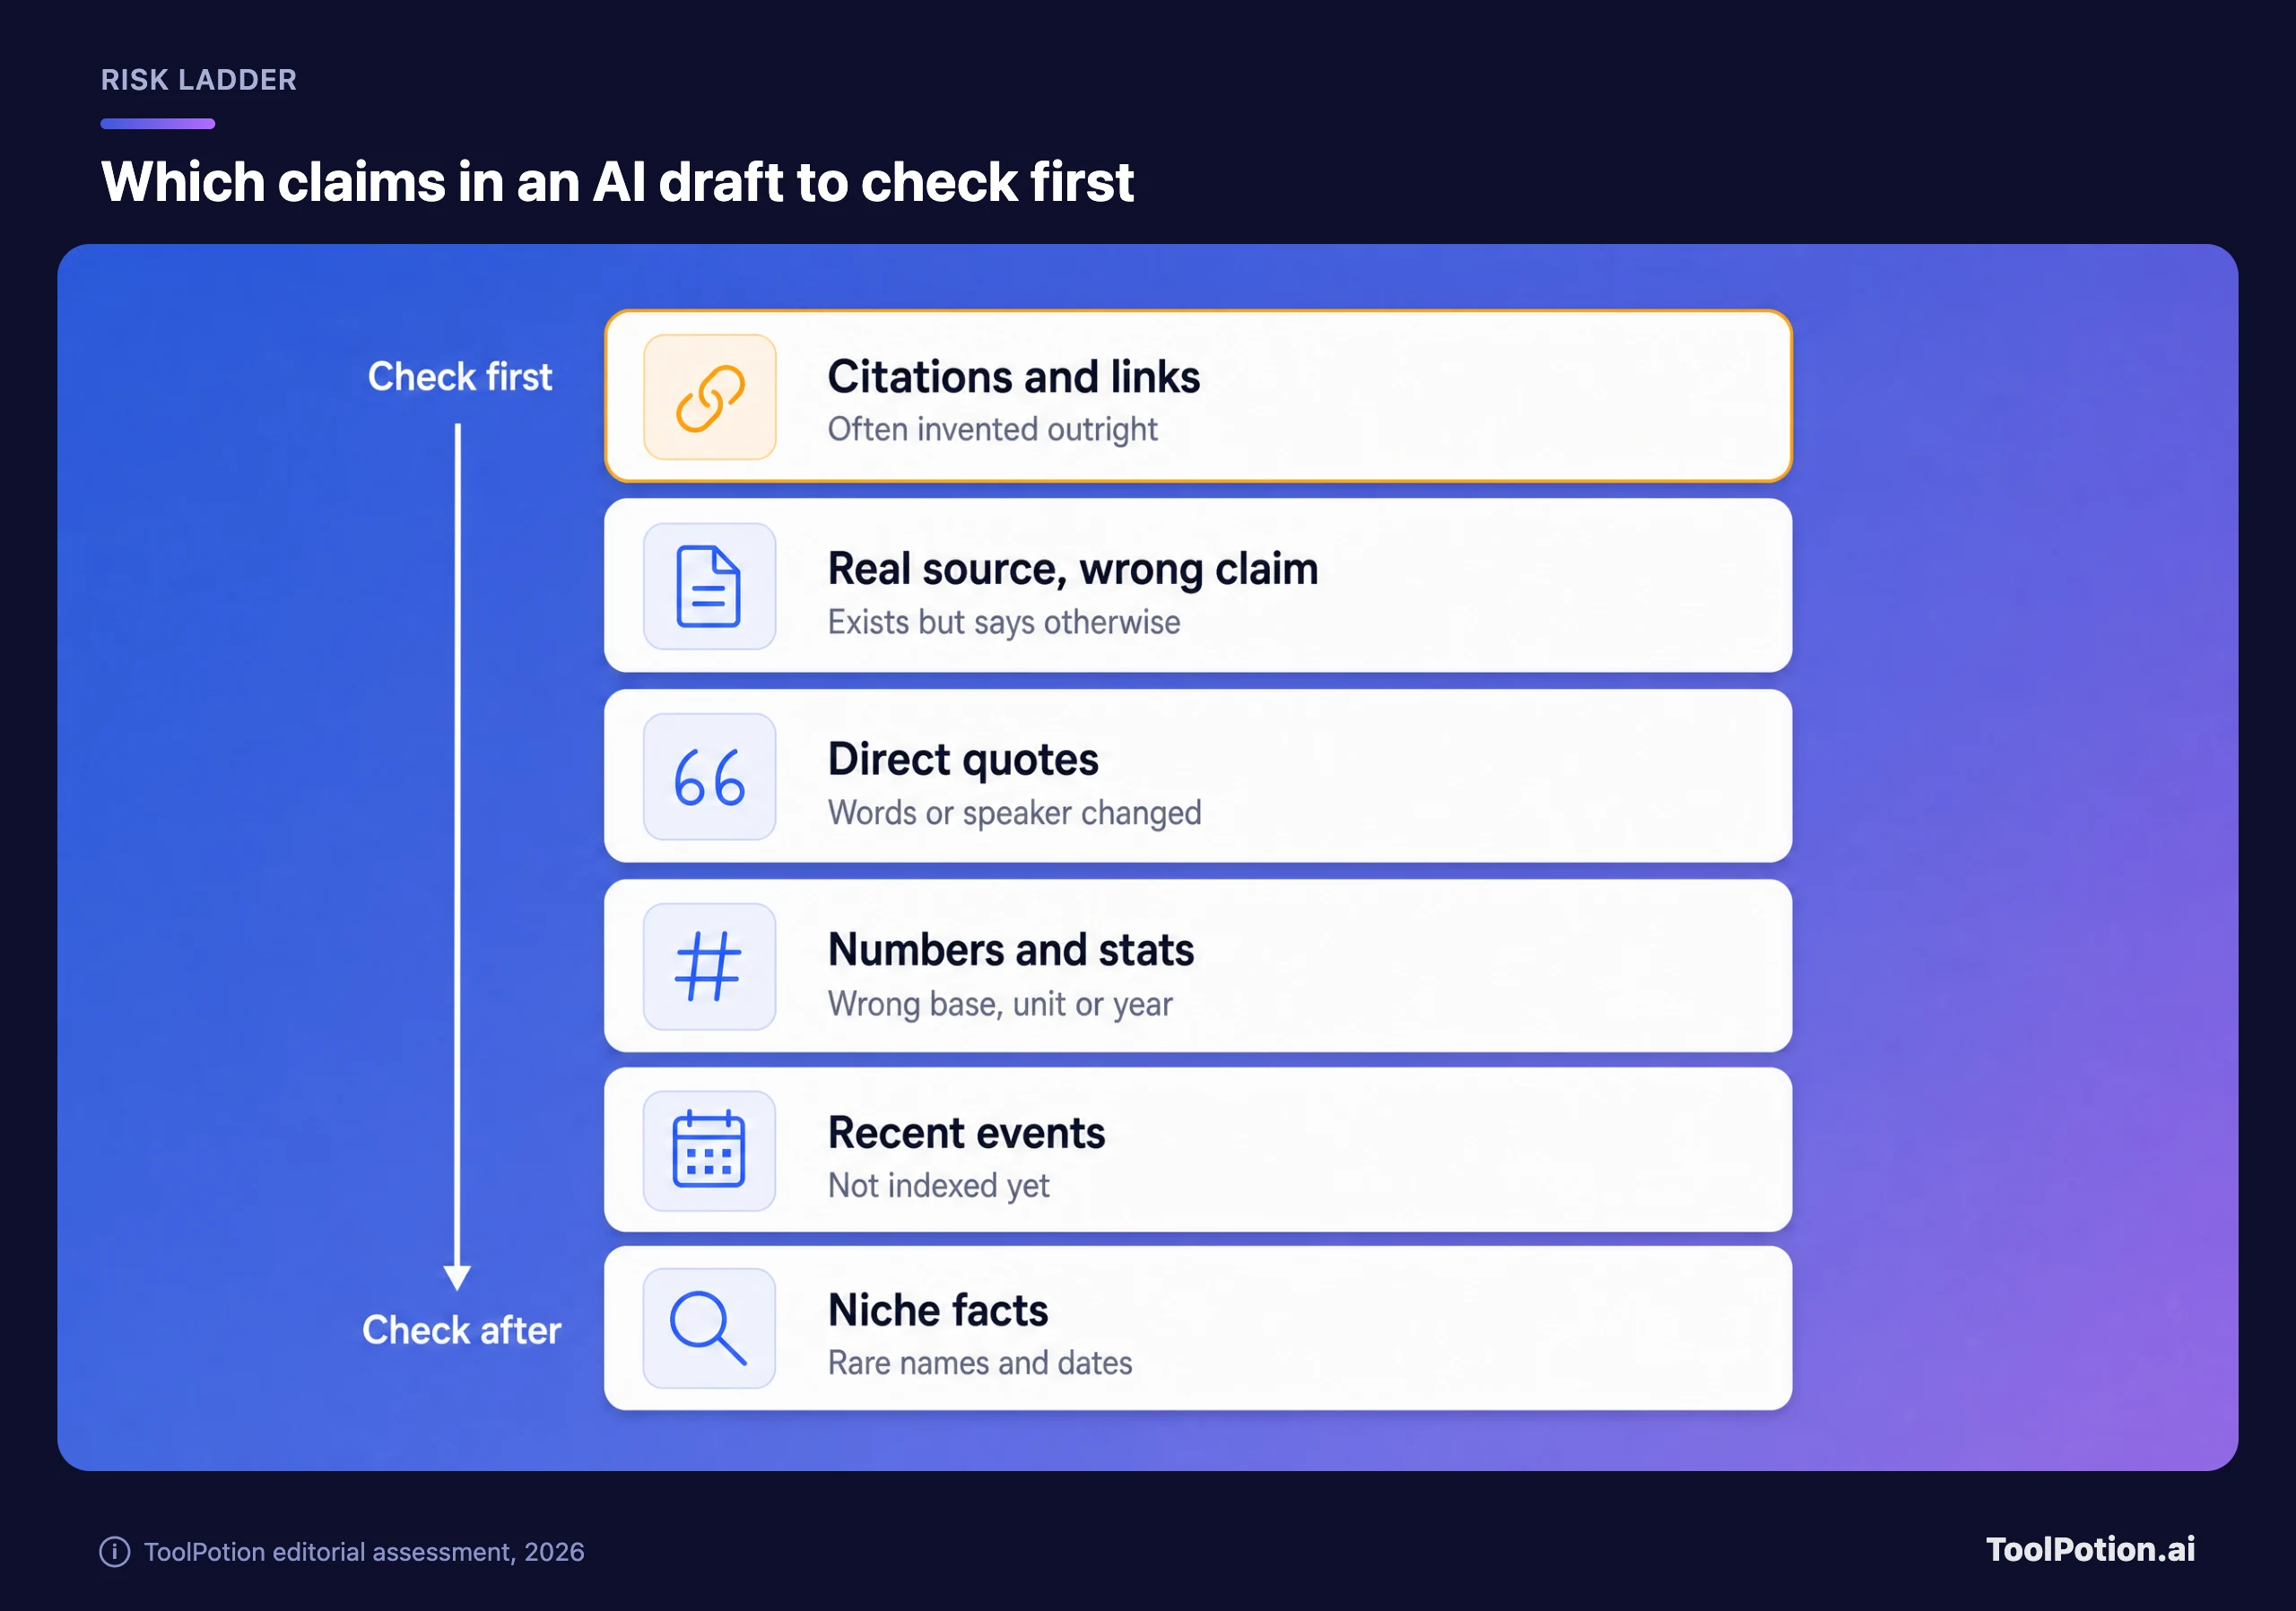
引用が最上位にあるのは、2通りの壊れ方をするからです。一つは完全な捏造です。2025年に Columbia 大学の Tow Center が、8つの AI 検索ツールに1,600件のクエリを投げ、ニュース記事の抜粋の出典を特定させたところ、全体で6割超が誤りで、Grok 3 は200件の引用のうち154件をエラーページに誘導しました(Tow Center)。もう一つは、実在する情報源なのに、書かれていないことの根拠として引かれるケースです。Charlotin のデータベースでは、内容の誤った引用が絡む判断が894件、捏造が絡む判断が1,752件あります。リンクが開けるかどうかでは、この後者は見抜けません。
次に危ないのが発言の引用です。データベースには、偽の発言を含む判断が572件あり、OpenAI 自身のヘルプセンターも、ChatGPT の既知の失敗パターンとして「捏造された引用文、研究、出典、存在しない情報源への参照」を挙げています(OpenAI Help)。数字の誤りはもっと静かに起こります。年が違う実在の数値、パーセントポイントのはずがパーセント表記、特定地域の価格を世界共通の価格として扱う、といったものです。
最新情報には独特の落とし穴があります。Perplexity の開発者向けドキュメントによれば、ハルシネーションが最も起きやすいのは、情報がログインやペイウォールの内側にあるとき、検索が「関連はあるが一致しない結果」を返すとき、あるいは「ごく最近の情報がまだインデックスされていないとき」です(Perplexity docs)。2025年に BBC が主導した、ChatGPT、Microsoft Copilot、Google Gemini、Perplexity によるニュース回答3,000件超の調査では、その20%に、情報が古いことを含む重大な正確性の問題が見つかりました。
さらに口調の問題があります。Tow Center のテストでは、ChatGPT は134件の記事を誤認しながら、不確かさを示したのは200回答中わずか15回でした。また、有料プランのツールには、正答数が増えた一方で、自信満々の誤答も増えたものがありました。OpenAI のヘルプページも率直にこう述べています。「モデルは、誤った回答でも高い確信を示すことがあります」。AI の出力では、自信のある口調は正確さについてほとんど何も教えてくれません。
モデルに「もう一度確認して」と頼むだけでは足りない理由
手っ取り早いのは、下書きをそのまま貼り直して、正確かどうか聞くことです。それがどうなるかは Mata v. Avianca がすでに示しており、研究でも裏づけられています。ICLR 2024 で発表された論文は、モデルが「外部からのフィードバックなしには自分の回答をうまく修正できず、自己修正によって性能がかえって下がることさえある」ことを明らかにしました(Huang et al.)。
原因は学習のしかたにあります。OpenAI の研究者は、「標準的な学習と評価の手順は、不確かさを認めることよりも推測することに報酬を与えている」と論じています。多肢選択式の試験で、空欄より当てずっぽうが得になるのと同じ構図です。また、現実の問題には答えが出せないものもあるため、精度が「100%に達することはない」とも認めています。モデルが自分の下書きを見直すとき、誤りを生んだのと同じ知識に頼るため、見直しも同じ誤りを繰り返しがちです。
それでも自己レビューには使いどころがあります。2023年の Chain-of-Verification に関する論文は、構造化したやり方が有効であることを示しました。モデルが回答を下書きし、検証用の質問を作り、下書きとは切り離してそれに答え、そのうえで修正する、という流れです。これにより複数のタスクでハルシネーションが減りました。怪しい箇所を洗い出す手段として使い、シロと判定する手段にはしないでください。
根拠を与えても、正しいとは限らない
モデルに元資料を渡して作業させると、誤りの率は下がりますが、ゼロにはなりません。Vectara の公開リーダーボードは、7,700本を超える記事について、各記事の内容だけを使って要約させ、その要約を Vectara 独自の検出モデルで採点します。これだけ易しい条件でも、掲載されているすべてのモデルが、一定の割合の要約に裏づけのない内容を加えています(Vectara)。
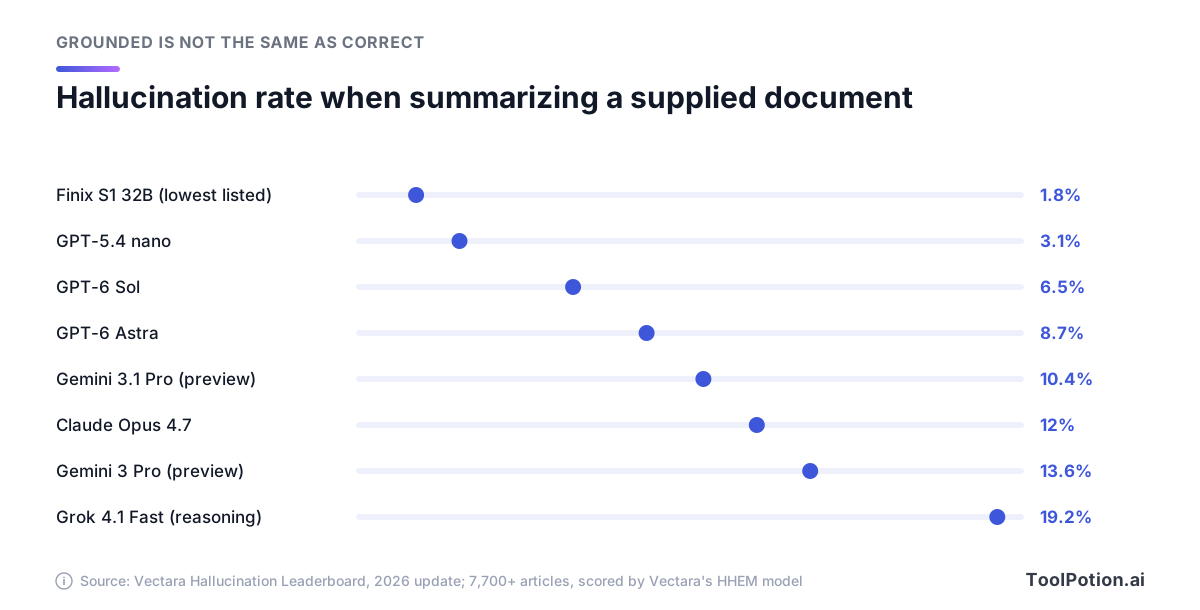
最新の更新では、GPT-6 Sol は要約の6.5%に、Claude Opus 4.7 は12%に、裏づけのない内容を加えました。別のモデルが採点役を務める以上、完璧ではありません。Vectara 自身も、このテストがあらゆる種類のハルシネーションを捉えるわけではないと明言していますし、現行のすべてのリリースが表に載っているわけでもありません。それでも傾向ははっきりしています。実在の判例を検索する法務リサーチツール(Lexis+ AI や Westlaw の AI-Assisted Research など)を調べた2024年の研究でも、17%から33%の確率でハルシネーションが起きていました。グラウンディングは問題を「この情報源はこう書いているか?」という一つの問いに絞り込みます。ただし、その問いは自分で確かめる必要があります。
リスクで仕分ける検証ワークフロー
解決策はトリアージです。下書きの大半は、枠組みやつなぎの文、どのみち自分で主張を擁護できる意見といった「つなぎ」の部分です。記事を支えているのはごく一部の主張で、誤りが害を及ぼすのもそこです。まず仕分けをして、確認に使う時間を効果のある場所に振り向けましょう。
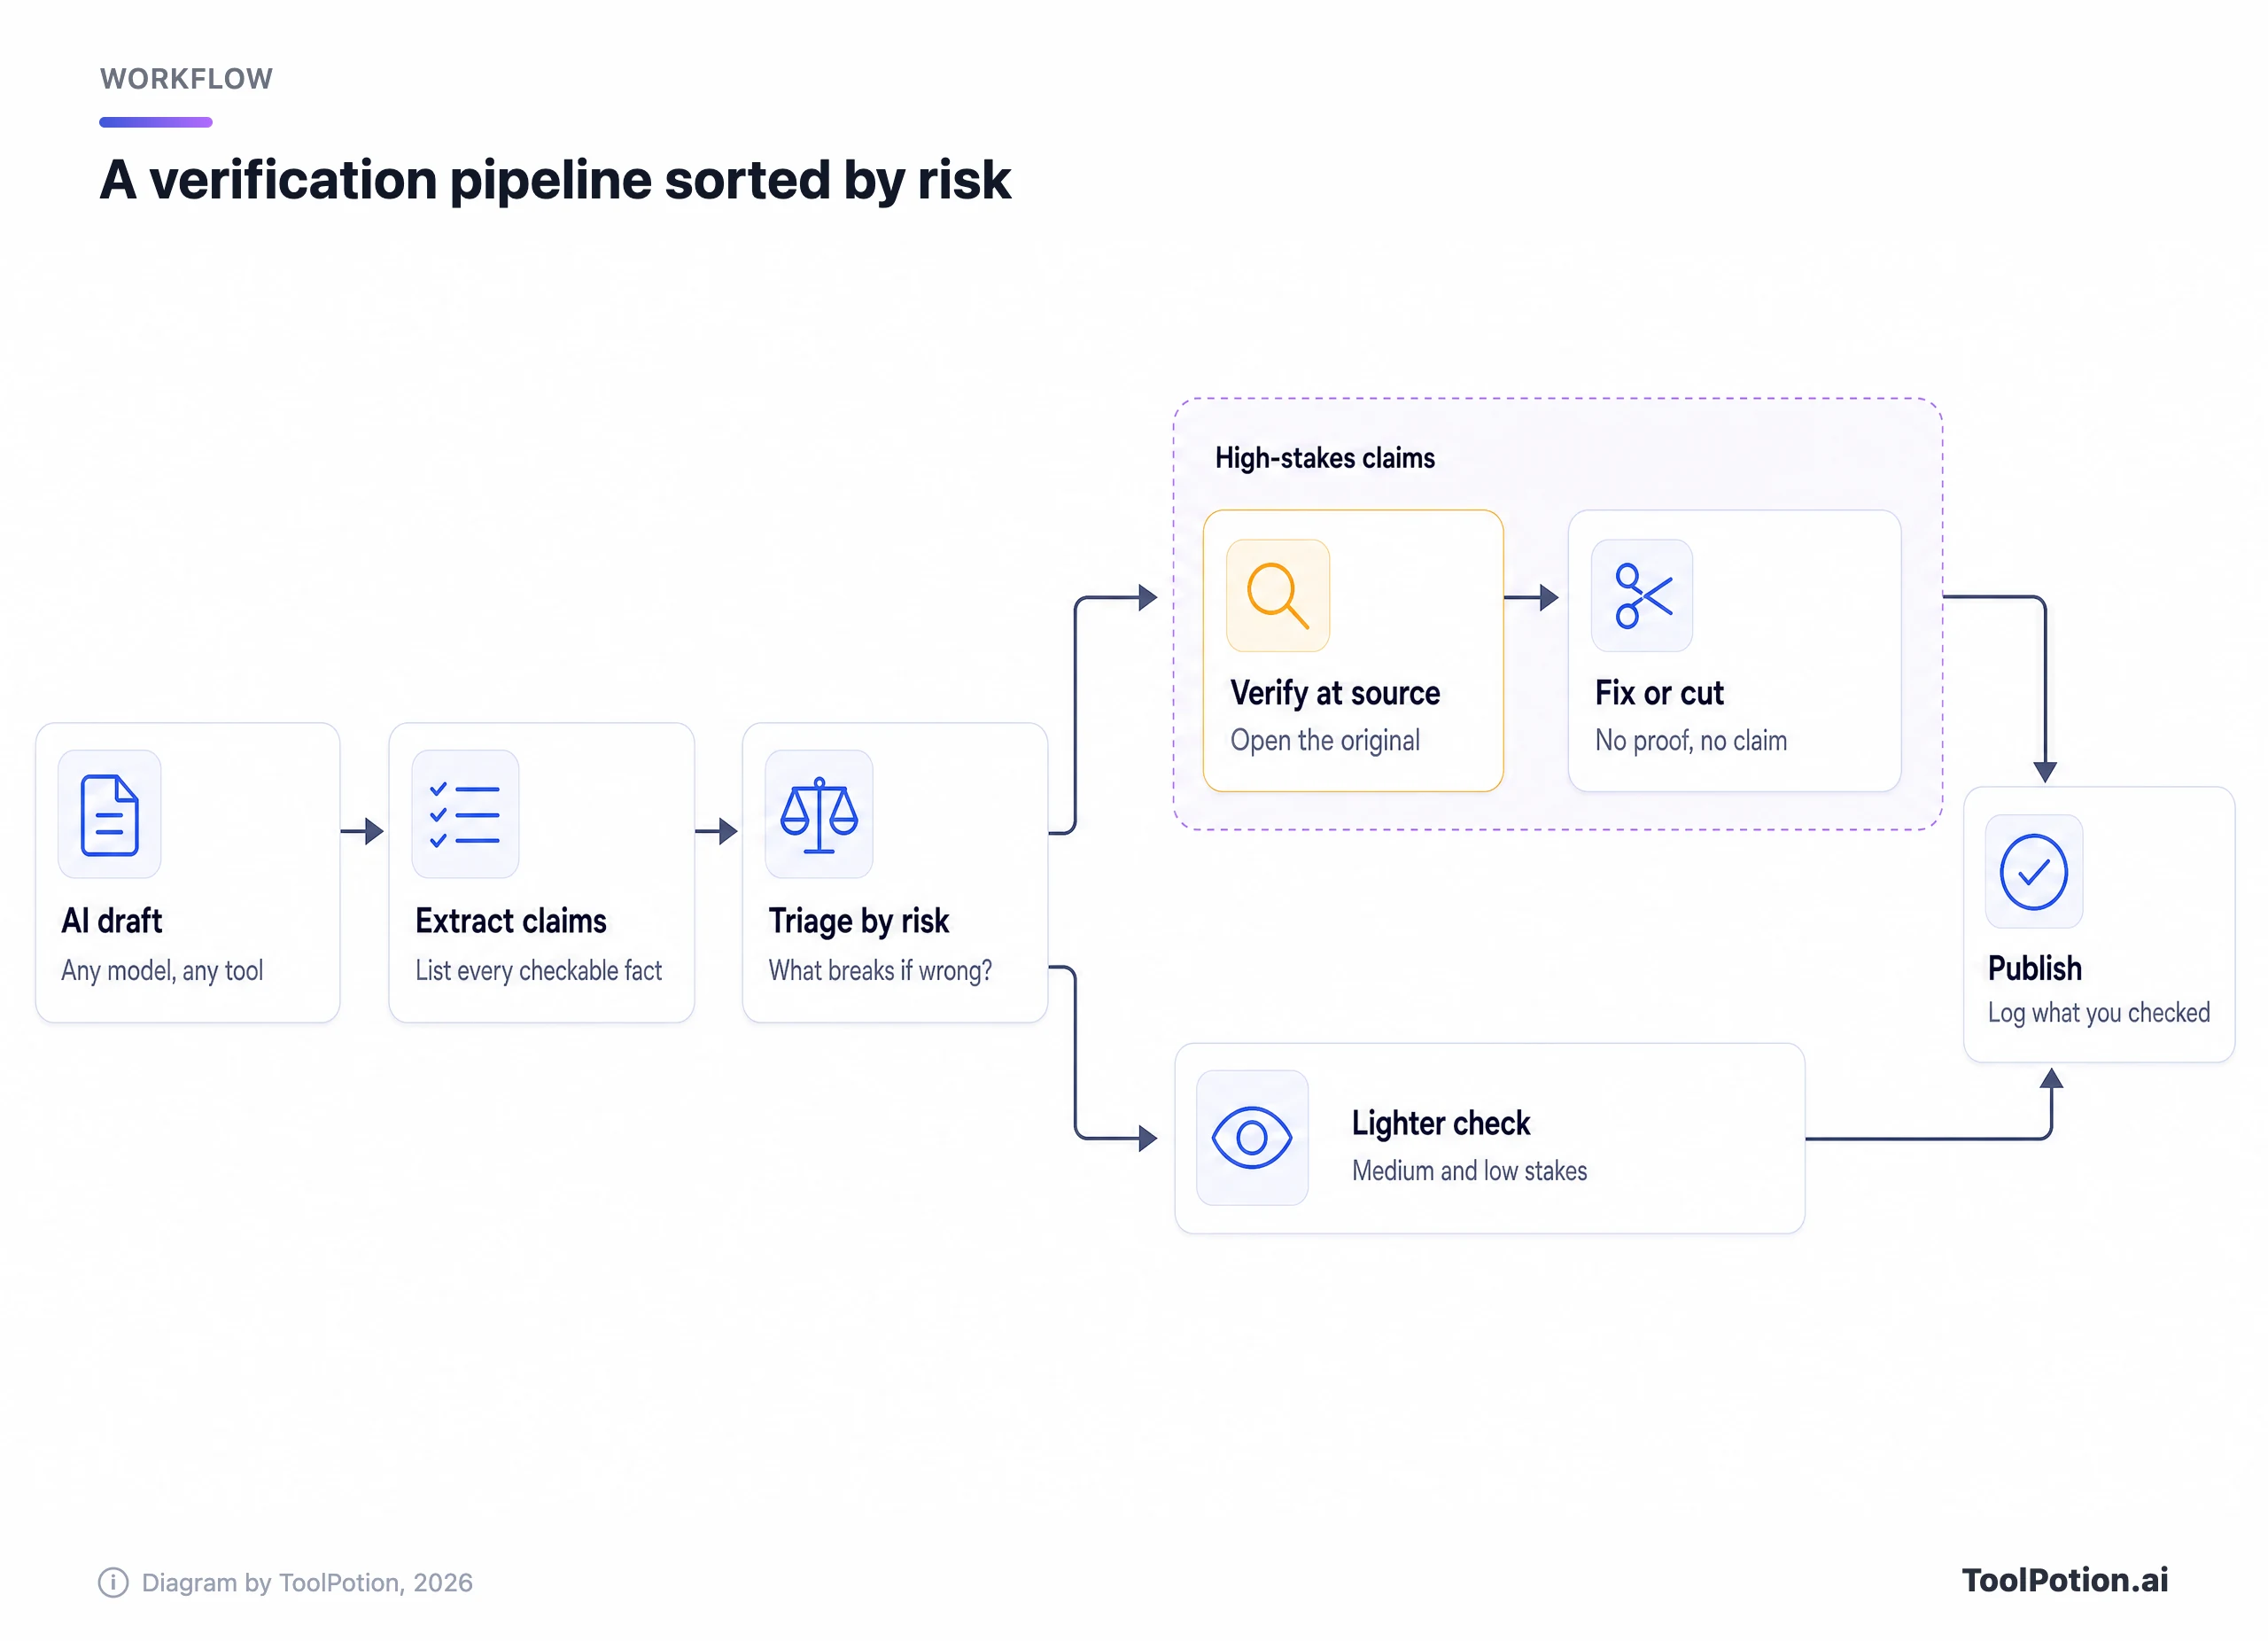
- 主張を抽出する。モデルに、下書き中の確認可能な記述をすべて挙げさせます。人名、数字、日付、発言、引用、因果関係の主張などです。自分では主張していると気づいていなかったことが見つかります。
- 影響の大きさで仕分ける。それぞれの主張が間違っていたら何が起きるかを考えます。法務、医療、金融に関わるものは高リスクです。すべての引用、すべての直接の発言、見出しや要約に使う統計、実名の人物や企業に関する主張も同じく高リスクです。読者が人に話しそうな補足的な背景情報は中リスク。記憶だけでも擁護できる枠組みの話は低リスクです。
- 高リスクの主張は、一次情報で検証する。裁判所の意見書、提出書類、データセット、企業自身のページ、論文そのものです。研究を紹介したニュース記事は、その研究ではありません。
- 中リスクの主張は、後述の水平読みでスポットチェックし、低リスクの主張は編集者の目で読みます。
- 修正、トーンダウン、削除。その主張に見合う時間をかけても確認できなければ、削除するか、「ベンダーによれば」のように出どころを明示します。もっともらしいからという理由で残してはいけません。
- 記録を残す。高リスクの主張ごとに1行、主張、情報源、裏づけの該当箇所を書いておきます。数分で済み、編集者やクライアント、裁判官がいずれ尋ねる問いに答えられます。
労力は、その出力がどこまで広がるかに合わせて調整します。ブレインストーミングなら、丁寧に読めば十分です。クライアントへの納品物なら、高リスクの主張をすべて情報源で開いて確認する必要があります。確認の手間が大きすぎると感じるなら、おそらく下書きの主張が多すぎます。検証するより削るほうが早いことも多いです。
出力がどのリスク層にあたるかわからない場合は、下の質問(最大3つ)に答えてみてください。
このツリーが尋ねているのは、出力がどこへ渡るか、何が書かれているかであって、どのモデルが書いたかではないことに注目してください。強力なモデルなら確率は変わりますが、誤りの責任を誰が負うかは変わりません。
引用・発言・数字の確認方法
主張の種類ごとに、手早くできるテストがあります。特別なソフトは要りません。必要なのは、チャットボットから離れて元の情報源を開く習慣だけです。
引用
まず実在するかを確認します。タイトル、DOI、事件番号、URL を、自分で管理できるデータベースや検索エンジンで検索してください。その引用を出したチャットボット自身には尋ねないことです。次に裏づけを確認します。情報源を開き、その文を支える箇所を見つけます。数分探して見つからなければ、その引用は不合格です。版にも注意してください。Tow Center は、AI 検索ツールが元の出版社ではなく配信コピーを指すことが多いと指摘しており、プレプリントと公刊論文が異なる場合もあります。
発言
特徴的な5〜6語のフレーズを引用符で囲んで検索します。どこにも出てこない、あるいは機械が書いたように見えるページにしか出てこないなら、その発言は捏造とみなします。実在する場合は、前後の段落を読み、発言者、日付、意味を確認します。本物の発言でも、文脈から切り離せば、偽物と同じように誤解を招きます。
数字
計算できるものは再計算します。単位(パーセントかパーセントポイントか、月次か年次か、どの通貨か)、年、分母を確認してください。下書きに「倍増した」とあれば、両方の数字を探します。出典が明示されていない統計は、どれほどもっともらしくても載せません。
最近の出来事と拡散している主張
すべての情報源の日付を確認し、出来事の後に公開された報道を優先します。すでにネットで広まっている主張には、Google の Fact Check Explorer が使えます。公開済みのファクトチェックを検索でき、どの組織がどう評価したかがわかります。画像をアップロードして、過去に検証されたことがあるかを調べることもできます。
公開ボタンを押す前に、このチェックリストで下書きを確認してください。最初の4項目は2倍の重みがあります。
重みづけは裁判データに基づいています。データベースの大半を占めるのは、捏造された引用、誤って示された情報源、偽の発言です。この4つの欄が埋まっていなければ、リストの他の項目を満たしても、その下書きを安全に出せるとは言えません。
裏づけの文献がない主張には水平読みを
開ける引用が付いていない主張もあります。その場合は、プロのファクトチェッカーの習慣を借ります。Stanford の Civic Online Reasoning グループは、ファクトチェッカーの作業を観察したうえで、「ウェブサイトについて知る最良の方法は水平読みだ」と結論づけました。そのページ自体を調べるのではなく、ページを離れて、他の情報源がそのサイトについて何と言っているかを見る方法です。
Mike Caulfield 氏はこの習慣を、SIFT という4ステップの手順にまとめました(Caulfield)。AI の回答にもよく合いますが、調べる対象が、チャットボット本体とそれが選んだリンクになる点だけが違います。
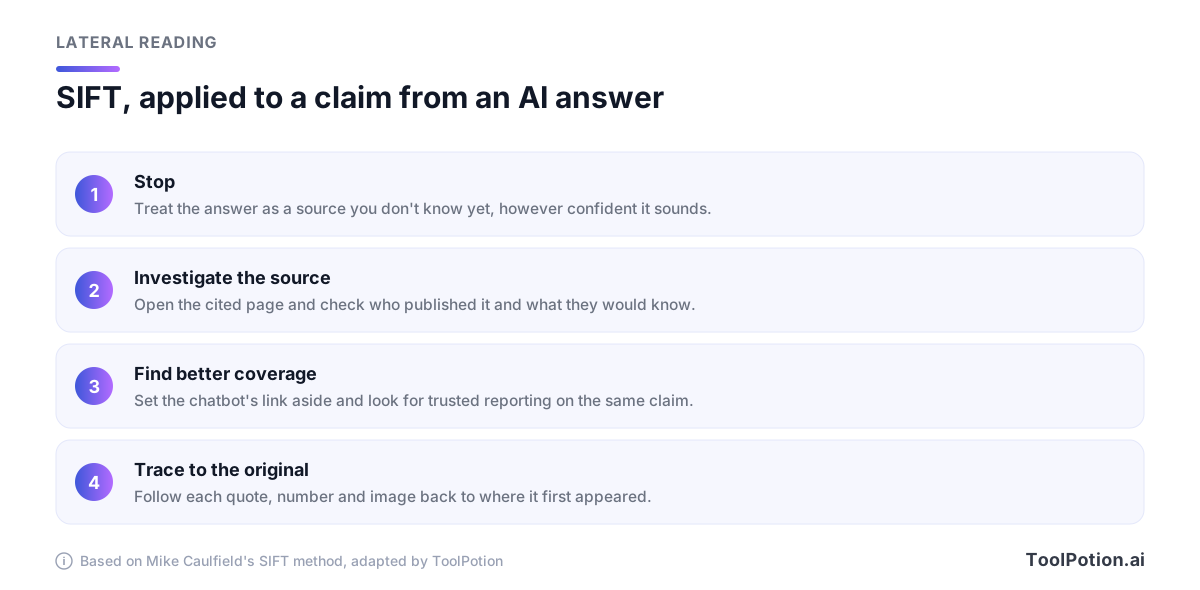
チャットボットを相手にするとき、最も効くのは3つ目の動きです。記事そのものより主張のほうが重要な場合、Caulfield 氏の助言は、「あなたのところに届いた情報源は無視して、その主張について信頼できる報道や分析を探す」ことです。ですから、主張を自分の言葉で改めて検索しましょう。広く報じられているはずの内容に独立した報道が見当たらなければ、それが答えです。
水平読みは、モデルが自分で見つけてきた情報源の判断にも役立ちます。聞いたこともないサイトの実在する URL は、AI が参考文献をどれだけきれいに整えていても、弱い情報源です。
検証しやすい出力に導くプロンプト
プロンプトでハルシネーションをなくすことはできませんが、誤りを見つけやすい出力の形にすることはできます。最良の手引きはベンダー自身のドキュメントです。Anthropic は、推奨する手法は「ハルシネーションを大幅に減らす」が「完全にはなくせない」と述べています(Anthropic docs)。プロンプトの基本的な習慣については、実践的なプロンプトエンジニアリングガイドをご覧ください。
「わからない」と言ってよいと明示する
Anthropic も Perplexity も、開発者に対し、不確かさを認めたり、何も見つからなかったと報告したりすることをモデルに明示的に許可するよう勧めています。それが重要な理由は OpenAI の研究が示しています。SimpleQA ベンチマークでの比較では、質問の52%に回答を控えたモデルは26%を誤答したのに対し、1%しか控えなかったモデルは75%を誤答しました。精度はほぼ同じでした。次の指示を常設にしておくとよいでしょう。
Answer using only facts you can attribute to a specific source.
For each factual claim, name the source and give a short direct quote from it.
If you are not sure of something, write "Unknown" instead of guessing.
Mark anything that is your own inference or opinion with [Inference].
結論の前に引用を出させる
Anthropic のドキュメントは、長い文書では、タスクに入る前に原文どおりの引用を抜き出させ、その後で各主張に対応する裏づけの引用をモデルに探させ、裏づけられない主張は撤回させることを推奨しています。実際には次のようになります。
Step 1: From the document below, extract the exact quotes relevant to [your question]. Number them. If none are relevant, write "No relevant quotes found."
Step 2: Answer using only the numbered quotes, citing them like [2].
Step 3: Review each sentence of your answer. If a sentence has no supporting quote, delete it and mark the spot with [].
惜しい一致を指摘させる。簡潔さを強要しない
Perplexity のガイドには、真似する価値のあるルールがあります。「関連はあるが一致しない結果(たとえば、年が違う、親会社や子会社だった、など)を見つけたら、回答する前にその不一致を明示すること」。これにより、正しい事実が別の対象のものだったという、目視ではきわめて見つけにくい誤りを拾えます。同ガイドのルール例では、情報源をドメインで引用し、「完全な URL は書かない」ようにもモデルに指示しています。
長さも関係します。パリの AI テスト企業 Giskard は、GPT-4o、Mistral Large、Claude 3.7 Sonnet に簡潔な回答を求めると精度が下がることを発見しました。「短く答えるよう強いられると、モデルは一貫して正確さより簡潔さを選ぶ」ためです。同じ調査では、ユーザーが自信たっぷりに述べた物議を醸す主張に対して、モデルは反論しにくくなることもわかりました。「X が成り立つ理由を説明して」のように主張を前提にせず、「X は本当ですか?」と中立的に質問しましょう。
主張を抽出して、2回実行する
このプロンプトは、ワークフローの最初のステップで使います。自分で書いたものを含め、どんな下書きにも使えます。
List every factual claim in the text below as a numbered table with three columns: the claim, its type (citation, quote, number, date, name or other), and the kind of source that would prove it.
Do not judge whether the claims are true. Do not add claims that are not in the text.
Anthropic は、ベストオブN方式のチェックも提案しています。同じプロンプトを複数回実行して結果を比べ、回答が一貫しなければハルシネーションの可能性が高いと見るものです。OpenAI が博士論文のタイトルで3通りの答えを見たのと同じ症状です。実行ごとの食い違いは、どこを調べるべきかを教えてくれます。一致していても、何の証明にもなりません。
情報源に基づくツールは、ある程度までは役に立つ
別の種類のツールは、モデルが参照できる範囲を絞り込みます。これにより「これは本当か?」という問いが「情報源はこう書いているか?」に変わり、確認が速くなります。ただし、確認自体がなくなるわけではありません。
Google は今年の初めに NotebookLM を Gemini Notebook に改称し、単独のリサーチツールとして残しました。Google によれば、利用者は3,000万人を超えています(Google)。チャットでは、追加したソースだけから回答し、「ソースからの直接の引用、テキスト、画像を出典として使い」ます。引用にカーソルを合わせると引用された文章が表示され、クリックすると前後の文脈の中でその箇所に移動できます(Gemini Notebook Help)。そのため、裏づけの確認が素早くできます。ただし、限界も知っておきましょう。Google のヘルプによると、ペイウォールのあるウェブページには対応しておらず、Google ファイル内の脚注やコメントも取り込まれません。ウェブ検索やコード実行ができる新しいエージェント型チャット機能は実験的と位置づけられ、「必ず再確認してください」という注意書きが付いています。
Perplexity のような回答エンジンは、各回答にリンクを付けます。出典のないチャットボットより確実に前進しています。それでも、リンクは開いて確かめる必要があります。Perplexity は2025年の Tow Center のテストで37%のクエリを誤り(その後ツールは変わっています)、Google 自身の Gemini ヘルプにも「すべての回答に関連リンクや情報源が含まれるわけではありません」と書かれています。
研究に関する主張には、オープンなウェブではなく論文に基づいて回答する学術検索ツールがあります。Consensus は査読済みの文献を検索し、「十分な関連エビデンスが見つからなければ、そう伝えます」と述べて、空白を埋めずに済ませます。Elicit は、AI が生成するすべての主張に、文単位の引用で裏づけを付けるとしています。Scite は、その後の研究が論文の知見を支持したのか否定したのかを表示します。他のツールが見逃す失敗、つまり実在はするがその後に異論が出た研究を拾えます。
自前のパイプラインを組むなら、Anthropic の Citations API は各主張の根拠となる正確な箇所を返し、Anthropic のドキュメントによれば、その引用は「提供された文書への有効なポインタを含むことが保証されて」います。これで架空の情報源は排除できますが、その箇所が付随する文を本当に裏づけているかまでは確認できません。参考文献チェッカーは最終段階に位置します。GPTZero は参考文献リストをスキャンするハルシネーション検出機能を提供しており、同社のチームは KPMG のレポートを指摘したほか、今年初めには、主要な AI 学会 NeurIPS に採択された51本の論文から100件のハルシネーション引用を見つけたと TechCrunch が報じています。
| ツールの種類 | 回答の根拠 | それでも確認すべきこと |
|---|---|---|
| ノートブック型ツール(Gemini Notebook) | アップロードしたソース | 引用された各箇所が主張を裏づけているか、ソース自体が正しいか |
| 回答エンジン(Perplexity、検索付き ChatGPT) | リアルタイムのウェブ検索結果 | すべてのリンクを開き、日付を確認し、元の発行元を探す |
| 研究検索(Consensus、Elicit、Scite) | 学術論文 | 論文の実際の知見と限界、のちに出た反証 |
| 引用 API(Claude Citations) | 自分で渡した文書 | 有効なポインタ以上に、主張が裏づけられているか |
| 参考文献チェッカー(GPTZero) | 書誌レコード | 実在する参考文献が、下書きの主張どおりのことを述べているか |
選択肢を比べるには、AI リサーチアシスタントのボード、AI 検索エンジンのボード、学術文献の検索ボードをご覧ください。機能や料金については、AI リサーチアシスタントと AI 検索エンジンのまとめ記事でさらに詳しく解説しています。
よくある質問
別の AI モデルで、あるモデルの出力をファクトチェックしてもいいですか?
最初の一次チェックとしてなら、はい。2つ目のモデル、特に検索機能付きのものは、1つ目が見逃した誤りのいくつかを指摘してくれますし、食い違いはどこを調べるべきかを示してくれます。ただし、何かを確定させることはできません。両方のモデルに同じ盲点がある可能性があるからです。指摘は ToDo リストとして扱い、一つひとつ情報源で決着をつけてください。2つ目のアシスタントを選ぶなら、ChatGPT の代替ツールガイドで主な選択肢を比較しています。
AI 検出ツールは事実を確認してくれますか?
いいえ。Originality.ai detector のようなツールは、文章が機械で書かれたかどうかを推定するだけです。主張が真実かどうかについては何も語りませんし、人間が書いた下書きでも同じくらい間違っていることはあります。ファクトチェックには元の情報源が必要です。
AI の下書きのファクトチェックには、どのくらい時間がかかりますか?
長さではなく、下書きに含まれる高リスクの主張の数で決まります。トリアージの後で数えてみてください。統計4つと発言2つを含む2,000語の解説記事なら、短い作業で済みます。一方、引用だらけの1ページのメモはそうはいきません。
ChatGPT などのチャットボットを情報源として引用してもいいですか?
事実については不可です。OpenAI 自身も「ChatGPT は最終的な情報源ではなく、第一稿として使ってください」と助言しています。確認した元の文書を引用しましょう。モデルのテストのように、AI の出力そのものが対象である場合は、どのモデルをいつ使ったかを明記してください。
ディープリサーチエージェントを使えば、確認は不要になりますか?
いいえ。OpenAI の deep research のようなエージェントは、多数のウェブ情報源から出典付きのリサーチレポートをまとめますが、それは開くべき引用が増えるということであり、確認すべき主張が減るわけではありません。情報源の誤った示し方という問題は、引用されたすべての文に当てはまるので、レポートが長くなるほどトリアージの工程が重要になります。