

「私たちは、この証明をまだ完全に理解しているとは主張しません」。OpenAIが、同社の主張するYang-Mills問題の成果を検証するために任命した委員会の言葉で、Scientific Americanが引用しています。物理学者のDavid Gross氏が率いるこのグループは、問題の半分についての証明が、数学の証明を検証するプログラミング言語であるLeanで正しいと確認できたと発表したばかりでした。それでも、証明がどう機能しているのかは説明できませんでした。
最新のAI×科学の資料を読み込みました。上の記事、Anthropicの投稿5本、OpenAIのウェットラボ向けベンチマーク、PSIというスタートアップを扱ったTechCrunchの記事、そしてAIエージェントがメキシコの公式登録簿に載っていないマヤの遺跡を見つけたと報告するブロガーの投稿です。見出しはどれも、中身よりはるかに先走っています。そこで、よく聞かれる6つの主張を取り上げ、それぞれを情報源が実際に述べている内容と照らして検証しました。
主張1:AIはもう自力で新しい科学を発見している
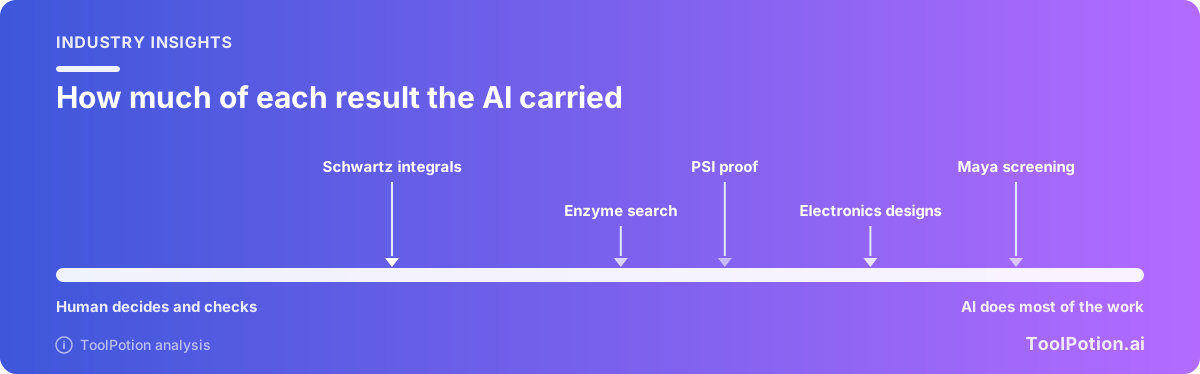
判定:自力ではありません。 優れた事例は本物ですが、どの事例でも、問いを選んだか、検証を行ったか、あるいはその両方を人間が担っています。
まず生物学から。Anthropicによると、Claudeのエージェントは、CRISPRに似た反復配列を持つ酵素システムを発見しました。使われたのは約950のエージェント、2億1,000万トークン、21時間です(Anthropic)。反復パターンに気づいたのは1つのエージェントでした。ただし、最初のプロンプトを用意し、ラボでの作業をすべて行ったのはAnthropicの科学者です。Claudeが挙げた候補の大半はレビューで除外され、成果はプレプリントの段階です。このシステムの主要な機能についての研究も、まだ続いています。投稿には、Claudeはこのシステムの特徴的な性質に「最初に気づいたと思われる」、Claudeは「異常を自律的に検出できる」とあります。探索の段階についてなら妥当ですが、それ以外については言い過ぎです。同じ投稿で、プレプリントを読んだMITとBroad InstituteのFeng Zhang氏は、これを「AIエージェントが生物学的発見に貢献できることを示す刺激的な例」と評し、この発見は「さらに調査する価値がある」と述べています。
Anthropicの客員研究員である物理学者のMatthew Schwartz氏は、ほかの誰よりも率直です。Anthropicへの寄稿で、Claudeを使って30個の積分を最初から最後まで計算させ、15個は既知の結果の再現、残る15個はこれまで計算されたことのないものだったと報告しています(Anthropic)。向いている対象を「Claude向き(Claude-shaped)」の問題と呼び、「科学的に価値のあるものを出させるには、かなりの手取り足取りが必要になりうる」と付け加えています。外部の専門家を招いたところ、「ほとんどの場合、Claudeは技術的には正しかったものの、専門家が方向づけてくれるまでは、結果はそれほど面白いものではなかった」そうです。Claudeは「昔の論争、つまり引用は多いが長らく忘れられた論争を好む傾向があるようだ」とも言います。何を解く価値があるかという判断は、人間の側に残ったままでした。
次にPSIです。TechCrunchによると、スタートアップラボPhysical Superintelligence(PSI)の技術スタッフであるDavid Turturean氏は、Anthropicの Fable 5.2 モデルに早期アクセスして、量子コンピューティングの18年来の未解決問題、Aaronson-Ambainis予想を解きました(TechCrunch)。この問題を提起したScott Aaronson氏は、証明は完全には理解できていないものの、Leanで自動形式化され、PSIが共有したトップ研究者のチームが説明してくれたので正しいと考えている、と書いています。Turturean氏自身の説明は控えめです。「これは否定的な結果で、『もうそっちは探さなくていい』と分かるようになるということです」。この解決が閉ざしたのは、量子による高速化へ至る道の1本であって、すべてではないようです。
私たちの見方では、これは疲れを知らない高速な協力者であり、問題を選ぶ人が別に必要です。それだけでも大きな成果です。ただ、自律ではありません。各社自身の投稿も、注意書きまで読めばそう書いています。
主張2:結果は検証済みである
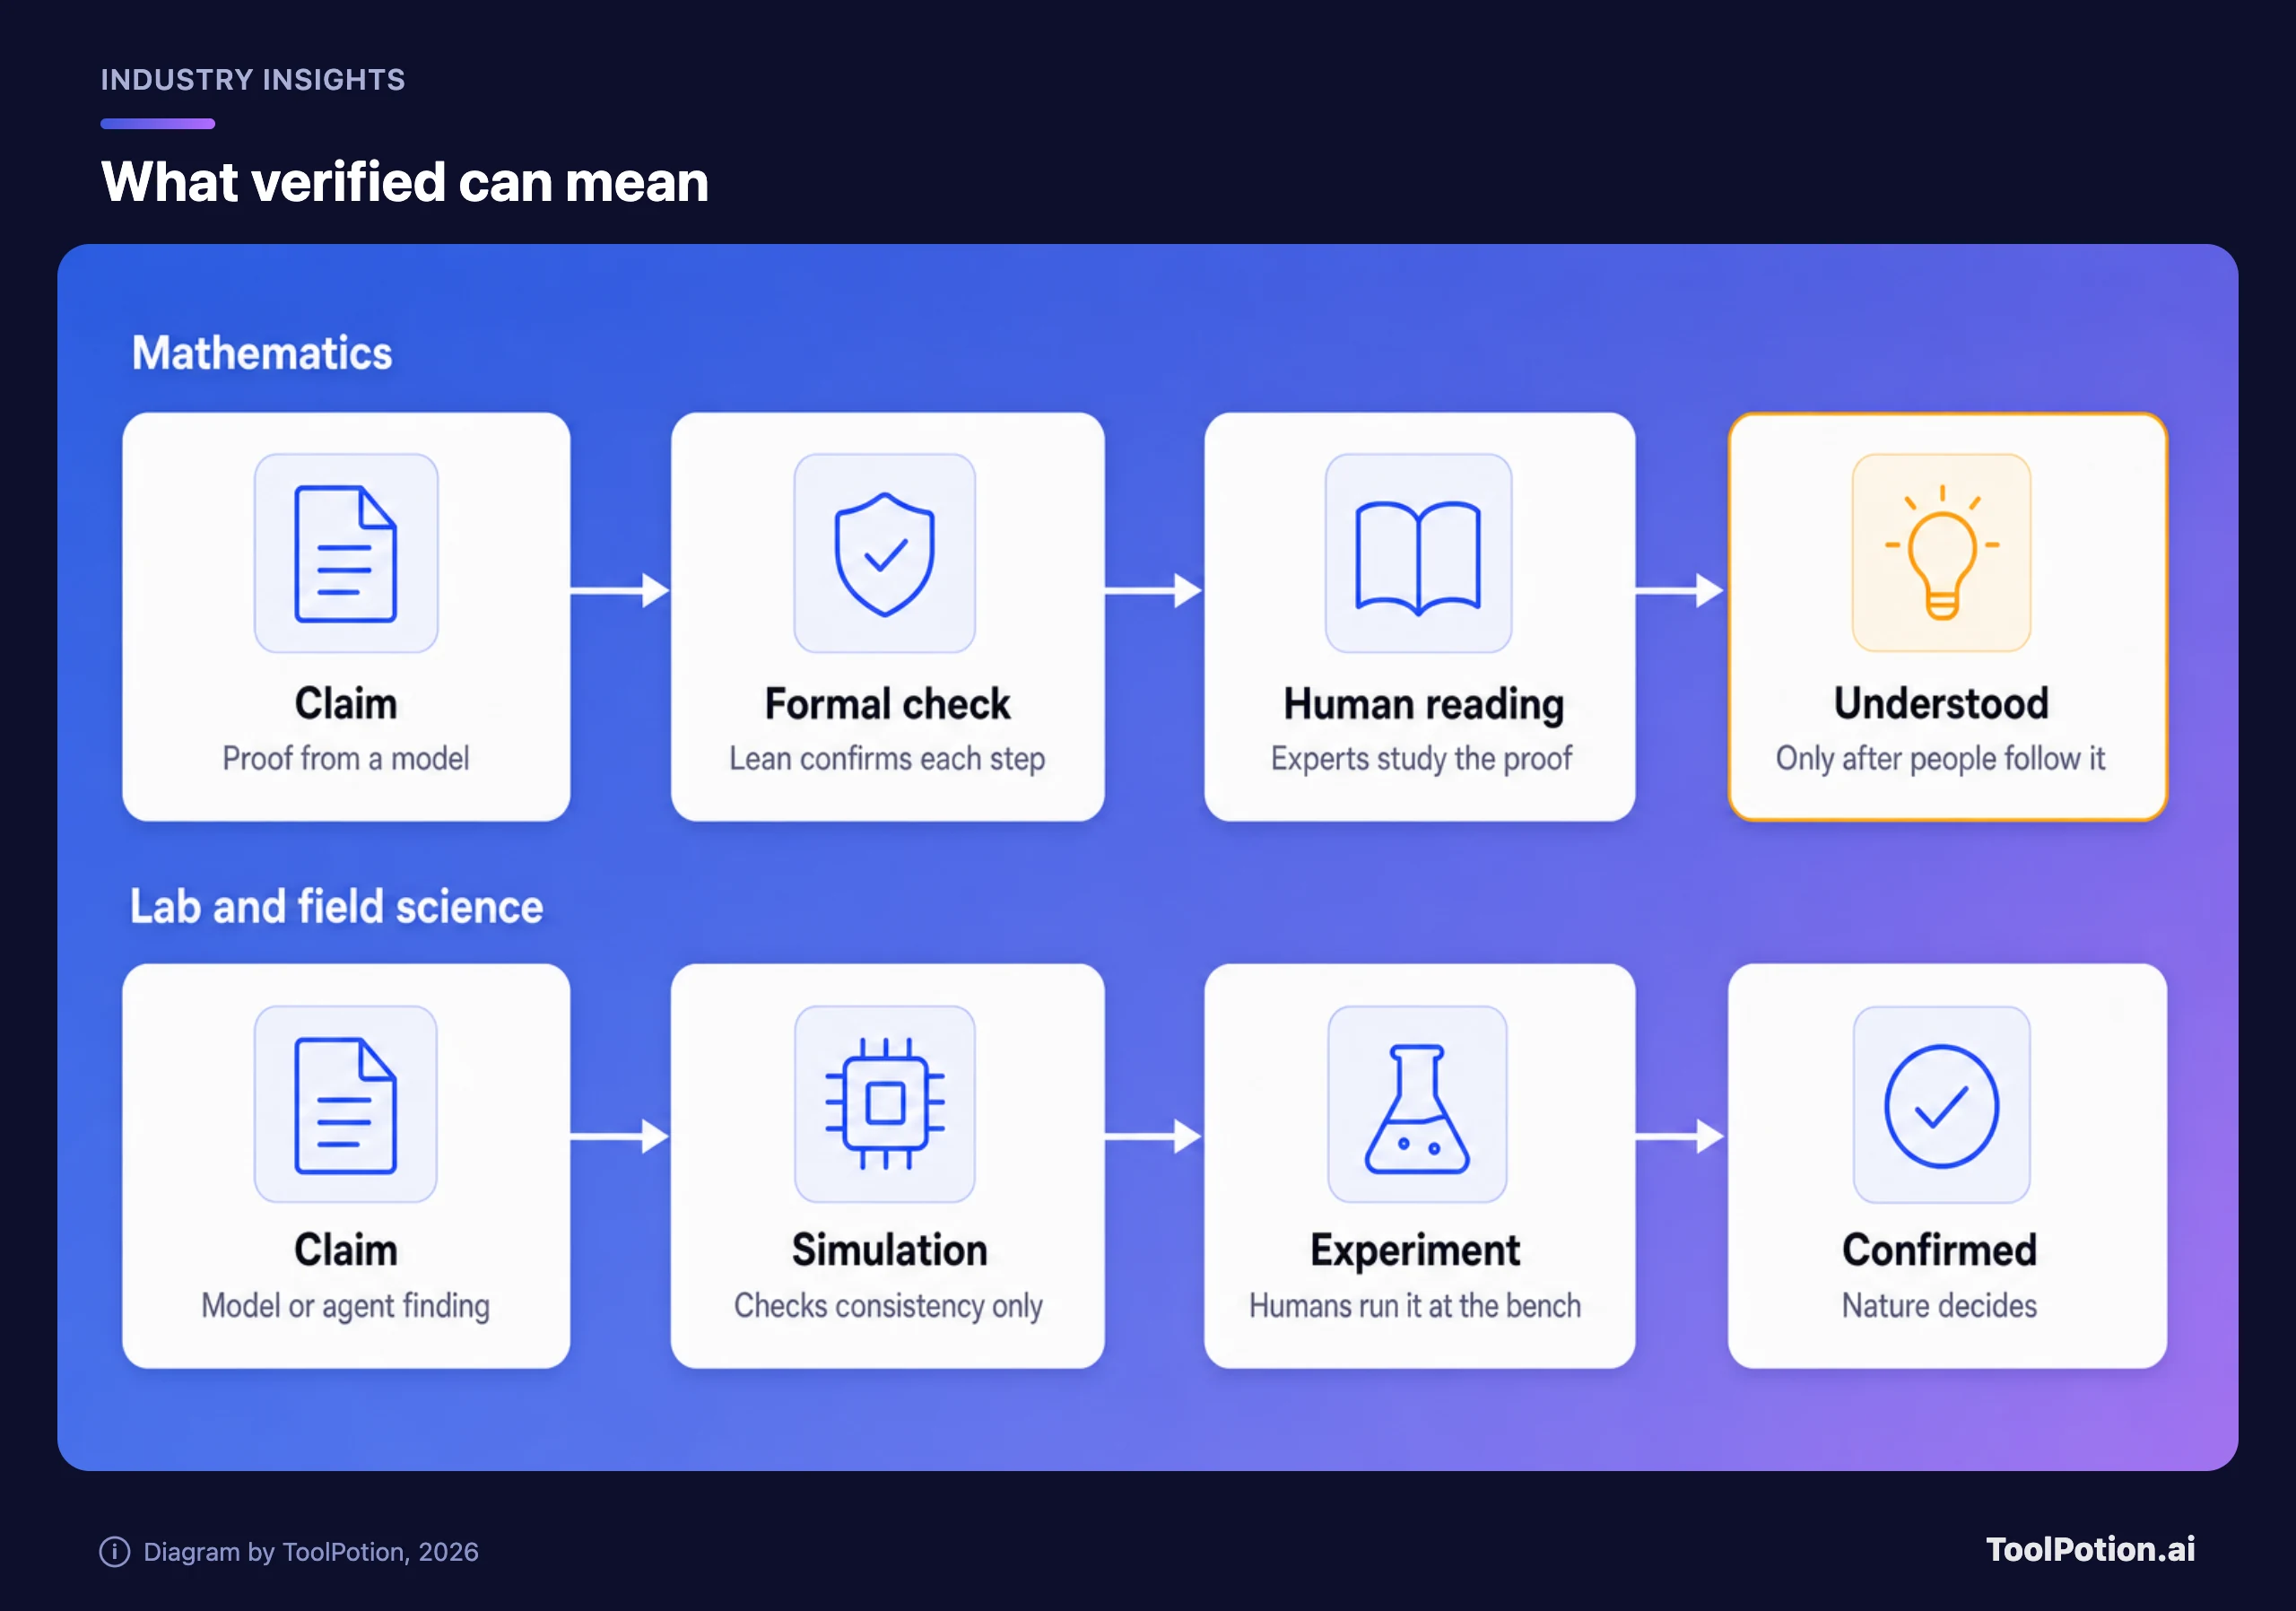
判定:部分的にそうです。数学では形式検証ツールは強力なテストになります。それ以外の分野では、「検証済み」がシミュレーションから登録簿の照会まで、さまざまな意味になりえます。
数学では、Leanは、証明が与えられた命題から導かれることを機械的に確認できます。これは強力なチェックで、PSIやOpenAIの成果が真剣に受け止められている理由でもあります。ただ、Scientific Americanの報道は限界も示しています。OpenAIの主張が扱うのはYang-Mills問題のうち存在に関する半分で、もう半分の質量ギャップは未解決です。委員会は、Leanのコードを読み解くのにOpenAI自社のAstraモデルを使っており、証明をまだ理解しているとは主張しないと明言しています。
次に公開性の問題があります。Scientific Americanによると、この「シェパード(導き手)」方式は、OpenAI関連の諮問グループによる透明性の推奨に反しており、閉鎖的だと見る一部の数学者の反発を招いています。Leanの証明は現在は公開されています。NYUのScott Armstrong氏は、ようやく公開されて嬉しいと述べたうえで、こう付け加えました。「このレビューは、公開の場のほうがもっと効率的に、素早く行えます」(Scientific American)。私たちも同意見です。OpenAIが任命した委員会しか見ていない証明は、レビューを待つ主張にすぎませんでした。そのレビューがようやく始められます。
数学の外にはLeanがありません。PSIのCEOであるMatt Pines氏はTechCrunchに対し、物理学が数学と違うのは「現実のモデルに対して、自然が票を持っている」からだと語り、機械が主導する理論物理は「まだそこまで来ていないが、向かってはいる」と述べました。Schwartz氏は「自動チェックはいまだに信用できない」と指摘しています。そして後で触れるマヤの投稿には公式の返答があり、メキシコの研究所は、報告された場所に登録された遺跡はないとしました。これで確認できたのは、登録簿に載っていないことです。遺跡の存在が確認されたわけではありません。
主張3:エージェントはラボを運営できる
判定:まだできません。 計画、設計、分析まではできます。ピペットを握ったりはんだ付けをしたりするのは、いまも人間です。
Anthropicの電子回路に関する投稿は、最近でもっとも強力な例で、全文を読む価値があります。基板メーカーのDiodeと協力して(AnthropicはDiodeと商業上の関係があるとしています)、Claude(Fable 5.2 モデル)は、USB-Cスピーカーフォン、音声アシスタントのハブ、携帯型のバーチャルペットを、回路図からレイアウト、ファームウェアまで設計しました(Anthropic)。Diodeのエンジニアは、Claudeの設計ファイルから基板を製造し、試作機を手作業で組み立ててテストしています。Claudeは試験機器にも基板の製造装置にも接続されていなかったためです。これらのデバイスは、電気的な妥当性検証、アンテナの調整、熱試験、認証を受けていません。投稿にはベンチマークでの向上(Diode社内のPCBレイアウトテスト「PCB Gym」で、前モデルの25%から69%へ)も載っていますが、これはAnthropicの依頼で実施されたテストにおけるAnthropic自身の数字です。コストも、本文ではなく、グラフの軸にしか示されていません。
生物学の側では、OpenAIが100タスクのベンチマークBioBasicsBenchを公開しました。AIエージェントが生の実験データをどれだけ解釈でき、日常的なウェットラボの科学をどれだけこなせるかを測るものだとしています(OpenAI)。ベンダーが作ったテストであり、ベンチマークは、ベンダー以外の人が実行するまでは主張にすぎません。
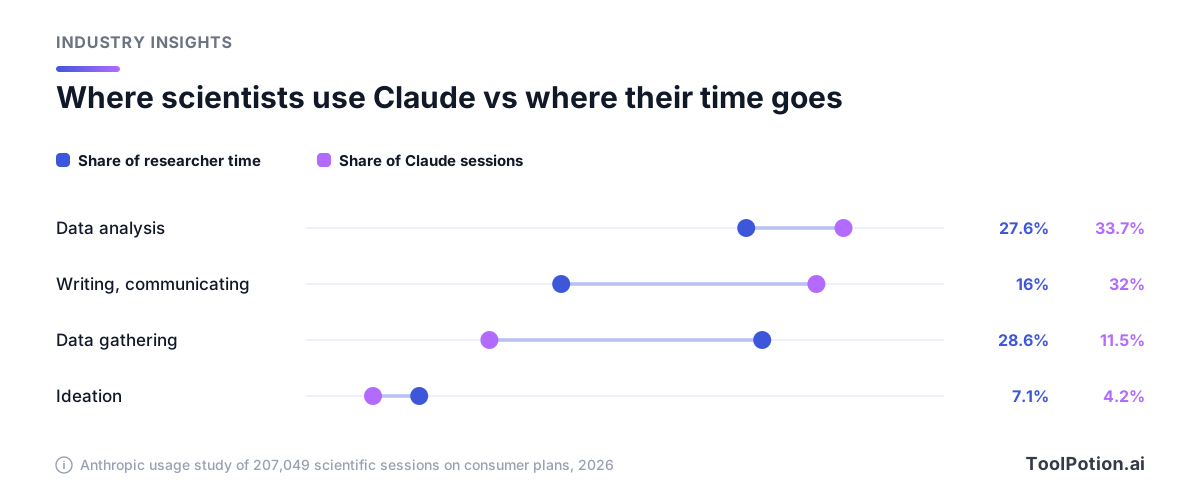
Anthropicが、個人向けプランでの科学分野のセッション207,049件を調べた利用調査も、実際の現場で同じ構図を示しています。データ収集は研究者の時間の28.6%を占めますが、Claudeでのセッションでは11.5%にとどまり、臨床データや生化学データの収集のように物理的な制約がある領域で差がもっとも大きくなっています(Anthropic)。調査自身の言葉では、「物理的なボトルネックは依然として強力」です。
主張4:いまや誰でもできる
判定:始めるだけなら誰でもできます。ただ、検証に耐えるものにするには、その分野に詳しい人が必要です。
マヤの件は、もっとも分かりやすい試金石です。自分は考古学者ではないと言うPietro Miotti氏は、48のエージェントに、NASAが公開しているおよそ1,200平方キロメートル分のライダーデータを調べさせました。その結果、広場とピラミッドのある丘の上の遺跡が見つかり、72時間足らずで公式の返答まで得ました(本人の投稿)。手法についての彼の一文は、潔いほど素っ気ないものです。「特別なモデルや分類器は使っていません。エージェントは文字どおり画像を見ただけです」。
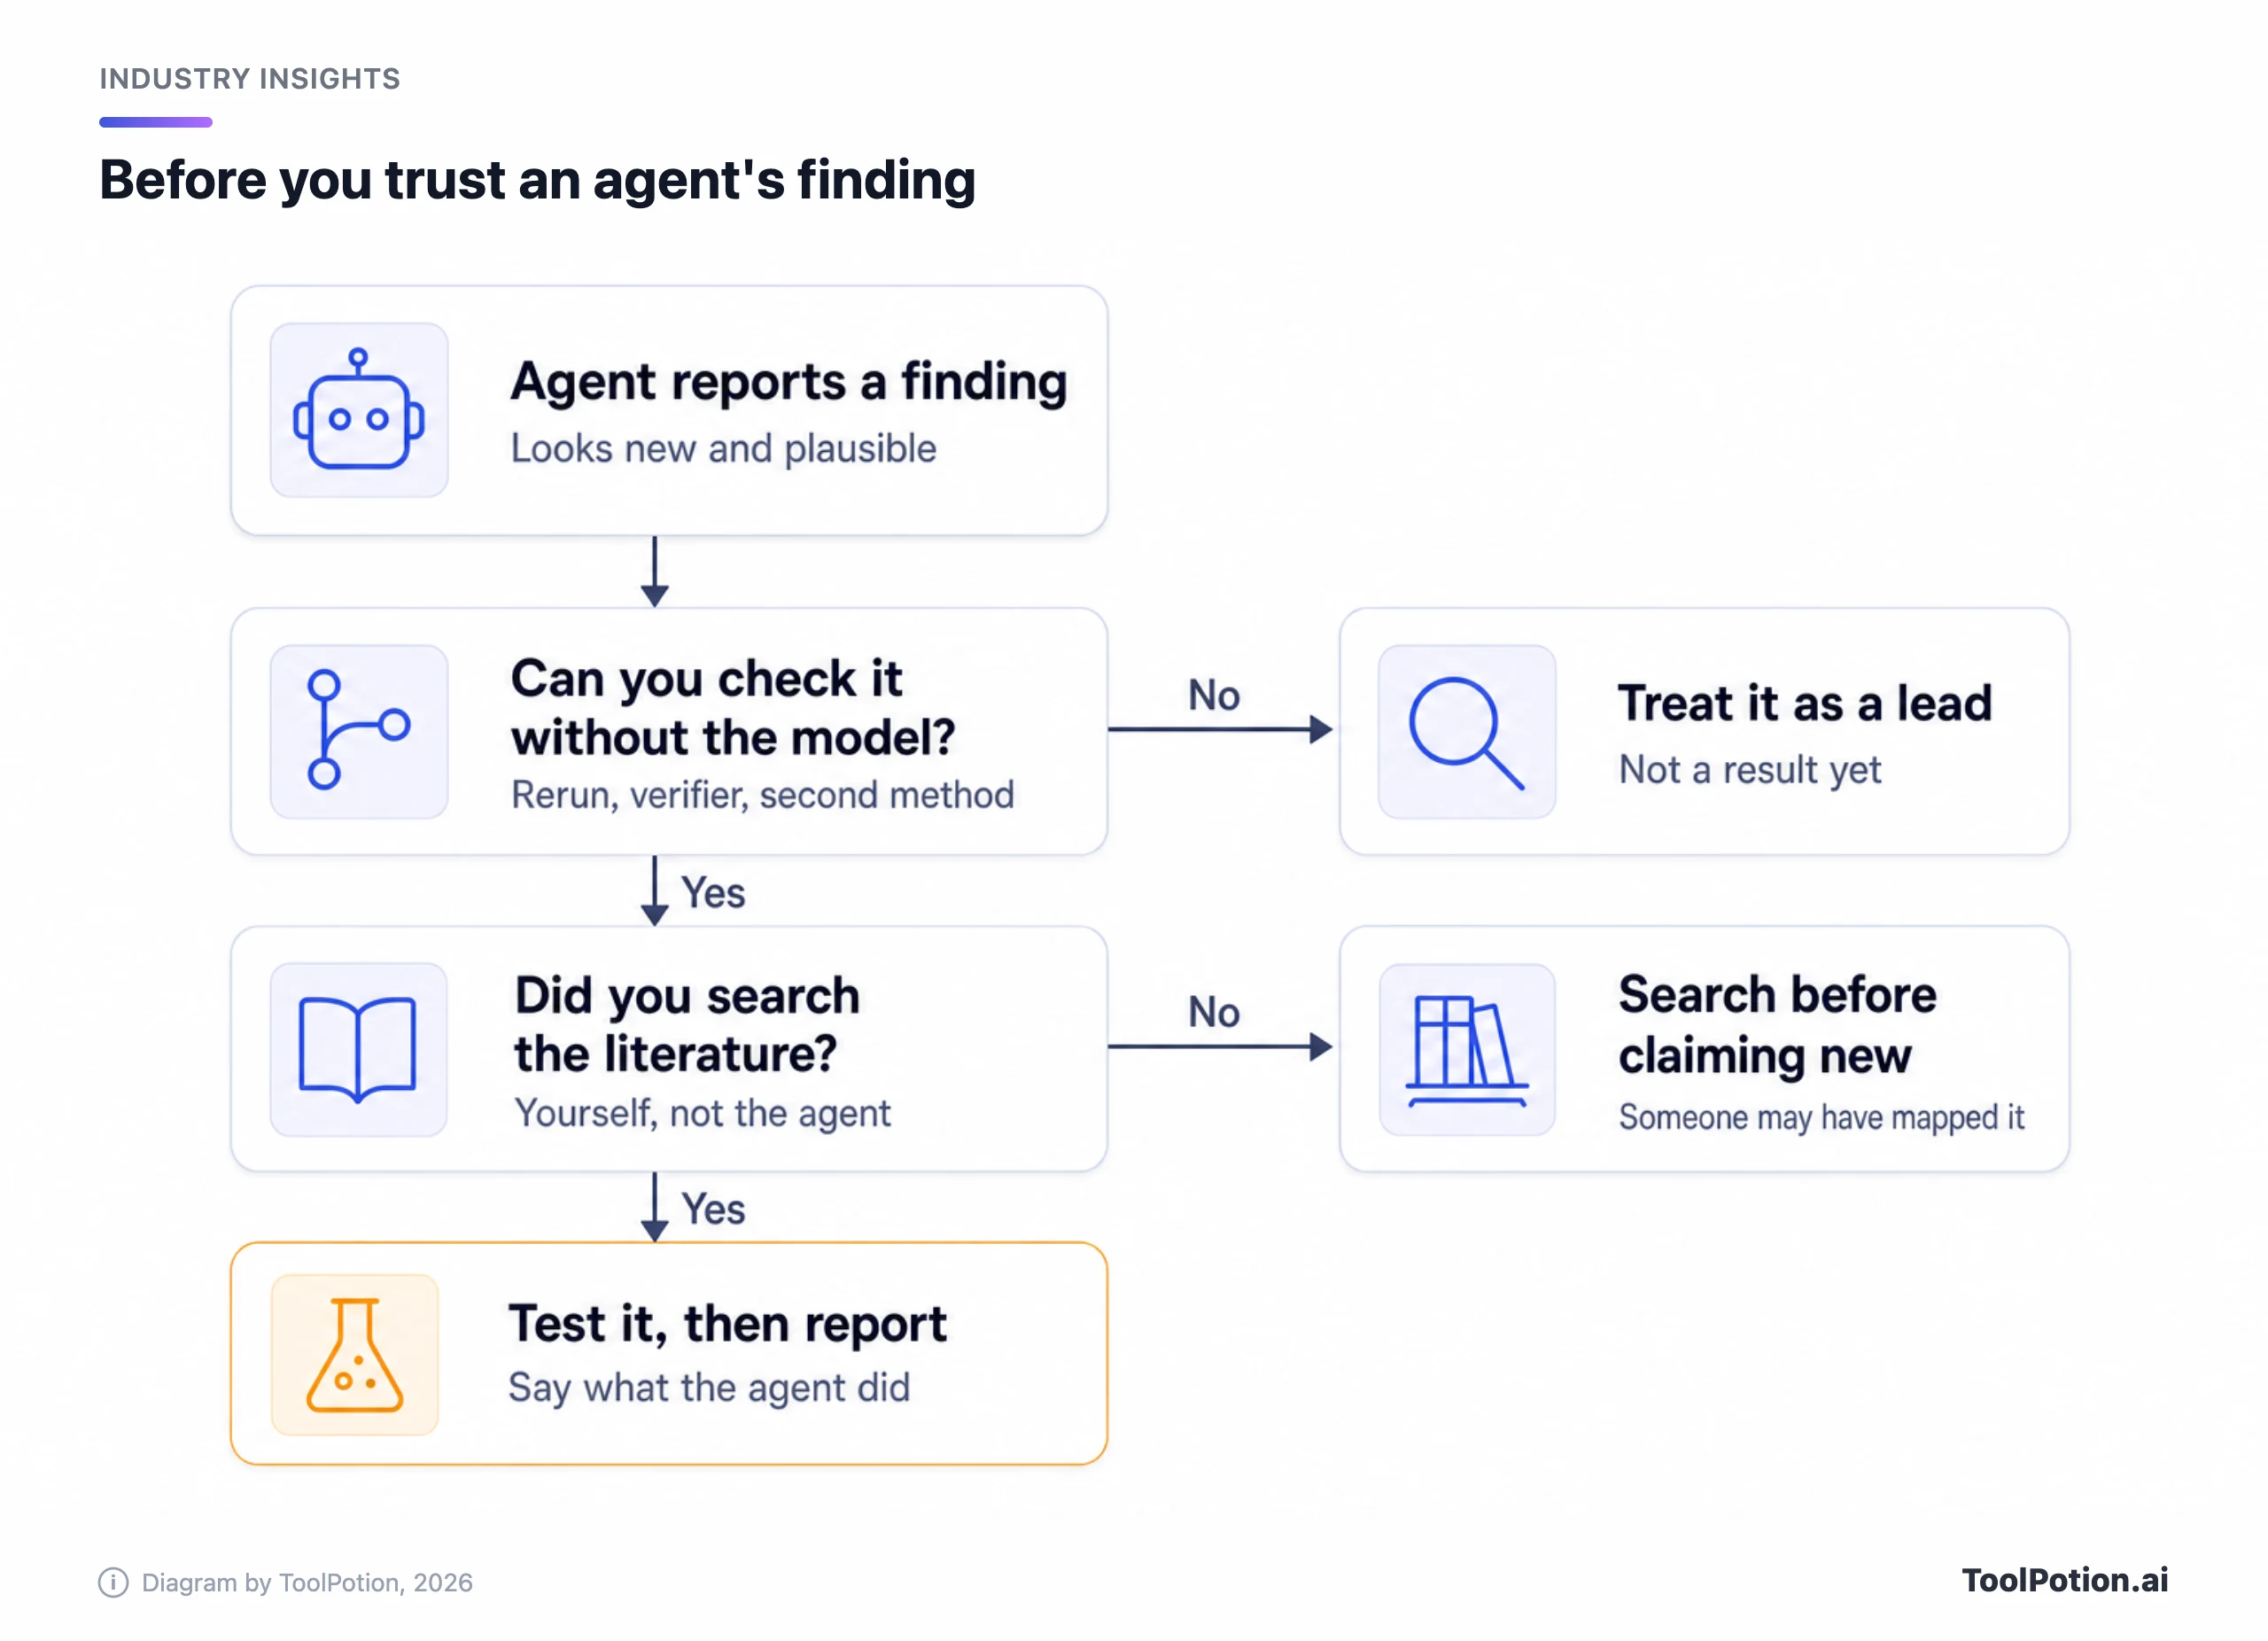
そして訂正です。いまはページの冒頭に載っています。「エージェントは文献を調べる段階で見落としたので、発見したのではなく再発見したことになります」。この遺跡は、2025年にEstrada-Belli氏らの論文ですでに地図化されていました。メキシコの登録簿に載っていなかっただけです。これを最初に書いたMiotti氏は立派です。彼はまた、スペイン語は話せず、報告書の翻訳もエージェントを信用したと述べています。古典期についての話は「エージェントとの長いチャットから出た推測」で、復元イメージはAI生成です。現地調査についての記述はありません。
私たちの解釈では、これは安価なスクリーニングの好例ではあっても、発見の例としては不十分です。「見る」ことは、いまやほぼ無料です。けれど、以前に誰かが見ていないかどうかを知るには、いまも専門家が必要です。少なくとも、エージェントが適切に行わなかった文献検索が要ります。PSIのやり方は違っていて、参考になります。Anthropicのモデルがリリース間近になるまで結果を伏せ、その間に、説明できる研究者たちに見せたのです。PSIのアドバイザーを務めるノースイースタン大学のJim Halverson教授は、TechCrunchに「ベストプラクティスはまだ固まっていません」と語りました。
主張5:科学者はまもなく自動化される
判定:未証明です。そして最も声の大きい主張は、その主張に利害を持つ人たちから出ています。
Turturean氏はTechCrunchに「これが自分の出す最後の論文になるかもしれない、という考えを全面的に受け入れています」と語りました。Pines氏は、6〜9か月前に投資家と話していたときは、理論物理がまもなくほぼ機械の領域になると言うのに「やや無理をする必要があった」と述べ、いまも「まだそこまで来ていない」としています。Anthropicの調査では、研究者528人のうち約40%が、2030年までにAIが研究プロジェクト全体を自力で遂行すると予想しています。ただし、回答者はAnthropic自身の「AI for Science」助成プログラムの応募者から集められており、一般の研究者よりAIを頻繁に使っている可能性が高いです(Anthropic)。
モデル化された数字はもっと控えめです。Anthropicのモデリングによると、現在の能力が広く普及すれば、新しい研究に必要な研究者の時間の27〜52%を肩代わりできる可能性があり、アウトプットは、芸術分野の1.35倍から統計学の2.02倍に増える計算になります。AIが物理的でない作業をすべて自動化するという、報告書の仮想シナリオでは、統計学とコンピュータサイエンスで約15倍に達しますが、物理的な工程がボトルネックであり続ける生物学や化学のようなベンチ科学では3〜4倍にとどまります。これは測定値ではなく、シナリオです。控えめなケースでも、ひとつの分野にとっては大きな変化です。ただ、置き換えではありません。報告書も、現在のAIの仕事は主に補助的か共同作業だと指摘しています。誰の手柄になるのかについては、Schwartz氏の言葉が私たちよりうまく表現しています。それは「人間の貢献がタイピングだったかのように装うことでは、解決しません」。
主張6:AIのモデルがデータに合っていれば、そのシステムを理解したことになる
判定:誤りです。そして、こうしたシステムを作っている著者たち自身がそう言っています。
科学モデルを構築するAIの教え方について、テュービンゲンのグループ(Jakob Macke氏、Daniel Gedon氏、Stefan Wahl氏。いずれもAnthropic AI for Scienceの助成対象者)が寄せたゲスト投稿は、この点を丁寧に論じています。同じデータに合うモデルは多数あるため、有用なアウトプットは、もっともらしいモデルの幅と、それらが一致する点の一覧です(Anthropic)。著者たちは、こうしたシステムが「ほとんどの場合、科学者がすでに知っているモデルの再発見でテストされてきた」こと、答えが未知の問題についての証拠が乏しいことを認めています。そしてこう書いています。「モデルをただ渡すAIシステムは、答えをくれるかもしれませんが、理解はくれません」。
この最後の一文は、すべての実験台と、すべての学生の机の上に貼っておくべきだと思います。フィットは数字です。説明は、次に何が起こるかを予測するために人が使えるものです。
研究者と学生のための進め方
ここまでの内容は、これらのツールを使うなという意味ではありません。Anthropicの利用データを見ると、科学者はすでに、もっとも力を発揮する場面、つまり主に分析と執筆で使っています。以下は、上の事例でうまくいかなかった点をもとにまとめた、私たちが実践する進め方です。
- 出力を自分で確認できる作業をエージェントに任せましょう。データ分析、言語間のコード移植、論文や画像のスクリーニングなどです。Claude CodeとClaude Coworkは、そうした仕事向けに作られており、ターミナル型コーディングエージェントの比較で全体像を紹介しています。
- 始める前に、何をチェックとみなし、誰が行うかを決めておきましょう。同じモデルではいけません。形式検証ツール、別の分析、ベンチでの実験、あるいは同僚です。
- エージェントが何かを新しいと言ったら、自分で文献を検索しましょう。Elicit、Consensus、SciSpace、ResearchRabbitのような専用ツールなら数分で済みます。省いたときの代償は、マヤの件が示しています。より長いリストはAIリサーチアシスタントのランキングにあります。
- 物理的な工程は人間が担い、記録を残しましょう。結果が測定、サンプル、現地訪問に依存するなら、テストされるのはそこです。
- まとめるときは、エージェントが何をしたか、そして自分が何を確認したかを書きましょう。Schwartz氏は、人間の貢献はタイピングではなかったと、はっきり述べています。
- 学生の方へ。最初のモデルは自分で作りましょう。テュービンゲンの著者たちは「洞察をもたらすのは、それを構築する過程です」と書いています。エージェントは、自分のモデルを批評させるために使い、モデルを渡してもらうために使わないでください。
AIが生物学で成果を出した例として、より歴史が長く、検証も進んでいるのは、やはりAlphaFoldです。構造を予測し、それをラボが検証します。文献調査やエージェント型のリサーチには、Edison Scientific、自分のエージェントに装備させるScientific Agent Skills、そして研究者向けAIツール トップ250のボードもあります。汎用アシスタントについては、ChatGPT vs Claude vs GeminiがChatGPTを主な2つのライバルと比べており、AIリサーチアシスタントとAIエージェントのボードでは専門ツールをランキングしています。
私たちの結論と、考えを変えるもの
本物と言えるのは、エージェントがいまや、疲れを知らない有用なアナリストでありエンジニアになっていることです。電子回路の試作機は動き、酵素の手がかりは興味深く、モデルが出してLeanで検証された証明は、誰が最初に理解するにせよ本物の成果です。Schwartz氏の15個の新しい積分も、狭い分野での本物の成果です。
誇張なのは、自律性、ゆるく使われる「検証済み」、そして自動化された科学者の波がやって来るという話です。上で見た印象的な成果のほぼすべてで、それが真実かどうかを決める部分を担っているのは人間であり、その人間たち自身がそう言っています。また、ラボには、ベンチマークのスコアの横にドル建てのコストも載せてほしいです。クレジットやトークン数では、発見にかかったコストが見えません。酵素1件の探索に2億1,000万トークンというのは、ラボの予算にとって重要な数字です。
私たちの考えを動かすものは2つあります。1つは、OpenAIの委員会の外にいる数学者がYang-MillsのLeanコードを読み、理解できたと報告することです。もう1つは、システムが何をしているのかを説明する、査読済みの酵素研究です。それまでは、どちらも有望だが未完成のものとして扱います。