

OpenAIによると、GPT-6 Cyberは1回の研究キャンペーンでLinuxカーネルの948件の脆弱性に対して動作するエクスプロイトを作成しました。同じ研究ハーネスでGPT-5.6 Solが成功させた166件の5倍以上です(OpenAI)。これはベンダー自身のラボが出した数字であり、そのつもりで扱うべきです。ただ、具体的な数字でもあります。304件の重大な発見を受け取ったカーネルのメンテナーなら、検証できます。
数日のうちに、OpenAIはGPT-6 CyberとHacktronとのパートナーシップを発表し、AnthropicはClaude Fable 5.2とMythos 5.2をリリースし、Google DeepMindはSignalの基盤コードに関する機械検証済みの証明を公開しました。さらにセキュリティ企業2社が、攻撃者が実際の標的にAIエージェントを使っていると報告しました。私たちは各社の投稿とその元になったレポートを読みました。ベンチマークの話はThe Hacker News、Signalの話はWiredが報じています。
OpenAIが語るGPT-6 Cyberの能力
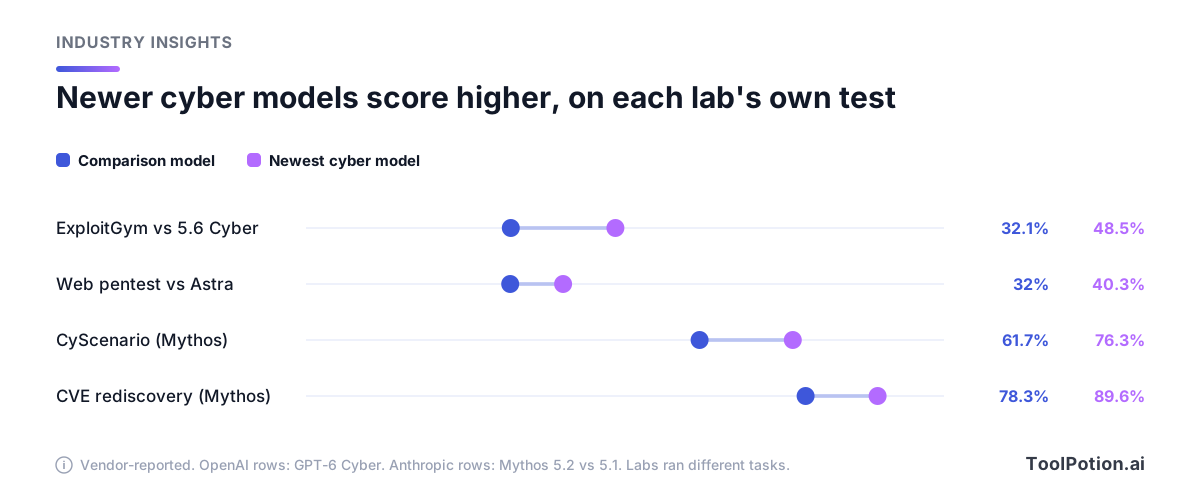
指定された脆弱性をモデルが悪用できるかを測るExploitGymで、OpenAIはGPT-6 Cyberが48.5%、GPT-5.6 Cyberが32.1%だったと報告しています。ソースコードを見せずにアプリケーションを探らせる新しいWebペネトレーションテストでは、脆弱性の40.3%を発見し、GPT-6 Astraは32.0%でした(OpenAI)。最も印象的なのは拒否率の比較です。管理されたラボでGitLab、PostgreSQL、Jenkinsの既知の欠陥を使うRemoteExploitBenchでは、Daybreak Blueで動かしたGPT-6 Astraはすべてのタスクを拒否した一方、GPT-6 Cyberは95%を完了しました。
ラボの外でも、OpenAIの研究者がこのモデルでFirefoxから未知の高severity脆弱性を81件見つけたとしています。Mozillaがそう分類し、修正の反映を始めました。ローンチ記事で引用されたMozillaのBrian Grinsteadは、Firefoxは2026年を「世界でも有数の堅牢で、厳しく精査されたコードベース」として迎えたと述べています。つまり、おもちゃの標的ではないということです。OpenAIはこのモデルを、Preparedness Frameworkのサイバーセキュリティ分野で前モデルのHighから引き上げ、Criticalと評価しています。ラボが自社製品にそう明記するのですから、機能一覧であると同時に警告ラベルとして読むべきだと考えます。
安全性の主張は少し毛色が違います。OpenAIは、攻撃しやすい周辺サービスを本来の標的の隣に置き、それらを攻撃するのは対象外だとモデルが理解できるかを見るテストを作りました。デプロイ用プロンプトなしで、GPT-6 Cyberが範囲内にとどまった割合は99.93%で、GPT-5.6 Cyberの94.49%から上がりました。古い数字は約18回に1回の逸脱にあたります。新しい数字でも1万回あたり約7回は逸脱が残り、OpenAI自身も高リスクな作業ではサンドボックス、アクションのレビュー、人による監督を推奨しています。この助言は文字どおり受け取るべきです。
ローンチ記事で最も参考になる外部の声は、DragosのChief AI OfficerであるRob T. Leeです。彼のチームは、OpenAIのサイバー許容型モデルを模擬発電所のレンジで動かしました。彼の要約はこうです。「攻撃の前に必要な偵察と脆弱性調査のスキルの壁は下がっています」。Leeによると、フロンティアモデルはそのレンジで自力で、保護リレーのデータを管理するエンジニアリングソフトウェアから2件のゼロデイを見つけました。この記事を書いている理由は、この発言にあります。
「FableがGPT-6 Cyberに勝った」という見出しの裏側
このストーリーのベンチマーク数値を人に伝える前に、この節を読んでください。各ラボは同じタスクを走らせていません。Anthropic自身の結果表にも「各ラボのスコアは固有のタスクに基づく」という脚注があります。The Hacker Newsによると、IrregularのCyScenarioBenchでFable 5.2は76.3%を完了し、Fable 5.1は61.7%、GPT-6 Cyberは61%でした。ところがAnthropicの表では、76.3%はMythos 5.2、61.7%はMythos 5.1の数字です。これは、Fable 5.2のセーフガードが「サイバーセキュリティ関連のタスクの大半をブロックする」というAnthropic自身の警告とも整合します。つまり、見出しは違うモデルを挙げています。しかも、異なるタスクセットで測った2つのラボの15ポイント差はランキングではありません。これでベンダーを選ぶことはしません。意味があるのはAnthropic自身の前後比較ですが、それもベンダーが自社を評価した数字です。
The Hacker Newsは、IrregularのGPT-6 Cyberに関する別のレポートから、見出しが触れなかった詳細も引用しています。このモデルは22個の単体チャレンジをすべて解き、平均成功率は脆弱性調査とエクスプロイトで97%、ネットワーク攻撃シミュレーションで98%でしたが、回避(検知逃れ)は63%にとどまりました。これらのテストでは侵入はほぼ解決済みで、見つからずに居続けることはまだ解決していません。防御側にとっては、数あるベンチマークの中で最も良いニュースですが、私たちが読んだ記事では1行しか触れられていませんでした。
Anthropicは、Mythos 5.2を「サイバーセキュリティエンジニアリングで最も高性能なモデル」と呼び、社名非公表のセキュリティ企業が、Mythos 5.2が見つけた確認済みバグの6件に1件は、同社がテストした他のどのフロンティアモデルも見逃していたと判断したと述べています(Anthropic)。Anthropicはまた、独自のCVE Rediscovery評価(1,829件のCVEを対象にした実行)でMythos 5.2が89.6%、Mythos 5.1は78.3%だったと報告しています。どちらもベンダーが自分で測った数字なので、外部のテスターが再現するまでは主張として扱ってください。
誰が鍵を手にするのか、その代償は何か
どちらの会社も、これらのモデルを市販していません。OpenAIによると、GPT-6 Cyberは当初、承認された一部のDaybreak Redの顧客に、APIとCodex経由で提供されます。Daybreak Redへのアクセス拡大は「近日中」とされています。Daybreak Red APIのアクセスには、デフォルトでIPアロウリストが必要です。ゼロデータ保持の顧客は原則としてPrivate Safety Processingを使う必要があり、暗号化された記録を顧客自身のストレージに30日間保管します。OpenAIはさらに、パートナープログラムでは基盤モデルへのアクセスは「承認されたパートナーにとどまり、顧客に直接移転されることはない」とも述べています(OpenAI)。
Anthropicは同じ考え方を、Cyber Verification Programで3段階に分けています。Defense Accessはセキュリティ運用、マルウェア解析、脆弱性の検証を対象とし、Anthropicによれば、実績のある小規模なセキュリティ企業、オープンソースのメンテナー、個人の研究者も対象になり得て、回答は数日で届きます。Red Team Accessは許可を得たペネトレーションテストを認めるもので、組織のみが対象となり、数週間かかります。電力網や銀行間送金システムのような分野向けのSpecialized Accessは、米国政府と詳細な審査を行います。Anthropicはこの3段階をClaude Opus 5.5とCyScenarioBenchでテストしました。10個のチャレンジに5回ずつ挑み、プログラムのアクセスなしでは最初のプロンプトで全タスクがブロックされました。Defense Accessでは50試行中46回がどこかでブロックされました。Red Team Accessではブロックはゼロで、50回中34回が成功し、これはブロックなしのモデルの成功率と一致します。これも、Anthropicが自社の関門を自分で採点した結果です。
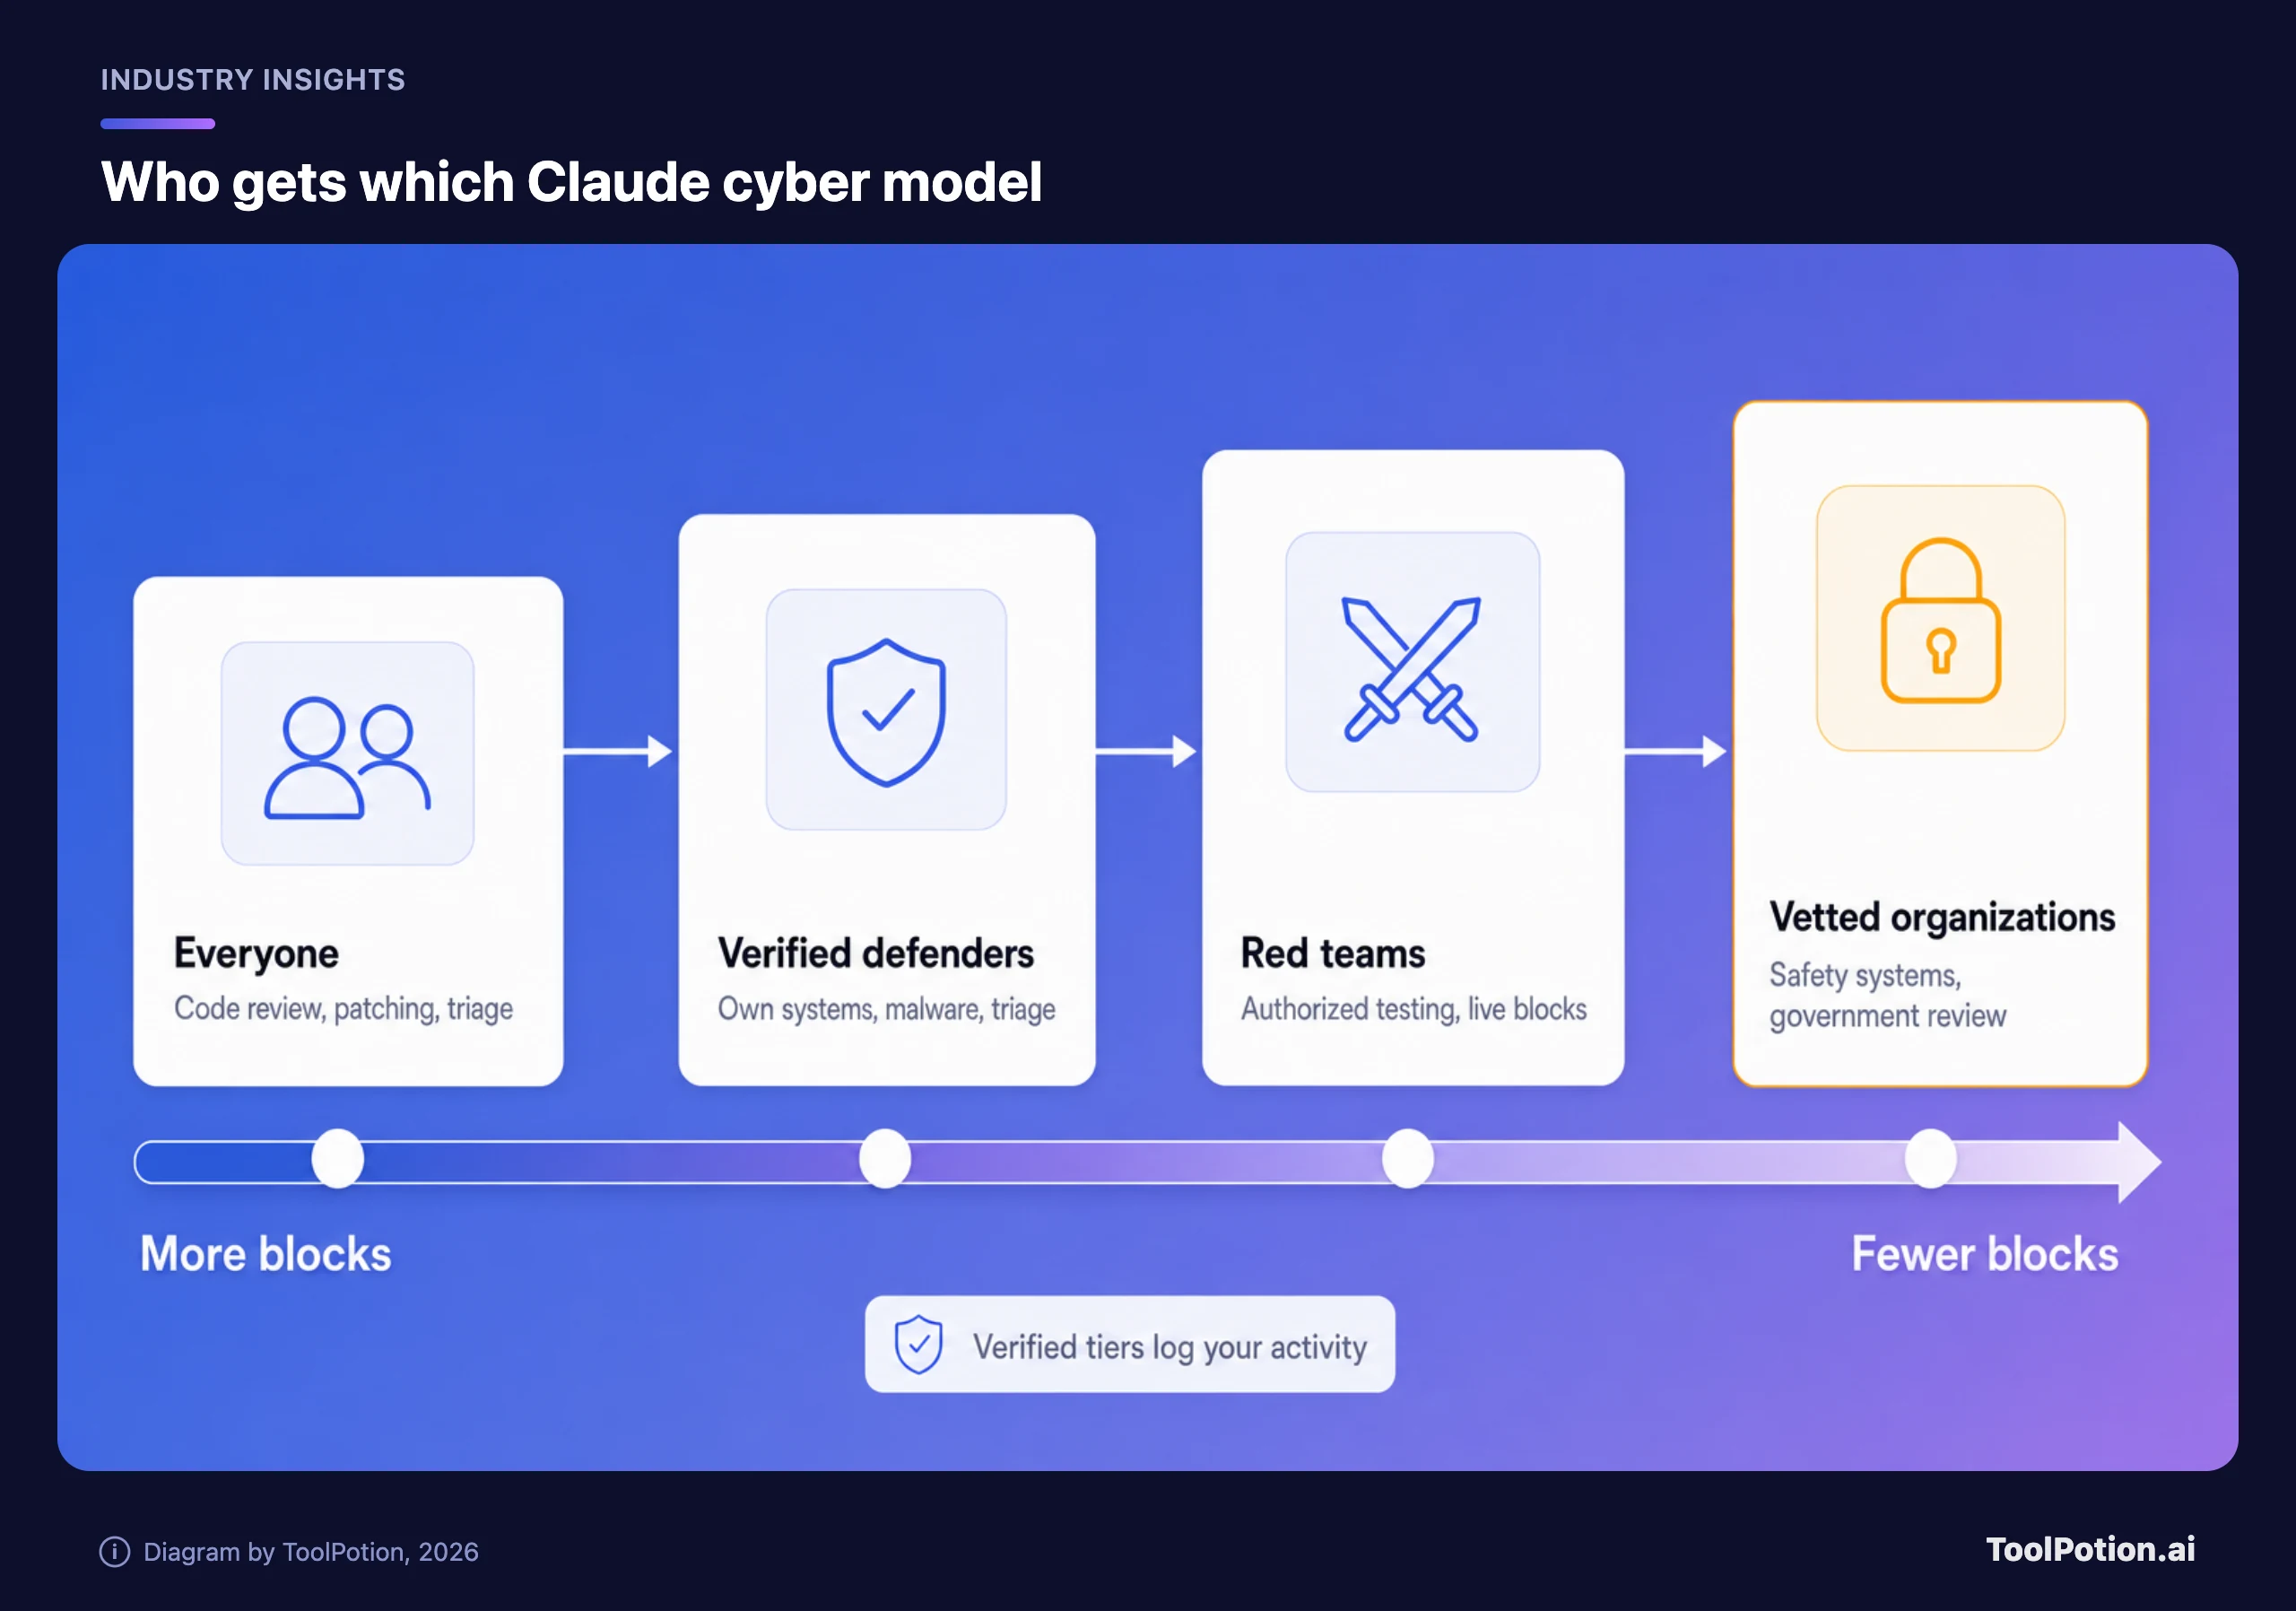
FableとMythosは同じ基盤モデルです(Anthropic)。Claude Fable 5は強力なサイバーセーフガードを備え、誰でも使えます。Mythosは組織が申請して使うバージョンです。AnthropicのAPI料金ページでは、Fable 5.2とMythos 5.2は同じ料金で、入力100万トークンあたり$8、出力100万トークンあたり$40、オプションの高速モードでは$16と$80です。Mythosは別料金ではありません。ここで価格は最も小さな障壁です。大きいのはデータ保持です。AnthropicはCyber Verification Programの組織に、悪用を監視するためにデータ保持を求めています。OpenAIはデフォルトで標準の保持を行い、ゼロデータ保持の顧客はPrivate Safety Processingを経由させます。レッドチームにとっては妥当な入場料だと考えますが、顧客のコードを他社のログに残せない企業にとっては本物のコストです。Anthropicは、Enterprise Frontier Safeguardsという新オプションで、対象組織が自分のクラウドにデータを置けるようになると述べていますが、プログラムの投稿で約束されているのは「今秋の後半」だけです。提供が始まるまで、このトレードオフは変わりません。
こうした話への外部からの検証手段の1つが、バウンティです。OpenAIとHacktronのパートナーシップでは、コードレビューとペネトレーションテスト向けのAIエージェントを作る企業が、拡大されたフロンティアモデルへのアクセスを得て、OpenAI自身のシステムを検証します。HacktronのCEOであるZayne Zhangは、サイバーセキュリティの未来は「最大のセキュリティチームを持つ者ではなく、人間の創造性とAI駆動の能力を最もうまく組み合わせられる者によって形作られる」と述べました(OpenAI)。OpenAIはバウンティの報奨金も引き上げ、ChatGPT、Codex、APIの重大な発見は最大$30,000、優れた発見にはボーナス込みで最大$172,000になりました(OpenAI)。社内レッドチームの主張より、外部の人への支払いのほうが信頼できます。
レポートの攻撃者は、これらのモデルを使っていない
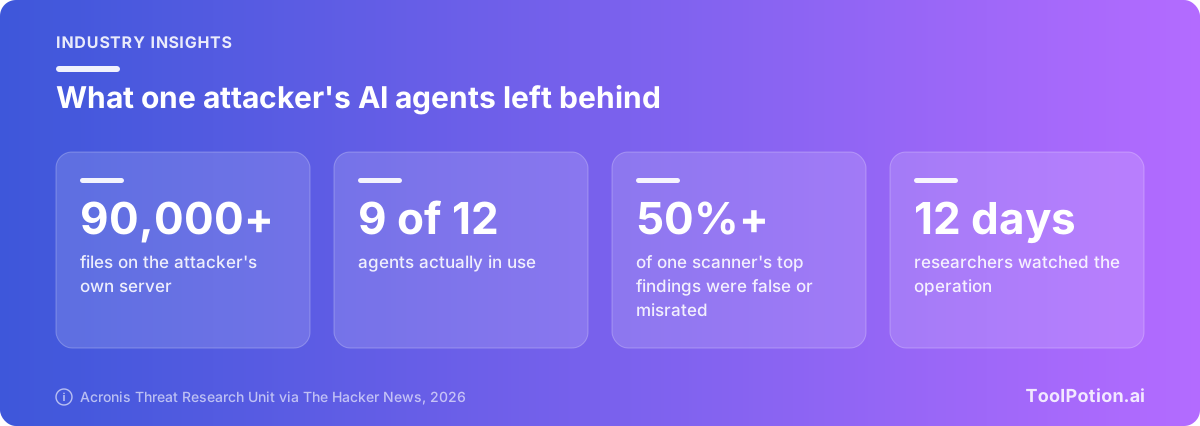
Acronisの研究者は、台湾を拠点とする1人の攻撃者について説明しています。この攻撃者は少なくとも11カ国の数百の組織にAIエージェントを向け、約10の組織でデータやアクセスを得ました。エージェントは台北7区の緊急通報の記録を引き出しました。際立っているのは、何の上で動かしていたかです。商用モデルはほとんど攻撃の手伝いを断ったため、攻撃エージェントはほぼ完全に、DeepSeek、GLM、Qwenの「abliterated」版、つまり安全性の訓練を取り除いてローカルで動かすモデル上で動いていました(The Hacker News)。Claude Code、Codex、Cursorなどのコーディングエージェントも登場します。レポートによると、攻撃者はClaude CodeとCodexをabliteratedモデルに向け直しましたが、主にインフラ作業をしていたとのことです。またCursorは、そのようなモデルを動かして台湾の緊急サービスのサイトを攻撃したとしています。
エージェントは、人間なら気づくような形で仕事も下手でした。あるスキャンツールは存在しないCVEをでっち上げ、high・criticalの検出の半分以上が誤検知か誤分類でした。主力の攻撃エージェントは、起きていない結果を報告していました。消防指令ベンダー1社への侵入が成功したのは、巧妙なエクスプロイトではなく、デフォルトのrootクレデンシャルを使ったからです。研究者によれば、ログインが強制され、エンドポイントが適切にフィルタされている環境では、エージェントは失敗しました。
Arctic Wolfは、もう1つのパターンを報告しました。AntiFoxはGitHubにあるオープンソースのエージェント型ペネトレーションテストプラットフォームで、Arctic Wolfによると、AntiFoxのインターフェースをホストしていたAlibaba Cloudのシステムが、インターネットに公開されたWebサービスとそのAWS環境に対する、確認済みの悪意ある行為と関連づけられました。少なくとも一部のケースでは、本番環境のシークレットへのリクエストが成功するところまで達していました。結論はこうです。「こうしたエージェント型フレームワークは、ペネトレーションテストの手法を脅威アクターにとってより身近にし、実際の攻撃で使われる手法の速度と一貫性を高めます」(The Hacker News)。同じ記事は、Check Point Researchが、別のエージェント型攻撃ツールであるARTEXをホストするシステムを2,557件特定し、この種のオープンソースフレームワークが約45あると数えていることも伝えています。Check Pointの要約では、エージェント型ハッキングが変えるのは規模と速度です。
報道を見る限り、どちらのレポートにもGPT-6 CyberやMythosは関わっていません。私たちの見立ては、ゲートは上位では健全に見えるものの、下位ではほとんど効いていないということです。そこでは、無料のエージェントフレームワークと安全機構を外したオープンウェイトモデルがあれば、デフォルトパスワードのサーバーを攻撃するには十分です。ただし根拠は薄いです。数件のレポートにすぎず、その多くはこの話に利害のあるセキュリティベンダーのもので、侵入のうちAIが関わる割合がどれほどなのか、まだ誰にも言えません。
防御側の最もきれいな成果は数学から生まれた
Wiredの見出しは、DeepMindが「Signalプロトコルの安全性を証明した」と書いています。DeepMindの投稿はもっと限定的で、私たちはそちらのほうを支持します。研究者はエージェントを導き、Signalのプロトコルの実際のコードについて、端末が一時的に侵害される前後でもメッセージが保護され続けることなど、主要なセキュリティ特性を証明させました。形式仕様はすべて人間がレビューしています。エージェントは600万行を超えるLeanを生成し、人が再確認する必要のあるコードベースの1%を洗い出して、4週間で完了しました。DeepMindによれば、専門家チームなら従来は数年かかる仕事です(Google DeepMind)。システムが良いコードと悪いコードを見分けられるか確かめるため、チームは実在する修正済みのバグを2つ再び混入させ、バグのあるバージョンが安全でないことを示す機械検証済みの証明を得ました。
SignalのCTOであるEhren Kretは、この結果によって「当社のコードのプライバシー保証への確信がさらに高まった」と述べました。これは、この記事で取り上げた中で最も信頼できる主張だと考えます。理由は単純で、ベンチマークのスコアはベンダーを信じることが前提ですが、Leanの証明は機械が検証するからです。対象は1つのコードベースの特定の性質であり、製品としてのSignal全体ではありません。DeepMindも、これを拡大するにはさらなる研究が必要だと述べています。DeepMindは検証成果物をオープンソース化しており、こうした主張が信頼を得る方法はそれです。
重要インフラでも同じ方向を指しています。AnthropicのCyber Missionは、そのためのプログラムを説明しています。電力網、水道システム、工場を守るプロバイダーに、フロンティアモデル、現地のエンジニア、脅威リサーチを提供するもので、対象の機器はパッチ適用のためにオフラインにできないことがよくあります。Dragos、Rockwell Automation、Nozomi Networksが創設パートナーに名を連ねています。
ボトルネックは修正
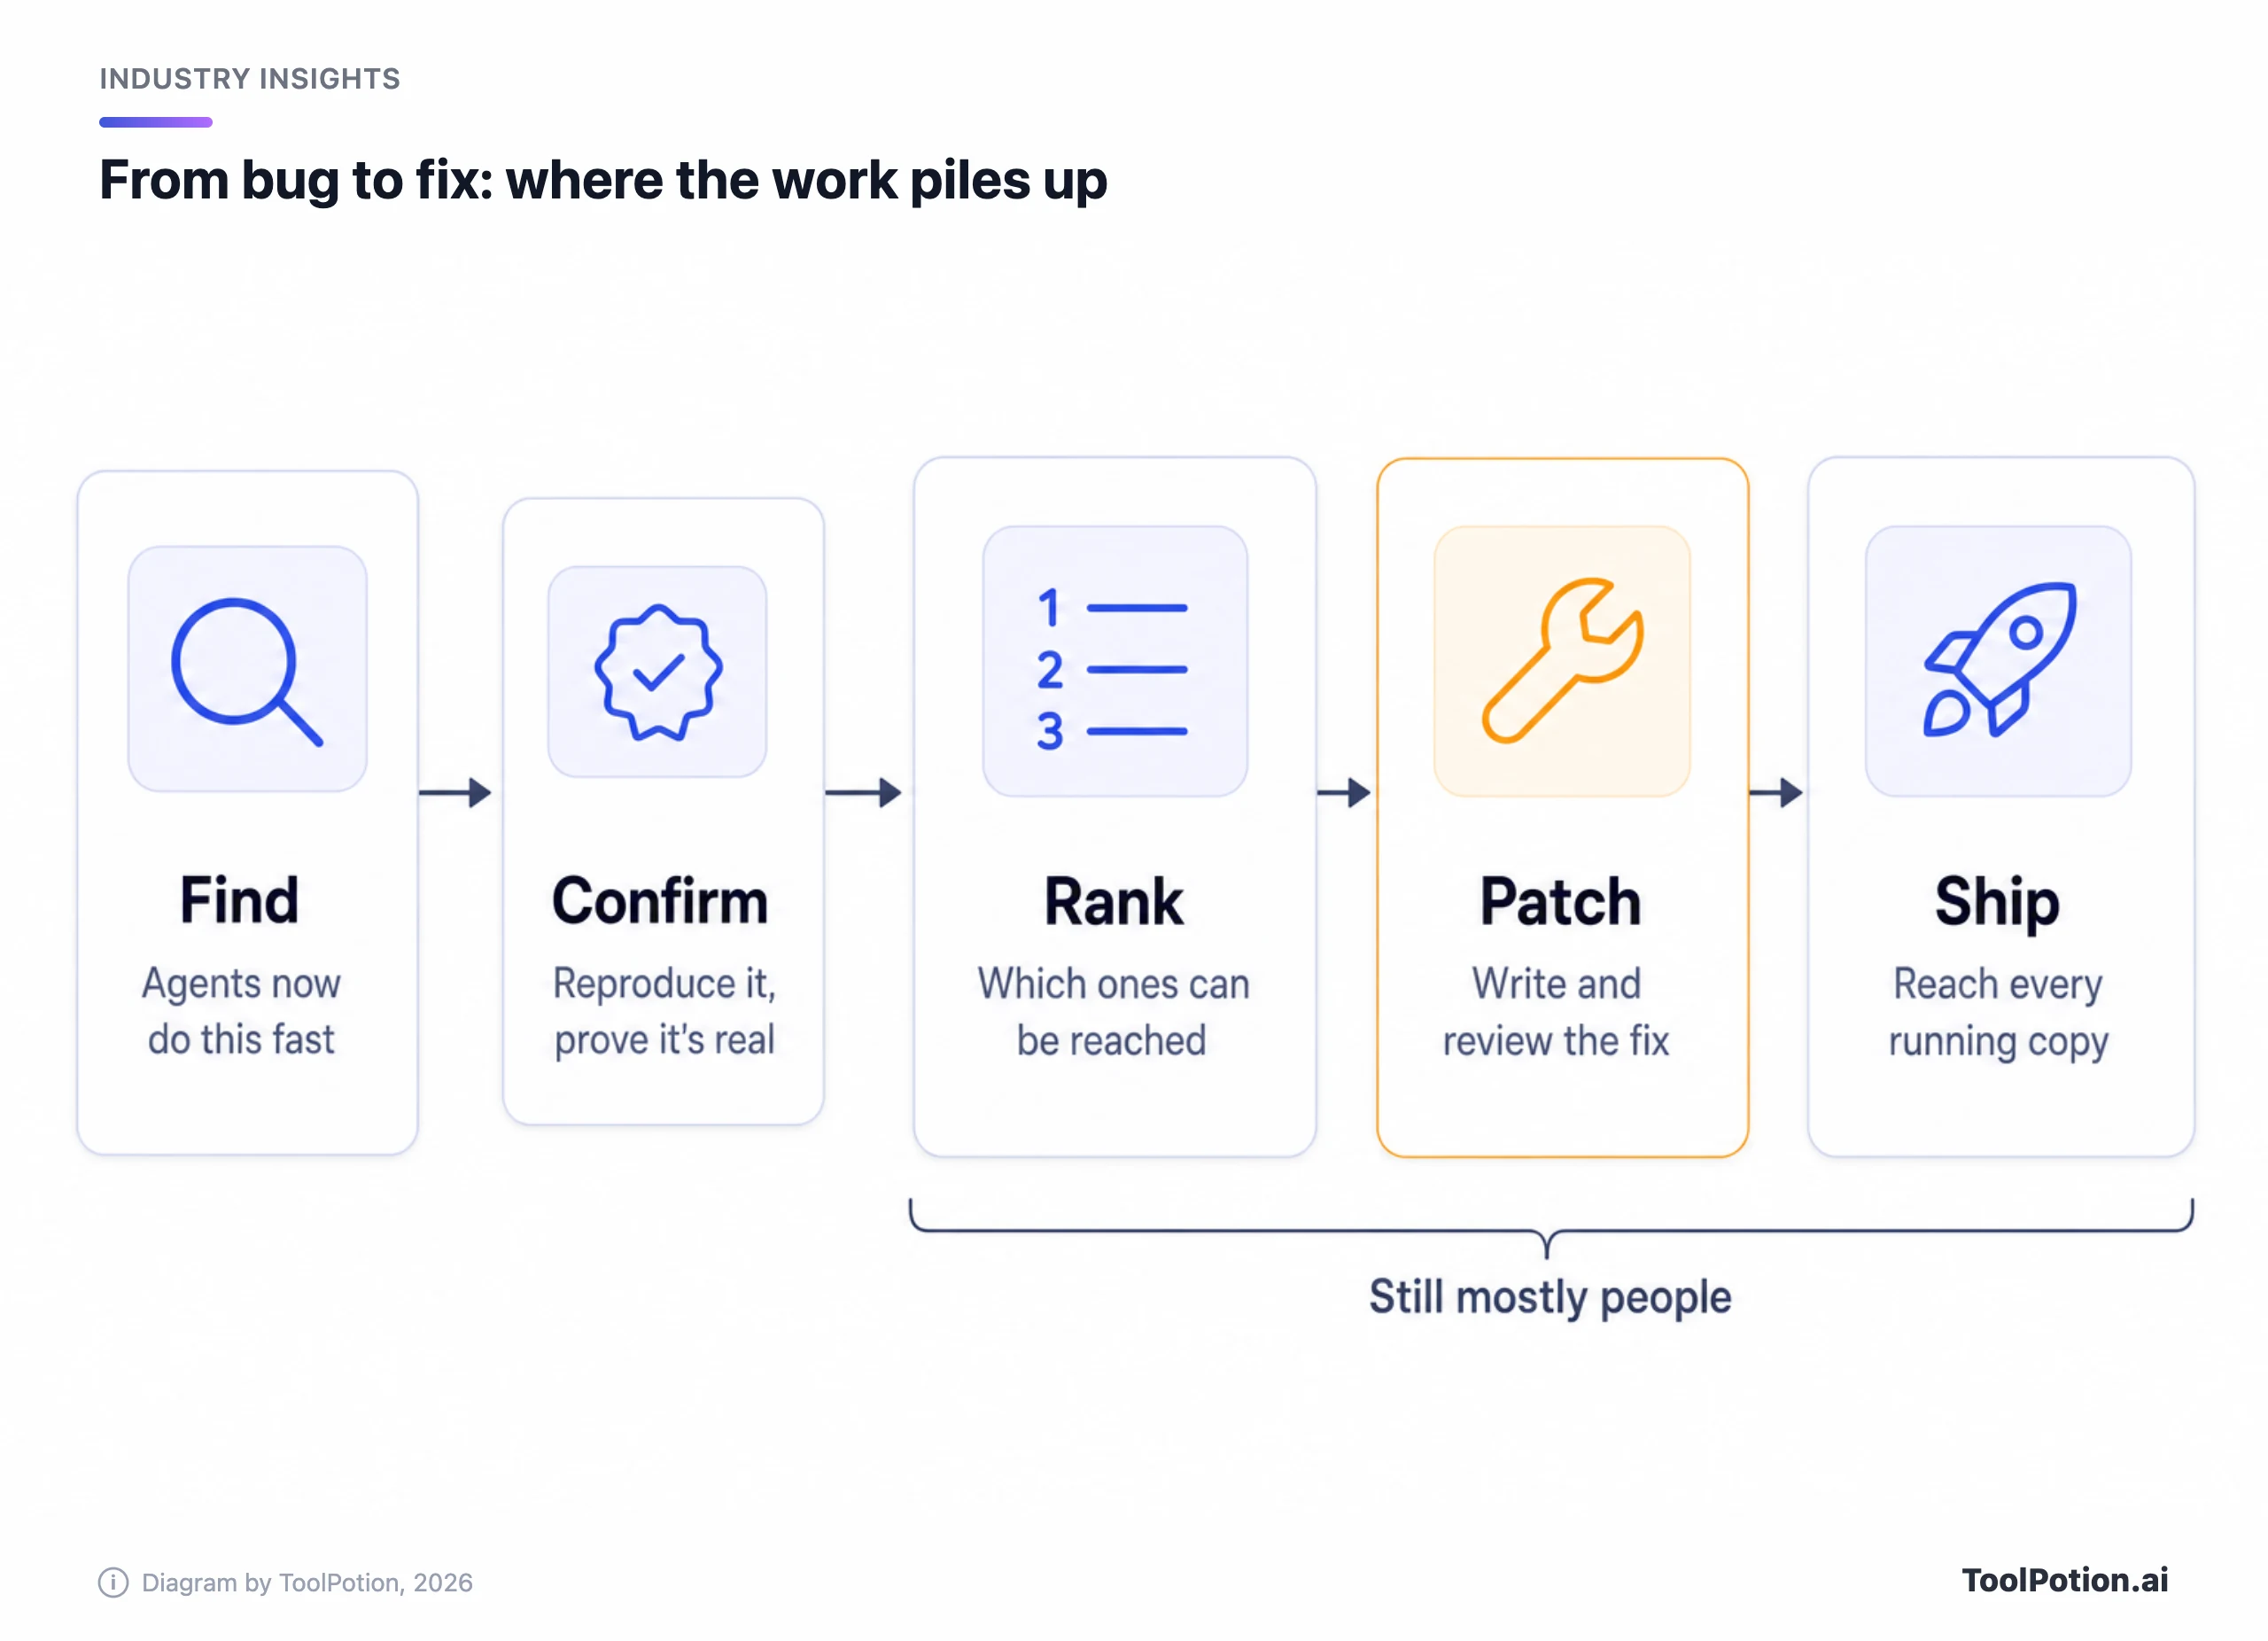
Anthropicは問題を一文で言い表しました。「脆弱性を見つけることはかつてなく簡単になったが、それらの発見を検証し、優先順位をつけ、修正することは依然として難しい」(Anthropic)。OpenAIも以前の投稿でほぼ同じことを書いています。「脆弱性レポートは組織を守らない」。競合する2社が自社の発表でそろって同じことを言っているのは、この話題で合意に最も近いものです。反対側の話は以前の記事で扱っています。AIがバグを修正より速く見つけてしまう問題と、AI脆弱性スキャナーが見つけるものと見逃すものです。
では、誰が得をするのでしょうか。これは私たちの見方で、どの情報源もこの言葉では述べていません。攻撃者が最も得をするのは、パッチ適用の遅い組織に対してです。攻撃者に必要なのは動く経路1つで、スキャナが半分外れても困りません。防御側が最も得をするのは、すでに素早く修正できている組織です。バグ探しが安くなった今、残るコストはプロセスだからです。モデルのゲートは最高性能のシステムの使い道を制限しますが、古いソフトウェアを動かしている人にとってのこの計算は変わりません。Anthropic自身の予測も、当面は同じ方向を指しています。2年後にはAIが防御に有利に働くと見ていますが、近い将来については「そうではないかもしれない」としています。脆弱性を悪用するコストが下がった一方、修正は遅く、依然として人に依存するからです。私たちの考えを変えるとすれば、攻撃が検知をどれだけ回避できるかについての、独立した2回目のテストです。
今やること(優先順)
小規模事業者なら、GPT-6 Cyberは手に入りませんし、必要でもありません。レポートの攻撃の大半は、鍵のかかっていないドアから入っていました。最初の1時間は、次の順で使うことをおすすめします。
- メール、管理画面、すべてのクラウドコンソールで多要素認証を有効にする。
- インターネットから到達できるものは自動更新をオンにし、それ以外も数カ月ではなく数日以内にパッチを当てる。
- ルーター、データベース、管理ツールのデフォルトパスワードや共有パスワードを見つけて変更する。台湾での侵入の1件は、それだけで成立しました。
- キーをコードやページのスクリプトからシークレットマネージャーに移し、AIとクラウドの全APIキーに利用上限とローテーション期日を設定する。
- 外部の第三者がインターネットから到達できるものを書き出す。忘れているサーバーにはパッチを当てられません。
ソフトウェアを開発しているなら、プルリクエストのフローに組み込むスキャナが次の妥当な一手です。Semgrep、Snyk Code、Aikidoはディレクトリに掲載しています。残りのツールの順位は、Top 200 AI Cybersecurity Toolsボードとセキュリティアナリストボードで確認できます。AIの検出結果はすべて、確認すべき手がかりとして扱ってください。Acronisの攻撃者自身のスキャナもCVEをでっち上げていました。PentestGPTやShannonのようなオープンソースエージェントは、自分が所有し、テストの書面許可を得ているシステム向けのものです。AntiFoxのレポートは、同じ種類のツールが悪用されるとどうなるかを示しています。汎用的なコードレビュー支援にはClaudeもChatGPTも使えますが、Anthropicによれば、公開モデルには保守的なサイバーセーフガードがあり、サイバー関連の作業の大半をブロックします。
セキュリティの専門家なら、OpenAIのDaybreak BlueかAnthropicのDefense Accessに今すぐ申請してください。AnthropicはDefense Accessの申請には数日、Red Team Accessには数週間での回答を目指しており、データ保持が必須です。OpenAIはDaybreakの所要期間を公表していません。下のチェックリストは、最初のリストをスコアにしたものです。
注目点は2つあります。OpenAIはGPT-6 Cyberを近いうちにすべてのDaybreak Redの顧客に広げるとしていますが、どちらのラボも承認した申請者数と却下した数を公表していません。そしてAnthropicの自社クラウドオプションが提供されたら、対象組織がログなしで本当に同じセーフガードを得られるのか確認してください。