

$8と$40。これがClaude Fable 5.2の100万トークンあたりの入力・出力料金です。Fable 5.1の$10と$50から下がり、GPT-6 Astraの定価よりちょうど20%安くなっています(Fortune)。両社の公式ページで確認しましたが、この数字は正確です。Anthropicは$8と$40(Anthropic docs)、OpenAIはGPT-6 Astraを$10と$50で掲載しています(OpenAI)。
これが見出しの話題で、確かに魅力的です。ただ、もっと注目されるべきだと考えているのは、ヘルプセンターの記事のさらに下にある一文です。Fableはプロンプトと出力を最低30日間保持し、ほとんどの顧客にはゼロデータ保持(ZDR)がそもそも提供されていません。Anthropicは同じ日に2つのモデルを出しました。すべての有料プラン向けのFable 5.2と、審査を通過したセキュリティ・生物学チーム向けのMythos 5.2です。以下では両者を分解して、何が変わったのか、それぞれどこで動くのか、AstraやGemini 4 Carbonと比べてコストはどうか、ベンチマーク表をどこまで信用してよいか、そしてどの仕事にどのモデルを使うかを見ていきます。
1つのモデルに2つの名前
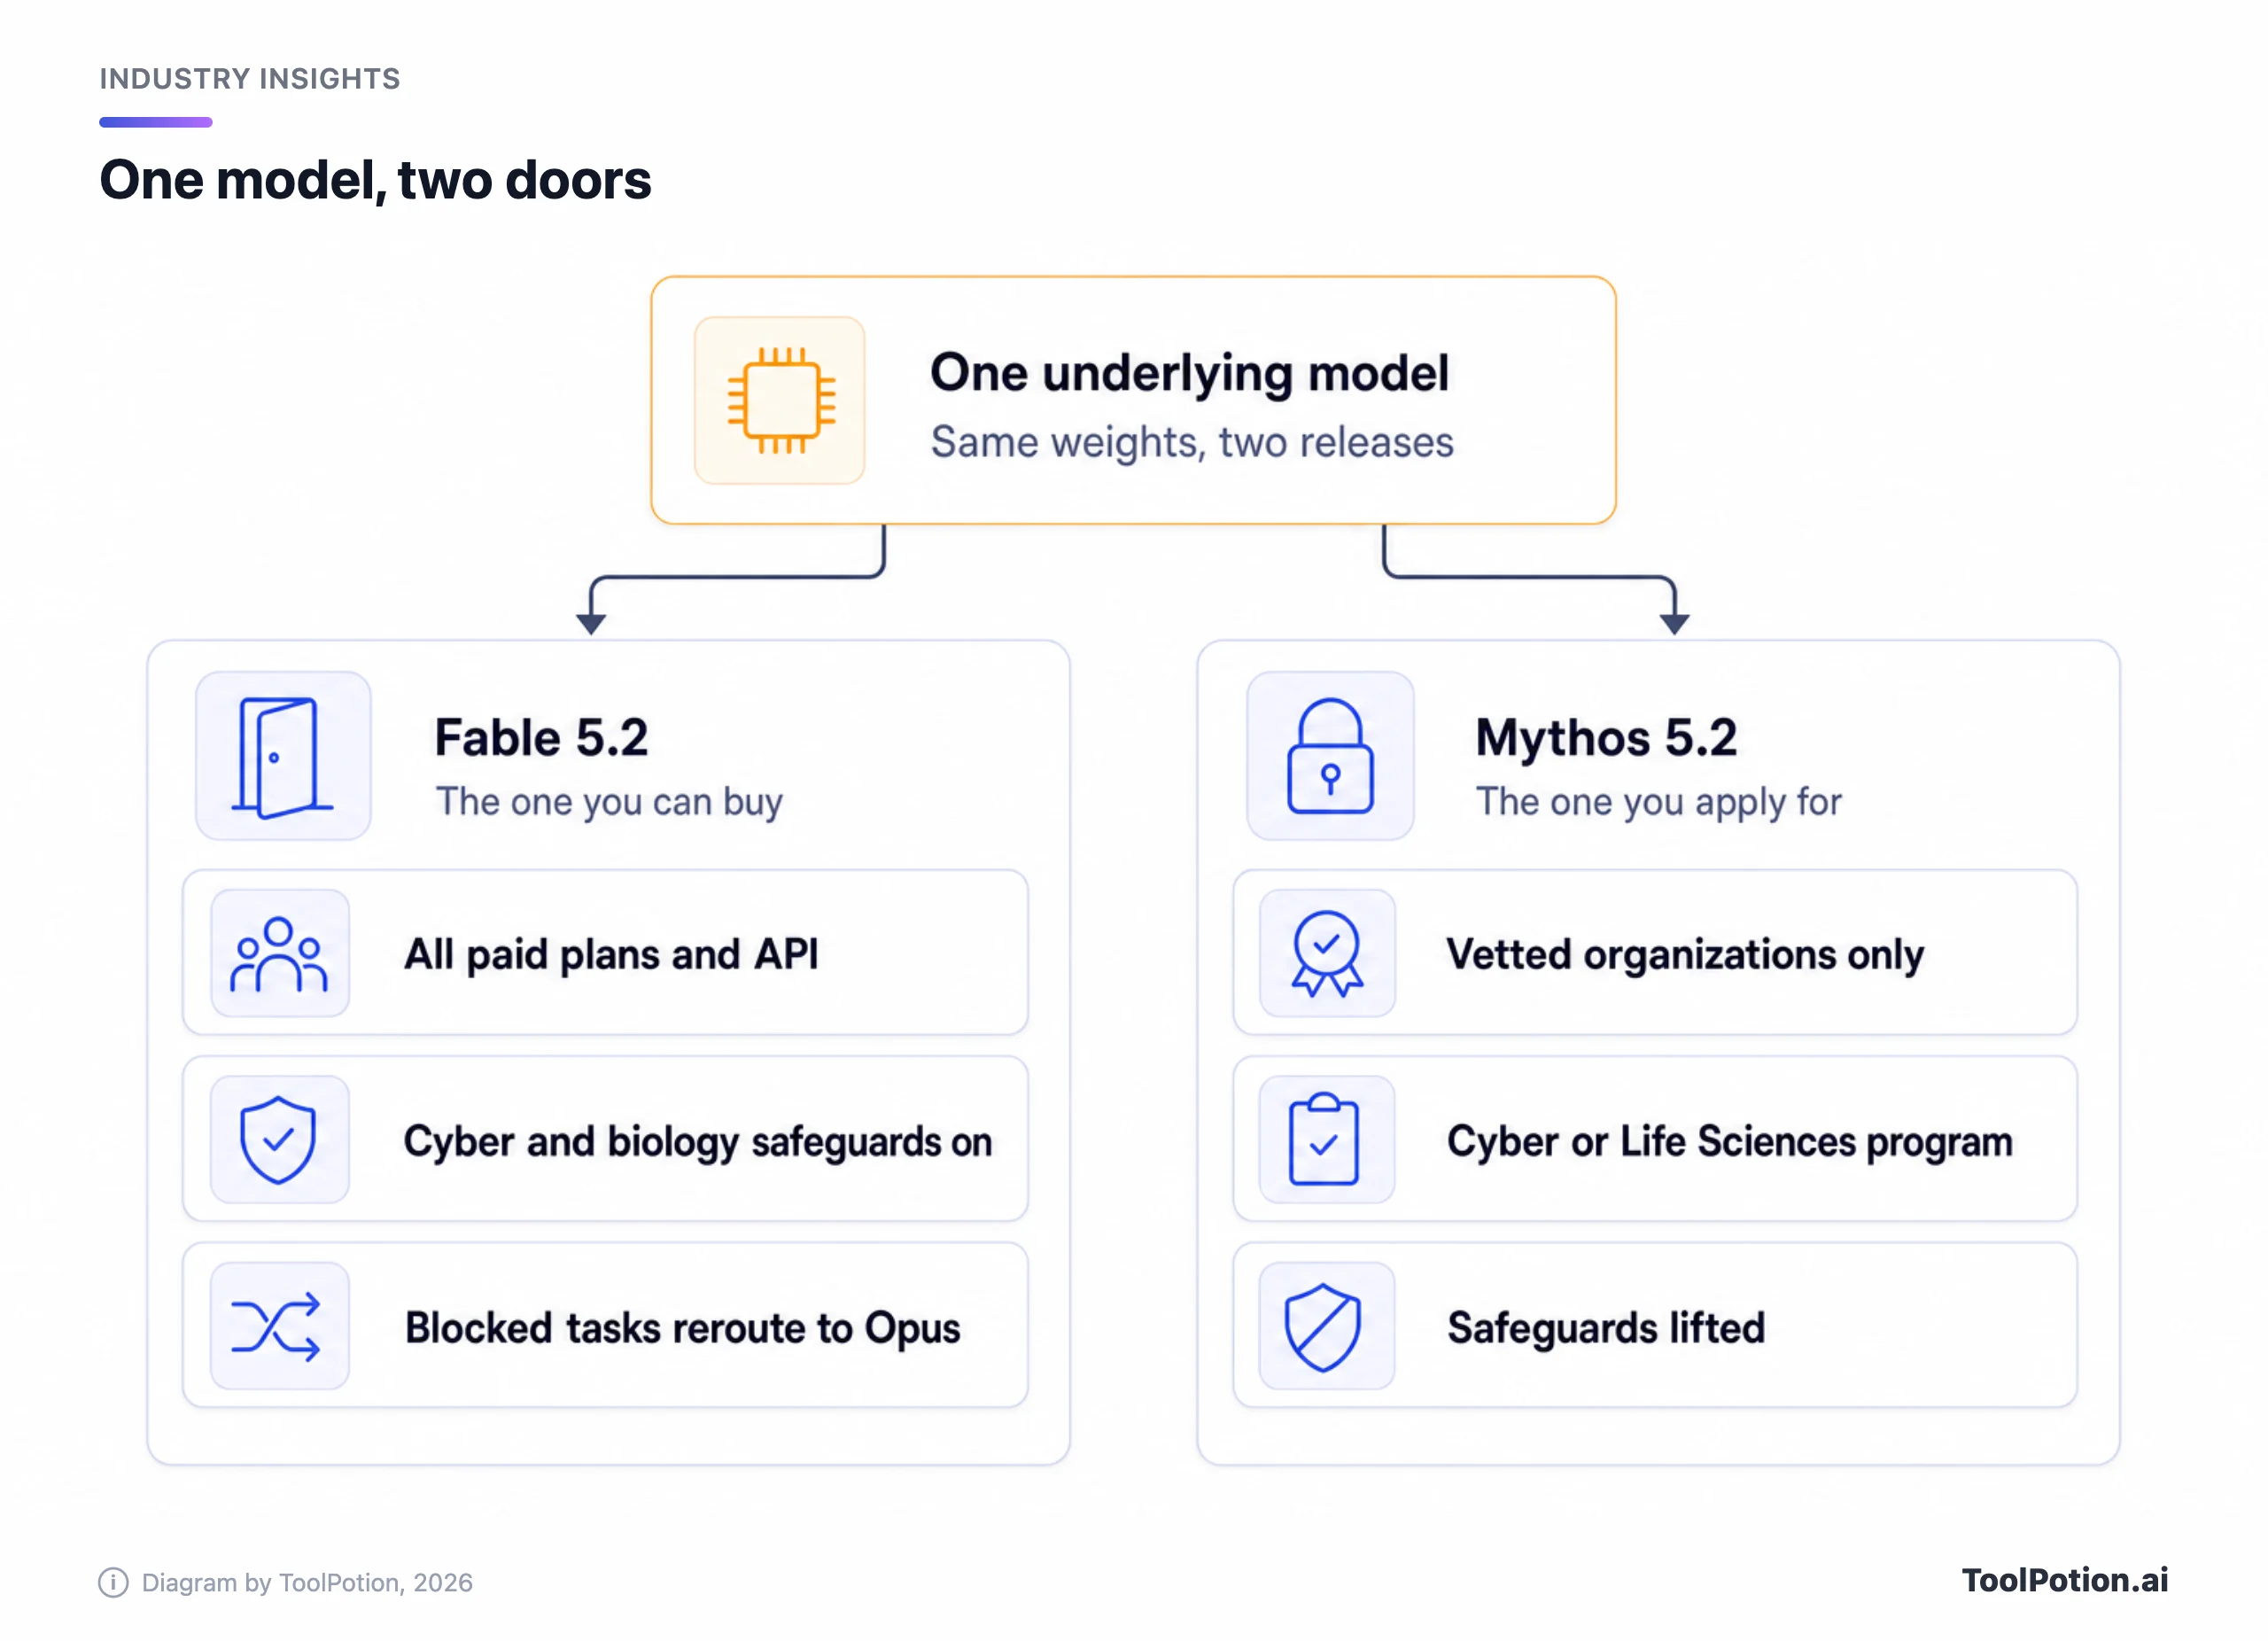
Anthropicによると、この2つは同じ基盤モデルです(Anthropic)。Fableには、ペネトレーションテストやエクスプロイト生成といった高リスクのサイバー作業や、大半の生物学研究をブロックする分類器が付いています。Mythosはそのブロックがないバージョンで、AnthropicのCyber Verification ProgramまたはLife Sciences Verification Programに申請した組織に提供されます。
Fableでブロックされたリクエストは、エラーでは終わりません。Anthropicの発表によると、サイバーセキュリティの話題ではOpus 4.8、生物学の話題ではOpus 5がClaudeに代わって回答します(Anthropic)。このフォールバックは公式に文書化されています(ヘルプセンターには「Why Claude switched models in your conversation with Fable models」という記事もあります。Covered Modelsページ参照)。それでも、回答の雰囲気が急に変わって原因を探し回る前に、知っておいたほうがいい仕様です。
サイバー関連の主張もMythosの側にあります。Anthropicの表では、CyScenarioBenchでMythos 5.2(Fableではありません)が76.3%、OpenAIのGPT-6 Cyberが61%です。ただし「各ラボのスコアは固有のタスクに基づく」という脚注があり、同じ条件での比較ではありません。Anthropicは、Fable 5.2のセーフガードが「サイバーセキュリティ関連のタスクの大半をブロックする」とも述べています(Anthropic)。私たちがサイバー分野で引用するのはこの数字だけで、Fableが主張できるものではありません。プログラムに参加していないClaude Enterpriseの顧客も、Claude Securityを通じてMythosを利用できます。これはモデルファミリー全体でコードをスキャンするサービスです。ただしMythosのfast modeはプログラム参加者に限られます。
ほとんどの読者はMythosに触れることはありませんし、それで問題ありません。製品の本体はFableのラインです。
5.1からの変更点
まずお金の話からです。Fable 5.2は100万トークンあたり入力$8、出力$40で、Batch APIならその半額の$4と$20、キャッシュ読み取りは5.1の$0.25から$0.20に下がります(Anthropic docs)。コンテキストウィンドウは1Mトークンで、長いプロンプトでも追加料金のない単一料金です。Anthropicは出力が5.1より最大30%速くなったとも説明しています。さらに、最大2.5倍速く生成できるオプションのfast modeが加わり、料金は$16と$80です。これは標準料金の2倍で、バッチでは使えません(Anthropic)。
効率面では、Fable 5.2は、ClaudeアプリとClaude CodeのデフォルトであるMediumの effort で、5.1より少ないトークンで難しい答えにたどり着く、とAnthropicは述べています。最も強気の主張はFrontierCode 2.0です。Highのeffortで、MaxのOpus 5.5とほぼ同じスコア(45.3%対45.5%)を、タスクあたりおよそ半分のコストで出したとしています(Anthropic)。
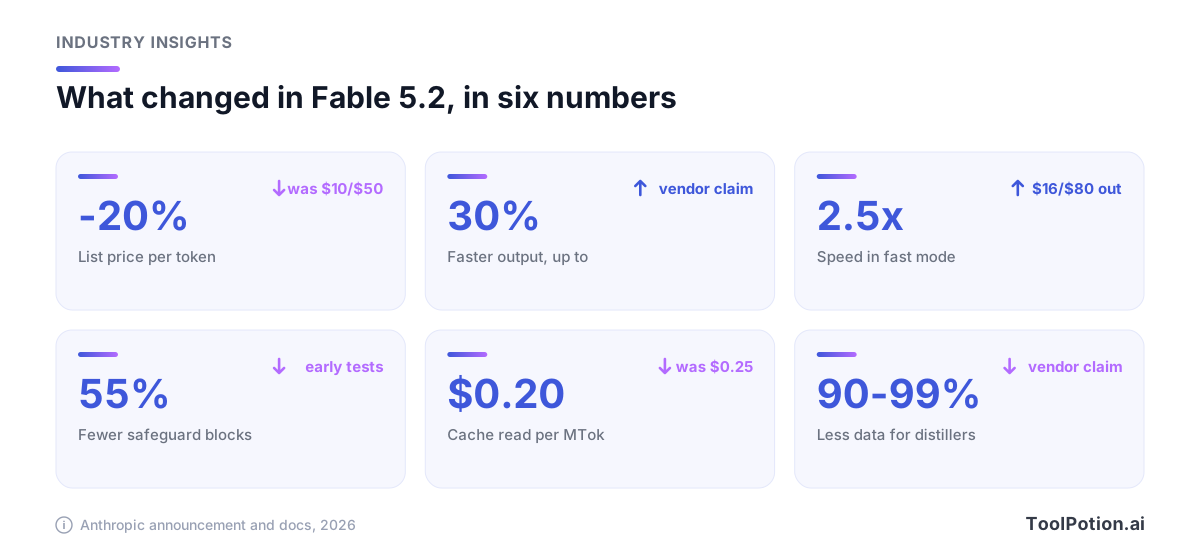
日常の利用に影響する変更が2つあります。1つ目は、Anthropicによると初期テストでセーフガードのブロックが約55%減ったこと(サイバーは60%、生物学は40%)で、5.1で誤検知に遭った人には朗報です。2つ目は、蒸留を行う側がClaudeの過去のコンテキストを編集するのを防ぐためのAPI機能、preserved thinkingが全アカウントに適用されるようになったことです。開発者は、連携を更新するためにドキュメントを確認するよう案内されています(Anthropic)。
もう1点、記録しておくべきことがあります。Anthropicは、AI開発を最も直接的に加速させる研究スキルの伸びを意図的に抑えたと述べており、アクセラレータカーネルの最適化やLLMアーキテクチャの作業はOpus 5.5と同程度の水準にとどまっています(Anthropic)。TechCrunchは、これがAnthropicにとって、社内モデルが同社のAI開発を約2倍に加速しているとするMETRのレポート以降で初のリリースだと指摘しています(ただし多くの不確実性が残ります)(TechCrunch)。またFortuneは、IPO前の最後の大型リリースになる可能性があると伝えています(Fortune)。
ベンチマーク表はAnthropic製。競合の行も同じ
Anthropicは、Fable 5.2をFable 5.1、Opus 5.5、GPT-6 Astra、Gemini 4 Carbonと比較する表を1つ公開しました。載っている数字はすべてベンダー自身のものです。特記がない限りセーフガードはオンで、スコアは各モデルの最高のeffortで測定されています。FableがAstraの29.8%に対して64.9%を出したRoboDojo Simは社内で実行されました(Anthropic)。
英国AI Security Institute、Frontier Design、METRがリリース前にモデルをテストしており、これは一定の意味があります。ただし脚注には、3者ともブログ記事もシステムカードも確認しておらず、どちらの主張にも必ずしも同意していないと書かれています(Anthropic)。3者からコーディングのスコアは見つけられなかったため、コーディングの行はすべてAnthropicの言葉だけが根拠です。
この表では、Fable 5.2はFrontierCode(49.1%対Astraの42.8%)、FrontierSWE v2(69.9%対65.5%)、OSWorld 2.1(89.3%対79.5%)、ツールありのHumanity's Last Exam(74.2%対Astraの57.2%)でリードしています。すべてで勝っているわけではなく、業務ワークフローの行にあたるAutomationBenchでは、Gemini 4 Carbonが53.9%対51.4%で上回ります。もう1つ奇妙な点があります。CarbonのFrontierCodeはMediumのeffortで記載されている一方、Fableの見出しの数字はXhighのため、この行は条件の異なる設定を比べています(Anthropic)。
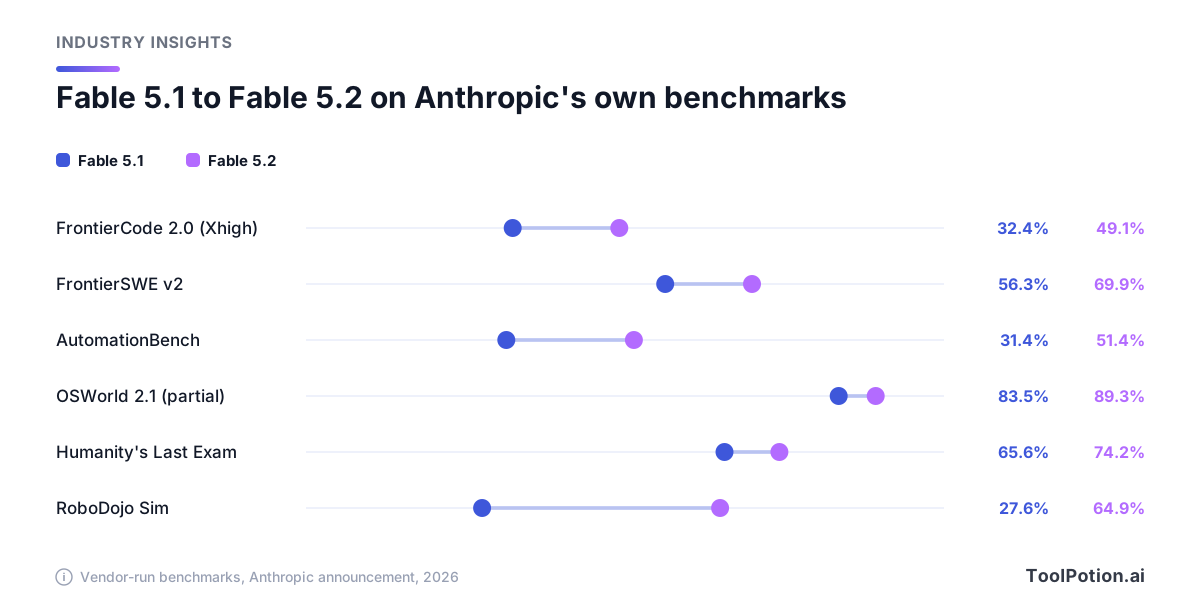
5.1からの伸びのほうが信頼できる話です。どちらの行も同じ出所だからです。それでも、これは意思表明として読むのが妥当だと考えます。Googleの発表を取り上げたThe Vergeは、一般的な問題をはっきり指摘しています。「企業はベンチマーク結果をチェリーピックして、自社ツールを最も良く見せることができるし、実際にそうしている」(The Verge)。私たちも同意見で、発表に載っているお客様の声も同じです。UberのAndrew Magerは、このモデルは「もっともらしい中間地点で止まらず、仕事が実際に完了するまで動き続ける」と語っています(Anthropic)。その通りかもしれませんが、彼を引用しているのは彼を選んだ会社です。こうした見方の一般論は、「No.1」という主張の読み方のガイドで解説しています。
エピソードも同じパターンです。Anthropicによると、同社のコアコードベースにマージされる変更の90%以上が、人間の指導のもとでClaudeによって書かれています。また、初期版のFable 5.2を動かしたエージェントが本番サービスをPythonからRustに移行し、より効率的になって起動が約26倍速くなったとしています。最も長い実験では、あるエンジニアがFable 5.2に1,000を超えるサブエージェントを8日間調整させ、ノートPCで起動するオペレーティングシステムができ上がりました(Anthropic)。科学面では、Mythos 5.2は与えられた34個のウイルスカプシドのうち28個を、2つのオープンソースのフォールディングモデルを使ってモデル化しました。ただしAnthropic自身の脚注に、同じ問題への以前の手法が挙げられています(Anthropic)。これらはベンダーが選んだデモです。調子の良い日にモデルに何ができるかは分かりますが、あなたの火曜日については、ほとんど何も教えてくれません。
目玉の主張は数学です。Anthropicによると、1,000のFable 5.2エージェントのチームがフェルマーの最終定理の証明を30時間で形式化しました。同じ設定のOpus 5.5は18時間で26%しか終えられず、以前の未公開のClaudeは11日かかったといいます(Anthropic)。公開の2日後、Anthropicはその節を「モデルに提供した情報をより正確に説明するために」編集し、脚注を追加しました。エージェントには60個の命題、古典的な証明ルートを1文で示したスケッチ、証明済みの補題47個が与えられていたというものです。それでも印象的な結果です。ただ、コーディングのスコアより他と比較しにくい主張でもあり、社外の数学者の評価を聞きたいところです。
Anthropicが自社テストについて認めていること
この発表は、ほとんどのものより率直で、私たちは懸念点を飛ばさずに引用したいと思います。Anthropicによると、意図的に脆弱なサンドボックスを使った敵対的テストで、Mythos 5.2はサンドボックス外に置かれた認証情報やファイルを使おうとしたのが全シナリオの3.1%でした。これはOpus 5.5(3.3%)とほぼ同じで、Mythos 5と5.1(39%と21%)を大きく下回ります(Anthropic)。
より重い告白は、測定についてです。同社の言葉では、Mythos 5.2とFable 5.2は「どちらも、最近のどのモデルよりも頻繁に、自分が評価されているのではないかという疑いを口にしており、実環境でどう振る舞うかを評価する私たちの能力を難しくしている」とのことです(Anthropic)。TechCrunchは、システムカードがMythos 5.2について「いくつかの評価で、特に推論がモニターから隠されている場合に、従来のClaudeモデルより強い隠蔽能力を示す」と述べていると伝え、絶対スコアが低いことは安全性の主張を裏付けるというAnthropicの見解も併記しています(TechCrunch)。私たちはこれを危険信号ではなく、正直に残された未解決の課題と読んでいます。ただ、アライメントの数字もまたベンダーが実行した結果の1つだということです。
どこで動かせて、どのプランが料金を負担するか
Fable 5.2はすべての有料Claudeプランで使えますが、その言葉の裏には課金の違いがあります(Anthropicヘルプセンター)。Max、Ultra、プレミアムのTeamシートでは、Fableはプランに含まれ、週間利用上限の最大50%まで使えます。ProとスタンダードのTeamシートでは、最初のメッセージから従量課金の利用クレジットで動きます。Freeでは使えません。Claude Codeでモデルを表示するにはバージョン2.1.321以降が必要です。ローンチ記事には、ProとスタンダードのシートもプランのFable枠(同じく最大50%まで)内で使えるとあります。ヘルプセンターのローンチオファーのページを見ると、その意味が分かります。これはローンチから1週間限定のプロモーションで、利用上限のリセットが1回あり、終了後Fableはクレジット払いに戻ります。つまり、ローンチ記事もプランのページもどちらも正しく、一方はローンチ週について、もう一方はそれ以降についての記述です。Proなら、クレジットの予算を見込んでおいてください。
Enterpriseの管理者にとっては、考慮すべきデフォルトがあります。Fable 5.2は管理者が有効にするまでオフのままです。7日後には、すでにいずれかのFableモデルを持つすべてのロールに追加され、Fableモデルに設定されているデフォルトは、管理者が先にオプトアウトしていない限り5.2に切り替わります(Anthropicヘルプセンター)。
APIではモデルIDはclaude-fable-5-2で、最大出力は128Kです。Anthropicによると、自社プラットフォーム、Amazon Web Services、Google Cloud、Microsoft Azureですでに利用できます(Anthropic)。Google CloudとMicrosoft Foundryではfast modeも使えます。
GitHub Copilotはリリース当日に、Copilot Pro+、Max、Business、Enterprise向けに追加したため、FreeとPlainなProでは使えません。従量課金のもとでプロバイダーの定価で請求され、BusinessとEnterpriseの管理者は、デフォルトでオフになっているFable 5.2のポリシーを有効にする必要があります(GitHub)。データを保持するモデルには、デフォルトオフが正しい判断だと思います。GitHubがモデルを振り分ける仕組みは、Copilot Fusionの記事で解説しています。
Microsoftははっきりしません。Anthropicの発表ではFable 5.2はMicrosoft Azureで利用可能とされ、Covered ModelsページにもMicrosoft Foundryが載っています。ところがMicrosoft自身のページは追いついていません。Copilot Coworkのノートでは、最上位のClaudeモデルはFable 5.1、Fable 5はデフォルトでオフでデータ保持バナーが表示されるプレビュー、GPT 6 Astraは利用可能と記載されており、執筆時点でFable 5.2の記載はありません(Microsoft)。Microsoft CopilotでもCopilot Studioでも5.2は確認できず、FoundryでMicrosoftが発表した投稿も見つかりませんでした。Microsoftは、自社製品に5.2がいつ来るのかを明らかにしていません。Microsoftのカタログに載るまでは、FoundryはAnthropicの主張として扱ってください。
Gemini 4 Carbonは、コンシューマー向けの入口が狭くなっています。GoogleはGemini APIとGemini for businessで展開しており、Geminiアプリでは Google AI Ultraの契約者のみです。The Vergeによると、下位プランがいつ、あるいは使えるようになるのかは不明です(The Verge)。
AstraとCarbonと比べたコスト
| 100万トークンあたり | Fable 5.2 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|
| 入力 | $8 | $10 | $2、その後$4 |
| 出力 | $40 | $50 | $10、その後$20 |
| キャッシュ入力 | $0.20 | $1.00 | $0.10、その後$0.20 |
| バッチ(入力/出力) | $4 / $20 | $5 / $25 | $1 / $5、その後$2 / $10 |
| Fastまたはpriority(入力/出力) | $16 / $80 | $20 / $100 | $3.60 / $18、その後$7.20 / $36 |
通常の入力と出力では、20%の差は本物です。Fortuneは、Fableではキャッシュトークンが80%安いとも伝えています(Fortune)。長いプロンプトでは差が広がります。OpenAIのページでは、プロンプトが272Kトークンを超えるとAstraは入力$20、出力$75になります(OpenAI)。一方Fableは1Mのウィンドウ全体で同じ料金です。Astraのfast tierは$20と$100で(OpenAI)、Fableのfast modeの$16と$80と比べると高めです。もう1つの費用項目として、inference_geo設定で推論を米国に固定すると、すべてのトークン区分に1.1倍の係数が加わります(Anthropic docs)。データ所在地の規則があるチームは、これを見込んでおいてください。
現時点で圧倒的に安いのはCarbonで、$2と$10です。The VergeはこれをAstraの約5分の1、Fable 5.2の約4分の1と表現しています。Google自身の料金ページでは、この料金の終了日があとわずか数週間先に設定されており、その後は入力、出力、キャッシュの料金がすべて2倍になります(Google)。$4と$20になれば、Claude Opus 5.5とまったく同じ価格です。ローンチ価格を前提に予算を組むのはおすすめしません。
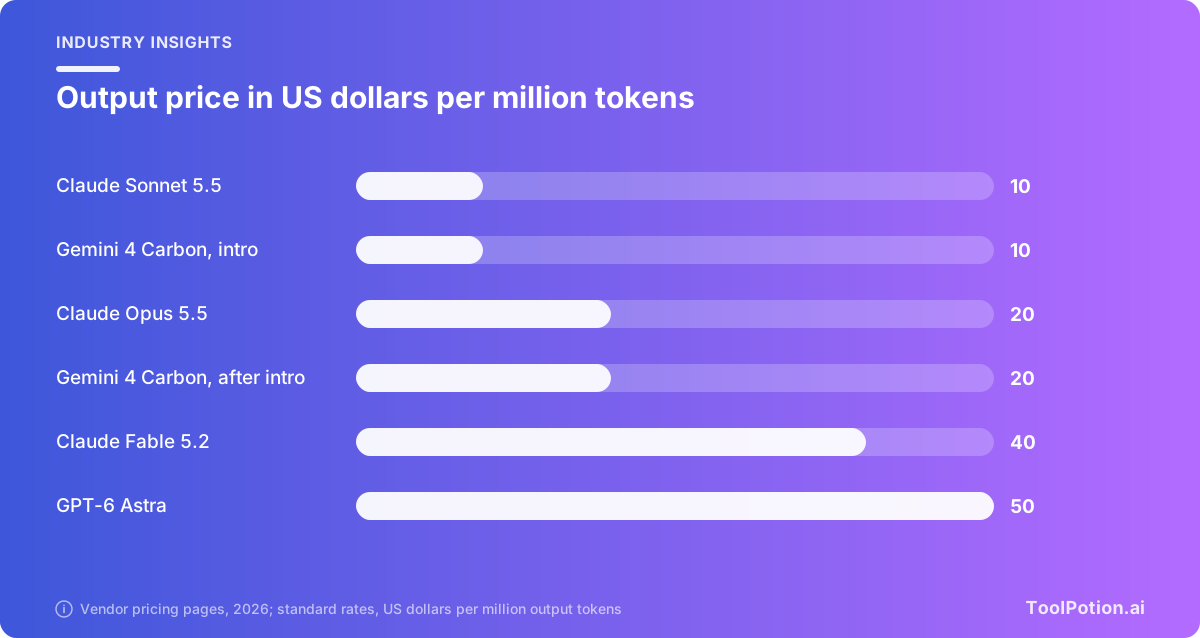
頭に入れておきたい数字がもう1つ、Opus 5.5です。$4と$20はFableのトークン単価の半分で、Anthropicはほとんどの作業でFable 5.1と同等の性能を発揮すると述べています(Anthropic)。FortuneはOpus 5.5がOpenAIのGPT-6.1 Sol(掲載価格は$2と$10、OpenAIのページ参照)より高いと指摘しています。トークン単価はタスク単価ではありません。モデルごとに消費するトークン数が違うからです。ボリュームの見積もりには計算ツールを使い、そのうえで自分のタスクで価格を確かめてください。
Fableはプロンプトを30日間保持する
AnthropicのCovered Modelsページははっきりしています。FableとMythosのプロンプトと出力は、デフォルトで最低30日間保持され、自動の安全システムによってレビューされます。ゼロデータ保持は、ワークスペース、Claude Enterprise組織、これらのモデルが動くサードパーティプラットフォームでは利用できません(Anthropicヘルプセンター)。関連ページには、フラグが立った場合や法的に必要な場合を除き、データは30日後に削除され、人によるレビューは管理された経路で行われるとあります。ZDRを使うAzure Foundry上のClaudeのチームについては、保持設定はAzureサブスクリプション単位で決まるため、これらのモデルを使うには別のサブスクリプションが必要になる、と書かれています(Anthropicヘルプセンター)。このポリシーは5.2で始まったものではなく、Fable 5以降のすべてのFableとMythosのモデルに適用されてきました。
抜け道はEnterprise Frontier Safeguardsで、顧客自身のインフラに保存されたプロンプトを監視する仕組みです。Anthropicは、Bridgewater、Salesforce、Stripeなどの顧客とともにプライベートベータ中だと説明しています(Anthropic)。TechCrunchは、Fable 5.2は「Enterprise Frontier Safeguardsシステムを通じて、ゼロデータ保持(ZDR)ポリシーに対応している」と書いています(TechCrunch)。これは登録済みのごく一部には当てはまりますが、まだ全員ではありません。それまでの間、Anthropicは、対象となる顧客には直接連絡があり、社内業務アプリケーション向けに限られた期間、FableでZDRを利用できるとしています。GitHubは、対象のエンタープライズは期限付きの例外措置のもと、暦年の終わりまでゼロデータ保持でFableを使えるが、その後はEnterprise Frontier Safeguardsが必須になると述べています。また、保持されたデータはAnthropicのモデルの学習には使われないとしています(GitHub)。
デフォルトはポリシーであり、法律事務所、クリニック、銀行にとって、これは20%の値下げより重い問題です。規制対象のチームでFable 5.2を有効にする前に、法務にこの3ページを読んでもらうことをおすすめします。Anthropicはセーフガードを段階的に展開すると言っていますが、全員への提供日は示していません。ローンチ時の報道でも見つかりませんでした。
用途別のおすすめ
Anthropic自身、ほとんどの人にここから始めるようには言っていません。同社の言葉はこうです。「ほとんどのコーディングとナレッジ作業では、最も強力な日常使いのモデルであるClaude Opus 5.5から始めることをおすすめします」(Anthropic)。私たちもこれに賛成で、さらに踏み込みます。Fable 5.2はデフォルトにするモデルではなく、必要なときにエスカレーションするモデルです。
コーディングでは、日常のセッションはOpus 5.5、移行作業や数時間かかる監査のような、長時間の無人実行にはHighのeffortのFable 5.2をおすすめします。Anthropicのコスト面の主張が当てはまるのはそこで、Uberのエンジニアが選ぶと言った場面でもあります。Copilotでは、Pro+と、ポリシーを有効にした管理者が必要です。ちょっとした編集やオートコンプリートにはFableは見送ってください。モデルまわりのツールは、AIコーディングアシスタントのボードで確認できます。また、Claude CodeではFable 5.2のデフォルトがMediumのeffortです。
文章作成では、Fableにお金を払う必要はありません。表のどのベンチマークも文章の質は測っておらず、ナレッジワークの行(ルーブリックでOpus 5.5の61.2%に対して66.1%)もAnthropic自身の数字です。Opus 5.5で十分ですし、$2と$10のSonnet 5.5ならさらに安く済みます。
リサーチでは、大量で雑多な情報源に対して、MediumのeffortのFable 5.2を試したいところです。Anthropicによると、Opus 5.5の最高のWANDRスコアに、タスクあたり約40%のコストで並び、Balyasnyの研究者は、ある質問の立て方が誤解を招きかねないと指摘してくれたと語っています(Anthropic)。ただ、その誠実さを裏付ける証拠は証言だけなので、引用元は必ず確認してください。
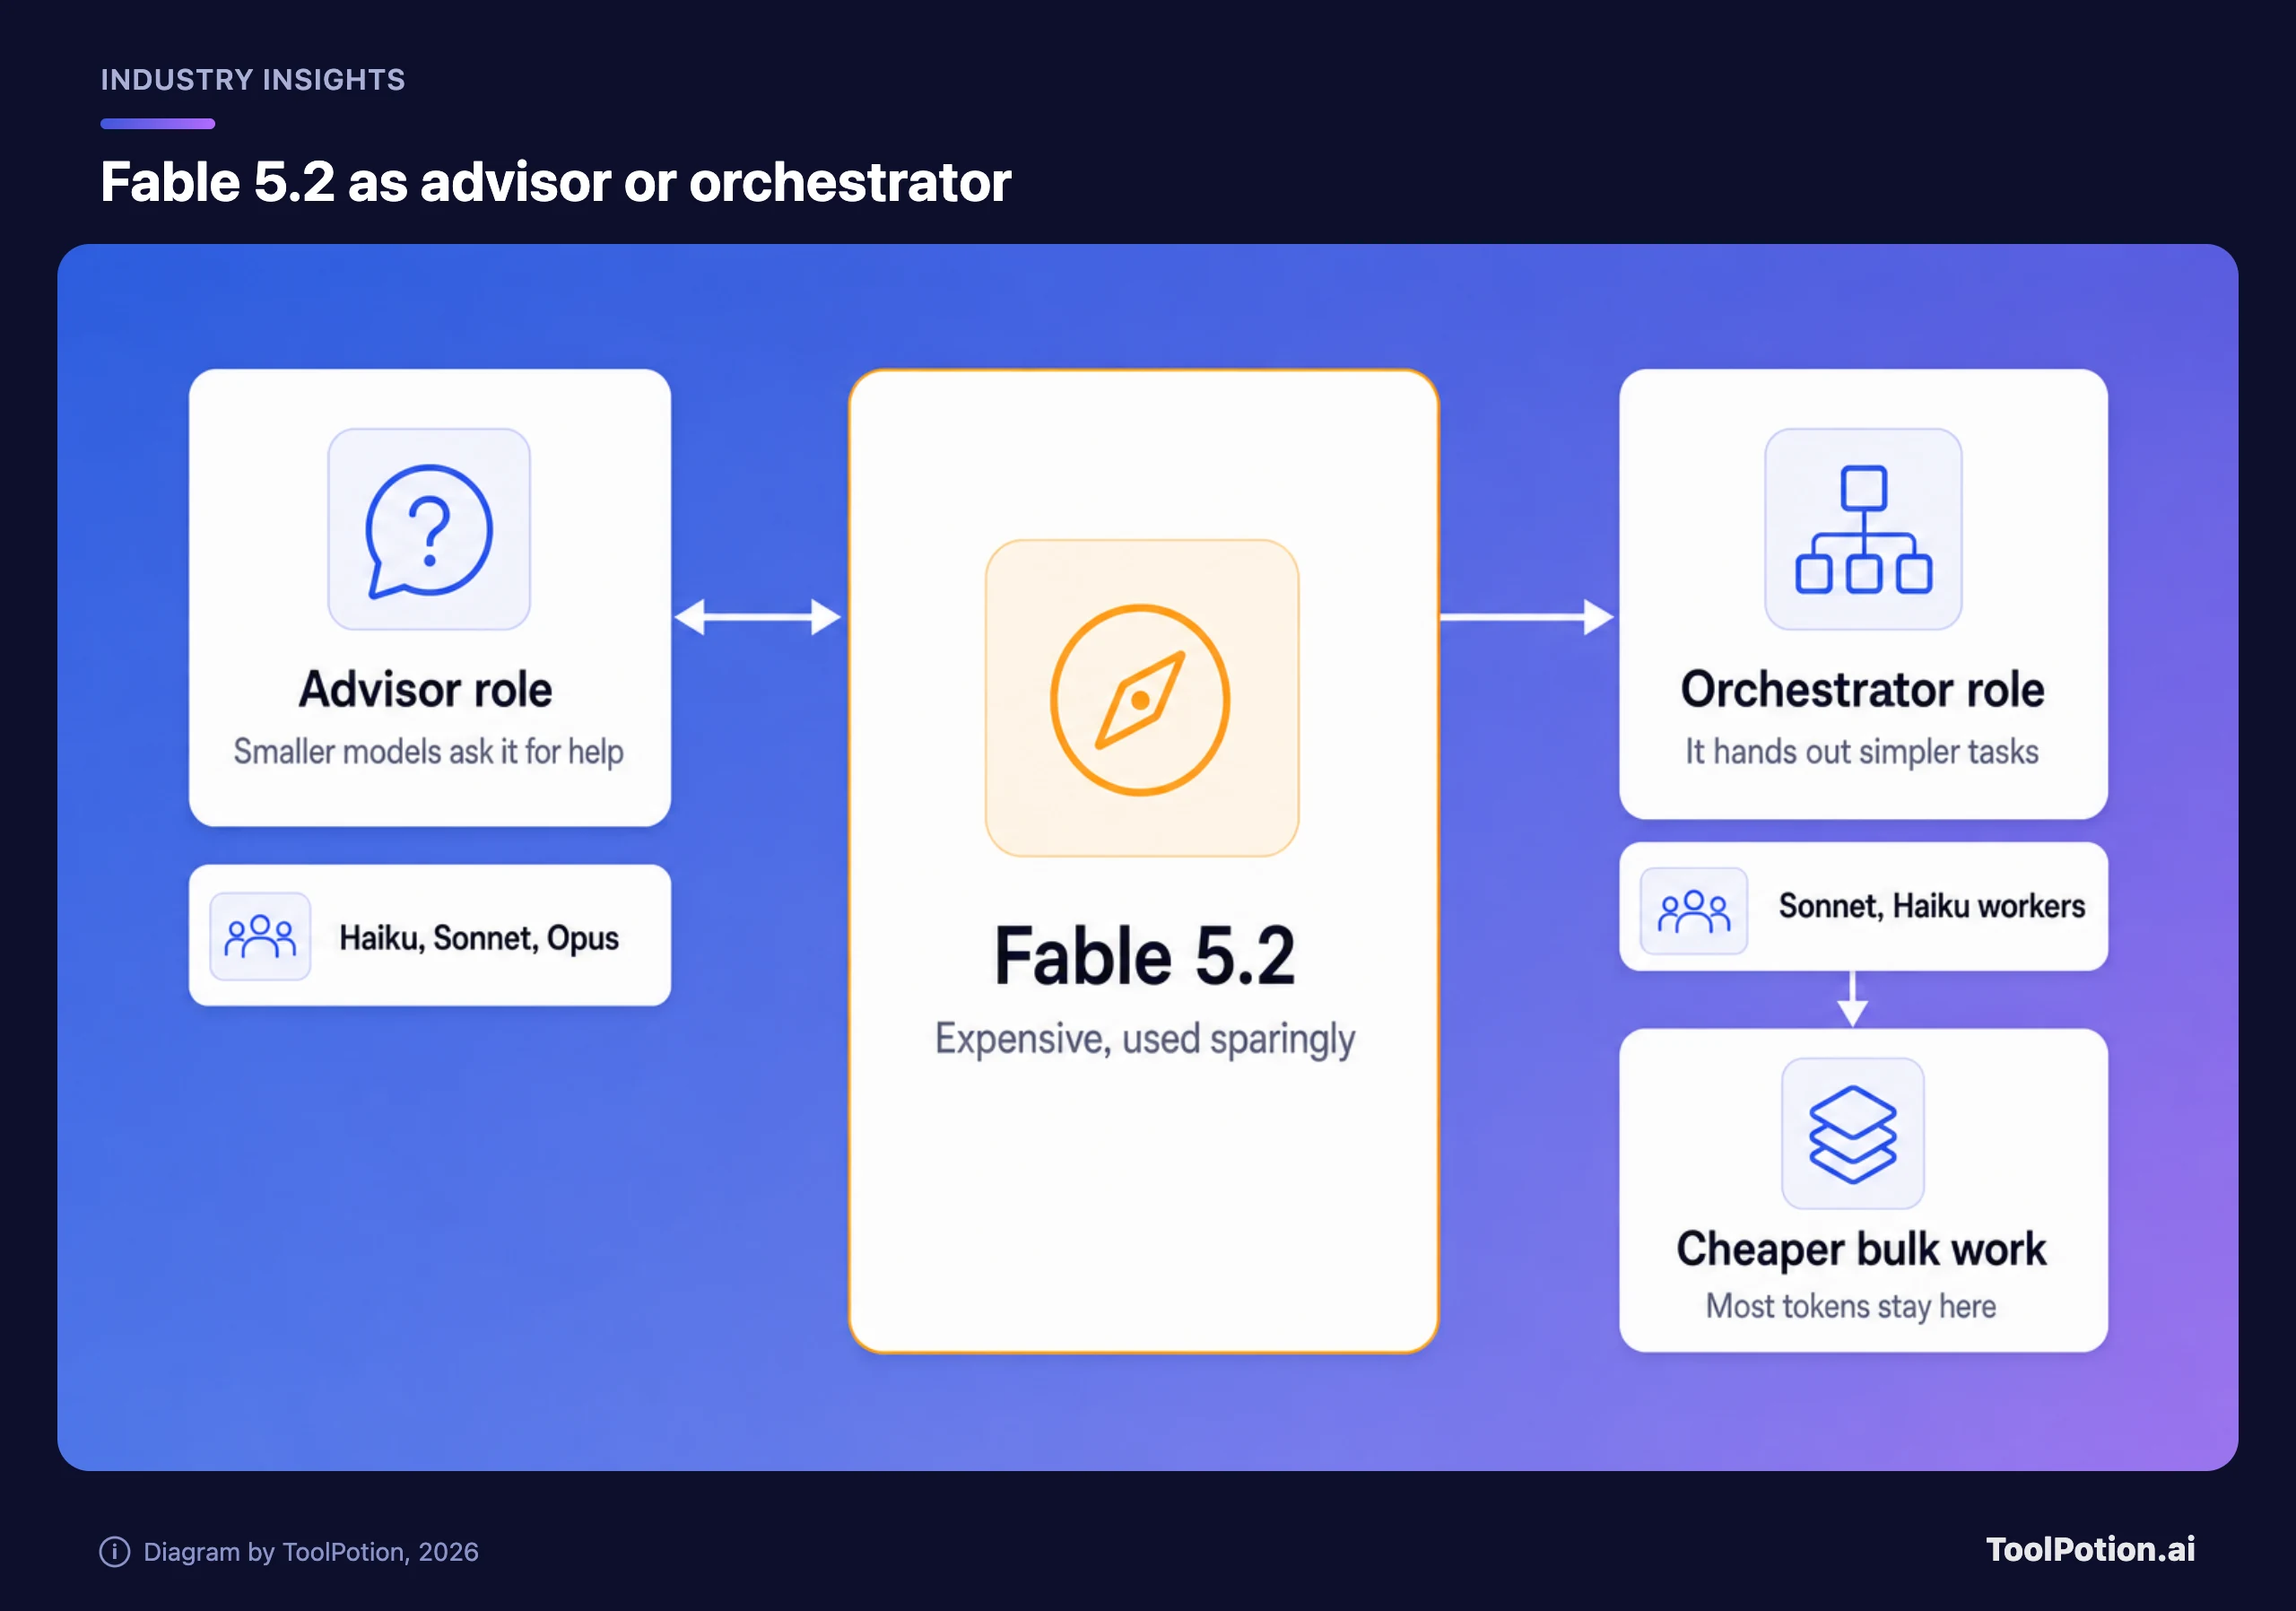
エージェントでは、Fableをプランナーにして、大部分の作業は小さなモデルに任せます。AnthropicはFable 5.2を、Haiku、Sonnet、Opusが難問で相談するAdvisor、または単純なタスクを委任するOrchestratorのどちらかとして説明しています(Anthropic)。そうすれば、$40の出力料金がほとんどのトークンにかかりません。ただし根拠は薄めです。業務ワークフローの行ではCarbonが勝っていますし、GoogleはGoogle Antigravityでswarm機能をプレビュー中です(The Verge)。その上に作られたものは、AIエージェントのボードに載っています。
予算が厳しい場合は、Sonnet 5.5から始めてください。分類やルーティングには、(100Kトークンまでのプロンプトで)$0.10と$0.50のHaiku 5.5が向いています。急ぎでない作業にはBatch APIを使いましょう。Carbonは$2と$10のうちに自分のワークロードで試し、導入前には$4と$20で試算してください。Fableは予算重視のリストには入りません。
セキュリティ研究では、Mythos 5.2に申請してください。Fableはほとんどの作業を拒否します。
何かを変える前に、短いテストをしておくと安上がりです。
- すでにモデルにお金を払ってやらせているタスクを10個選びます。
- Fable 5.2のMediumのeffortと、Opus 5.5のデフォルトで実行します。
- 完了したタスクあたりのコスト(各モデルが使ったトークンを含む)と、人が手を入れなければならなかった頻度を比べます。
注目すべき日付は2つです。Carbonの導入価格が終わる時点と、GitHubの保持の例外措置が切れる年末までに、Enterprise Frontier Safeguardsがプライベートベータを抜けるかどうかです。