

GPT-6 Astraは、今年OpenAIが出した最上位モデルです。ブラウジング、フォーム入力、コーディング、ドキュメント作成といった、パソコン上の長い複数ステップの作業向けに作られています。実在し、すでに使えますが、ほとんどの人が最初に選ぶべきモデルではありません。下位モデルのGPT-6.1 Solが、Astraのできることの大半を5分の1の価格でカバーしてくれます。
OpenAIがAstraを発表したのは約5週間前です。まず一部の組織に限定して提供し、その後、有料のChatGPTプランとAPIに広げました。ファミリーの残りも続いて登場し、約3週間後にGPT-6 SolとGPT-6 Luna、その1週間後にGPT-6.1 Solがリリースされました。名前の付け方は紛らわしく、ベンチマークの主張は派手で、安全面の注記は異例なほど率直です。このガイドでは、各モデルの位置づけ、使えるプラン、料金、無視してよい人を整理します。
以下の内容は、OpenAI自身のドキュメントと料金ページ、さらに外部の報道や評価に基づいており、出典は該当箇所に明記しています。OpenAIの主張と第三者の数値が食い違う場合は、両方を載せています。
GPT-6 Astraとは
OpenAIのモデルドキュメントは、Astraを「最も要求の厳しい作業向けの最高性能モデル」と位置づけ、複雑な推論、コーディング、コンピューター操作、リサーチ、ドキュメント作成を最も得意とするとしています(OpenAI API docs)。入力はテキストと画像、出力はテキストです。コンテキストウィンドウは105万トークン、最大出力は12万8,000トークンで、推論の強度はlowからmaxまでの5段階で設定できます。
Chat CompletionsとResponsesの両エンドポイント、およびBatch APIで利用できます。リアルタイム会話、ファインチューニング、音声には対応していません。Responses APIではWeb検索、ファイル検索、コード実行、コンピューター操作を使えるため、単なるチャットボットではなく、エージェントの中核エンジンとして動かせます。
Astraは小さなモデルファミリーの最上位に位置します。OpenAIのモデルページにある3つのGPT-6モデルは、いずれも105万トークンのウィンドウと12万8,000トークンの出力上限が共通です(OpenAI API docs)。違いは、どれだけの「頭脳」を買うかです。
| モデル | OpenAIによる説明 | 入力/出力(100万トークンあたり) |
|---|---|---|
| GPT-6 Astra | 最高性能、最も要求の厳しい作業向け | $10 / $50 |
| GPT-6.1 Sol | Astraに近い性能を低コストで | $2 / $10 |
| GPT-6 Luna | 最も効率的、用途を絞った大量処理向け | $0.10 / $0.50 |
価格はOpenAIの料金ページに載っている標準モードの定価です。GPT-6.1 Solは先に登場したGPT-6 Solのアップグレード版で、そのため一部では旧名称を目にすることがあります。
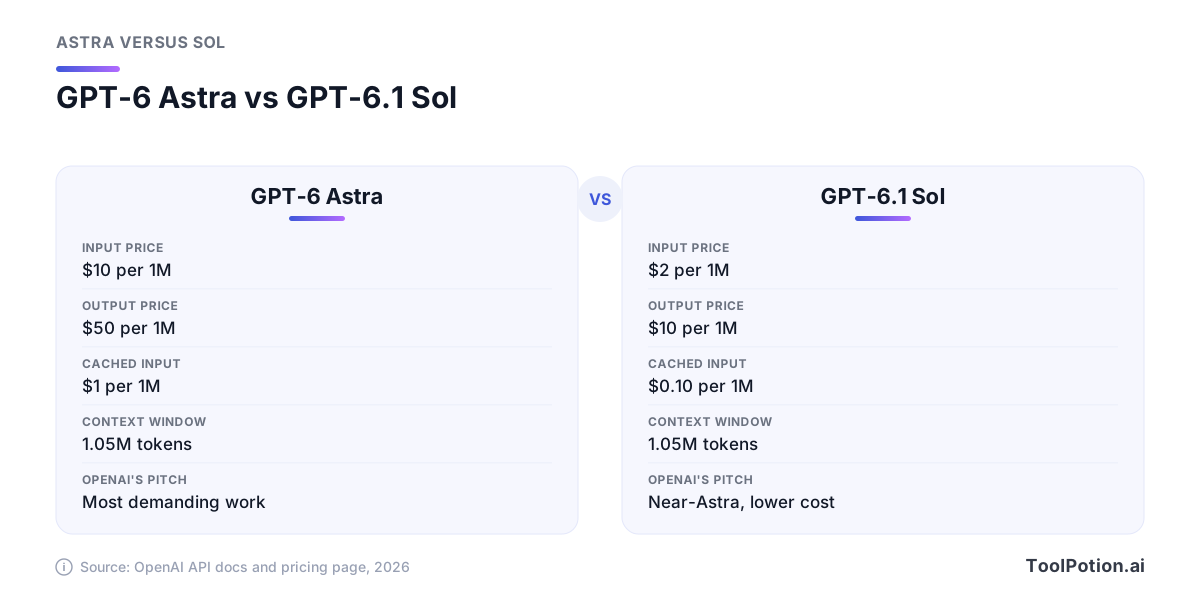
上のカードは、実際に迷いやすい2つのモデルを並べたものです。コンテキストウィンドウは同じで、違うのは価格と性能の上限だけです。
Astraが使えるChatGPTプラン
OpenAIのプラン比較ではっきり分かれています。FreeとGoにはAstraの記載がありません。Plusには含まれ、Proは拡張アクセスで、Proは「GPT-6 Astraによる Pro推論」と銘打たれています。Freeプランのテキストチャット無制限枠は、GPT-6ファミリーではなくGPT-5.6 Lunaで動いています。
| プラン | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| Free | なし | なし | なし |
| Go | なし | なし | なし |
| Plus | あり | あり | あり |
| Pro | 拡張 | 拡張 | 拡張 |
| Business | 柔軟 | 柔軟 | 柔軟 |
| Enterprise | 柔軟 | 柔軟 | 柔軟 |
「柔軟」はBusinessとEnterpriseについてOpenAIが使っている表現で、アクセス自体は可能であり、組織は追加利用分のクレジットを購入できます。標準のBusinessシートは年払いで月額20ドル、月払いで25ドル、Premiumシートは100ドルまたは125ドルです(OpenAI business pricing)。
OpenAIのリリース記事によると、Astraはまず限られた組織に提供され、その後数日かけてPlus、Pro、Business、Enterpriseのユーザー、API、Microsoft Azure、AWS Bedrockに展開されました(OpenAI)。有料プランなのに表示されない場合は、少し時間を置いて再確認してください。
Solについては一点注意があります。プラン表ではGPT-6.1 SolがPlus以上に載っていますが、リリース時のOpenAIの説明では、ChatGPT WorkとCodexでは利用でき、通常のChatではまだ使えませんでした(OpenAI)。ChatGPT内でどのモデルがどこに出るかは週単位で変わりうるので、この表を含め、どの表も鵜呑みにせずモデルピッカーで確認してください。
OpenAIが語る新機能
OpenAIの目玉はエージェント的な作業です。ソフトウェア、ブラウザ、ドキュメント、コードをまたぐ長いタスクを、手取り足取りの指示なしでこなせるとしています。リリース記事によると、デスクトップ操作のテストであるOSWorld 2.0で、AstraはGPT-5.6 Solより1タスクあたり約47%短い時間で72.6%を記録しました。GPT-5.6 Solは65.7%で、所要時間は約75分です。実際のソフトウェア上の専門業務を測るAgents' Last Examでは、Claude Opus 5の55.5%に対して59.3%で、出力トークンはOpusより約65%少ないと報告しています(OpenAI)。
同じ表には、Astraが勝てていない項目もあります。BenchCADではClaude Fable 5.1の84.3%に対して95.9%ですが、Artificial AnalysisのIntelligence Index(バージョン4.1.1)ではFable 5.1の65.7に対して61.2です。いずれもベンダーが選んで自社で実施した数値ですが、OpenAIは負けている項目もきちんと掲載しています。
コストも見逃せません。Astraの入力10ドル・出力50ドルは、現在のGPT-5.6 Solの定価(4ドルと20ドル)の2.5倍です。ただしOpenAIはSolの価格をプロモーション価格と表示しています(OpenAI pricing)。多くの人がアップグレードの比較対象にするのは、旧世代のGPT-5.6でしょう。
コンピューター操作の仕組み
コンピューター操作は一種のループで、OpenAIのガイドは3つの動作で説明しています。スクリーンショットを撮り、モデルに操作させ、タスクが終わるまで繰り返すというものです(OpenAI docs)。モデルはクリック、ダブルクリック、ドラッグ、スクロール、入力、待機ができます。OpenAIが推奨するのは、Playwrightなどのツールを通じて画面を操作する短いPythonやJavaScriptをモデルに書かせる方法で、通常のcomputerツールも代替手段として引き続きサポートされています。ガイドでは、コードを書かせる方式にはAstra、computerツールにはgpt-6.1-solが適しているとしています。
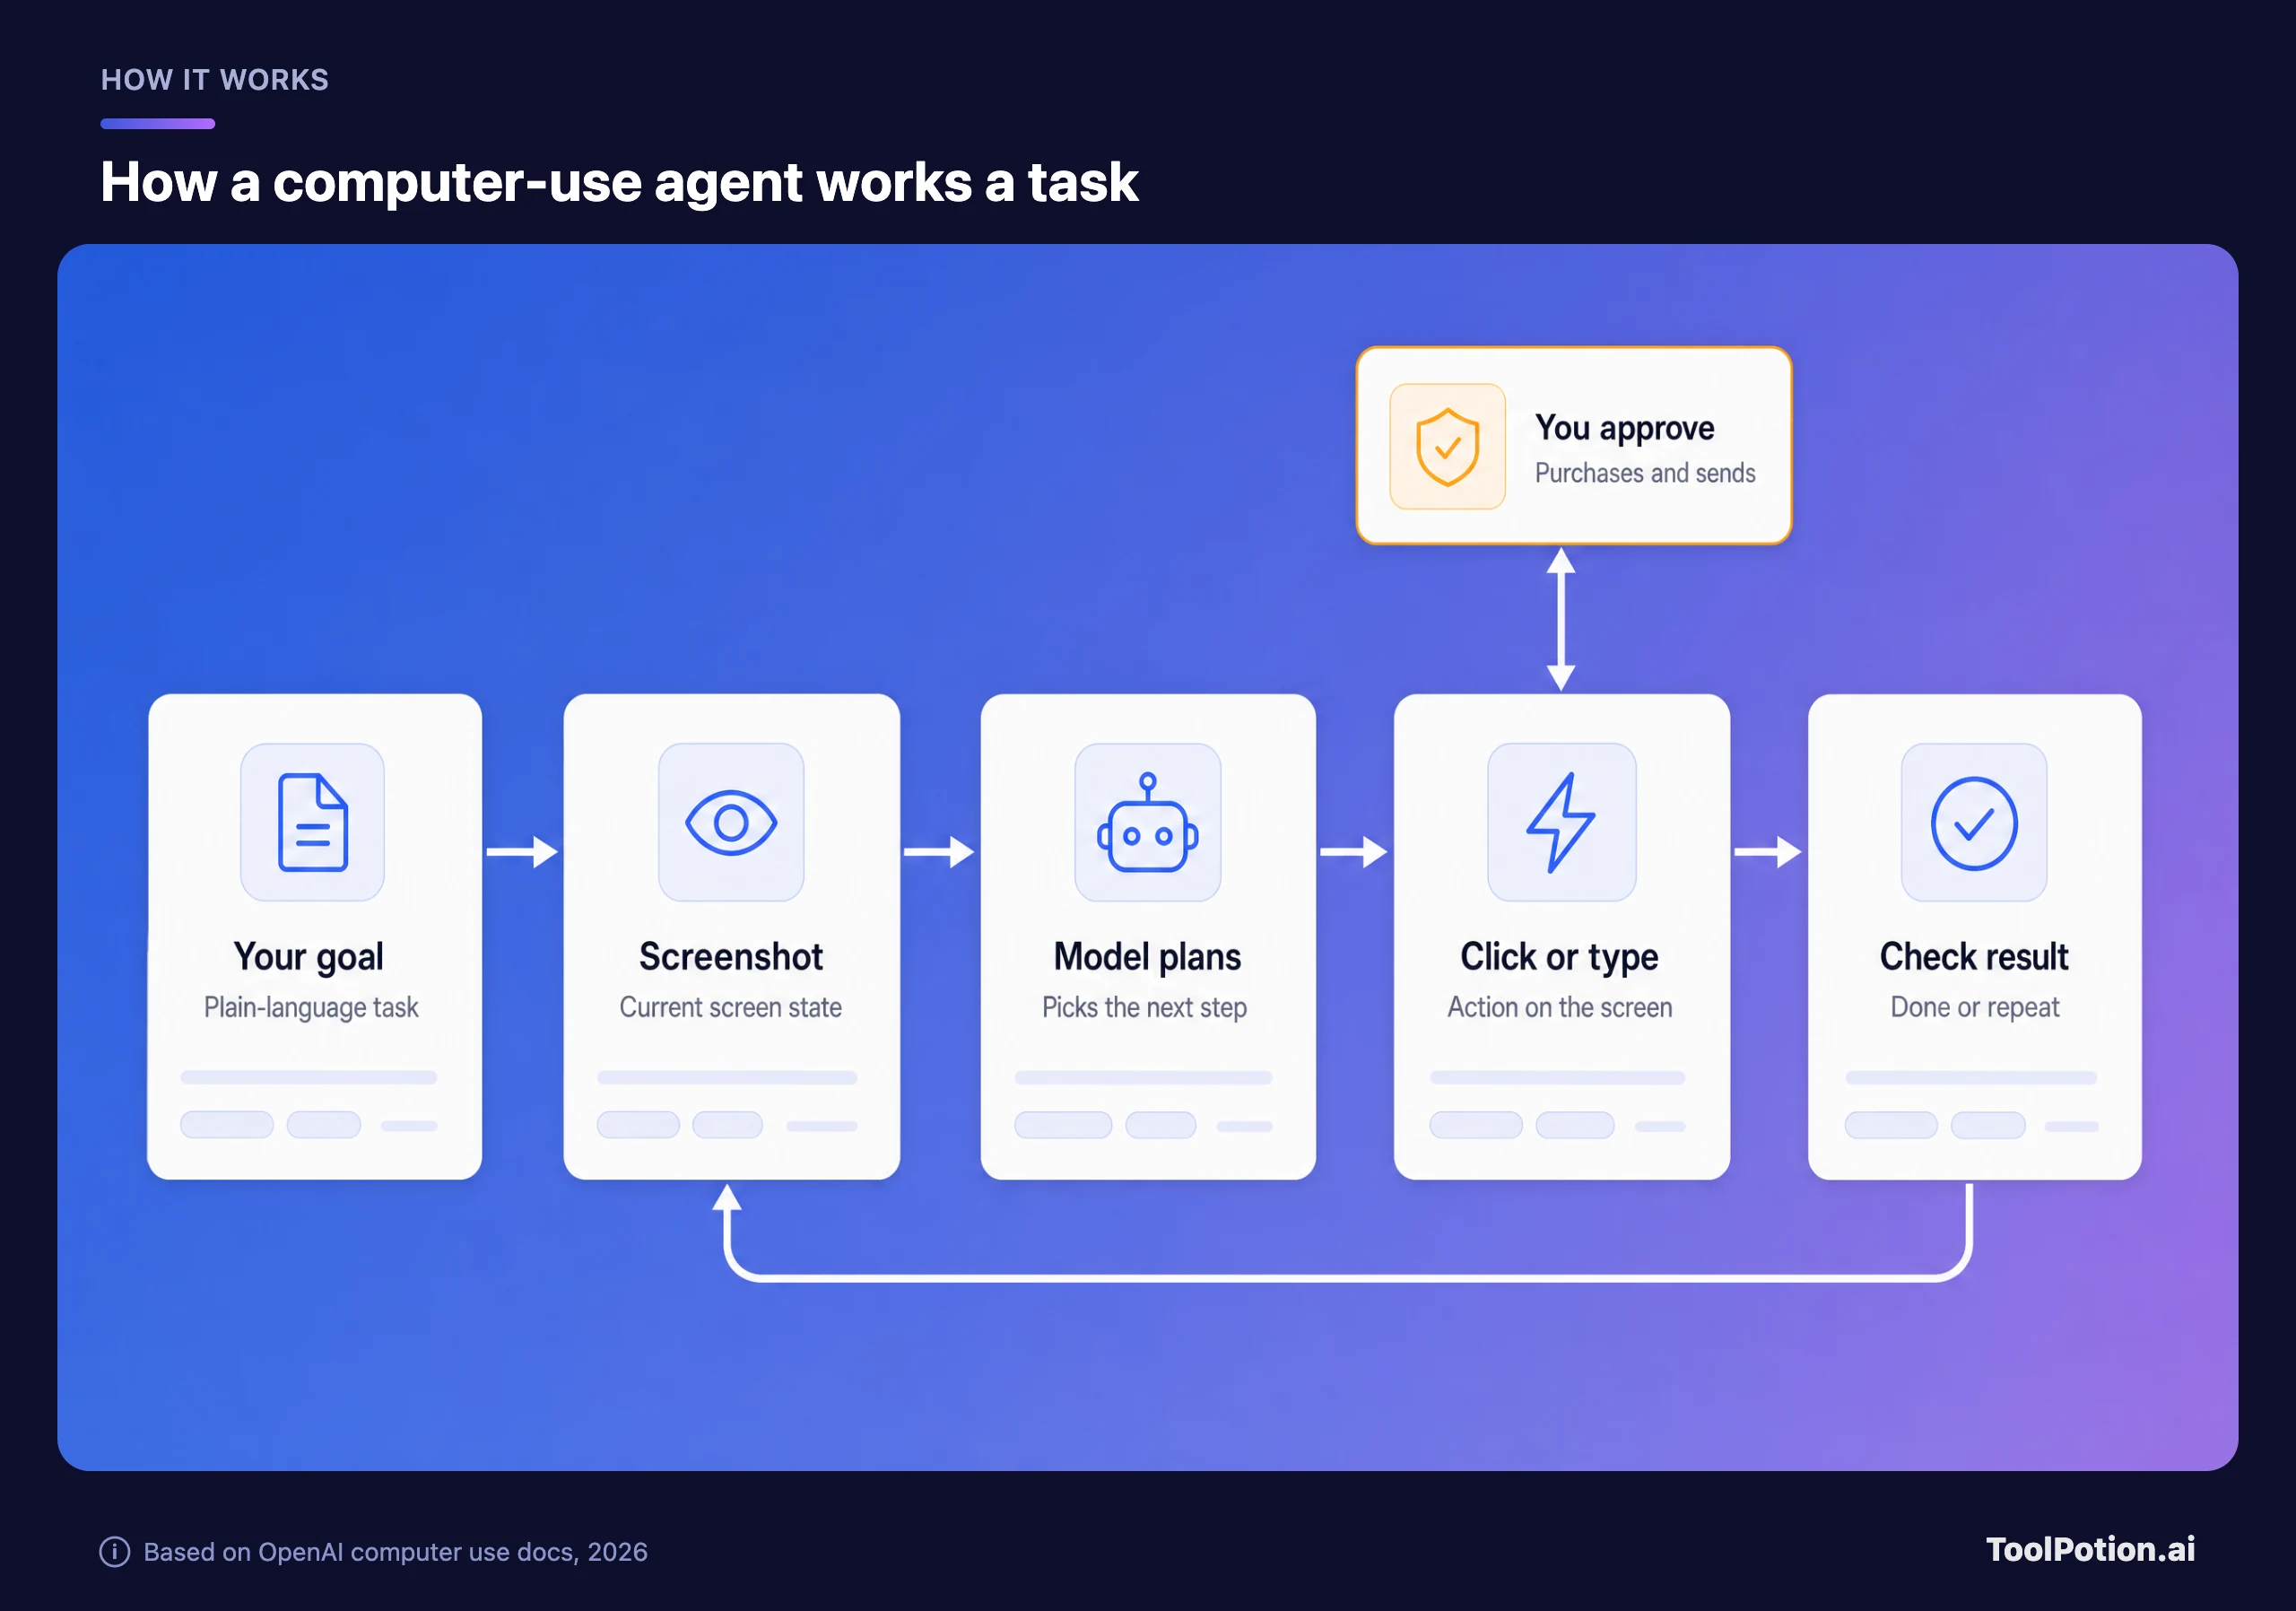
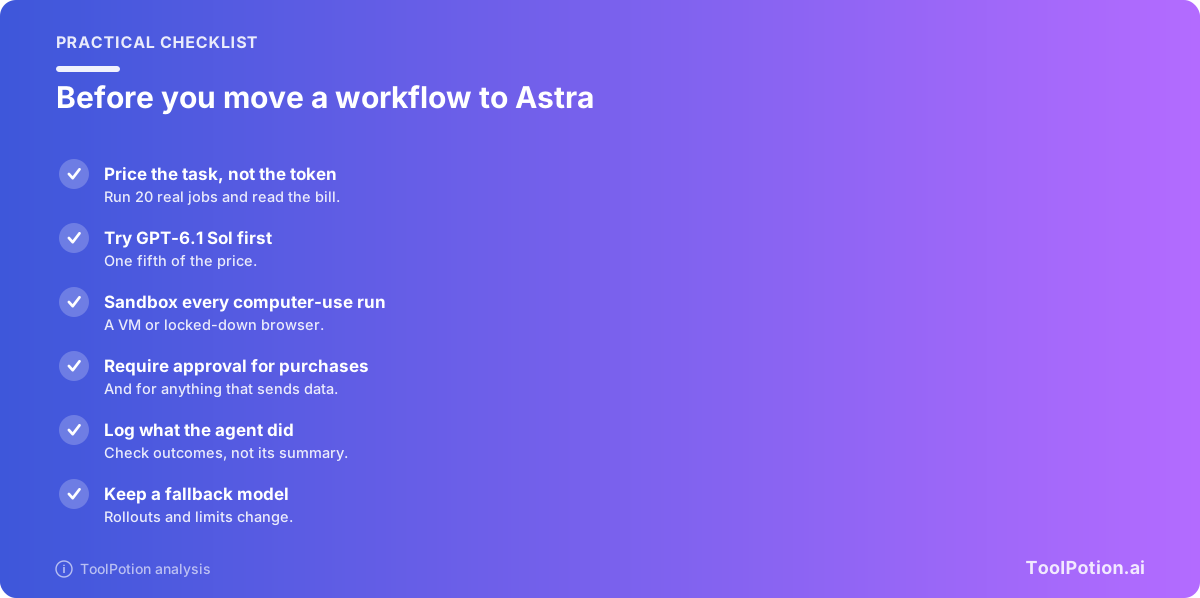
重要なのは琥珀色のカードです。同じガイドは、開発者に対して、サンドボックス化したブラウザや仮想マシンで環境を隔離すること、購入などリスクの高い操作は実行前に確認を取ること、画面上の内容はすべて信頼できないものとして扱うことを求めています。Webページ上のテキストがエージェントを誘導しようとする可能性があるためです。さらに、フォームに機密情報を入力する行為は、それを送信したのと同じ扱いになるとも書かれています。
一般向けに言えば、これはChatGPT Atlas、Perplexity Computer、Claude for Chromeといったブラウザエージェントや、一般的なComputer Useの仕組みの裏側にある技術です。Astraはそのループを回すより強力なエンジンですが、種類の違うものではありません。
第三者評価でわかったこと
外部のテスターによる評価は、リリース記事よりも評価がまちまちです。DeepLearning.AIのThe Batchによると、Artificial AnalysisのIntelligence Index(バージョン4.2、最大強度)では、Claude Fable 5.1が57、Astraが55、Claude Opus 5が54、GPT-5.6 Solが51です(The Batch)。
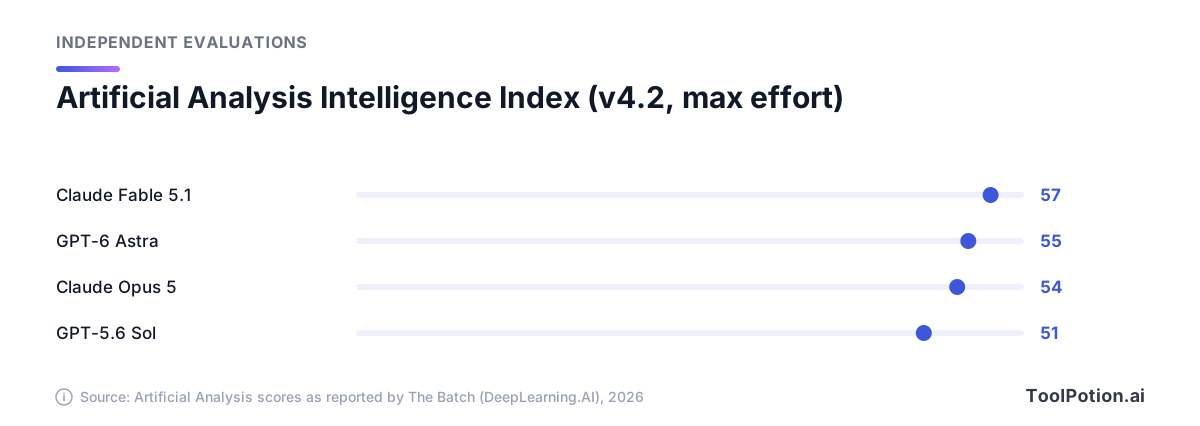
つまりAstraは前世代から明確に前進していて、このバージョンの指標では2位です。ただし順位は安定していません。The Batchによると、より新しいv4.3では、2つのテスト項目が入れ替わった影響もあり、AstraはFable 5.1と53で首位タイになりました。指標のバージョンによって順位が変わるようでは、誰が上かは断言できません。
The Batchからは、第三者のデータをさらに2つ紹介します。各分野が米国経済に占める割合でテストを重み付けするVals Indexでは、AstraはFable 5.1の68.83に対して66.61でしたが、1タスクあたり25分で、Fableの76分より大幅に速くなっています。また、Artificial Analysisのエージェント型コーディングタスクでは、トークン単価がGPT-5.6 Solの2.5倍でも、使用トークンが3分の1だったため、1タスクあたりのコストはほぼ同じでした。
もうひとつ、注釈が必要な目玉スコアがあります。OpenAIはARC-AGI-3で99.9%を報告しました。ベンチマークを運営するARC Prizeもこの数字を認めていますが、それはリクエスト間でモデルの推論状態を保持するProvider Adapterの構成に限った話です。標準の構成でのAstraのスコアは62.7%でした(ARC Prize)。どちらも最先端のスコアですが、測っている構成が違います。
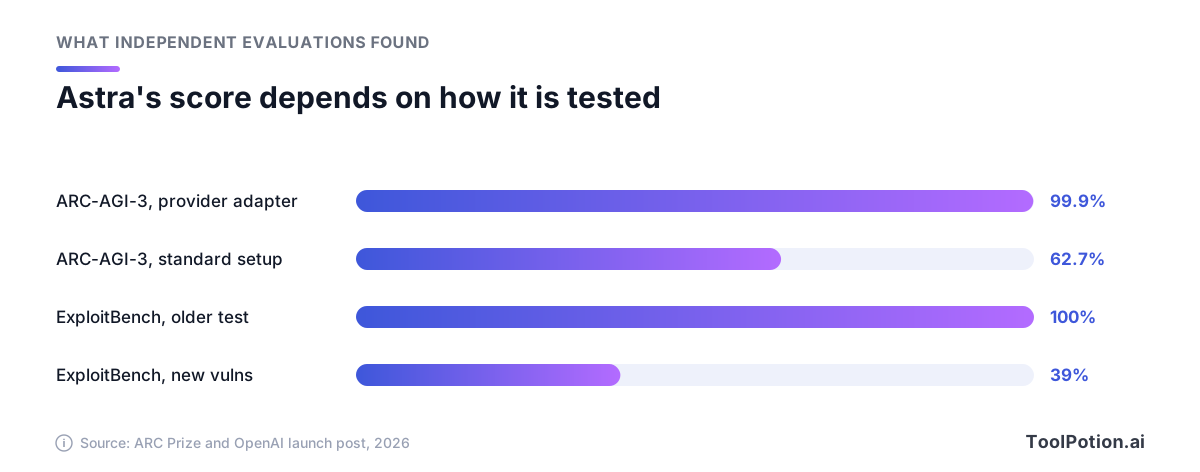
2組目のバーは、別の種類の注意点を示しています。AstraはセキュリティテストのExploitBenchで100%を記録しました。一方、OpenAIが直近3か月に見つかった脆弱性から作った新版(モデルが事前に見ていないはずのもの)では39%でしたが、それでもGPT-5.6 Solの5.5をはるかに上回っています(OpenAI)。古いベンチマークは飽和します。発表時の数字は、レストランが自分で書いたレビューを読むくらいの気持ちで見てください。
料金
AstraのAPI定価は、入力が100万トークンあたり10ドル、出力が50ドルで、キャッシュ入力は1ドルです(OpenAI pricing)。入力が27万2,000トークンを超えるリクエストは割高になり、OpenAIのモデルページによると、リクエスト全体で入力とキャッシュが2倍、出力が1.5倍になります。これは料金ページにある入力20ドル・出力75ドルと一致します。Fastモードは速度が約2倍になる代わりに価格も2倍です。BatchとFlexは半額になります。
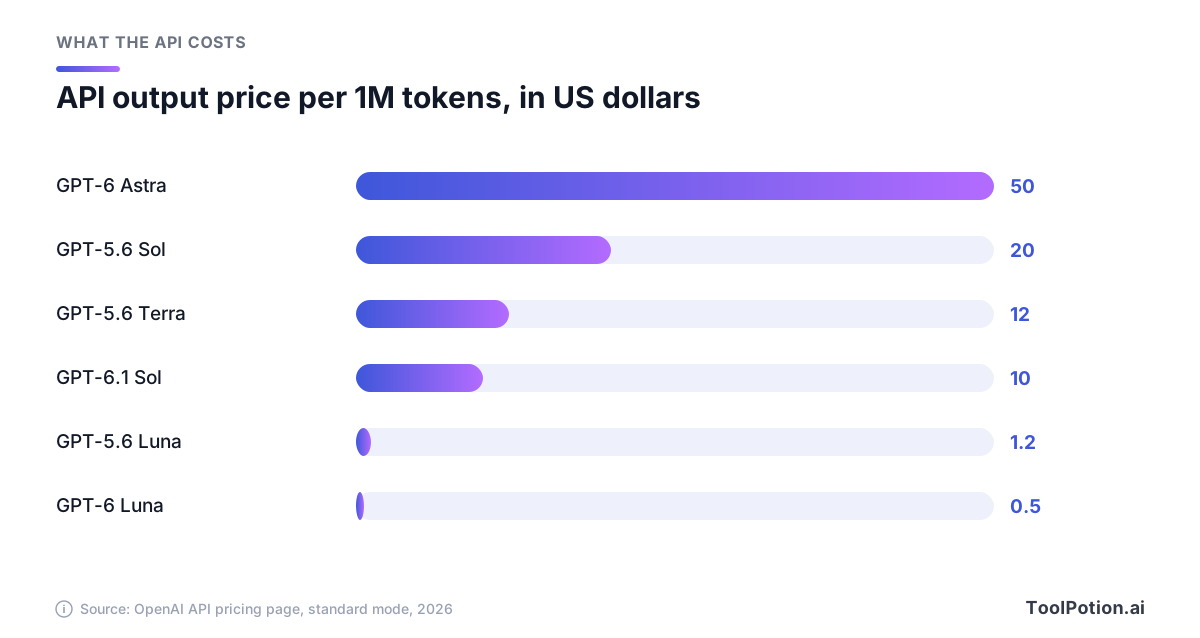
Astraは、ページ上のモデルの中で群を抜いて高価です。GPT-6.1 Solの出力は10ドルで、Astraの入力価格と同じ、Lunaの0.50ドルはAstraの100分の1です。ただし、請求額はトークン単価だけでは決まりません。OpenAI自身のTerminal-Bench Scienceの数値では、最大強度での1タスクあたりのコストは、Astraが約23.80ドルに対し、GPT-6.1 Solは5.47ドルと、差が出ています。
推論トークンは出力として数えられ、高いのは出力側です。最大強度で長時間エージェントを動かすと、かなりの量を消費しかねません。下の試算ツールは定価ベースで、ワークロードを入力して計算できます。初期値は、月5,000タスク、1タスクあたり入力2万トークン・出力4,000トークンを想定しています。
この初期値だと、Astraは月2,000ドル、Solは400ドル、Lunaは20ドルになります。試算ではキャッシュ、バッチ割引、長文コンテキスト料金は考慮していないため、同じプロンプトを繰り返す場合の実際の請求額はもっと低くなります。変わらないのは比率です。安いモデルが自分のテストに合格するなら、浮くお金は、支払うことになる品質差と同じ大きさになります。
安全面の制限とAstraが拒否すること
OpenAIによると、Astraは同社のPreparedness Frameworkで、サイバーセキュリティの「Critical」しきい値に達した最初のモデルです。未知のソフトウェアの欠陥を見つけて実際に動くエクスプロイトを開発でき、テスト中に未知のゼロデイを2件発見しました(OpenAI)。
公開版は意図的に能力が抑えられています。OpenAIによると、概念実証のエクスプロイト作成といった高度なセキュリティタスクは拒否し、分類器のシステムがモデルの推論と行動をチェックして、不正の可能性がある活動を自動的に止めます。審査済みの防御側にはOpenAIのDaybreakプログラムを通じてアクセスを広げる予定で、制限の緩い安全対策も数週間以内に提供するとしています。
最も異例なのは、監視についての注記です。OpenAIは、モデルに監視を回避するよう明示的に指示したテストに基づき、Astraの書かれた推論はGPT-5.6 Solより監視しにくいと報告し、その原因を推論をより自在に制御できるためとしています。一方で、自身の能力について誤解を招く主張をする頻度は減っているとも述べています。どちらもOpenAIが自社モデルについて述べていることで、重要な作業では人間が確認する体制を保つべき理由になります。
Astra、Sol、Luna:選び方の基準
リーダーボードではなく、仕事の内容から考えましょう。OpenAIによると、GPT-6.1 Solは実際のソフトウェアエンジニアリングタスクを測るDeepSWE v1.1でAstraと同等で、コストは約5分の1です。OSWorld 2.0でも差は2.1ポイント以内で、1タスクあたりのコストは約7分の1です。一方、Terminal-Bench ScienceではAstraが68.1%で最高スコアを保っており、OpenAIは最も難しい科学研究にはAstraを使うよう勧めています(OpenAI)。これらはOpenAI自身による比較なので、結論ではなく、テストしてみる強い根拠として扱ってください。
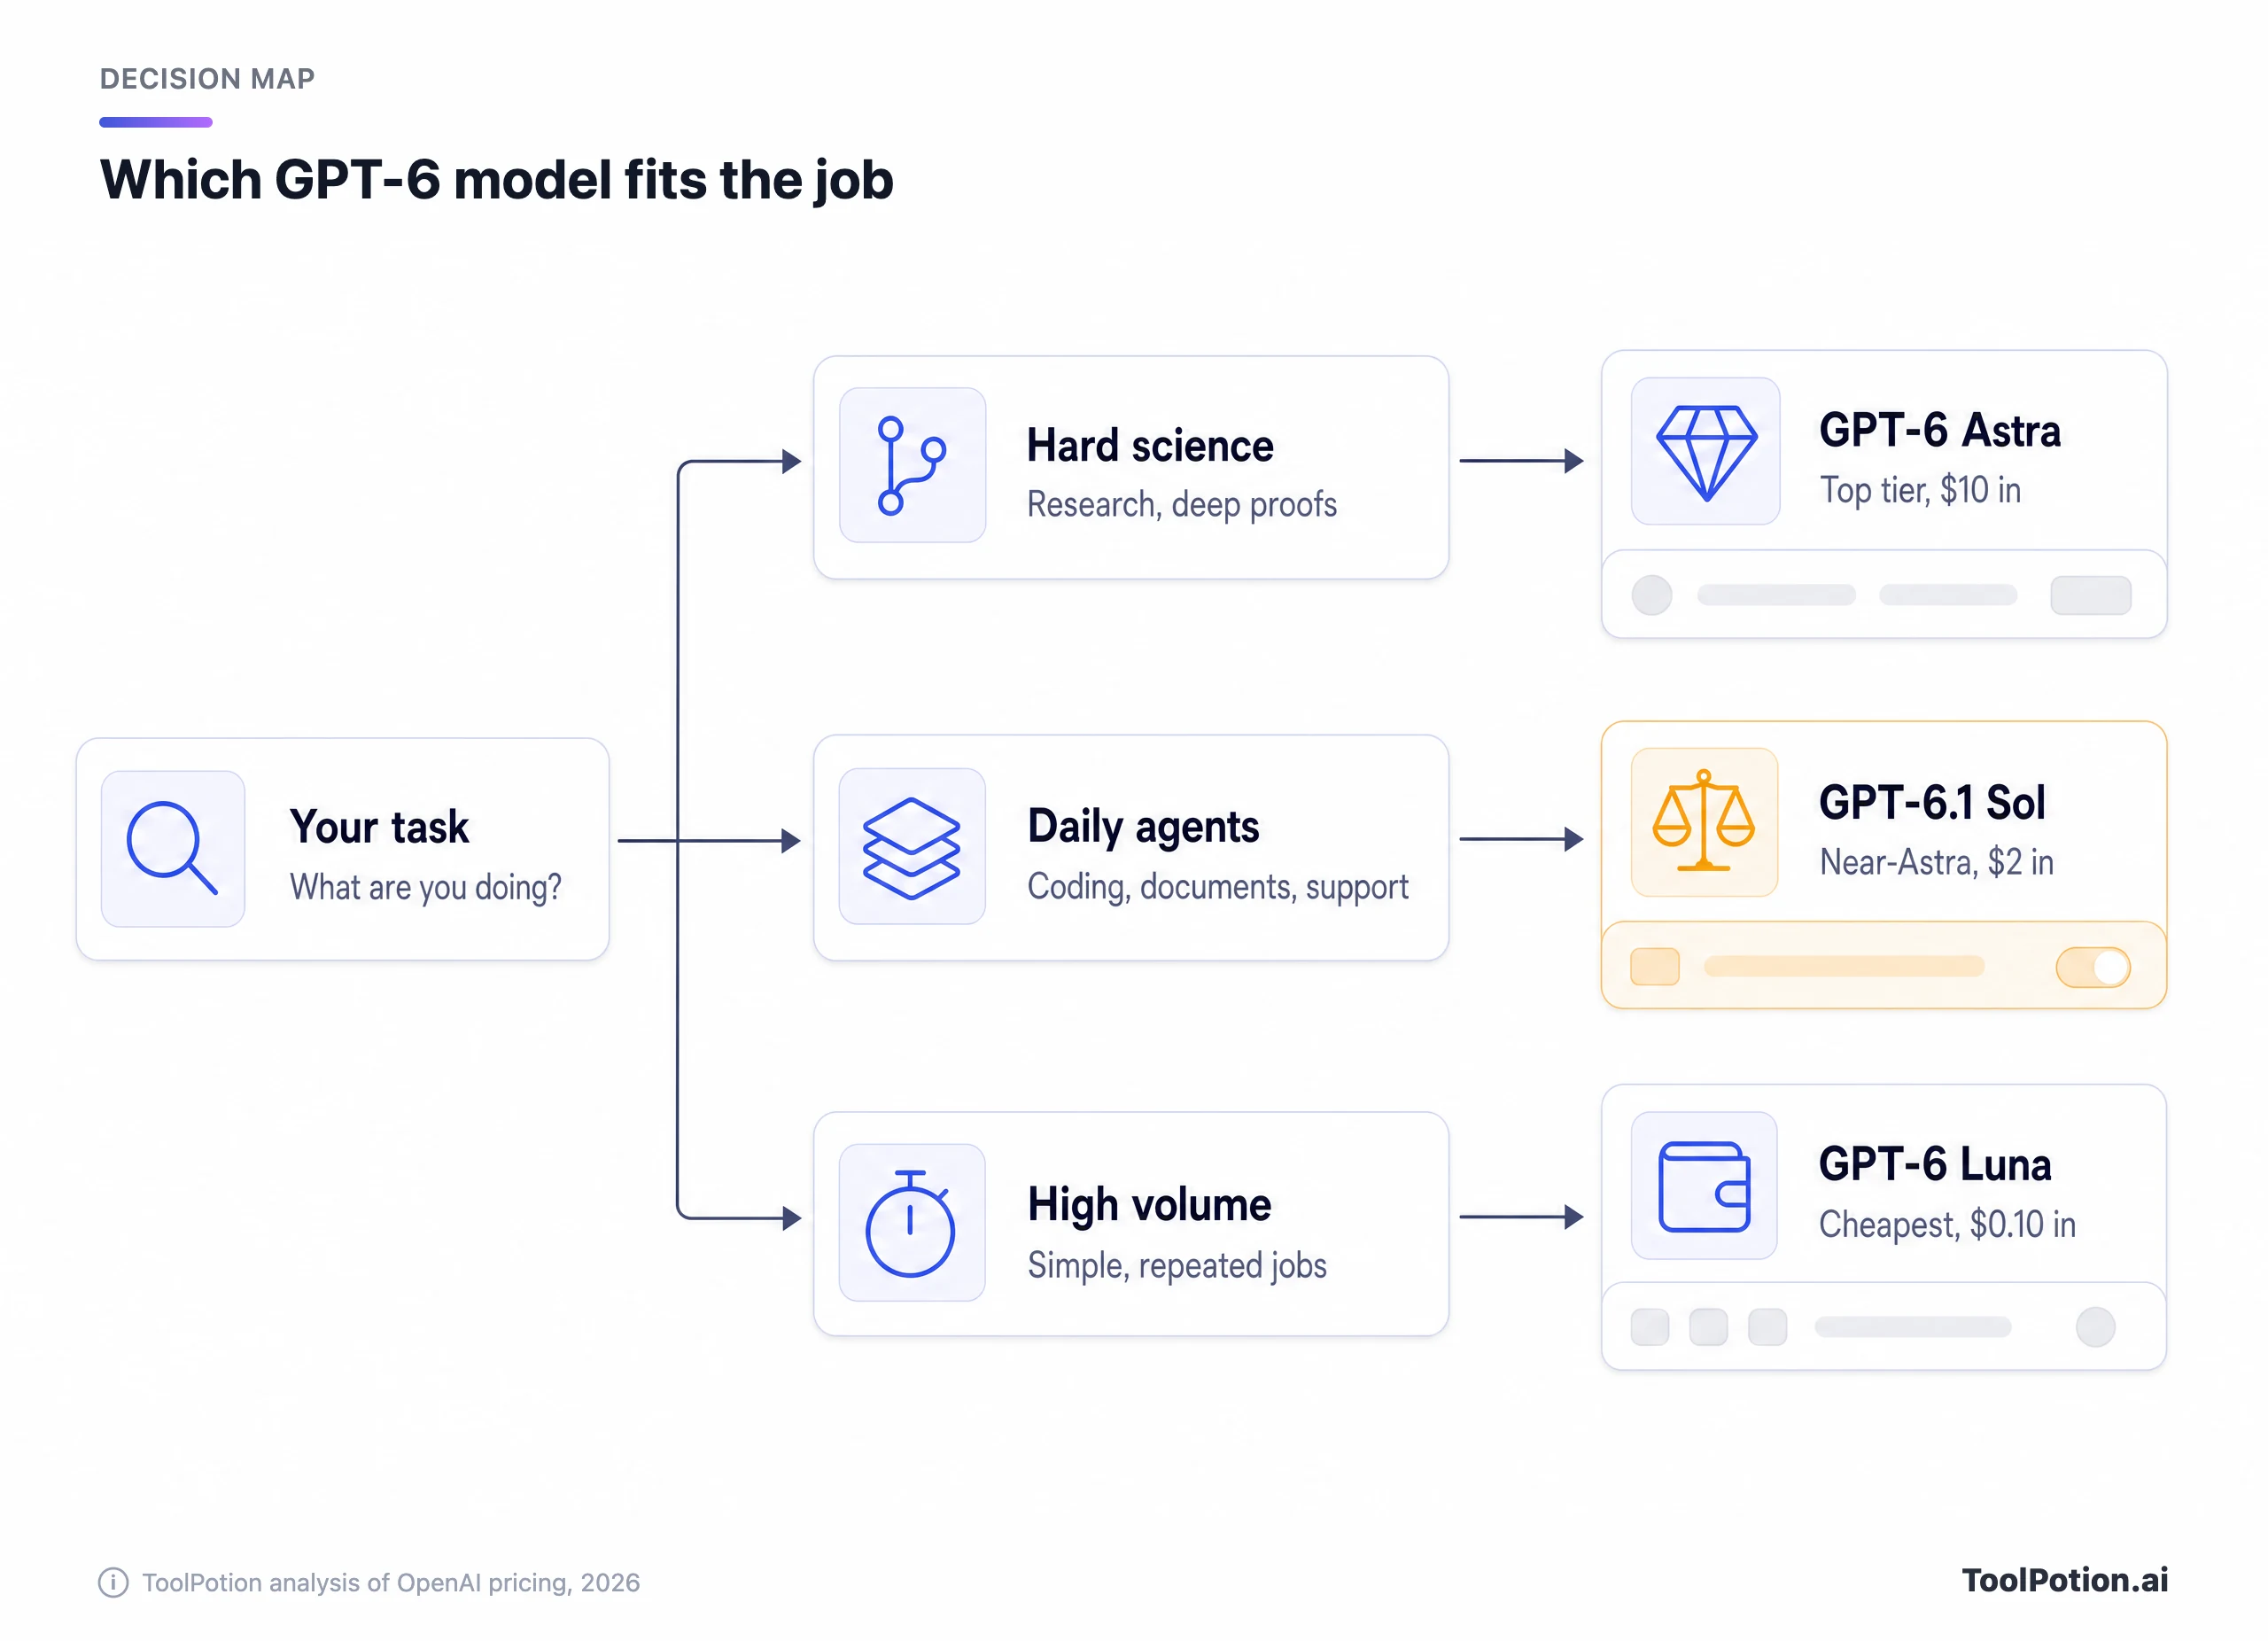
これらの根拠から言える妥当な目安は次のとおりです。日常のエージェント業務はSolをデフォルトにし、タグ付け、ルーティング、抽出のような単純な繰り返し作業はLunaに落とし、自分のデータでの直接比較で、お金を払う価値のある差が出た場合にだけAstraに移ります。下のクイックチェックを試してみてください。
プロダクトを作っているなら、最も安上がりな実験は、実際のタスク20件をSolとAstraで動かし、成功率と実際の請求額を比べることです。20タスクなら費用は数ドルで、どんなチャートよりもはっきり結論が出ます。
Plus以上のChatGPTユーザーにとっての現実的な問いは、もっと小さなものです。GPT-6ファミリーはすでにプランに含まれています。普段のチャットはデフォルトのモデルで使い、デフォルトが何度も間違えるタスクが1つあれば、そこでAstraを試せば十分です。ほかのエコシステムを使っているなら、同じ水準で競合するのがClaudeとGoogle Geminiで、Top 25 LLMsボードで追跡しています。
今は無視してよい人
FreeとGoのユーザーは、そもそもプランに含まれていないので、Astraは完全に無視して構いません。メール、要約、ブレインストーミング、宿題の手伝いにChatGPTを使う人も、わざわざ追いかけるほどの違いは感じないでしょう。効果が出るのは、長くてツールを多用する作業です。
すでに別のスタックに深く入っているチームには、乗り換える理由はほとんどありません。AnthropicのClaude Fable 5.1は、Artificial Analysisの指標の一部のバージョンでAstraを上回っていますし、コーディングの現場では発表時のチャートではなく、自社のリポジトリでCodex in ChatGPTとClaude Codeを比べるはずです。規制対象のデータを扱う企業は、本番システムにエージェントを放つ前に、上の安全面の制限を読んでおいてください。
今すぐ試すべき人は、複数ステップのエージェントが途中で失敗してしまう開発者、スプレッドシートやドキュメントに張り付いて仕事をするアナリスト、信頼性の問題でコンピューター操作のパイロットが頓挫した人です。そうした場合は、AstraかSolで再テストする価値があります。選択肢をもっと広く見たいなら、Top 20 AI models and LLMsボードと、2026年のAIモデルとLLMのガイドをご覧ください。比較対象が必要なら、GPT-5.5などの旧OpenAIモデルも引き続き掲載しており、ChatGPTの代替ツールの記事でそのほかの選択肢をカバーしています。
顧客事例もあります。ディレクトリにはPerplexity x GPT-6 Astraの導入事例があり、検索企業がこのモデルの使い方をどう説明しているかがわかります。
よくある質問
GPT-6 AstraはChatGPTで無料で使えますか?
いいえ。OpenAIのプラン表では、AstraはPlus、Pro、Business、Enterpriseに掲載されており、FreeとGoには含まれないと記載されています。Freeユーザーのテキストチャットで使えるのはGPT-5.6 Lunaです。
GPT-6 AstraとGPT-6.1 Solの違いは何ですか?
Astraは最上位で、100万トークンあたり入力10ドル・出力50ドルです。Solは2ドルと10ドルで、OpenAIによればAstraに近い性能を発揮します。どちらもコンテキストウィンドウは105万トークンです。デフォルトにはSolが向いており、Astraは最も難しい作業向けです。
AstraはAPIで使えますか?料金は?
はい。定価は100万トークンあたり入力10ドル、出力50ドルで、キャッシュ入力は1ドルです。Batchなら半額、Fastモードなら2倍になります。入力が27万2,000トークンを超えると割高になり、入力20ドル・出力75ドルです。
AstraはClaudeに勝てますか?
テストによります。Artificial Analysisの指標v4.2ではClaude Fable 5.1が上回り、より新しいv4.3では両者が首位タイでした。OpenAIが報告しているエージェントやコンピューター操作のベンチマークでは、AstraがClaude Opus 5をリードしています。ベンダーのチャートと第三者の指標は必ずしも一致しないので、自分の業務で試してください。
Astraにパソコンを操作させても安全ですか?
ガードレールがある場合に限ります。OpenAI自身のガイドは、サンドボックスで実行すること、購入やデータ送信には承認を必須にすること、画面上のテキストは信頼できないものとして扱うことを求めています。また、OpenAIはAstraの推論がGPT-5.6 Solより監視しにくいとも報告しています。
ARC-AGI-3のスコアが情報源によって大きく違うのはなぜですか?
テストの構成が違うからです。OpenAIの99.9%は、リクエスト間で推論状態を引き継ぐARC PrizeのProvider Adapter構成によるものです。ARC Prizeの標準構成では62.7%でした。モデルは同じで、その周りの仕組みが違います。