

「リーダーボードで#1」という主張が正しいのは、特定のテストを、特定の方法で、特定の日に実施した結果についてだけです。そのモデルがあなたの仕事に最適かどうかは、ほとんど分かりません。ランキングを理由にツールを乗り換えたり上位プランに課金したりする前に、どのボードの数字なのか、誰が実施したのか、何を測っているのかを確認しましょう。
2026年は、リーダーボードがビジネスになった年なので、この点がいっそう重要です。旧LMArenaの公開ランキングサイトであるArenaは、今年2億ドルを調達し、評価額は31億ドルになりました。2026年前半の17億ドルからほぼ倍増です(Phemex)。Arenaは、年間換算の売上が1億ドルを超えたとしています(Arena)。今ではどのモデルの発表でも順位が前面に出され、その順位が売り上げにつながっています。
だからといって、ボードがどれも偽物というわけではありません。多くは真剣な人たちが作っていて、実際に何かを測っています。問題は、ボードごとに測っているものが違うことと、発表記事がそのモデルに都合のいいボードだけを引用することです。このガイドでは、主要なボードの仕組みと弱点、そして2分ほどで主張を読み解く方法を説明します。
ボードは4種類、問いも4種類
目にするランキングの多くは、4つのグループのどれかに入ります。数字の意味はどのグループのものか分かって初めて決まるので、個別のボードよりもグループの違いのほうが大切です。
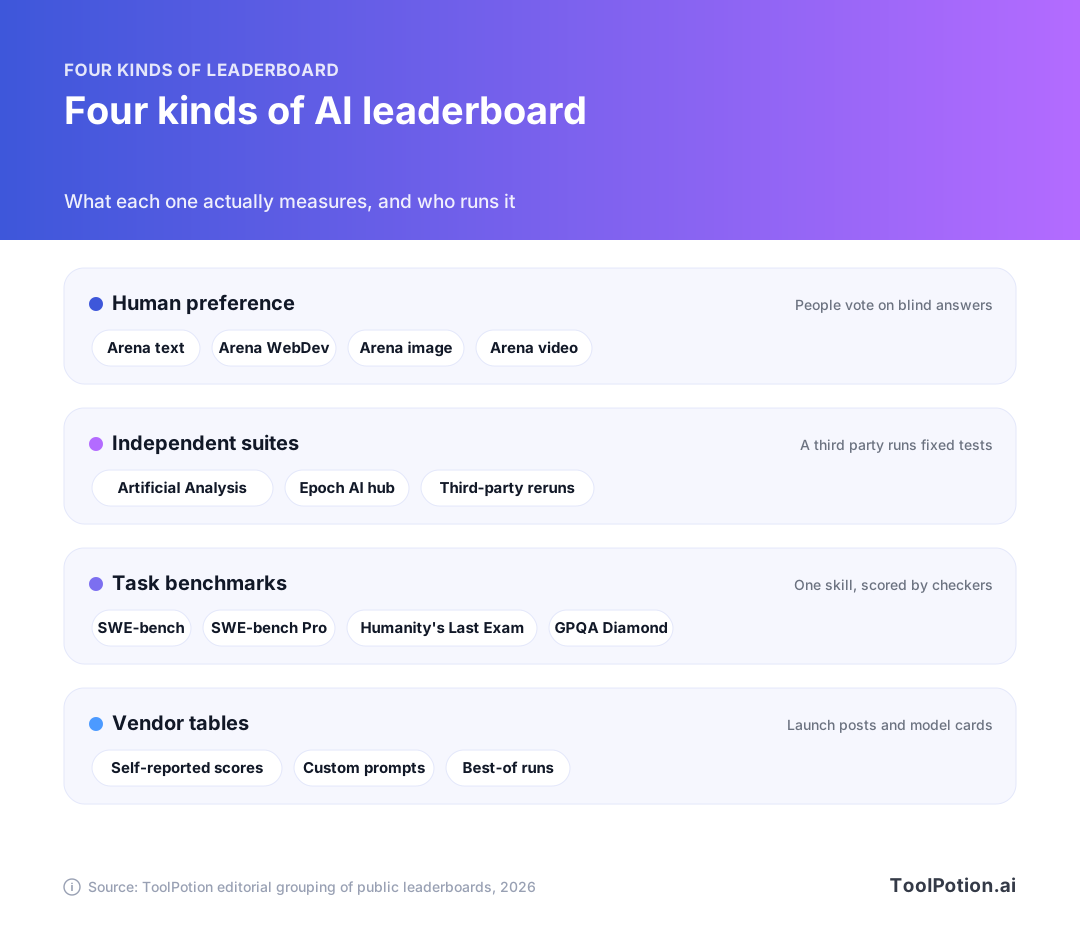
人間の好みを問うアリーナは、どちらの回答が好きかを人に選んでもらいます。独立スイートは、すべてのモデルに同じ条件で決まったテストを実施します。タスクベンチマークは、実際のソフトウェアのバグ修正のような1つのスキルを、自動採点で確かめます。ベンダーの表は、ラボが自社の発表記事やモデルカードに載せるスコアで、設定もたいていラボが選んだものです。
これらのグループは競合するというより、それぞれ別の問いに答えています。好みの投票は、人がどのモデルとの会話を楽しむかを教えてくれます。スイートは、中立の第三者が計測したときの各モデルの比較を教えてくれます。タスクベンチマークは、1つの限られた仕事をこなせるかどうかを教えてくれます。ベンダーの表は、ラボが注目してほしいことを教えてくれます。
| ボードの種類 | 例 | 測っているもの | 主な弱点 |
|---|---|---|---|
| 人間の好み | ArenaのテキストとWebDev | 人がどの回答に投票するか | 文体や長さが有利に働く。操作されうる |
| 独立スイート | Artificial Analysis、Epoch AIハブ | 固定のテストセットでのスコア | 選んだテストの質次第 |
| タスクベンチマーク | SWE-bench、Humanity's Last Exam | 自動採点による1つのスキル | 汚染、欠陥のある課題、飽和 |
| ベンダーの表 | 発表記事、モデルカード | ラボが報告すると決めた内容 | 設定やプロンプトを確認できない |
アリーナの投票はどうやってレーティングになるか
ArenaはUCバークレーの研究プロジェクトだったChatbot Arenaから始まりました。仕組みは単純です。プロンプトを入力すると、匿名の2つのモデルが答え、良いと思うほうを選びます。研究者たちの元論文によると、最初の数か月で24万票以上が集まり、クラウドの投票は専門家の判断とよく一致したそうです(arXiv)。
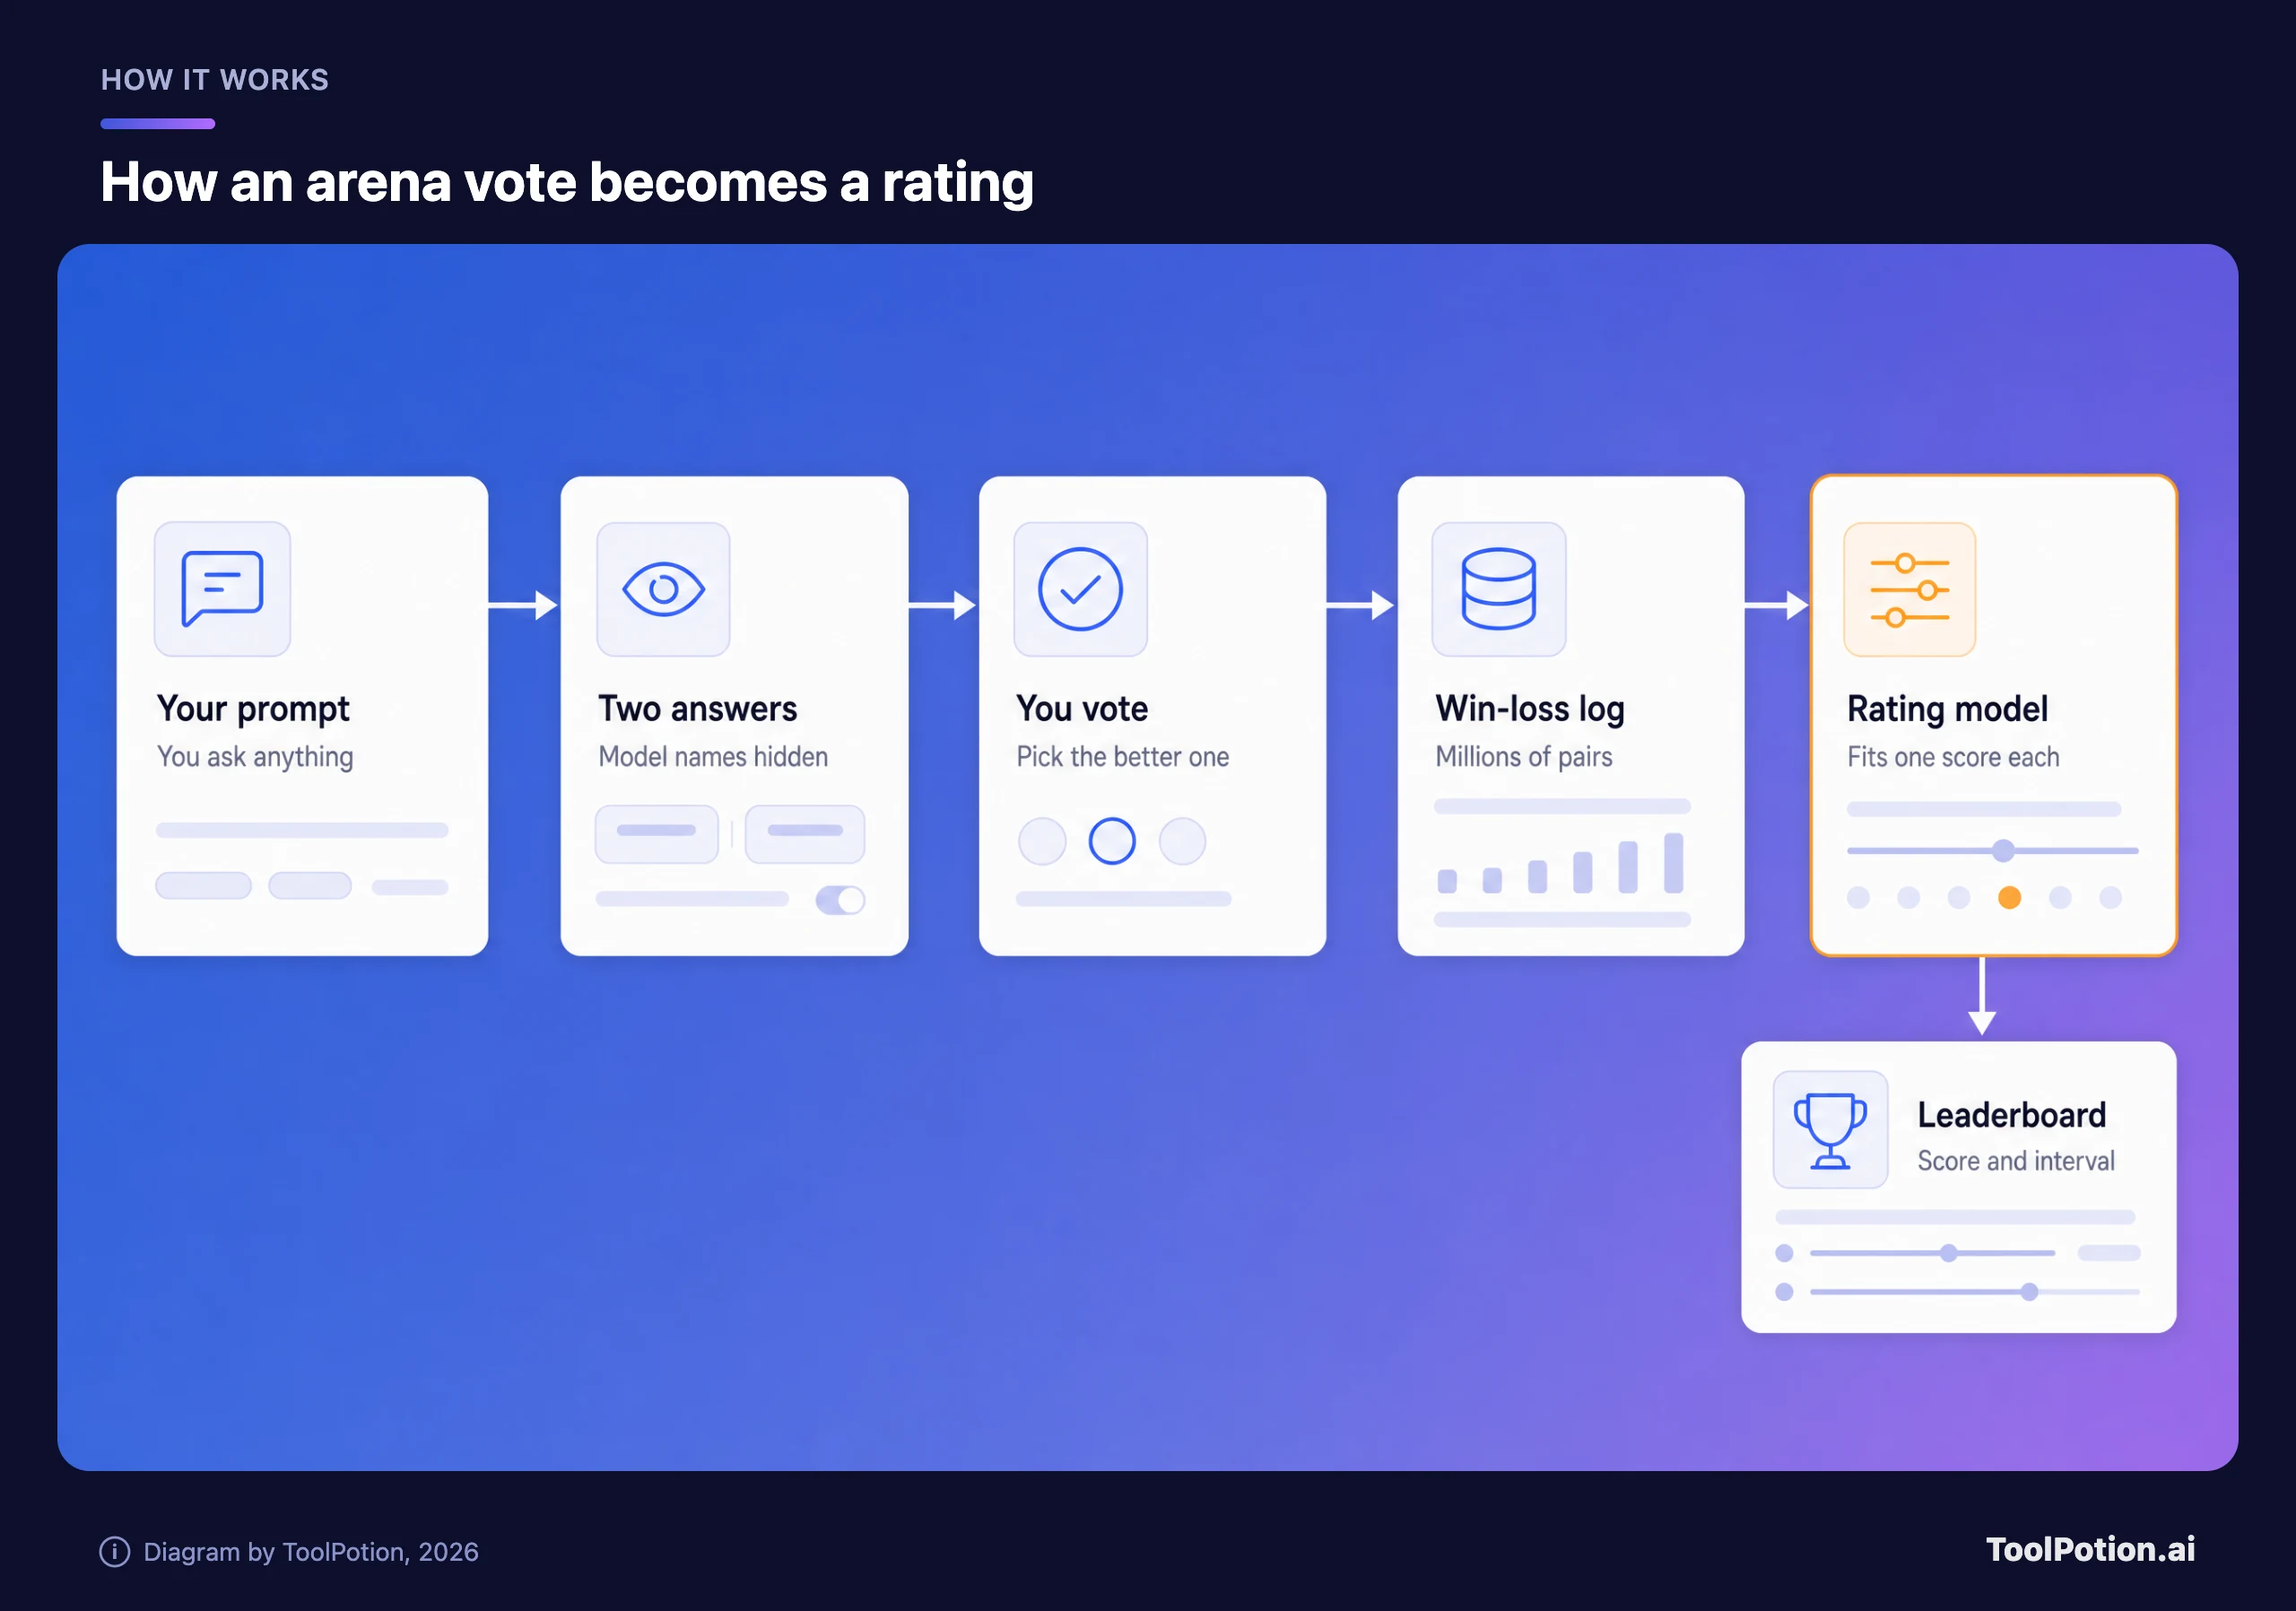
1票は「このプロンプトではモデルAがモデルBに勝った」という小さな記録です。何百万件ものこうした記録を統計モデルにかけて、各モデルに1つのスコアを割り当てます。Arena自身の解説では、この手法はBradley-Terry回帰で、チェスで使われるEloシステムの近い親戚だと説明されています(LMSYS)。強い相手に勝てばスコアは上がり、弱い相手に負ければ下がります。テキストのリーダーボードでは、点推定だけでなく、各スコアの横に区間(「±」の数字)も表示されます。
発表記事が省くのが、この区間です。2つのモデルのスコア差が数ポイントで区間が重なっているなら、正直に読めば引き分けです。2、3ポイントの差に基づく「#1」は、たいてい統計的にはコイントスと変わりません。
Arenaはチャットの枠をはるかに超えて広がっています。現在のリーダーボードには、テキスト、WebDev、ビジョン、検索、画像生成・編集、動画の各ボードがあり、さらに勝率と並べてタスクあたりのコストを示す新しいエージェントボードもあります(Arena)。このコストの列は見る価値があります。順位が1つ上でも価格が数倍なら、おすすめの結論は変わります。
アリーナでは分からないこと
好みの投票には、よく知られた問題が3つあります。1つ目は文体です。人は長くて整った回答を好むので、モデルは文章を増やして見出しを付けるだけで順位を上げられます。Arenaチームの分析では、回答の長さが最大の文体効果であり、長さとマークダウンを補正するとモデルの順位が入れ替わることが分かりました。2024年のその分析では、GPT-4o-miniが6位から11位に下がり、Claude 3.5 Sonnetが6位から4位に上がりました(LMSYS)。Arenaには今では文体を補正したビューがあるので、活用しましょう。
2つ目はアクセスです。2025年の論文「The Leaderboard Illusion」(著者にSayash KapoorやNoah Smithらを含む)は、大手ラボがArenaで構造的な優位を得ていると主張しました。論文によると、MetaはLlama 4のリリース前に27個の非公開バリアントをテストし、最高スコアだけを公表しました。また、GoogleとOpenAIがArena全データのそれぞれ約19.2%と20.4%を受け取った一方、オープンウェイトの83モデルを合わせても約29.7%だったと推定しています(arXiv)。
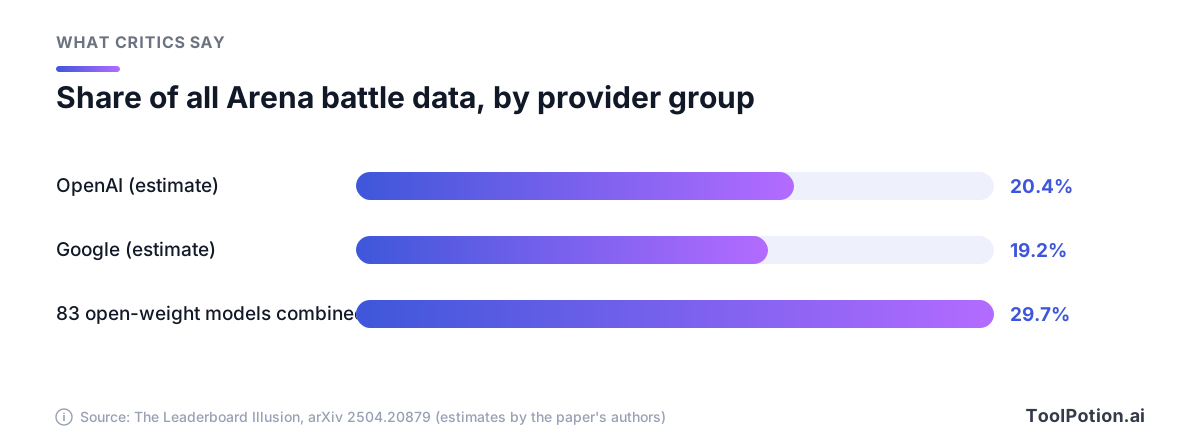
論文はさらに、Arena形式のデータで学習すると、Arenaの分布での性能が最大112%上がりうると報告しています。これは、汎用的な能力ではなくボードに合わせてチューニングする動機になります。これらは著者の推定と主張で、論文執筆時点のスナップショットを反映したものです。それでも、誰もルールを破らなくても好みのボードが操作されうることを示す、外部からの最も明快な説明です。
3つ目は、好みは正しさと同じではないことです。自信ありげで親しみやすい回答は、誤った事実を含んでいても投票で勝てます。チャットの感触や文章については、好みは妥当な指標です。しかし、動かなければならないコードや正確でなければならない数字については、頼りない指標です。
Arenaの現行のポリシーページは、これらの一部に対処しています。公開前のモデルはスコアが安定する(最低1,000票)まで匿名名でテストされ、そのスコアは非公開でプロバイダーに共有され、公開後はあらためて票が集まるまで「preliminary」(暫定)と表示されるとのことです。また、すべての対戦に少なくとも1つは公開モデルが含まれ、対戦の少なくとも20%は公開モデルだけで行われるとも述べています(Arena)。実用上のルールは、「preliminary」の表示は数字がまだ確定していないという意味だ、ということです。
独立スイート:Artificial AnalysisとEpoch AI
好みのボードが「人は何を好むか」を問うなら、独立スイートは「全員に同じテストを受けさせたとき、モデルに何ができるか」を問います。最もよく知られているのがArtificial Analysisです。Intelligence Index(現在はバージョン4.3.2)は、10個の評価を4つのグループにまとめています。エージェント(重み30%)、一般知識と推論(30%)、コーディング(20%)、科学的推論(20%)です。すべてのモデルが同じ条件でpass@1(1問につき1回の試行)で採点され、サイトによれば、データセットは自前のコピーを保持しています。主観的な採点には、異なるラボの最先端モデル3つによるパネルを使います。このインデックスは主に英語とテキストが対象で、多言語とマルチモーダルの能力は別に評価されています(Artificial Analysis)。
重み付けは編集上の判断です。エージェントを減らしてコーディングを増やすなど別の重み付けにすれば、順位が入れ替わるモデルも出てくるでしょう。それは欠陥ではありませんが、「総合」の数字は何が大事かについての1つの意見にすぎないということです。コーディングを重視するなら、見出しの数字ではなくコーディングの結果を読みましょう。
Epoch AIは、GPQA Diamond、FrontierMath、SWE-bench Verifiedなど自前で実施するテストと、外部ソースの結果を組み合わせたベンチマークハブを運営しています。読者にとって最も役立つ発見は、ベンダーの数字に関するものです。Claude 3.5 SonnetはGPQA Diamondで65%と報告されていましたが、Epochが16回の実行で測ると55%(±3)で、ラボが使ったプロンプトや温度を公開していないことが多いとも指摘しています(Epoch AI)。設定の違いだけで10ポイントの差が出るのですから、第三者による再実行を重視する十分な理由になります。このハブは英国AI Security Instituteが資金を提供しており、データは自由に再利用できます。
独立しているからといって、偏りがないわけではありません。テストを選ぶのは第三者ですし、LLMを審査員に使うインデックスは審査員のクセを受け継ぎます。ArenaによるAI審査員の研究では、モデルは自分の回答を好むことが分かりました。12個のモデルが審査した1,460件のText Arena対戦で、審査員は人間より約70%多く自分の回答を選んでいました(Arena)。
ベンチマークは古くなる
タスクベンチマークは逆の問題を抱えています。客観的ではあるものの、あっという間に古くなります。ベンチマークは難しい状態で登場し、ラボが最適化してスコアが上がり、テストが学習データに漏れ、やがて上位モデルがどれも上限近くに並んで、順位が意味を持たなくなります。
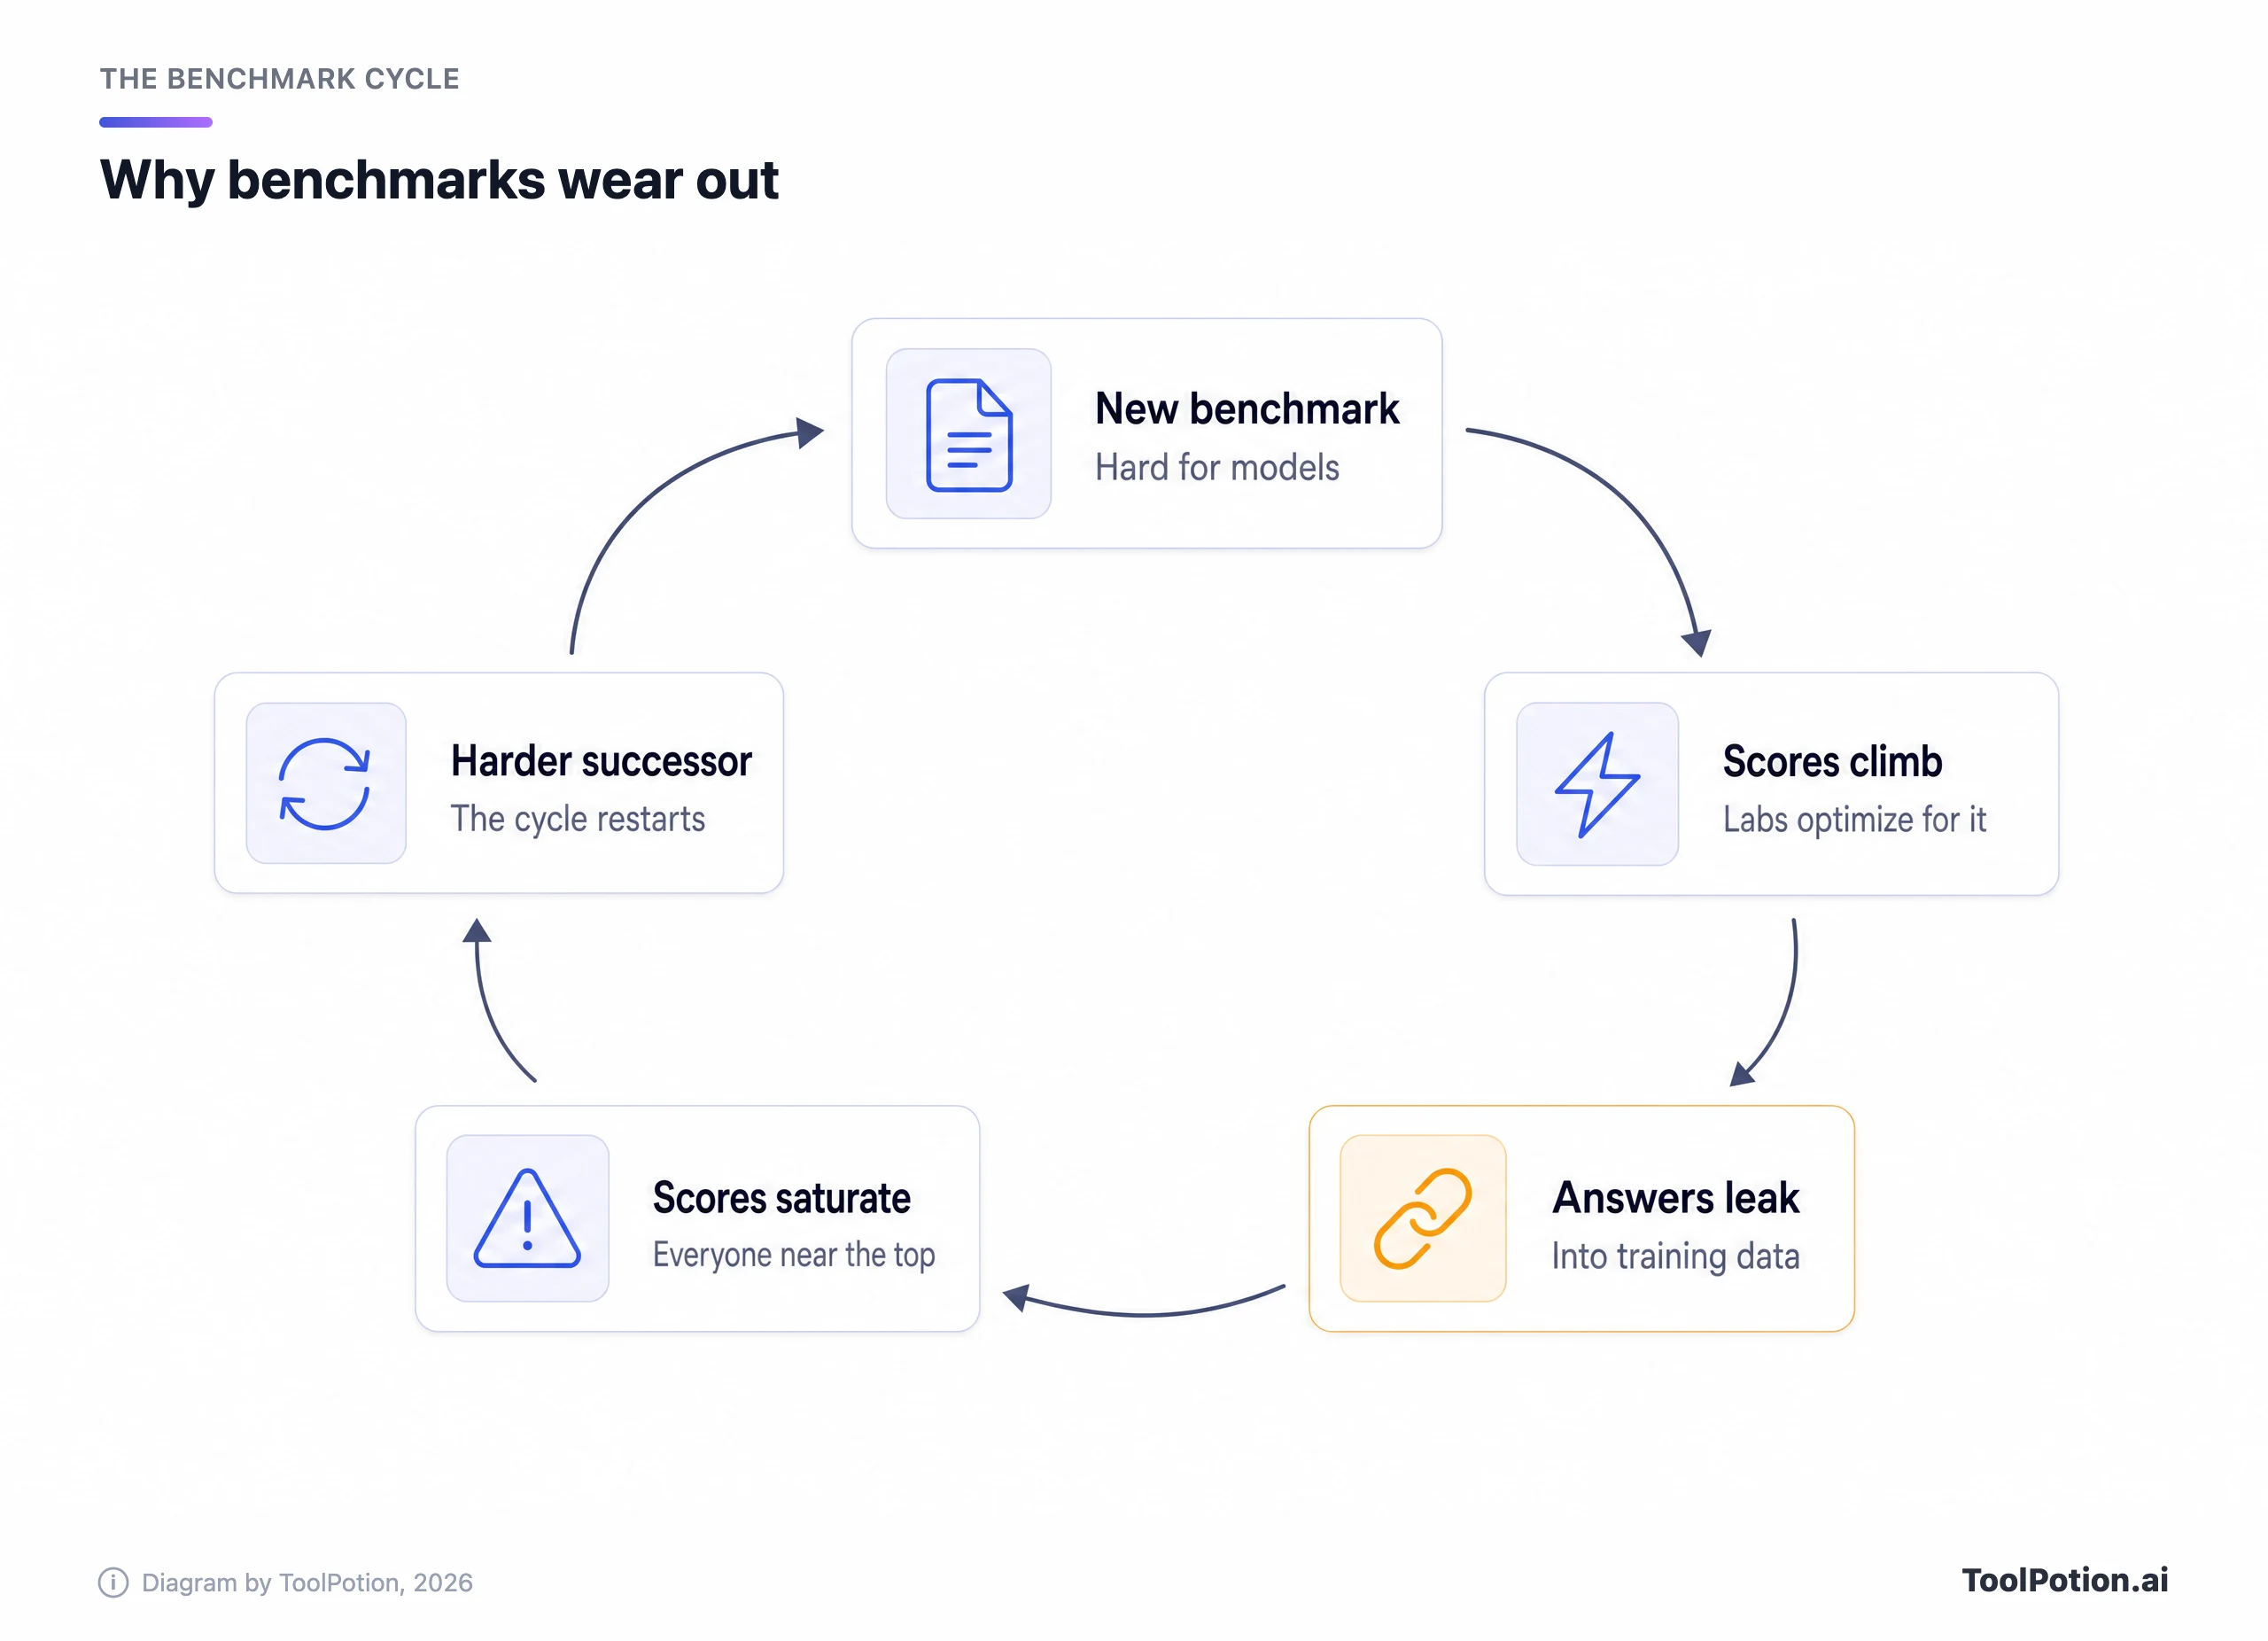
Humanity's Last Examは、この問題への対応の好例です。100以上の分野にわたる2,500問を、500以上の機関の約1,000人の専門家が作成し、過学習を見つけるために非公開のテストセットを保持しています。作られた理由は、MMLUのような古いテストを最先端モデルが90%超まで押し上げてしまったからです(arXiv)。2026年にNatureに掲載されましたが、作成者たち自身もスコアが急速に伸びると予想していました。
SWE-benchは、ライフサイクルの全体像をよく示しています。元のベンチマークは12のPythonプロジェクトにある実際のGitHub issue 2,294件で、当時の最良モデルだったClaude 2が解けたのは1.96%でした(元論文による)。500課題に絞って精査したサブセットのVerifiedは、コーディング関連の発表で標準的な数字になりました。そこに監査が入ります。
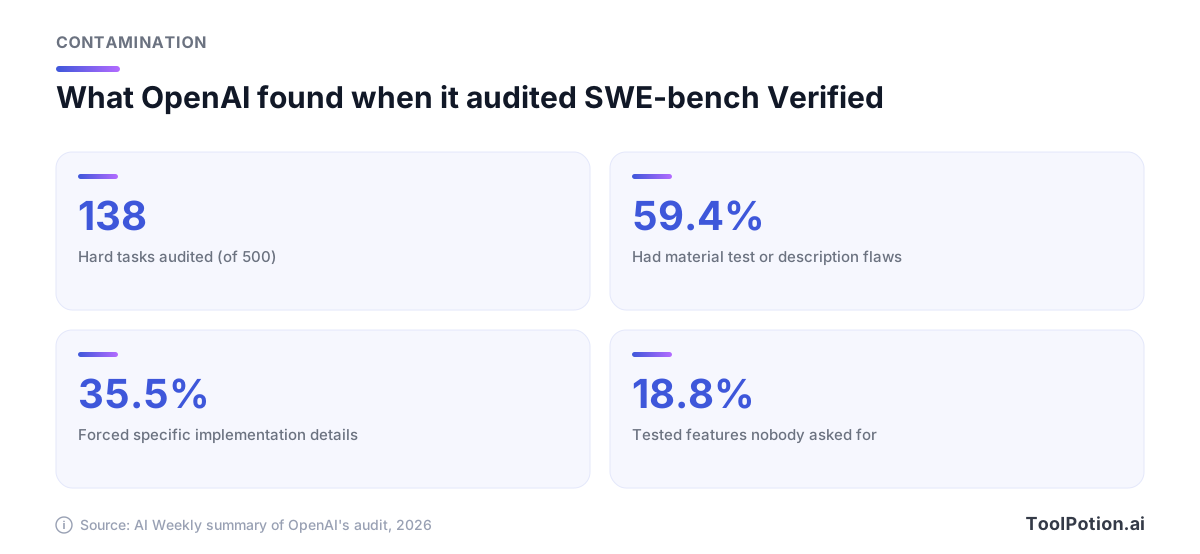
OpenAIは、o3モデルが安定して解けなかったVerifiedの138問を監査し、それぞれを少なくとも6人のエンジニアがレビューしました。その結果、59.4%でテストや説明に重大な問題があることが分かりました。別の汚染テストでは、GPT-5.2、Claude Opus 4.5、Gemini 3 Flash Previewのいずれも元の修正内容の細部を再現でき、課題が学習データに漏れていた兆候とされました。OpenAIはVerifiedのスコア報告をやめ、代わりにSWE-bench Proを推奨しています(OpenAI)。AI Weeklyのまとめによると、上位モデルはVerifiedで約80%、Proではそれより約35ポイント低く、その後の外部監査ではProの採点も疑問視されたとのことです(AI Weekly)。
教訓は、コーディングのベンチマークが役に立たないということではありません。廃止されたり漏れたりしたテストのスコアは古い数字だ、ということです。発表記事でSWE-benchが引用されていたら、どのバリアントか、モデルをどんなエージェントのスキャフォールディングで包んでいたかを確認しましょう。Arenaの「HarnessTax」研究は、21組のモデルとスキャフォールディングの組み合わせを調べ、スキャフォールディングの選択はタスク成功率にほとんど影響しない一方、同程度の結果でもコストが最大5倍変わることを示しました。ただしサンプルは各ベンチマーク30タスクと小規模です(Arena)。
「#1」という主張を見極めるチェックリスト
2分でできる簡易版です。ランキングを信じる前に、特にそれを理由にお金を使う前に、順に確認してください。
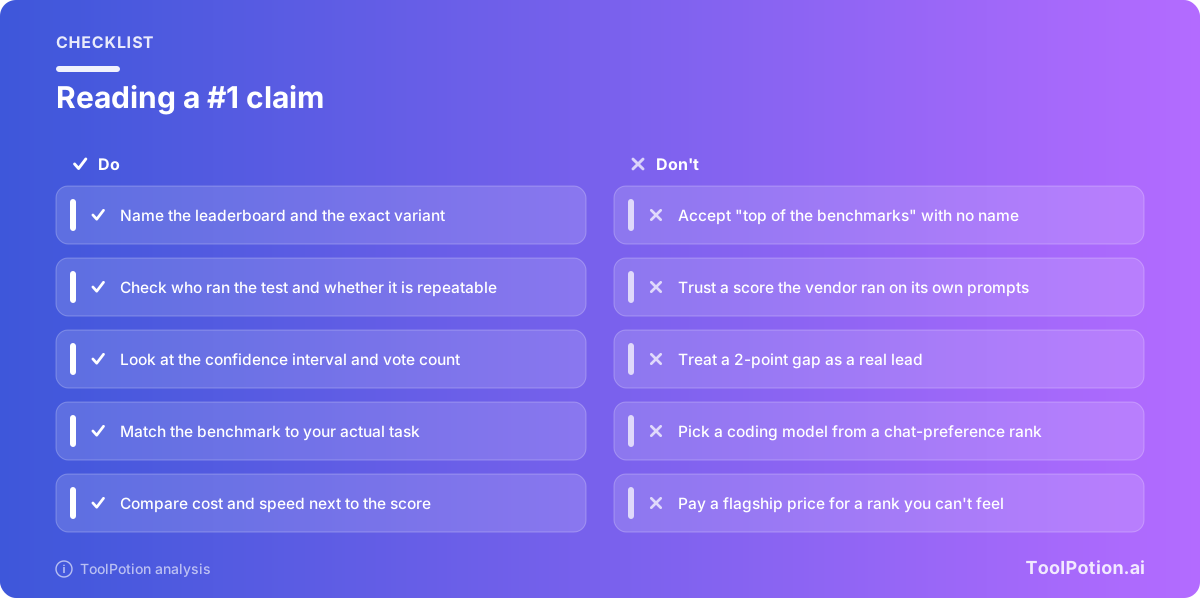
- 正確なボードとバージョンを特定する。「ベンチマークで首位」は確かめようのない主張です。「Arenaのテキストで、文体補正ありで1位」なら確かめられます。
- 誰が実施したかを確認する。ラボが自社のプロンプトで自ら実施した結果は、マーケティング用の数字です。第三者による再実行のほうが重みがあります。
- 区間と投票数を読む。差が区間より小さければ、引き分けです。
- モデルが公開されているか確認する。今日試せないモデルのスコアは、選ぶ助けになりません。
- テストが自分のタスクに合っているかを考える。チャットでの好みは、スプレッドシートやコードベースの扱いを予測してくれません。
- 一致する別の種類のボードを探す。1つのボードは間違っていたり操作されていたりすることがあります。無関係な2つが一致していれば、偽装はずっと難しくなります。
- スコアの隣に価格と速度を並べる。2つ順位が下でも安いモデルのほうが、お買い得なことはよくあります。
下のチェックリストを使えば、自分で主張を採点できます。第三者による実行や、ボード間での一致など、偽装しにくい項目に重みを置いています。
自分の疑問に合うボードを選ぶ
ボードごとに答える問いが違うので、まず自分の疑問から出発し、ボードは後から選ぶのが有効です。文章作成や会話向けのアシスタントを選ぶなら、好みのアリーナは最初の絞り込みとして十分です。生の能力を再現可能な形で比べたいなら、独立スイートを使いましょう。コーディングツールを選ぶなら、実際のリポジトリに基づくタスクベンチマークを見たうえで、自分のコードで試してください。
このツリーは出発点であり、判定ではありません。どのボードにたどり着いても、自分の仕事での短いテストは、公開ランキングのどれよりも頼りになります。毎週こなしている実際のタスクを10件用意し、候補2、3個に通して、出力を並べて比べてください。午後ひとつあればできますし、どんなリーダーボードにも測れない、あなた自身の仕事を測れます。
カテゴリ別に探すなら、ToolPotionのAI Models & LLMsディレクトリとAIモデルボードでモデルを横並びで見られます。フラッグシップにお金を払う価値があるのはどんなときかは、タスクに合わせたAIモデルのティア選びのガイドで解説しています。もっと幅広くまとめた記事なら2026年のAIモデル&LLMトップ15を、特定のアシスタントが出発点なら2026年のChatGPT代替をご覧ください。
数字の信頼性がとくに低い場面
とくに疑ってかかるべき場面がいくつかあります。公開直後の新しいモデルは票が少なく、区間も広いので、Arenaがそのスコアを暫定と表示するのには理由があります。Hugging Faceからダウンロードできるようなオープンウェイトのモデルも盲点です。Leaderboard Illusionの著者らは、こうしたモデルが受け取るArenaデータの割合は小さいと推定しており、スコアがぶれやすい可能性があります。ホスト型のモデルは同じ名前のまま挙動が変わることもあるので、公開週のスコアが数か月後に使っているモデルを表しているとは限りません。
専門的な業務が最大の穴です。法律文書の起草、医療コーディング、マイナー言語、社内のコードベースなどは、公開ボードではほとんどカバーされていません。Real-SWE Benchmarkはその1つの答えで、非公開の企業コードベースで最先端モデルを評価します。公開リポジトリより学習データに漏れている可能性が低いのが利点です。こうしたボードは有用なセカンドオピニオンとして扱い、自分のテストの代わりにはしないでください。
それに、カジュアルに使う人ならこうしたことは不要かもしれません。日常の文章作成や質問なら、OpenAI、Anthropic、Googleの上位数モデルは十分に近く、選ぶ決め手は価格、インターフェース、慣れになるでしょう。ほぼ互角のモデルのどれにするかを決めるのに、ランキングの確認で1時間使うのは割に合いません。
よくある質問
ArenaとLMArenaは同じものですか?
はい。LMArenaはUCバークレーのChatbot Arena研究プロジェクトから生まれ、現在はArena(arena.ai)という名前になっています。古い名前は、記事や古い論文でいまも見かけます。
どのリーダーボードが最も信頼できますか?
あらゆる場合に信頼できるボードはなく、何を知りたいかによって答えは変わります。再現性なら、すべてのモデルを自前で実行する第三者のスイートが最も強力です。人が何を好むかについては、Arenaのデータ量が最大です。最も信頼できる根拠は、無関係な2つのボードが一致していることで、そのうえで自分のタスクで短いテストをすることです。
ベンチマークの汚染とは何ですか?
モデルが学習中にテストの問題や答えを見てしまっていて、高いスコアが能力ではなく記憶を反映している状態のことです。OpenAIによるSWE-bench Verifiedの監査では、最先端モデルが一部の課題で元の修正内容を再現できることが分かりました。Humanity's Last Examが保持しているような非公開のテストセットは、対策の1つです。
ベンダーはリーダーボードで不正をしていますか?
証拠から言えるのは、もっと限定的なことです。ラボは、どのスコアを公表するか、どの設定を使うか、そしてLeaderboard Illusionの論文によれば、どの非公開バリアントを公開するかを選んでいます。これはルールの範囲内での選択的な報告であり、必ずしもルール違反ではありません。だからこそ、独立した再実行が重要なのです。
新しいモデルが#1になるたびに乗り換えるべきですか?
いいえ。順位の差は誤差の範囲内にあることが多く、乗り換えにはプロンプト、ワークフロー、テストの面で実際にコストがかかります。乗り換えるのは、自分のタスクで今のモデルを上回ったとき、または同等の性能で明らかに安いときにしましょう。