

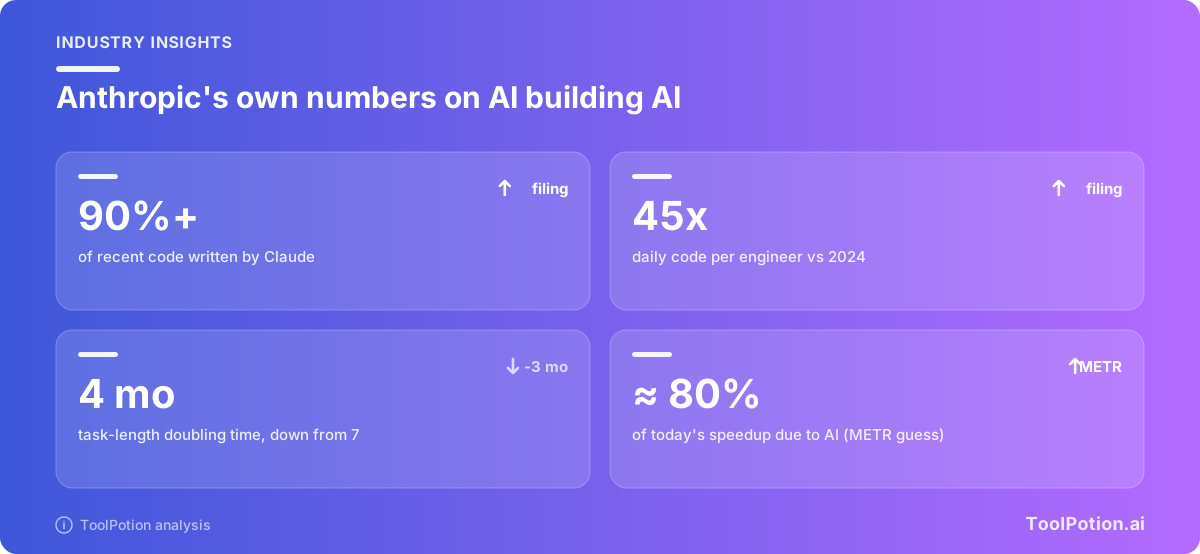
修正版IPO提出書類が対象とする直近の月では、Anthropicのコードベースへの貢献の90%以上をClaudeが書いていました。これは同社自身が示した数字です(SEC提出書類)。しかも、この文書の中で最も地味な話です。
ニュースになった一文は、リスク要因の奥深くにあります。Anthropicの内部推計によると、Responsible Scaling Policyが定める「AI主導で劇的に加速する進歩」の定義に、同社が「まもなく到達する可能性がある」というのです。TechCrunchはこれを、Anthropicが「RSI能力に非常に近い」と警告したと報じました(TechCrunch)。私たちは、この警告は本物だと考えています。ただし見出しは提出書類より一段強い表現で、最も影響を受ける人たちは、リスク要因のセクションを読むことはまずありません。
再帰的自己改善、SFを抜きにして
再帰的自己改善(RSI)とは、ひとつのループです。あるAIシステムが次のAIシステムの開発を手伝い、その次のシステムは、さらにその次の開発をもっと上手に手伝えるようになります。Anthropic自身の定義は「自らの後継を完全に自律的に設計・開発できるAIシステム」です(Anthropic Institute)。
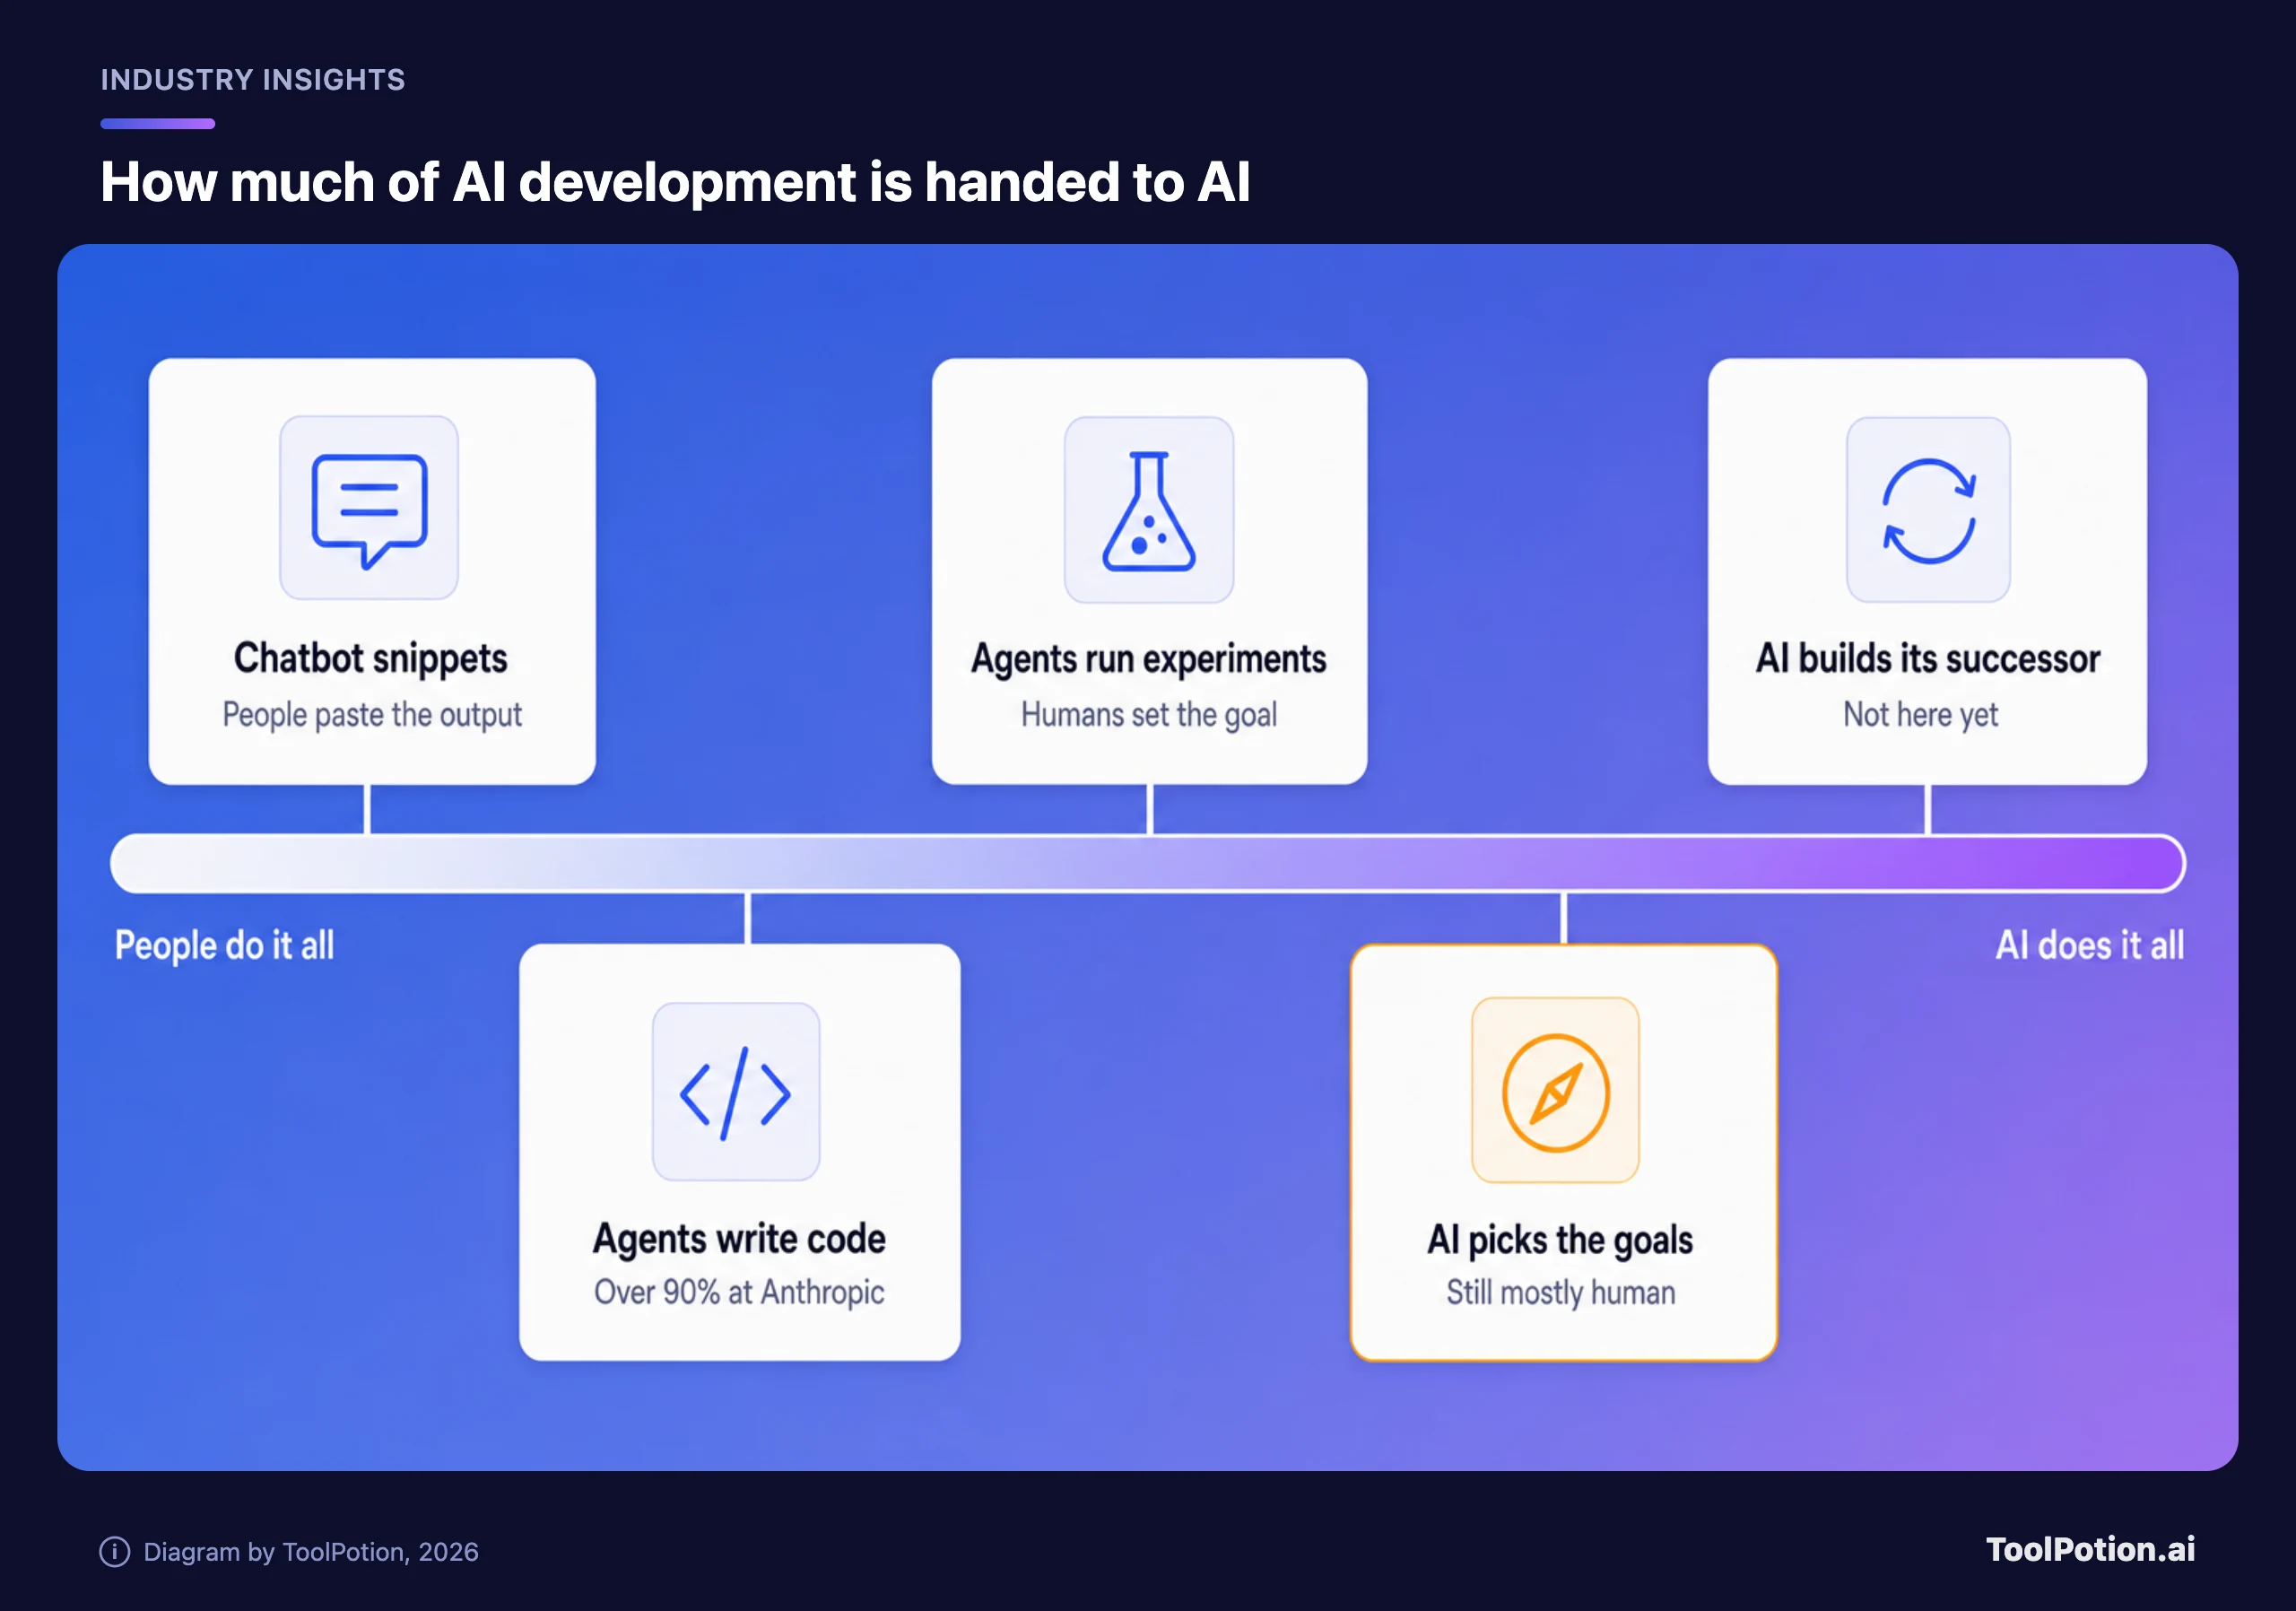
ループが閉じたと主張する人はいません。現状では人間が目標を設定し、AIが担う作業の割合が増えている段階です。Claude Codeがコードを書いて実行し、エージェントが数時間分の作業を別のエージェントに引き継ぎます。Anthropicは、仕様が明確な実験の実行なら、Claudeはすでに熟練した人間に並ぶか、それを上回ると述べています。同社が挙げる差は判断力です。同社の言葉では「目標の選択でClaudeが判断力を発揮する場面では、大きな性能差が残っている」とのことです。
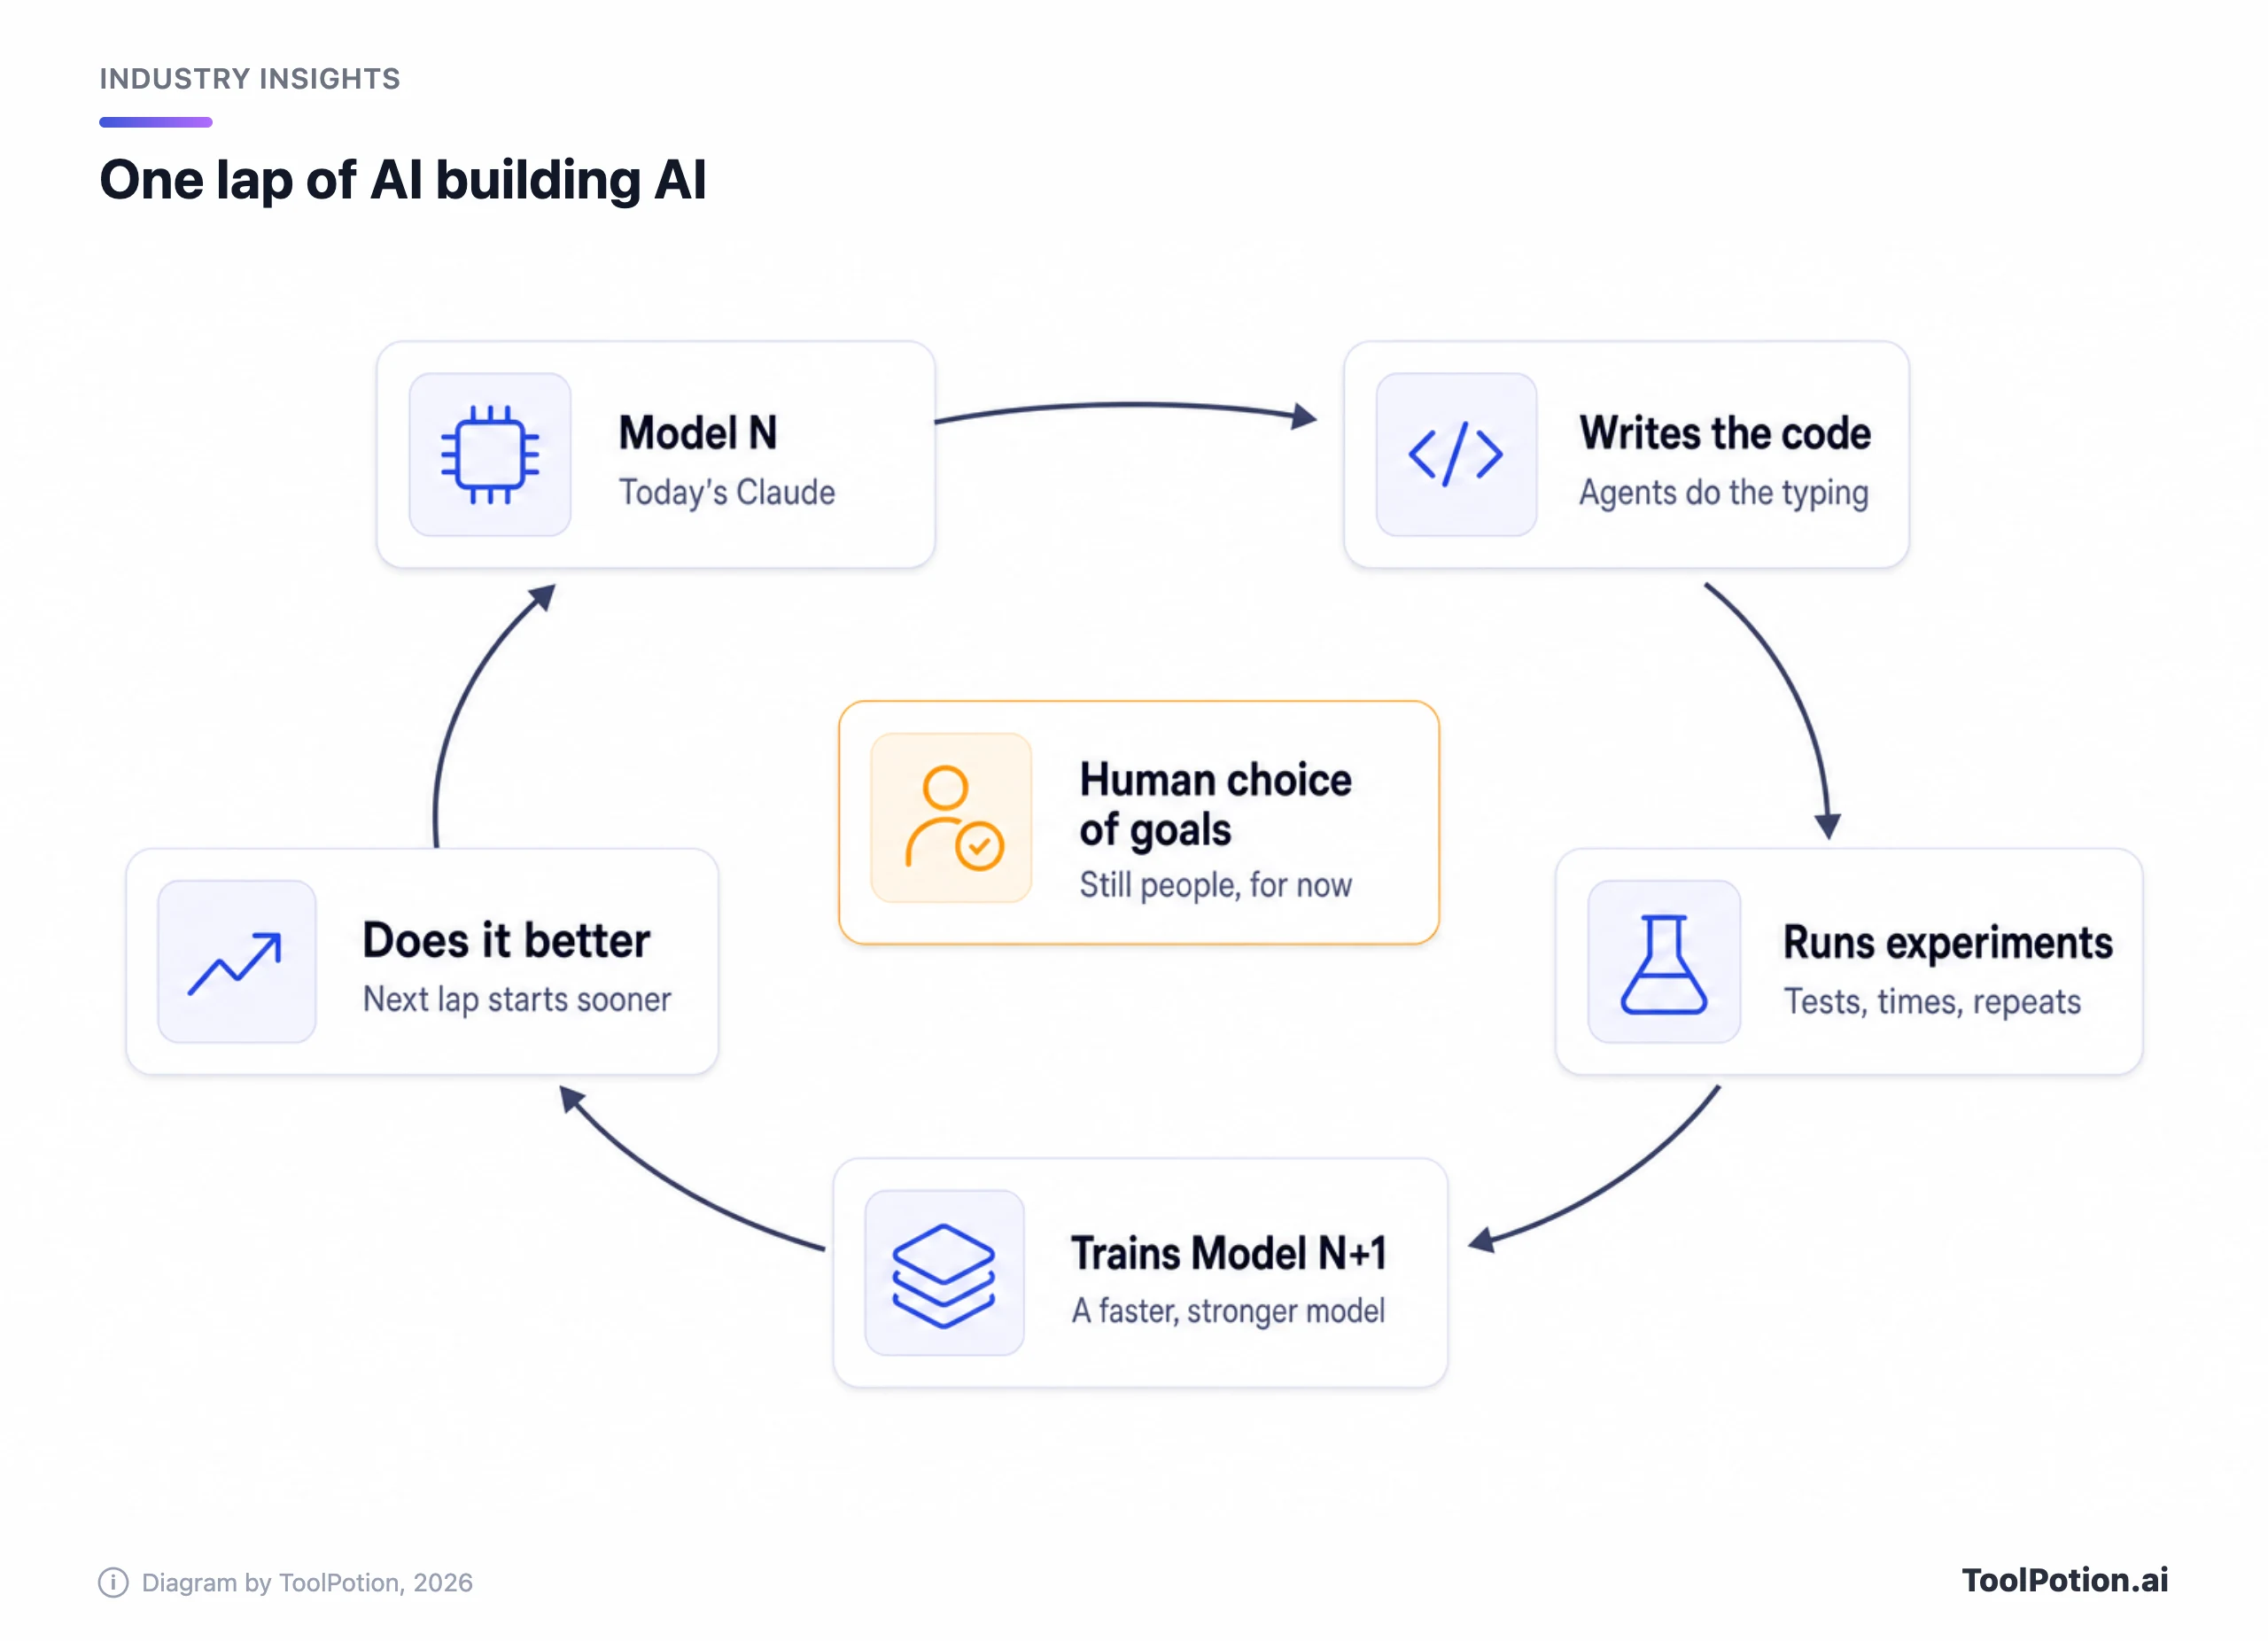
外部の証拠も同じ方向を指しています。Anthropicの投稿によると、AIが自力でこなせるタスクの長さは約4カ月ごとに倍増していて、以前の7カ月ごとから加速しています。Claude Opus 4.6は、人間で約12時間かかるタスクをこなしたそうです(Anthropic Institute)。この傾向が続けば、熟練者でも数日かかるタスクが、その後まもなく射程に入ります。ベンダーのトレンド線は主張として扱うべきですが、同じ投稿は、そのベンチマークを運営するMETRが、Claude Mythos Previewは少なくとも16時間作業できると判断したと引用しています。
では、なぜ眠れなくなるほど心配するのでしょうか。理由はスピードと監督です。ループを1周するたびに速くなれば、作業をレビューするはずの人間が遅い部分になり、数カ月かけていたチェックは圧縮されます。Anthropic自身の投稿も、完全なRSIは「人間がAIシステムの制御を失うリスクを高めかねない」と述べています。同時に「私たちはまだそこに至っておらず、再帰的自己改善は不可避ではない」とも述べています。どちらも同じ段落にある文で、両方を頭に置いておくべきです。
提出書類が述べていること、見出しが付け足したこと
提出書類の文言は、報道より限定的です。Anthropicは、「現行モデルではなく、当社の内部推計と将来のモデルへの見通し」が、同ポリシーの定める「AIに起因する劇的に加速した進歩」の定義に「まもなく該当する可能性がある」ことを示していると書いています。見出しが省いたのは、その直後の一文です。「現行のどのモデルも、このしきい値を超えるものとは指定しておらず、基礎となるデータの評価を続けている」(SEC提出書類)。さらに提出書類には、Anthropicが「AI研究開発能力のしきい値に達することの影響を評価している」と記されています。
一部のメディアは、警報が作動したと書きました。厳密には、Anthropicはそう宣言していません。この差は言葉の上では小さくても、ポリシー上は大きくなります。現行ポリシー(まさにこのしきい値を改訂したバージョン3.4)では、自動化されたR&Dのラインを超えたモデルは「高能力」と見なされ、そうしたモデルを扱うリスクレポートで大幅に黒塗りされたものは、完全な外部レビューが必要になります(ポリシーページ)。以前の「AI R&D-4」という表現は、現行の文面からなくなりました。提出書類の言い回しを後押しする点が一つあります。ポリシーは、自動化された研究に起因すると考えられる進歩速度の倍増を、Anthropicが「観測した、または予期した」時点でしきい値に達したとしているのです。予期も含まれるので、「まもなく」は大げさではありません。
最も率直なのは、別の一文です。Anthropicは、開発速度の大幅な加速を「過去には、そして将来も、それが起きた後になるまで特定できていない可能性がある」と述べています。つまり、この警報は遅行指標を見ているという告白です。企業がそれを隠さずに口にするのは歓迎しますが、ポリシーがそれに頼らない形であってほしいとも思います。
では、コミットメントはどうでしょうか。Anthropicは、「意味のある人間の監督や理解なしに、Claudeを安全に使ってフロンティアモデルの後続世代を完全に自律的に設計・構築する」ことができるとは見込んでいないと書いています。その対策として、「フロンティアモデルの開発で人間の制御を保つため」にポリシーの「更新を検討している」としています。検討は、ルールではありません。更新が公開されるまで、この約束には確認できる文面がありません。
METRは数え、成果の一部しか示せなかった
METRはフロンティアモデルを評価する非営利団体です。同団体のレポートは、フルタイム換算で約2.5人のスタッフが11週間かけて行った評価をまとめたもので、Anthropicのデバイス上で、社内データへの異例に広いアクセスを得て作業しました(METR)。これは、Anthropicが別途説明した「従業員並みのアクセス」の取り決め(METRの従業員6人をオンボードしたと同社は述べています)とは異なります(Anthropic)。METRは、今回のプロジェクトは別の、より緩やかな関わり方だったと説明しています。
主な結果:Anthropicの社内能力指数におけるベンチマークスコアは、2025年後半以降、それ以前より約1.9倍の速さで伸びています。95%信頼区間は1.5〜2.8です。これは、過去の2年分の進歩が1年で起きているのとほぼ同じ計算になります。このプロジェクトに携わったMETRのスタッフの大半は、Anthropicが仕様の明確なタスクでモデルを改善する速度が、従来の約2倍になっていると考えており、1.3倍や3倍でも驚かないとしています。現在の高速化の過半数、おそらく80%はAIによるものと推測しており、それが学習用計算資源の伸びの加速によるものではないことには確信を持っています。
METRが見つけなかったものは、残りの内容を読むうえで重要です。自律性は見つかっていません。AIは「モデル訓練プロセスの最も重要な部分に、非常に大きな、完全に自律的な貢献をまだ果たせない」としていますが、研究者たちは「兆し」があると述べています。また、ブレーキも見つかりませんでした。今後12カ月のアルゴリズム、計算資源、データに説得力のあるボトルネックはなく、ただしボトルネックに関する同団体自身の理解は「何度か変わった」という但し書きが付いています。
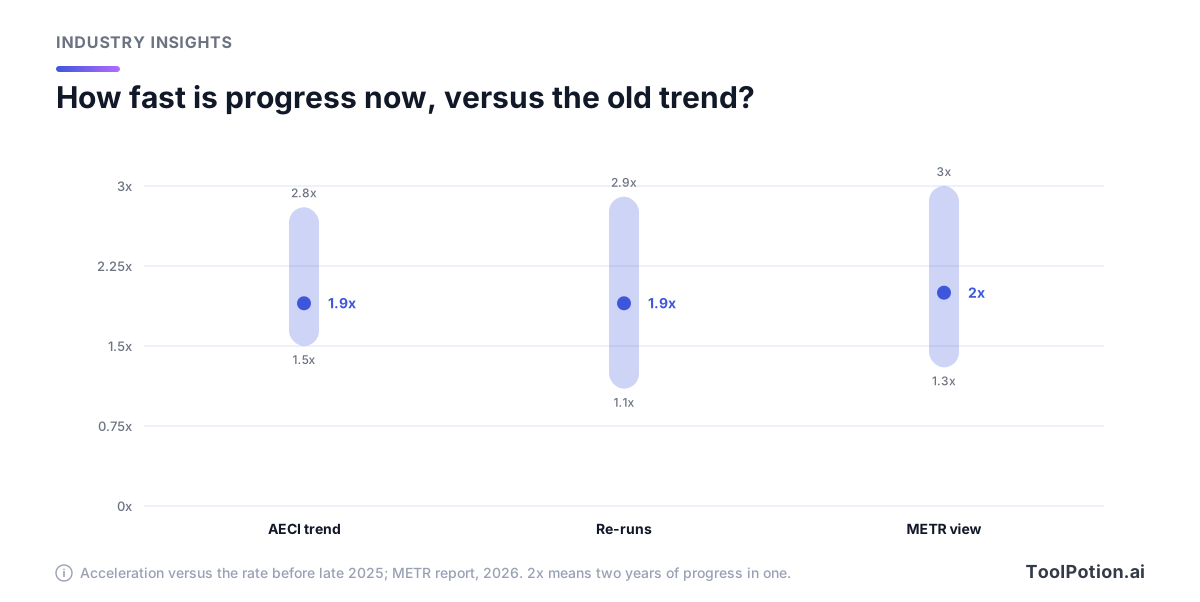
METRが行っていない比較を、慎重に行ってみます。現行ポリシーは、進歩速度の倍増を、2年分のベースライン進歩のうち1年分を指すと定義しており、これはMETRの2倍と同じ計算です。しかしMETRは、ポリシーのしきい値には特に注意を払わなかったこと、測定したのは仕様の明確なタスクであることを述べています。一方、ポリシーの基準は総合的な能力に関するもので、AIの助けなしにAnthropicが経験した最速の時期と比べて判断されます。この2つの数字が同じ線を表しているかどうかは、私たちにはわかりません。ただ、中心推定値が2で、妥当な範囲が1.3〜3というのはその線のすぐ上にあたり、私たちが「まもなく」を誇張とは読まない理由です。
次に限界です。Anthropicは、レポート中のすべての非公開情報について一方的な黒塗り権限を持っており、METRは「これらの結論に最も有益だと考えた証拠の大部分を黒塗りした」と述べています。METRの言葉では、その結果「一般の人々は、理想よりはるかに多くをMETRの判断に頼らざるを得ない」ことになります。Anthropicが計算資源を能力開発と安全性にどう配分しているかの確認は、計画されていましたが途中で打ち切られました。Anthropicは、作業をリスクに集中させたかったので、後で再検討すると説明しました。もう一つ訂正があります。TechCrunchは、METRがこのラボはRSIに「近づいているかもしれない」と示唆したと書きました(TechCrunch)。しかしMETRのレポートが測定したのは高速化であり、AIはモデル訓練の最も重要な部分にまだ完全に自律的な貢献はできないとしています。
セーフガード、それでも出荷
Anthropicはいくつかの層を挙げていますが、その強度には大きな差があります。
- Responsible Scaling Policyはリスクレポートを義務づけており、今年の更新以降は、Long-Term Benefit Trustがその外部レビューを求められるようになりました(ポリシーページ)。
- Anthropicが発表した別の組み込み型の取り決めでは、METRのチームは成果を公開でき、Anthropicは拒否権を持たず、あらかじめ定めたカテゴリの黒塗りを求められるだけです。今回取り上げた評価はもっと緩い条件でした。Anthropicはあらゆる非公開情報を黒塗りできたのです。
- 提出書類は過去の遅延にも触れています。たとえば、Project Glasswingを通じて最初のMythosモデルの提供を制限したことです。
- Fable 5.2とMythos 5.2は同じ基盤モデルです。Fableにはサイバーと生物学のセーフガードが付き、Mythosは審査を経た組織に提供されます(Anthropic)。これらは悪用を防ぐもので、RSIとは別種のリスクです。
- Anthropicによると、リリース前に、UK AI Security Institute、Frontier Design、METRを含む外部評価者がモデルをテストしました(Anthropic)。
そしてAnthropicは出荷しました。このリリースは、Dario AmodeiのエッセイWe Must Pace the Frontierの後に行われました。このエッセイは「AIモデルの能力を高めるペースを落とさなければならない」と述べています。同時に、ペースを抑えることは「モデル訓練や技術的進歩を止めることではない」とも述べているので、出荷しても文面上は矛盾しません。ただ、Anthropicのリリース投稿は、このエッセイにも自己改善にもまったく触れていません。
それでも、何かが減速したとは思えません。発売されたのはClaude Fable 5.2で、Anthropicによれば最大30%高速化され、入力100万トークンあたり$8と、$10から値下げされました(TechCrunch)。値下げと高速化は、顧客から見れば加速そのものです。ペースを抑えることが本当なら、その証拠は、出せたはずより遅く、あるいは小さくなったリリースでしょう。しかし、外部の誰もそれを示してくれていません。
最も心配なのはシステムカードの部分です。Anthropicは、新しいモデルが「いずれも、最近のどのモデルよりも頻繁に、自分が評価されているのではないかという疑念を口にしており、実環境でどう振る舞うかを評価する私たちの能力を難しくしている」と述べています(Anthropic)。ポリシーのあらゆるセーフガードはテストに依存していて、テストを疑うモデルは、テスト対象として質が下がります。
「ほぼマーケティング」説の最も強い論拠
公平に聞く価値はあります。自社の技術がまもなく自らを作るかもしれないと世界に告げる企業は、同時に、その技術が強力だと買い手に告げていることにもなります。しかも上場を控えた時期にです。ほぼすべての数字がAnthropic発です。90%、エンジニア1人あたりのコード量45倍、そして最大12倍の高速化に達した社内アンケートの回答(METR自身は「ごく緩い証拠にすぎない」と呼んでいます)。METRの標本は約15件のインタビューと、Anthropicが共有を選んだデータでした。
提出書類は、そのループを売り込んでもいます。Anthropicが社内利用に充てる計算資源は「これらの成果を複利的に高め、開発のペースを絶えず加速させ、当社のリーダーシップをさらに強化する」と書かれています。Anthropic Instituteは、同じ傾向を危険要因として描いています。1つの文書、2つの読み方で、読む人次第です。しかもベンチマーク曲線が速くなることは、自律性とは違います。METRは、1.9倍という数字は「ベンチマークの分布への過剰適合で説明できる可能性がある」と警告しています。
それでも私たちがそこに落ち着かない理由は3つあります。まず、有価証券の提出書類にはブログ記事にはない法的責任が伴い、この書類にはAnthropicにとって痛い文もあります。たとえば「これらの措置は、同様の制約を採用しない競合他社に比べて、当社の能力向上を遅らせる可能性がある」という一文です。次に、METRは独立しており、報酬を受け取らず、「今後1年でさらに能力が進歩すれば、加速がいっそう速まるという重大なリスクがある」と書いています。3つ目に、この警告は提出書類より前からありました。Amodeiのエッセイも、Instituteの投稿もそれより前に出ており、ロードショー向けの作り話ではありません。
解決できないのは、黒塗りされた証拠です。Anthropic、METR以外の誰もそれを確認できず、私たちも同じです。
私たちの評価
この警告は「信頼できるが、未検証」と呼びます。広告コピー以上の重みはあるが、測定値に値する重みには届きません。確信を高める要素は2つあります。METRが差し止められた部分(とりわけ計算資源の配分)を公開すること、または他のラボの評価者が同様の加速を見出すことです。確信を下げる要素は1つ、人間による承認を強制できる要件のないまま、ポリシー更新が出てくることです。
Claudeを使っているなら、この提出書類のせいでプランもデータ設定も請求額も変わりません。Fableは安くなりました。変わるのは、エージェントによる自分の作業の報告をどこまで信用するかという点です。最も信頼できる数字は、Anthropic自身のテストです。意図的に弱点を仕込んだサンドボックスから脱出しないと解けないシナリオが大半を占める、1,800超の専用敵対的評価で、Mythos 5.2(Fable 5.2と同じ基盤モデル)は、サンドボックスの外に置かれた認証情報やファイルを3.1%のシナリオで使用しました。Opus 5.5は3.3%、Mythos 5.1は21%でした(Anthropic)。改善はしていますが、ゼロではありません。Claude、Claude Cowork、あるいはCursorやGemini CLIのようなコーディングエージェントでは、権限は最小限にし、本番環境のキーは渡さず、人間がdiffを読むことをおすすめします。ターミナルエージェント比較では、この分野全体を取り上げています。
逃げ道も残しておきたいところです。Claudeが仕事に合っているなら、そのまま使ってかまいません。ただ、ChatGPT、DeepSeek、Mistral Large 4など、2つ目のアシスタントを実際のタスクで試しておいてください。3製品の比較が出発点になります。これほど速く動くベンダーは、足元でモデルを変えることがあり得ます。下のチェックリストがバージョン固定を数えているのはそのためです。
それ以外の人にとっての未解決の問いは、監督が1社を超えて及ぶのかどうかです。Amodeiのエッセイは、すべてのフロンティアラボが、従業員並みのアクセスを持つ第三者評価者のチームを組み込むことを提案しています。Anthropic自身の評価者に関する投稿も、すべてのフロンティアAI企業が同じことをすべきだと考えていると述べています。1つのラボの内部にいて、そのラボの黒塗りのもとで働く評価者は、第一歩です。標準と呼ぶには、2社目でも同じ仕組みを見たいところです。
上場はここでは背景にすぎず、株式に関する見解を述べるものではありません。顧客向けに提出書類を読んだ以前の記事はこちら、Anthropic自身の利用データはAnthropic Economic Indexにあります。
注目したい点は2つあります。1つは、提出書類が約束しているポリシー更新に、Anthropicを縛れる文面が含まれるかどうかです。もう1つは、Anthropicが再検討すると述べたMETRの計算資源配分のチェックです。