

Anthropicが今週、オープンソースプロジェクト向けの無料・オプトイン方式のAIセキュリティスキャナーを公開しました。タイミングは、なかなか込み入った時期です。AIは、人間が何年も監査してきたコードから本物のバグを見つけられるようになりました。一方で、ボランティアのメンテナーを偽のバグ報告で埋もれさせることもできます。どちらも事実であり、小さなチームはその両方を踏まえて対応を決めなければなりません。
新サービスの名前は OSS Scanner。参加登録したプロジェクトに対し、Anthropicの最上位モデルで定期的に脆弱性スキャンを実行します。各レポートには再現コード(reproducer)と説明が付き、可能な場合は修正パッチの候補も付いてきます(Anthropic)。Google、OpenAI、GitHub、Snyk、Semgrepによる似た取り組みが並ぶ一方で、低品質なAIレポートが増え続け、窓口を閉ざしたメンテナーも出ています。
この記事では状況を整理します。これらのツールは何をするのか、どれが無料か、自分を傷つけずに参加するにはどうするか、そして2人チームでも回せるワークフローを紹介します。結論を先に言うと、AIスキャナーはもう真剣に検討できる水準にあります。ただし、出力を読まずにマージしてはいけません。
AnthropicのOSS Scannerでできること
コアメンテナーは、テンプレートに沿ってGitHubリポジトリにプルリクエストを出して参加登録します。Anthropicは案件ごとに判断し、基準はGoogleのOSS-Fuzzに近いものです。プロジェクトに「インフラとユーザーセキュリティへの重大な影響」があることが条件です(Anthropic)。つまり、趣味のリポジトリ向けではありません。curlやwolfSSLのように、インターネットの半分がリンクしているようなライブラリが対象です。
利用は無料です。費用は、AnthropicがDefender Advantage Fundと呼ぶ資金から出ており(SiliconANGLE)、参加プロジェクトの負担はゼロのままだと同社は述べています。
いちばん重要なのは、何が欠けているかです。レポートは「人によるレビューやトリアージを経ない、完全にモデル生成のもの」で、中には誤りもあるとAnthropic自身がはっきり認めています(Anthropic)。例として挙げているのが、深刻度の評価ミスです。レポートを仕分ける人手がないプロジェクトは、人間が先に検証する従来の開示プロセスを引き続き使えます(SiliconANGLE)。
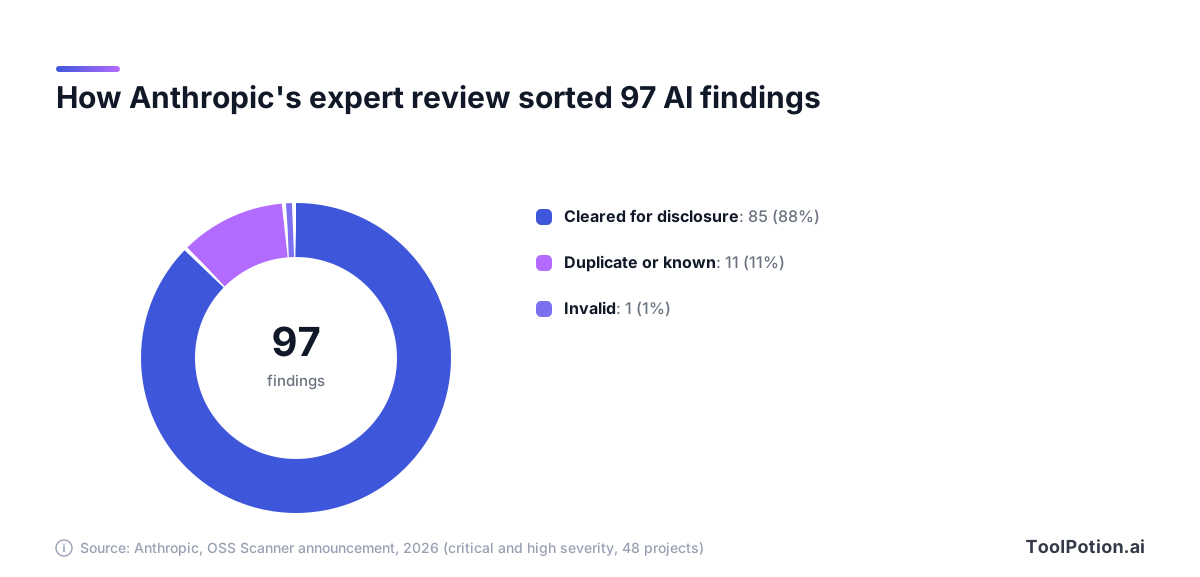
Anthropicが、このトレードオフに価値があると考える理由は、同社自身の数字に表れています。専門のペネトレーションテスターが、48プロジェクトの重大・高深刻度の指摘97件をレビューしました。そのうち85件は協調的開示の基準を満たし、11件は重複、または本物だが既知のもので、無効だったのは1件だけでした(Anthropic)。これとは別に、wolfSSLは初期トライアルの74件のレポートのうち72件が有効で、5件のCVEにつながったと報告しています(SiliconANGLE)。
curlを運営するDaniel Stenbergは、このスキャナーが「ここ数年で報告されたcurlの脆弱性の中でも最悪クラスのもの」を見つけたと述べています(Anthropic)。ただし、これらの数字はすべてAnthropicかそのパートナーが出したものだという点には注意してください。Anthropicは真陽性率が90%を超えると見込んでいるとも述べていますが(Anthropic)、これは予測であって、あなたのリポジトリでの保証ではありません。
AIスキャナーの仕事:見つけて、証明して、パッチを書く
従来型の静的解析は、コードをルールと照合します。高速で挙動も予測しやすい反面、警告が洪水のように出ます。新しいエージェント型スキャナーは、駆け出しのセキュリティ研究者に近い動きをします。コードを読み、どこが壊れるかの仮説を立て、実際に壊せるか試し、そのうえで報告を書きます。
見るべきは、その真ん中のステップです。動くエクスプロイト付きの指摘と、自信満々の文章が一段落付いただけの指摘は、まったく別物です。
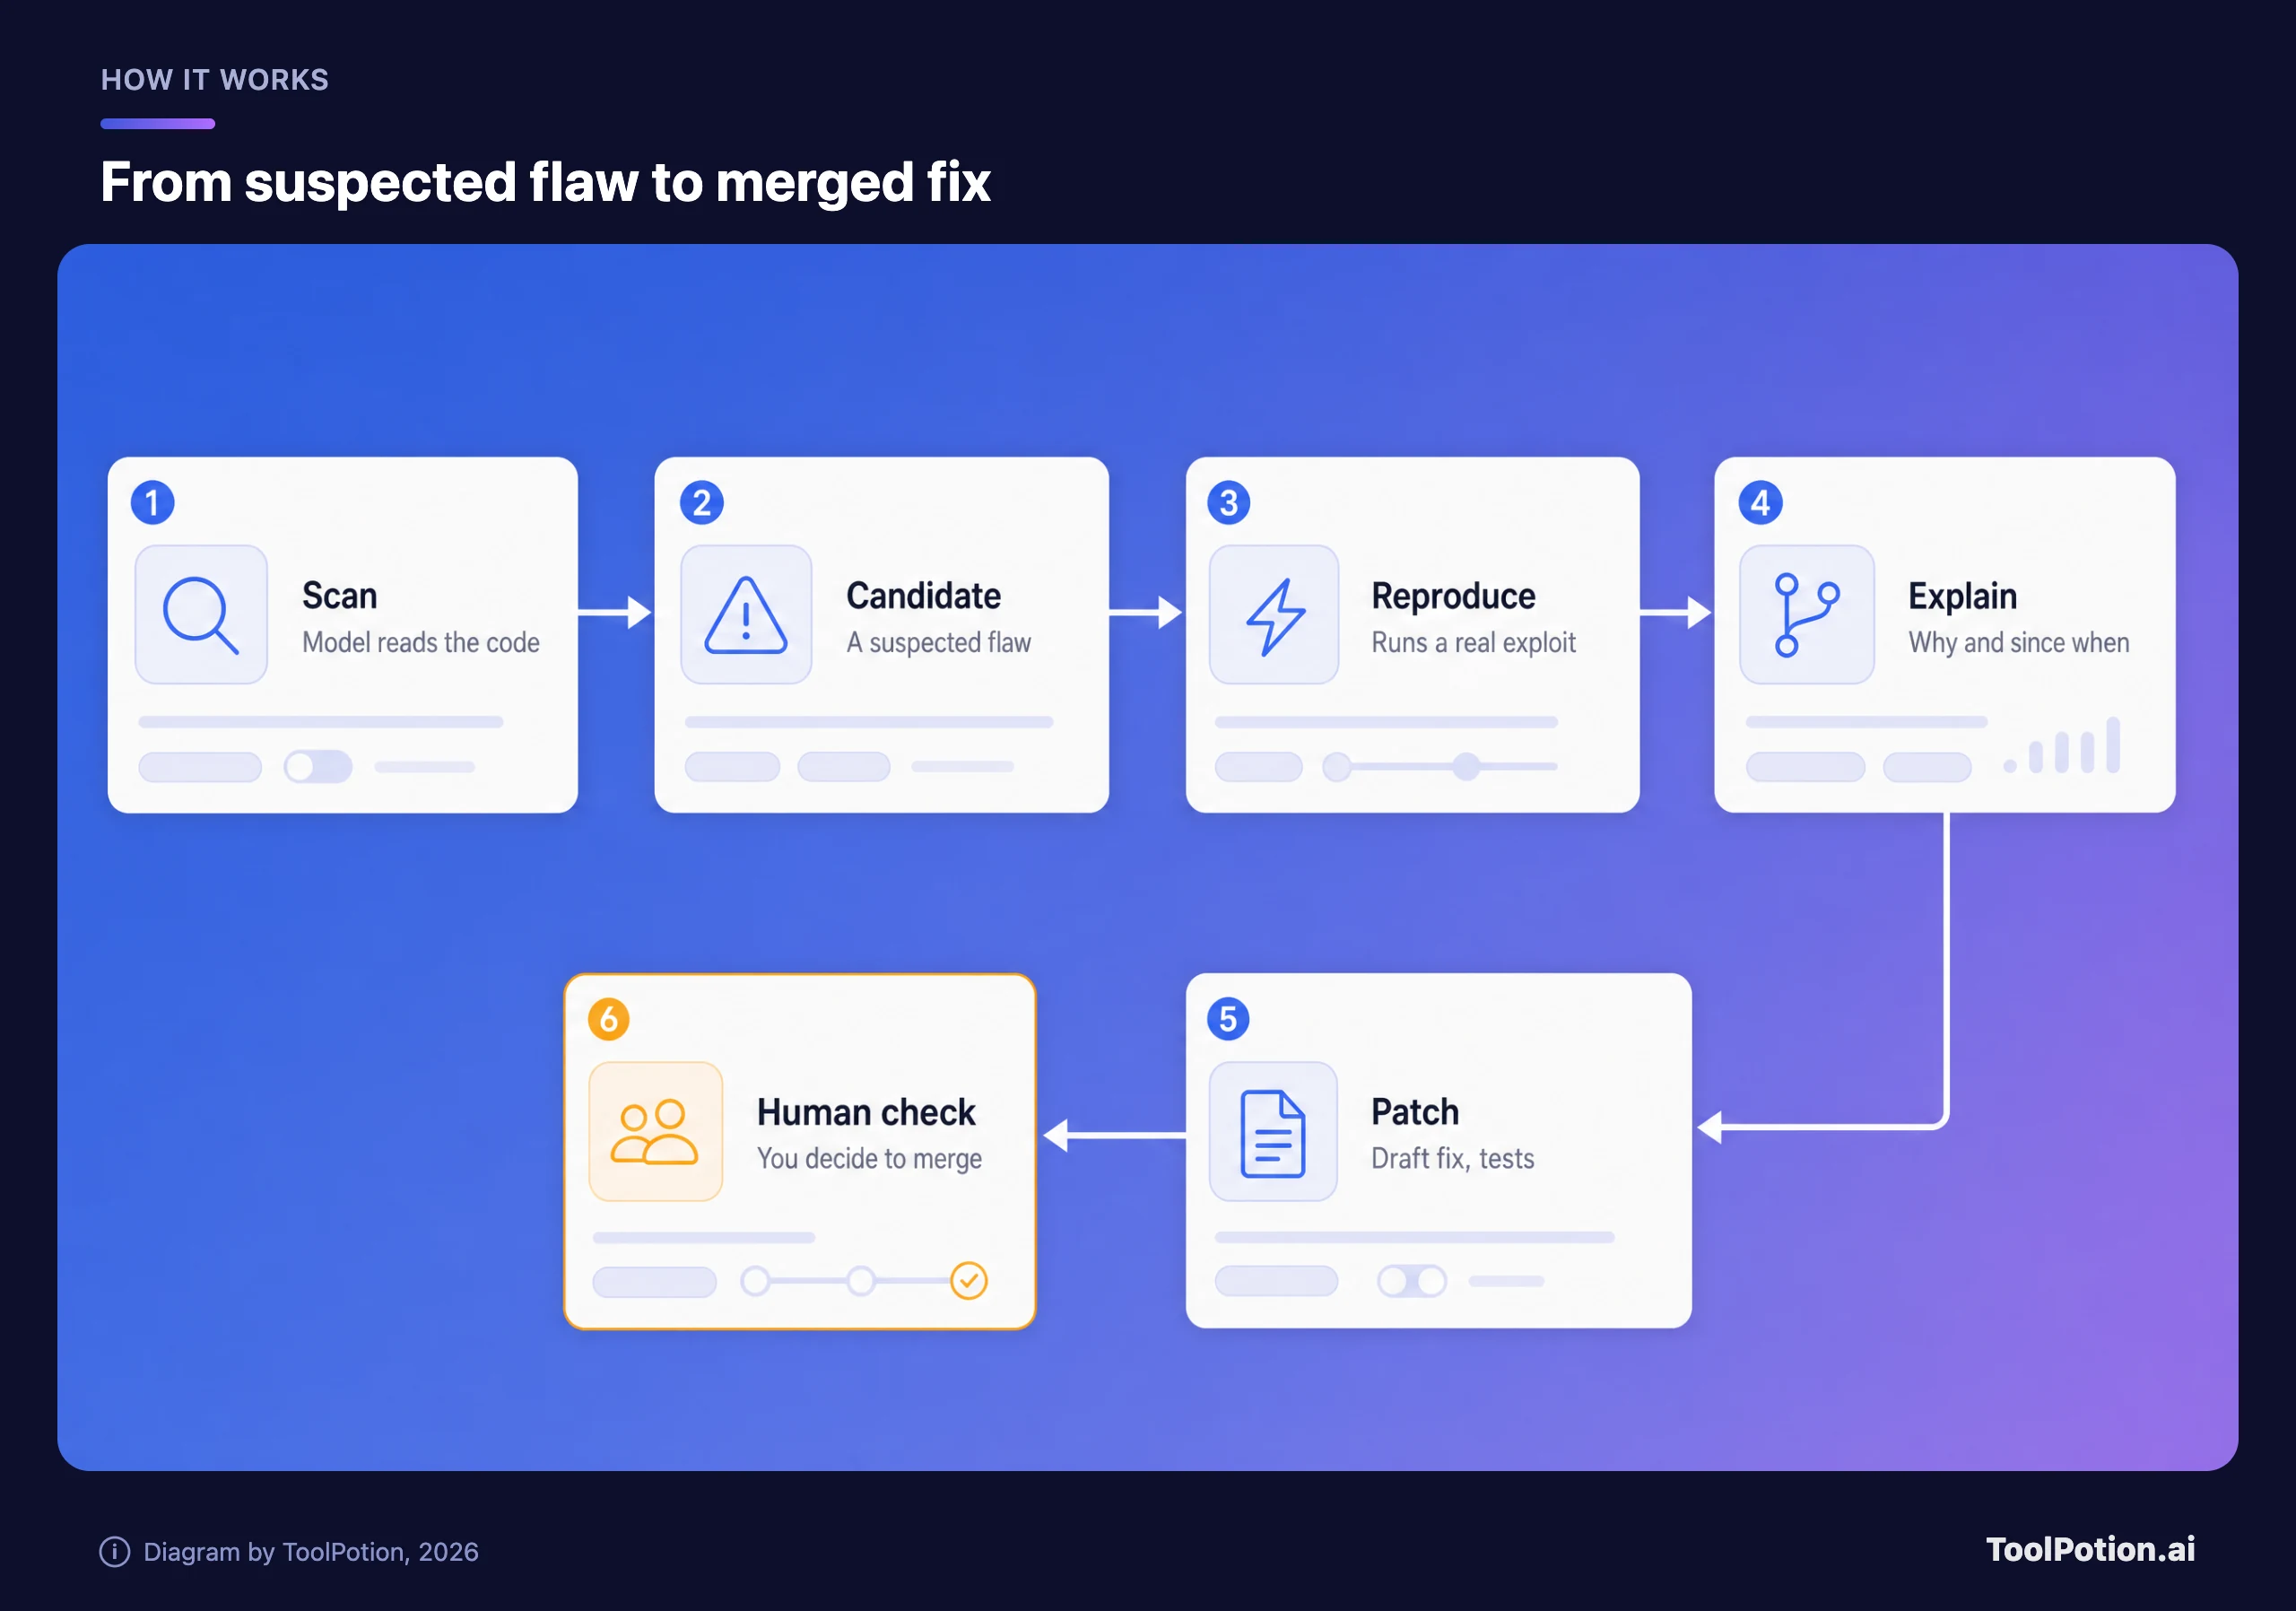
パイプラインは左から右へ読んでください。最初の3ステップは「正しさ」のためのもので、候補は誰かの目に触れる前に実際のテストを受けます。4つ目と5つ目は「使いやすさ」のためのもので、何が壊れたかの説明と修正案の下書きです。最後の枠はあなたの担当で、理由があって琥珀色になっています。GoogleはCodeMenderのパッチをすべて人がレビューすると述べており、GitHubのAutofixも提案にとどまります。Anthropicのスキャナーはトリアージの面で例外なので、最後の枠があなたに回ってくるのです。
2026年のツール勢力図
OSS Scannerだけではありません。GoogleのDeepMindは、バグを探すエージェントのBig Sleepと、修正を書くCodeMenderを作りました。DeepMindは、すでに72件のセキュリティ修正をオープンソースプロジェクトに上流反映(upstream)しており、パッチはすべて事前に人間の研究者がレビューしたと述べています(Google DeepMind)。CodeMenderはその後、Google Cloudのエンタープライズ顧客向けにパブリックプレビューへ移行しました。サンドボックス内でproof-of-concept(PoC)のエクスプロイトを作り、テスト済みの修正をdiffとして返し、開発者のレビューに回します(Infosecurity Magazine)。
OpenAIの製品は当初Aardvarkとして登場しました。GPT-5ベースのエージェントで、リポジトリの脅威モデルを作り、新しいコミットを監視し、サンドボックスで問題を確認し、パッチを提案します。OpenAIによれば、テスト用リポジトリの既知および合成の脆弱性で92%を検出し、10件のCVE IDが付く問題も見つけたとのことです(OpenAI)。その後、OpenAIはこれをCodexに統合して名前も変えました。Aardvarkのページには今、「AardvarkはCodex Securityになりました」とあり、リサーチプレビューとして提供されています(OpenAI)。ドキュメントではCodex Securityを、チームが脆弱性を「見つけ、確認し、修正する」のを助けるエージェントと説明していて、クラウド版はまだリサーチプレビューです(OpenAI docs)。
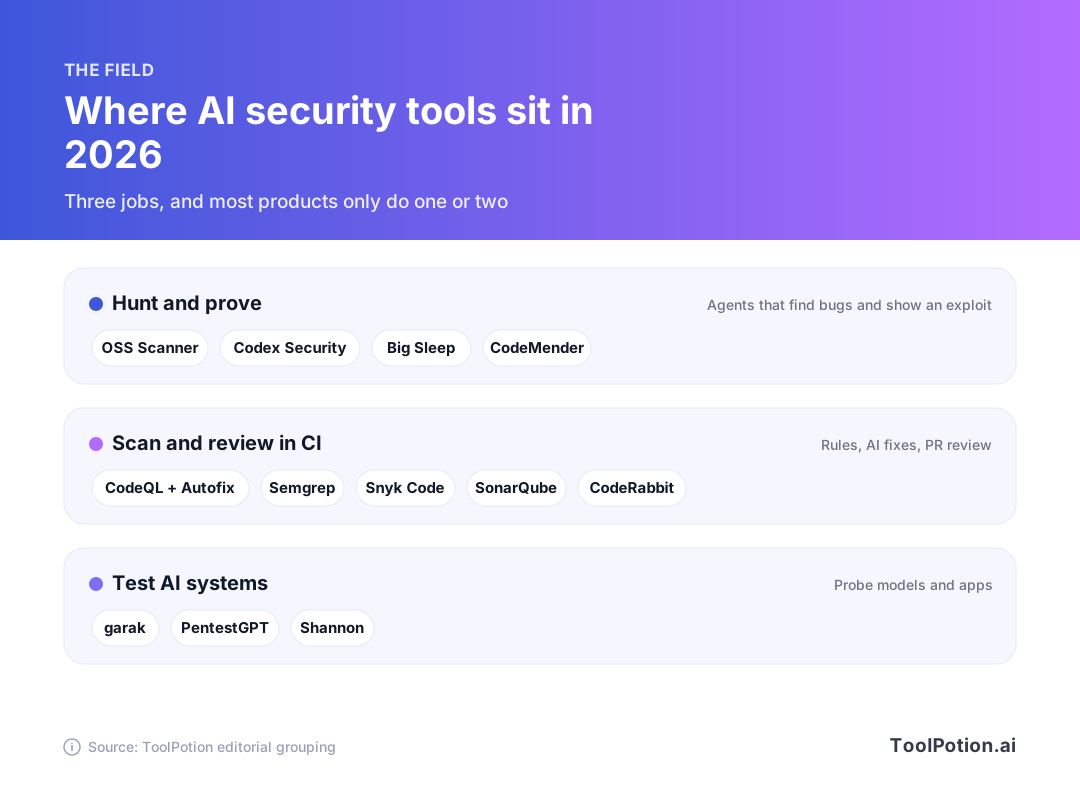
このマップは役割別にまとめたもので、分類は各ベンダーのものではなく私たちの整理です。上段は探して証明するツール。中段はパイプラインの中に常駐し、コミットのたびに動くツール。下段は向きが逆で、AIシステムそのものをテストするツールです。
中段では、GitHub Copilot AutofixがGitHubのスキャナーCodeQLが出したアラートに対して修正を提案します。SemgrepとSnyk Codeは独自のエンジンで同様の働きをし、SonarQubeはコード品質に加えてセキュリティチェックもカバーします。CodeRabbitはプルリクエストをレビューします。下段では、garakが言語モデルの弱点を探り、PentestGPTがモデルを使ってペネトレーションテストを進めます。より幅広いツールのランキングはAIサイバーセキュリティボードに、プルリクエスト系ツールはコードレビューボードにまとめています。
| ツール | 主な役割 | 利用できる人 |
|---|---|---|
| OSS Scanner(Anthropic) | バグの発見と証明、パッチの下書き | 登録済みのオープンソースプロジェクト、無料 |
| Codex Security(OpenAI) | 発見、確認、修正 | Codex内のリサーチプレビュー |
| CodeMender(Google) | スキャン、証明、パッチ作成 | パブリックプレビュー、Google Cloud顧客向け |
| Copilot Autofix(GitHub) | CodeQLアラートへの修正提案 | パブリックリポジトリは無料 |
| Semgrep | ルールベースのスキャン+AI機能 | コントリビューター10人まで無料 |
| Snyk Code | コードと依存関係のスキャン | 無料プランは月100回のCodeテスト |
この表の内容の大半はベンダーのページに基づいており、ベンダーは自社製品を好意的に説明するものです。いちばん役に立つのは利用条件の列だと考えてください。変わるのが早いので。
裏側:メンテナーは溺れかけている
本物のバグを見つけるモデルは、もっともらしい偽のバグも書けてしまいます。わかりやすい例がcurlです。curlのバグバウンティは2019年から2026年初めまで続き、確認された87件の脆弱性に対して10万ドル超を支払ったうえで、終了しました。2025年には、確認されたレポートは5%未満で、以前の年の15%以上から下がっています(Daniel Stenberg)。
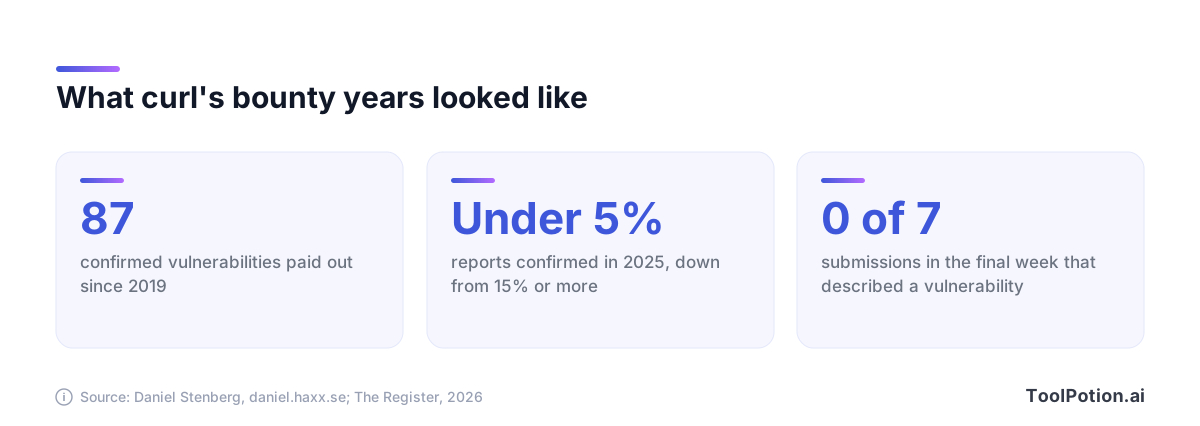
バウンティが終わる前の最後の1週間に、curlには7件の投稿が届きましたが、脆弱性を説明していたものは1件もありませんでした(The Register)。Stenbergの理屈は明快です。目的は「AI生成かどうかを問わず、質の低い、調査不足のレポートを送るインセンティブをなくすこと」でした。Apache Log4jのPiotr Karwaszも同じ傾向を語っており、多くのレポートが「私たちのセキュリティモデルの基本を見落としていて、価値ではなくノイズを増やしている」と述べています(Daniel Stenberg)。
curlはその後、さらに踏み込みました。Stenbergによると、プロジェクトは今年の夏に脆弱性レポートの受付を1か月停止し、これを「最近でも最高のプロジェクト判断だったかもしれない」と評しています(Daniel Stenberg)。
AIノイズを止めるためにバウンティを閉じたのと同じプロジェクトが、最悪クラスのバグを見つけたAIスキャナーを称賛している点に注目してください。これは矛盾ではありません。違いは、動く再現コードがあるかどうか、そして送り手がすでに検証を済ませているかどうかです。主張を自ら証明するモデルなら、メンテナーの負担は数分で済みます。モデルの出力をそのまま貼り付ける人は、数時間分の負担を生みます。
Anthropicのスキャナーは人間の仲介を省いており、そこが魅力でもありリスクでもあります。届くのは速くなりますが、誰も読んでいないレポートがあなたのもとに届きうるということでもあります。プロジェクトのメンテナーなら、表にあるどのベンダーからも、こうしたレポートが増えると覚悟しておいたほうがいいでしょう。
攻撃者も同じモデルを使える
Anthropicの発表自体が、「フロンティアモデルは、脆弱性の悪用やサイバー作戦に誤用されうる」と述べています(Anthropic)。現実的に読めば、話は単純です。強力なモデルを公開コードに向けて「どこが壊れるか」と尋ねることは誰にでもでき、オープンソースは定義上、公開されています。
これが、自分のコードをスキャンすべき本当の理由です。AIスキャナーが魔法だからではありません。バグが存在してから誰かに見つかるまでの時間が短くなっていて、先に見つけるのは自分のほうがいいからです。スキャンしていないプロジェクトは安全なのではなく、ただ観測されていないだけです。
無料のものと、そうでないもの
役に立つ層の多くは、コードが公開されていれば無料です。Copilot Autofixは、CodeQLを使うパブリックリポジトリでデフォルトで有効になり、Copilotのサブスクリプションは不要です(GitHub)。GitHubは2024年にすべてのパブリックリポジトリで無料にしました(GitHub changelog)。
Semgrepの無料版は、コントリビューター10人・リポジトリ10個までで、AIクレジット60が含まれます(Semgrep)。Snykの無料プランは、5プロジェクトと月100回のSnyk Codeテストまで(Snyk)。さらにオープンソースのメンテナーが無料アクセスを申請できるプログラムもあります。
有料になる部分は、主にプライベートコードとエージェントです。GitHubの新しいエージェント型autofix(まだプレビュー)はAIクレジットを消費し、プライベートリポジトリでのCopilot AutofixにはCode Securityライセンスが必要です(GitHub)。Codex Securityを使うには、リサーチプレビューへのアクセスが必要です(OpenAI docs)。
安全に参加するには
無料だからといって、影響がないわけではありません。コードを読んで報告を送ってくるスキャナーは、あなたのワークフローや開示プロセス、場合によっては評判にも影響します。次のステップを踏めば、コントロールを保てます。
- まず適格性を確認する。OSS Scannerの対象は、重要インフラやセキュリティに影響するプロジェクトです。プルリクエストに時間をかける前に、Anthropicのリポジトリにある基準を読んでください。
- レポートの届け先を決める。GitHubのprivate vulnerability reportingやセキュリティ用のメールアドレスなど、非公開のチャネルを使い、修正が出る前に指摘が公になるのを防ぎます。
- 担当者を決める。全レポートを受け取り、対応を判断する人を1人置きます。2人いると、お互いが相手に任せたと思い込みます。
- ホスト型スキャナーのデータ規約を読む。たとえばSemgrepは、オプトインしたAI機能が、指摘を含むファイルの一部を処理することがあると説明しています(Semgrep)。何がマシンの外に出るのかを把握しておきましょう。
- 読み取り専用のアクセスから始め、パッチは提案にとどめる。mainブランチにプッシュしていいツールはありません。
- 最初のレポートが届く前に、開示のタイムラインを書き出しておく。冷静なときに自分で書いたルールは、守りやすいものです。
特別なことは何もありません。優れたメンテナーが外部の研究者に対して当たり前にやっている衛生管理を、レポートの量が増える前に済ませておくだけです。
小さなチーム向けのワークフロー
2〜10人でプロダクトを出荷しているなら、初日からエージェント型スキャナーは要りません。必要なのは、本当に空にできるキューです。下のループは6ステップで、琥珀色のステップは多くのチームが飛ばしがちなところです。
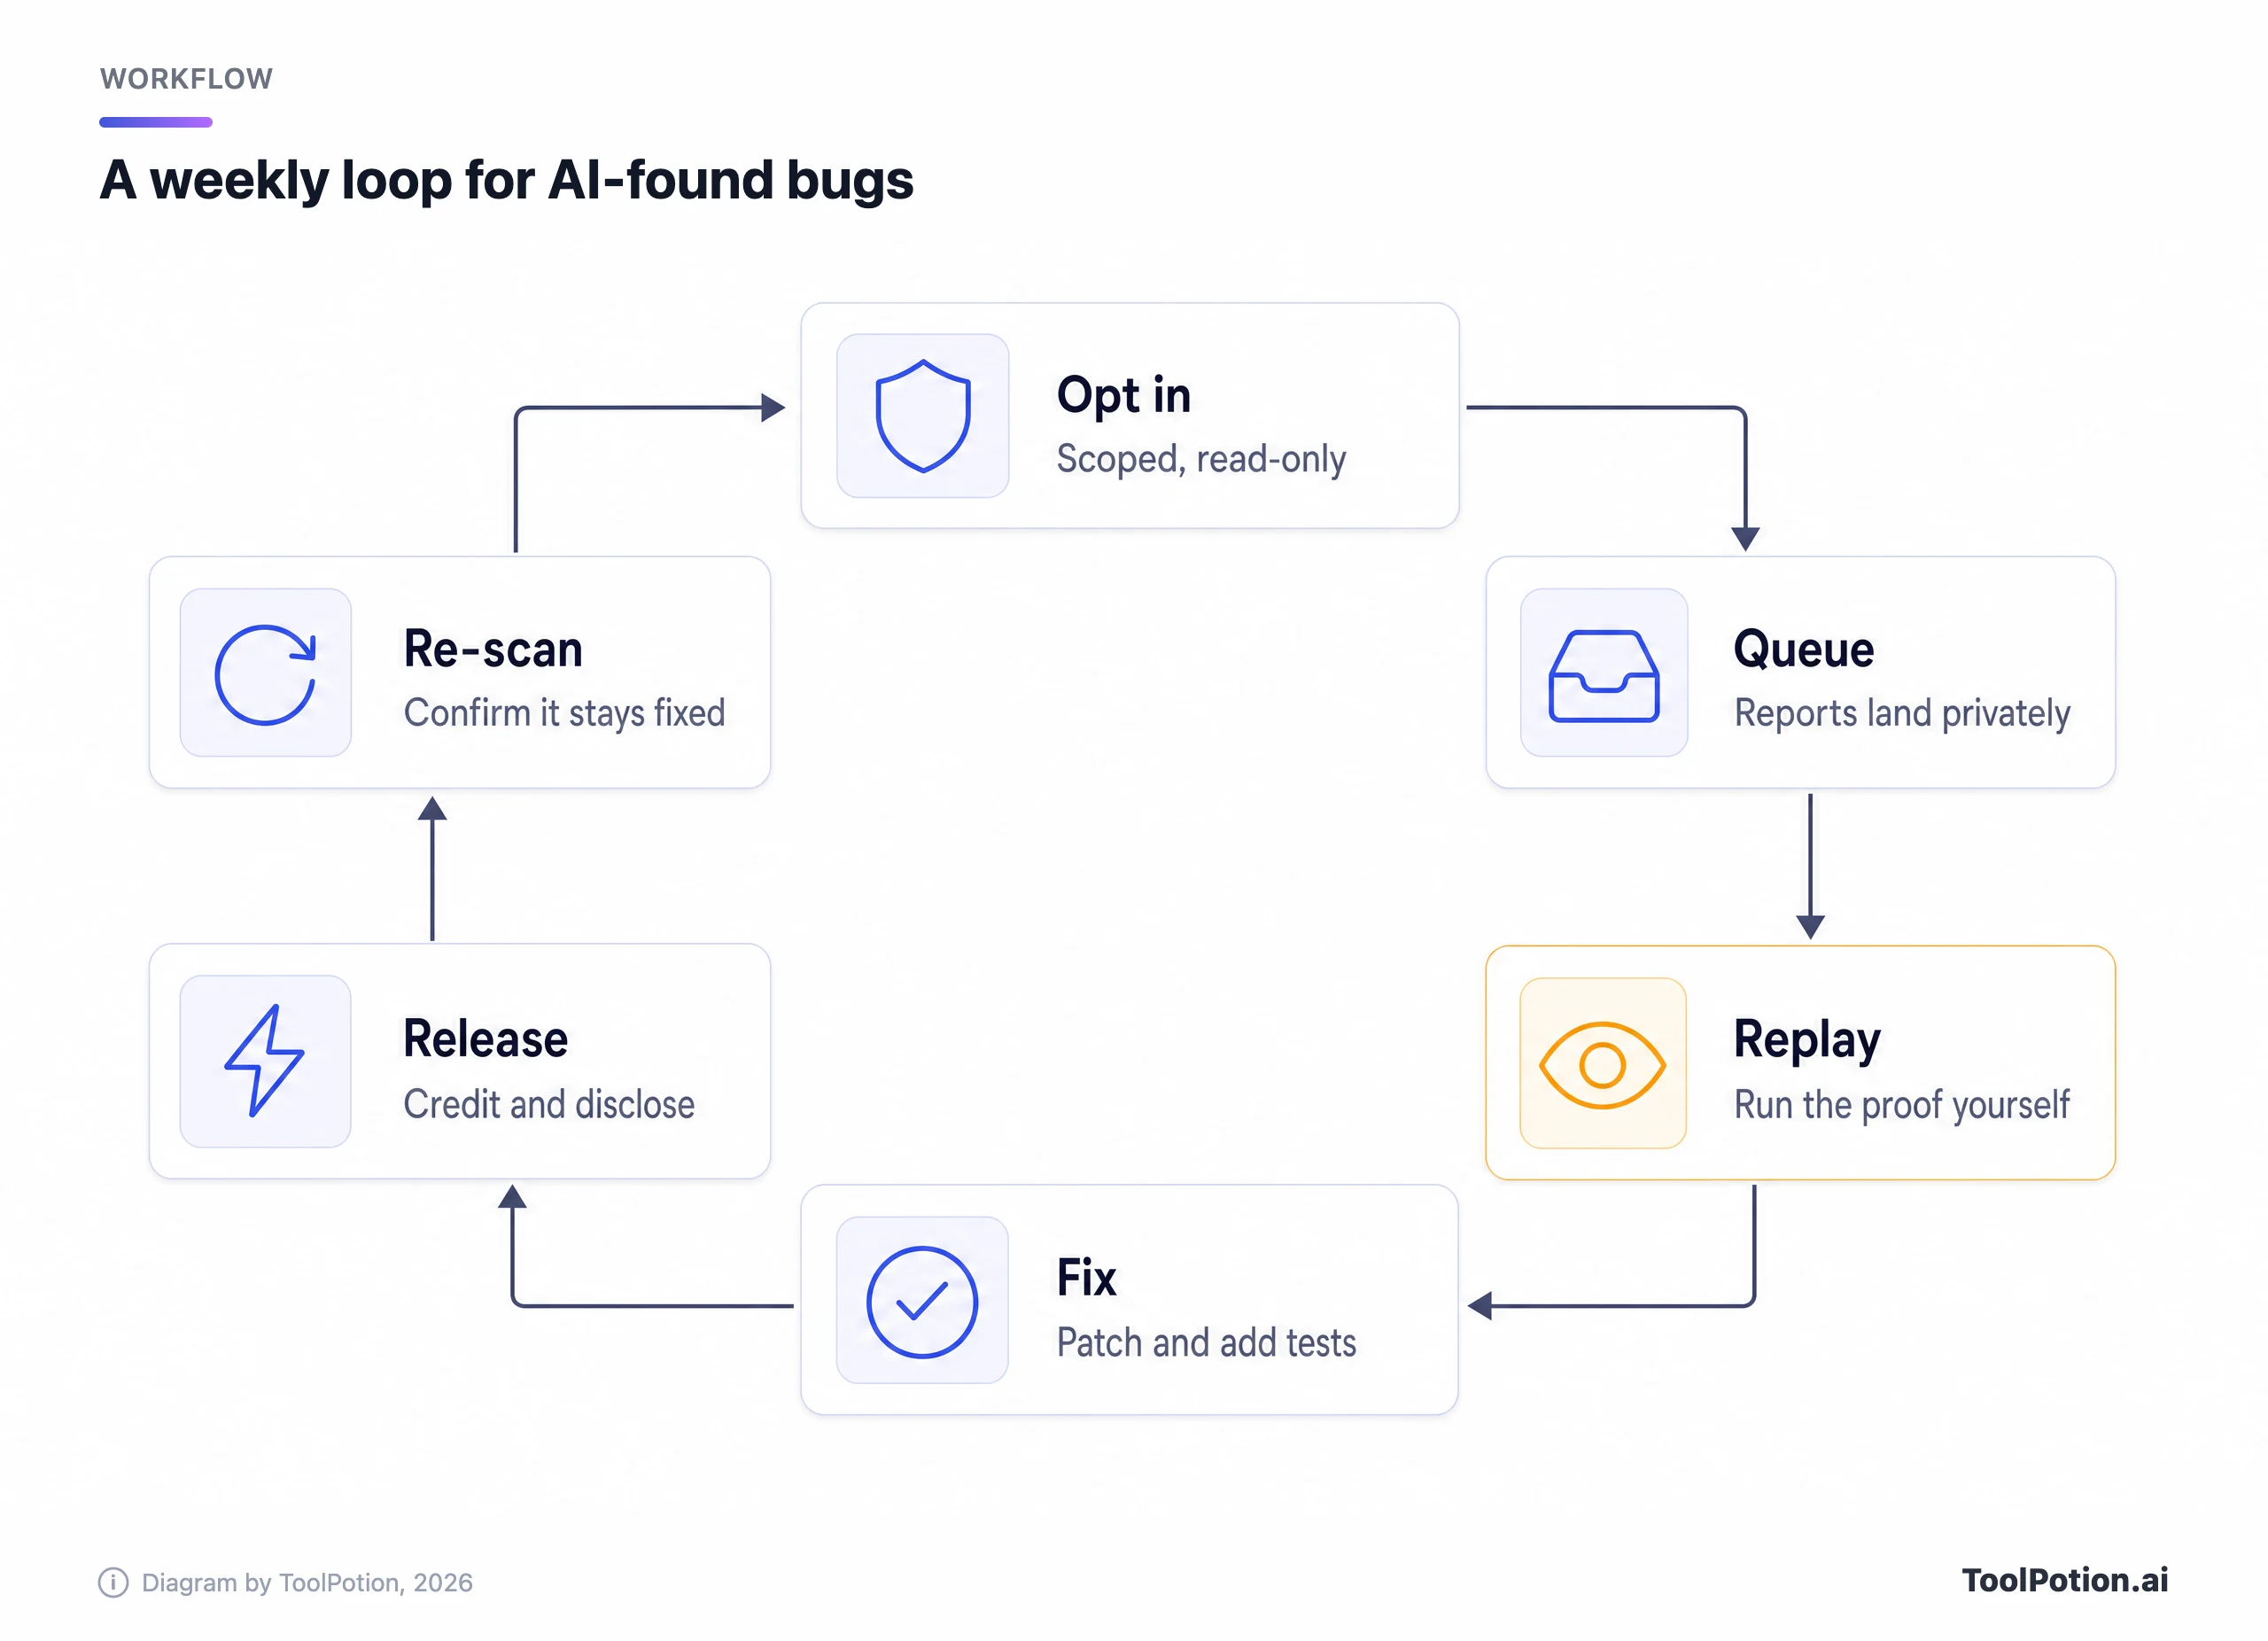
再現(replay)は、役に立つスキャナーとノイズだらけのスキャナーを分けるステップです。レポートに再現コードがあるなら、自分で実行してください。なければ、出してもらいましょう。主張が動くところを見せられないモデルが渡してきたのは、仮説にすぎません。そして仮説は安いものです。
どこから始めればいいかわからない方へ。下のデシジョンツリーに、よくあるケースをまとめました。上で見たベンダーの条件に基づく編集部のアドバイスなので、状況に合わせて調整してください。
多くの小さなチームにとって、最初の一手は無料のプルリクエストスキャナーと、結果に責任を持つ担当者を1人置くことです。エージェント型ツールは、そのキューが数週間穏やかなまま保てるようになってから足せば十分です。趣味のリポジトリなら、ホスト側が提供する無料のデフォルト機能で足ります。重要な経路にあるライブラリなら、OSS Scannerに申し込むべきです。
トリアージのコストを計算する
トリアージにかかる時間は料金ページには載りませんが、スキャナーが助けになるか足かせになるかを決めるのはこのコストです。優秀なツールでも、重複は多少出ます。Anthropic自身のレビューでも、97件中11件でした。下の計算ツールで、レポート件数を時間に換算できます。
無効な割合を上げて、時間がどれだけ急に膨らむか試してみてください。次に、1件あたりの分数を15分まで減らしてみましょう。動く証明が付いていれば、これくらい節約できるかもしれないという大まかなイメージです(この数字は例示であり、実測値ではありません)。この差こそ、AIツールにも人間にも再現コードを求めるべき理由です。
レポートが届き始めたら、いくつかの習慣が役立ちます。下の図にまとめました。
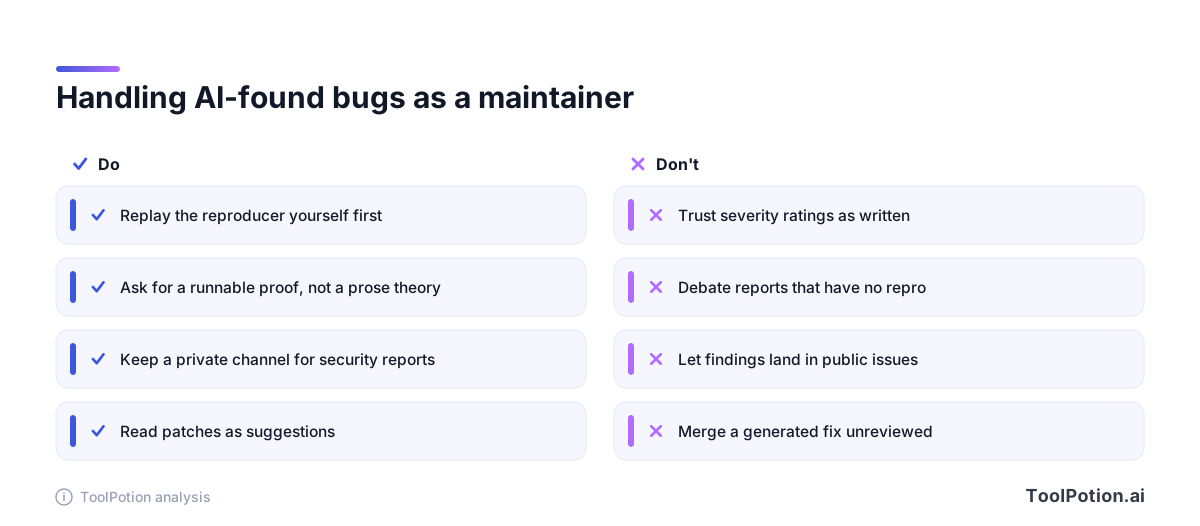
最初の組は繰り返す価値があります。深刻度の評価はモデルが付けたもので、間違っていることもあるとAnthropic自身が警告しています(SiliconANGLE)。再現を確かめたうえで、自分で評価し直してください。Claude Codeのようなアシスタントは、バグが本物だと判断した後の修正やリグレッションテストの作成を手伝ってくれますが、判断は人間の役目です。この種のツールについてもっと知りたい方は、コーディングアシスタントボードとAIコードレビューツールのガイドをご覧ください。
これらのツールがまだ苦手なこと
得意なのは、コードに痕跡が残るタイプのバグです。メモリエラー、インジェクション、チェックの欠落などですね。一方、ビジネスの実際の動き方に依存する欠陥、たとえば誰が何を承認してよいかといった問題は苦手です。スキャナーには、あなたの意図まではわかりません。
セキュリティ全体の代わりにもなりません。GoogleのCodeMenderは、パッチを上流に出す前に人間のレビューを挟んでいます(Google DeepMind)。GitHubも、Autofixはベストエフォートで動くもので、カスタムクエリのアラートについては修正で解消されたかを確認できないと説明しています(GitHub)。最も得をするはずのベンダーですら、出力は確認するようにと言っているわけです。
正直な限界は量です。バグを見つけるコストは、直すコストよりも速く下がっています。3人のプロジェクトに40件の本物の指摘を渡すスキャナーは、より安全なプロダクトではなく、バックログを作っただけです。ツールは、何を見つけられるかではなく、1か月でどれだけ直せるかで選びましょう。
よくある質問
AnthropicのOSS Scannerは、どのGitHubリポジトリでも利用できますか?
いいえ。オプトイン方式で、案件ごとに審査されます。基準はOSS-Fuzzに近く、インフラとユーザーセキュリティに重大な影響があるプロジェクトが対象です。メンテナーは、AnthropicのGitHubリポジトリにプルリクエストを出して申請します。
AIスキャナーはペネトレーションテストの代わりになりますか?
顧客にとって重要なものについては、なりません。コードレベルのバグには強い一方、ビジネスロジックの欠陥は苦手です。時々行う人間によるレビューとあわせて、常時動く追加のレイヤーと考えてください。
ClaudeやGeminiに直接コードを監査させてもいいですか?
ClaudeやGoogle Geminiにコードを貼り付けて、セキュリティレビューを頼むことはできます。単一の関数なら役に立ちます。ただ、上で紹介した専用エージェントが備えるサンドボックスや、リポジトリ全体の脅威モデル、エクスプロイトの検証はないので、誤検知は多くなると思ってください。
偽物に見えるAI作成のレポートが届いたら、どうすればいいですか?
バージョンを指定して、再現コードを求めてください。本物の指摘なら答えられますが、でっち上げだと答えられないことが多いです。何度も送ってくる相手には、レポートをクローズして先に進んで構いません。
無料のスキャナーは、プライベートコードに使っても安全ですか?
それぞれの規約を読んでください。完全に自分のマシン上で動くものもあれば、ファイルの一部をホスト型モデルに送るものもあります。プライベートリポジトリを接続する前に、ベンダーが何をどれくらいの期間保存するのかを確認しましょう。