

オープンウェイトモデルは、最高峰のクローズドモデルにかなり近づきました。多くの用途で、問うべきは品質ではなくなっています。誰がモデルを動かすのか、データがどこへ送られるのか、ライセンスで何が許されるのかです。Bloomberg Intelligenceによると、中国のトップモデルと米国の最上位モデルの差は、主要ベンチマークで約3%。今年初めには約15%でした(AI Weekly、Bloomberg引用)。
この変化が最も効いてくるのは、開発者、スタートアップ、プライバシー規則のあるチームです。Hugging Faceからモデルを取得して自分で管理するハードウェア上で動かせば、1年前は有料APIの向こう側にあったレベルのコーディング性能やエージェント性能が手に入ります。ハードウェアを用意せず、安価なホスト経由で同じウェイトを呼び出すこともできます。
ただし、良いことばかりではありません。「オープン」といっても、何でも自由なライセンスから細則を読み込む必要があるものまで幅があります。大型モデルの中にはGPUラック一式が必要なものもあり、セキュリティ面や検閲面で無視できないリスクを抱えるものもあります。このガイドでは現在の主要モデルを整理し、費用を示したうえで、選び方のルールを紹介します。クローズドとオープンを含めた全体像を知りたい方は、Top 25 LLMsボードをご覧ください。
差は縮まり、顔ぶれも変わった
注目すべきはベンチマークの差なので、その中身を見てみましょう。Bloombergの測定では、中国のトップモデルは今年初めに約15%遅れ、年央には約9%、その1か月後には約6%まで詰め、当時の過去最小を記録しました(The Next Web)。最新の測定値は約3%です。最新のデータ点はDeepSeek V4.1 Flashで、LiveBenchのスコアは81.1。Anthropicの主力モデルは83.4でした。一方、このベンチマークのエージェント型コーディングのサブテストでは、77.3対66.1でDeepSeekがリードしています。
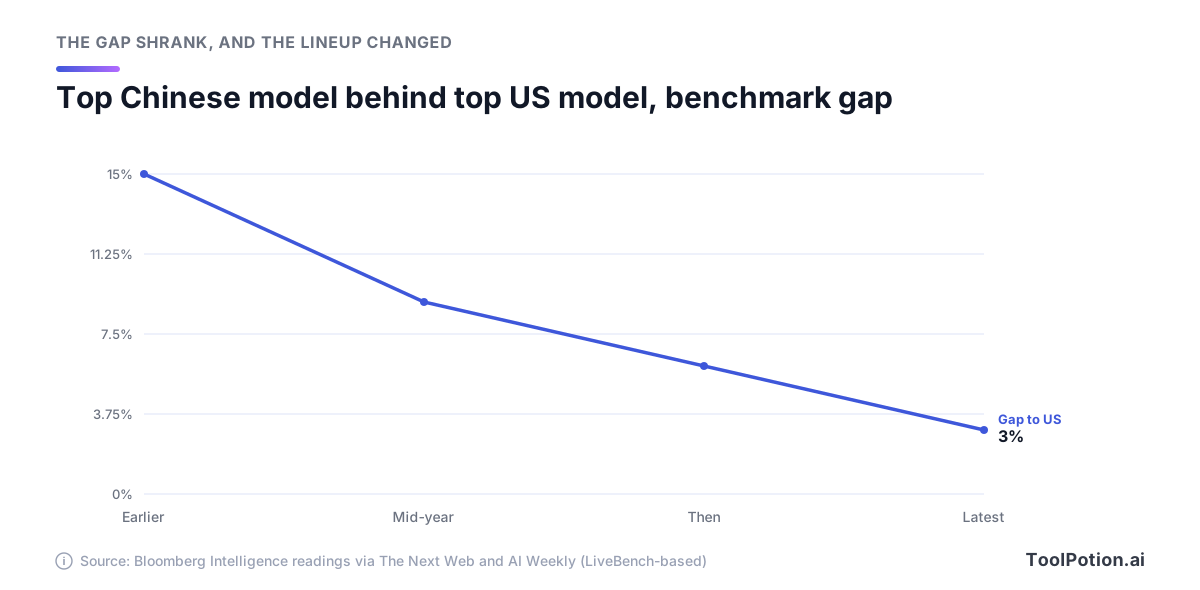
注意点も押さえておいてください。LiveBenchの上位15件のうち中国勢は3件だけなので、これは最前線での話であって、全面的な勝利ではありません。また、この差は両陣営の最良モデルを1つのベンチマークで比べたものにすぎず、どちらの情報源も対象がオープンモデルに限られるとは述べていません。それでも方向性は明確です。そして差を縮めたモデル、DeepSeek V4.1 Flashはオープンウェイトです。
今年はほかにも2つ変化がありました。1つ目は、Qwenが初めてMax級のモデルをオープンウェイトで公開したことです。これはQwen3.8-2.4T-A95B自身のモデルカードに書かれています。2つ目は、Metaのオープン公開の動きです。MetaのHugging Faceページにある最新のLlamaは、いまも2025年のLlama 4 ScoutなどLlama 4ファミリーです。Metaの開発者サイトは現在、ホスト型のMuse Sparkモデルを前面に出し、オープンなモデルとしてローカルエージェント向けの30BオープンウェイトモデルMuse Glimmerを挙げています。
もう1つのニュースはMistralです。パラメータ数1兆、アクティブ520億のMistral Large 4を発表し、APIでプレビューを公開しました。ウェイトは月末までに続くとしています(Mistral)。執筆時点ではダウンロードできず、ライセンスも公開されていないため、Large 4は「約束されたもの」であり、リリース済みとは言えません。ウェイトとライセンスがHugging Faceに載るまでは、計画に組み込まないでください。
知っておきたいオープンウェイトモデル
現在の主要モデルを一覧にしました。サイズとライセンスは各モデルのHugging Faceカード、価格は各メーカーの料金ページに基づきます。「アクティブ」とは、Mixture-of-Experts(MoE)モデルでトークンごとに動作するパラメータ数のことで、速度を左右します。
| モデル | ライセンス | サイズ(アクティブ) | コンテキスト | メーカーAPI、100万トークンあたり$ 入力/出力 |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B(8B〜16B) | 1M | 0.30 / 1.20(ピーク時) |
| DeepSeek V4-Pro | MIT | 1.7T | 1M | 1.32 / 3.96(ピーク時) |
| Kimi K3 | Kimi K3 License | 2.8T(104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B(Dense) | 262K | ホスト版は近日公開 |
| gpt-oss-120b | Apache 2.0 | 117B(5.1B) | 該当なし | メーカーAPIの掲載なし |
| Gemma 4 31B | Apache 2.0 | 31B(Dense) | 256K | メーカーAPIの掲載なし |
| Muse Glimmer | Apache 2.0 | 30B(Dense) | 131K以上 | メーカーAPIの掲載なし |
| Mistral Large 4 | 未公開 | 1T(52B) | 該当なし | 1.36 / 4.18(プレビュー) |
コスト面で無難な選択肢はDeepSeekです。V4.1 FlashのウェイトはMITライセンスで、APIの価格は大型モデルの中で最安、さらにオフピーク時は半額になります(DeepSeekドキュメント)。名前に惑わされないでください。ここでの「Flash」は763Bのモデルで、ダウンロードサイズは510 GBあります(モデルカード)。V4-Pro-0813はさらに大きく、約1.7Tです。
Kimi K3は話題をさらうモデルです。パラメータ数は2.8兆、アクティブ1040億で、自身のカードによればGPQA Diamondで93.5、BrowseCompで91.2を記録しています。ただしこれはMoonshot自身の数字なので、主張として読んでください。また、Moonshot自身のAPIはオープン勢の中で最も高価で、意外に思われる方が多いようです(詳しくは後述)。
Z.aiのGLM-5.3はコーディング特化型です。GLM-5.2とベースモデルが同じで、Z.aiによれば向上分はすべてポストトレーニングによるものであり、自社のコーディングベンチマークでは50%の伸びだったそうです(モデルカード)。これはベンダー自身の測定です。低価格の兄弟モデルGLM-5.3-Flashは、入力$0.15、出力$0.50です。
最も幅広いラインナップがあるのはQwenです。Qwen3.8-27BはApache 2.0のDense 27Bモデルで、ビジョンに対応し、ネイティブコンテキストは262K、SWE-bench Proで61.7が報告されています(モデルカード)。ワークステーション1台なら、コーディングやエージェント用途で最初に試すのに最適で、多くの小規模チームにとっても出発点になるモデルです。大型のQwen3.8-2.4Tは別のライセンスの下にあり、次の章で扱います。Qwenはアプリからも試せます。
OpenAIのgpt-oss-120bは、いまや古い部類ですが、まだ使えます。Apache 2.0で、アクティブパラメータは5.1B、OpenAIによれば80 GBのGPU1枚で動作します(モデルカード)。公開は2025年で、OpenAIのHugging Faceページに新しいgpt-ossは見当たりませんでした。Gemma 4はGoogleの現行ファミリーで、31BモデルはApache 2.0、256Kのウィンドウを持ち、Ollamaとllama.cpp向けの量子化ビルドも提供されています(モデルカード)。Muse Glimmerは小型の1本で、Metaによれば約4ビット版は20 GB未満に収まり、24 GBまたは32 GBの範囲で動作し、より厳しい設定での品質低下は約1%とのことです(モデルカード)。
ヨーロッパ勢は現在2つあります。Mistral Medium 3.5は、Denseの128Bモデルで、256Kのウィンドウを持ち、修正MITライセンスで公開されています。Mistralの説明では、売上規模の大きい企業を除き商用利用が可能です。119BのMistral Small 4と、旧世代のMistral Large 3は、Hugging Face上でApache 2.0です。
「オープン」でも条件が付くことがある
多くの開発者が思い浮かべる意味で本当にオープンなのは、Apache 2.0とMITのモデルだけです。最有力クラスのモデルにも、そうでないものがいくつもあります。見出しではなく、ライセンスファイルを読んでください。
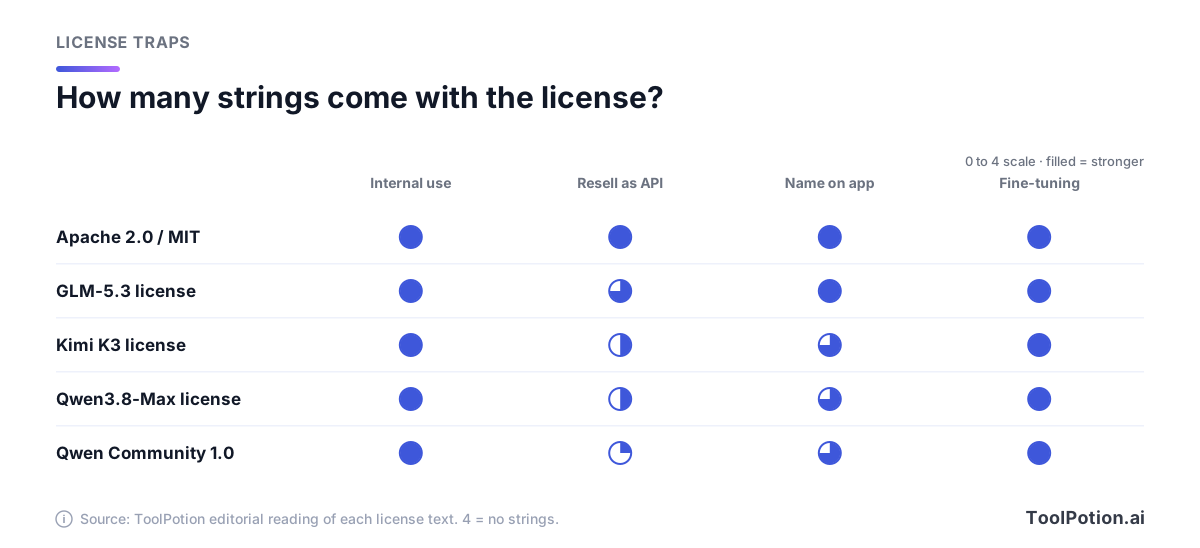
カスタムライセンスに共通するパターンがあります。使用、改変、ファインチューニングは自由です。条件が付くのは、モデルを他者に販売する場合、たいていはAPIとして提供する場合で、一定の売上規模を超えたときです。たとえばMoonshotのライセンスでは、12か月で2,000万ドルを超える収益を上げる「Model as a Service」事業者は、商用利用の前に別途契約が必要と定められています。月間ユーザー1億人、または月間売上2,000万ドルに達する製品は、インターフェースに「Kimi K3」と表示しなければなりません(ライセンス本文)。社内利用は対象外です。
Z.aiのライセンスはもっと緩やかです。条件は、売上が100億ドルを超えるModel-as-a-Service事業者へのセキュリティレビューだけです。Qwenのライセンスはこの中で最も厳しいものです。Qwen3.8-Flash-NextのQwen Community Licenseでは、Model-as-a-Serviceや「AI Work Assistant」事業を行う企業は、先にQwenから別途ライセンスを取得する必要があります。社内利用は例外です(ライセンス本文)。2.4TモデルのMaxライセンスでは、この基準が売上5,000万ドルに引き上げられています。
これらのモデルの上にアプリを作るだけなら、ほぼ問題ありません。「このモデルを提供するAPI」そのものが製品なら、公開前に弁護士と一緒にライセンスを読んでください。疑問の余地を残したくなければ、Apache 2.0かMITを選びましょう。具体的には、DeepSeek、Qwen3.8-27B、gpt-oss、Gemma 4、Muse Glimmerです。
ホスト型APIの費用
オープンウェイトだからといって、APIが安いとは限りません。誰がモデルをホストするかで状況は変わります。
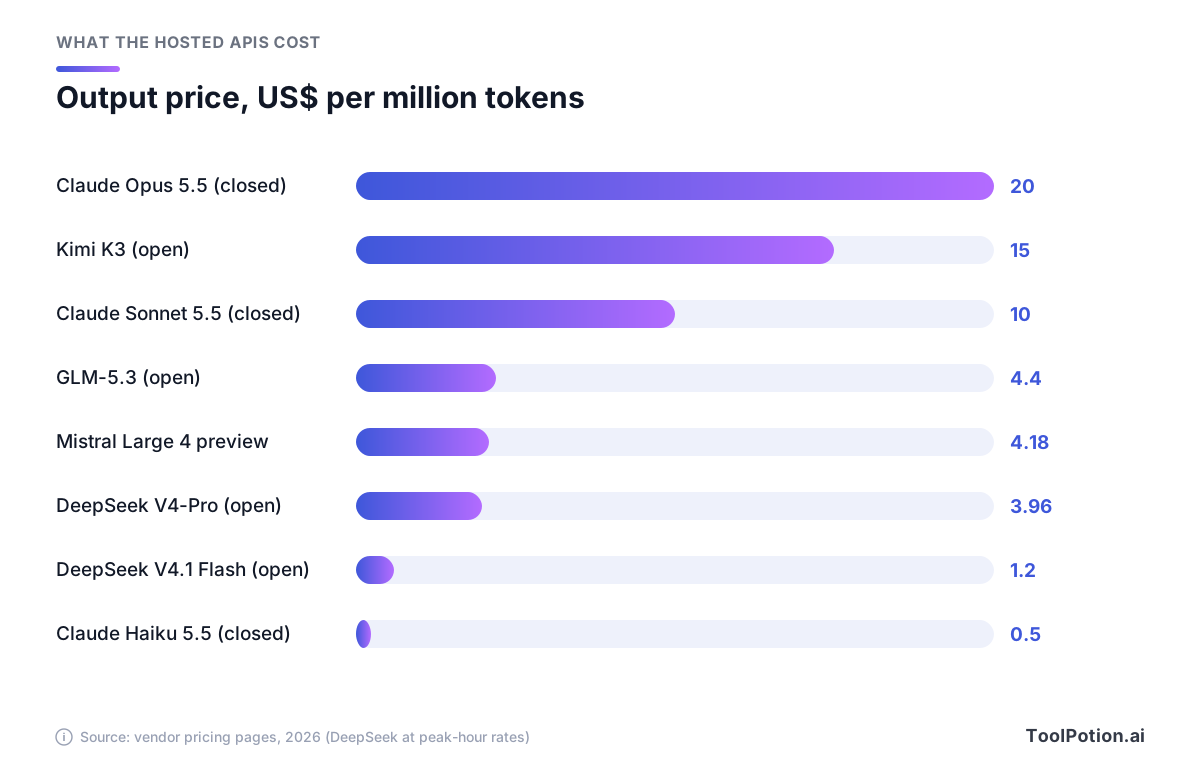
Moonshotの料金ページによると、Kimi K3は100万トークンあたり入力$3、出力$15です。これはAnthropicのClaude Sonnet 5.5の$2と$10より高く、しかもSonnetはクローズドモデルです。DeepSeekはその逆で、V4-Proの出力はピーク時$3.96、オフピーク時$1.98。Z.aiのGLM-5.3は入力$1.40、出力$4.40です。
クローズドの小型モデルは、オープンの主力モデルの多くより安くなります。各ベンダーの料金ページによれば、Claude Haiku 5.5は入力$0.10、出力$0.50で、OpenAIのGPT-6 Lunaと同じです。つまり「オープンにすれば安くなる」が成り立つのは、高価なクローズド上位モデルと比べる場合だけで、しかも安いオープンホストを選んだときに限られます。
最安のルートは、同じウェイトを提供するサードパーティであることが多いです。OpenRouterの公開モデル一覧では、gpt-oss-120bは100万トークンあたり入力約$0.04、出力約$0.17で、価格はプロバイダーによって異なり、頻繁に変わります。OpenRouter、Together AI、Fireworks AI、Groqはいずれもオープンモデルを単一のAPI形式で再販しているので、プロバイダーの乗り換えはベースURLの変更だけで済みます。
自前で動かすか、ホストを使うか
オープンモデルの動かし方は4通りあり、段階が上がるごとにコントロールできる範囲と手間が少しずつ増えます。
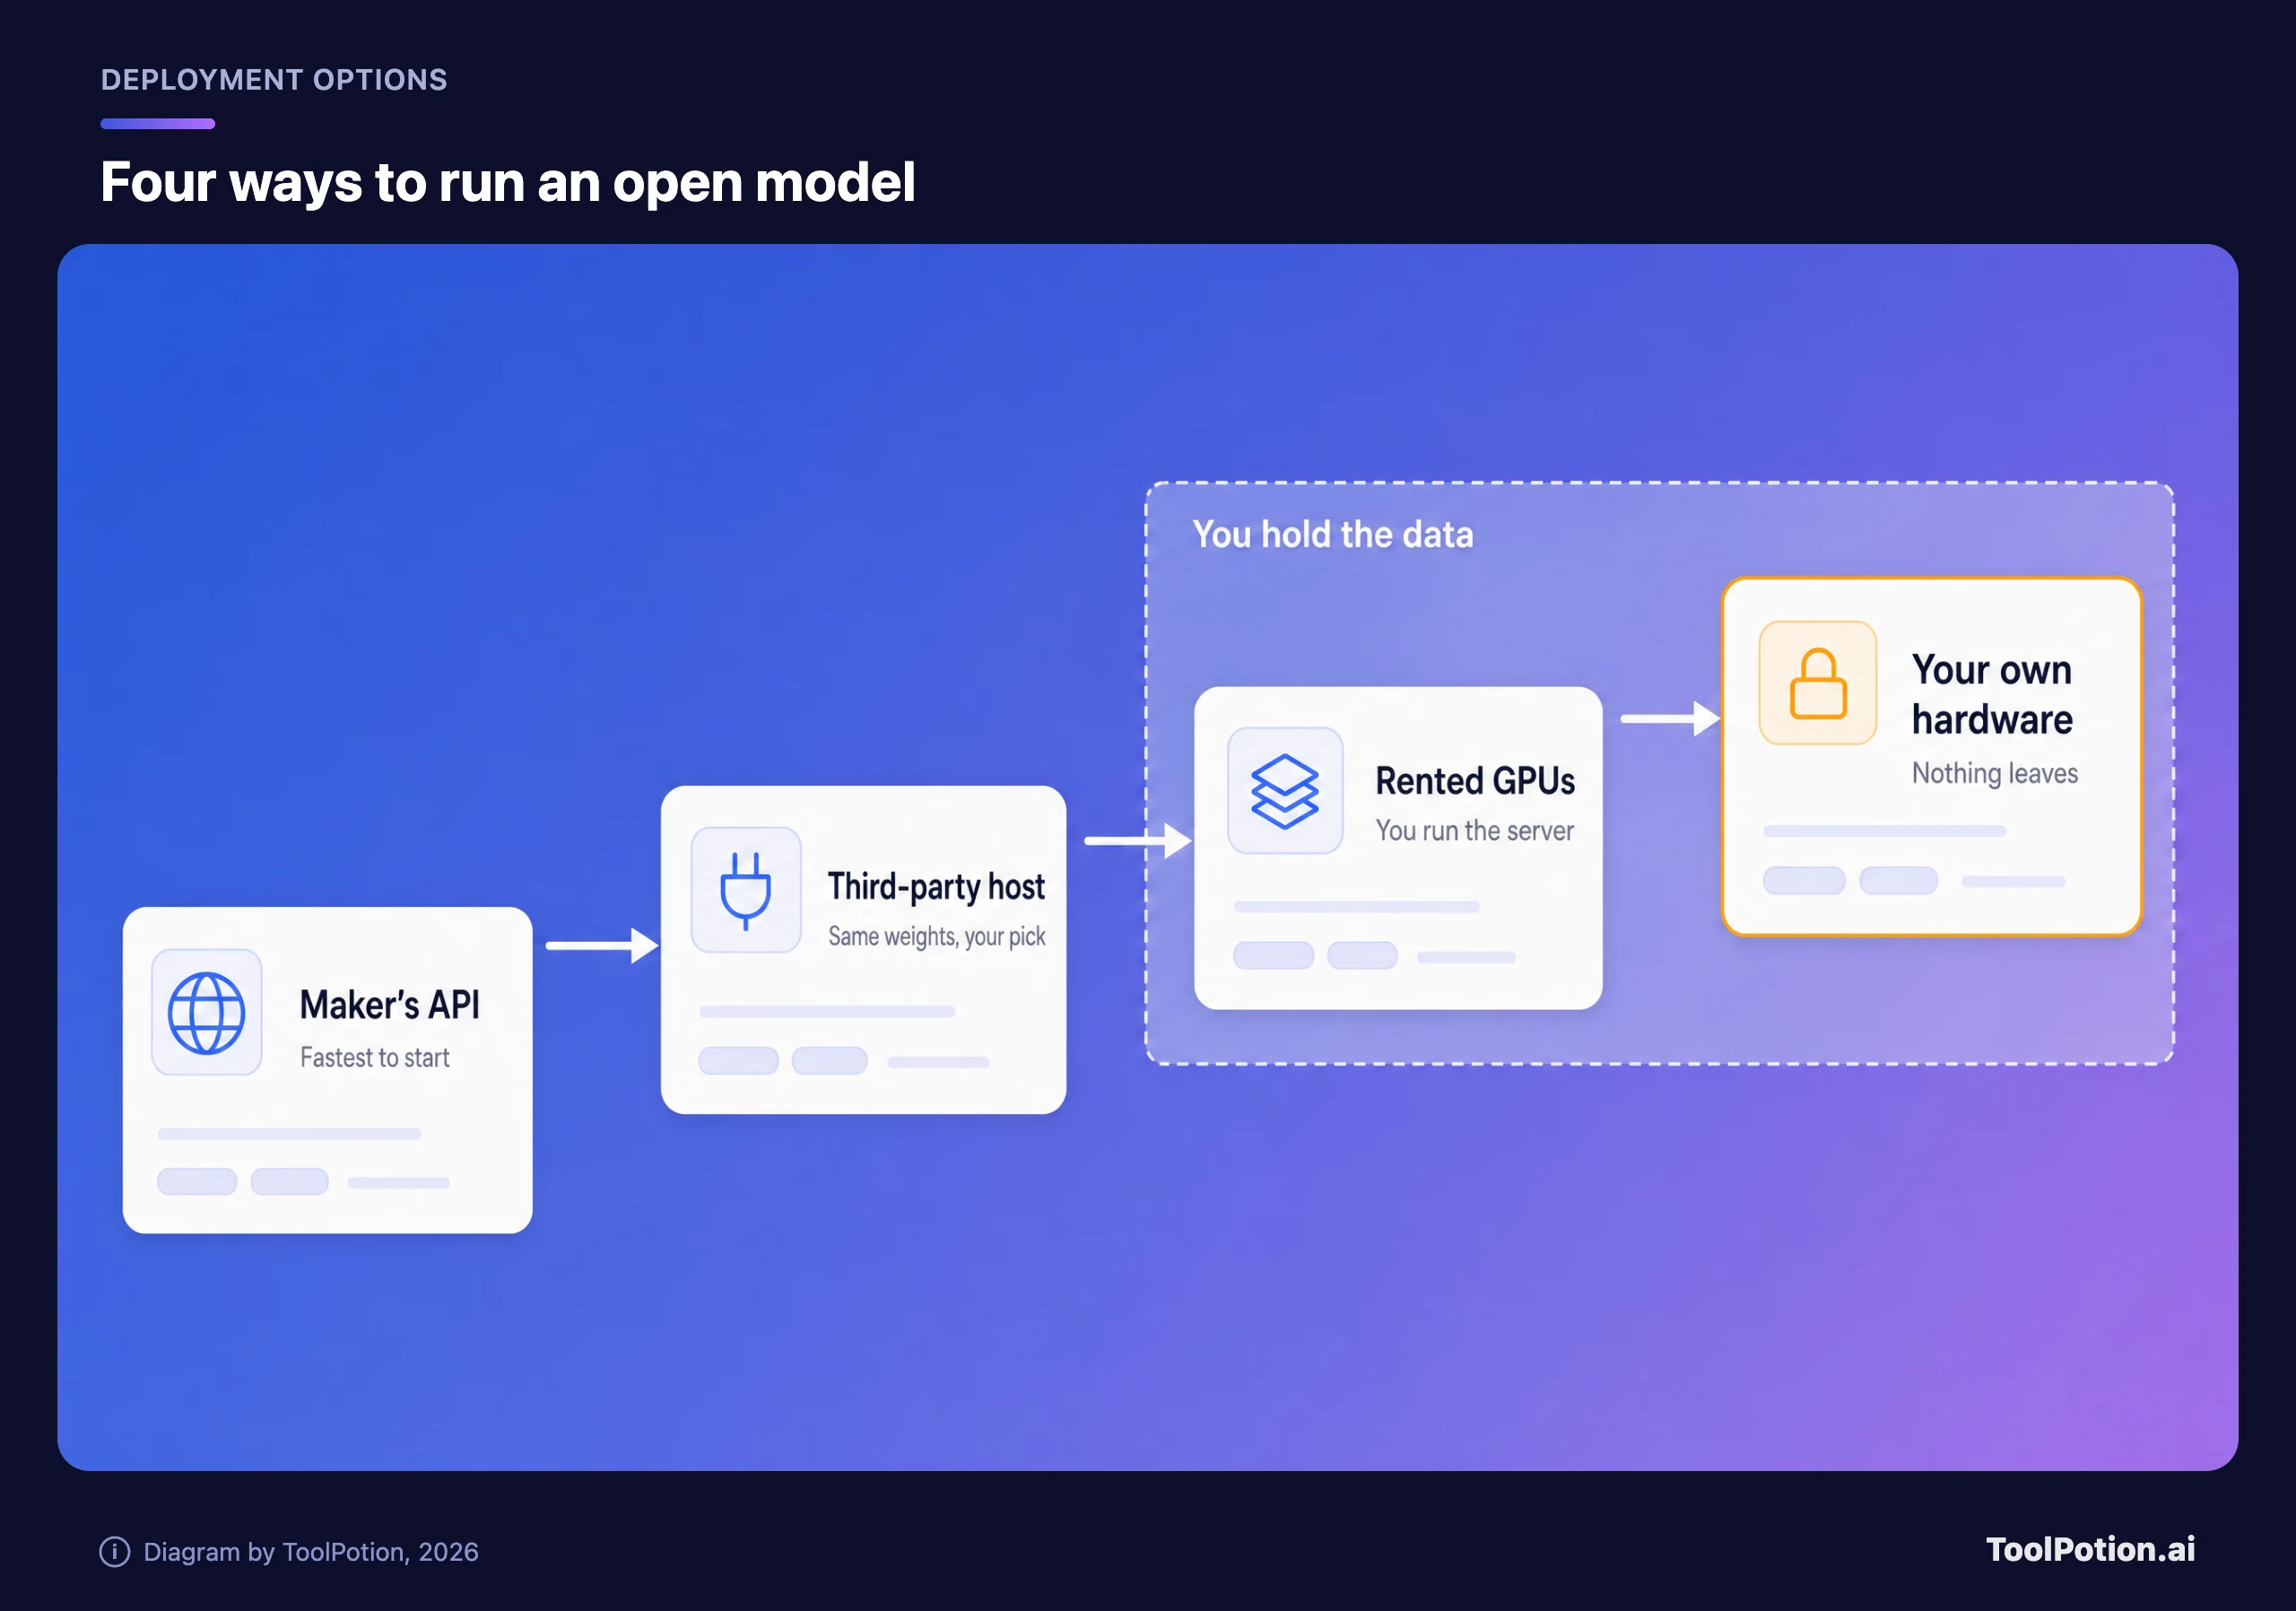
最初の2つはマネージド型です。メーカーまたはホストにトークンを送り、データは他者のネットワークを通ります。後ろの2つは、モデルを自分で管理するマシン上に置く方法で、契約や規制でデータを外に出せない場合はこちらが目的になります。自前のハードウェアに収まらないウェイトが最大の障害になりがちなので、まずサイズから確認しましょう。
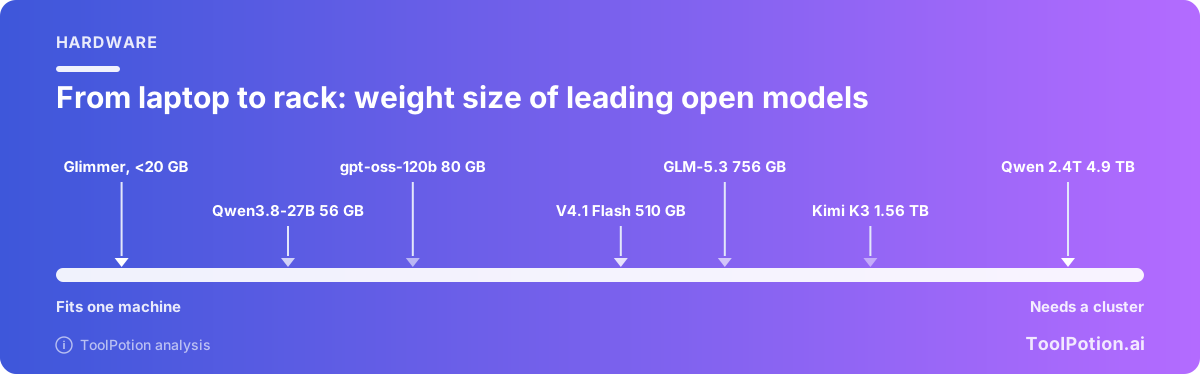
話題の大型モデルの多くは、1台のマシンに収まるサイズではありません。Kimi K3はウェイトだけで1.56 TBあり、180 GBのB200を8枚積んだノードの合計1.44 TBを超えます。DeepSeek V4-ProとGLM-5.3も、それぞれ数百GBが必要です。1台に収まるのは、20B〜120Bクラスのモデルです。見積もりツールで、モデルと精度をお手持ちのハードウェアに照らして確認してください。
まずはデフォルト設定を試してください。gpt-oss-120bを4ビットで動かすと、オーバーヘッド込みで約70 GBが必要なので、80 GBのGPU1枚に収まります。Kimi K3に切り替えると、同じ見積もりツールは180 GBのGPUを10枚要求します。10枚ということは、8GPUノードが2台です。LambdaのB200が料金ページ記載のオンデマンド価格で1時間あたり$6.69なら、この16枚を丸1か月動かすと約$78,000です。フロンティア級のオープンモデルを自前でホストする費用は、運用する人員を確保する前の段階でこれだけかかります。
小型モデルなら、ずっと優しい金額です。Lambdaは80 GBのGPUを1時間$3.99から提供しており、24時間稼働させて月約$2,900です。APIより得になるかどうかは、完全に利用量次第です。
月3億出力トークンでAPI価格が$10なら、両者の請求額はほぼ同じになります。それ以下ならAPIが有利、それ以上ならレンタルが有利です。ただしGPUが常に稼働していて、モデルが用途に十分な性能であることが条件です。もっとも、本当に比べるべき相手は安価なホストです。gpt-oss-120bの掲載ホスト価格、100万出力トークンあたり約$0.17で計算すると、$2,900で約170億出力トークンを買えるので、コストだけで見れば、GPUを1枚借りてホストに勝てることはまずありません。借りる理由は、プライバシー、コントロール、予測しやすいレイテンシです。小型モデルでコストを抑えるために借りるのはやめましょう。
ここで、数字は仮のものですが現実的な利用量で試算してみます。サポートチームが1日2万件のチケットを要約し、1件あたり入力1,500トークン、出力300トークンだとします。月間で入力約9億、出力約1.8億トークンです。Claude Sonnet 5.5(100万トークンあたり$2と$10)なら$3,600。DeepSeek V4.1 Flashのピーク料金で最大$486、オフピークならその半額です。gpt-oss-120bの掲載ホスト価格なら約$64。80 GBのGPUを1枚借りると、送るトークン量にかかわらず$2,913です。安価なホストが大差で勝ち、クローズドモデルはメーカー自身の価格で比べても、オープンモデルの約7倍かかります。
費用をかける前に使える近道が2つあります。ノートPCやワークステーションなら、Ollamaやllama.cppで、Gemma 4、Qwen3.8-27B、Muse Glimmerの量子化ビルドをコマンド1つで動かせます。本番サーバーなら、Kimi K3とQwen3.8のモデルカードがどちらも対応を明記している推論エンジンがvLLMです。
選び方
出発点はリーダーボードではなく、自分の制約です。3つの質問で、たいていのケースは振り分けられます。
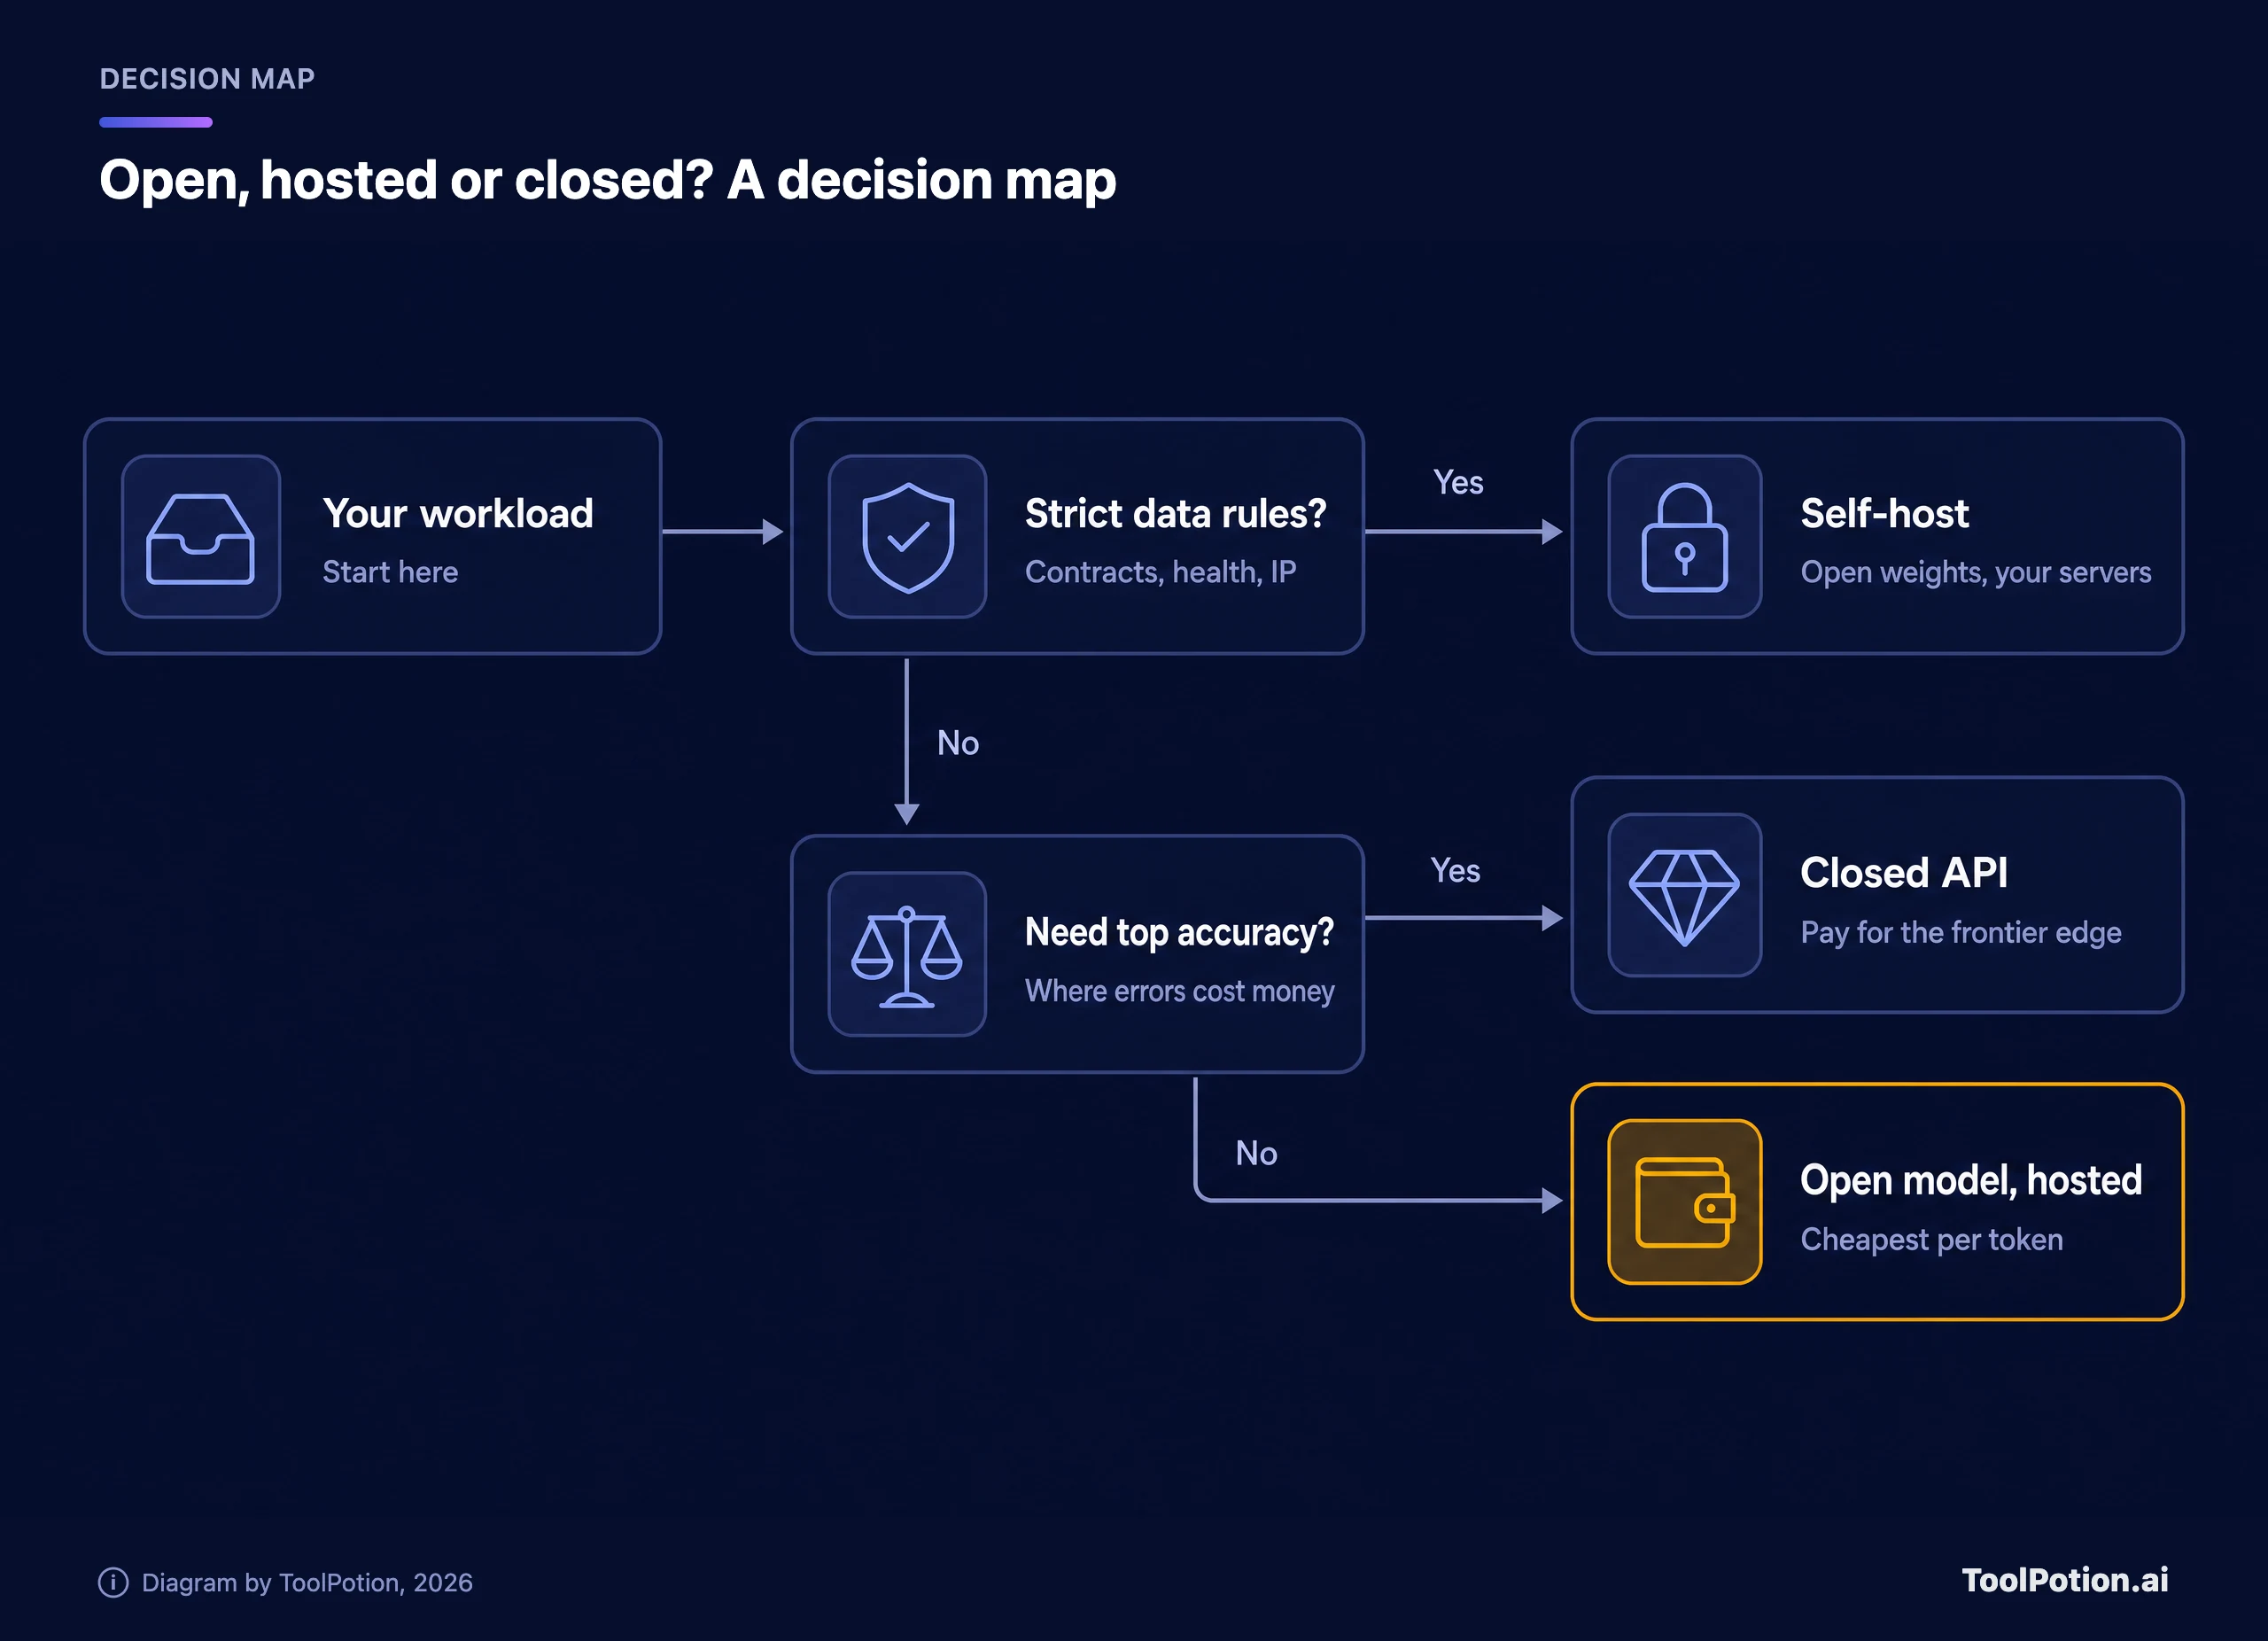
データを自分の管理下から出せないなら、自前でホストするしかなく、モデルは手持ちのハードウェアに収まる必要があります。その制約の下では次のとおりです。
- GPU1枚またはワークステーション:コーディングとエージェント用途ならQwen3.8-27B。欧米製モデルがよければgpt-oss-120b。ノートPCならMuse GlimmerかGemma 4。
- マルチGPUサーバー:大型カードを8枚と数百GB規模のウェイトを用意できるなら、DeepSeek V4.1 FlashかGLM-5.3。
- クラスター:Kimi K3かQwen3.8-2.4T。ただし、推論運用を本業とするチームがいる場合に限ります。
データを外に出せるなら、ミスのコストが高いかどうかを考えましょう。高い場合(法務の文書、財務分析、レビューなしでリリースするコード)は、クローズドのフロンティアモデルにお金を払い、自分の事例で検証してください。高くない場合(要約、タグ付け、情報抽出、社内検索、コードの初稿)は、安いホスト経由のオープンモデルが最安の選択肢です。
選ぶ前に、この順番で確認してください。
1. 動かせない制約を書き出す:データの所在、月の予算、品質の下限のいずれか。
2. 自分の用途でライセンスを確認する。モデルを使った製品を作るだけなら、ほぼどこでも問題ありません。条件が付くのはモデル自体の再販です。
3. メモリを確認する:ウェイトのGB数を、実際に購入またはレンタルするハードウェアと照らし合わせる。
4. 同じワークロードを、メーカーAPI、サードパーティのホスト、レンタルGPUで見積もる。
5. 自分のタスク50件を2〜3候補に通し、勝ったものを残す。
決める前にテストしてください。ここで挙げたベンチマークはベンダー自身が出したもので、異なるスイートで実行されているため、あるリーダーボードの90点は、別のリーダーボードの88点について何も教えてくれません。実際のワークロードから50件のタスクを取り出し、2〜3候補に通して結果を採点しましょう。その午後の作業は、1週間モデルカードを読むより価値があります。
モデルカードには載らないリスク
セキュリティ。 オープンウェイトだからといって、モデルが安全になるわけではありません。米国政府のNISTは、2025年に旧世代のDeepSeekモデルを評価し、その中で最良だったR1-0528でも、一般的なジェイルブレイクの下で明らかに悪意のあるリクエストの94%に応じたと報告しています。米国の参照モデルでは8%でした。また、DeepSeekのエージェントは、扱うコンテンツに仕込まれた悪意ある指示に従う確率が12倍高いという結果でした(NIST CAISI)。これは現行のV4系より前のモデルであり、現行リリースについて同等の公的評価は、本記事の情報源からは見つかりませんでした。だからこそテストすべきだと考えてください。特に、モデルにツールや書き込み権限を与える前には欠かせません。
検閲。 NISTはまた、DeepSeekモデルが、米国の参照モデルの4倍の頻度で、不正確な中国共産党の主張をそのまま繰り返すことも確認しました。Kimi K2 Thinkingに関する別のNISTレポートでは、中国語では強い検閲が見られた一方、英語、スペイン語、アラビア語では比較的検閲が少なかったとされています。ユーザーが中国語で政治や歴史について尋ねるなら、直接テストしてください。コードや表計算が中心なら、ほとんど問題になりません。
データの所在。 誰がモデルをホストするかで、データの行き先が決まります。DeepSeekのプライバシーポリシーには、個人データを中華人民共和国内で収集、処理、保存すると書かれています(DeepSeekプライバシーポリシー)。これはDeepSeek自身のアプリとAPIに当てはまる話で、他所で動かすMITライセンスのウェイトには当てはまりません。Mistralは逆の訴求をしています。Large 4はヨーロッパにある自社データセンターで学習し、プレビューも欧州法の下での欧州デプロイとして運用していると説明しています。どのホストでも、顧客データを送る前に、推論がどこで動くのか、何がログに残るのかを確認してください。
陳腐化。 オープンモデルは数か月で古くなります。gpt-ossのウェイトは1年前のもので、Metaの最新Llamaは2025年のものです。一方、QwenとDeepSeekは2026年だけで複数のバージョンを出しています。テストしたモデルのバージョンを正確に固定し、アップグレードの際は再テストしてください。
それでもクローズドAPIに払うべき人
3%という差は、1つのベンチマークの読み取り値です。最上位ではいまもクローズドモデルがリードしており、それを売るラボは、オープンウェイトには付いてこないツールやマネージド機能を追加し続けています。
難しく、失敗が許されない仕事で最高の精度が必要な場合、インフラを運用できる人がいない場合、あるいは量が少なくてどんなホスティングの工夫も意味をなさない場合は、ClaudeやChatGPTにお金を払いましょう。1日数千回の呼び出し程度のチームなら、トークンで節約できる額より、エンジニアの工数のほうが大きくなります。稼働率、セキュリティ、サポートについて、1社に責任を持ってほしい場合も、有料が向いています。
切り替えるのではなく、併用しましょう。よくある構成は、日常的な大部分の処理をホスト経由のオープンモデルに回し、難しいケースだけクローズドモデルにエスカレーションするものです。モデルのティアをタスクに合わせるガイドのルーティングルールがそのまま使えます。基本は安いモデルから始め、失敗したら上位に回すことです。
よくある質問
オープンウェイトとオープンソースの違いは?
オープンウェイトは、学習済みモデルをダウンロードできるという意味です。厳密な意味でのオープンソースは、承認されたライセンスの下で、学習データとコードも含みます。このリストの中で、その基準を満たすものはほぼありません。実用上これに最も近いのは、Apache 2.0とMITのモデルです。KimiやQwenのようなカスタムライセンスは、さらに条件が加わります。
商用利用はできますか?
ここで取り上げたどのライセンスでも、モデルを使って製品を作る分には可能です。条件が効いてくるのは、モデルそのものをサービスとして販売する場合と、一部では製品の規模が非常に大きい場合です。Apache 2.0とMITのモデルには、売上に関する条件は一切ありません。
コーディングに最適なオープンモデルは?
ベンダーが報告する数字では、GLM-5.3、Kimi K3、DeepSeek V4.1 Flashがリードしていますが、3つともサーバー級のハードウェアが必要です。1台のマシンで動かすなら、Qwen3.8-27Bが現実的な選択です。ベンチマークのスイートは異なるので、自分のコードベースで自分でテストしてください。
会社のデータにDeepSeekを使っても安全ですか?
動かし方次第です。DeepSeekのアプリとAPIは、上記のポリシーに従って中国にデータを保存します。MITのウェイトを自前のサーバーか信頼できるホストで動かす場合は、DeepSeekには何も送られません。ただし、NISTの旧世代評価で示されたモデルの挙動に関するリスクは、別途残ります。
GPUメモリはどれくらい必要ですか?
おおよそ、パラメータ数×ビット数÷8に、キャッシュとランタイム用の約20%を加えた量です。27Bモデルを8ビットで動かすと、オーバーヘッド込みで約33 GB。117Bモデルを4ビットなら約70 GBです。上の見積もりツールが計算してくれます。
Mistral Large 4はいつオープンになりますか?
Mistralは発表の直後にウェイトを公開すると約束していますが、ライセンス条件はまだ公開していません。計画に組み込む前に、Hugging Faceのページを確認してください。