

Apple mengklaim iMac baru dengan M6 menghadirkan performa AI on-device hingga 12x lebih cepat untuk pemrosesan prompt di LM Studio dibandingkan iMac dengan M1, dan hingga 5x lebih cepat dibandingkan M4. Dua detail dalam kalimat itu menentukan apakah Anda perlu peduli. Pembandingnya adalah perangkat keras lama, dan yang diukur adalah seberapa cepat model membaca prompt Anda, bukan seberapa cepat model menulis jawabannya.
Kami membaca dua pengumuman M6 dari Apple, spesifikasi teknis, dan halaman tokonya. Pendapat kami: M6 adalah chip yang bagus dengan harga yang wajar, tetapi untuk AI lokal, ini bukan tempat yang tepat untuk mengeluarkan uang lebih. Spesifikasi yang paling penting adalah memori, dan M6 maksimal hanya 32GB.
Apa yang sebenarnya dirilis Apple
Hanya dua mesin yang mendapat M6. MacBook Pro 14 inci dengan M6 dibanderol mulai $1.999 di AS, dan iMac dengan M6 mulai dari $1.499 (10-core) atau $1.699 (12-core). Keduanya memiliki dual Neural Engine 16-core dan Neural Accelerator di setiap core GPU. Apple menyebut beban kerja AI pada GPU laptop ini hingga 25 persen lebih cepat dibanding M5, dan Neural Engine-nya hingga 1,9x lebih cepat.
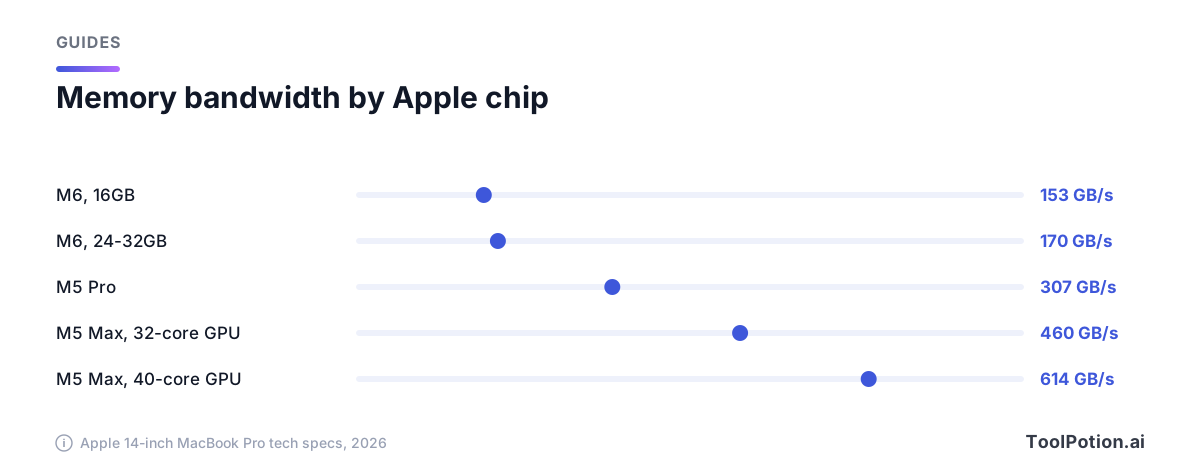
Laptop ini dibekali memori terpadu 16GB sebagai standar, bisa dikonfigurasi hingga 32GB, dengan bandwidth 153GB/s pada 16GB dan 170GB/s pada 24GB atau 32GB, menurut spesifikasi teknis Apple. iMac juga tercantum dengan bandwidth hingga 170GB/s; pengumuman iMac dari Apple tidak menyebutkan memori maksimum, jadi kami tidak mencantumkannya.
Shelly Goldberg, vice president Hardware Engineering Apple, dikutip dalam pengumuman yang menjanjikan "kemampuan yang lebih canggih lagi untuk AI on-device." Itu wajar saja. Namun itu kalimat tentang kemampuan, dan kemampuan yang paling penting bagi pengguna model lokal, yaitu memori, justru dibiarkan Apple di angka 32GB.
Soal harga, ceritanya lebih baik daripada soal performa. Kedua mesin dibanderol sama dengan model yang digantikannya, yang menurut 9to5Mac terjadi setelah kenaikan harga awal tahun ini yang membuat iMac naik dari $1.299 ke $1.499 dan MacBook Pro dari $1.699 ke $1.999. Kesimpulan situs itu: Mac bertenaga M6 yang baru "jauh dari murah" tetapi tidak mengalami kenaikan lagi.
MacBook Pro baru lainnya, yang memakai layar sentuh OLED, sama sekali tidak memakai M6. Laptop ini menggunakan M5 Pro dan M5 Max, dengan memori terpadu hingga 128GB pada Max (64GB pada Pro), mulai dari $2.899 di AS. Kalau AI lokal alasan Anda berbelanja, inilah mesin yang diarahkan Apple. Siaran pers Apple menyebut dengan M5 Max, para profesional bisa "menjalankan LLM dengan ratusan miliar parameter sepenuhnya di perangkat."
Dua jenis AI on-device, dan hanya satu yang butuh campur tangan Anda
Apple Intelligence menjalankan model kecil di Mac untuk alat bantu menulis, dikte, edit foto, dan sejenisnya, lalu mengirim permintaan yang lebih berat ke Private Cloud Compute, sistem server Apple. Pernyataan privasi Apple berbunyi, "Apple Intelligence mengetahui informasi pribadi Anda tanpa mengumpulkan informasi pribadi Anda." Anda tidak perlu memilih model atau mengatur memori. Syarat masuknya adalah Mac apa pun dengan M3 atau lebih baru dan memori terpadu minimal 12GB, jadi M6 menambah kecepatan, bukan akses. Tulisan kami tentang Siri AI dan posisi Gemini membahas sisi cloud-nya.
Apple juga memungkinkan aplikasi apa pun memanggil model on-device tersebut lewat framework Foundation Models, yang menurut Apple bekerja offline tanpa biaya per permintaan. Itulah alasan tersembunyi mengapa Mac dengan memori lebih besar makin berguna seiring waktu.
Jenis kedua adalah yang menjadi sasaran benchmark tadi: mengunduh model open dan menjalankannya sendiri di LM Studio (posting iMac Apple juga menyebut LM Studio Bionic di antara aplikasi yang dioptimalkan untuk Apple silicon) atau Ollama. Tidak ada data yang keluar dari mesin, tidak ada biaya per pemakaian, dan tidak ada yang sebagus model cloud terbesar. Model open mana yang layak memakan ruang disk adalah pertanyaan lain yang kami bahas di rangkuman model open-weight kami.
Memori menentukan apa yang bisa jalan, jadi baca baris itu lebih dulu
Model harus berada di memori agar bisa berjalan, dan di Mac, CPU dan GPU berbagi satu pool yang sama. README Ollama versi lama menyarankan aturan praktis: minimal RAM 8GB untuk model 7B, 16GB untuk model 13B, dan 32GB untuk model 33B. (Kalimat itu berasal dari rilis lama yang bertag dan tidak ada di README saat ini, jadi anggap sebagai batas bawah kasar dari sejarah tool tersebut, bukan jaminan.) Persyaratan sistem LM Studio menyebut 16GB atau lebih direkomendasikan, dan Mac 8GB sebaiknya memakai model yang lebih kecil dengan ukuran konteks yang sederhana.
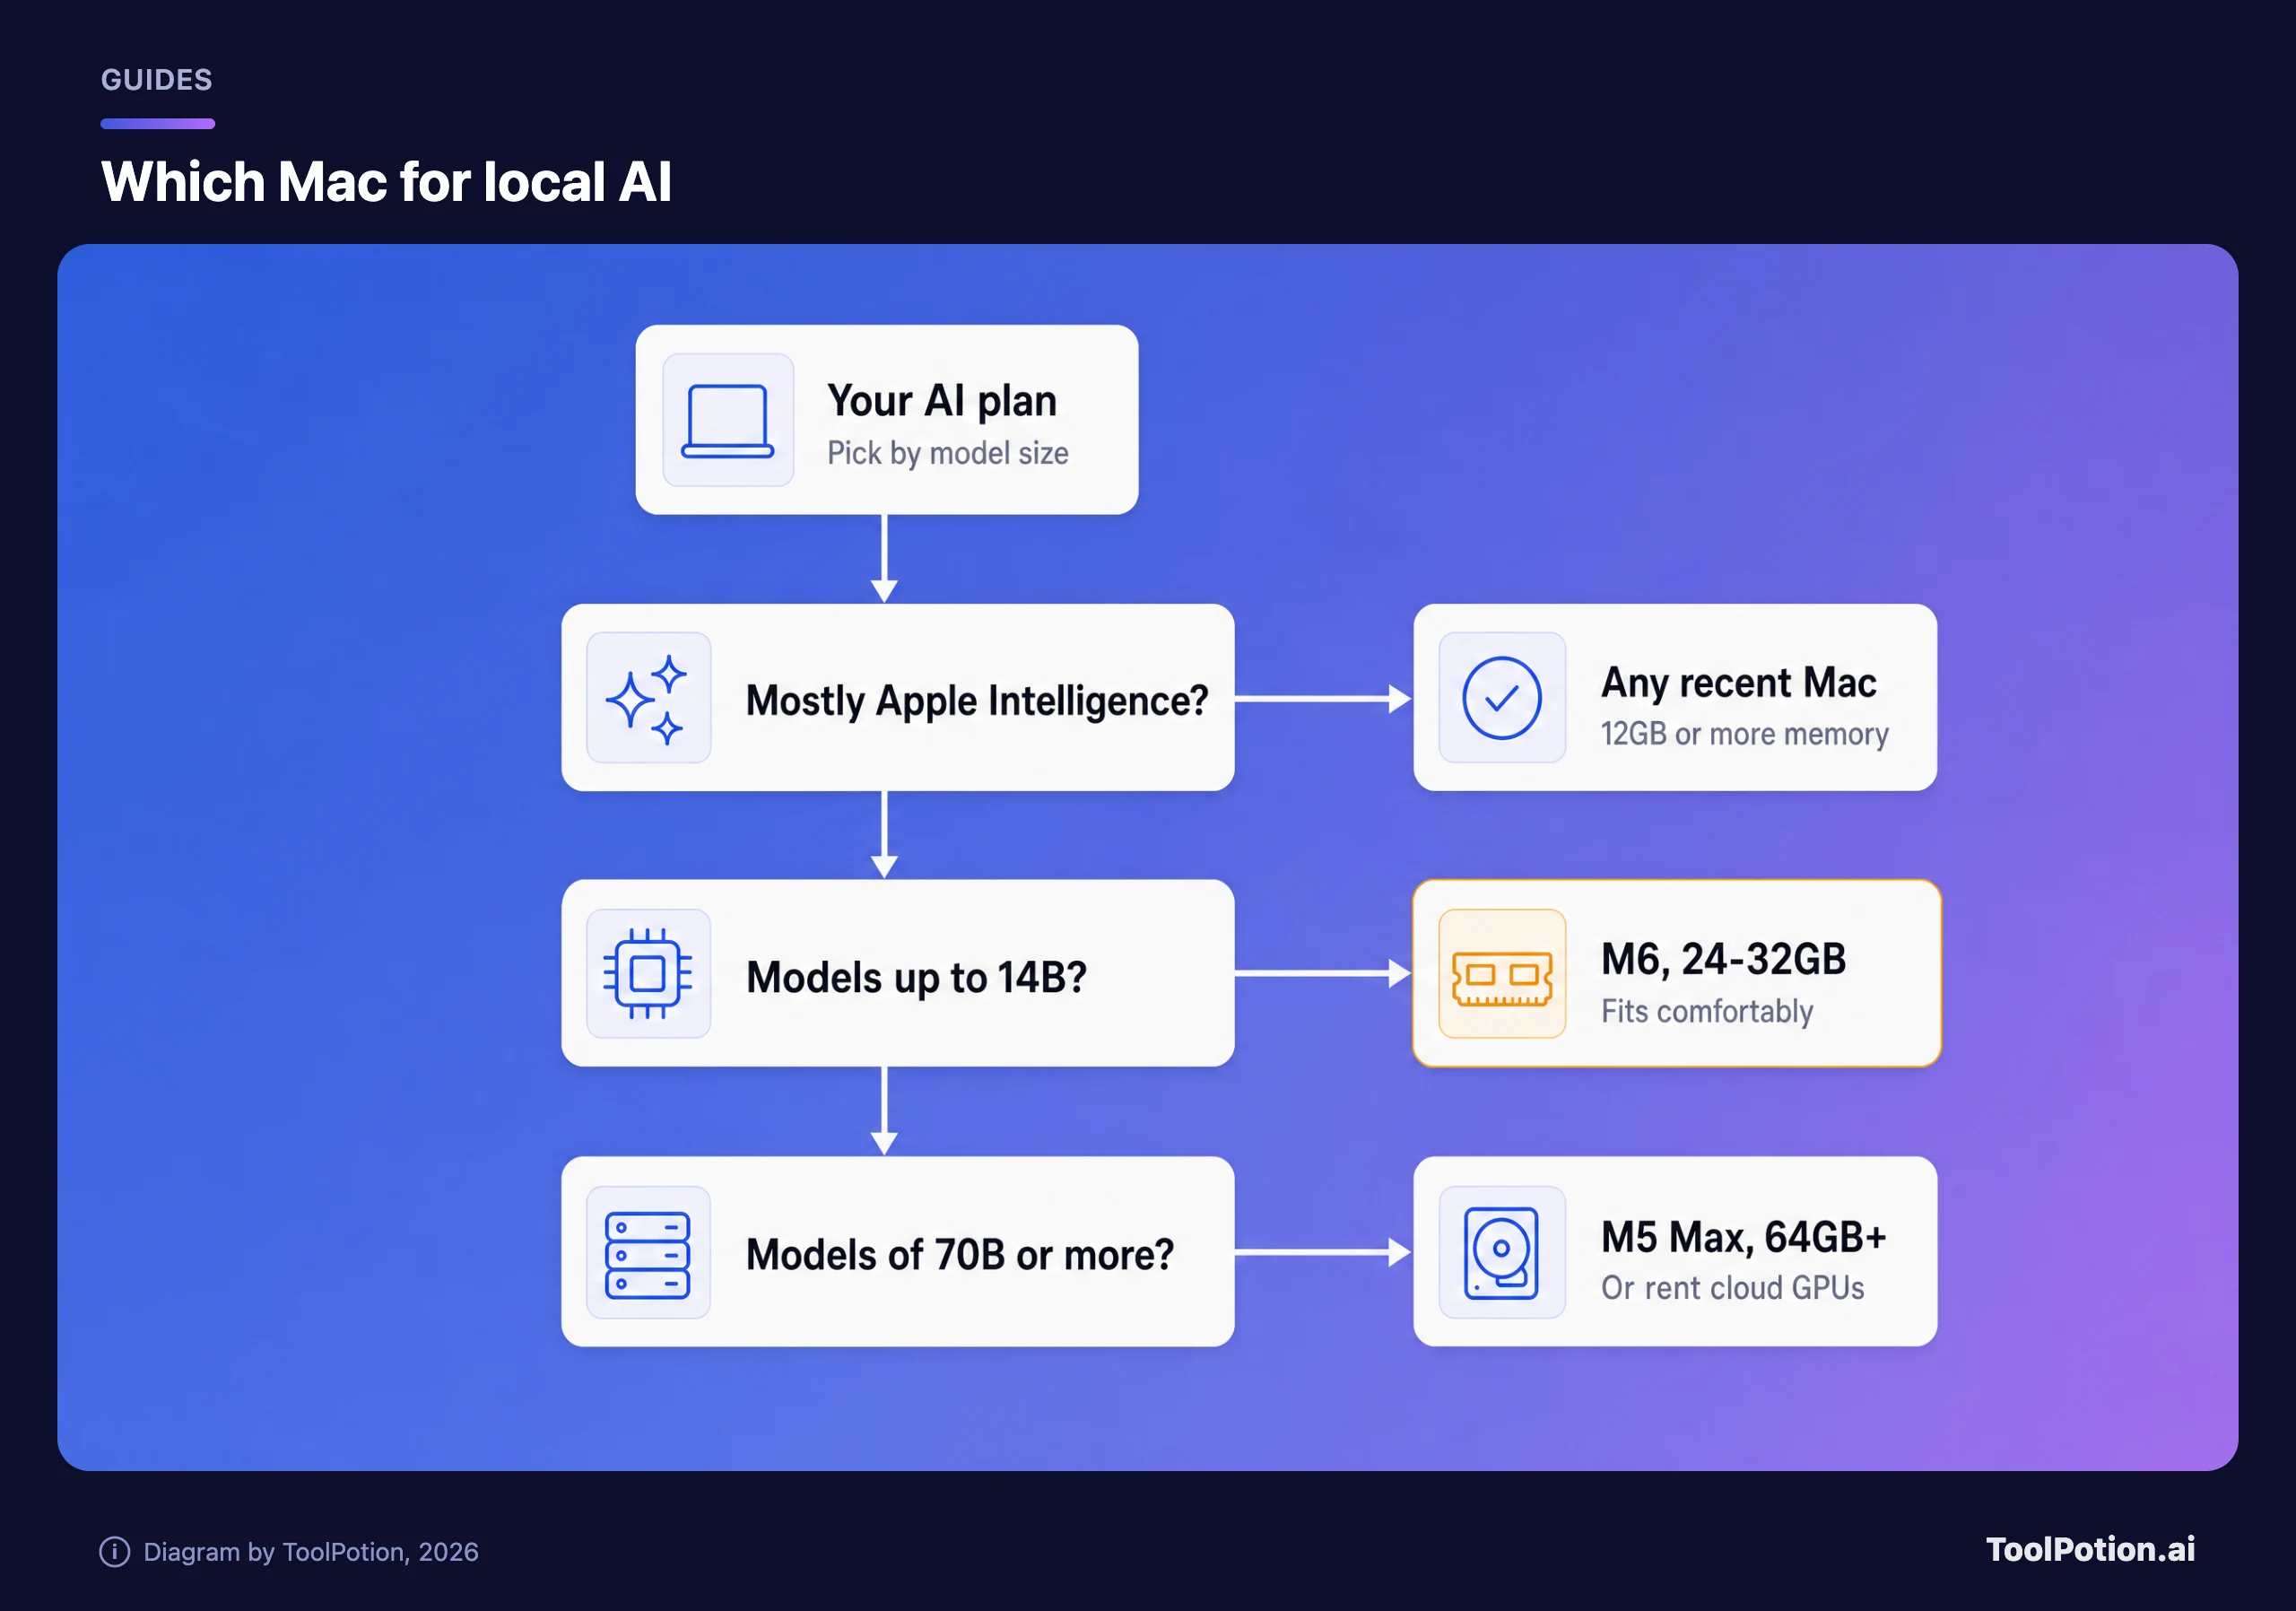
Sekarang lihat model besar yang sungguhan. FAQ Ollama menampilkan ollama ps yang mencantumkan llama3:70b sebesar 42 GB. Menurut inferensi kami dari ukuran model itu, ia tidak akan muat di Mac 32GB, apa pun chip-nya; model ini butuh 64GB, yang berarti M5 Pro atau M5 Max, bukan M6.
Kecepatan adalah batas yang berbeda. Klaim AI Apple untuk M6 berkaitan dengan pemrosesan prompt, seperti time to first token hingga 1,3x lebih cepat dibanding M5 pada pengujian laptop yang dicantumkan di catatan kaki. Itu angka dari Apple, dijalankan pada konfigurasi Apple. Menurut penalaran kami, bandwidth memori adalah hal yang perlu diperhatikan untuk bagian penulisan jawaban, dan M6 berada di baris terbawah pada grafik di atas.
Siapa yang sebaiknya membayar untuk 32GB, dan siapa yang tidak
Beli M6 dengan 24GB atau 32GB jika Anda ingin menjalankan model sekitar 7B hingga 14B untuk menyusun draf, merangkum dokumen pribadi, atau membantu coding, dan Anda lebih suka memiliki laptop senyap dengan baterai awet daripada menyewa GPU. Untuk keperluan itu, tambahan memori adalah uang yang paling berguna di konfigurator. Kami akan melewatkan memori 16GB pada model dasar $1.999 untuk penggunaan ini. Model kecil memang bisa jalan, tetapi Anda harus menutup aplikasi lain demi memberi ruang.
Jangan beli M6 untuk model kelas 70B, dan jangan berharap lonjakan dramatis dibanding chip tahun lalu pada hal-hal yang Anda jalankan sehari-hari. Kalau itu tujuannya, hitung harga M5 Pro atau Max, lalu hitung juga alternatifnya, karena MacRumors melaporkan Mac Studio dengan memori 512GB dibanderol mulai $22.299 di AS. Pada titik itu, tagihan layanan cloud yang Anda pakai beberapa jam seminggu terlihat kecil. Perbandingan kami tentang AI lokal vs cloud menguraikan di mana titik impasnya, dan mencocokkan tingkat model dengan tugas membantu jika sebagian besar pekerjaan Anda memang tidak membutuhkan model frontier.
Alasan untuk tetap memakai Mac lama Anda
Peningkatan utama yang digembar-gemborkan Apple sebagian besar dibandingkan dengan M1. Dibandingkan M5, pemrosesan prompt laptop ini hingga 1,3x lebih cepat, yang terasa di benchmark tetapi nyaris tidak terasa saat chat. Kalau Anda punya Mac M4 atau M5 dengan memori 24GB atau lebih, kami sarankan tetap dipakai dan simpan uangnya untuk memori lebih besar di pembelian berikutnya. Kalau Anda punya M1 dengan 8GB, peningkatannya memang nyata, tetapi seri M bekas atau refurbished dengan 32GB bisa menjalankan model yang sama dengan harga di bawah $1.999. Mac baru ini punya radio Wi-Fi 7 dan baterai yang lebih baik. Tak satu pun dari keduanya menjalankan model.
Satu pertanyaan yang masih terbuka: Apple belum menyebutkan seberapa besar dari peningkatan GPU 25 persen itu yang terlihat pada pembuatan token, dan tidak ada liputan yang kami baca yang bisa menjawabnya. Angka independen dari LM Studio dan Ollama seharusnya muncul setelah mesinnya sampai ke tangan pelanggan.
Pertanyaan yang sering diajukan
Apakah Apple Intelligence membutuhkan M6?
Tidak. Apple mencantumkan model Mac dengan M3 atau lebih baru dan memori terpadu minimal 12GB. M6 membuatnya lebih cepat, bukan membuatnya tersedia.
Apakah 16GB cukup untuk menjalankan model AI lokal?
Untuk model kecil dengan konteks sederhana, cukup. LM Studio merekomendasikan 16GB atau lebih, dan README Ollama versi lama menyarankan 16GB untuk model 13B. Ruang tersisa untuk aplikasi lain akan sedikit.
Haruskah saya menunggu benchmark pihak ketiga?
Kalau Anda membeli khusus untuk AI lokal, ya. Pengujian Apple membandingkan dengan M1 dan M5 pada konfigurasinya sendiri, dan yang diukur adalah pemrosesan prompt.