

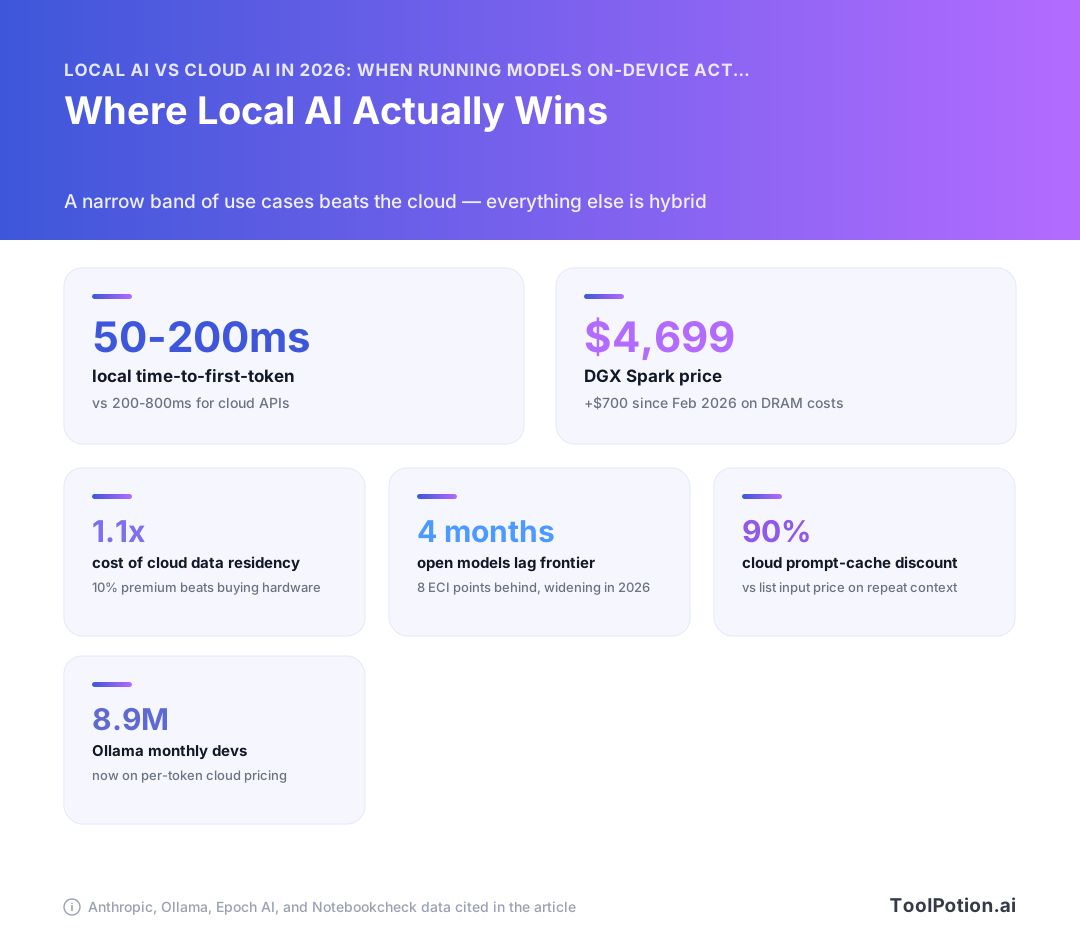
Beli GPU hanya jika kamu akan memakainya terus-menerus. Itulah jawaban singkat soal AI lokal vs AI cloud di 2026: di atas sekitar 26% utilisasi harian yang berkelanjutan, rig lokal mengalahkan bayar per token. Di bawah itu, kamu membiayai silikon yang menganggur dengan harga memori 2026 yang tidak ramah: NVIDIA menaikkan DGX Spark dari $3.999 menjadi $4.699 pada Februari 2026, dengan alasan biaya DRAM dan penyimpanan yang melambung (Notebookcheck).
Sementara itu, sisi cloud justru makin murah dengan cara yang sering luput dari perbandingan. Cache prompt dikenakan 0,1x harga input, dan diskon Batch 50% bisa ditumpuk di atasnya, sehingga Claude Haiku 4.5 turun menjadi $0,50 input / $2,50 output per juta token (Anthropic).
Berikut gambaran perhitungannya, apa yang bisa dijalankan dengan 24GB, dan di mana garis batas itu jatuh untuk kamu.
AI lokal vs AI cloud: panduan 2026 gagal di empat titik
Perhitungan titik impas yang pernah kamu baca salah, dan bukan sekadar salah pembulatan. Salah karena hardware makin mahal, statistik kemampuan salah dibaca, tooling berganti pihak, dan daftar harga cloud diam-diam turun di bawah spreadsheet semua orang.
Tiga asumsi yang masih dipakai setiap perbandingan
Hampir setiap panduan lokal-vs-cloud di halaman pertama hasil pencarian bersandar pada tiga klaim yang sama, semuanya bertanggal 2024. Pertama: hardware adalah biaya tetap yang terus turun, jadi kamu menyusutkan GPU $1.999 selama 18 bulan dan membandingkannya dengan pengeluaran per token. Kedua: model open-weight tertinggal tiga hingga enam bulan dari model frontier tertutup, sehingga apa pun yang kamu jalankan di rumah selalu beberapa kuartal di belakang. Ketiga: "lokal" berarti Ollama di mesinmu dan "cloud" berarti frontier API, pertarungan dua arah yang bersih.
Ketiganya masuk akal di 2024. Tidak satu pun yang bertahan menghadapi kenyataan 2026.
Apa yang berubah sejak 2024 hingga sekarang
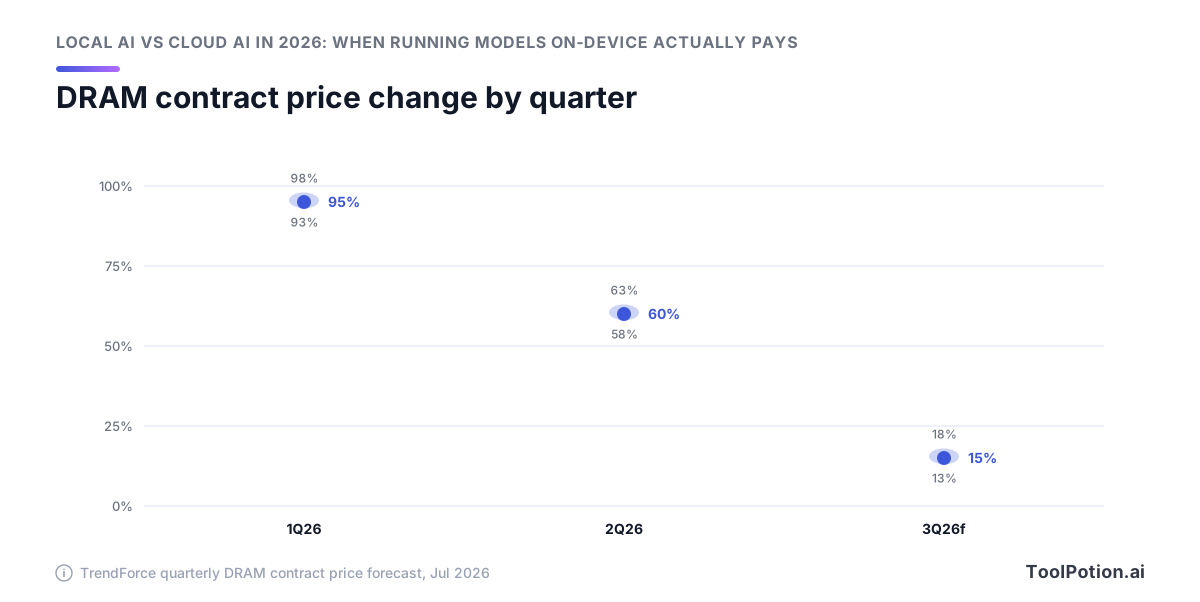
Mulai dari lantai harga hardware, karena ia bergerak ke arah yang salah. NVIDIA menaikkan DGX Spark dari $3.999 menjadi $4.699 pada Februari 2026, kenaikan $700 yang dikaitkan dengan melonjaknya biaya DRAM dan penyimpanan. Harga kontrak DRAM konvensional naik sekitar 93–98% quarter-over-quarter di 1Q26 dan masih merangkak 13–18% di 3Q26. Setiap kalkulator yang mengutip MSRP meremehkan CapEx kamu hingga ribuan dolar.
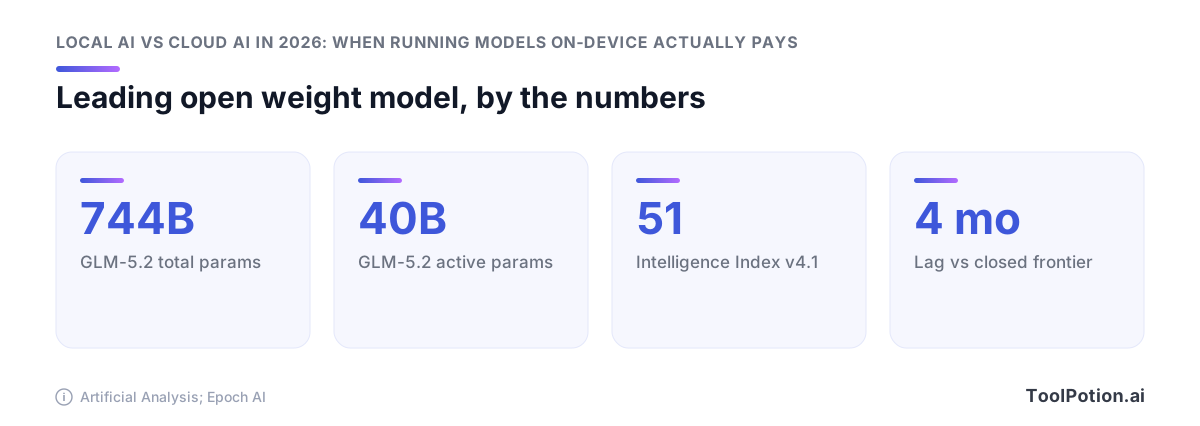
Kemudian soal kesenjangan kemampuan. Epoch AI menetapkan lag pada 4 bulan, atau 8 poin ECI sejak Januari 2026, lebih lebar dari rata-rata 3 bulan yang diukurnya dari Januari 2023 hingga Oktober 2025. Bagian yang tidak pernah dikutip: model yang membawa klaim itu, GLM-5.2, memiliki 744B parameter total dan 40B parameter aktif. Itu butuh rak server, bukan laptop.
Perubahan ketiga yang paling mengejutkan. Pada 31 Agustus 2026, Ollama memindahkan paket Pro, Max, dan Team ke harga cloud per token di $20, $100, dan $500 per bulan. Alat "jalankan lokal" yang jadi pilihan utama kini menjual token, yang mengubah perbandingan menjadi perlombaan tiga arah antara GPU kamu, open weight yang di-hosting dengan murah, dan frontier API. Jika kamu sedang membandingkan pilihan di model AI yang kami pantau, jalur tengah itulah yang perlu dihitung harganya lebih dulu.
Dan sisi cloud makin murah dengan cara yang tidak dimodelkan kalkulator mana pun yang sudah diterbitkan: cache prompt dibaca dengan 0,1x harga input dasar, diskon Batch API 50% yang bisa ditumpuk, dan penguncian inferensi hanya di AS dengan pengganda 1,1x. Yang terakhir ini menjual properti residensi data yang dibeli orang dengan hardware, dengan premium 10% alih-alih $4.699.
Apa yang benar-benar bisa ditangani model lokal di 2026
Kartu 24GB di 2026 bisa menjalankan model mixture-of-experts 20–30B yang bagus, dan model itu akan membuat draf, meringkas, mengklasifikasi, dan bernalar melalui masalah terstruktur pada kualitas yang dianggap memadai oleh kebanyakan tim. Model itu juga akan dengan percaya diri mengarang fakta tentang apa pun yang berada di luar data pelatihannya. Dua kalimat itu adalah peta kemampuannya, dan kebanyakan panduan titik impas melewatkan kalimat kedua.
Batas atas hardware konsumen adalah kelas MoE 20–30B
gpt-oss-20b dan Qwen3-30B-A3B adalah batas praktis untuk satu GPU konsumen. Keduanya merupakan desain MoE sparse, sehingga jumlah parameter aktif tetap cukup kecil agar kartu 24GB dapat menampung bobotnya dan masih ada ruang tersisa untuk konteks. Di bawah itu terdapat model kelas dense Llama, Mistral, dan Phi di 7–14B, yang lebih nyaman masuk namun mengorbankan kemampuan. Daftar LLM open-weight kami condong kuat ke rentang ini, karena itulah yang bisa dijalankan orang di rumah.
Kuat dalam penalaran, lemah dalam pengetahuan dunia
Berikan dokumen ke model lokal 30B dan minta ia mengekstrak field, mengikuti skema, atau menjalankan rantai langkah, dan ia bertahan dengan baik. Tanya siapa yang mengakuisisi siapa di 2024, dan kamu akan mendapat fiksi yang meyakinkan.
Jumlah parameter itulah yang membeli fakta-fakta yang dihafal, dan model berukuran konsumen telah membuang sebagian besar parameter tersebut. Retrieval menutup celah itu: masukkan fakta ke dalam konteks dan biarkan model lokal mengerjakan bagian terstrukturnya. Apa pun yang membutuhkan recall luas tanpa lapisan retrieval di belakangnya sebaiknya dilimpahkan ke frontier API.
Mengapa judul "model open makin menyamai" itu merujuk hardware yang tidak kamu miliki
Epoch AI menetapkan kesenjangan di 4 bulan, atau 8 poin ECI, sejak Januari 2026, sedikit lebih lebar dari rata-rata 3 bulan yang diukurnya dari Januari 2023 hingga Oktober 2025 (Epoch AI). Angkanya valid dan tidak mengatakan apa-apa tentang laptop kamu. Model yang membawa mahkota open-weight, GLM-5.2, mencetak 51 pada Intelligence Index v4.1 milik Artificial Analysis dengan 744B parameter total dan 40B aktif (Artificial Analysis). Itu hardware datacenter. Pengukuran yang sama menunjukkan GLM-5.2 membakar 43.000 token output per tugas, 37.000 di antaranya token penalaran, yang berakhir pada sekitar $0,46 per tugas dibanding $0,18 untuk MiniMax-M3.
Apa yang hilang akibat kuantisasi
Q4_K_M menjadi pilihan default karena ada alasannya. Pada Mistral-7B-Instruct-v0.2 dengan llama.cpp di Apple M1 Pro, ia mengecilkan model dari 7,2 GB menjadi 4,1 GB — 43,1% lebih kecil — dengan kehilangan perplexity hanya 0,51% (dasroot). Q2_K adalah titik di mana kurva patah, dengan kehilangan perplexity 7,94%, dan kamu merasakannya dalam kemampuan mengikuti instruksi jauh sebelum terlihat di benchmark. Kuantisasi ke 4-bit, berhenti di situ, dan gunakan memori yang tersimpan untuk panjang konteks.
Lantai harga hardware bergerak, dan bergerak ke arah yang salah
Setiap kalkulator titik impas yang akan kamu temukan mengasumsikan kamu bisa membeli perangkat dengan harga daftar. Di 2026, sebagian besar tidak bisa, dan harga daftar itu sendiri sudah naik.
Krisis memori, dalam harga yang bisa kamu cek
Harga kontrak DRAM konvensional naik sekitar 93–98% quarter-over-quarter di 1Q26, lalu 58–63% di 2Q26, dan TrendForce memperkirakan kenaikan lebih lanjut 13–18% di 3Q26 (TrendForce). Itu perlambatan, bukan pemulihan. Harga masih naik dari basis yang sudah dua kali lipat. Permintaannya bukan dari kamu: pusat data menyerap hingga 70% output memori dunia di 2026 dibanding sekitar 20–30% pada 2022, dan HBM saja mengambil 23% wafer DRAM tahun ini dibanding 8% pada 2024 (IDC). Inferensi lokal adalah pembelian kapasitas memori yang bersaing dengan pihak yang membangun cloud yang ingin kamu hindari.
DGX Spark, RTX 5090, dan jurang antara MSRP dan harga pasar
NVIDIA menaikkan DGX Spark dari $3.999 menjadi $4.699 pada Februari 2026, kenaikan $700 yang dikaitkan perusahaan dengan melonjaknya biaya DRAM dan penyimpanan (Notebookcheck). 128 GB LPDDR5X-nya adalah alasan utama ia menarik untuk model lokal, dan itu juga alasan harganya mengikuti pasar komoditas yang tidak kamu kendalikan.
Anggap saja setiap MSRP 2025 yang dikutip dalam postingan perbandingan sebagai fiksi. Cek harga part tersebut minggu ini, lalu hitung ulang angkamu berdasarkan harga itu.
Listrik adalah pengeluaran yang selalu dilupakan semua orang
GPU adalah pembelian satu kali yang mengirimkan tagihan setiap bulan. Rata-rata listrik residensial AS mencapai 18,34 ¢/kWh pada Juni 2026, naik 5,0% year-over-year, dengan kisaran dari 8,96¢ di New Mexico hingga 28,50¢ di California (EIA). Rig yang sama memiliki biaya operasional yang berbeda lebih dari 3x tergantung di mana ia dicolokkan. Jika kamu di California, biaya listrik saja bisa menyamai biaya token hosted yang setara. Di New Mexico kalkulasinya cukup berbeda untuk mengubah jawaban.
Berapa biaya rig 2026 yang layak dipertahankan
Anggarkan perangkat dengan harga pasar saat ini, tambah konsumsi daya dengan tarif utilitas aktualmu, dan tambah jam yang akan kamu habiskan untuk framework inferensi lokal dan penyetelan kuantisasi yang tidak diminta oleh endpoint hosted. Angka CapEx empat digit dengan ekor OpEx tiga digit tahunan adalah titik awal yang jujur, dan kedua sisinya memburuk tahun ini karena alasan yang sama sekali tidak ada hubungannya dengan seberapa bagus modelnya.
Ollama vs cloud API: perbandingan kini menjadi tiga arah
Ada tiga harga yang penting sekarang: GPU yang kamu beli, open weight yang di-hosting, dan frontier API. Pilihan tengah memenangkan sebagian besar beban kerja, dan itulah yang hampir tidak pernah disertakan dalam formula titik impas yang sudah diterbitkan.
Ollama sendiri menjadi cloud API pada 31 Agustus 2026
Alat yang mengajarkan satu generasi developer untuk menjalankan model di mesin sendiri kini menjual token. Pada 31 Agustus 2026, Ollama memindahkan paket Pro, Max, dan Team ke harga cloud per token: $20/bln termasuk $60 penggunaan, $100/bln termasuk $300, dan $500/bln termasuk $1.000 yang dibagi antar pengguna tanpa batas, dengan nol retensi data dan hosting di AS dan Eropa (Ollama). Jadi "Ollama vs cloud" tidak lagi menggambarkan pilihan yang nyata.
Open weight yang di-hosting: pilihan tengah yang tidak dimodelkan siapa pun
| Model | Input / output per MTok | Sumber |
|---|---|---|
| nemotron-3-super (Ollama Cloud) | $0.015 / $0.60 | Ollama |
| deepseek-v4-flash (Ollama Cloud) | $0.22 / $0.66 | Ollama |
| qwen3.5:397b (Ollama Cloud) | $0.60 / $3.60 | Ollama |
| Claude Haiku 4.5 | $1.00 / $5.00 | Anthropic |
| Claude Sonnet 5 | $2.00 / $10.00 | Anthropic |
Baca cetakan kecilnya sebelum kamu membangun perkiraan berdasarkan angka-angka itu. Sebagian besar tarif Ollama Cloud berlipat ganda antara pukul 12:00 dan 18:00 UTC pada hari kerja (Ollama), yang mengubah tagihanmu menjadi pertanyaan penjadwalan. Jadwalkan pekerjaan massal di malam hari dan akhir pekan, dan kamu mempertahankan tarif yang tercantum. Jalankan produk interaktif untuk pengguna Eropa di sore hari dan kamu membayar tarif ganda setiap hari kerja. Variabel waktu itu lebih layak mendapat perhatian daripada pilihan antara dua penyedia hosting yang harganya serupa.
Frontier API lebih murah dari yang tersirat di harga daftarnya
Cache read ditagih 0,1x harga input dasar, Batch API memotong 50% dari input dan output, dan keduanya bisa ditumpuk (Anthropic). Haiku 4.5 yang di-batch turun ke $0,50 input dan $2,50 output per juta token, dan Sonnet 5 mempertahankan harga perkenalan $2/$10 alih-alih pindah ke $3/$15 yang dijadwalkan pada 1 September 2026 (Anthropic). Pekerjaan massal async adalah tepat yang selalu dipitchkan untuk rig lokal, dan itulah beban kerja di mana diskon cloud paling terasa.
Catatan kaki tokenizer yang menarik ke arah sebaliknya
Claude 4.7 dan versi lebih baru menggunakan tokenizer baru yang menghasilkan sekitar 30% lebih banyak token untuk teks yang sama (Anthropic). Tagihan Sonnet 5 aktualmu untuk korpus tetap berjalan sekitar 30% di atas yang diimplikasikan kartu $2/$10 ketika dibandingkan dengan model lokal yang menggunakan tokenizer lama. Hitung token pada teksmu sendiri dengan keduanya sebelum kamu berkomitmen.
Menghitung titik persilangan: pada volume berapa GPU-mu menang?
Hardware milik sendiri mulai mengalahkan open weight yang di-hosting di sekitar 26% utilisasi GPU harian yang berkelanjutan — kira-kira enam jam kerja nyata setiap hari — diihitung dari harga hardware 2026 dan tarif listrik lokalmu. Di bawah garis itu, kartu menganggur sementara jam depresiasi terus berjalan. Hitung volumenya sendiri terhadap tarif hosting sebelum membeli: deepseek-v4-flash dikenakan $0,22 input dan $0,66 output per juta token di Ollama Cloud (Ollama).
Di mana lokal menang (daftar singkat yang bisa disebutkan namanya)
Ada empat kasus yang bertahan jika diteliti. Selebihnya adalah setup hybrid di mana kamu merutekan kueri mudah ke model lokal dan mengeskalasinya untuk sisanya.
Pekerjaan batch volume tinggi yang berkelanjutan yang membuat kartu tetap sibuk
Jika GPU kamu menganggur 90% hari, kamu membeli pemanas ruangan. Kasus pembelian membutuhkan kartu yang bekerja lebih dari seperempat hari, setiap hari, dan harus bertahan dalam perbandingan dengan Claude Batch API yang memotong token input dan output sebesar 50% dan bisa ditumpuk dengan prompt caching (Anthropic). Itu menempatkan pekerjaan batch Haiku 4.5 di $0,50 per juta token input dan $2,50 output. Rig lokalmu harus mengalahkan itu dengan hardware yang disusutkan ditambah listrik, dan dengan rata-rata listrik residensial AS 18,34 ¢/kWh pada Juni 2026 (EIA), kartu yang menarik beban nyata pun tidak gratis. Hitung dengan volume token aktualmu sebelum menggunakan lembar spesifikasi.
Kedaulatan data yang ketat, CLOUD Act, bukan hanya GDPR
Ada kategori nyata di sini, dan lebih sempit dari yang diklaim kebanyakan orang. Kepatuhan GDPR adalah masalah kontrak. Persyaratan bahwa tidak ada entitas yurisdiksi AS yang bisa dipaksa mengungkapkan datamu adalah masalah fisika, dan masalah fisika diselesaikan dengan hardware yang kamu kendalikan.
Loop interaktif di mana time-to-first-token adalah produknya
Inferensi lokal memberikan time-to-first-token 50–200ms dibanding 200–800ms untuk cloud, dengan Claude Haiku 4.5 terukur di 597ms dan GPT-4.1 Mini sekitar 2.400ms (Eden AI). Untuk jendela chat, tidak ada yang memperhatikannya. Untuk penyelesaian kode inline, atau agen multi-langkah yang merantai delapan panggilan, perbedaan itu berlipat menjadi sesuatu yang dirasakan pengguna. Jika kamu membangun dengan bentuk itu, jelajahi agen AI di direktori kami dan periksa berapa banyak di antaranya yang melakukan round trip per keystroke.
Operasi offline dan air-gapped
Tidak ada argumen yang perlu dibuat. Jaringannya ada atau tidak ada.
Argumen privasi yang kini dijual kembali oleh cloud kepadamu
Kontra terkuat untuk kasus kedua adalah bahwa Anthropic akan menjual properti itu langsung kepadamu. Pada Claude 4.6 dan versi lebih baru, mengunci inferensi hanya ke AS dengan inference_geo: "us" dikenakan pengganda 1,1x untuk semua kategori token (Anthropic). Itu premium 10% alih-alih $4.699 DGX Spark. Paket berbayar Ollama, sementara itu, mengiklankan nol retensi data yang di-hosting di AS dan Eropa per 31 Agustus 2026 (Ollama). Jika persyaratan privasi kamu terpenuhi dengan jaminan kontraktual dan pin geografis, kamu tidak membutuhkan persyaratan hardware.
Setup hybrid yang dipakai kebanyakan praktisi
Rute berdasarkan kesulitan, bukan berdasarkan prinsip. Model MoE 20–30B di kartumu sendiri menangani sekitar tujuh dari setiap sepuluh kueri dalam beban kerja asisten atau pemrosesan dokumen yang khas, dan tiga sisanya dikirim ke frontier API. Itulah arsitekturnya. Selebihnya adalah penyetelan.
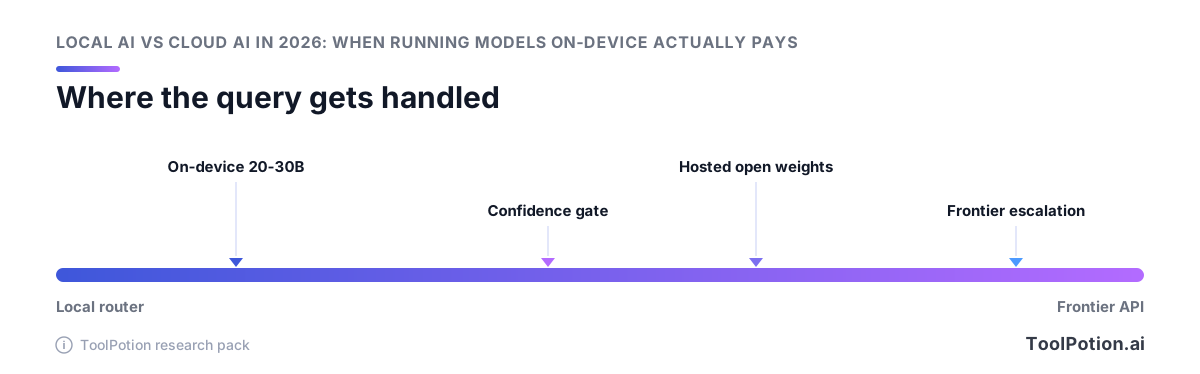
Tiga sinyal memutuskan eskalasi, dan kamu bisa menghitung semuanya sebelum model lokal selesai: kepercayaan model itu sendiri (margin log-prob atau self-check murah), apakah kueri membutuhkan pengetahuan dunia yang tidak dimiliki bobot lokal, dan panjang konteks. Sinyal pengetahuan menangkap sebagian besar kegagalanmu. Model kelas 24GB bernalar dengan baik tetapi mengingat dengan buruk, sehingga apa pun yang terlihat seperti "siapa yang mengakuisisi siapa di 2025" sebaiknya melewati lokal sama sekali.
Tumpukan konkret yang berfungsi
Ollama atau LM Studio di depan, satu frontier API di belakang, dan router tipis di antara keduanya yang mencatat setiap keputusan.
Kirim traffic yang dieskalasinya ke Claude Haiku 4.5 dengan $1/MTok input dan $5/MTok output terlebih dahulu, dan baru menjangkau Sonnet 5 dengan $2/$10 ketika jawaban Haiku gagal pemeriksaanmu (Anthropic pricing). Jika pekerjaan yang dieskalasinya bersifat async, batch-kan: Batch API memotong setengah keduanya, sehingga Haiku turun ke $0,50/$2,50. Kebanyakan tim melewati ini dan membayar harga daftar untuk pekerjaan yang bisa menunggu dua puluh menit.
Pantau tingkat eskalasi atau kamu terbang buta
Catat empat angka per permintaan: tingkat mana yang melayaninya, kepercayaan model lokal, jumlah token, dan apakah manusia mencoba ulang jawabannya. Tingkat retry adalah sinyal kualitas nyatamu. Jika eskalasi berada di bawah sekitar 20%, model lokalmu menjawab hal-hal yang tidak seharusnya dan kamu akan melihatnya pada retry. Di atas 45% dan GPU tidak menghasilkan nilai yang cukup untuk depresiasi.
Mengapa batasnya berubah setiap kuartal
Harga di kedua sisi bergerak lebih cepat dari arsitekturmu. Ollama memindahkan Pro, Max, dan Team ke penagihan cloud per token pada 31 Agustus 2026 (Ollama), tarif Ollama Cloud berlipat ganda antara pukul 12:00 dan 18:00 UTC pada hari kerja (Ollama pricing), dan kemampuan open-weight tertinggal rata-rata 4 bulan dari model frontier tertutup sejak Januari 2026 (Epoch AI). Tinjau ambang routing kamu terhadap angka terkini setiap kuartal. Masukkan dalam kalender.
Lapisan tooling cukup stabil untuk dibangun di atasnya
Ollama berjalan dengan 8,9 juta developer aktif bulanan dengan tim 14 orang, ada di dalam 85% Fortune 500, dan mengumpulkan $65M yang dipimpin Theory Ventures pada Juli 2026 (TechCrunch). Itu bukan proyek yang menghilang tahun depan. Lem router di sekitarnya adalah bagian yang kamu miliki, dan kamu bisa meminjam sebagian besarnya dari repo AI open-source yang sudah menerbitkan pola ini.
Putuskan dalam lima pertanyaan
Jawab secara berurutan. Yang pertama memberikan jawaban tegas memutuskan setup kamu, dan kamu bisa berhenti di situ.
Apakah kamu memiliki persyaratan kedaulatan yang ketat?
Ketat berarti air-gapped, eksposur CLOUD Act yang sudah ditulis oleh tim hukum, atau kontrak yang menyebutkan mesinnya. Jika kamu termasuk golongan itu, beli hardware dan berhenti membaca bagian biaya. Jika persyaratanmu lebih longgar dari itu, Anthropic akan mengunci inferensi ke AS saja dengan inference_geo: "us" pada Claude 4.6 dan versi lebih baru dengan pengganda 1,1x untuk semua kategori token (Anthropic pricing docs), dan paket berbayar Ollama menjalankan nol retensi data di AS dan Eropa (Ollama). Premium 10% mengalahkan hardware seharga $4.699 untuk hampir semua orang.
Apakah pekerjaanmu terikat latensi atau terikat throughput?
Loop interaktif di mana seseorang menunggu setiap token lebih cocok untuk lokal: 50–200ms hingga token pertama dibanding 200–800ms untuk cloud, dengan Claude Haiku 4.5 terukur di 597ms (Eden AI). Pekerjaan throughput berjalan sebaliknya. Batch-kan dan ambil diskon 50%, yang menempatkan Haiku 4.5 di $0,50/MTok input dan $2,50 output (Anthropic).
Apakah GPU akan tetap sibuk lebih dari seperempat hari?
Di bawah garis itu kartumu berdepresisi saat menganggur dan open weight yang di-hosting menang dari sisi biaya. Di atasnya, perhitungan lokal mulai berfungsi. Jujurlah dengan penyebutnya, karena malam dan akhir pekan ikut dihitung.
Apakah tugasmu membutuhkan pengetahuan dunia atau hanya penalaran?
Penalaran atas teks yang kamu sediakan berjalan baik pada model MoE 20–30B. Pertanyaan yang bergantung pada fakta yang sudah harus diketahui model sebaiknya dilimpahkan ke frontier API, atau ke GLM-5.2 yang di-hosting, yang memiliki 744B parameter total dan tidak pernah muat di laptopmu (Artificial Analysis).
Bisakah kamu mentoleransi penyetelan ulang setiap kuartal?
Kesenjangan open-closed berada di 4 bulan dan bergerak dari rata-rata 3 bulan (Epoch AI), sehingga ambang routing kamu memiliki masa berlaku. Tim yang tidak akan meninjau ulangnya sebaiknya default ke frontier API dengan caching diaktifkan dan tidak merutekan apa pun. Tim yang mau bisa melihat studi kasus deployment nyata untuk mengetahui ambang orang lain pada akhirnya.
Apa yang akan mengubah kesimpulan ini di 2027
Saran ini memiliki tanggal kedaluwarsa, dan ada tiga angka spesifik yang menentukannya.
Harga memori melambat, bukan turun
Harga kontrak DRAM konvensional naik sekitar 93–98% quarter-over-quarter di 1Q26, lalu 58–63% di 2Q26, dengan perkiraan 13–18% untuk 3Q26. Kurva itu mendatar. Tapi masih menunjuk ke atas. Laju kenaikan yang lebih lambat tidak mengembalikan $700 yang ditambahkan NVIDIA ke DGX Spark pada Februari 2026, dan tidak ada dalam perkiraan yang mengatakan harga pasar akan turun tahun depan. Rencanakan kasus hardware yang tetap lemah hingga 2027 kecuali permintaan pusat data mereda.
Pantau kesenjangan open/closed, bukan benchmark headline
Dua sinyal lebih penting dari posisi leaderboard mana pun. Yang pertama adalah kesenjangan ECI Epoch AI, yang berada di 4 bulan, atau 8 poin, sejak Januari 2026. Yang kedua adalah jumlah parameter aktif: GLM-5.2 memimpin open weight dengan 40B aktif dari 744B total, sehingga hari di mana model dengan aktif di bawah 30B mendekati frontier dalam beberapa poin ECI, kartu 24GB menjadi menarik lagi. Pantau juga apakah penggandaan jam sibuk Ollama (12:00–18:00 UTC hari kerja) bertahan atau menormal. Laporan tren AI kami melacak rilis model yang akan menggerakkan salah satu dari ini.
Pertanyaan yang Sering Diajukan
Apakah lebih murah menjalankan LLM secara lokal atau menggunakan cloud API di 2026?
Untuk kebanyakan orang, cloud, dan kesenjangan melebar di 2026. Claude Haiku 4.5 dihargai $1 per juta token input dan $5 per juta output, turun menjadi $0,50/$2,50 melalui Batch API, dan cache prompt ditagih 0,1x tarif input dasar (Anthropic pricing). Di sisi lain, NVIDIA DGX Spark naik dari $3.999 menjadi $4.699 pada Februari 2026 karena biaya DRAM dan penyimpanan (Notebookcheck), dan kamu masih membayar listrik dengan rata-rata residensial AS 18,34 ¢/kWh pada Juni 2026 (EIA). Lokal mendapat nilainya pada pekerjaan batch volume tinggi yang berkelanjutan yang membuat kartu tetap sibuk sebagian besar hari, pada operasi air-gapped, dan pada loop yang sensitif terhadap latensi.
Hardware apa yang saya butuhkan untuk menjalankan LLM secara lokal di 2026?
GPU 24GB adalah batas bawah konsumen yang praktis, dan itu membatasimu pada kelas mixture-of-experts 20–30B alih-alih yang mendekati frontier open-weight. Di atas itu, kamu membeli kotak 128 GB LPDDR5X seperti DGX Spark, yang kini seharga $4.699 (Notebookcheck). Anggarkan untuk harga memori yang terus naik: harga kontrak DRAM konvensional naik sekitar 93–98% quarter-over-quarter di 1Q26 dan 58–63% di 2Q26, dengan proyeksi tambahan 13–18% untuk 3Q26 (TrendForce). Kuantisasi memperluas apa yang muat, dan 4-bit hampir gratis: Q4_K_M mengecilkan Mistral-7B-Instruct-v0.2 dari 7,2 GB menjadi 4,1 GB untuk 0,51% kehilangan perplexity, sementara Q2_K merosot tajam pada 7,94% (tradeoff kuantisasi).
Seberapa bagus model lokal dibandingkan Claude atau GPT?
Kesenjangan yang banyak dikutip itu nyata tetapi mendeskripsikan hardware yang mungkin tidak kamu miliki. Epoch AI mengukur model open-weight tertinggal rata-rata 4 bulan dari model frontier tertutup, atau 8 poin ECI, sejak Januari 2026, sedikit lebih lebar dari rata-rata 3 bulan untuk Januari 2023 hingga Oktober 2025 (Epoch AI). Model yang membawa klaim itu, GLM-5.2, mencetak 51 pada Intelligence Index v4.1 Artificial Analysis dengan 744B total dan 40B parameter aktif, yang merupakan hardware datacenter (Artificial Analysis). Yang sebenarnya muat di laptop atau satu GPU kuat dalam penalaran terstruktur dan lemah dalam pengetahuan dunia, jadi anggap angka 4 bulan itu sebagai batas atas yang tidak bisa kamu capai di rumah.
Apakah Ollama masih gratis, dan bagaimana harga Ollama Cloud dibandingkan dengan frontier API?
Framing lokal-versus-Ollama tidak lagi masuk akal sejak 31 Agustus 2026, ketika Ollama memindahkan paket Pro, Max, dan Team ke harga cloud per token: $20/bln termasuk $60 penggunaan, $100/bln termasuk $300, dan $500/bln termasuk $1.000 yang dibagi antar pengguna tanpa batas, dengan nol retensi data yang di-hosting di AS dan Eropa (Ollama blog). Open weight yang di-hosting murah di sana: deepseek-v4-flash dikenakan $0,22 input dan $0,66 output per juta token, nemotron-3-super $0,015/$0,60, qwen3.5:397b $0,60/$3,60, meskipun sebagian besar tarif berlipat ganda selama jam sibuk dari pukul 12:00 hingga 18:00 UTC pada hari kerja (Ollama pricing). Bandingkan dengan Claude Haiku 4.5 di $1/$5 (Anthropic pricing) dan keputusan nyatanya adalah tiga arah, dengan open weight yang di-hosting mengalahkan GPU milikmu dari sisi biaya untuk sebagian besar beban kerja. Ollama memiliki skala yang perlu diambil serius bagaimanapun juga, dengan 8,9 juta developer aktif bulanan dan 85% dari Fortune 500 (TechCrunch).
Apakah menjalankan model secara lokal benar-benar membuat data saya lebih privat dari cloud API?
Ini memberimu satu properti yang tidak dimiliki hal lain, yaitu bahwa byte tidak pernah meninggalkan mesinmu, dan itu penting untuk pekerjaan air-gapped dan untuk persyaratan kedaulatan data yang ketat seperti CLOUD Act. Untuk semua yang lebih lunak dari itu, penyedia kini menjual jaminan yang sama dengan murah. Pada Claude 4.6 dan versi lebih baru, mengunci inferensi ke AS saja dengan inference_geo: "us" dikenakan pengganda 1,1x untuk semua kategori token (Anthropic pricing), dan paket berbayar Ollama menjalankan nol retensi data di AS dan Eropa (Ollama blog). Premium 10% adalah komitmen yang jauh lebih kecil dari hardware seharga $4.699 (Notebookcheck).
Model lokal mana yang harus saya mulai dengan GPU 24GB?
Mulai dengan model mixture-of-experts 20–30B seperti Qwen3-30B-A3B atau gpt-oss-20b, dikuantisasi ke Q4_K_M. Kelas itu mencetak 73–87% pada AIME 2024 di satu RTX 5090, sehingga penalaran bertahan dengan baik, sementara recall faktual tentang dunia adalah kelemahannya. Q4_K_M adalah titik kuantisasi yang tepat: ia memotong model 7,2 GB menjadi 4,1 GB untuk 0,51% kehilangan perplexity, dan Q2_K menurun tajam pada 7,94% (tradeoff kuantisasi). Jalankan sebagai hop pertama dan eskalasikan kueri yang banyak membutuhkan pengetahuan ke model cloud.