

GitHub menyatakan bahwa di Artificial Analysis Coding Agent Index, Copilot Fusion Max "scored 60, within two points of Claude Code with Opus 5.5 Max" (GitHub changelog). Judul The New Stack mengubahnya menjadi sistem yang "beats Claude Code for half the API cost" (The New Stack). Keduanya kalimat yang berbeda, dan di celah antara keduanya itulah tim Anda sebaiknya berpikir.
Fusion tersedia secara umum di GitHub Copilot sebagai entri baru di model picker. Anda tidak memilih model. Anda memilih tingkat effort, dan Copilot yang menentukan model mana yang berjalan, dalam urutan apa, untuk setiap prompt. Idenya bagus, tetapi bukti pendukungnya masih tipis, jadi kami akan memperlakukannya sebagai fitur pengendali biaya dulu, baru klaim kualitas kemudian.
Enam puluh bukan enam puluh dua
Baca lagi kata-kata GitHub sendiri. Fusion Max berada dalam selisih dua poin dari Claude Code dengan Opus 5.5 Max, dengan biaya API rata-rata per tugas sekitar setengahnya, token sekitar setengahnya, dan waktu sekitar 40% lebih singkat (changelog). Hasil itu layak dihargai dan pitch-nya wajar. Tapi itu bukan kemenangan, dan isi artikel The New Stack sendiri menyebut "comparable" di bawah judul yang bilang "beats". GitHub mengulang klaim itu di rangkuman Universe, dan versi "half the cost" yang paling mudah menyebar.
Artificial Analysis menerbitkan indeks yang dikutip GitHub. Indeks ini menggabungkan tiga benchmark, FrontierCode, Terminal-Bench 4.0, dan SWE-Atlas-QnA-AA, dengan bobot yang sama (Artificial Analysis). Tampilan default halaman itu menunjukkan Claude Code dengan Opus 5.5 Max di angka 62 dan tidak ada entri Fusion. Aktifkan toggle "Router models" dan GitHub Copilot - Copilot Fusion (Max) muncul di angka 60, jadi angkanya nyata dan sesuai dengan yang dikatakan GitHub. Toggle yang sama juga menampilkan Devin Fusion CLI dari Cognition, yang memasangkan Opus 5.5 Max dengan GPT-6 Luna, seri dengan Claude Code di 62. Ini menandakan router sebagai kategori sedang mengejar ketertinggalan, bukan bahwa milik GitHub yang harus dikalahkan. Kami tidak membandingkan kolom biaya di halaman itu dengan angka "half the cost" dari GitHub, jadi bagian tersebut masih sebatas klaim GitHub.
Tiga jalur di balik satu entri menu
Dokumentasinya menyebut Fusion sebagai "an intelligent runtime model router and orchestrator" (GitHub Docs). Untuk setiap prompt, ia memilih satu dari tiga pola eksekusi, dan prompt yang berbeda dalam satu sesi bisa mengambil jalur yang berbeda.
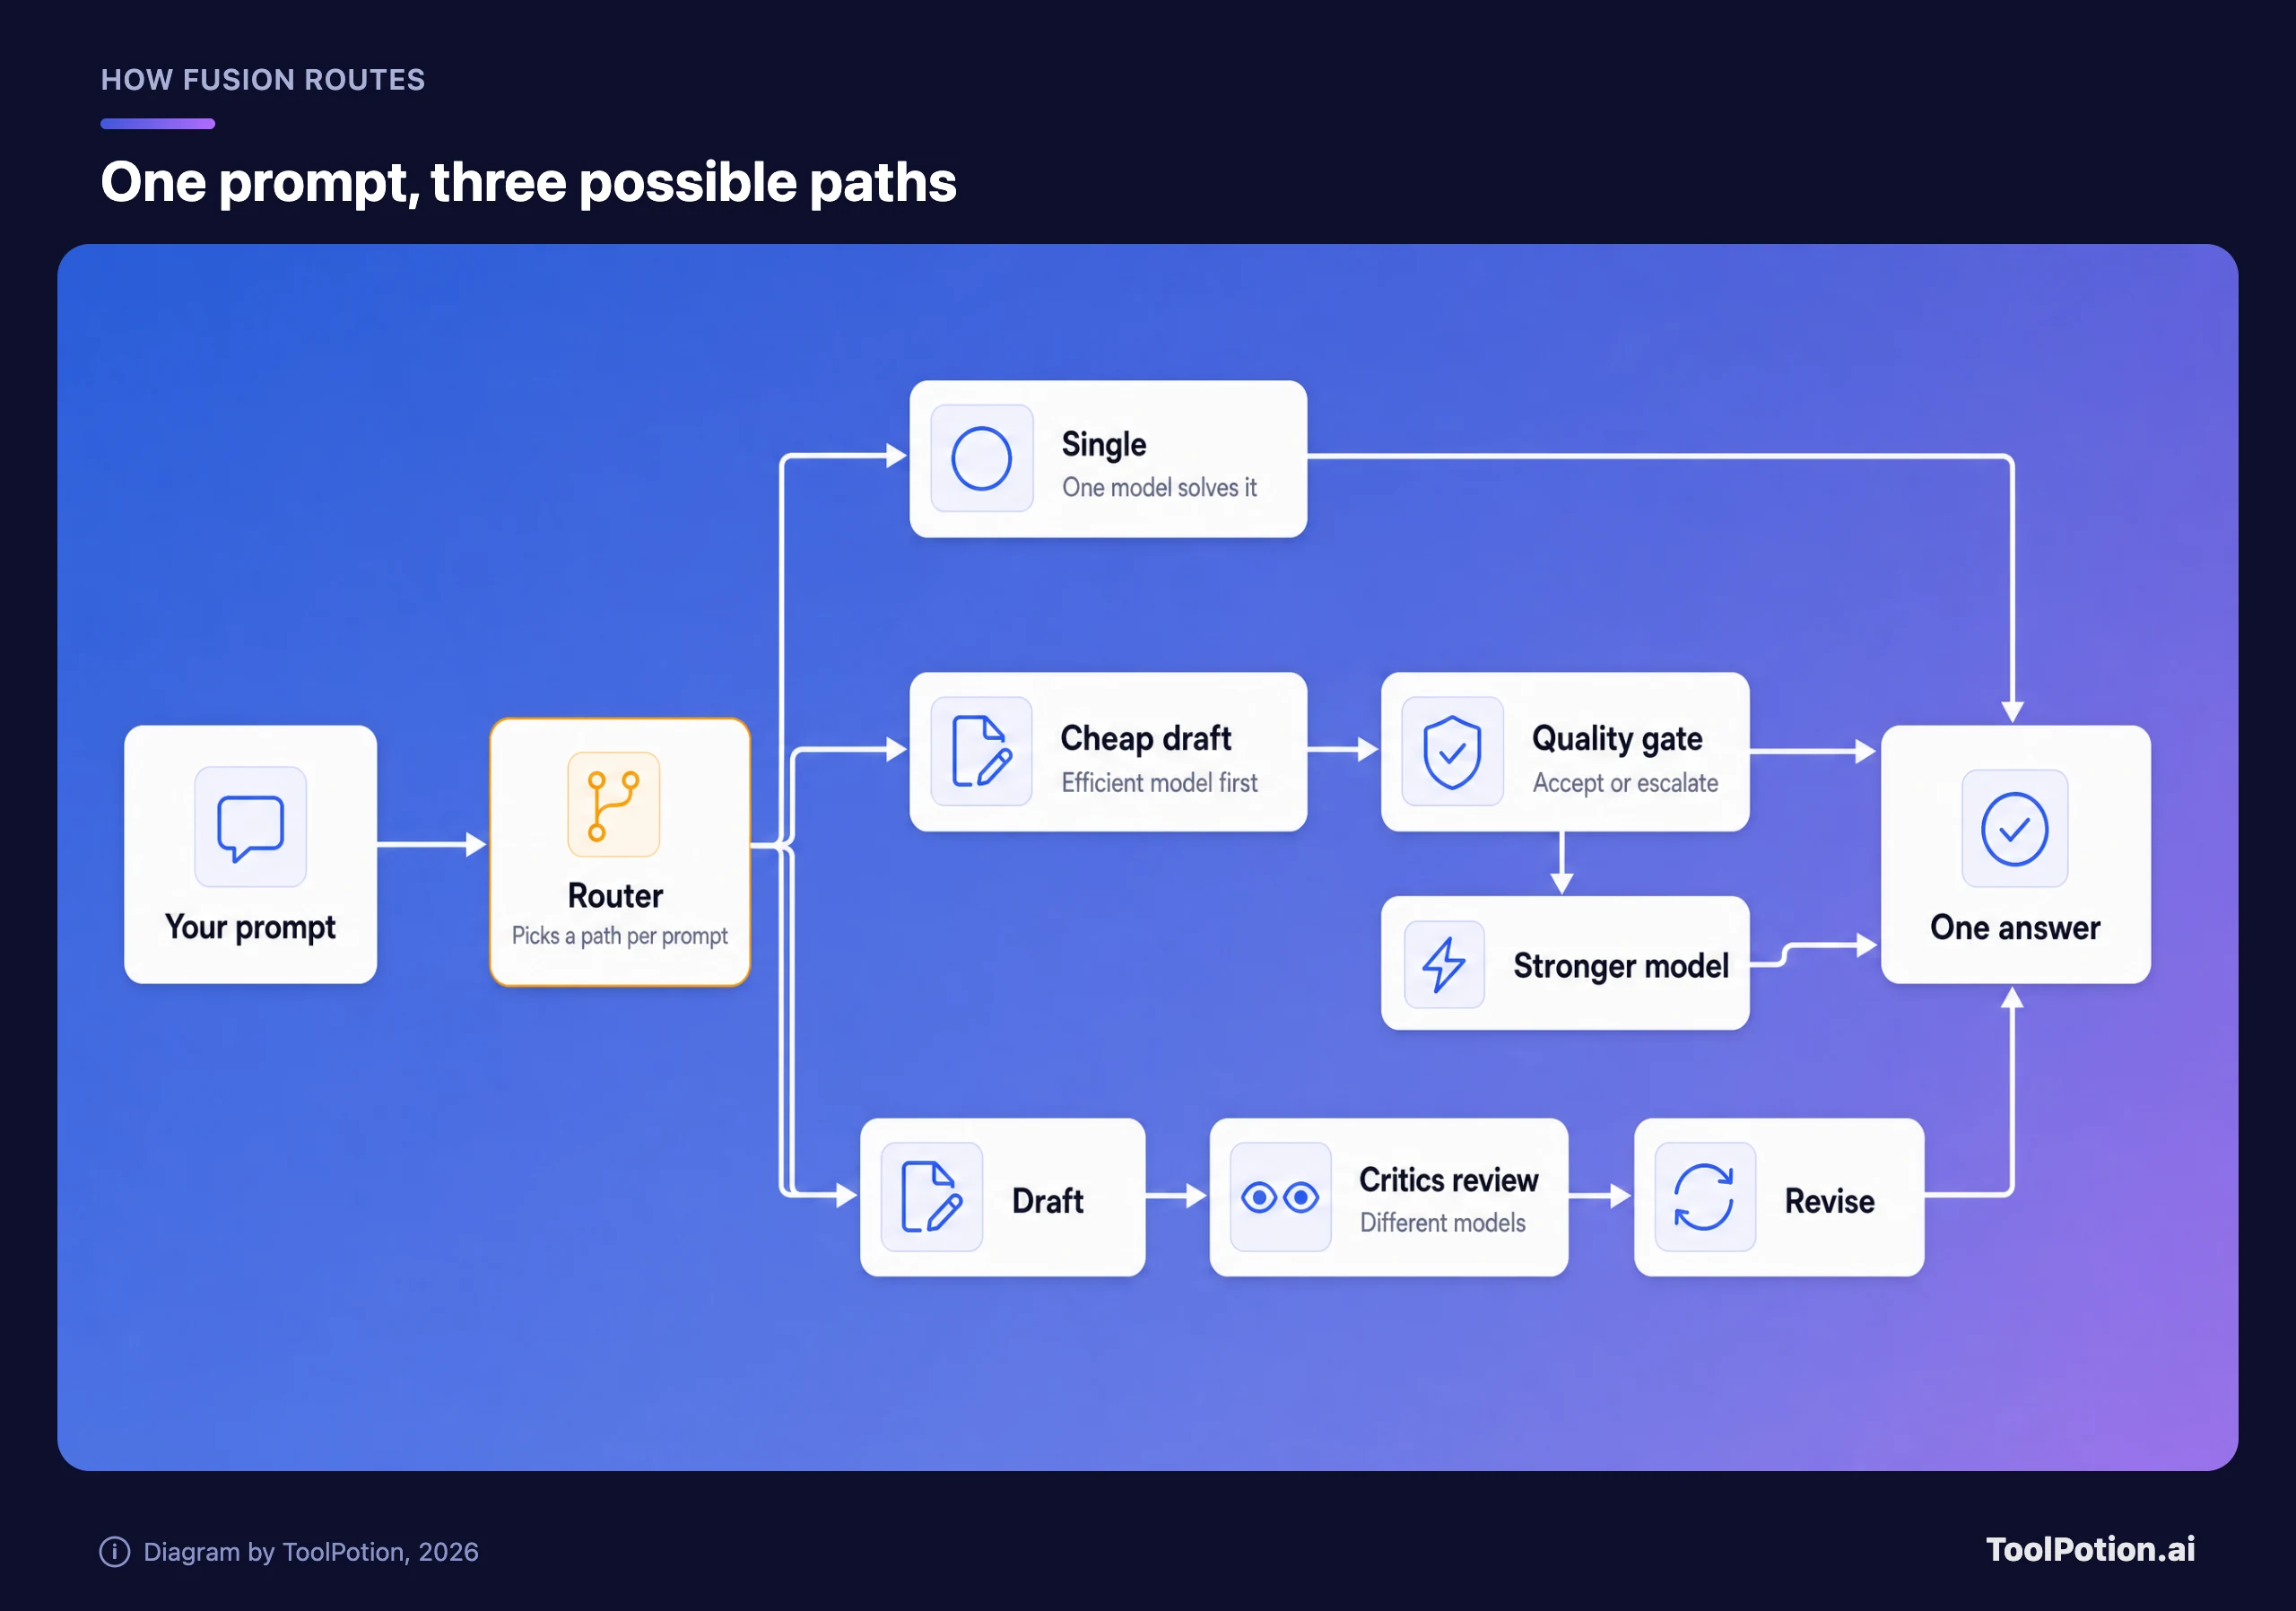
Single berarti satu model menjawab langsung. Cascade membiarkan model yang efisien membuat draf, lalu sebuah judge memutuskan apakah draf itu diterima atau dieskalasi ke model yang lebih kuat. Critique membuat satu model menyusun draf sementara model lain meninjaunya, lalu penyusun draf merevisi. Tingkat effort menentukan seberapa agresif routing berjalan: Standard untuk pekerjaan sehari-hari, High untuk tugas yang besar, Max untuk penalaran tersulit.
Satu detail berubah antara preview dan peluncuran. Postingan research preview GitHub sebelumnya menyebut "an independent read-only critic from a different model family" (GitHub blog). Changelog peluncuran menyebut "another model reviews it", sementara dokumentasinya menyatakan beberapa model melakukan kritik secara paralel dan masukan mereka digabungkan. Menurut pembacaan kami, langkah critique berkembang dari satu reviewer menjadi beberapa, tetapi GitHub tidak menyatakannya, dan changelog tidak menandai perbedaannya.
Semua paket mendapatkannya, dan Anda membayar per model
Menurut changelog, Fusion tersedia di semua paket Copilot di VS Code, aplikasi Copilot, Copilot CLI, dan IDE JetBrains, dengan lebih banyak klien menyusul. Anda ditagih untuk setiap model yang dipakainya dengan tarif standar model tersebut, tanpa biaya Fusion terpisah. Paket berbayar mendapat diskon 30% untuk biaya model selama waktu terbatas, dan dokumentasi menyebut diskon itu berakhir akhir tahun ini (docs).
Ada dua hal yang masih menggantung. Dokumentasi Fusion menyebut ia "available with all GitHub Copilot plans." Sementara halaman paket menyatakan bahwa di Free dan Student, akses ke model hanya lewat auto model selection. GitHub tidak mendamaikan keduanya. Tabel tingkat effort per paket di dokumentasi menandai ketersediaan dengan ikon yang terbaca sebagai sel kosong saat kami membukanya, jadi kami tidak bisa memastikan level mana yang didapat seat Free dan Student. Periksa sendiri di picker Anda. Dan karena High dan Max bisa memanggil beberapa model, dokumentasinya sendiri memperingatkan bahwa satu tugas bisa memakai lebih banyak AI credit dibanding di Standard. Setengah biaya per tugas adalah klaim tentang Max melawan Claude Code, bukan janji soal saldo credit Anda.
Benchmark ini GitHub menilai GitHub
Postingan HydraFusion sebelumnya lebih terus terang daripada materi peluncuran. Pengujiannya berjalan pada tingkat penalaran medium yang sama untuk setiap model, memakai estimasi biaya dengan asumsi harga yang seragam, dan dibandingkan dengan Opus 5 dan GPT-5.6 Sol. GitHub juga menyatakan bahwa mereka menyetel kebijakan routing dengan beam search pada tiga benchmark yang sama dengan yang mereka laporkan (GitHub blog).
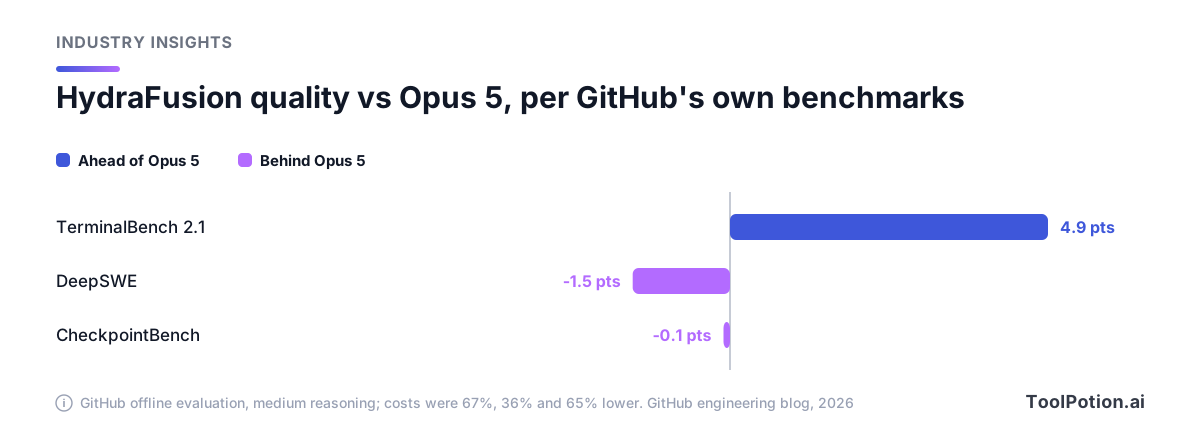
Perhatikan polanya. Satu benchmark menunjukkan kenaikan 4,9 poin. Dua lainnya menunjukkan penurunan kecil, dengan biaya 36% hingga 67% lebih rendah. Ini cerita tentang biaya dengan kualitas yang tetap kurang lebih setara, dan itu pula yang akhirnya dikatakan materi peluncuran.
Developer di Hacker News menyerang baseline-nya. Seorang komentator menulis bahwa "Opus 5 (in practice) is not a good baseline to compare against" (HN). Yang lain meragukan hasilnya, dengan mengatakan "It doesn't take much to beat the frontier in single benchmarks if one puts extra software between the model and the harness" (HN). Seorang pengguna Copilot CLI di thread yang sama mengatakan mode auto "only changes models at the start of a session or after compaction" (HN), dan satu lagi menyebut auto selection "basically unusable" baginya (HN). Ini komentar individu, bukan studi. Tapi cukup menunjukkan di mana letak keraguannya.
Ada juga ketidaksesuaian penagihan yang perlu diingat. Indeks dan perbandingan GitHub memakai biaya API bayar-per-token. Developer dengan langganan flat Claude Code tidak pernah melihat angka itu, jadi "half the cost" terasa berbeda bagi pengguna solo dibanding tim yang memantau pengeluaran API. Artificial Analysis sendiri mencatat bahwa banyak pengguna mengakses tool ini lewat langganan, bukan bayar-per-token. Kesimpulan ini inferensi kami, bukan klaim GitHub, tetapi ia mengubah siapa sasaran headline tersebut.
Satu-satunya suara pelanggan yang disediakan GitHub adalah Hari Pokhrel dari AT&T, yang dikutip di changelog GitHub sendiri: "Previously, developers would often choose a more powerful model for a complex task and forget to switch back for everyday activities." Itulah argumen jujur untuk Fusion: ia mencegah orang membiarkan model mahal tetap menyala untuk pekerjaan rutin.
Kebijakan Anda menentukan siapa yang membaca diff Anda
Bagian ini yang akan kami baca sebelum benchmark-nya. Fusion hanya memakai model yang diaktifkan dalam kebijakan enterprise dan organisasi Anda. Admin bisa menonaktifkan model tertentu untuk Fusion tanpa menonaktifkannya di tempat lain, dan model yang dikecualikan oleh kebijakan data-residency atau FedRAMP tidak disertakan (docs).
Peninjauan oleh model kedua adalah taruhan desainnya, dan postingan preview menyebut reviewer itu berasal dari keluarga model yang berbeda. Jika itu berarti vendor lain, ia melihat diff Anda, dan itu keputusan penanganan data yang sebaiknya diambil dengan sengaja oleh seseorang di tim Anda. Setelah respons selesai, Anda bisa mengarahkan kursor ke label effort untuk melihat model mana yang berjalan.
Bagian keterbatasan juga penting. Jika Fusion membuang sebuah draf, edit file yang sudah dibuat draf itu tidak otomatis dibatalkan, jadi tinjau diff sebelum commit. Fusion juga tidak punya context window sendiri: angka yang ditampilkan adalah yang terkecil di antara model-modelnya.
Di mana kami akan menempatkannya dalam uji coba tim
Kami akan menjalankan Fusion Standard sebagai default untuk tim Copilot, dan tidak menjadikan Max sebagai default. Skor 60 di indeks independen itu layak dihargai, tetapi Max adalah level yang memanggil paling banyak model dan menghabiskan paling banyak credit. Standard adalah tempat cerita AT&T berlaku dan tempat routing menghemat paling banyak. Bagi tim yang sudah memakai Claude Code atau Codex, pertanyaan lock-in-nya berjalan ke arah sebaliknya: tool-tool itu terikat pada model satu vendor, sedangkan Fusion adalah router yang dikendalikan GitHub dan bisa mereka rombak kapan saja. Tak satu pun bebas dari ketergantungan.
Perbandingan kami yang sudah ada membahas tool-nya sendiri: terminal coding agent, Cursor melawan Copilot dan Windsurf, mencocokkan tier model dengan tugas, dan daftar tool coding yang lebih luas. Fusion mengubah kolom biaya di sana, bukan tool yang akan Anda pilih. Pengguna Cursor belum punya vonis yang setara, dan papan ToolRank coding assistants adalah tempat untuk melihat bagaimana persaingan saat ini terurut.
Tes yang menentukannya murah. Ambil sepuluh tiket nyata, jalankan lewat Fusion Standard dan setup Anda saat ini, lalu hitung perubahan yang diterima dan credit yang terpakai. Diskon GitHub berakhir akhir tahun ini, jadi ukurlah sebelum itu terjadi. Lalu cek lagi tampilan Router models di Artificial Analysis, karena entri router di sana yang paling mungkin bergeser.