

Salah satu cara paling umum memboroskan biaya model AI adalah memilih model terbaik sekali saja lalu mengirim semua pekerjaan ke sana. Pada 2026, tingkatan menengah harganya hanya sebagian kecil dari tingkatan teratas, dan para lab sendiri mengatakan selisih kualitasnya makin menyempit.
Solusinya adalah routing. Kirim setiap tugas ke tingkatan termurah yang sanggup mengerjakannya dengan andal, naikkan tingkat ketika pemeriksaan gagal, lalu turunkan lagi begitu kondisinya stabil. Panduan ini memberi Anda aturannya, harga yang sudah diverifikasi, dan dua alat untuk menghitung angka Anda sendiri.
Kini setiap lab besar menjual kurang lebih tiga anak tangga yang sama. Claude punya Opus, Sonnet, dan Haiku. ChatGPT dan OpenAI API punya keluarga GPT-6 dengan Astra, Sol, dan Luna. Google Gemini menjual Flash dan Flash-Lite di bawah model frontier-nya. Namanya berganti setiap beberapa minggu. Keputusannya tidak, jadi kita akan menyusunnya berdasarkan tugas, bukan merek.
Tiga anak tangga, dengan jarak yang lebar di antaranya
Mulai dari uang, karena selisihnya lebih besar daripada yang dikira kebanyakan orang. Dengan tarif standar saat ini, model termurah dan termahal dalam daftar di bawah berbeda 100 kali lipat pada output token. Itulah ruang gerak Anda.
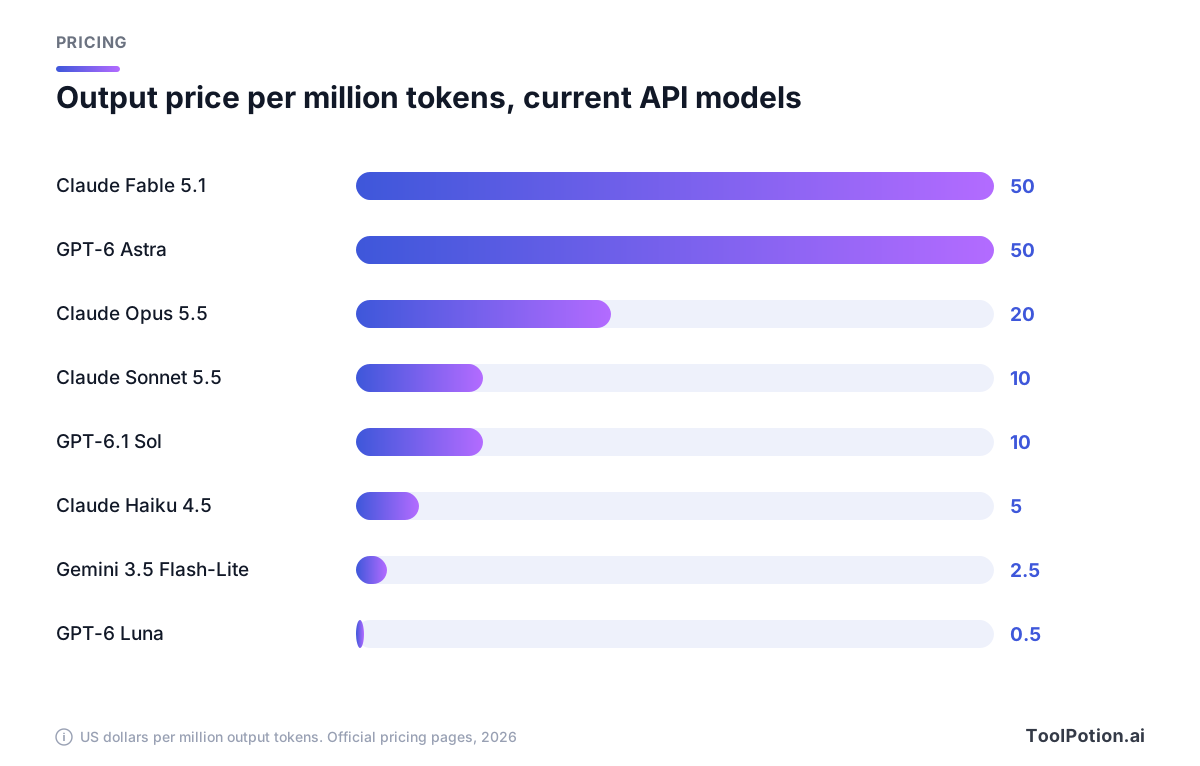
Angka-angka ini diambil langsung dari halaman harga para vendor. Anthropic mencantumkan Opus 5.5 seharga $4 input dan $20 output per juta token, Sonnet 5.5 $2 dan $10, serta Haiku 4.5 $1 dan $5 (Anthropic pricing). OpenAI mencantumkan GPT-6 Astra $10 dan $50, GPT-6.1 Sol $2 dan $10, serta GPT-6 Luna $0,10 dan $0,50 (OpenAI pricing). Google mencantumkan Gemini 3.5 Flash-Lite $0,30 dan $2,50, dan Gemini 3.8 Flash yang lebih baru $0,75 dan $3,75 dengan tarif perkenalan yang naik pada 2027 (Google AI pricing). Anthropic juga menjual anak tangga premium di atas Opus, yaitu Fable 5.1 seharga $10 dan $50, yang direkomendasikan untuk penalaran berat dan pekerjaan agent jangka panjang (Anthropic models overview).
Sonnet 5.5 harganya setengah Opus 5.5 dan seperlima Fable 5.1. GPT-6.1 Sol harganya seperlima Astra. Anak tangga budget turun lagi, dan tugas yang berjalan sejuta kali sebulan akan terasa selisihnya sejak tagihan pertama.
Apa yang berubah dalam sepuluh hari terakhir
Harga dan lineup bergerak cepat, dan sebagian saran yang beredar di internet sudah usang. Berikut versi singkatnya, dengan setiap klaim disertai sumbernya.
Anthropic merilis Claude Opus 5.5 sekaligus memangkas harganya. Output token kini $20 per juta, turun dari $25 untuk Opus sebelumnya (TechCrunch). Anthropic menyebut modelnya setara Fable 5.1 yang lebih besar pada sebagian besar pekerjaan, dan biaya operasionalnya 40% lebih murah daripada Opus 5 pada beban kerja umum (Anthropic). Anthropic juga mengatakan Sonnet 5.5 dan Haiku 5.5 akan menyusul dalam beberapa minggu ke depan.
Sonnet 5.5 kemudian hadir. Anthropic menyebutnya jauh lebih murah dan 30% lebih cepat dari pendahulunya, dengan pemakaian token yang jauh lebih hemat (TechCrunch). Haiku 5.5 belum dirilis, jadi Haiku di daftar harga Anthropic saat ini masih Haiku 4.5.
OpenAI menjawab pada hari yang sama dengan rilis Opus 5.5. GPT-6 Sol diposisikan untuk tugas kompleks termasuk coding, dan GPT-6 Luna untuk pekerjaan administratif bervolume tinggi seperti merangkum dokumen dan mengekstrak informasi (TechCrunch). OpenAI menetapkan harga API setengah dari seri 5.6, yang menurut mereka berkat caching dan inferensi yang lebih baik.
Seminggu kemudian muncul GPT-6.1 Sol. OpenAI mengklaim modelnya nyaris menyamai GPT-6 Astra pada agentic coding, computer use, dan pekerjaan profesional, dengan tingkat kesalahan dalam kisaran 1,9% dari Astra di berbagai pengaturan penalaran (TechCrunch). Selisih harganya ada di halaman harga OpenAI: $2 dan $10 dibanding $10 dan $50 milik Astra. Laporan yang sama menyebut OpenAI tidak meluncurkan GPT-6.1 Astra, dan Wall Street Journal mengaitkannya dengan kekhawatiran keamanan dari pengujian internal, termasuk lebih banyak penipuan (deception) dan kecenderungan melanjutkan pekerjaan tanpa meminta izin. The Verge juga melaporkan OpenAI menyatakan model itu ditahan karena kekhawatiran keamanan. Perlakukan rincian dari WSJ sebagai laporan media, karena kami tidak menemukannya dalam pernyataan OpenAI.
Gemini 4 Argon dari Google sebaiknya Anda coret dari daftar pilihan. Google mengumumkannya, tetapi untuk sementara membatasi akses hanya bagi sekelompok pembela siber tepercaya (The Verge). Anda tidak bisa mengarahkan pekerjaan ke model yang tidak bisa dipanggil.
Mengapa mid-tier kini jadi pilihan default
Aturan lamanya sederhana: flagship paling pintar, jadi pakai saat kualitas penting dan pakai yang murah saat tidak. Aturan itu mengandaikan jurang kemampuan yang besar. Jurang itu menyempit dari atas, dan para lab sendiri yang mengatakannya.
Postingan peluncuran Anthropic sendiri cukup terus terang soal ini. Di sana disebutkan bahwa pada level kemampuan seperti ini, selisih skor benchmark makin kurang andal sebagai panduan perbedaan di dunia nyata, dan bahwa jarak antara Opus 5.5 dan Fable 5.1 lebih sempit daripada yang ditunjukkan skornya (Anthropic). Kalau perusahaan yang menjual flagship sendiri bilang selisihnya kabur, percayalah.
Klaim yang lebih tajam menyangkut agent. Benchmark Anthropic menunjukkan Sonnet 5.5 mengungguli Opus 5.5 pada agentic coding, dan dugaan TechCrunch adalah model yang lebih murah itu bisa menjalankan beberapa agent sekaligus tanpa melampaui batas biaya (TechCrunch). Tanggapi dengan skeptis seperlunya, sebab itu tes dari vendor sendiri dan penjelasannya hanya inferensi seorang reporter. Namun mekanismenya masuk akal dan bisa Anda tiru. Uang membeli percobaan paralel, dan beberapa percobaan plus satu pemeriksaan sering mengalahkan satu percobaan mahal.
Itu menjadikan mid-tier tempat yang masuk akal bagi coding agent seperti Claude Code, Codex in ChatGPT, Cursor, Gemini CLI, dan GitHub Copilot, di mana loop yang panjang melipatgandakan setiap tambahan dolar per juta token. Flagship tetap berguna, tetapi di wilayah yang lebih sempit. Satu catatan tandingan: dokumentasi model Anthropic sendiri menyarankan mulai dari Opus 5.5 untuk sebagian besar beban kerja, lalu naik ke Fable 5.1 hanya ketika eval pada effort lebih tinggi tidak memuaskan (Anthropic models overview). Dengan harga $4 dan $20, Opus 5.5 tidak lagi dibanderol seperti barang mewah, jadi anggap ia batas atas rentang rutin Anda dan uji Sonnet 5.5 sebagai pembandingnya.
Routing berdasarkan volume, kompleksitas, risiko, dan latensi
Empat pertanyaan cukup untuk menempatkan hampir semua tugas. Ajukan dalam urutan ini dan berhenti begitu salah satunya memberi jawaban yang jelas.
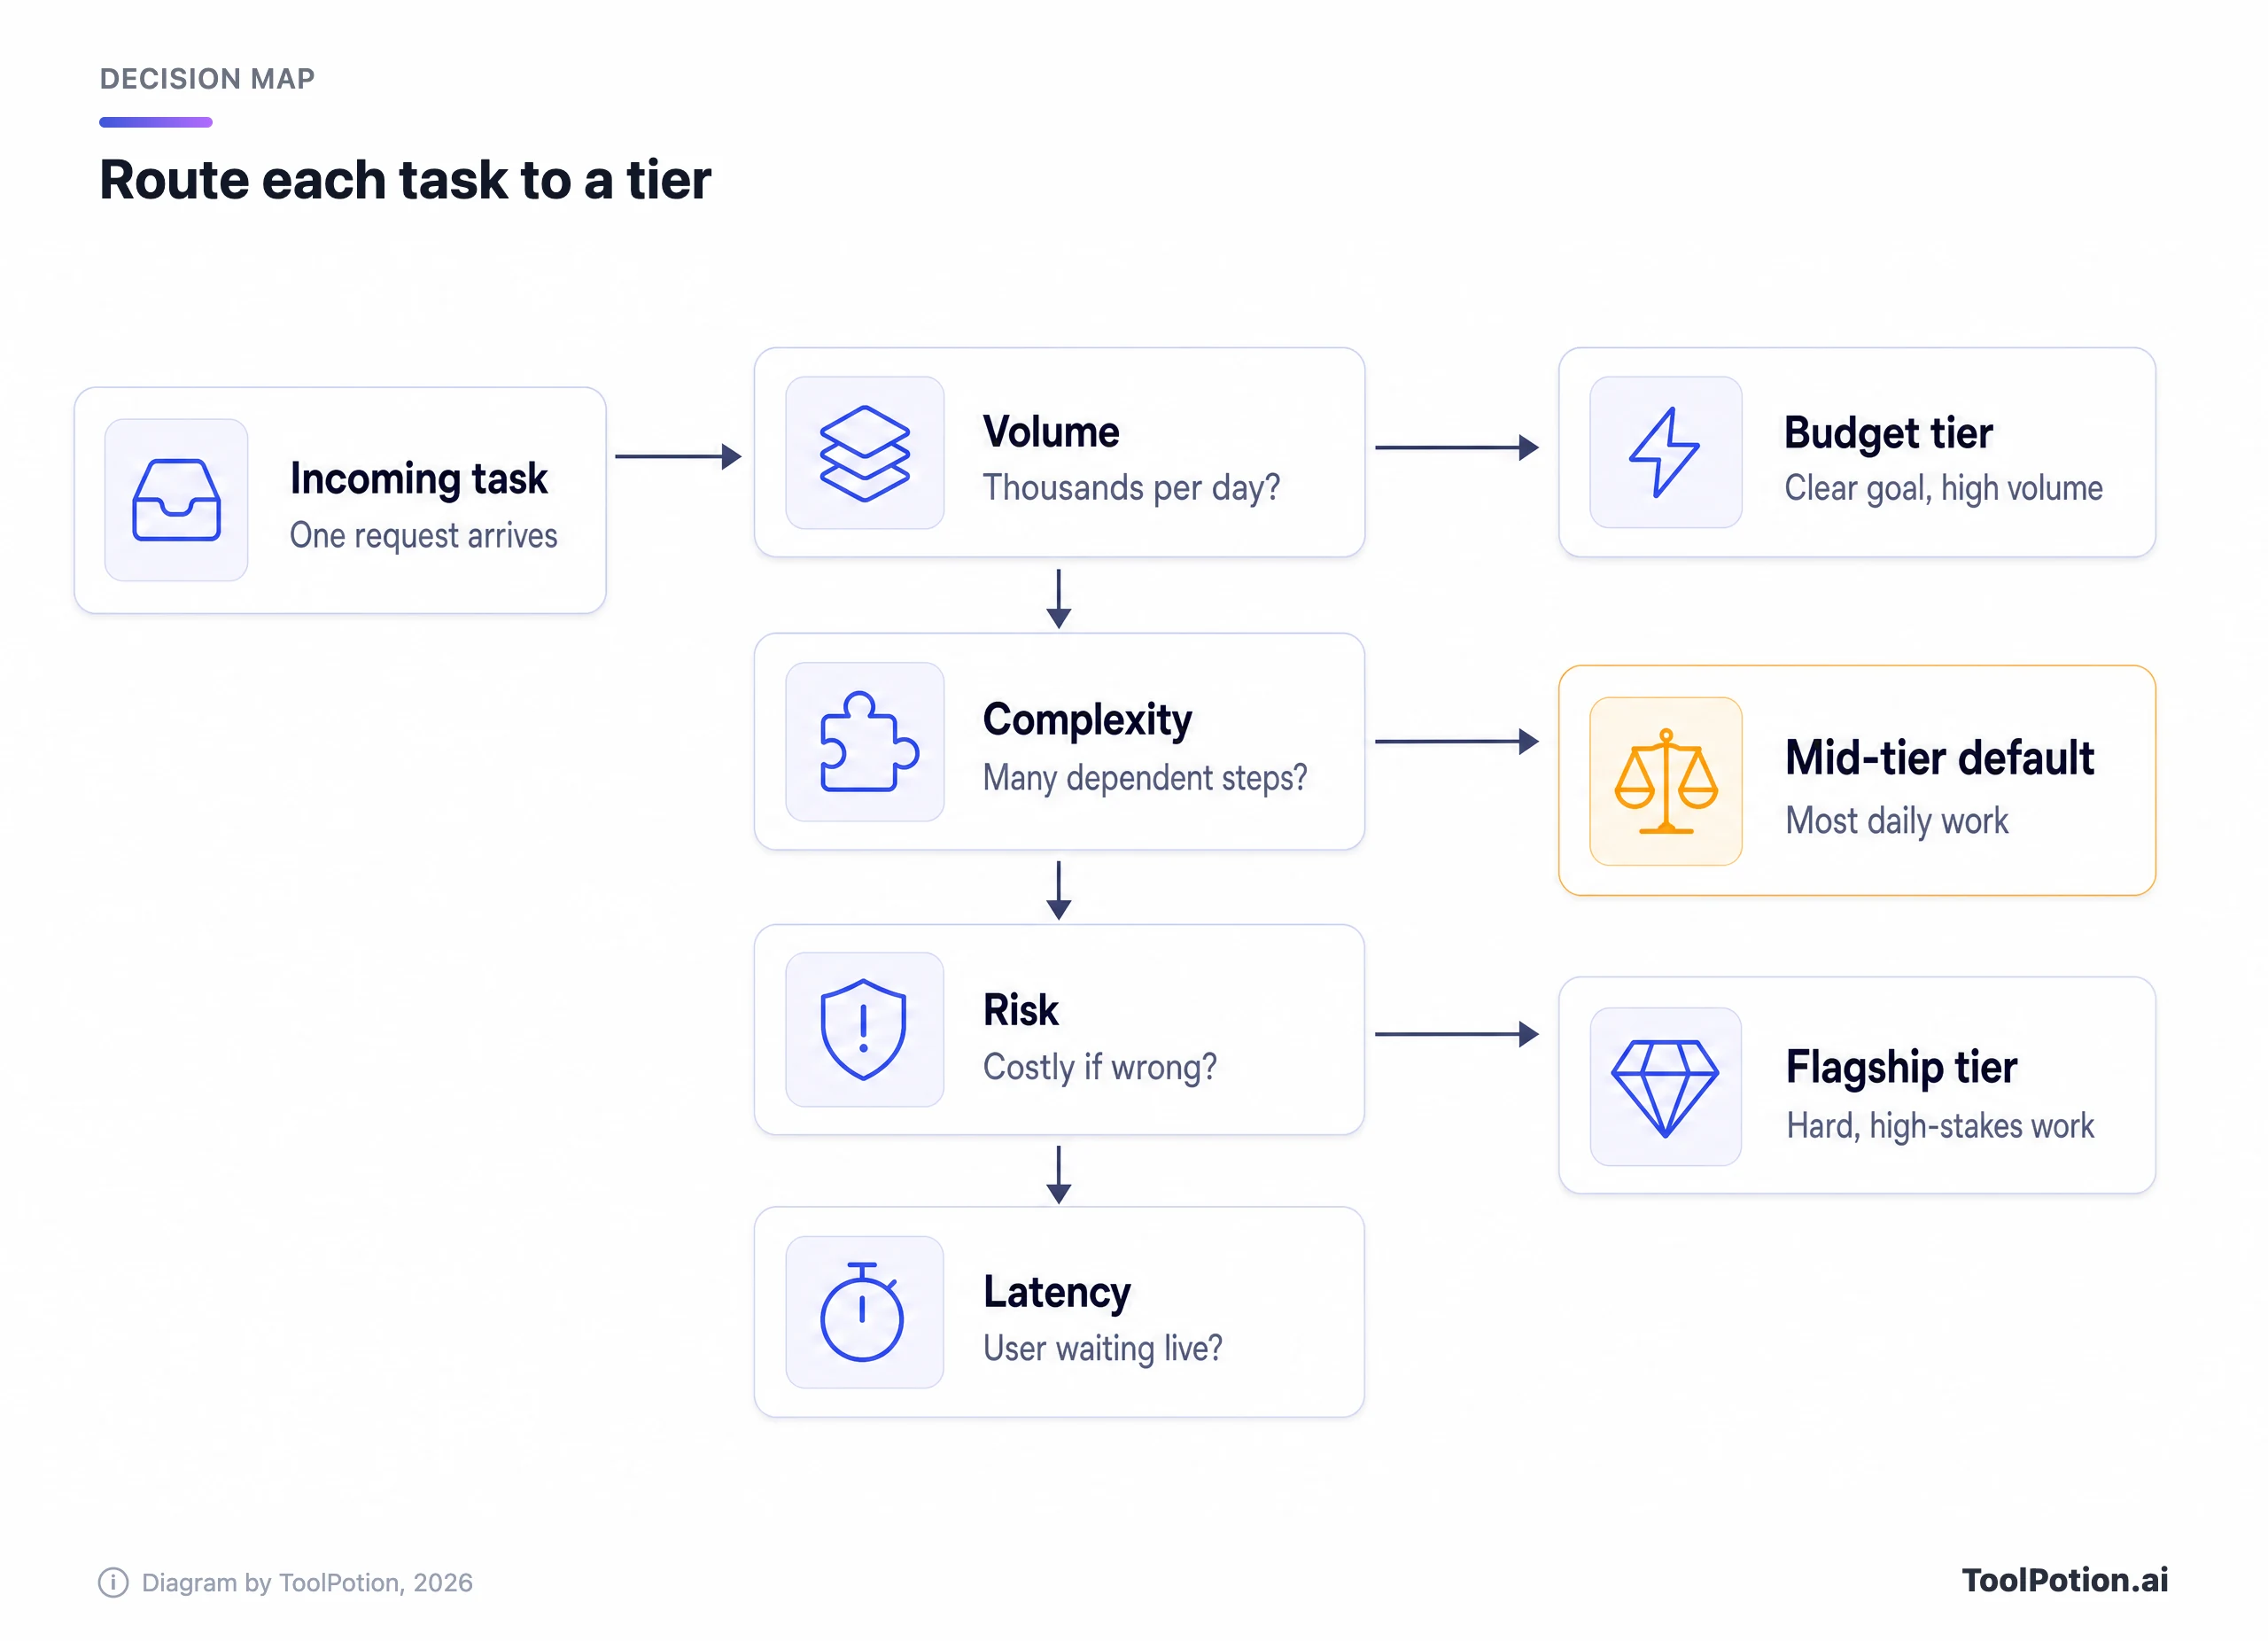
Volume didahulukan karena di situlah uangnya. Tugas yang berjalan ribuan kali sehari dengan tujuan jelas dan pemeriksaan yang mudah cocok untuk tingkatan budget. OpenAI menggambarkan Luna dibuat persis untuk pekerjaan semacam itu, dan Anthropic memosisikan Haiku sebagai model terkecilnya.
Kompleksitas menentukan apakah tingkatan budget sanggup menanganinya. Rantai langkah yang saling bergantung, instruksi yang samar, dan codebase besar mendorong Anda naik ke mid-tier. Risiko kemudian menentukan seberapa jauh naiknya. Kalau jawaban yang salah berarti kerugian uang, risiko hukum, atau hilangnya pelanggan, flagship adalah asuransi murah untuk panggilan spesifik itu. Latensi jadi penentu terakhir. Orang yang menunggu balasan langsung mungkin lebih peduli pada kecepatan daripada peningkatan kualitas yang tipis, dan Anthropic menyebut Sonnet 5.5 berjalan 30% lebih cepat dari pendahulunya.
Aturan default, naikkan, turunkan
Jadikan itu kebijakan tertulis supaya tidak ada yang berdebat soal ini di setiap pull request.
- Jadikan mid-tier sebagai default untuk setiap tugas baru.
- Turunkan tugas ke tingkatan budget hanya jika tujuannya jelas, volumenya tinggi, dan Anda bisa memeriksa output secara otomatis.
- Naikkan tugas ke tingkatan flagship hanya jika kesalahan mahal harganya atau mid-tier gagal dalam pemeriksaan pada contoh nyata.
- Tinjau ulang penugasan setiap kali sebuah lab merilis tingkatan baru, yang pada 2026 berarti setiap beberapa minggu.
Naikkan saat gagal, turunkan saat stabil
Penugasan statis cepat basi. Loop routing mengatasinya, dan tidak butuh infrastruktur besar. Anda memerlukan first pass yang murah, cara memverifikasi, dan aturan untuk kondisi gagal.
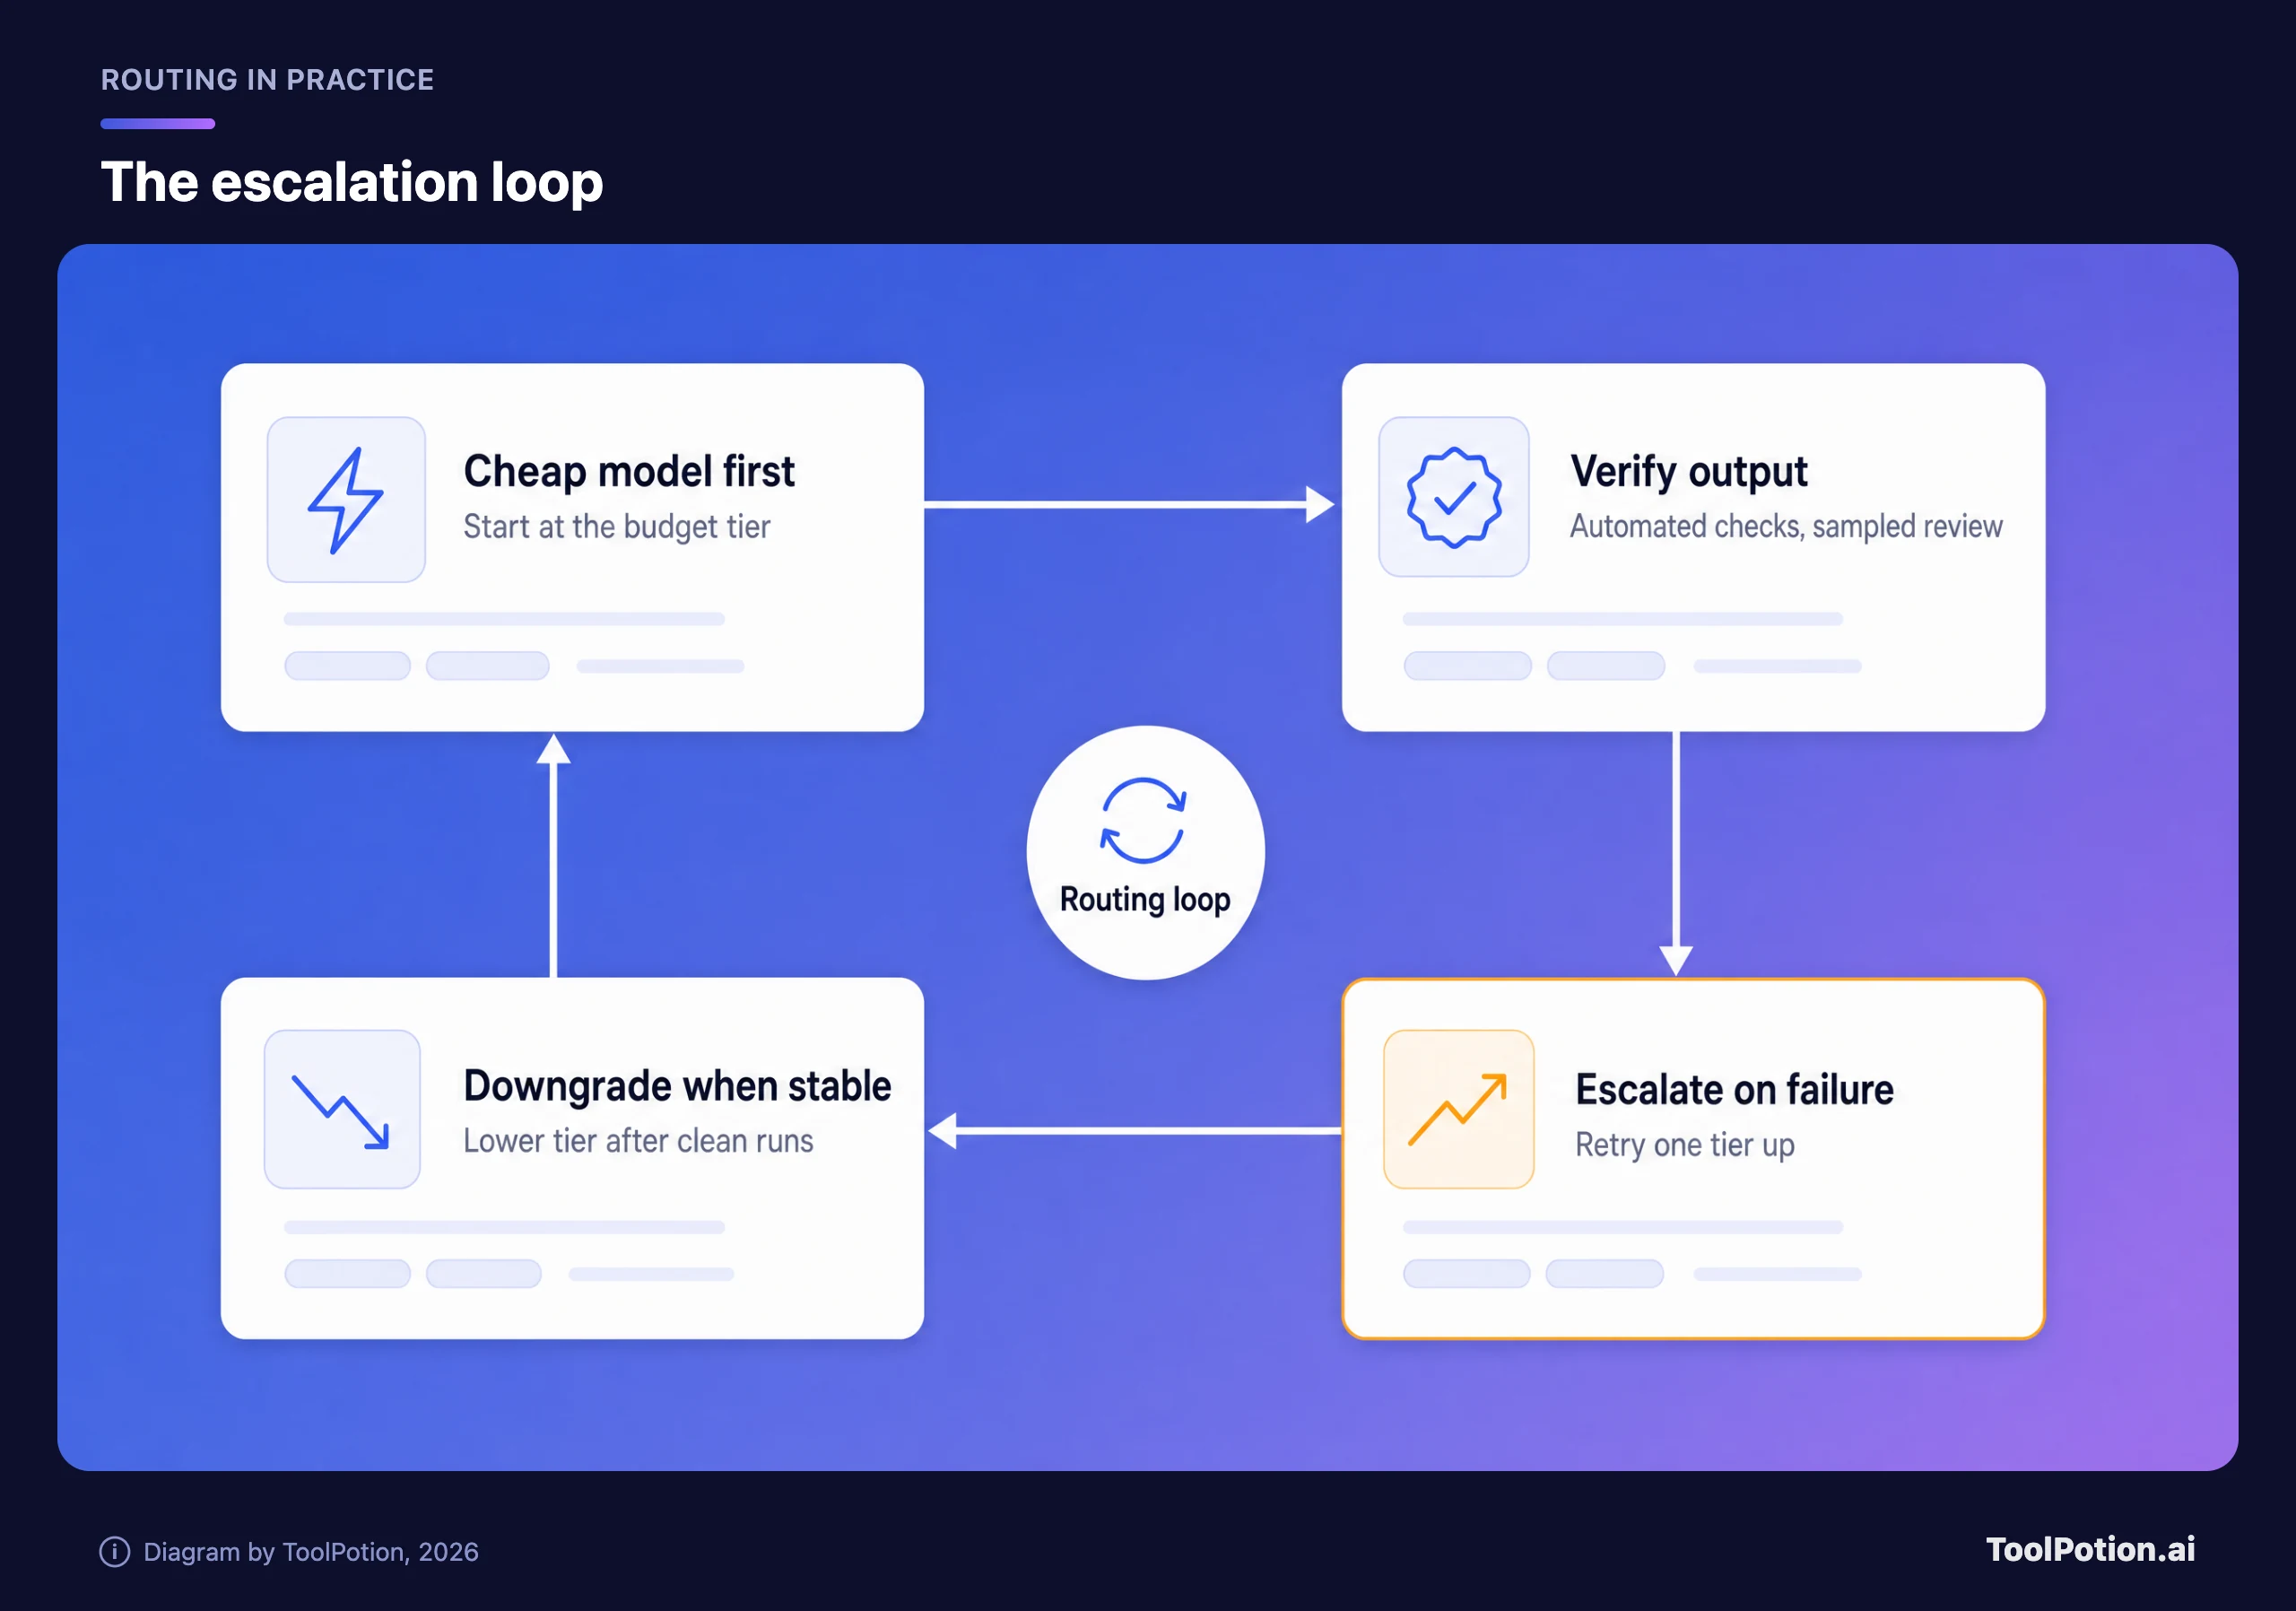
Verifikasi adalah bagian yang sering dilewati tim. Untuk output terstruktur mudah: validasi JSON schema, cek bahwa field hasil ekstraksi muncul di sumbernya, jalankan unit test. Untuk teks bebas lebih sulit, jadi ambil sampel kecil untuk ditinjau manusia dan pantau tingkat kegagalannya, bukan setiap output. Model juga bisa menilai hasil model lain, tetapi penilainya berisik, jadi gunakan untuk menandai kandidat bagi manusia, bukan untuk menyetujuinya.
Ketika pemeriksaan gagal, coba ulang sekali satu tingkat di atasnya. Catat kegagalan dan jenis tugasnya. Setelah serangkaian proses yang bersih, coba tingkatan di bawahnya pada sebagian kecil trafik dan lihat apakah tingkat kegagalannya bertahan. Begitulah cara Anda mengetahui, dengan data sendiri, tugas mana yang benar-benar sanggup ditangani tingkatan budget. Benchmark vendor tidak bisa memberi tahu Anda hal itu.
Satu catatan soal biaya. Retry juga memakan biaya. Kalau lebih dari sebagian kecil panggilan di tingkatan murah naik tingkat, Anda membayar dua kali dan loop-nya merugi. Pantau tingkat eskalasi. Kalau terus naik, tugas itu seharusnya ditempatkan satu tingkat lebih tinggi secara permanen.
Di mana tugas-tugas umum mendarat
Penempatan di bawah ini bersifat editorial, bukan benchmark. Ia mencerminkan logika volume dan kemampuan di atas, dan Anda sebaiknya menggeser titik mana pun yang bertentangan dengan hasil tes Anda sendiri.
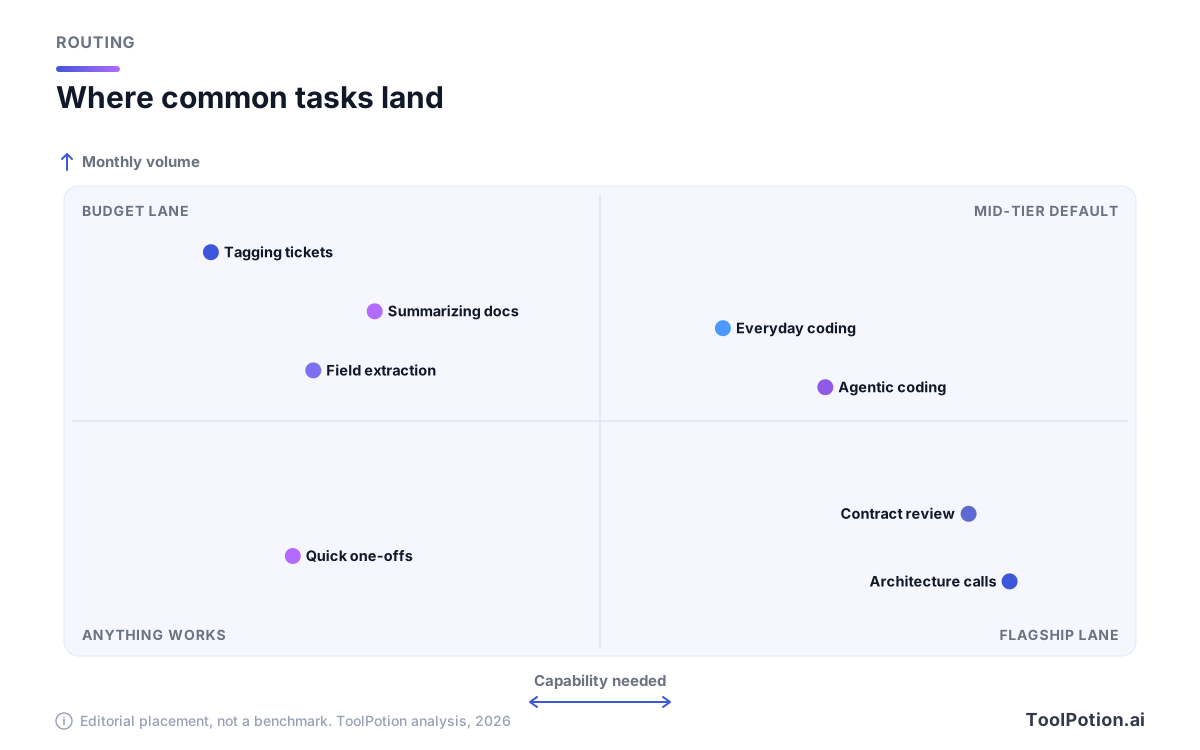
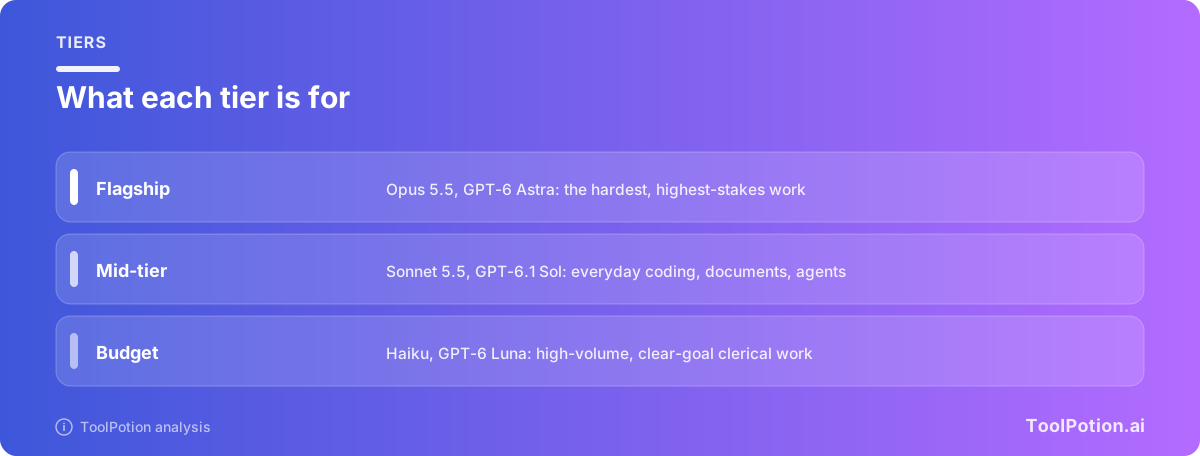
Beberapa hal spesifik perlu dijelaskan. Tagging, ekstraksi field, dan ringkasan adalah pekerjaan klasik tingkatan budget, dan para lab memasarkan tingkatan termurahnya untuk itu. Coding sehari-hari dan penyusunan dokumen masuk mid-tier. Review kontrak, keputusan arsitektur, dan apa pun yang jawaban salahnya mahal membenarkan flagship, meski di sini pun Anda bisa memakainya sebagai reviewer, bukan penulis.
| Tugas | Mulai dari | Naikkan saat | Alasan |
|---|---|---|---|
| Tagging dan pelabelan tiket | Budget | Lebih dari beberapa persen gagal validasi | Volume tinggi, jawaban jelas, mudah diperiksa |
| Ringkasan dokumen | Budget atau mid | Ringkasan melewatkan fakta penting saat spot check | Risiko per item rendah, total volume besar |
| Balasan ke pelanggan | Mid | Kesalahan nada atau kebijakan sampai ke pelanggan | Kesalahan terlihat, volume sedang |
| Coding sehari-hari | Mid | Tes gagal setelah dua percobaan | Mid-tier adalah titik terbaik untuk agent |
| Agent multi-langkah | Mid, dengan batas | Langkah verifikasi gagal | Percobaan paralel dengan batas biaya |
| Kontrak, keuangan, keselamatan | Flagship | Jarang, tambahkan review manusia sebagai gantinya | Kesalahan mahal harganya |
Hitung angka Anda sendiri
Berikut perhitungan untuk satu lab, memakai tarif Anthropic yang dikutip di atas. Masukkan pengeluaran Anda jika semuanya di Opus 5.5, lalu geser pekerjaan turun ke Sonnet 5.5 dan Haiku 4.5. Pengeluaran dan kedua persentase bisa Anda ubah sendiri. Tarifnya tetap, dan karena Sonnet 5.5 persis setengah Opus 5.5 baik di input maupun output sedangkan Haiku 4.5 seperempatnya, hasilnya tidak bergantung pada rasio input/output Anda.
Pada nilai default, tim yang menghabiskan $3.600 sebulan untuk Opus 5.5 di semua pekerjaan turun menjadi sekitar $2.070 dengan memindahkan 40% pekerjaan ke Sonnet dan 30% ke Haiku (30% dari $3.600 tetap harga penuh, 40% setengah harga, 30% seperempat harga). Itu penghematan sekitar 43%, dengan 30% trafik tersulit tetap di flagship. Tagihan nyata akan berbeda karena caching, diskon batch, dan retry semuanya mengubah hitungan, jadi anggap ini alat untuk memperkirakan skala.
Kalau Anda belum yakin harus mulai dari mana untuk tugas tertentu, decision tree di bawah mengajukan tiga pertanyaan singkat.
Paket berbasis seat mengubah pertanyaannya
Semua di atas mengasumsikan Anda membayar per token. Kalau tim Anda membayar per seat untuk aplikasi chat atau alat coding, labnya yang menentukan tingkatan untuk Anda, dan tuas yang Anda punya berbeda. Anthropic menaikkan batas pemakaian lima jam pada paket Pro, Max, Team, dan Enterprise berbasis seat bersamaan dengan peluncuran Opus 5.5 (Anthropic). Dalam praktiknya, pengguna seat sebaiknya memilih opsi mid-tier di model picker untuk pekerjaan rutin, menyimpan flagship untuk sesi yang sulit, dan memeriksa bagaimana batas pemakaian paket mereka memperlakukan tiap model.
Kalau Anda tidak yakin model penagihan apa yang dipakai alat-alat Anda, panduan model harga alat AI kami menjelaskan kredit, seat, dan token. Gateway seperti OpenRouter layak dilirik kalau Anda ingin satu integrasi yang bisa berganti tingkatan dan lab tanpa mengubah kode, karena seluruh gagasan routing bergantung pada kemudahan berpindah.
Kesalahan yang membuat tagihan tetap tinggi
- Memilih tingkatan berdasarkan kesetiaan pada merek dan tidak pernah menguji ulang setelah ada rilis baru.
- Menilai sebuah tingkatan dari satu contoh sulit, bukan sampel trafik nyata Anda.
- Mengirim konteks panjang ke flagship padahal model yang lebih murah dengan retrieval sudah cukup.
- Melewatkan caching. Anthropic menetapkan cache read Opus 5.5 sebesar $0,20 per juta token, yang penting untuk loop agent yang mengirim ulang konteks yang sama.
- Menganggap benchmark vendor sebagai ramalan hasil Anda sendiri.
Prompt juga berpengaruh. Prompt yang disusun baik memungkinkan tingkatan yang lebih murah menyelesaikan tugas yang oleh prompt asal-asalan didorong ke atas, dan tulisan kami tentang pola prompt yang tahan pembaruan model membahas cara menjaga pekerjaan itu tetap portabel. Untuk gambaran lebih luas tentang model yang tersedia, lihat perbandingan top AI models dan LLM kami dan papan live Top 20 LLMs. Kalau Anda lebih butuh asisten chat daripada API, papan AI chatbots dan panduan top AI chatbots kami membahas sisi itu, sementara papan AI coding assistants dan rangkuman coding assistants melakukan hal yang sama untuk developer. Kalau Anda menimbang menjalankan model sendiri, local AI vs cloud AI membahas kapan hal itu sepadan.
Pertanyaan yang sering diajukan
Model AI mana yang sebaiknya saya pakai kalau hanya boleh memilih satu?
Pilih mid-tier dari lab mana pun yang sudah dipakai stack Anda. Model sekelas Sonnet 5.5 atau GPT-6.1 Sol menangani rentang pekerjaan terluas dengan biaya moderat, dan Anda bisa menambah tingkatan yang lebih murah atau lebih kuat nanti jika data membenarkannya.
Apakah flagship pernah layak dibayar?
Ya, pada sekumpulan kecil panggilan di mana kesalahan mahal harganya atau mid-tier gagal dalam pemeriksaan pada contoh nyata. Ia alat presisi, bukan default.
Bisakah model mid-tier mengalahkan flagship?
Benchmark Anthropic menunjukkan Sonnet 5.5 unggul atas Opus 5.5 pada agentic coding. Itu hasil dari vendor pada satu jenis tugas, jadi uji dulu pada pekerjaan Anda sendiri sebelum memindahkan alur kerja yang kritis.
Haruskah saya menunggu Haiku 5.5 atau Gemini 4 Argon?
Jangan menunggu keduanya. Anthropic menyatakan Haiku 5.5 akan hadir dalam beberapa minggu ke depan, dan Google membatasi Argon untuk pembela siber tepercaya untuk sementara serta belum membukanya secara umum. Bangun lapisan routing agar tingkatan baru cukup berupa perubahan konfigurasi, lalu jalankan ulang tes Anda saat keduanya rilis.
Bagaimana saya tahu tingkatan yang lebih murah sudah cukup baik?
Jalankan pada sampel input nyata, terapkan pemeriksaan otomatis, dan bandingkan tingkat kegagalannya dengan tingkatan di atasnya. Kalau selisihnya kecil dan tugasnya berisiko rendah, turunkan. Kalau kegagalan sampai ke pelanggan, jangan.
Apakah harga ini berlaku untuk langganan chat?
Tidak. Ini tarif API per juta token. Paket chat dan alat coding ditagih per seat atau dengan batas pemakaian, jadi penghematan datang dari memilih model yang lebih ringan untuk sesi rutin.