

Pola rekayasa prompt yang bertahan melewati pembaruan model adalah yang membawa informasi yang tidak bisa disimpulkan model: role yang menetapkan audiens, konteks yang tidak dimilikinya, task dengan aturan keputusan, dan kontrak output yang ditegakkan di luar prompt. Sisanya adalah folklor dengan masa kedaluwarsa.
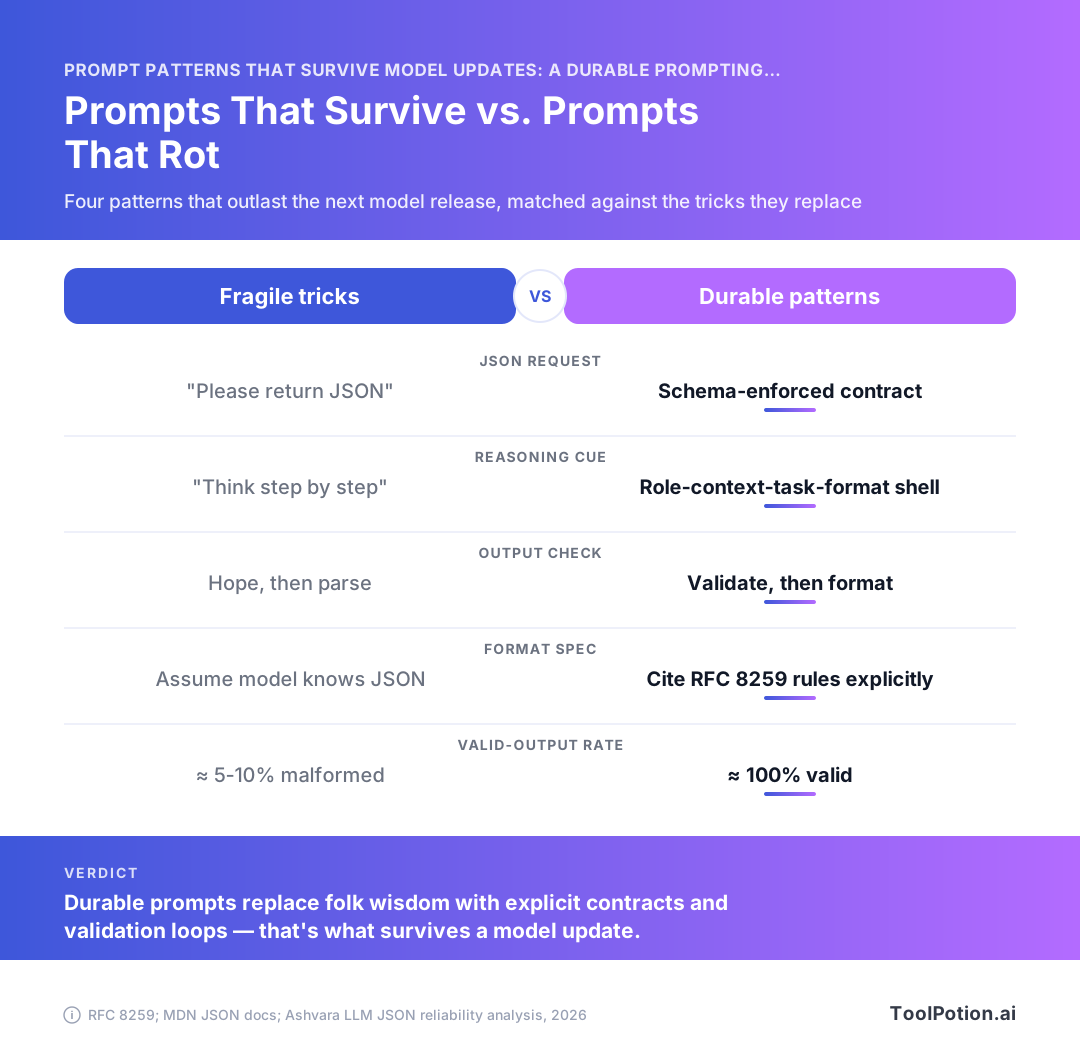
Perbedaannya paling jelas terlihat pada JSON. Meminta model dengan sopan untuk menghasilkan JSON masih menghasilkan sekitar 5-10% output yang cacat, JSON mode membawa angka itu ke sekitar 95-99% valid, dan decoding yang dibatasi schema secara efektif 100% (Ashvara). Maksud yang sama, tiga lapisan penegakan, tingkat kegagalan yang sangat berbeda pada hari rilis.
Panduan ini mencakup empat pola yang terus bekerja di seluruh Claude, GPT, dan Gemini; trik-trik rapuh yang layak dihapus dari perpustakaan Anda; dan rangkaian eval kecil yang mengubah rilis model berikutnya menjadi sebuah diff alih-alih insiden.
Mengapa prompt membusuk: mode kegagalan yang tidak pernah diberi versi
Prompt tidak membusuk secara acak. Mereka membusuk di sepanjang garis yang bisa diprediksi: bagian yang bergantung pada perilaku model tertentu akan dibatalkan oleh checkpoint berikutnya, dan bagian yang menyatakan apa yang Anda inginkan akan bertahan.
Dua jenis prompt: yang mendeskripsikan maksud dan yang mengeksploitasi keanehan
Prompt berbasis maksud mengatakan apa yang harus ada dalam output, siapa yang membacanya, dan apa yang dianggap salah. Prompt berbasis keanehan mengatakan apa pun yang kebetulan berhasil minggu lalu. ONLY RETURN JSON dengan huruf kapital semua. Pengulangan instruksi yang sama tiga kali karena dua kali tidak cukup. Pembukaan ajaib yang disalin dari thread forum. Trik-trik itu disetel terhadap perilaku decoding satu checkpoint, dan tidak ada yang di dalamnya memberi tahu model masa depan apa yang sebenarnya Anda butuhkan.
Prompting "tolong kembalikan JSON" yang naif masih menghasilkan estimasi 5-10% output yang cacat (Ashvara), dan angka itu merupakan properti model, bukan prompt Anda. Ganti modelnya dan angkanya bergerak. Anda tidak pernah menuliskan kontraknya, jadi Anda tidak punya dasar untuk memegang model baru ke standar yang sama.
Apa yang sebenarnya rusak pada hari rilis
Kerusakannya jarang keras. Parser Anda mulai lempar error pada trailing comma (sekitar 40% dari kesalahan JSON dalam satu analisis berasal dari hal itu, Flying Fish Space), atau model menjadi lebih percakapan dan membungkus output bersih dalam kalimat pembuka. Sementara itu laju rilis model baru berarti checkpoint yang Anda setel mungkin bukan yang melayani traffic kuartal depan.
Bandingkan dengan panggilan yang dibatasi schema, di mana generasi dibatasi pada bentuk yang Anda suplai dan validitas sintaksis hampir 100% (Ashvara). Penegakan itu hidup di luar teks prompt. Pembaruan model bisa mengubah nada, verbositas, dan kedalaman penalaran tanpa menyentuhnya.
Uji ketahanan: apakah prompt ini masih masuk akal untuk model yang lebih cerdas?
Satu pertanyaan, ditanyakan untuk setiap prompt yang Anda miliki: jika model menjadi dua kali lebih mampu dalam semalam, apakah instruksi ini masih melakukan pekerjaan yang berguna?
"Kembalikan objek dengan kunci id, status, dan confidence, di mana status adalah salah satu dari tiga nilai literal" lolos. RFC 8259 sudah mematok kosakata yang Anda pinjam: empat tipe primitif, dua tipe terstruktur, dan tepat tiga nama literal huruf kecil (RFC 8259). Instruksi itu dapat dibaca oleh model mana pun, sekarang atau nanti. "Tarik napas dalam-dalam dan pikirkan langkah demi langkah" gagal, karena itu mengkompensasi kelemahan yang mungkin tidak dimiliki rilis berikutnya. Hapus kompensasinya dan pertahankan kontraknya.
Pola rekayasa prompt yang dapat ditransfer: role, context, task, format
Restrukturisasi setiap prompt ad-hoc ke dalam empat slot, dan masukkan hanya informasi yang tidak dapat disimpulkan model ke dalam masing-masing. Role, context, task, format. Shell ini bertahan melewati pembaruan model karena setiap slot membawa fakta tentang masalah Anda, bukan folklor tentang bagaimana checkpoint kuartal lalu merespons sanjungan.
Empat slot dan apa yang seharusnya ada di dalamnya
Role adalah untuk siapa output itu dan keahlian apa yang diasumsikan jawabannya. "Anda adalah pakar kelas dunia" menetapkan suasana hati dan tidak membawa informasi. "Anda menulis untuk engineer pembayaran yang sudah tahu apa itu kunci idempotency" memberi tahu model penjelasan mana yang bisa dilewati.
Context adalah semua yang tidak mungkin diketahui model: schema, sistem upstream, edge case yang sudah Anda temui di produksi, fakta bahwa parser Anda menolak UTF-8 BOM. Task adalah satu kata kerja dan objeknya. Format adalah kontrak output, dan harus cukup spesifik untuk divalidasi secara mekanis.
Slot format yang hanya mengatakan "kembalikan JSON" adalah sebuah harapan. Slot format yang menamai kunci-kuncinya, tipenya, dan apa yang terjadi saat nilai tidak diketahui adalah kontrak yang dapat Anda uji. JSON memberi Anda empat tipe primitif (string, number, boolean, null) dan dua tipe terstruktur, object dan array (RFC 8259), sehingga ada kosakata kecil yang terbatas untuk digunakan secara presisi. Katakan null daripada "biarkan kosong", karena nama literal true, false, dan null adalah huruf kecil dan tidak ada yang lain yang legal (RFC 8259).
Mengapa shell ini bisa ditransfer ke Claude, GPT, dan Gemini
Tidak ada dalam keempat slot yang bergantung pada tokenizer, keanehan system-prompt, atau feature flag provider. Setiap model harus diberi tahu bidang mana yang Anda inginkan dan apa yang dilakukan kode downstream Anda dengan field tersebut, sehingga shell yang sama masuk ke Claude, GPT, dan Gemini tanpa penulisan ulang. Portabilitas itu juga yang membuatnya dapat di-upgrade: saat checkpoint baru dikirim, slot context masih benar dan slot format masih merupakan kontrak yang ditegakkan oleh validator Anda. Anda menukar modelnya, menjalankan ulang eval, dan diff-nya kosong.
Sebagian besar dari 212 alat rekayasa prompt yang menemplat struktur ini di direktori kami menjual slot-slot itu sebagai sebuah formulir. Anda bisa mendapatkan efek yang sama dengan heredoc dan empat komentar.
Menulis batasan sebagai fakta, bukan mantra
Ada uji untuk menentukan apakah sebuah baris layak masuk dalam prompt Anda: bisakah kontraktor yang kompeten bertindak berdasarkannya tanpa mengajukan pertanyaan lanjutan? "Jadilah menyeluruh" gagal. "Nama properti menggunakan tanda kutip ganda, tidak ada trailing comma setelah elemen terakhir" lolos, dan itu memetakan ke mode kegagalan nyata, karena trailing comma saja menyumbang sekitar 40% dari kesalahan JSON dalam satu analisis (Flying Fish Space).
Sebuah mantra berhenti mendapatkan tokennya tanpa pernah gagal dengan keras, sementara fakta yang dinyatakan mempertahankan maknanya di setiap checkpoint yang Anda tunjuk padanya.
Penulisan ulang before/after yang dikerjakan
| Sebelum (ad-hoc) | Sesudah (empat slot) |
|---|---|
| "Anda adalah analis data ahli. Ekstrak detail faktur dengan cermat dan kembalikan JSON. Jadilah akurat!" | Role: output dikonsumsi oleh panggilan json.loads Python, tidak ada manusia yang membacanya. Context: faktur adalah PDF hasil OCR; nama vendor sering terpotong; jumlah mungkin mengandung simbol mata uang. Task: ekstrak vendor, invoice_number, total_cents, issued_date. Format: satu objek JSON, kunci persis seperti yang tercantum, total_cents adalah integer tanpa leading zero, nilai yang tidak diketahui sebagai null, tidak ada prosa sebelum atau sesudahnya. |
Versi sesudah tidak mengatakan apa pun tentang kepribadian model dan mengatakan segalanya tentang data Anda. Perhatikan bahwa null dan {} keduanya JSON valid tetapi memiliki arti berbeda (Jsonic), jadi pilih salah satu dan tuliskan. Leading zero juga tidak legal dalam angka JSON (MDN), itulah mengapa slot format mengeja aturan integer secara eksplisit daripada mempercayai model untuk mengingat gramatikanya.
Scaffold few-shot yang disetel untuk transfer
Pilih contoh berdasarkan ambiguitas yang mereka selesaikan. Blok few-shot yang mendemonstrasikan empat kasus di mana manusia akan ragu mengajarkan sesuatu yang masih dibutuhkan model berikutnya. Blok yang menampilkan empat kasus mudah dalam gaya tertentu mengajarkan nada, dan nada adalah hal yang semakin baik ditebak oleh setiap checkpoint secara mandiri.
Contoh yang mengajarkan batas keputusan, bukan kosakata
Sebelum menempelkan contoh, tanyakan apa yang akan berubah jika Anda menghapusnya. Jika jawabannya adalah "outputnya terdengar sedikit kurang seperti kita," hapus. Jika jawabannya adalah "model akan mengklasifikasikan pengembalian dana dengan pengiriman parsial sebagai return bukan dispute," pertahankan, karena keputusan itu tidak dapat diturunkan dari deskripsi task.
Uji yang sama berlaku untuk bentuk output. Satu contoh yang menampilkan hasil kosong sebagai [] daripada null lebih berharga daripada lima contoh hasil yang terisi, karena array kosong dan null keduanya JSON valid dan memiliki arti berbeda (Jsonic). Model menebak secara berbeda untuk itu, dan satu contoh menyelesaikannya untuk selamanya.
Edge case dan negatif menghasilkan biaya token mereka
Dua atau tiga dari shot Anda harus berupa kasus yang pernah salah di produksi. Field yang hilang. Input yang sudah dalam format target. Rekaman di mana jawaban yang benar adalah "data tidak mencukupi" dan model yang membantu akan menciptakan nilai sebagai gantinya.
Negatif bekerja ketika Anda memasangkannya dengan koreksi daripada menyatakan larangan. Tampilkan output yang cacat dan yang sudah diperbaiki berdampingan, dan batasnya menjadi konkret. Instruksi bare "jangan gunakan tanda kutip tunggal" cepat usang, dan tanda kutip tunggal adalah salah satu pelanggar berulang di balik JSON yang cacat, bersama trailing comma, yang menyumbang sekitar 40% dari kesalahan dalam satu analisis (Flying Fish Space).
Berapa banyak shot, dan kapan harus turun ke nol
Mulailah dari nol. Tambahkan shot hanya saat kasus eval gagal, dan tambahkan contoh terkecil yang memperbaiki kasus itu. Sebagian besar prompt klasifikasi dan ekstraksi stabil antara tiga dan enam; di atas delapan Anda biasanya mengkompensasi deskripsi task yang tidak pernah Anda tulis dengan benar.
Turun ke nol kapan pun schema melakukan pekerjaan itu. Decoding terbatas terhadap schema yang disuplai memberi Anda hampir 100% JSON yang valid secara sintaksis (Ashvara), sehingga contoh format menjadi beban mati di sana. Pertahankan shot untuk penilaian, gunakan schema untuk struktur.
Bau overfitting: contoh yang akan ditiru model berikutnya terlalu harfiah
Perhatikan shot yang fitur permukaannya bersifat kebetulan. Jika setiap contoh input berisi sekitar 40 kata, model yang lebih kuat mungkin memperlakukan panjang sebagai sinyal. Jika semua empat contoh mendarat pada label yang sama, Anda telah membiaskan prior-nya. Jika contoh Anda menggunakan nama placeholder seperti Acme Corp, harapkan nama-nama itu muncul dalam output nyata pada akhirnya.
Jalankan ulang set few-shot Anda terhadap checkpoint baru pada minggu pertama rilis dan diff output pada kasus yang tidak dicakup oleh contoh. Di situlah imitasi bocor. Tim yang mempublikasikan tulisan deployment nyata cenderung menjaga set contoh di bawah version control untuk alasan ini: contoh yang tidak bisa di-diff adalah contoh yang tidak bisa dipensiunkan.
Kontrak output yang bertahan melewati model
Dorong penegakan ke bawah stack sampai format tidak lagi bergantung pada bagaimana checkpoint kebetulan berperilaku hari itu. Meminta JSON dengan sopan adalah tier terlemah yang tersedia, dan itulah yang masih dijalankan oleh sebagian besar kode produksi.
Tiga tier keandalan: permintaan prosa, JSON mode, decoding terbatas
| Tier | Cara Anda meminta | Apa yang dikembalikan |
|---|---|---|
| 1 | "Tolong kembalikan JSON" dalam teks prompt | Estimasi 5-10% output cacat (Ashvara) |
| 2 | JSON mode provider diaktifkan | Sekitar 95-99% valid secara sintaksis dalam observasi produksi (Ashvara) |
| 3 | Generasi dibatasi pada schema yang disuplai | Hampir 100% valid secara sintaksis (Ashvara) |
Ambil tier 3 di mana pun provider Anda mendukungnya. Validitas kemudian berasal dari decoder bukan dari bobot, sehingga penggantian model tidak bisa meregresinya. Tetap pertahankan kontrak di level prompt, karena decoding terbatas menjamin bentuk dan tidak mengatakan apa pun tentang apakah nilainya benar. Jika Anda tidak ingin menulis pipa-nya, framework yang membungkus penegakan schema di direktori kami berjumlah 128 entri.
Apa yang harus ditetapkan kontrak di luar "kembalikan JSON"
Namai kunci-kuncinya, tipe di balik setiap kunci, dan perilaku saat model tidak punya nilai untuk diletakkan di sana.
- Setiap kunci dieja persis seperti yang diharapkan parser Anda, dengan tipe yang diambil dari enam tipe JSON: empat primitif (string, number, boolean, null) dan dua tipe terstruktur, object dan array (RFC 8259).
- Hanya literal huruf kecil. Gramatikanya mengizinkan tepat tiga: false, null, true (RFC 8259).
- Nama kunci unik di dalam setiap object, yang RFC 8259 rekomendasikan agar setiap parser menyepakati pemetaan nama-nilai yang sama.
- Apakah kunci opsional dihapus atau diterbitkan dengan nilai null, dan enum apa pun yang Anda harapkan, ditulis sebagai string literal.
Mode kegagalan yang layak dikodekan: trailing comma, tanda kutip tunggal, string yang tidak di-escape
Satu analisis menempatkan trailing comma pada sekitar 40% dari semua kesalahan JSON, dengan tanda kutip tunggal, tanda kutip yang tidak di-escape di dalam string, koma yang hilang, dan karakter UTF-8 BOM tersembunyi mencakup sebagian besar sisanya (Flying Fish Space). Lima kegagalan itu mungkin hanya membutuhkan 25 token untuk secara eksplisit dilarang dalam slot format, dan larangan itu tetap benar di setiap model yang pernah Anda tunjuk padanya. Padukan dengan langkah validate-then-format di sisi Anda daripada mempercayai string-nya (QuickTinyData).
Object kosong, array kosong, null: tiga jawaban berbeda
Di sinilah kontrak bocor antara versi model tanpa ada yang menyadarinya. Object kosong dan array kosong keduanya JSON valid, dan keduanya memiliki arti berbeda dari null (Jsonic). Satu checkpoint mengembalikan [] untuk tidak ada hasil, yang berikutnya mengembalikan null, dan kode downstream Anda memperlakukan salah satunya sebagai error.
Pilih representasinya, nyatakan dalam kontrak, dan validasilah. Parser Anda juga perlu bertahan dari nilai bare di level teratas, karena nilai JSON tunggal apa pun dihitung sebagai dokumen lengkap, termasuk string mandiri atau angka 42 (Jsonic).
Trik-trik rapuh yang mati dengan setiap rilis
Buka perpustakaan prompt Anda dan cari empat pola ini. Setiap temuan adalah kandidat untuk dihapus, karena masing-masing mengkompensasi kelemahan model yang sudah diperbaiki atau dipindahkan.
"Pikirkan langkah demi langkah" generik sebagai tambalan
Menambahkan "pikirkan langkah demi langkah" ke prompt masuk akal ketika model langsung melompat ke jawaban. Model reasoning saat ini sudah menguraikan secara default, sehingga frasa itu menambahkan token dan kadang menyeret task klasifikasi pendek menjadi tiga paragraf narasi yang kemudian harus Anda hapus.
Pertahankan instruksi penalaran hanya jika spesifik untuk task: "daftarkan klausa yang bertentangan sebelum Anda memilih satu" memberi tahu model apa yang harus dinalar. Pengganti yang tahan lama adalah slot task dari shell role-context-task-format Anda, yang mengeja artefak perantara yang Anda inginkan. Mantra generik masuk ke tempat sampah.
Ancaman, suap, dan tekanan roleplay
"Anda akan dipecat jika salah." "Saya akan memberi Anda tip $200." "Anda adalah analis terhebat di dunia." Ini bersandar pada keanehan checkpoint RLHF tertentu, dan keanehan tidak bertahan dari retraining. Yang lebih buruk, mereka tidak bisa difalsifikasi: Anda tidak bisa menulis tes yang membuktikan tip-lah yang memperbaiki output Anda, sehingga barisnya tetap ada dalam prompt selamanya, tanpa dipertanyakan.
Ganti tekanan dengan batasan. Rubrik yang model nilai sendiri, atau daftar eksplisit tentang apa yang dianggap gagal, melakukan pekerjaan yang sama dan terus bekerja saat checkpoint berubah.
Hack formatting yang melawan tokenizer
Mengisi prompt dengan tuntutan ALL CAPS, tanda seru tiga kali, atau rentang panjang delimiter seperti ##### adalah folklor. Bagian delimiter memiliki inti kebenaran (batas bagian yang jelas membantu), tetapi eskalasi tidak. Dua baris baru dan tag seperti XML mengalahkan empat puluh tanda hash.
Sama untuk "no code fences, no preamble, no explanation, output ONLY JSON" yang ditumpuk tiga cara. Katakan sekali dalam slot format dan kemudian letakkan jaminan di tempat jaminan sebenarnya hidup: membatasi generasi ke schema yang disuplai adalah yang membawa Anda ke hampir 100% JSON yang valid secara sintaksis (Ashvara), dan tidak ada tumpukan larangan di sisi prompt yang mendekati angka itu.
Memohon di level prompt saat parser sudah cukup
Mode kegagalannya membosankan dan struktural: trailing comma setelah item terakhir, kunci tanpa tanda kutip, karakter tanda kutip yang tidak valid, koma yang hilang, kurung kurawal yang tidak sesuai (QuickTinyData). Trailing comma saja menyumbang sekitar 40% dari kesalahan JSON dalam satu dataset kesalahan (Flying Fish Space), dan dilarang oleh format itu sendiri (MDN). Tidak ada jumlah permohonan yang bisa menutup celah itu.
Hapus permohonan itu. Letakkan schema dan validator di sana, dan biarkan prompt mengatakan apa yang dimaksud oleh field-field tersebut.
Loop eval memperlakukan prompt sebagai artefak yang diberi versi
Bangun dua puluh kasus uji sebelum Anda membangun apa pun yang canggih. Prompt tanpa set eval adalah prompt yang tidak bisa Anda upgrade, karena Anda tidak punya cara untuk mengetahui apakah model baru membuatnya lebih baik atau merusak satu kasus yang penting bagi pelanggan terbesar Anda tanpa memberi tahu Anda.
Dua puluh bukan angka kompromi. Cukup untuk menangkap kelas kegagalan yang sudah Anda ketahui, cukup kecil agar bisa Anda tulis dalam satu sore, dan cukup murah untuk dijalankan ulang di setiap checkpoint tanpa memikirkan tagihannya.
Eval minimum yang layak: 20 kasus, satu asersi masing-masing
Satu asersi per kasus, dan jadikan boolean: apakah output ter-parse, apakah mengandung field yang diperlukan, apakah ia menolak ketika seharusnya menolak. Rubrik, model juri, dan skor kemiripan bisa datang belakangan, setelah boolean sudah hijau. Kasus dengan tiga asersi berubah menjadi kasus yang tidak bisa Anda debug, dan run merah tidak memberi tahu Anda mana dari ketiganya yang rusak.
Pilih dua puluh Anda dari traffic nyata, berbobot ke ujung yang jelek. Lima happy path, lima input yang ambigu, lima yang adversarial atau kosong, lima yang pernah rusak di produksi pada suatu waktu. Simpan di sebelah prompt dalam repo yang sama, dalam commit yang sama. Jika prompt berubah dan kasusnya tidak, itu komentar review.
Validasi dulu, baru format: meminjam workflow debugging JSON
Dunia JSON sudah menyelesaikan argumen ini bertahun-tahun lalu. Panduan troubleshooting QuickTinyData merekomendasikan validasi dulu dan format kedua, karena pretty-printing dokumen yang rusak menyembunyikan kesalahan struktural yang sedang Anda cari: trailing comma, kunci tanpa tanda kutip, karakter tanda kutip yang salah, koma yang hilang, kurung kurawal yang tidak sesuai (QuickTinyData).
Jalankan eval Anda dengan cara yang sama. Tegaskan validitas sebelum Anda menegaskan kualitas. Output model yang gagal json.loads tidak boleh lanjut ke pemeriksaan semantik, dan tidak boleh mendapat kredit parsial. Suite eval Anda membutuhkan dua kolom, parse rate dan pass rate, dan yang kedua hanya menghitung baris di mana yang pertama berhasil.
Mengetahui distribusi kesalahan memberi tahu Anda apa yang harus ditegaskan. Satu analisis menempatkan trailing comma pada sekitar 40% dari kesalahan JSON, dengan tanda kutip tunggal, tanda kutip yang tidak di-escape di dalam string, koma yang hilang, dan karakter UTF-8 BOM tersembunyi menyusun sebagian besar sisanya (Flying Fish Space). Yang BOM itu layak mendapat asersi khusus, karena tidak terlihat di setiap editor yang akan Anda gunakan untuk memeriksa output.
Run regresi pada hari rilis
Checkpoint baru dikirim. Anda menjalankan dua puluh, Anda mendapatkan diff, Anda memutuskan. Itulah seluruh prosedurnya, dan ini membutuhkan sekitar empat menit jika Anda membangun suite dengan benar.
- Pin model lama dan jalankan ulang suite untuk mengonfirmasi baseline Anda masih dapat direproduksi. Jika tidak, masalahnya ada di pengaturan tes Anda, bukan di rilis tersebut.
- Jalankan suite terhadap checkpoint baru dan catat parse rate dan pass rate secara terpisah.
- Baca setiap kasus yang berubah, di kedua arah. Kasus yang mulai lulus bisa jadi keberuntungan, dan itu layak mendapat perhatian sebanyak regresi.
- Kirim, rollback, atau tambal prompt-nya. Kemudian commit angka baseline baru di sebelah file prompt.
Ini paling penting dalam stack agen di mana satu parse yang buruk berdampak berantai, karena kegagalan muncul tiga tool call kemudian sebagai sesuatu yang sama sekali tidak terlihat seperti bug formatting.
Pinning versi, dan apa yang harus dilakukan saat Anda tidak bisa
Pin ke ID model bertanggal di mana pun Anda bisa, dan perlakukan alias seperti dependensi mengambang yang Anda pilih untuk tidak dikunci. Beberapa provider tidak memberi Anda pin, atau akan mendepresiasi yang Anda gunakan dengan jendela pendek. Saat itu terjadi, suite eval Anda adalah yang berdiri di antara perubahan perilaku yang diam-diam dan tiket dukungan yang tidak bisa Anda reproduksi.
Jalankan suite secara terjadwal terhadap endpoint yang tidak di-pin. Mingguan sudah cukup. Anda akan menemukan drift sebelum pengguna Anda menceritakannya kembali kepada Anda dalam laporan bug.
Memporting satu prompt ke Claude, GPT, dan Gemini
Sekitar 80% dari prompt yang dibangun dengan baik dapat diporting tanpa perubahan. Sisanya adalah lapisan adapter yang Anda tulis sekali per provider dan kemudian sebagian besar dilupakan. Jika Anda menulis ulang semuanya untuk setiap vendor, prompt Anda membawa perilaku spesifik provider yang tidak pernah perlu dibawanya.
Apa yang tetap identik: shell, contoh, kontrak
Shell empat slot berpindah ke vendor dengan nol edit. Role, context, task, format mendeskripsikan pekerjaan, dan pekerjaan tidak berubah saat Anda mengganti checkpoint. Sama untuk blok few-shot Anda: contoh yang menyelesaikan ambiguitas nyata dalam domain Anda mengajarkan setiap model hal yang sama, karena ambiguitasnya ada dalam data Anda, bukan dalam decoder.
Kontrak output Anda juga tetap identik, dan memang harus begitu. Apa pun yang dikembalikan provider harus memenuhi parser yang sama: nama properti dengan tanda kutip ganda, tidak ada trailing comma, tidak ada NaN atau Infinity, dan hanya empat karakter whitespace legal (spasi, tab, line feed, carriage return) (MDN). Tulis schema sekali. Validasi ketiga output dengan validator yang sama, dan diff kegagalannya.
Pertahankan set eval Anda juga agar netral vendor. Dua puluh kasus yang lulus di Claude dan gagal di Gemini memberi tahu Anda sesuatu yang berguna. Dua puluh kasus yang ditulis terhadap keanehan Claude tidak memberi tahu Anda apa pun.
Apa yang Anda setel ulang per provider: bobot system-message, delimiter, enforcement API
Tiga hal mendapat adapter. Seberapa banyak instruksi Anda masuk ke system message versus user turn, karena provider membobot keduanya secara berbeda. Apa yang Anda gunakan untuk memisahkan blok, tag seperti XML atau header markdown. Dan enforcement API mana yang Anda panggil.
Yang terakhir itu adalah bagian yang merepotkan. JSON mode apa pun membeli Anda sintaksis dan berhenti di situ: observasi produksi menempatkannya sekitar 95-99% valid secara sintaksis, sementara membatasi generasi ke schema yang disuplai hampir 100% (Ashvara). Tidak ada tier yang mengatakan apa pun tentang apakah kuncinya adalah yang Anda minta, sehingga pemeriksaan schema tetap ada dalam kode Anda tidak peduli vendor mana yang Anda gunakan. Jika Anda memilih target, ada baiknya melakukan perbandingan model itu sendiri sebelum Anda berkomitmen, dan platform multi-provider di direktori kami akan menyerap sebagian pekerjaan adapter ini untuk Anda.
Daftar periksa portabilitas sebelum Anda mengirim
- Hapus setiap kalimat yang menyebutkan model, versi, atau perilaku yang diketahui dari satu model. Itu adalah baris yang pertama kali rusak.
- Jalankan set eval yang sama terhadap ketiga provider dan catat pass rate per kasus, bukan hanya rata-rata.
- Konfirmasi validator schema berjalan pada setiap respons terlepas dari apakah provider mengklaim constrained decoding.
- Baca ulang dokumen penegakan setiap provider saat Anda menyambungkan adapter, dan simpan frasa atau flag yang diperlukan di dalam adapter, bukan di prompt bersama.
- Catat adapter mana yang terpicu. Saat checkpoint dikirim dan kualitas bergerak, Anda ingin tahu apakah prompt atau adapter yang berubah di bawah Anda.
Jika sebuah prompt gagal daftar periksa ini pada satu vendor saja, bug-nya hampir selalu ada di adapter, bukan di shell.
Pertanyaan yang Sering Diajukan
Apakah saya perlu menulis ulang prompt setiap kali model baru dikirim?
Tidak, dan jika Anda melakukannya, prompt Anda kemungkinan membawa hack spesifik model daripada instruksi. Bagian yang bertahan dari pembaruan adalah yang terikat pada sesuatu di luar model: deskripsi task, data input, dan kontrak output seperti JSON schema. Decoding terbatas terhadap schema yang disuplai menghasilkan hampir 100% JSON yang valid secara sintaksis terlepas dari model mana yang ada di baliknya, karena batasannya ada di decoder. Apa yang seharusnya Anda tulis ulang pada perubahan model adalah tidak ada. Yang harus Anda jalankan ulang adalah set eval Anda.
Apakah 'pikirkan langkah demi langkah' masih bekerja pada model saat ini?
Sebagian besar sudah menjadi beban mati sekarang. Frasa itu adalah solusi sementara untuk model yang langsung melompat ke jawaban, dan model saat ini sudah mengurai pekerjaan multi-langkah tanpa diberitahu. Yang lebih buruk, menambahkannya ke prompt yang menuntut output JSON ketat mengundang model untuk mengeluarkan prosa penalaran di sekitar objek, yang persis kelas kegagalan yang mendorong prompt naif ke estimasi tingkat JSON cacat 5-10%. Jika Anda menginginkan penalaran, berikan field bernama dalam schema Anda dan biarkan parser menjaganya terpisah dari payload.
Apakah JSON mode sudah cukup, atau saya butuh schema?
Gunakan schema. JSON mode membawa Anda ke sekitar 95-99% output yang valid secara sintaksis, yang terdengar bagus sampai Anda menjalankan sepuluh ribu panggilan per hari dan menderita ratusan kegagalan. Decoding terbatas oleh schema membawa validitas sintaksis ke hampir 100%, dan juga mematok nama kunci Anda, yang penting karena RFC 8259 memperlakukan objek JSON sebagai koleksi pasangan nama-nilai yang tidak berurutan dan hanya merekomendasikan nama unik. Validitas sintaksis bukan kebenaran semantik, jadi teruslah memvalidasi objek yang di-parse terhadap aturan Anda sendiri bagaimanapun juga.
Berapa banyak contoh few-shot yang harus dimiliki prompt yang tahan lama?
Dua hingga empat, dan pilih berdasarkan cakupan edge case daripada volume. Contoh yang menampilkan happy path yang sama berulang kali tidak mengajarkan model apa pun yang belum dilakukannya; contoh yang mematok kasus-kasus sulit adalah yang ditransfer antar model. Untuk output terstruktur, gunakan setidaknya satu contoh untuk membedakan antara container kosong dan nilai yang hilang, karena [object kosong {} dan array kosong [] keduanya JSON valid tetapi secara semantis berbeda dari null](https://jsonic.io/guides/json-examples). Jika contoh Anda mengandung format yang akan ditolak parser yang ketat, Anda mengajarkan kegagalan: trailing comma saja menyumbang sekitar 40% dari kesalahan JSON dalam satu analisis.
Seberapa besar set eval prompt perlu sebelum berguna?
Tiga puluh hingga lima puluh kasus berlabel akan menangkap sebagian besar regresi, dan dua puluh lebih baik dari nol yang dijalankan kebanyakan tim. Ukuran kurang penting daripada komposisi: bobot set ke mode kegagalan yang benar-benar pernah Anda lihat di produksi, seperti kunci tanpa tanda kutip, tanda kutip tunggal, tanda kutip yang tidak di-escape di dalam string, koma yang hilang, dan karakter UTF-8 BOM tersembunyi, yang semuanya muncul dalam rincian kesalahan JSON yang terdokumentasi. Jalankan validasi sebelum formatting agar Anda menangkap kerusakan struktural daripada menyembunyikannya, yang merupakan workflow yang QuickTinyData rekomendasikan. Beri versi set di samping prompt dan jalankan ulang pada hari model baru tiba.
Bisakah prompt yang sama benar-benar berjalan tanpa perubahan di Claude, GPT, dan Gemini?
Isi instruksi dapat diporting dengan bersih. Lapisan penegakan output tidak bisa, karena JSON mode dan decoding terbatas oleh schema dikonfigurasi secara berbeda per provider, jadi rencanakan satu prompt dan tiga adapter tipis. Menjaga kontrak dalam format yang sudah disepakati setiap provider membantu: RFC 8259 bersifat independen bahasa dan mendefinisikan empat tipe primitif plus object dan array, dengan true, false, dan null huruf kecil sebagai satu-satunya nama literal. Jika Anda mencari tooling untuk mengelola prompt lintas provider, direktori kami mencantumkan 212 alat rekayasa prompt dan 324 entri di bawah model AI.