

Pipeline multimodal Anda tidak akan gagal karena model berhalusinasi. Pipeline akan gagal karena URL unduhan Sora kedaluwarsa 61 menit setelah render selesai, atau karena podcast 90 menit Anda menabrak batas transkripsi 25 MB OpenAI sementara AssemblyAI bisa menerima file 5 GB penuh dalam satu permintaan.
Setiap hop antara model memiliki kontrak: format file yang tepat, tier paket yang membukanya, jendela kedaluwarsa, dan fallback saat vendor mematikan model. Kebanyakan panduan melewati keempat hal ini.
Artikel ini memberikan kontrak tersebut, tiga pipeline yang telah dikerjakan, dan rencana pertukaran yang Anda butuhkan sebelum OpenAI menutup Videos API beserta kedua model Sora 2 pada 24 September 2026 tanpa ada pengganti yang disebutkan. Itu 19 hari lagi.
Mengapa pipeline multimodal gagal di handoff, bukan di model
Setiap model dalam rantai Anda bekerja dengan baik. Transkripsi akurat, gambar terlihat benar, suara terdengar manusiawi, video di-render. Yang gagal adalah momen ketika output satu model harus menjadi input model berikutnya, dan tidak ada yang menuliskan seperti apa output tersebut seharusnya.
Contoh konkretnya: URL unduhan aset yang dihasilkan Sora hanya valid selama maksimal satu jam setelah pembuatan, dan output-nya tiba sebagai MP4 ditambah thumbnail WebP dan spritesheet JPG (OpenAI). Jika pipeline Anda mengantrekan render dan baru sampai ke langkah salin 90 menit kemudian, render tersebut sudah hilang. Model sudah melakukan tugasnya dengan sempurna.
Kontrak handoff: format, tier, kedaluwarsa, fallback
Perlakukan setiap hop sebagai kontrak dengan empat syarat yang Anda tuliskan sebelum membangun apa pun.
Format adalah spesifikasi file persis yang diminta hop berikutnya, hingga sample rate dan dimensi piksel—bukan aspek rasio dan harapan. Tier adalah level paket atau parameter API tunggal yang membuka format tersebut, karena banyak format yang Anda butuhkan terkunci di balik langganan berbayar atau nama model lama. Expiry adalah berapa lama artefak dapat diambil dari vendor sebelum Anda menanggung kerugian. Fallback adalah apa yang Anda ganti saat vendor menghentikan model, yang sekarang bukan lagi sekadar hipotesis.
Tuliskan keempat baris tersebut per hop dan sebagian besar proses debugging akan hilang sebelum Anda mulai.
Empat mode kegagalan yang mematikan pipeline di tengah jalan
- Hop hulu menghasilkan format yang secara diam-diam diturunkan atau langsung ditolak oleh hop hilir.
- Fitur yang Anda asumsikan ada di API ternyata berada di balik tier paket yang lebih tinggi atau versi model yang lebih lama.
- Artefak kedaluwarsa di penyimpanan vendor sementara pekerjaan Anda masih dalam antrean.
- Model yang Anda bangun mendapat tanggal penutupan, dan vendor tidak mencantumkan pengganti yang direkomendasikan.
Tiga pipeline yang mengikuti semuanya merupakan instance dari kontrak yang sama: podcast ke catatan acara, skrip ke video bernarasi, dan foto produk ke set kampanye. Masing-masing menyebutkan format, tier, kedaluwarsa, dan fallback di setiap hop.
Artikel ini ditulis untuk seseorang yang mengirimkan deliverable, bukan membandingkan arsitektur fusi. Anda dapat memilih alat individual dari 18.982 alat AI aktif di direktori kami. Menghubungkan semuanya adalah bagian yang tidak pernah didokumentasikan siapa pun.
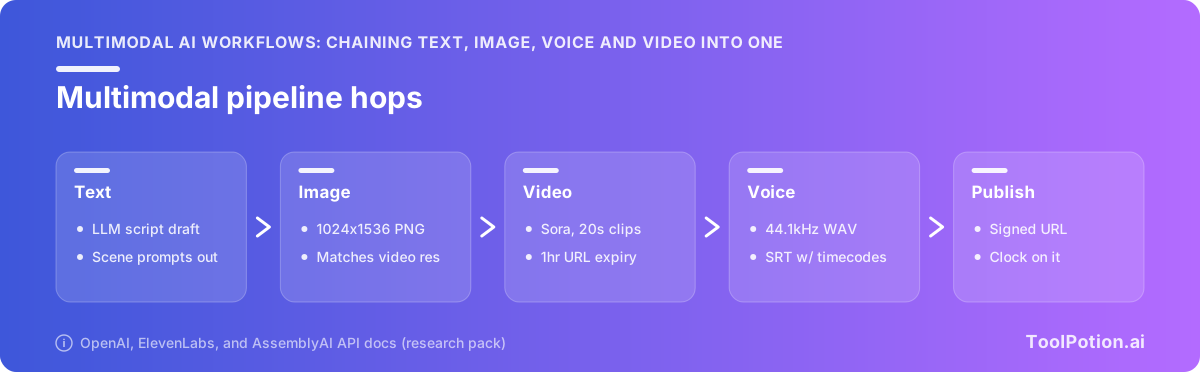
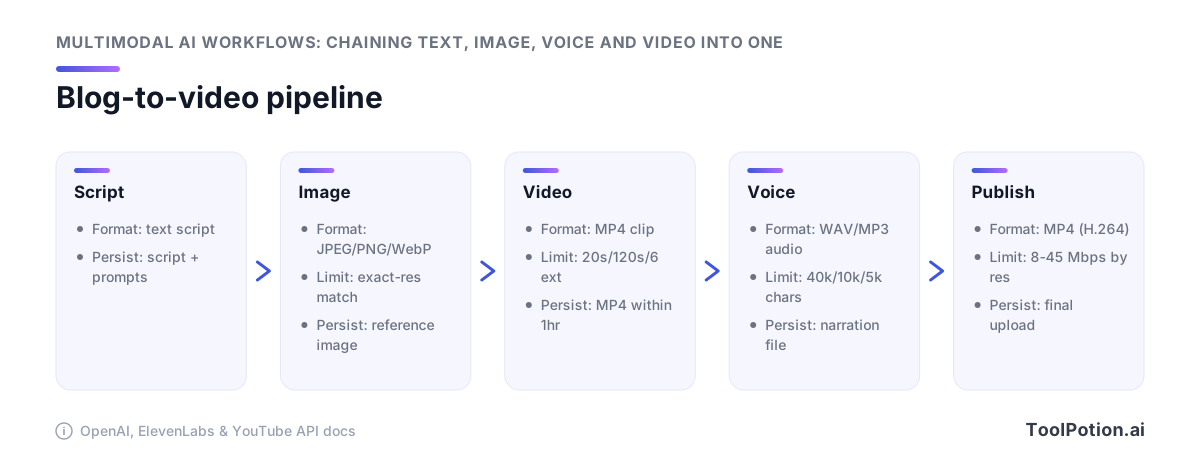
Pipeline 1: posting blog ke video bernarasi
Ambil artikel 1.200 kata dan Anda ingin video dua menit bernarasi di ujungnya. Empat hop: pecah teks, buat still, animasikan, beri narasi. Setiap hop tersebut memiliki spesifikasi yang harus dipenuhi oleh hop sebelumnya, dan Anda menetapkan sebagian besar spesifikasi tersebut sebelum membuat satu pun panggilan API.
Segmentasi skrip sebelum panggilan pembuatan apa pun
Segmentasi bukan langkah pemformatan yang Anda lakukan di akhir. Ini adalah parameter yang diwarisi oleh semua proses hilir, karena model suara yang Anda pilih membatasi apa yang dapat Anda kirim per permintaan. Eleven Flash v2.5 menerima 40.000 karakter, Multilingual v2 menerima 10.000, dan v3 berhenti di 5.000 (ElevenLabs). Pilih v3 untuk narasi ekspresif dan skrip 1.200 kata Anda muat dalam satu panggilan. Pilih untuk penjelas 9.000 kata dan Anda harus membaginya menjadi dua, dengan sambungan yang harus disembunyikan.
Segmentasi pada batas adegan, bukan jumlah kalimat. Setiap segmen membutuhkan satu ide visual, durasi target dalam detik, dan resolusi piksel target yang dilampirkan sebagai metadata. Kolom terakhir itulah yang dibaca oleh hop gambar.
Hop gambar: cocokkan dimensi piksel persis dari hop video
Jalur image-to-video Sora mengharuskan gambar referensi cocok dengan resolusi video target secara persis, dalam image/jpeg, image/png, atau image/webp (OpenAI). Persis berarti piksel, bukan "16:9". Generator gambar yang diperintahkan menghasilkan still widescreen akan dengan senang hati memberikan Anda 1792x1024 saat panggilan video menginginkan 1280x720, dan pekerjaan gagal saat pengiriman, bukan saat render. Jadi template prompt gambar membawa lebar dan tinggi sebagai bilangan bulat literal yang diambil dari konfigurasi hop video, dan Anda memvalidasi dimensi dan tipe MIME file yang dikembalikan sebelum mengantrekan apa pun. Di antara 324 model AI yang dilacak di direktori kami, model-model yang memungkinkan Anda menentukan dimensi piksel sembarang daripada preset bernama adalah yang layak dihubungkan di sini.
Hop video: klip 16 dan 20 detik yang dirantai
Baik sora-2 maupun sora-2-pro menghasilkan klip 16 atau 20 detik. Setiap ekstensi menambahkan hingga 20 detik, dibatasi enam ekstensi dan total 120 detik (OpenAI). Segmen dua menit Anda adalah enam panggilan yang dirantai.
Kontinuitas di keenam panggilan tersebut adalah tanggung jawab Anda. Model tidak mengingat alur narasi antara ekstensi 3 dan ekstensi 4, sehingga prompt untuk setiap panggilan harus menyebutkan kembali latar, subjek, dan perilaku kamera. Anggarkan untuk pengulangan di sambungan.
Hop suara dan mux
Buat narasi per segmen, bukan per video, sehingga pengambilan yang buruk hanya menghabiskan satu panggilan. Kemudian selaraskan: audio untuk segmen 4 harus muat dalam klip 20 detik yang Anda render untuk segmen 4, yang biasanya berarti memangkas salinan skrip daripada time-stretching audio. Mux dengan ffmpeg, satu segmen sekaligus, lalu concat.
Pipeline 2: episode podcast ke klip dan catatan acara
Satu WAV 58 menit masuk. Yang keluar adalah transkrip, bab bertimestamp, enam klip vertikal dengan keterangan terbakar, dan halaman catatan acara. Audio tidak pernah mengubah format setelah hop pertama, itulah yang membuat pipeline ini lebih mudah dari pipeline video. Yang menentukan apakah pipeline ini berhasil adalah vendor transkripsi mana yang Anda pilih dan tiga parameter apa yang Anda tetapkan pada permintaan.
Dinding 25 MB dan cara menghindarinya
Endpoint transkripsi OpenAI membatasi unggahan hingga 25 MB dan menerima mp3, mp4, mpeg, mpga, m4a, wav dan webm (OpenAI). WAV 48kHz berdurasi 58 menit berukuran sekitar 300 MB. Jadi Anda harus transcode ke MP3 bitrate rendah dan berharap, atau memecah file—dan memecah audio pada batas byte sembarang memotong kata di tengah dan menggeser setiap timestamp setelah sambungan.
AssemblyAI menerima hingga 5 GB per permintaan di /v2/transcript (2,2 GB jika Anda mengunggah file lokal melalui /v2/upload) dan menangani file dari 160 ms hingga 10 jam (AssemblyAI). Itu sekitar 200x batasnya. Untuk audio panjang, kirim seluruh episode ke sana dan simpan vendor LLM Anda untuk hop penalaran di hilir.
Timestamp tingkat kata adalah primitif pemotongan klip
Anda tidak dapat memotong klip secara otomatis dari transkrip yang hanya memiliki batas paragraf. Anda perlu tahu bahwa kata "anyway" dimulai pada 00:41:12.340 agar potongan jatuh sebelumnya, bukan di tengahnya.
Dua catatan di sisi OpenAI. Output SRT dan VTT ditambah parameter timestamp_granularities[] hanya berfungsi pada whisper-1, bukan pada gpt-transcribe atau gpt-4o-transcribe (OpenAI). Jika pipeline Anda membakar keterangan atau memotong berdasarkan timecode, Anda menyimpan model yang lebih lama dalam rantai dengan sengaja dan berhenti menganggapnya sebagai utang teknis. ElevenLabs Scribe v2 memberikan timestamp tingkat kata, diarisasi, dan deteksi entitas di lebih dari 90 bahasa dalam satu respons (ElevenLabs), yang merupakan pilihan lebih bersih jika Anda sudah membayar mereka untuk hop TTS.
Diarisasi hanya berfungsi jika Anda memintanya
Label pembicara membutuhkan chunking_strategy yang diatur ke auto untuk audio yang lebih panjang dari 30 detik, dan gpt-4o-transcribe-diarize hanya melakukan identifikasi pembicara (OpenAI). Hilangkan parameter dan permintaan berhasil. Anda mendapatkan kembali teks yang bersih, fasih, dan sepenuhnya tanpa label, dan tidak ada dalam respons yang memberitahu Anda bahwa wawancara dua-host baru saja tergabung menjadi satu suara. Periksa kolom pembicara di langkah validasi Anda, bukan dengan mata.
Transkrip ke catatan acara, bab, dan salinan sosial
Satu transkrip dengan timing kata menghasilkan empat artefak tanpa pemrosesan audio lebih lanjut: penanda bab dari perubahan topik, paragraf ringkasan ditambah daftar tautan untuk halaman catatan acara, kandidat klip berperingkat yang dinilai berdasarkan kepadatan kutipan, dan potongan vertikal yang dirender dari titik masuk dan keluar tersebut. Masukkan transkrip yang sama ke masing-masing, secara paralel, dengan prompt yang berbeda. Jika Anda mencari referensi format sebelum membangun, ada 201 podcast AI di direktori kami yang menerbitkan kira-kira pada stack ini.
Pipeline 3: foto produk ke varian iklan
Satu foto studio sepatu menjadi dua belas still bermerek, kemudian empat iklan gerak 8 detik untuk media sosial berbayar. Hop-nya adalah gambar masuk, gambar keluar, video keluar, dan rekayasa yang menarik berada di antara hop dua dan tiga, di mana model visi melihat apa yang dihasilkan generator gambar dan memutuskan apakah layak dikirim.
Tinjauan model visi sebagai gerbang QA
Still produk yang dihasilkan gagal dengan cara yang membosankan. Penempatan logo yang salah, enam lubang sepatu daripada lima, bayangan yang bertentangan dengan cahaya utama. Anda tidak ingin manusia memeriksa 120 varian, jadi Anda mengirimnya ke model visi dengan foto sumber dan spesifikasi merek tertulis, dan meminta lulus/gagal ditambah string alasan.
Claude menerima hingga 100 gambar per permintaan pada model konteks 200k dan 600 pada model lainnya, dengan 20 per pesan di claude.ai, dibatasi 8000x8000 px dan 10 MB per gambar (Claude Docs). Itu bukan angka yang akan menghantam Anda.
Batas ukuran permintaan standar 32 MB itulah yang akan menghantam. Dua belas PNG 4K melampaui batasnya jauh sebelum Anda mencapai 100 gambar, itulah mengapa Anthropic merekomendasikan pengunggahan melalui Files API dan mereferensikan setiap gambar dengan file_id daripada menyisipkan base64 (Claude Docs). Bangun hop tinjauan dengan cara itu sejak hari pertama. Mengubahnya setelah ukuran batch Anda bertumbuh berarti menulis ulang pembangun permintaan dan logika retry sekaligus.
Pengambilan sampel frame adalah pengungkit biaya langsung
Claude menagih gambar sebagai token visual 28x28 piksel, dihitung sebagai ⌈lebar/28⌉ × ⌈tinggi/28⌉. Frame 3840x2160 menghabiskan 4.784 token visual pada tier resolusi tinggi dan 1.560 setelah downscaling pada tier standar, kira-kira $23,92 per seribu frame 4K pada tarif input $5/M Claude Opus 5 (Claude Docs). Downscale sebelum Anda mengirim, kecuali pemeriksaan QA bergantung pada detail halus seperti jahitan atau teks kecil.
Matematika yang sama mengatur hop analisis video. Meninjau empat iklan 8 detik pada 24fps adalah 768 frame jika Anda tidak cermat. Sample pada 2fps, periksa 64, dan tagihan tinjauan Anda turun faktor dua belas tanpa kehilangan satu pun perubahan adegan.
Mengelompokkan gambar tanpa menabrak batas permintaan
Kelompokkan berdasarkan byte payload, bukan jumlah gambar. Urutkan varian ke dalam grup yang tetap di bawah sekitar 25 MB referensi, simpan foto sumber di setiap batch sebagai anchor perbandingan, dan kirim ulang kegagalan satu per satu pada resolusi penuh agar string alasan layak dibaca. Direktori kami mendaftar 727 generator gambar dan 342 editor foto di antara alat gambar dan foto AI di direktori kami, dan hampir tidak ada yang mengekspos mekanisme batch yang Anda butuhkan di sini. Bagian itu tetap ada di kode Anda.
Lembar spesifikasi handoff: apa yang harus dituntut di setiap hop
Tulis kontrak sebelum Anda menulis kode. Setiap hop dalam rantai memiliki tiga hal yang perlu Anda tetapkan: format output persis yang Anda minta, tier paket atau parameter yang membukanya, dan berapa lama artefak bertahan sebelum hilang. Salah satu di antaranya dan kegagalan muncul dua hop kemudian sebagai keluhan kualitas yang tidak bisa dilacak siapa pun.
Audio: tier yang membuka output berkualitas siaran
ElevenLabs menempatkan pcm_44100, pcm_48000, wav_44100 dan wav_48000 di balik langganan Pro, dan mp3_44100_192 di balik Creator (referensi API ElevenLabs). Jadi pada paket gratis atau entry, editor video Anda menerima MP3 lossy di 128kbps atau di bawahnya, tidak peduli seberapa bagus model suaranya. Itu plafon kualitas yang ditetapkan oleh penagihan, bukan oleh inferensi.
Jika deliverable Anda adalah podcast yang harus mencapai -16 LKFS dengan true peak di bawah atau sama dengan -1 dBFS (Apple Podcasts), Anda menginginkan lossless masuk dan satu encode di akhir. Menormalisasi MP3 128kbps dan meng-encode ulangnya menumpuk dua generasi lossy. Anggaarkan tier Pro sebagai biaya produksi, bukan upgrade.
Video: URL yang kedaluwarsa dan aset sidecar
Sora tidak memberikan Anda satu file. Render yang selesai memberikan MP4, thumbnail WebP, dan spritesheet JPG, dan URL unduhan hanya valid selama maksimal satu jam (panduan video OpenAI). Pekerjaan Anda di hop tersebut adalah menyalin ke penyimpanan objek milik Anda sendiri, dipicu oleh event penyelesaian, bukan oleh batch malam hari. Lewatkan jendela dan render tidak dapat dipulihkan.
Teks dan timing: kolom yang dibutuhkan langkah hilir
Langkah-langkah hilir sangat membutuhkan kolom tertentu, dan yang membutuhkan timing adalah yang gagal secara diam-diam. Output SRT dan VTT ditambah timestamp_granularities[] hanya berfungsi pada whisper-1, bukan model transkripsi yang lebih baru (OpenAI speech to text). Apa pun yang memotong klip atau membakar keterangan membutuhkan timestamp tingkat kata dalam kontrak.
| Hop | Tuntut output ini | Yang membukanya | Kedaluwarsa |
|---|---|---|---|
| Text to speech | wav_48000 atau pcm_44100 | Tier Pro; Creator untuk mp3_44100_192 | Tidak kedaluwarsa, simpan saat penulisan |
| Speech to text | Timestamp tingkat kata, label pembicara | whisper-1 untuk SRT/VTT; chunking_strategy: auto di atas 30 detik untuk diarisasi | Tidak kedaluwarsa |
| Image to video | MP4 ditambah thumbnail dan spritesheet | Gambar referensi yang cocok dengan resolusi video secara persis | 1 jam pada URL unduhan |
| Video to text | Frame sampel pada laju tetap | Tier standar vs resolusi tinggi mengubah biaya token visual ~3x | Tidak kedaluwarsa |
Apa pun orkestrator yang Anda pilih dari 128 framework AI di direktori kami, uji terlebih dahulu pada hop biner. Meneruskan JSON antar model adalah bagian yang mudah.
Platform otomasi atau lem manual
Aturannya sederhana: biarkan platform memutuskan apa yang terjadi dan kapan, dan biarkan kode Anda sendiri memindahkan byte. Apa pun yang menyentuh file besar atau berlomba dengan jendela kedaluwarsa harus ada dalam skrip dengan penyimpanan objek di belakangnya.
Di mana platform unggul
Trigger, retry pada langkah murah, gerbang persetujuan, dan fan-out di akhir. Zapier menawarkan integrasi 9.000+ aplikasi yang terhubung ke Zaps, Tables, Forms, dan Zapier MCP, dan katalog tersebut adalah alasan nyata untuk menggunakannya. Memasukkan catatan acara yang selesai ke CMS Anda dan tautan klip ke kalender konten adalah pekerjaan konektor, dan menulis konektor tersebut sendiri tidak memberikan nilai apa pun.
Human-in-the-loop juga termasuk di sini. Sebuah Zap yang memposting empat varian iklan ke Slack, menunggu persetujuan, lalu melepaskan langkah penerbitan adalah dua puluh menit penyiapan dan satu-satunya hal yang berdiri antara klaim produk yang berhalusinasi dan anggaran media sosial berbayar Anda.
Di mana media biner mengalahkannya
Node tanpa kode meneruskan JSON dengan baik tetapi file dengan buruk. WAV 58 menit harus dipecah menjadi potongan 25 MB atau kurang sebelum endpoint transkripsi OpenAI menerimanya (OpenAI). Render Sora dua menit adalah hingga enam panggilan ekstensi yang dirantai masing-masing 20 detik (OpenAI), dan URL unduhan hanya valid selama maksimal satu jam setelah pembuatan (OpenAI). Logika retry di enam panggilan dengan hitungan mundur yang berjalan pada artefak adalah sebuah program, bukan sebuah kanvas.
Dua platform memang menangani media. n8n menyimpan file sebagai data biner antar node daripada memaksakan round-trip base64, dan node kodenya berada tepat di sebelah node agen (n8n). Descript mengekspos transkripsi, klip, dan keterangan melalui API daripada GUI (Descript).
Jalan tengah: platform untuk alur kontrol, kode untuk byte
Setiap hop menulis ke bucket Anda sendiri dan mengembalikan kunci. Platform meneruskan kunci dan kode status, bukan file. Menyusun pekerjaan dengan cara itu juga memangkas komputasi: sistem OnePiece melaporkan penurunan konsumsi GPU 16x untuk Wan2.1 image-to-video setelah pipeline monolitik diuraikan menjadi layanan bertahap (arXiv).
Jika Anda memilih komponen, direktori kami melacak 550 agen AI dan alat orkestrasi di samping 301 repo AI open-source. Repo-repo itulah tempat lem pemindah byte biasanya berada, karena tidak ada vendor yang menjual bagian itu.
Spesifikasi pengiriman: memenuhi platform di mana ia menerbitkan
Hop terakhir Anda bukan render. Itu adalah unggahan, dan unggahan juga memiliki lembar spesifikasi.
Video: target bitrate dan audio untuk unggahan
YouTube menerbitkan bitrate pengiriman yang direkomendasikan berdasarkan resolusi: 8 Mbps untuk 1080p SDR, 16 Mbps pada 1440p, dan 35–45 Mbps pada 4K, dengan audio dikirimkan sebagai AAC-LC, Opus, atau Eclipsa pada 48 kHz dan 384 kbps stereo (Bantuan YouTube). Jika hop video Anda menghasilkan file jauh di bawah angka-angka tersebut, jangan naikkan bitrate saat ekspor. Anda akan menghabiskan waktu encode untuk menambah artefak kompresi. Yang harus Anda lakukan adalah membuat langkah encode membaca resolusi sumber dan memilih target yang cocok, sehingga render Sora 1080p tidak dipaksa menggunakan tangga 4K karena seseorang men-hardcode-nya di konfigurasi enam bulan lalu.
Target audio lebih penting dari target video untuk konten bernarasi. Trek AAC 48 kHz 384 kbps dari sumber 44,1 kHz berarti ada resample di suatu tempat, dan Anda ingin resample tersebut terjadi sekali, dalam panggilan ffmpeg Anda sendiri, di mana Anda bisa melihatnya.
Audio: pra-kondisi loudness sebelum encoding
Apple Podcasts meminta -16 dB LKFS ±1 dB dengan true peak di bawah atau sama dengan -1 dB FS, diukur per ITU-R BS.1770-5, dan secara eksplisit menyatakan bahwa audio harus dipra-kondisi ke target tersebut sebelum encoding (Apple Podcasts for Creators). Urutan operasi, bukan preferensi. Menormalisasi MP3 yang sudah jadi berarti Anda mendorong gain melalui artefak lossy yang dipanggang pada level berbeda, dan true peak pada MP3 yang telah di-decode bisa sudah melebihi apa yang dilihat encoder. Letakkan proses loudness pada WAV, lalu encode.
Inilah mengapa tier format TTS dari awal rantai terus penting. Menyerahkan MP3 128 kbps ke normalizer Anda adalah titik awal yang lebih buruk daripada menyerahkan PCM, dan tidak ada perawatan hilir yang bisa memperbaikinya.
Provenance dan pelabelan pada aset yang dihasilkan
Putuskan tentang provenance saat Anda merancang pipeline, bukan setelah platform memintanya. SynthID Google memberi tanda air pada media yang dihasilkan saat pembuatan, yang berarti tanda itu ikut bersama aset hanya jika pipeline Anda tidak menghapus atau meng-encode ulangnya. Setiap proses ffmpeg antara pembuatan dan unggahan adalah kesempatan untuk kehilangan sinyal tersebut, jadi lacak hop mana yang memperkenalkan file dan simpan catatan model, prompt, dan timestamp di penyimpanan metadata Anda sendiri daripada mempercayai container untuk membawanya.
Bangun untuk pertukaran: tebing deprecation di bawah setiap hop video
Jika hop video Anda memanggil Sora, Anda punya 19 hari. OpenAI mengumumkan pada 24 Maret 2026 bahwa Videos API dan kedua model sora-2 serta sora-2-pro ditutup pada 24 September 2026, termasuk snapshot sora-2-2025-10-06, sora-2-2025-12-08 dan sora-2-pro-2025-10-06, tanpa model pengganti yang direkomendasikan (deprecasi OpenAI). Kolom pengganti yang kosong berarti Anda memilih penggantinya sendiri, dan Anda memilihnya sebelum batas waktu, bukan setelahnya.
Mengabstraksi hop sehingga pertukaran hanya perubahan konfigurasi
Solusinya adalah adapter tipis per hop generatif. Pipeline Anda menyerahkan pekerjaan yang dinormalisasi ke adapter: prompt, jalur gambar referensi, resolusi target, durasi dalam detik, kunci bucket output. Adapter memiliki semua hal berbentuk vendor. Aturan Sora bahwa gambar referensi harus cocok dengan resolusi video secara persis, klip 16 dan 20 detiknya yang diperpanjang dalam langkah 20 detik hingga batas 120 detik, kedaluwarsa unduhan 1 jamnya (pembuatan video OpenAI). Tidak ada yang bocor ke kode orkestrasi Anda.
Kemudian mengganti provider hanyalah nilai konfigurasi, bukan penulisan ulang. Validasi adapter kedua terhadap dokumen model Runway sekarang, jalankan keduanya pada sepuluh prompt yang sama, dan simpan yang kalah tetap siap.
Keluarga gambar dan audio membawa tanggal mereka sendiri, jadi perlakukan ini sebagai pemeliharaan rutin daripada kepanikan satu kali. Direktori kami ada sebagian untuk memungkinkan Anda melacak rilis dan sunset model di seluruh 324 model yang terdaftar.
Daftar periksa migrasi untuk pipeline yang berjalan hari ini
- Grep setiap repo dan JSON workflow untuk
sora-2,sora-2-prodan path dasar Videos API. Sertakan cron job dan skrip satu kali, di situlah panggilan yang terlupakan biasanya berada. - Bungkus setiap hasil dalam adapter dengan schema pekerjaan Anda sendiri sebelum mengganti provider, sehingga pertukaran dan refactor bukan commit yang sama.
- Jalankan provider alternatif pada sepuluh prompt nyata dan bandingkan output pada resolusi, panjang klip, dan kualitas gerakan.
- Atur pengingat kalender dua minggu sebelum setiap tanggal sunset yang diterbitkan, per vendor, per keluarga model.
- Log ID model dan snapshot pada setiap render sehingga Anda dapat menjawab "apa yang menghasilkan aset ini" setelah model tidak ada lagi.
Pertanyaan yang Sering Diajukan
Apa itu alur kerja AI multimodal, dalam istilah praktis?
Ini adalah rantai panggilan API di mana file output satu model menjadi file input model berikutnya, dan setiap hop memiliki kontrak format yang harus Anda penuhi. Rantai khas berjalan dari transkrip ke skrip ke gambar diam ke video ke narasi ke render akhir, dan setiap tanda panah adalah tempat di mana resolusi atau codec yang salah menghentikan jalannya. Hop image-to-video Sora adalah contoh bagus betapa literalnya kontrak tersebut: gambar referensi harus cocok dengan resolusi video target secara persis dan berupa image/jpeg, image/png, atau image/webp, sehingga langkah gambar di hulu membutuhkan dimensi piksel langkah video, bukan sekadar aspek rasio (dokumen pembuatan video OpenAI). Anggap pipeline sebagai sekumpulan handoff, bukan sekumpulan alat.
Bagaimana cara menghubungkan alat AI tanpa kehilangan kualitas antar langkah?
Tetapkan spesifikasi output di setiap hop sesuai kebutuhan langkah terakhir dalam rantai, lalu kerjakan mundur. Kehilangan kualitas biasanya berasal dari tier harga atau parameter default daripada model: ElevenLabs menempatkan pcm_44100, pcm_48000, wav_44100 dan wav_48000 di balik langganan Pro dan mp3_44100_192 di balik tier Creator, sehingga akun entry-tier menyerahkan MP3 lossy ke editor Anda entah Anda menginginkannya atau tidak (referensi speech ElevenLabs). Salin setiap artefak yang dihasilkan ke penyimpanan objek Anda sendiri segera, karena URL unduhan Sora hanya valid selama maksimal satu jam setelah pembuatan (dokumen pembuatan video OpenAI). Sample rate juga merupakan pengungkit biaya, bukan hanya kualitas: Claude menghargai frame 4K sebesar 4.784 token visual pada tier resolusi tinggi versus 1.560 pada standar, kira-kira $23,92 per seribu frame 4K pada tarif input $5/M Opus 5 (dokumen visi Claude).
Format audio apa yang harus saya serahkan dari langkah text-to-speech ke editor video?
WAV 48 kHz yang tidak terkompresi atau PCM, yang pada ElevenLabs berarti wav_48000 atau pcm_48000 dan langganan Pro atau lebih tinggi (referensi speech ElevenLabs). Menyerahkan MP3 128 kbps ke editor memanggang artefak kompresi yang bertahan melalui setiap encode berikutnya. Jika tujuannya adalah YouTube, target pengiriman akhir adalah AAC-LC, Opus, atau Eclipsa pada 48 kHz dan 384 kbps stereo (pengaturan encoding unggahan YouTube), dan jika itu feed podcast, Apple menginginkan loudness yang dipra-kondisi ke -16 dB LKFS ±1 dB dengan true peak di bawah atau sama dengan -1 dB FS, diukur per ITU-R BS.1770-5, sebelum Anda encode (persyaratan audio Apple Podcasts). Anda tidak bisa mencapai salah satu target secara andal dari intermediate lossy.
Mengapa transkripsi podcast saya gagal pada episode berdurasi penuh?
Endpoint transkripsi OpenAI membatasi unggahan pada 25 MB dan menerima mp3, mp4, mpeg, mpga, m4a, wav dan webm, sehingga apa pun yang lebih panjang dari sekitar setengah jam pada bitrate yang layak harus dipecah menjadi potongan 25 MB atau kurang (dokumen speech-to-text OpenAI). Itulah mengapa pipeline audio panjang biasanya mengarahkan transkripsi jauh dari vendor LLM: AssemblyAI menerima hingga 5 GB per permintaan di /v2/transcript (2,2 GB untuk unggahan lokal) dan file dari 160 ms hingga 10 jam, sekitar 200x batas OpenAI (dokumen audio pre-recorded AssemblyAI). Dua mode kegagalan lainnya terlihat seperti sukses: diarisasi pembicara diam-diam mengembalikan teks tanpa label kecuali Anda mengatur chunking_strategy ke 'auto' untuk audio lebih panjang dari 30 detik, dan output SRT/VTT ditambah timestamp_granularities[] hanya berfungsi pada whisper-1, bukan pada gpt-transcribe atau gpt-4o-transcribe (dokumen speech-to-text OpenAI). Jika Anda membutuhkan timestamp tingkat kata untuk pemotongan klip otomatis, ElevenLabs Scribe v2 memberikannya di lebih dari 90 bahasa bersama diarisasi (model ElevenLabs).
Haruskah saya membangun pipeline konten AI di n8n atau Zapier, atau menulis kode sendiri?
Tulis kode untuk hop apa pun yang memindahkan media biner, dan gunakan platform otomasi untuk trigger, persetujuan, dan notifikasi di sekitarnya. Kekuatan Zapier adalah keluasan, dengan 9.000+ integrasi aplikasi yang dinyatakan vendor ditambah Zaps, Tables, Forms, dan Zapier MCP (platform developer Zapier), yang persis apa yang Anda inginkan untuk "baris baru di Airtable, mulai render, posting tautan ke Slack." Ini lapisan yang salah untuk MP4 200 MB dengan URL kedaluwarsa satu jam. n8n berada di tengah-tengah, karena node agen dan penanganan passthrough biner-nya memungkinkan Anda menyimpan file di dalam workflow (dokumen Tools Agent n8n), dan ada argumen infrastruktur nyata untuk membagi rantai menjadi tahap daripada satu monolit: makalah OnePiece melaporkan penurunan 16x dalam konsumsi GPU dari menguraikan pipeline AIGC menjadi layanan mikro bertahap untuk Wan2.1 image-to-video (arXiv).
Apa yang menggantikan Sora dalam pipeline video setelah penutupan September 2026?
OpenAI mengumumkan pada 24 Maret 2026 bahwa Videos API dan model sora-2 serta sora-2-pro (snapshot sora-2-2025-10-06, sora-2-2025-12-08 dan sora-2-pro-2025-10-06) ditutup pada 24 September 2026, dan tidak mencantumkan model pengganti yang direkomendasikan (deprecasi OpenAI). Dari 5 September 2026 itu adalah 19 hari, sehingga langkah praktis adalah menempatkan hop video Anda di balik antarmuka tipis hari ini dan mengarahkannya ke vendor lain, dengan API Runway sebagai pertukaran paling langsung untuk dievaluasi (dokumen model Runway). Anggaran juga untuk penulisan ulang logika chunking Anda, karena batas Sora telah membentuk banyak pipeline: klip 16 dan 20 detik, hingga 20 detik ditambahkan per ekstensi, dan maksimum 120 detik di seluruh hingga enam ekstensi, yang membuat segmen narasi dua menit menjadi enam panggilan yang dirantai (dokumen pembuatan video OpenAI). Jika Anda mencari alternatif, direktori kami saat ini melacak 452 alat di bawah AI Video Generators.