

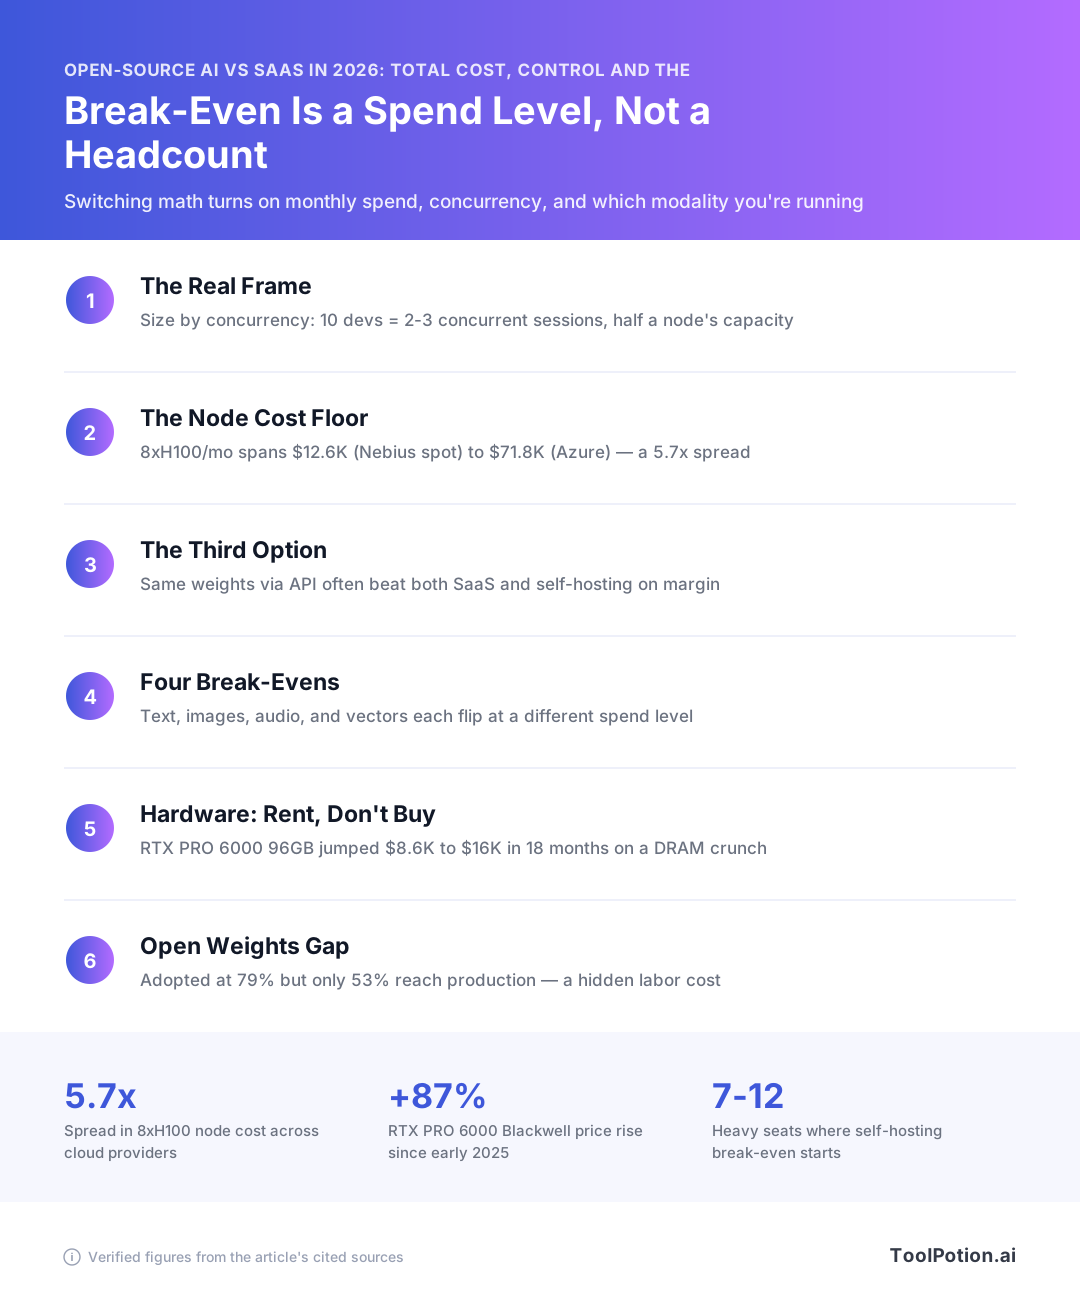
Keputusan AI open source vs SaaS bergantung pada dua angka: pengeluaran bulanan Anda dan profil konkruensi Anda. Jumlah anggota tim adalah proksi yang buruk untuk keduanya. Engineer DoiT sendiri rata-rata menghabiskan $2.200 per developer per bulan untuk Claude Code berbasis penggunaan, yang membuat node seharga $15K–$25K relevan pada sekitar 7 hingga 12 kursi pengguna berat. Namun hanya 10–20% tim yang memiliki permintaan aktif sekaligus, sehingga sepuluh developer setara dua atau tiga sesi konkuren dan setengah node yang menganggur.
Dan sebelum Anda menghitung harga GPU sama sekali, periksa opsi ketiga yang tidak pernah dibandingkan siapa pun: DeepInfra menyajikan Llama-3.3-70B seharga $0,10 input / $0,32 output per juta token. Bobot identik, margin multi-penyewa yang tidak bisa Anda tandingi. Kalkulasi di bawah ini dijalankan empat kali, untuk teks, gambar, transkripsi, dan lapisan vektor.
Titik impas adalah level pengeluaran dan profil konkruensi
Dua angka menentukan apakah Anda harus melakukan self-host, dan ukuran tim bukan salah satunya. Yang pertama adalah pengeluaran bulanan Anda untuk AI saat ini. Yang kedua adalah berapa banyak permintaan yang sedang berjalan pada saat yang sama. Segalanya, termasuk pilihan model, bergantung pada kedua faktor tersebut.
Dua angka yang menentukan sebelum pilihan model apa pun
Sebuah node GPU berbiaya sama baik Anda memanfaatkannya penuh maupun membiarkannya menganggur pukul 3 pagi. Itulah asimetri yang menjadi dasar seluruh perbandingan ini: SaaS menagih Anda per token, sebuah node menagih Anda per jam. Jadi pertanyaannya adalah apakah tagihan bulanan Anda telah melampaui biaya tetap sebuah mesin yang bisa Anda sibukkan.
Tim engineering DoiT rata-rata menghabiskan sekitar $2.200 per developer per bulan untuk harga Claude Code Enterprise berbasis penggunaan, yang membuat titik impas self-hosting $15K–$25K/bulan berada pada sekitar 7 hingga 12 kursi AI berat. Itu ambang batas yang jauh lebih rendah dari garis "Anda butuh ratusan engineer" yang terus diulang kebanyakan panduan TCO. Ini adalah ambang pengeluaran, bukan ambang jumlah orang. Dua belas developer yang nyaris tidak menggunakan asisten tidak akan membawa Anda ke sana, sementara tujuh yang menjalankan agen sepanjang hari akan.
Konkruensi adalah angka kedua, dan itulah yang sering salah diperhitungkan tim. Argumen DoiT adalah bahwa pada momen tertentu hanya 10–20% tim developer yang memiliki permintaan aktif, sehingga sepuluh developer setara dua atau tiga sesi konkuren, paling banyak setengah kapasitas sebuah node. Anda membayar delapan H100 dan menggunakan tiga atau empat. Ukurlah berdasarkan permintaan konkuren puncak dan target throughput token, lalu periksa apakah itu muat dalam satu node sebelum menghitung harga apa pun.
Mengapa '50 engineer kami' adalah pemicu yang salah
Jumlah anggota tim hanya berkorelasi dengan pengeluaran jika penggunaan per orang seragam, dan itu tidak pernah terjadi. Tim 50 orang di mana 8 orang menjalankan agen pengkodean terus-menerus dan 42 orang hanya sesekali menggunakan obrolan memiliki kebutuhan node yang sama dengan tim 8 orang pengguna berat, dan tagihan yang kira-kira sama. Hitunglah kursi pengguna berat.
Jalankan dua angka ini sebelum Anda membandingkan model open-weight yang tercantum di direktori kami dengan apa pun. Pilih model setelah Anda tahu apakah sebuah node bisa tetap sibuk, karena model yang 6 poin di bawah frontier adalah trade-off yang baik pada mesin jenuh dan kesalahan mahal pada mesin yang berjalan seperempat kapasitas.
AI open source vs SaaS: biaya self-hosting di 2026
Mulailah dengan kartu tarif, karena itu satu-satunya angka yang bisa Anda cari. Segalanya dalam anggaran self-hosting adalah estimasi yang Anda pertahankan dalam spreadsheet.
Kartu tarif GPU yang disewa: selisih ~7x pada silikon berkemampuan inferensi
Harga publik RunPod mencantumkan H100 SXM 80GB seharga $3,29/jam di Secure Cloud dan $2,69/jam di Community Cloud, H200 141GB seharga $4,59/$3,59, A100 PCIe 80GB seharga $1,39/$1,19, L40S 48GB seharga $0,99/$0,79, dan B200 180GB seharga $6,79/$5,98 (RunPod). Itu sekitar 7x antara kartu termurah dan termahal yang bisa menjalankan inferensi. Jika workload Anda adalah model 7B atau 8B dengan konteks sedang, lini L40S adalah yang perlu diperhitungkan, dan sebagian besar tulisan TCO tidak pernah menyebutnya.
Lambda mengenakan $4,29/jam untuk satu H100 SXM on-demand, turun menjadi $3,99/jam per GPU pada node 8x, dengan H100 PCIe seharga $3,29/jam dan B200 SXM6 seharga $6,69–$6,99/jam (Lambda). Node 8xH100 dengan tarif tersebut sekitar $31,92/jam, atau kira-kira $23.300 untuk bulan 730 jam pada uptime 100%. Tidak ada yang berjalan di 100% uptime, itulah inti dari angka berikutnya.
Diskon komitmen adalah leverage tunggal terbesar yang Anda kendalikan. Together AI mengenakan $3,99/GPU-jam on-demand untuk HGX H100 dan $3,19–$3,69/GPU-jam dengan syarat reserved dari 7 hingga 180+ hari (Together AI). Anggap saja diskon 20%, tersedia hanya jika Anda cukup yakin dengan beban Anda untuk menandatangani kontrak.
Pengganda penyedia: $12.600 hingga $71.800 untuk bulan 8xH100 yang sama
DoiT menghitung harga node 8xH100 yang identik untuk bulan 730 jam dari berbagai penyedia: sekitar $12.600 di Nebius spot, $22.500 di Nebius on-demand, $40.200 di AWS, $64.100 di GCP, dan $71.800 di Azure (DoiT). Silikon yang sama, selisih 5,7x. Pilihan penyedia Anda menggeser kalkulasi perpindahan lebih besar daripada pilihan model Anda, jadi jika Anda menjalankan evaluasi ini dengan harga daftar hyperscaler karena di situlah pengeluaran berkomitmen Anda berada, Anda membandingkan versi terburuk self-hosting dengan SaaS.
| Penyedia / kartu | Tarif per jam | Catatan |
|---|---|---|
| RunPod L40S 48GB | $0,99 / $0,79 | Secure vs Community Cloud |
| RunPod H100 SXM 80GB | $3,29 / $2,69 | Secure vs Community Cloud |
| Lambda H100 SXM (node 8x) | $3,99 per GPU | ~$23.300 / bulan 730 jam |
| Together AI HGX H100 | $3,99 on-demand, $3,19–$3,69 reserved | Syarat 7–180+ hari |
Item yang tidak pernah diperhitungkan: jam menganggur, redundansi, dan tenaga kerja pemeliharaan
Node yang disewa ditagih berdasarkan jam dinding. Tagihan API Anda melacak token, sementara tagihan GPU Anda melacak jam yang mungkin tidak pernah Anda gunakan. Jika lalu lintas Anda adalah jam kerja dan hari kerja, Anda membayar sekitar 168 jam kapasitas berguna dari 730 dan membuang sisanya, jadi kalikan biaya token efektif Anda dengan empat sebelum membandingkannya dengan tagihan API. Tambahkan node kedua atau kunci API cadangan jika layanan menghadap pelanggan, karena node tunggal tidak memiliki failover. Tambahkan engineer yang menambal vLLM, merotasi versi model, memantau tekanan cache KV, dan dipanggil pukul 2 pagi. Vendor di direktori platform machine learning kami akan mengelola sebagian dari itu dengan margin, yang biasanya lebih murah daripada setengah headcount yang akan Anda habiskan.
Jadi angka bulanan yang dapat dipertahankan adalah: jam node pada tarif nyata penyedia Anda, dibagi uptime nyata Anda, ditambah redundansi, ditambah waktu engineering yang termuat. Jalankan semua empat sebelum Anda membandingkan apa pun.
Opsi ketiga yang membunuh sebagian besar kasus self-hosting
Hampir setiap artikel yang membandingkan open source dengan SaaS meletakkan tagihan GPU di samping tagihan API frontier dan menyatakan pemenang. Perbandingan itu melewati opsi yang seharusnya dipilih oleh kebanyakan tim: orang lain menjalankan bobot terbuka untuk Anda, multi-penyewa, dan mengenakan biaya per token.
DeepInfra menyajikan Llama-3.3-70B-Instruct-Turbo seharga $0,10 input / $0,32 output per juta token, dan Meta-Llama-3.1-8B seharga $0,02/$0,04 (DeepInfra). Checkpoint yang sama yang akan Anda unduh. Syarat lisensi yang sama. Perbedaannya adalah H100 mereka berjalan hampir penuh kapasitas untuk ribuan pelanggan, sementara milik Anda berjalan pada beban lalu lintas Anda pukul 3 pagi pada hari Minggu.
Bobot terbuka yang identik, kurva hunian milik orang lain
Jalankan kalkulasinya terhadap tier dedicated DeepInfra sendiri dan selisihnya menjadi memalukan. H100 80GB dedicated berharga $2,20/jam di sana (DeepInfra), jadi $1.606 untuk bulan 730 jam. Dengan $0,32 per juta token output, $1.606 yang sama membeli sekitar lima miliar token output di endpoint serverless. Tersebar selama 43.800 menit dalam bulan itu, H100 tunggal Anda harus mempertahankan sekitar 115.000 token output per menit, setiap menit, hanya untuk menyamai API dari sisi harga. Deployment nyata menghabiskan sebagian besar menit tersebut dalam keadaan menganggur.
Anda membeli kapasitas dedicated karena alasan selain harga per unit: residensi data, tidak ada retensi pihak ketiga, lantai latensi yang Anda kendalikan, LoRA kustom, model yang tidak di-host siapa pun. Itu nyata. Itu adalah alasan pengadaan daripada alasan spreadsheet, dan Anda harus mengatakannya dengan jelas saat Anda mengajukan proposal.
Kapan menyewa bobot berhenti menjadi lebih murah
Ujung pasar model kecil telah runtuh ke dalam dirinya sendiri. GPT-5-nano berjalan $0,05/$0,40 per juta token dan GPT-5 berjalan $1,25/$10,00 (OpenAI), yang berarti model proprietary sekarang lebih murah dari apa yang Anda bayarkan untuk menjaga model open 8B tetap hangat di hardware Anda sendiri. API open-weight murah dan API proprietary murah bersaing pada sumbu yang sama, dan self-hosting kalah dari keduanya.
Pilih benchmark Anda dengan hati-hati, karena itu menentukan jawabannya. Rentang Anthropic berjalan dari $10/$50 per juta untuk Fable 5.1 turun ke $1/$5 untuk Haiku 4.5 (Anthropic). Benchmark self-hosting terhadap ujung atas rentang itu dan terlihat seperti nilai bagus. Benchmark terhadap Haiku, atau terhadap Llama DeepInfra, dan node GPU harus membenarkan dirinya sendiri dengan kontrol daripada biaya.
Empat modalitas, empat titik impas yang sepenuhnya berbeda
Tim yang melakukan self-host transkripsi hampir tidak pernah melakukan self-host inferensi teks, dan alasannya adalah aritmatika. Setiap workload memiliki harga floor SaaS-nya sendiri, pola beban GPU-nya sendiri, dan aturan lisensinya sendiri. Jalankan satu model titik impas untuk semua empat dan Anda akan mendapat jawaban yang salah tiga kali.
Inferensi teks: titik perpindahan terlebar dan paling tidak dapat diprediksi
Ini adalah modalitas di mana titik perpindahan paling banyak bergerak, karena harga API yang Anda bandingkan mencakup satu orde besaran. Anthropic mengenakan $2/$10 per juta token input/output untuk Sonnet 5 dan $1/$5 untuk Haiku 4.5 (harga Claude), sementara OpenAI mencantumkan GPT-5-mini seharga $0,25/$2,00 dan GPT-5-nano seharga $0,05/$0,40 (harga API OpenAI). Pilih tier benchmark Anda dan titik impas berayun dari beberapa ratus juta token per bulan hingga beberapa miliar.
H100 dedicated seharga $2,20/jam di DeepInfra berjalan sekitar $1.606 sebulan pada uptime penuh (harga DeepInfra). Dibandingkan tarif gabungan GPT-5-nano, Anda membutuhkan volume yang jarang dicapai kebanyakan tim. Dibandingkan Fable 5.1 seharga $10/$50 per juta (harga Claude), node yang sama terbayar jauh lebih cepat. Tentukan tier mana yang dibutuhkan workload Anda sebelum Anda memodelkan apa pun, dan jelajahi daftar model dan LLM jika Anda masih memilih open weight.
Pembuatan gambar: lisensi yang memutuskannya sebelum GPU melakukannya
Di sini kalkulasi GPU adalah bagian yang mudah dan lisensi adalah jebakannya. Bobot FLUX.1 [dev] banyak dilaporkan dikirimkan di bawah lisensi non-komersial, yang akan menempatkan lisensi berbayar Black Forest Labs di antara Anda dan produk komersial, jadi baca syaratnya sendiri sebelum Anda menganggarkan hardware. Tidak ada yang membandingkan model gambar terbuka dengan Midjourney yang membahasnya, dan itu adalah item yang bisa membalik keputusan.
Pekerjaan gambar yang meledak-ledak adalah yang gagal dalam tes. Tim pemasaran yang menghasilkan gambar secara massal pada hari Selasa membiarkan kartu menganggur selama sisa minggu, dan jam menganggur ditagih dengan tarif yang sama seperti jam sibuk. L40S seharga $0,79/jam di RunPod Community Cloud (harga RunPod) cukup murah sehingga pekerjaan batch kondisi tunak melewati ambang batas dengan nyaman, itulah mengapa pipeline terjadwal adalah bentuk yang berhasil di sini. Ada 727 alat pembuatan gambar di direktori kami, dan syarat lisensi bervariasi lebih dari kualitas output.
Transkripsi: modalitas yang paling cepat mencapai titik impas
Kecuali biasanya tidak, dan alasannya adalah AssemblyAI. OpenAI mengenakan $0,006/menit untuk Whisper dan gpt-4o-transcribe, dan $0,003/menit untuk gpt-4o-mini-transcribe, yaitu $0,36 dan $0,18 per jam audio (harga API OpenAI). Dibandingkan $0,36/jam, L40S seharga $0,79/jam mencapai titik impas pada sekitar beberapa ratus jam audio per bulan, dengan asumsi throughput batch lebih cepat dari realtime. Itu ambang batas yang benar-benar rendah. Kemudian AssemblyAI menetapkan harga Universal-2 seharga $0,15/jam dan Universal-3.5 Pro seharga $0,21/jam (harga AssemblyAI), dan titik impas Anda naik lebih dari 2x.
Satu tempat di mana self-hosting masih menang secara mutlak adalah streaming. AssemblyAI menagih streaming per durasi sesi WebSocket, termasuk waktu koneksi menganggur (harga AssemblyAI). Jika Anda membuka soket untuk rapat di mana orang tidak berbicara, Anda membayar untuk keheningan. Endpoint yang di-host sendiri mengenakan biaya untuk detik GPU, bukan jam dinding.
RAG dan lapisan vektor berjalan berdasarkan volume kueri
Titik impas pencarian vektor dihitung dalam kueri per bulan, dan angka yang beredar mendarat di sekitar 60 hingga 80 juta kueri sebelum self-hosting mengalahkan harga terkelola. Anggap itu sebagai aturan praktis daripada kartu tarif, karena berubah dengan ukuran indeks, jumlah replika, dan seberapa banyak anggaran latensi yang bersedia Anda habiskan. Di bawah rentang itu Anda membayar seorang engineer untuk mengawasi indeks yang akan dijalankan layanan terkelola dengan biaya lebih rendah dari gaji mereka. Pembuatan embedding adalah kalkulasi terpisah lagi, dan itu adalah hal termurah untuk di-host sendiri dari semua yang dibahas di sini karena modelnya kecil dan pekerjaan dapat di-batch dengan sempurna.
Empat workload, empat ambang batas, dan tidak ada alasan untuk memindahkan semuanya sekaligus.
Beli hardware? Krisis memori 2026 mengatakan sewa
Setiap kalkulasi payback yang Anda baca yang ditulis sebelum pertengahan 2026 menggunakan harga yang sudah tidak berlaku lagi. Sarannya masuk akal pada saat itu: beli sebuah mesin, amortisasi selama tiga tahun, kalahkan tarif sewa pada bulan ke-14. Kemudian pasar memori rusak.
Kenaikan harga ~87% pada GPU yang tidak berubah
NVIDIA RTX PRO 6000 Blackwell 96GB adalah contoh paling jelas karena produknya tidak berubah. Tercantum seharga $8.565 di pengecer pada awal 2025 (dengan harga pre-order terendah $7.673), mencapai $13.250 pada Juni 2026, dan $16.000 pada Agustus 2026 (igor'sLAB). Itu sekitar 87% dalam 18 bulan, dan NVIDIA tidak mempublikasikan penjelasan resmi.
Masukkan itu ke dalam spreadsheet era 2025 dan bulan payback kira-kira berlipat ganda. Build workstation satu kartu yang Anda rencanakan seharga $12.000 total kini mendekati $20.000 sebelum Anda membeli RAM.
Mengapa HBM memakan pasokan DRAM
Permintaan GPU hanya setengah dari cerita. Yang penting adalah apa yang permintaan itu lakukan pada fab memori: memori bandwidth tinggi kini mengambil sekitar 23% kapasitas wafer DRAM global, naik dari 8% pada 2024, karena HBM menghasilkan pendapatan 3–5x per wafer dibandingkan DDR5 konvensional (DatacenterDisk). Fab memindahkan wafer ke mana uangnya berada. Harga DDR5 ECC RDIMM server naik sekitar 100% hingga 116% antara Q1 2025 dan Q1 2026, sehingga memori host di sekitar GPU Anda terpukul sekeras akselerator. Anda merasakannya dua kali dalam satu build: kartu, dan 1TB RAM sistem di bawahnya.
Apa yang harus diasumsikan jadwal depresiasi yang ditulis pada 2026
Asumsikan distorsi ini bertahan lebih lama dari keputusan pembelian Anda. Goldman Sachs memperkirakan pada Mei 2026 defisit DRAM global 4,9% untuk tahun ini, kekurangan terlebar dalam 15 tahun, ditambah kesenjangan pasokan HBM 5,1%, dan sebagian besar analis tidak memperkirakan perbaikan berarti sebelum akhir 2027 (Wccftech). Jadwal depresiasi tiga tahun yang dimulai hari ini menghabiskan dua tahun pertamanya dalam kekurangan.
Jadi hargakan kasus beli pada biaya akuisisi Agustus 2026 daripada angka 2025 yang masih ada di halaman peringkat, dan jangan asumsikan refresh yang lebih murah di tahun kedua. Jika angkanya hanya berhasil dengan harga hardware 2025, sewa. Menyewa adalah cara Anda mempertahankan opsi untuk membeli di 2028.
Kontrol dan kepatuhan: bagian yang terlewat oleh spreadsheet
Beberapa jaminan hanya bisa Anda dapatkan dengan menjalankan bobot sendiri. Sebagian besar yang dikutip tim sebagai alasan self-hosting, kini bisa Anda beli.
Apa yang benar-benar dibeli self-hosting, dan apa yang hanya tampak dibeli
Menjalankan inferensi sendiri memberi Anda empat hal yang tidak bisa direplikasi oleh klausul kontrak mana pun: bobot model yang tidak berubah di bawah Anda sesuai jadwal penghentian vendor, tidak ada data per permintaan yang keluar dari VPC Anda, tidak ada batas laju yang diberlakukan oleh perencanaan kapasitas orang lain, dan kemampuan untuk melakukan fine-tune atau kuantisasi tanpa meminta izin. Jika register risiko Anda memiliki baris tentang versi model yang dipensiunkan di tengah audit, itu adalah argumen nyata untuk memiliki artefak tersebut.
Daftar hal yang hanya tampak dibeli oleh self-hosting lebih panjang. Residensi data, enkripsi saat istirahat, komitmen tidak melatih data Anda, bukti SOC 2, log audit, pemrosesan regional: semua itu dapat dibeli sebagai syarat kontrak ditambah pemilih wilayah, dan sudah ada sejak lama. Membayar premi GPU untuk hal-hal itu berarti membeli dua kali. Risiko yang mendorong percakapan ini adalah kalkulasi penalti, dan kalkulasi penalti tidak peduli siapa yang memasang hardware. Regulator telah mengeluarkan €7,1 miliar dari 2.245 denda GDPR hingga awal 2026, dengan eksposur GDPR mencapai 4% omzet global dan eksposur AI Act hingga 7%. Model yang di-host sendiri yang salah konfigurasi gagal audit secepat yang di-host.
Reset regulasi 2026 mengubah tenggat waktu yang Anda rencanakan
Periksa tanggal pada timeline kepatuhan apa pun yang sedang dikerjakan tim Anda. Kewajiban berisiko tinggi EU AI Act ditunda oleh Digital Omnibus 2026, sehingga tenggat waktu 2 Agustus 2026 yang masih dicetak oleh beberapa halaman perbandingan yang banyak dikutip telah digantikan, dan Anda harus mengonfirmasi tanggal saat ini dengan penasihat hukum Anda sendiri sebelum menghabiskan anggaran berdasarkan itu. Jika Anda menyetujui anggaran self-hosting pada awal 2026 untuk melewati tanggal itu, urgensinya sudah hilang dan pengeluaran itu perlu dievaluasi ulang.
Ini paling penting di sektor yang diatur. Tim yang berbelanja alat AI kesehatan dan ilmu hayati adalah yang paling mungkin telah menghargai deployment privat terhadap tenggat waktu yang bergeser.
Cloud terkelola berdaulat adalah jalur tengah
Argumen residensi melemah selama 2026. Wilayah cloud berdaulat yang dikelola dan diatur di dalam EU kini menjadi opsi terkelola yang belum ada saat sebagian besar perbandingan open-source-versus-SaaS yang Anda temukan ditulis, jadi periksa apa yang ditawarkan hyperscaler pilihan Anda di dalam wilayah sebelum Anda menghargai sebuah node. Anda bisa mendapatkan penanganan data khusus EU tanpa mempekerjakan siapa pun untuk mengawasi vLLM pukul 2 pagi.
Urutan yang bertahan adalah ini. Jika kebutuhan Anda adalah residensi, beli cloud terkelola berdaulat. Jika itu adalah ketahanan bobot atau fine-tuning tak terbatas, lakukan self-host. Jika itu adalah baris dalam kuesioner yang mengatakan "data tidak boleh meninggalkan kendali kami," pergi baca apa yang akan diterima auditor Anda sebelum menandatangani node.
Seberapa jauh tertinggal bobot terbuka, sebenarnya?
Empat bulan. Itulah lag yang terukur, dan itu adalah angka yang harus menggantikan apa pun yang Anda yakini tentang model terbuka yang tertinggal satu generasi.
Empat bulan dan enam poin indeks
Epoch AI mengukurnya dengan melacak rilis open-weight terbaik terhadap frontier tertutup pada Epoch Capabilities Index antara 1 Januari dan 28 Mei 2026: lag 4 bulan, atau 8 poin ECI dengan interval kepercayaan 90% dari 7 hingga 11. Artificial Analysis mengukur hal yang sama secara berbeda dan mendarat di tempat yang sama. Pemimpin terbuka mendapat skor 52 hingga 54 pada Intelligence Index-nya dibandingkan 60 milik GPT-5.5, selisih 6 poin yang 12 bulan lalu adalah 13 poin.
Jadi selisihnya nyata dan semakin kecil. Untuk sebagian besar workload produksi (klasifikasi, ekstraksi, ringkasan, jawaban berbasis retrieval, kode draf pertama) frontier empat bulan yang lalu sudah cukup. Untuk ekor penalaran keras, tidak, dan tidak ada jumlah pekerjaan prompt yang menutup 8 poin ECI. Pilih workload Anda sebelum Anda memilih sisi argumen. Rilis open-weight yang dilacak di direktori kami berputar cukup cepat sehingga model yang Anda uji pada bulan Maret bukan yang akan Anda deploy hari ini.
Kesenjangan adopsi-ke-produksi yang menghabiskan uang nyata tim
Model terbuka kalah dalam pengiriman daripada kemampuan. Survei State of Open Source AI 2026 (N=1.410) menemukan 79% developer AI mengadopsi model terbuka tetapi hanya 53% yang memasukkannya ke produksi, dibandingkan 71% adopsi dan 63% produksi untuk model tertutup. Mereka lebih banyak dicoba dan lebih sedikit dikirimkan.
Penurunan 26 poin itu adalah waktu engineering yang Anda bayarkan dan tidak tercermin dalam lembar TCO Anda. Ini juga semakin buruk dengan skala daripada membaik: tingkat produksi model tertutup naik dari 54% di perusahaan kecil menjadi 73% di enterprise, sementara terbuka hampir stagnan di 53% hingga 57%. Organisasi dengan engineer platform terbanyak adalah yang paling sering meninggalkan deployment terbuka, yang merupakan kebalikan dari prediksi pitch self-hosting. Anggarkan untuk upaya yang tidak berhasil dikirimkan.
Jalur migrasi: apa yang sebenarnya dibutuhkan perpindahan
Penggantiannya sendiri itu murah. Yang menghabiskan uang Anda adalah pekerjaan evaluasi yang Anda lewati sebelum penggantian, yang kemudian Anda bayar dalam insiden produksi.
Pertukaran base-URL, dan pengecualian yang terdokumentasi yang perlu disebutkan
vLLM dilengkapi server yang kompatibel dengan OpenAI, sehingga untuk penyelesaian obrolan biasa migrasinya adalah base URL dan alias model. Arahkan klien Anda yang ada ke endpoint Anda, ubah model dari gpt-5-mini ke apa pun yang Anda sajikan, biarkan sisa kode. Itulah bagian yang diperlakukan setiap pesaing sebagai kotak hitam dan sejujurnya itu adalah setengah yang mudah.
Pengecualiannya adalah tempat tim kehilangan seminggu. Output terstruktur dan penegakan skema JSON ketat berperilaku berbeda di seluruh stack serving, jadi apa pun yang mengandalkan argumen fungsi yang dijamin valid memerlukan pengujian pada payload nyata daripada smoke test. Panggilan alat paralel adalah kesenjangan yang umum. Cache prompt bersifat spesifik penyedia, dan jika model biaya Anda mengasumsikan tarif input yang di-cache di sisi SaaS, diskon itu tidak mengikuti Anda. Perilaku konteks panjang terdegradasi pada titik yang berbeda dari yang diiklankan jendela konteks, dan tokenizer juga berbeda, yang berarti anggaran berbasis jumlah token dan logika pemotongan Anda keduanya perlu dikalibrasi ulang.
Bangun harness evaluasi sebelum cutover, bukan setelahnya
Jika Anda tidak dapat mengukur kualitas pada lalu lintas Anda sendiri, Anda tidak dapat mengetahui apakah lag kemampuan empat bulan itu penting untuk kasus penggunaan Anda atau tidak. Tangkap beberapa ratus permintaan produksi nyata beserta outputnya, beri skor sesuai cara bisnis Anda menilainya, lalu jalankan model terbuka kandidat terhadap set yang sama. Lakukan ini sebelum Anda menyediakan GPU.
- Log 200 hingga 500 permintaan nyata beserta respons dan sinyal hilir apa pun yang sudah Anda lacak (jempol, pengeditan, percobaan ulang, eskalasi).
- Beri skor output SaaS incumbent untuk menetapkan baseline Anda. Anda membutuhkan angka yang Anda pertahankan, bukan perasaan.
- Jalankan kandidat open-weight melalui API terlebih dahulu, karena DeepInfra menyajikan Llama-3.3-70B seharga $0,10 input / $0,32 output per juta token (DeepInfra) dan tidak membutuhkan infrastruktur untuk diuji.
- Hanya jika kualitas bertahan dan volume membenarkannya, pindah ke kapasitas dedicated.
Default hibrida: rute berdasarkan kelas permintaan daripada mengganti secara menyeluruh
Bagi lalu lintas berdasarkan nilai setiap permintaan. Klasifikasi, ekstraksi, ringkasan, dan reformulasi retrieval berjalan baik pada model 8B seharga $0,02/$0,04 per juta token (DeepInfra), dan ekor penalaran keras menuju Sonnet 5 seharga $2/$10 (Anthropic). Jika 80% panggilan Anda adalah kelas murah, Anda telah memangkas sebagian besar tagihan tanpa mempertaruhkan kualitas pada satu model.
Routing juga memberi Anda jalur fallback, yang tidak dimiliki penggantian menyeluruh. Stack serving dan router membentuk sebagian besar dari 128 framework AI di direktori kami, dan repo AI open-source yang layak dimulai adalah yang memiliki antarmuka kompatibel OpenAI, karena itulah yang membuat rollback Anda hanya satu perubahan konfigurasi.
Siapa yang harus beralih di 2026 — dan siapa yang tidak
Tiga profil memiliki aritmatika yang berpihak pada mereka. Tiga tidak, dan tidak ada jumlah antusias dari tim platform Anda yang memperbaiki itu.
Tiga profil di mana self-hosting jelas menang
Transkripsi volume tinggi dengan beban stabil. Jika Anda mendorong lebih dari beberapa ribu jam audio per bulan melalui pipeline yang berjalan terjadwal, Anda dapat menjaga kartu tetap sibuk dan mengalahkan floor $0,15/jam AssemblyAI (AssemblyAI). Pekerjaan batch adalah bentuk ideal di sini karena Anda mengontrol kapan antrean terkuras, sehingga menjaga kartu tetap terisi menjadi masalah penjadwalan daripada harapan.
Data yang diatur yang tidak boleh meninggalkan batas Anda, di mana kebutuhannya bersifat kontraktual daripada preferensi. Optimasi biaya bukan tujuan dalam kasus itu. Anda membeli jawaban audit, dan tagihan GPU adalah harganya.
Lima puluh lebih developer pada asisten pengkodean berbasis penggunaan. Pada sekitar 50 developer tagihannya mendekati $110.000 per bulan dibandingkan node yang dapat Anda saturasi, premi 3–9x, dan pada ~100 developer (~$220.000/bulan) hardware yang dimiliki terbayar dalam sekitar setahun (DoiT).
Tiga yang kalah hanya karena aritmatika
Tim di bawah sekitar 10 developer. Pada ~$22.000/bulan tagihan asisten seimbang dengan node yang tidak bisa disibukkan 10 orang itu (DoiT), dan keseimbangan itu tidak sepadan dengan rotasi on-call.
Siapa pun yang workload-nya adalah lalu lintas konsumen yang meledak-ledak. GPU yang menganggur ditagih dengan tarif penuh, dan kurva diurnal yang bergelombang berarti Anda membayar untuk puncaknya sementara rata-ratanya mungkin 20% dari itu. API model terbuka serverless sangat cocok untuk profil ini.
Tim yang standar kualitasnya berada di frontier. Jika evaluasi Anda hanya lulus pada Fable 5.1 seharga $10/$50 per juta token (Anthropic), model terbuka yang di-host sendiri adalah produk yang berbeda dengan level kualitas yang berbeda, dan penghematan membeli Anda penurunan kualitas.
Uji 90 hari yang harus dijalankan sebelum Anda mengkomitkan modal
- Minggu 1–2: ukur konkruensi, bukan pengeluaran. Log permintaan yang sedang berjalan per menit dan temukan p95 Anda. Jika di bawah 4, berhenti di sini.
- Minggu 3–6: arahkan 10% lalu lintas ke endpoint open-weight DeepInfra dan jalankan suite evaluasi Anda yang ada. Ini adalah perubahan base-URL dan alias model untuk sebagian besar stack.
- Minggu 7–12: sewa, jangan beli. H100 seharga $2,20/jam dedicated (DeepInfra) memberi Anda angka utilisasi nyata dengan biaya di bawah $1.700 per bulan, yaitu angka yang akan ditanyakan CFO Anda.
Jika kartu menganggur lebih dari 60% waktu di akhir itu, jawabannya adalah API open-weight terkelola, dan Anda telah menghabiskan satu kuartal untuk mengetahuinya daripada tiga tahun mendepresiasinya.
Pertanyaan yang Sering Diajukan
Apakah self-hosting AI open-source benar-benar lebih murah daripada kursi ChatGPT Business atau Claude Team?
Pada harga kursi daftar, tidak. Claude Team berharga $20 per kursi per bulan dengan penagihan tahunan ($25 bulanan), dengan kursi premium seharga $100/$125, dan Enterprise adalah $20 per kursi per tahun ditambah penggunaan pada tarif API (harga Anthropic). Tidak ada GPU yang disewa mendekati $20 per kepala, jadi langganan tarif tetap adalah hal paling sulit dalam AI untuk dikalahkan dengan hardware Anda sendiri. Self-hosting mulai bersaing hanya ketika tim Anda menggunakan penagihan berbasis penggunaan, di mana engineer DoiT sendiri rata-rata sekitar $2.200 per developer per bulan (DoiT).
Pada pengeluaran bulanan berapa self-hosting LLM mencapai titik impas di 2026?
Sekitar $15.000 hingga $25.000 per bulan pengeluaran API berbasis penggunaan, yang pada $2.200 yang diamati DoiT per developer per bulan menghasilkan sekitar 7 hingga 12 kursi berat (DoiT). Angka tersebut bergerak lebih banyak dengan penyedia cloud daripada dengan model Anda: node 8xH100 yang sama untuk bulan 730 jam berharga sekitar $12.600 di Nebius spot, $22.500 di Nebius on-demand, $40.200 di AWS, dan $71.800 di Azure (DoiT). Jumlah anggota tim adalah unit yang salah. Hanya 10 hingga 20% tim developer yang memiliki permintaan aktif pada saat tertentu, sehingga sepuluh developer adalah dua atau tiga sesi konkuren, paling banyak setengah kapasitas node (DoiT).
Berapa banyak jam GPU yang saya butuhkan untuk mengalahkan $0,36 per jam audio Whisper API?
Throughput menyelesaikan ini, dan jam hanya penting melalui tarif yang ditagihkan. OpenAI mengenakan $0,006/menit untuk Whisper dan gpt-4o-transcribe, yaitu $0,36 per jam audio, dan $0,003/menit ($0,18/jam) untuk gpt-4o-mini-transcribe (OpenAI). Pada RunPod L40S 48GB seharga $0,79/jam Community Cloud (RunPod), Anda membutuhkan throughput lebih baik dari sekitar 2,2x realtime untuk mengalahkan $0,36, sekitar 4,4x untuk mengalahkan tier mini, dan sekitar 5,3x untuk mengalahkan tarif $0,15/jam Universal-2 AssemblyAI (AssemblyAI). Waktu GPU menganggur dihitung melawan Anda, jadi deployment hanya menang dengan antrean yang stabil daripada lalu lintas harian yang meledak-ledak.
Apakah AI open-source gratis digunakan secara komersial?
Tidak, dan model gambar adalah tempat tim tersandung. Bobot FLUX.1 [dev] dilaporkan membawa lisensi non-komersial, yang akan menempatkan lisensi berbayar Black Forest Labs di antara Anda dan deployment komersial, jadi baca syaratnya sebelum Anda merencanakannya. Bahkan dengan bobot yang sepenuhnya permisif, komputasi tidak gratis: DeepInfra menyajikan Llama-3.3-70B-Instruct-Turbo seharga $0,10 input dan $0,32 output per juta token, dan Meta-Llama-3.1-8B seharga $0,02/$0,04 (DeepInfra), yang lebih murah dari yang bisa dijalankan kebanyakan tim dengan bobot identik sendiri pada H100 dedicated seharga $2,20/jam.
Apakah saya harus melakukan self-host untuk mematuhi GDPR dan EU AI Act?
Tidak. Kepatuhan berkaitan dengan lokasi data, perjanjian pemrosesan, dan dokumentasi, yang tidak mengharuskan Anda memiliki stack inferensi. Taruhannya nyata (regulator telah mengeluarkan €7,1 miliar dari 2.245 denda GDPR hingga awal 2026, dan eksposur mencapai 4% omzet global di bawah GDPR ditambah hingga 7% di bawah AI Act, per Kiteworks), tetapi opsi hosting terkelola dan berdaulat wilayah EU kini mencakup sebagian besar yang diminta petugas perlindungan data. Lakukan self-host ketika kontrak atau regulator secara khusus melarang pemrosesan pihak ketiga, bukan sebagai lindung nilai umum.
Haruskah saya membeli GPU atau menyewanya selama kekurangan memori 2026?
Sewa, kecuali Anda memiliki workload multi-tahun yang menjaga kartu tetap sibuk. NVIDIA RTX PRO 6000 Blackwell 96GB naik dari harga pengecer $8.565 pada awal 2025 menjadi $13.250 pada Juni 2026 dan $16.000 pada Agustus 2026, sekitar 87% lebih mahal untuk produk yang tidak berubah (igor'sLAB). Penyebabnya adalah memori: HBM kini mengambil sekitar 23% kapasitas wafer DRAM global versus 8% pada 2024, dan harga DDR5 ECC RDIMM server naik sekitar 100 hingga 116% antara Q1 2025 dan Q1 2026 (DataCenterDisk). Goldman Sachs memperkirakan defisit DRAM 4,9% untuk 2026, terlebar dalam 15 tahun, dengan pemulihan tidak mungkin sebelum akhir 2027 (Wccftech), jadi rencanakan harga pembelian yang tetap tinggi dan ambil selisih pasar sewa sebagai gantinya, dari $2,20/jam untuk H100 dedicated di DeepInfra hingga $4,29/jam di Lambda.