

Output Anda biasa-biasa saja karena input Anda terlalu besar, usang, atau urutan yang buruk. Bukan karena Anda salah merumuskan prompt. Dokumentasi Anthropic sendiri menyebutnya secara gamblang: "lebih banyak konteks tidak otomatis lebih baik. Saat jumlah token bertambah, akurasi dan recall menurun, fenomena yang dikenal sebagai context rot" (Claude Platform docs). Context engineering adalah solusinya, dan Anthropic mendefinisikannya sebagai mengkurasi "kumpulan token (informasi) yang optimal selama inferensi LLM" (Anthropic Engineering).
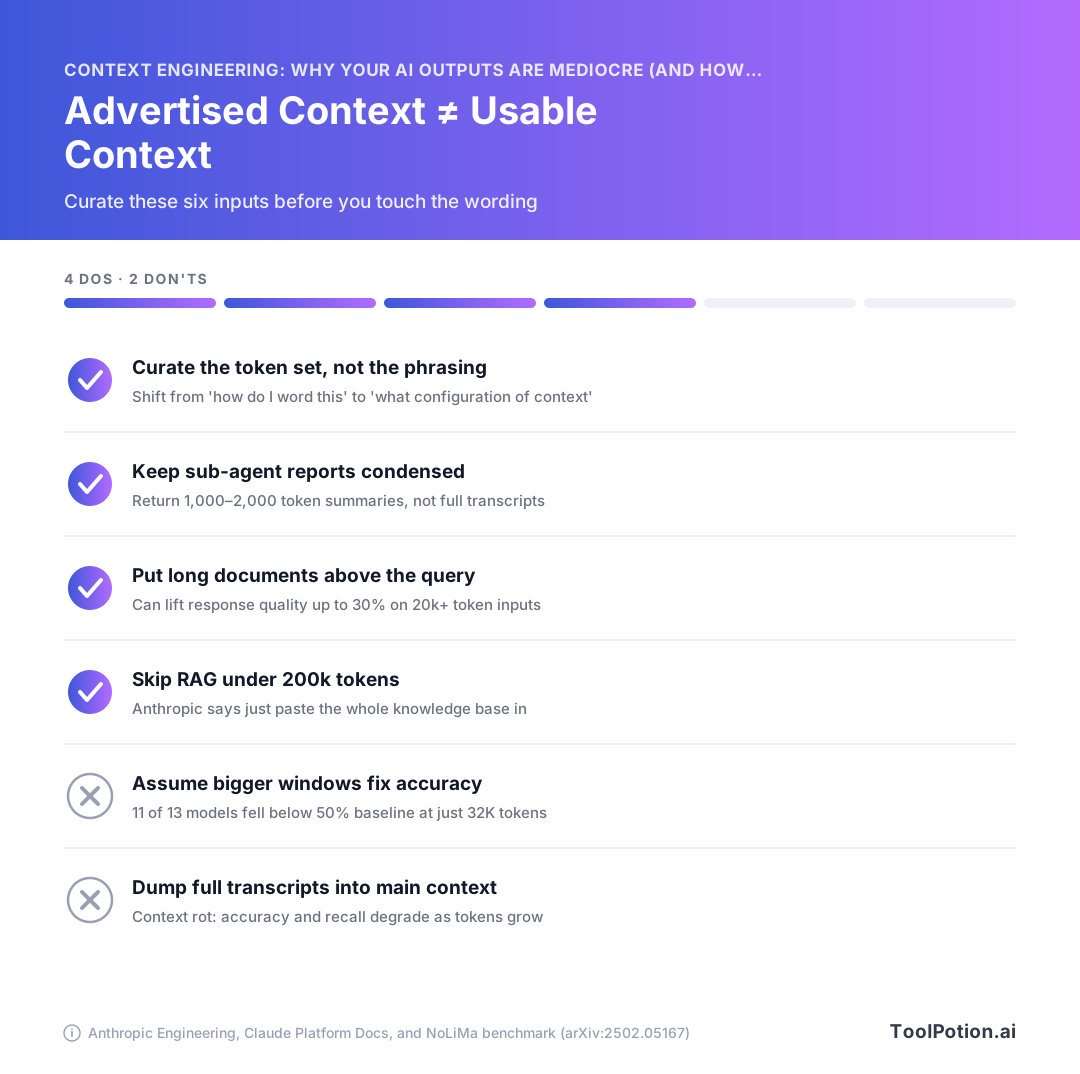
Angka-angkanya tidak berpihak pada kebiasaan maksimalis. Pada NoLiMa, 11 dari 13 model yang semuanya mengiklankan konteks 128K ke atas jatuh di bawah setengah skor konteks pendek mereka pada 32K token (arXiv:2502.05167).
Ini adalah panduan bagi orang yang menggunakan ChatGPT, Claude, Gemini, dan Copilot, bukan yang membangun framework agen: pengaturan mana yang perlu diubah, di produk mana, dan apa nilainya.
Context engineering adalah yang menggantikan prompt magic
Jika output Anda biasa-biasa saja, cara perumusan prompt Anda jarang menjadi masalahnya. Context engineering adalah praktik yang memperbaiki ini: Anthropic mendefinisikannya sebagai "kumpulan strategi untuk mengkurasi dan memelihara kumpulan token (informasi) yang optimal selama inferensi LLM, termasuk semua informasi lain yang mungkin masuk ke sana di luar prompt", dan menyebutnya sebagai perkembangan alami dari prompt engineering (Anthropic Engineering). Pertanyaan bergeser dari "bagaimana saya merumuskan ini?" menjadi "konfigurasi konteks mana yang paling mungkin menghasilkan perilaku yang diinginkan dari model kita?"
Dari "bagaimana saya merumuskan ini?" menjadi "apa yang seharusnya ada dalam window?"
Perumusan tetap penting di batas-batas tertentu. Ia hanya berhenti menjadi titik leverage utama. Pertanyaan yang dirumuskan dengan sempurna terhadap window yang penuh dan kurang relevan akan kalah dari pertanyaan yang sederhana terhadap window yang bersih, dan sisa artikel ini sebagian besar merupakan bukti untuk klaim tersebut.
Sebagian besar dari 212 alat prompt engineering yang kami lacak mengoptimalkan kalimat yang Anda ketik. Hampir tidak ada yang menyentuh lima hal lain yang berbagi window dengannya.
Lima input yang benar-benar Anda kendalikan
Setiap permintaan menyusun window dari bagian-bagian yang bisa Anda lihat dan ubah:
- Instruksi sistem, baik itu kolom instruksi custom GPT, deskripsi Claude Project, atau file CLAUDE.md di repo Anda.
- Memori: apa pun yang telah disimpan produk tentang Anda antar sesi, biasanya tanpa menampilkan teks lengkapnya kepada Anda.
- Dokumen yang dilampirkan dan kualitas penguraiannya, yang merupakan variabel paling underrated di seluruh tumpukan.
- Chunk yang diambil, jika alat melakukan retrieval, ditambah apa pun yang diputuskan retriever sebagai relevan.
- Giliran sebelumnya dalam percakapan, termasuk setiap jalan buntu yang Anda tinggalkan dua puluh pesan yang lalu.
- Definisi alat, yang menghabiskan token meskipun tidak ada alat yang dipanggil.
Itu ada enam, dan Anda mengendalikan semuanya dari UI produk. Tidak perlu framework, tidak perlu API key.
Jadi ini adalah panduan dari sisi input, ditulis untuk orang yang menggunakan ChatGPT, Claude, Gemini, dan Copilot daripada membangun sistem agen di atasnya. Pengaturan mana yang perlu diubah, di produk mana, dan apa yang dikatakan angka-angka 2026 tentang nilainya.
Context window AI dijelaskan: ukuran yang diiklankan vs ukuran yang bisa digunakan
Angka di lembar spesifikasi adalah batas penyimpanan, bukan jaminan kinerja. Model yang menerima satu juta token akan dengan senang hati menerimanya dan kemudian memberikan jawaban yang lebih buruk daripada jika hanya dengan 3.000 token. Perlakukan window yang diiklankan sebagai langit-langit ruangan, bukan ukuran meja kerja Anda.
Apa yang sebenarnya dihitung terhadap window
Lebih banyak dari yang Anda kira. Setiap bagian dari permintaan API menempati anggaran yang sama: system prompt, setiap pesan dalam thread termasuk hasil alat, gambar dan PDF, definisi alat itu sendiri, dan output model sendiri termasuk extended thinking (Claude Platform docs). Prefix yang di-cache tetap menempati window juga. Prompt caching mengubah apa yang Anda bayar untuk token tersebut, bukan apakah mereka dihitung.
Jadi percakapan yang terasa singkat bisa membawa 40.000 token berupa PDF terlampir, skema alat, dan penalaran sebelumnya yang tidak pernah Anda lihat. Itulah bagian yang ditinggalkan oleh halaman-halaman ensiklopedia.
Tebing 32K yang tidak ada di lembar spesifikasi
Benchmark NoLiMa menghapus tumpang tindih kata harfiah antara pertanyaan dan jawaban yang terkubur dalam tumpukan data, lalu menjalankan 13 model yang semuanya mengklaim konteks 128K atau lebih. Di bawah 1K token, hasilnya bagus. Pada 32K, 11 dari 13 telah jatuh di bawah setengah baseline konteks pendek mereka sendiri, dan Llama 3.1 70B turun dari 94,3% menjadi 42,7% (NoLiMa, arXiv:2502.05167). Preprint tersebut dari Februari 2025, sehingga mendahului setiap model dalam tabel di bawah. Bentuk temuan ini masih bertahan dalam karya terbaru, tetapi persentase spesifiknya adalah bukti yang sudah menua, bukan kartu skor terkini.
Ukuran window saat ini (angka 2026)
| Model | Context window | Maks output | Gambar/halaman PDF per permintaan |
|---|---|---|---|
| Claude Fable 5.1, Opus 5, Sonnet 5 (dan Mythos 5.1, Opus 4.8/4.7/4.6, Sonnet 4.6) | 1M token, default, harga standar | 128k | 600 |
| Claude Sonnet 4.5 dan lebih lama | 200k | — | 100 |
| OpenAI GPT-5.4 | 1.050.000 token | 128.000 | — |
Anthropic menghadirkan window 1M tersebut tanpa header beta dan tanpa biaya tambahan (Claude Platform docs). Milik OpenAI secara nominal lebih besar dan dihargai berbeda: melewati 272K input token pada GPT-5.4 dan seluruh sesi ditagih 2x input dan 1,5x output (OpenAI API docs). Pemborosan adalah item baris di sana, bukan hanya pajak kualitas.
Jika Anda membandingkan kapasitas antar vendor, periksa halaman spesifikasi model itu sendiri daripada rangkuman: window berubah dua kali pada tahun 2026 saja, dan tabel usang ada di mana-mana. Direktori kami yang berisi 324 model AI adalah titik awal untuk menemukan halaman yang tepat.
Context rot: mengapa menambahkan lebih banyak biasanya memperburuk output
Degradasi ini memiliki mekanisme, dan itu tidak misterius. Transformer harus memodelkan n² hubungan berpasangan di seluruh n token, sehingga setiap token yang Anda tambahkan membuat setiap token lain sedikit lebih bersaing untuk mendapatkan perhatian model. Tim engineering Anthropic menyebut ini sebagai anggaran perhatian yang terbatas, mirip dengan memori kerja manusia, dan mengatakan perhatian menjadi "terbagi tipis" saat konteks bertambah. Resep mereka jelas: temukan "kumpulan token berkualitas tinggi yang sekecil mungkin yang memaksimalkan kemungkinan hasil yang diinginkan."
Masalah anggaran perhatian
Dokumen produk Anthropic sendiri mengakui hal ini daripada memutar-mutarnya. "Lebih banyak konteks tidak otomatis lebih baik," kata dokumentasi platform. "Saat jumlah token bertambah, akurasi dan recall menurun, fenomena yang dikenal sebagai context rot." Itulah vendor yang menjual window 1M token kepada Anda yang mengatakan agar tidak mengisinya.
Pertanyaan yang sama, jawaban yang sama, 375x kebisingan
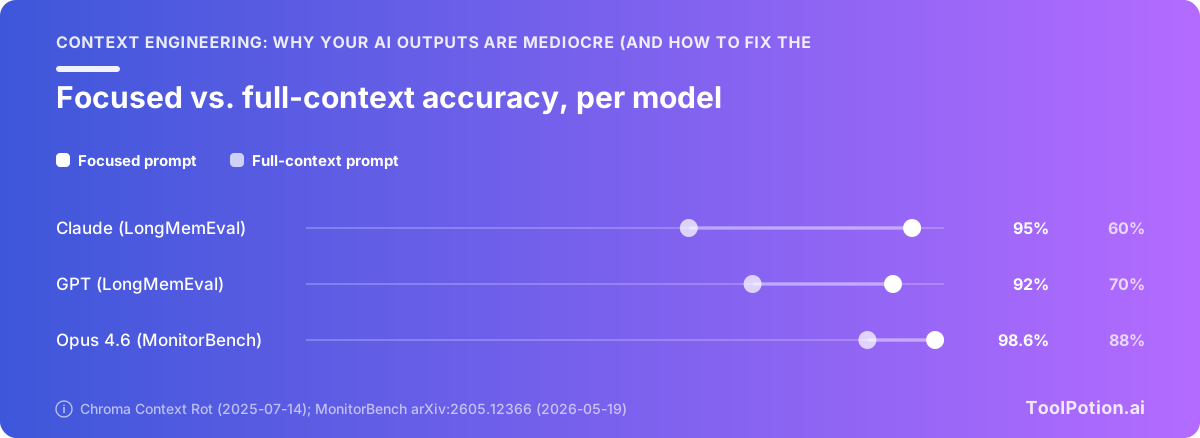
Chroma menguji 18 model, termasuk GPT-4.1, Claude 4, Gemini 2.5, dan Qwen3, dan menemukan keandalan menurun dengan input yang lebih panjang bahkan pada tugas sepele seperti retrieval dan replikasi kata (Chroma). Pengujian LongMemEval adalah yang perlu diingat. Setiap keluarga model melakukan jauh lebih baik pada prompt terfokus sekitar 300 token yang hanya berisi giliran relevan dibandingkan pada prompt penuh sekitar 113k token yang membawa seluruh riwayat percakapan, dengan model Claude menunjukkan kesenjangan terlebar. Pertanyaan yang sama. Jawaban yang sama ada dalam konteks di kedua waktu. Satu-satunya variabel adalah seberapa banyak materi yang tidak relevan mengelilinginya.
Chroma juga menemukan bahwa model mendapat skor lebih baik pada tumpukan data yang diacak daripada pada dokumen yang koheren secara logis, di semua 18 model. Teks sekitar yang koheren memberi model lebih banyak tempat yang terlihat masuk akal untuk mendarat. Laporan tersebut diterbitkan pada 2025-07-14, jadi sudah lebih dari setahun dan mendahului generasi model saat ini.
Efeknya belum menghilang. Pada MonitorBench, menambahkan 800k token tindakan yang tidak berbahaya dan tidak relevan menurunkan recall Opus 4.6 dari 98,6% menjadi 88% (arXiv:2605.12366). Tidak ada yang berubah dari tugasnya. Hanya paddingnya.
Di mana hal ini menggigit Anda dalam penggunaan normal
Anda sudah pernah mengalami ini tanpa memberi nama padanya. Chat yang dengan tepat menjawab brief Anda di pesan ke-12 dan menghasilkan filler generik di pesan ke-90, karena brief tersebut kini terkubur di bawah 78 pesan draf yang setengah ditinggalkan. Notebook NotebookLM tempat Anda menambahkan 40 sumber demi kelengkapan dan mulai mendapatkan jawaban yang lebih samar dibandingkan saat dengan delapan sumber. Sesi coding di mana model melupakan batasan yang Anda nyatakan sejam yang lalu dan dengan percaya diri menulis ulang di sekitarnya.
Tidak ada yang malas dari model tersebut. Anda-lah yang menghabiskan anggaran perhatian untuk token yang tidak memberikan nilai.
Persiapan dokumen: langkah yang hampir semua orang lewati
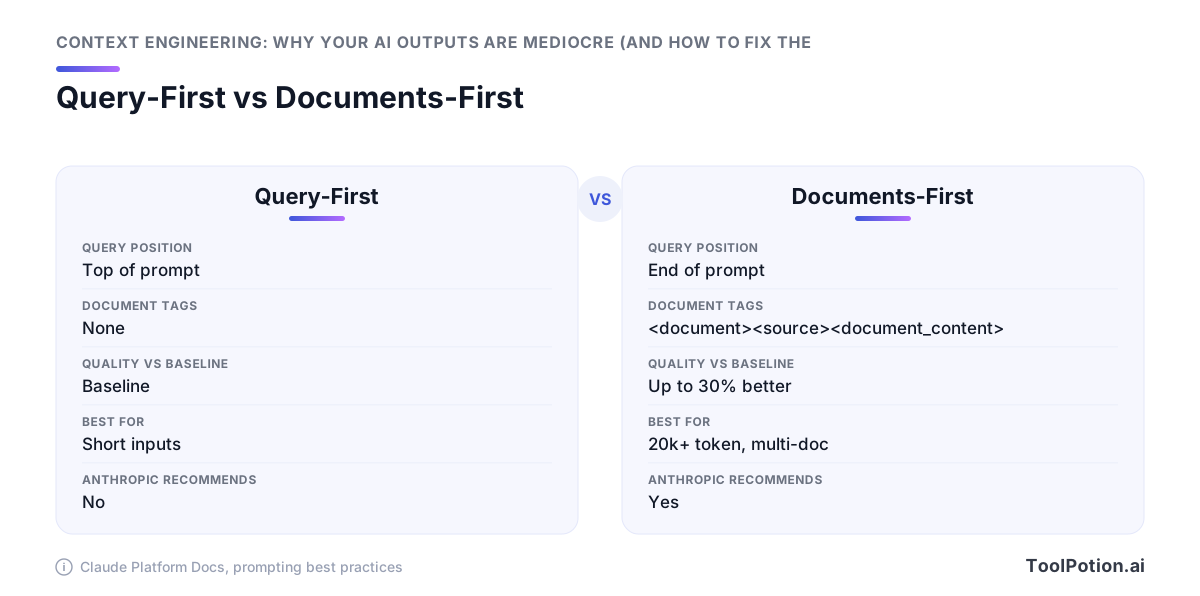
Di mana Anda meletakkan dokumen dalam prompt mengubah jawaban yang Anda dapatkan. Untuk input lebih dari 20.000 token, dokumentasi prompting Anthropic memberi tahu Anda untuk menempatkan data format panjang di bagian atas, di atas kueri, instruksi, dan contoh Anda: "kueri di akhir dapat meningkatkan kualitas respons hingga 30 persen dalam pengujian, terutama dengan input multidokumen yang kompleks" (Claude Platform docs). Sebagian besar orang melakukan sebaliknya. Mereka mengetik pertanyaan, lalu menempel laporan di bawahnya.
Letakkan materi panjang di bagian atas
Dokumen yang sama memberi Anda kerangka yang layak disalin secara verbatim: bungkus setiap dokumen dalam tag <document> dengan subtag <source> dan <document_content>, agar model dapat membedakan di mana satu file berakhir dan file berikutnya dimulai (Claude Platform docs). Kemudian minta untuk mengutip bagian yang relevan sebelum menjawab. Satu baris itu memaksa model untuk menemukan bukti dalam teks daripada merekonstruksinya dari apa yang setengah diingatnya, dan memberi Anda sesuatu yang bisa diperiksa ketika jawabannya terlihat salah.
<document>
  <source>Q3-board-deck.pdf</source>
  <document_content>...full text here...</document_content>
</document>
<document>
  <source>renewal-contract-2026.pdf</source>
  <document_content>...full text here...</document_content>
</document>

Before answering, quote the passages you relied on.
Question: which renewal terms conflict with the Q3 revenue plan?
Beri tag sumber Anda agar model dapat mengutipnya
Satu catatan sebelum Anda menstandarkan ini: vendor tidak sepakat. Anthropic menempatkan data panjang lebih dulu; panduan Google menunjukkan sebaliknya, meminta Anda untuk menutup dengan instruksi Anda. Jadi template prompt yang diambil dari tutorial Gemini dan ditempel ke Claude bisa berkinerja buruk tanpa pernah terlihat rusak. Jalankan kumpulan dokumen yang sama dengan kedua cara pada model yang sebenarnya Anda bayar, sepuluh pertanyaan masing-masing, dan pertahankan urutan yang menang. Itu adalah dua puluh menit kerja untuk klaim swing 30%.
Pilihan parser menentukan apa yang dilihat model
Tidak ada dari ini yang menyelamatkan ekstraksi yang rusak. Tabel faktur yang dipindai yang keluar sebagai satu baris panjang, makalah dua kolom yang diselingi baris per baris, catatan kaki yang disambungkan di tengah kalimat: model membaca sampah itu dengan setia dan menjawab dari situ. Langkah ekstraksi Anda menetapkan batas atas akurasi, dan segalanya di hilir dibatasi olehnya. Perlakukan parser sebagai keputusan kualitas dan uji dua atau tiga pada file nyata Anda yang paling sulit sebelum Anda berkomitmen. Direktori kami mencantumkan 217 alat dokumen dan PDF AI, dan kesenjangan antara yang baik dan yang buruk terlihat dalam output Anda, bukan di halaman pemasaran mereka.
Retrieval hygiene: lebih sedikit chunk yang lebih baik mengalahkan lebih banyak chunk
Sebelum Anda membangun lapisan retrieval, periksa apakah Anda membutuhkannya. Panduan Anthropic sendiri mengatakan bahwa jika basis pengetahuan Anda lebih kecil dari 200.000 token (sekitar 500 halaman), Anda bisa langsung menyertakan seluruhnya dalam prompt tanpa retrieval sama sekali (Anthropic Engineering). Sebagian besar wiki internal, buku panduan produk, dan kumpulan kebijakan masuk dalam batas tersebut.
Apakah Anda bahkan membutuhkan retrieval?
Jika korpus Anda cocok, lewati database vektor. Anda akan menghindari keputusan chunking, drift embedding, dan seluruh kelas kegagalan tersembunyi di mana paragraf yang tepat tidak pernah masuk ke dalam prompt. Pasangkan dengan prompt caching agar Anda tidak membayar harga penuh untuk token yang sama pada setiap panggilan sebesar 200k.
Di atas ukuran tersebut, retrieval berhenti menjadi opsional dan kualitas menjadi tumpukan perbaikan kecil yang saling menguatkan.
Tiga perbaikan yang saling menguatkan
Anthropic membenchmark-nya satu per satu. Menambahkan konteks spesifik chunk ke setiap chunk sebelum embedding memotong kegagalan retrieval top-20 dari 5,7% menjadi 3,7%, pengurangan sekitar 35%. Menambahkan pencarian hibrida BM25 kontekstual membawa kegagalan ke 2,9%, pemotongan 49%. Menambahkan reranking pass di atasnya membawa ke 1,9%, pengurangan total 67% (Anthropic Engineering). Setiap langkah tidak spektakuler sendiri dan ketiganya bersama-sama kira-kira melipattigakan peningkatan dari yang pertama.
Memangkas definisi alat juga penting
Skema alat adalah konteks. Jika Anda memberi model empat puluh definisi alat dan ia hanya membutuhkan dua, Anda telah membayar untuk tiga puluh delapan pengganggu. Pekerjaan RAG-MCP hanya mengambil skema yang relevan daripada mencantumkan semuanya dan memotong token prompt lebih dari setengah sementara akurasi pemilihan alat meningkat dari 13,62% menjadi 43,13% (arXiv:2505.03275). Itulah disiplin yang sama seperti pemilihan chunk, diterapkan satu lapisan lebih tinggi.
Pola sub-agen Anthropic memperluas ini lebih jauh: agen khusus melakukan penggalian dan mengembalikan ringkasan padat sekitar 1.000 hingga 2.000 token ke agen koordinator, sehingga konteks utama tidak pernah melihat transkrip pencarian mentah (Anthropic Engineering). Jika Anda memilih komponen daripada menulisnya, direktori kami mencantumkan 550 agen AI dan serangkaian framework retrieval dan agen yang mengimplementasikan pola-pola ini langsung dari kotak.
Fitur memori: pengaturan mana yang perlu diubah di setiap alat
Setiap produk AI konsumen sekarang menyuntikkan hal-hal ke dalam konteks Anda yang tidak Anda ketik. Fakta yang disimpan, chat sebelumnya, aktivitas aplikasi, file proyek yang diunggah. Anda tidak bisa melakukan context engineering dalam aplikasi chat sampai Anda mengetahui apa yang sudah ada di window sebelum kata pertama Anda.
Memori yang salah lebih mahal daripada tidak ada memori. Ini adalah teks yang terlihat berkualitas tinggi yang diperlakukan model sebagai fakta, dan ia berada di dekat instruksi Anda di mana perhatian paling kuat. Jabatan pekerjaan yang usang, nama klien lama, preferensi yang Anda atur sekali untuk tugas satu kali: masing-masing secara diam-diam membiaskan setiap jawaban setelahnya.
ChatGPT: dua toggle independen
Memori ChatGPT adalah dua mekanisme, bukan satu. Memori yang disimpan adalah fakta tersimpan diskret yang dapat Anda baca dan hapus satu per satu, sementara referensi riwayat chat mengambil dari percakapan sebelumnya melalui jalur retrieval terpisah (Embrace The Red). Mematikan yang satu membiarkan yang lain tetap berjalan. Jika output Anda masih terasa seperti proyek bulan lalu setelah Anda menghapus memori yang disimpan, toggle riwayat adalah yang Anda lewatkan.
Claude: pengetahuan proyek dan penulisan memori di tengah percakapan
Sejak unifikasi Cowork pada 25 Agustus 2026, Claude menulis memori di tengah percakapan daripada hanya di batas sesi, sehingga apa yang Anda katakan dalam chat terbawa ke sesi berikutnya (TechCrunch). Itu berarti komentar sambil lalu bisa menjadi konteks yang permanen.
Pengetahuan proyek adalah lever yang lebih baik, karena ini adalah korpus yang Anda pilih. Pertahankan di bawah aturan praktis 200.000 token Anthropic (sekitar 500 halaman) dan itu bisa dibawa sepenuhnya tanpa lapisan retrieval yang menebak chunk mana yang penting (Anthropic). Pangkas seperti daftar bacaan, bukan arsip.
Gemini: tiga sistem yang tumpang tindih di mana 'off' bukan 'dihapus'
Gemini melapisi konteks personal, info tersimpan yang Anda tulis sendiri, dan aktivitas dari aplikasi Google yang terhubung. Menonaktifkan sumber menghentikan penulisan baru. Ini tidak menghapus apa yang sudah tersimpan, jadi audit berarti mengunjungi setiap kontrol secara terpisah dan menghapus, bukan hanya mematikannya.
NotebookLM: alternatif dengan sumber terbatas
NotebookLM membatasi berapa banyak sumber yang bisa dimiliki notebook, dan batasan itu bekerja untuk keuntungan Anda. Ini memaksa kurasi yang dilewati oleh ketiga platform lainnya, yang merupakan disiplin yang sama yang ditentukan Anthropic: temukan kumpulan token berkualitas tinggi terkecil yang menghasilkan outcome yang Anda inginkan (Anthropic). Ketika pertanyaan membutuhkan delapan dokumen dan bukan delapan puluh, mulailah dari sana.
Pilih satu alat sebagai asisten penyimpan memori Anda dan jaga sisanya tetap bersih. Di antara 13.174 aplikasi AI dalam direktori kami, yang membuat memori dapat diaudit per item lebih berharga daripada yang menjanjikan mengingat segalanya.
Instruksi tingkat proyek adalah konteks yang dapat digunakan kembali
Konteks termurah yang pernah Anda tulis adalah konteks yang Anda tulis sekali. Setiap alat AI serius kini memiliki slot untuk instruksi tetap yang disuntikkan ke setiap sesi: AGENTS.md dan CLAUDE.md dalam repo, Claude Projects, instruksi kustom ChatGPT, file instruksi Copilot. Sebagian besar orang membiarkan slot tersebut kosong dan kemudian mengetik ulang tiga paragraf latar belakang yang sama ke setiap chat baru.
Mengapa file instruksi tetap mengalahkan penjelasan berulang
Sebuah studi di 10 repositori dan 124 pull request mengukur apa yang dilakukan file AGENTS.md tingkat repositori terhadap perilaku agen, dan hasilnya bukan hanya tentang ketepatan. Median waktu berjalan turun 28,64%, dari 98,57 detik menjadi 70,34 detik, dan token output turun 16,58% pada tingkat penyelesaian yang sebanding (arXiv:2601.20404). Agen berhenti mengeksplorasi untuk mengetahui hal-hal yang sudah Anda ketahui.
Itulah argumen dalam satu kalimat. Konteks tetap yang baik membuat model lebih cepat dan lebih murah, bukan hanya lebih akurat, karena sebagian besar yang dibakar agen dalam token adalah menemukan kembali konvensi Anda. Jika Anda memilih di antara 260 asisten coding AI dalam direktori kami, apakah alat membaca file instruksi proyek adalah filter yang lebih baik dari sebagian besar perbandingan fitur.
Apa yang sebenarnya layak ada di dalamnya
Pertahankan cukup pendek sehingga Anda sendiri mau membacanya. Lima hal yang layak ada:
- Konvensi yang tidak diumumkan oleh kode, seperti test runner mana yang nyata dan mana yang sudah tidak aktif.
- Kosakata Anda. Jika "account" dan "tenant" berarti hal berbeda di sini, katakan sekali.
- Bentuk output yang Anda inginkan, dalam format yang Anda inginkan (diff, tabel, lima poin).
- Daftar pendek larangan. Jangan sentuh file yang dihasilkan, jangan tambahkan dependensi tanpa bertanya.
- Di mana sumber kebenaran berada, agar model mengkuerinya daripada menebak.
Tinggalkan apa pun yang bisa dibaca alat sendiri. Pohon direktori, daftar file, tanda tangan fungsi yang diulangi, ringkasan README Anda. Token-token tersebut dihabiskan untuk menduplikasi sesuatu yang bisa diambil agen dalam satu panggilan, dan mereka bersaing untuk mendapatkan perhatian dengan instruksi yang penting. Tulis ulang file saat mulai diabaikan, yang biasanya berarti sudah terlalu panjang.
Context bloat memiliki harga
Konteks yang sembarangan menghabiskan uang di invoice, bukan hanya kualitas dalam output. Dua mekanisme penetapan harga membuat hal itu konkret, dan keduanya menghargai disiplin yang sama: prefix kecil, stabil, dan berurutan.
Step-function 272K pada GPT-5.4
GPT-5.4 OpenAI mengambil context window 1.050.000 token dengan hingga 128.000 token output, tetapi prompt di atas 272K input token "dihargai 2x input dan 1,5x output untuk seluruh sesi" (OpenAI API docs). Baca dengan seksama. Melewati batas sekali tidak membuat Anda membayar sedikit lebih pada overflownya. Ini menetapkan ulang harga seluruh sesi, termasuk output, sehingga satu tempel sembarangan dump 300K token menggandakan tagihan input Anda untuk setiap giliran berikutnya.
Anda membayar dua kali lipat untuk token yang paling mungkin merusak jawaban Anda.
Caching memberi penghargaan pada prefix yang stabil
API Claude menghargai cache read sebesar 0,1x input dasar, diskon 90%, sementara cache write dikenakan biaya 1,25x pada TTL 5 menit atau 2x pada TTL 1 jam (Claude Platform docs). Contoh perhitungan mereka: 100k token yang digunakan ulang sepuluh kali menghabiskan $1,075 versus $5,00 tanpa cache, penghematan 78,5%.
Diskon itu hanya berlaku jika prefix cocok byte demi byte. Caching bergantung pada prefix yang tepat, jadi jika Anda mengurutkan ulang dokumen, memasukkan timestamp ke dalam system prompt, atau mengacak definisi alat antar giliran, Anda membayar harga write lagi daripada harga read. Kebiasaan yang menjaga cache tetap hangat adalah yang sama yang menjaga recall tetap tinggi: tempatkan materi yang stabil pertama dalam urutan tetap, dan biarkan hanya kueri yang berubah di akhir.
Audit konteks yang bisa Anda jalankan minggu ini
Tidak ada dari ini yang membutuhkan API key atau tiket engineering. Setiap item adalah pengaturan yang sudah Anda miliki.
Enam pemeriksaan sebelum sesi panjang Anda berikutnya
- Buka chat baru daripada memperpanjang chat kemarin. Prompt terfokus Chroma (~300 token dari giliran relevan) mengalahkan riwayat penuh 113k token di setiap keluarga model yang mereka uji, dengan Claude menunjukkan kesenjangan terlebar (Chroma).
- Baca memori tersimpan Anda dan hapus yang usang. Fakta yang disimpan disuntikkan dengan atau tanpa bantuan.
- Lampirkan tiga dokumen bagus daripada dua belas yang biasa-biasa saja, dan bungkus masing-masing dalam tag
<document>dengan subtag<source>agar model dapat membedakannya (Claude docs). - Letakkan materi panjang di atas pertanyaan Anda. Pada input 20k+ token, urutan tersebut bernilai hingga 30% respons yang lebih baik dalam pengujian Anthropic (Claude docs).
- Tulis instruksi tetap sekali. AGENTS.md tingkat repo memotong median waktu berjalan 28,64% dan token output 16,58% di 124 PR (arXiv).
- Pertahankan prefix itu identik dari giliran ke giliran. Prefix stabil mendapatkan cache pada harga input 0,1x (Claude docs).
Satu kebiasaan yang memperbaiki sebagian besar output buruk
Sebelum Anda menulis ulang prompt, lihat apa yang sudah ada di window dan ambil sesuatu. Dokumentasi Anthropic sendiri menyatakannya: "lebih banyak konteks tidak otomatis lebih baik" (Claude docs). Ubah apa yang Anda masukkan ke model sebelum Anda mengubah cara Anda bertanya.
Pertanyaan yang Sering Diajukan
Apa itu context engineering, dan apa bedanya dengan prompt engineering?
Anthropic mendefinisikan context engineering sebagai "kumpulan strategi untuk mengkurasi dan memelihara kumpulan token (informasi) yang optimal selama inferensi LLM, termasuk semua informasi lain yang mungkin masuk ke sana di luar prompt" (Anthropic Engineering). Prompt engineering menanyakan cara merumuskan permintaan. Context engineering menanyakan konfigurasi konteks mana yang paling mungkin menghasilkan perilaku yang Anda inginkan, dan mencakup semua yang menempati window: system prompt, setiap pesan termasuk hasil alat, gambar dan PDF, definisi alat itu sendiri, dan output model sendiri termasuk extended thinking (Claude Platform docs). Anthropic menganggapnya sebagai perkembangan alami dari prompt engineering, bukan penggantinya.
Apakah context window yang lebih besar selalu berarti output AI yang lebih baik?
Tidak. Konteks yang diiklankan dan konteks yang bisa digunakan adalah dua angka yang berbeda: benchmark NoLiMa menguji 13 model yang semuanya mengklaim dukungan 128K atau lebih, dan pada 32K token, 11 dari 13 mendapat skor di bawah setengah baseline konteks pendek mereka sendiri, dengan Llama 3.1 70B turun dari 94,3% menjadi 42,7% (arXiv:2502.05167, Februari 2025). Dokumentasi platform Anthropic sendiri mengatakannya dengan jelas: "lebih banyak konteks tidak otomatis lebih baik. Saat jumlah token bertambah, akurasi dan recall menurun" (Claude Platform docs). Mengisi window juga menghabiskan uang secara bertahap daripada linear, karena OpenAI menagih prompt GPT-5.4 di atas 272K input token sebesar 2x input dan 1,5x output untuk seluruh sesi (OpenAI API docs).
Apa itu context rot dan bagaimana cara menghindarinya?
Context rot adalah degradasi akurasi dan recall saat jumlah token dalam permintaan bertambah, dan Anthropic menyebutnya dalam dokumentasinya sendiri (Claude Platform docs). Studi Context Rot Chroma menguji 18 model termasuk GPT-4.1, Claude 4, Gemini 2.5, dan Qwen3, dan menemukan keandalan menurun dengan input yang lebih panjang bahkan pada tugas retrieval dan replikasi kata yang sepele; dalam pengujian LongMemEval-nya, setiap keluarga model melakukan lebih baik pada prompt terfokus ~300 token daripada pertanyaan yang sama terkubur dalam ~113k token riwayat percakapan, dengan model Claude menunjukkan kesenjangan terlebar (Chroma, Juli 2025). Hindari dengan hanya menempel bagian yang penting, memulai chat baru untuk topik baru daripada memperpanjang yang lama, dan meminta agen khusus mengembalikan ringkasan padat 1.000 hingga 2.000 token ke agen koordinator daripada transkrip penuh (Anthropic Engineering).
Haruskah saya mematikan memori ChatGPT, Claude, atau Gemini?
Tergantung pada tugasnya, karena memori menyuntikkan token yang tidak Anda pilih ke dalam window di mana segalanya dihitung terhadap total (Claude Platform docs). Untuk penyusunan rutin di mana model mengetahui peran, gaya, dan tumpukan Anda menghemat pengetikan ulang, biarkan menyala. Untuk analisis berisiko tinggi dari dokumen tertentu, mulailah chat bersih dengan memori dimatikan, karena Chroma menemukan setiap keluarga model menjawab lebih baik dari prompt terfokus ~300 token daripada jawaban yang sama dikelilingi ~113k token riwayat yang tidak terkait (Chroma). Perlakukan memori sebagai system prompt tetap yang Anda bayar di setiap giliran, dan pangkas seperti Anda memangkas system prompt.
Apakah saya membutuhkan RAG, atau bisa saya langsung menempel dokumen ke dalam prompt?
Panduan Anthropic mengatakan bahwa retrieval sering kali tidak diperlukan pada skala kecil: "Jika basis pengetahuan Anda lebih kecil dari 200.000 token (sekitar 500 halaman materi), Anda bisa langsung menyertakan seluruh basis pengetahuan dalam prompt" (Anthropic Engineering, September 2024). Di atas itu, retrieval hygiene saling menguatkan dalam benchmark Anthropic: menambahkan konteks spesifik chunk sebelum embedding memotong kegagalan retrieval top-20 dari 5,7% menjadi 3,7%, menambahkan pencarian hibrida BM25 kontekstual membawa ke 2,9%, dan reranking pass membawa ke 1,9%, pengurangan 67% secara keseluruhan. Jika korpus Anda cocok, menempel adalah default yang lebih baik, dan prompt caching membuat penggunaan ulang murah pada cache read yang dihargai 0,1x input dasar (Claude Platform docs).
Di mana saya harus meletakkan dokumen panjang dalam prompt — sebelum atau sesudah pertanyaan saya?
Untuk Claude, letakkan data format panjang di bagian atas, di atas kueri, instruksi, dan contoh Anda. Dokumentasi prompting Anthropic memberikan ini sebagai aturan konkret untuk input 20k token atau lebih dan mengatakan "kueri di akhir dapat meningkatkan kualitas respons hingga 30 persen dalam pengujian, terutama dengan input multidokumen yang kompleks" (Claude Platform docs). Dokumen yang sama merekomendasikan membungkus setiap dokumen dalam tag <document> dengan subtag <source> dan <document_content>, dan meminta model untuk mengutip bagian yang relevan sebelum menjawab. Vendor tidak sepakat tentang urutan, jadi template yang disalin dari buku panduan satu provider bisa berkinerja buruk pada model provider lain, dan layak menjalankan kedua urutan sekali pada tugas Anda sendiri.