

Model open-weight kini cukup dekat dengan model closed terbaik, sehingga untuk banyak pekerjaan, pertanyaan sebenarnya bukan lagi soal kualitas. Yang menentukan adalah siapa yang menjalankan modelnya, ke mana data Anda pergi, dan apa yang boleh Anda lakukan menurut lisensinya. Bloomberg Intelligence menempatkan selisih antara model Tiongkok teratas dan model AS terdepan di sekitar 3% pada satu benchmark besar, turun dari sekitar 15% di awal tahun ini (AI Weekly, mengutip Bloomberg).
Pergeseran ini paling berarti bagi developer, startup, atau tim dengan aturan privasi ketat. Sekarang Anda bisa mengunduh model dari Hugging Face, menjalankannya di hardware yang Anda kendalikan, dan mendapatkan hasil coding serta agent yang setahun lalu masih terkunci di balik API berbayar. Atau Anda bisa melewatkan urusan hardware dan memanggil weights yang sama lewat host yang murah.
Tidak semuanya menguntungkan. "Open" mencakup lisensi dari yang bebas dipakai apa saja sampai yang harus dibaca teliti sampai ke huruf kecil, sebagian model terbesar butuh satu rak GPU, dan beberapa membawa beban keamanan dan sensor yang nyata. Panduan ini memilah para pemimpin saat ini, menunjukkan biayanya, dan memberi aturan untuk memilih. Kalau Anda ingin melihat lanskap model closed dan open yang lebih luas, papan Top 25 LLM kami memantaunya.
Selisihnya menyempit, dan susunan pemainnya berubah
Selisih benchmark adalah berita utamanya, jadi inilah yang ada di baliknya. Menurut pembacaan Bloomberg, model Tiongkok teratas tertinggal sekitar 15% di awal tahun ini, sekitar 9% pada pertengahan tahun, dan sekitar 6% sebulan kemudian, rekor terendah saat itu (The Next Web). Pembacaan terbaru menunjukkan sekitar 3%. Titik data terbarunya adalah DeepSeek V4.1 Flash, yang mencetak 81,1 di LiveBench dibandingkan 83,4 untuk model Anthropic terdepan, dan memimpin sub-tes agentic coding benchmark itu dengan skor 77,3 berbanding 66,1.
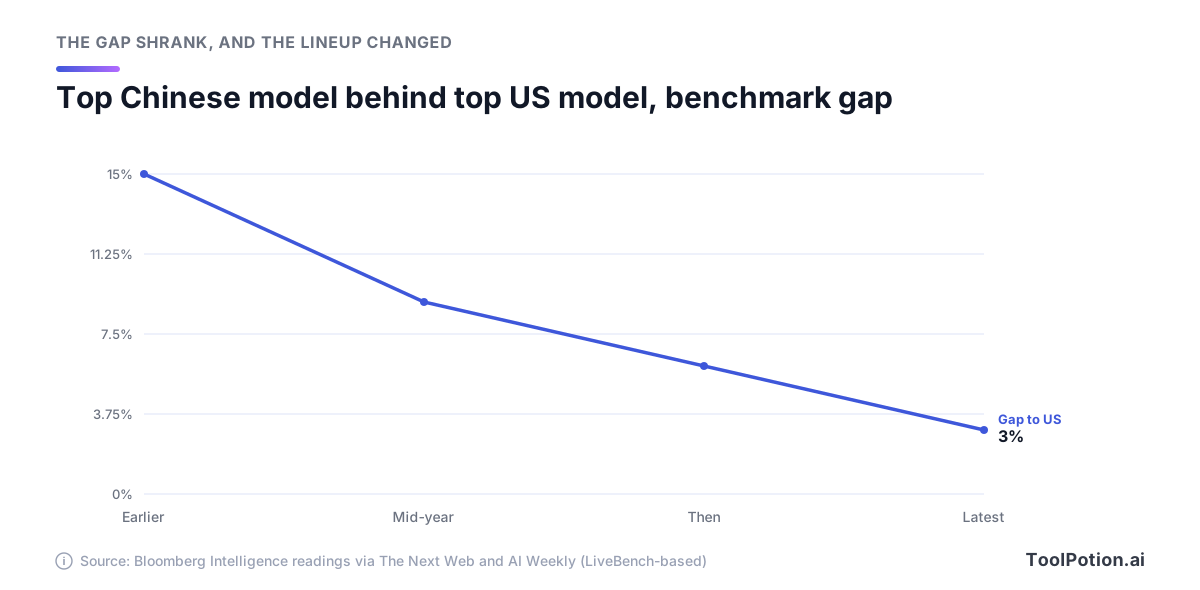
Tetap perhatikan catatannya. Hanya tiga dari 15 entri teratas LiveBench yang berasal dari Tiongkok, jadi ini cerita tentang batas terdepan, bukan penyapuan bersih. Selisih ini juga hanyalah pandangan satu benchmark terhadap model terbaik di masing-masing sisi, dan kedua sumber tidak menyebut bahwa angkanya terbatas pada model open. Meski begitu, arahnya jelas, dan model yang menutup selisih itu, DeepSeek V4.1 Flash, adalah open-weight.
Dua hal lain berubah tahun ini. Pertama, Qwen merilis model kelas Max sebagai open weights untuk pertama kalinya, menurut model card Qwen3.8-2.4T-A95B sendiri. Kedua, rilis open Meta bergeser. Model Llama terbaru di halaman Hugging Face Meta masih keluarga Llama 4 dari 2025, seperti Llama 4 Scout. Situs developer Meta kini mengedepankan model Muse Spark yang di-hosting, dan mencantumkan Muse Glimmer, model open-weight 30B untuk agent lokal, sebagai satu-satunya yang open.
Mistral adalah kabar lainnya. Perusahaan ini baru saja mengumumkan Mistral Large 4, model dengan 1 triliun parameter dan 52 miliar aktif, serta merilis versi preview di API-nya. Mistral mengatakan weights-nya menyusul sebelum akhir bulan (Mistral). Saat artikel ini ditulis, weights-nya belum bisa diunduh dan Mistral belum menerbitkan lisensi, jadi anggap Large 4 sebagai janji, bukan rilis. Jangan jadikan dasar rencana sebelum weights dan lisensinya ada di Hugging Face.
Model open-weight yang patut Anda kenal
Berikut para pemimpin saat ini sekilas. Ukuran dan lisensi diambil dari model card Hugging Face masing-masing, harga dari halaman harga resmi tiap pembuatnya. "Active" adalah jumlah parameter yang aktif per token pada model mixture-of-experts, yang menentukan kecepatan.
| Model | Lisensi | Ukuran (active) | Konteks | API pembuat, $ per juta token masuk / keluar |
|---|---|---|---|---|
| DeepSeek V4.1 Flash | MIT | 763B (8B hingga 16B) | 1M | 0,30 / 1,20 jam sibuk |
| DeepSeek V4-Pro | MIT | 1,7T | 1M | 1,32 / 3,96 jam sibuk |
| Kimi K3 | Kimi K3 License | 2,8T (104B) | 1M | 3.00 / 15.00 |
| GLM-5.3 | GLM-5.3 License | 753B | 1M | 1.40 / 4.40 |
| Qwen3.8-27B | Apache 2.0 | 27B dense | 262K | versi hosted segera hadir |
| gpt-oss-120b | Apache 2.0 | 117B (5,1B) | n/a | tidak ada API dari pembuatnya |
| Gemma 4 31B | Apache 2.0 | 31B dense | 256K | tidak ada API dari pembuatnya |
| Muse Glimmer | Apache 2.0 | 30B dense | 131K+ | tidak ada API dari pembuatnya |
| Mistral Large 4 | belum diterbitkan | 1T (52B) | n/a | 1,36 / 4,18 preview |
DeepSeek adalah pilihan default paling aman soal biaya. Weights V4.1 Flash-nya berlisensi MIT, harga API-nya terendah di antara model-model besar, dan diskon setengah harga di jam sepi memangkasnya lebih jauh (dokumentasi DeepSeek). Jangan tertipu namanya. "Flash" di sini adalah model 763B dengan unduhan 510 GB (model card). V4-Pro-0813 masih lebih besar, sekitar 1,7T.
Kimi K3 adalah yang paling mencuri perhatian. Dengan 2,8 triliun parameter dan 104 miliar aktif, model ini mencetak 93,5 di GPQA Diamond dan 91,2 di BrowseComp menurut kartu modelnya sendiri. Itu angka dari Moonshot, jadi anggap sebagai klaim. API Moonshot sendiri juga yang paling mahal di kelompok open, yang mengejutkan banyak orang (penjelasannya di bawah).
GLM-5.3 dari Z.ai adalah spesialis coding. Model ini berbagi base model dengan GLM-5.2, dan Z.ai mengatakan semua peningkatannya datang dari post-training, termasuk lonjakan 50% pada benchmark coding internalnya (model card). Itu pengukuran dari vendor. Saudaranya yang murah, GLM-5.3-Flash, dihargai $0,15 untuk input dan $0,50 untuk output.
Qwen punya jangkauan terluas. Qwen3.8-27B adalah model dense 27B berlisensi Apache 2.0 dengan kemampuan vision, konteks native 262K, dan skor 61,7 di SWE-bench Pro menurut laporannya (model card). Untuk satu workstation, ini percobaan pertama terbaik untuk pekerjaan coding dan agent, dan bagi kebanyakan tim kecil, inilah model untuk memulai. Qwen3.8-2.4T yang besar berada di bawah lisensi terpisah, dibahas berikutnya. Anda juga bisa mencoba Qwen lewat aplikasinya.
gpt-oss-120b dari OpenAI kini sudah tua tetapi masih berguna. Lisensinya Apache 2.0, punya 5,1B parameter aktif, dan menurut OpenAI bisa berjalan di satu GPU 80 GB (model card). Model ini dirilis pada 2025, dan tidak ada rilis gpt-oss yang lebih baru di halaman Hugging Face OpenAI. Gemma 4 adalah keluarga Google saat ini; model 31B-nya berlisensi Apache 2.0, punya jendela 256K, dan tersedia dalam build terkuantisasi untuk Ollama dan llama.cpp (model card). Muse Glimmer adalah yang kecil: Meta mengatakan versi sekitar 4-bit berukuran di bawah 20 GB dan berjalan dalam batas 24 GB atau 32 GB, dengan penurunan kualitas sekitar 1% pada pengaturan yang lebih ketat (model card).
Eropa punya dua opsi saat ini. Mistral Medium 3.5 adalah model dense 128B dengan jendela 256K di bawah lisensi MIT yang dimodifikasi, yang oleh Mistral digambarkan terbuka untuk penggunaan komersial kecuali bagi perusahaan berpendapatan besar. Mistral Small 4, yang berukuran 119B, dan Mistral Large 3 yang lebih lama berlisensi Apache 2.0 di Hugging Face.
"Open" tetap bisa disertai syarat
Hanya model Apache 2.0 dan MIT yang open dalam arti yang dimaksud kebanyakan developer. Beberapa yang terkuat tidak demikian. Baca file lisensinya, bukan judul beritanya.
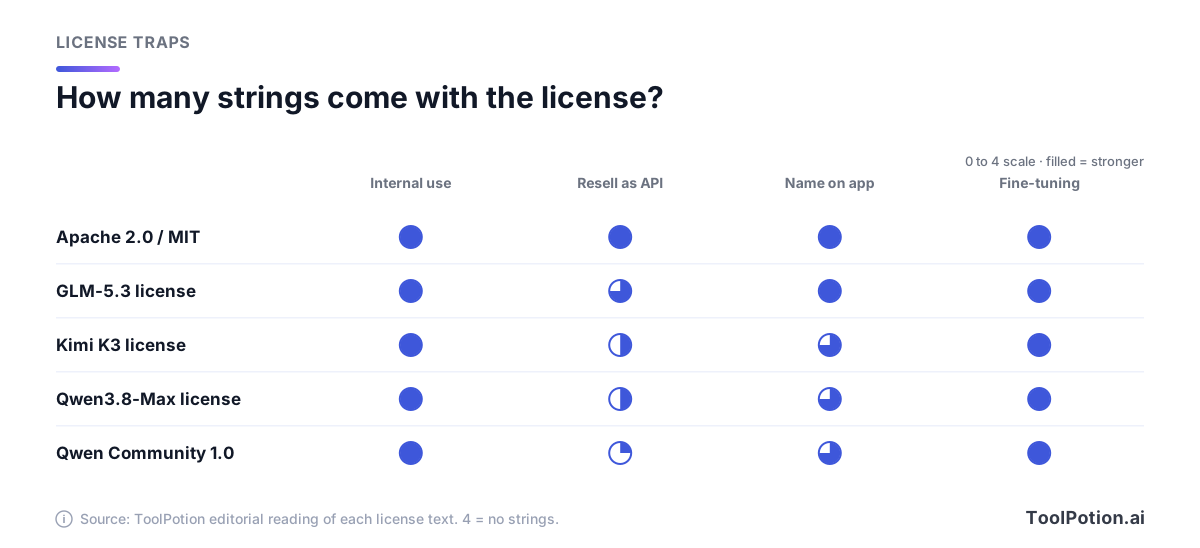
Polanya sama di semua lisensi kustom. Anda bebas memakai, memodifikasi, dan fine-tune. Syaratnya melekat pada penjualan model ke orang lain, biasanya sebagai API, begitu Anda melewati batas pendapatan tertentu. Lisensi Moonshot, misalnya, menyatakan operator "Model as a Service" dengan pendapatan lebih dari $20 juta dalam 12 bulan perlu perjanjian terpisah sebelum penggunaan komersial. Produk dengan 100 juta pengguna bulanan atau pendapatan bulanan $20 juta wajib menampilkan "Kimi K3" di antarmukanya (teks lisensi). Penggunaan internal dikecualikan.
Lisensi Z.ai lebih longgar. Satu-satunya syarat adalah tinjauan keamanan untuk operator Model-as-a-Service dengan pendapatan di atas $10 miliar. Lisensi Qwen yang paling ketat di kelompok ini. Qwen Community License pada Qwen3.8-Flash-Next menyatakan setiap perusahaan yang menjalankan bisnis Model-as-a-Service atau "AI Work Assistant" harus lebih dulu mendapat lisensi terpisah dari Qwen, dengan pengecualian untuk penggunaan internal (teks lisensi). Lisensi Max pada model 2.4T menaikkan batas itu menjadi pendapatan $50 juta.
Kalau Anda membangun aplikasi di atas salah satu model ini, hampir pasti aman. Kalau produk Anda adalah "API yang melayani model ini", baca lisensinya bersama pengacara sebelum meluncur. Kalau Anda butuh kepastian penuh, pilih Apache 2.0 atau MIT. Artinya DeepSeek, Qwen3.8-27B, gpt-oss, Gemma 4, dan Muse Glimmer.
Biaya API yang di-hosting
Open weights tidak berarti API murah. Gambarannya berubah tergantung siapa yang menghosting modelnya.
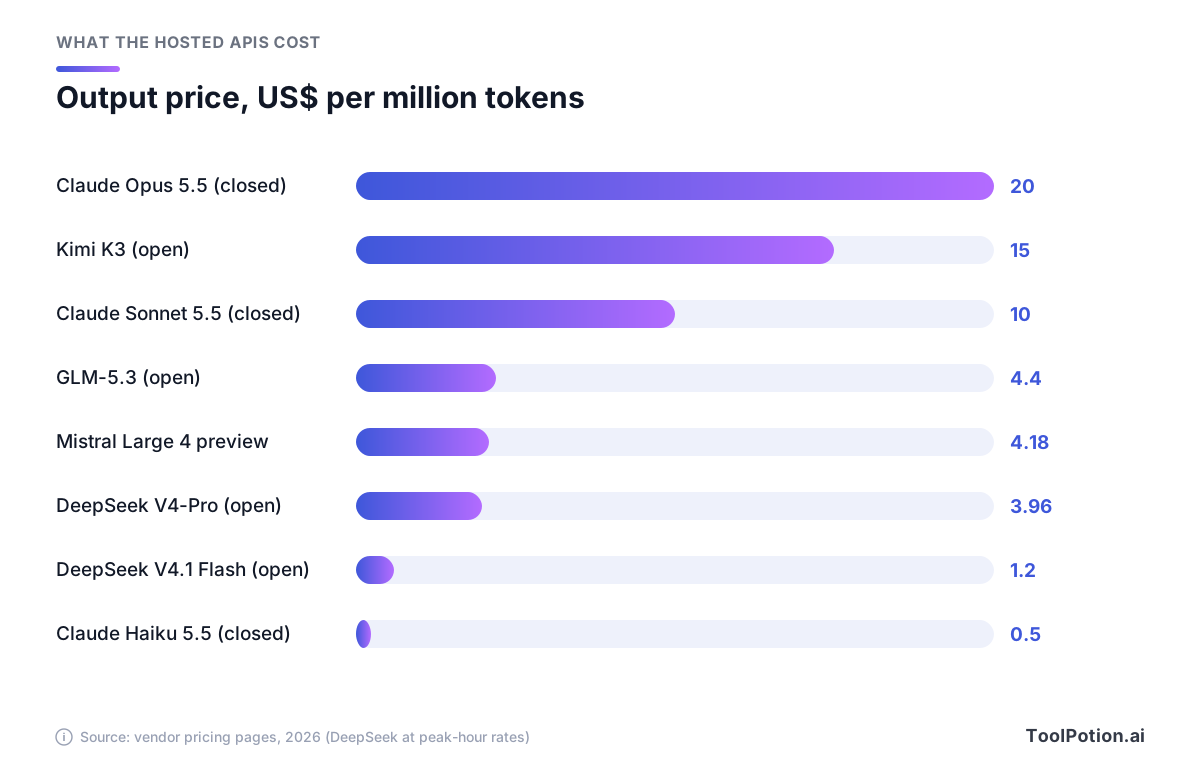
Moonshot mengenakan $3 untuk input dan $15 untuk output per juta token untuk Kimi K3, menurut halaman harganya. Itu lebih mahal daripada Claude Sonnet 5.5 dari Anthropic yang $2 dan $10, padahal Sonnet adalah model closed. DeepSeek kebalikannya: output V4-Pro berharga $3,96 saat jam sibuk dan $1,98 di luar jam sibuk. GLM-5.3 dari Z.ai $1,40 untuk input dan $4,40 untuk output.
Model kecil yang closed mengalahkan harga sebagian besar flagship open. Claude Haiku 5.5 dihargai $0,10 untuk input dan $0,50 untuk output, sama dengan GPT-6 Luna dari OpenAI, menurut halaman harga masing-masing vendor. Jadi "pakai open supaya hemat" hanya berlaku terhadap tier closed yang mahal, dan hanya kalau Anda memilih host open yang murah.
Jalur termurah sering kali adalah pihak ketiga yang melayani weights yang sama. Daftar model publik OpenRouter menunjukkan gpt-oss-120b sekitar $0,04 untuk input dan $0,17 untuk output per juta token, dan harga di sana bervariasi menurut provider serta sering berubah. OpenRouter, Together AI, Fireworks AI, dan Groq semuanya menjual ulang model open dengan satu format API, jadi berpindah provider cukup dengan mengganti base URL.
Jalankan sendiri atau pakai host
Ada empat cara menjalankan model open, dan masing-masing memberi sedikit lebih banyak kendali sekaligus sedikit lebih banyak kerja.
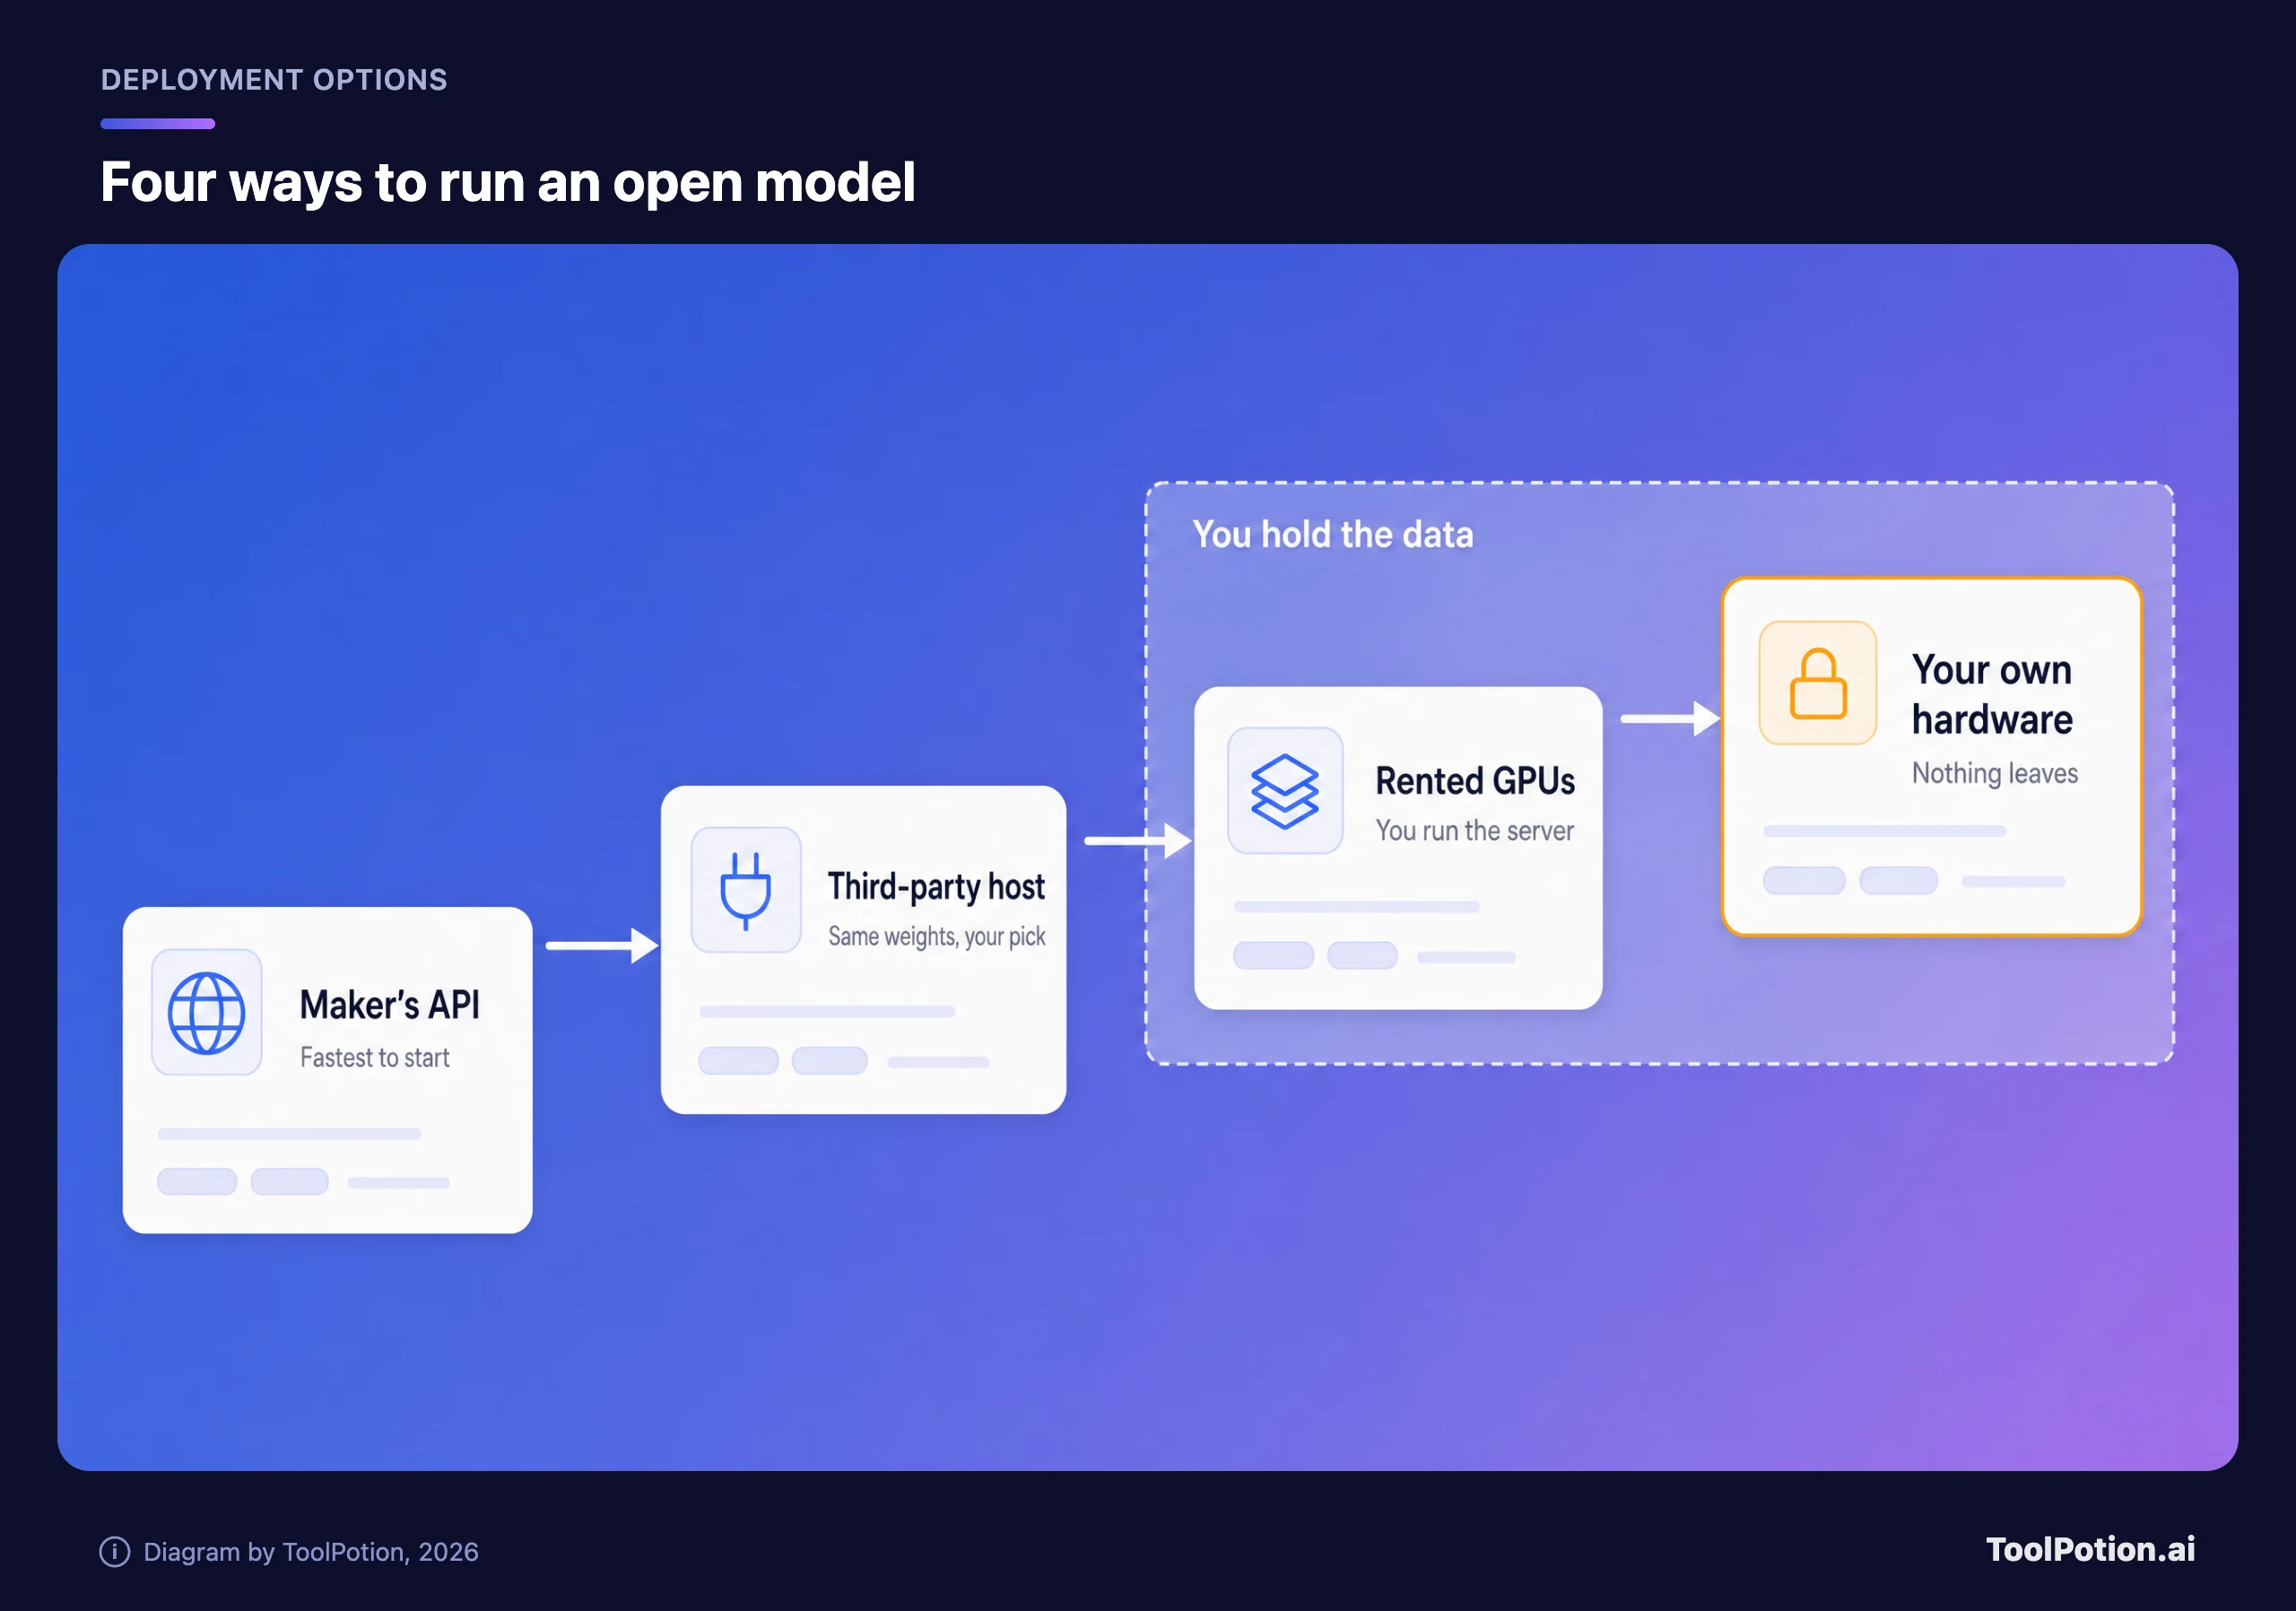
Dua yang pertama dikelola pihak lain. Anda mengirim token ke pembuat model atau ke host, dan data Anda melewati jaringan milik orang lain. Dua yang terakhir menaruh model di mesin yang Anda kendalikan, itulah intinya kalau kontrak atau regulator menyatakan data tidak boleh keluar. Weights yang tidak muat di hardware Anda adalah penghambat yang paling umum, jadi mulailah dari ukuran.
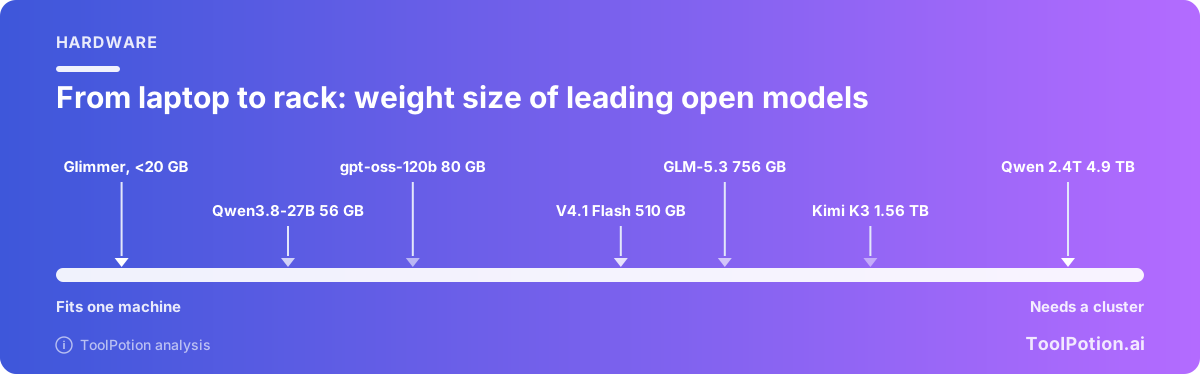
Sebagian besar model papan atas jauh terlalu besar untuk satu mesin. Weights Kimi K3 saja sudah 1,56 TB, lebih dari 1,44 TB yang Anda dapat dari satu node delapan GPU berisi kartu B200 180 GB. DeepSeek V4-Pro dan GLM-5.3 masing-masing butuh ratusan gigabyte. Model yang muat di satu mesin adalah kelas 20B sampai 120B. Gunakan estimator untuk memeriksa model dan presisi terhadap hardware Anda.
Coba nilai defaultnya. gpt-oss-120b pada 4-bit butuh sekitar 70 GB termasuk overhead, jadi muat di satu GPU 80 GB. Ganti ke Kimi K3 dan estimator yang sama meminta sepuluh GPU 180 GB. Sepuluh GPU berarti dua node delapan GPU. Dengan harga on-demand Lambda sebesar $6,69 per jam B200 dari halaman harga Lambda, 16 GPU itu yang berjalan sebulan penuh totalnya sekitar $78.000. Itulah biaya self-hosting model open kelas frontier, sebelum ada orang yang mengoperasikannya.
Di ujung yang kecil jauh lebih ramah. Lambda mencantumkan GPU 80 GB mulai $3,99 per jam, sekitar $2.900 per bulan kalau berjalan 24 jam nonstop. Apakah itu lebih baik daripada API sepenuhnya bergantung pada volume.
Pada 300 juta token output per bulan dan harga API $10, kedua tagihan hampir sama. Di bawah itu, API menang. Di atasnya, sewa menang, asalkan GPU-nya sibuk dan modelnya cukup baik untuk pekerjaannya. Pembandingan yang jujur adalah dengan host murah, tentu saja. Dengan harga host gpt-oss-120b yang tercantum, sekitar $0,17 per juta token output, $2.900 membeli sekitar 17 miliar token output, jadi satu GPU sewaan hampir tidak pernah mengalahkan host dari sisi biaya saja. Sewalah untuk privasi, kendali, dan latensi yang bisa diprediksi. Jangan menyewa demi menghemat biaya pada model kecil.
Berikut contoh hitungan dengan volume karangan tetapi masuk akal. Misalkan tim support meringkas 20.000 tiket per hari, masing-masing 1.500 token masuk dan 300 token keluar. Itu sekitar 900 juta token input dan 180 juta token output per bulan. Di Claude Sonnet 5.5 dengan $2 dan $10 per juta, tagihannya $3.600. Di DeepSeek V4.1 Flash dengan tarif jam sibuk, paling banyak $486, dan setengahnya di luar jam sibuk. Di gpt-oss-120b dengan harga host yang tercantum, sekitar $64. Satu GPU 80 GB sewaan harganya $2.913 berapa pun yang Anda kirimkan. Host murah menang telak, dan model closed biayanya sekitar tujuh kali lipat model open pada harga dari pembuatnya sendiri.
Dua jalan pintas membantu sebelum Anda mengeluarkan uang. Untuk laptop atau workstation, Ollama dan llama.cpp menjalankan build terkuantisasi Gemma 4, Qwen3.8-27B, dan Muse Glimmer dengan satu perintah. Untuk server produksi, vLLM adalah engine serving yang sama-sama tercantum sebagai didukung di model card Kimi K3 dan Qwen3.8.
Cara memilih
Mulailah dari kendala Anda, bukan dari leaderboard. Tiga pertanyaan cukup untuk memilah sebagian besar kasus.
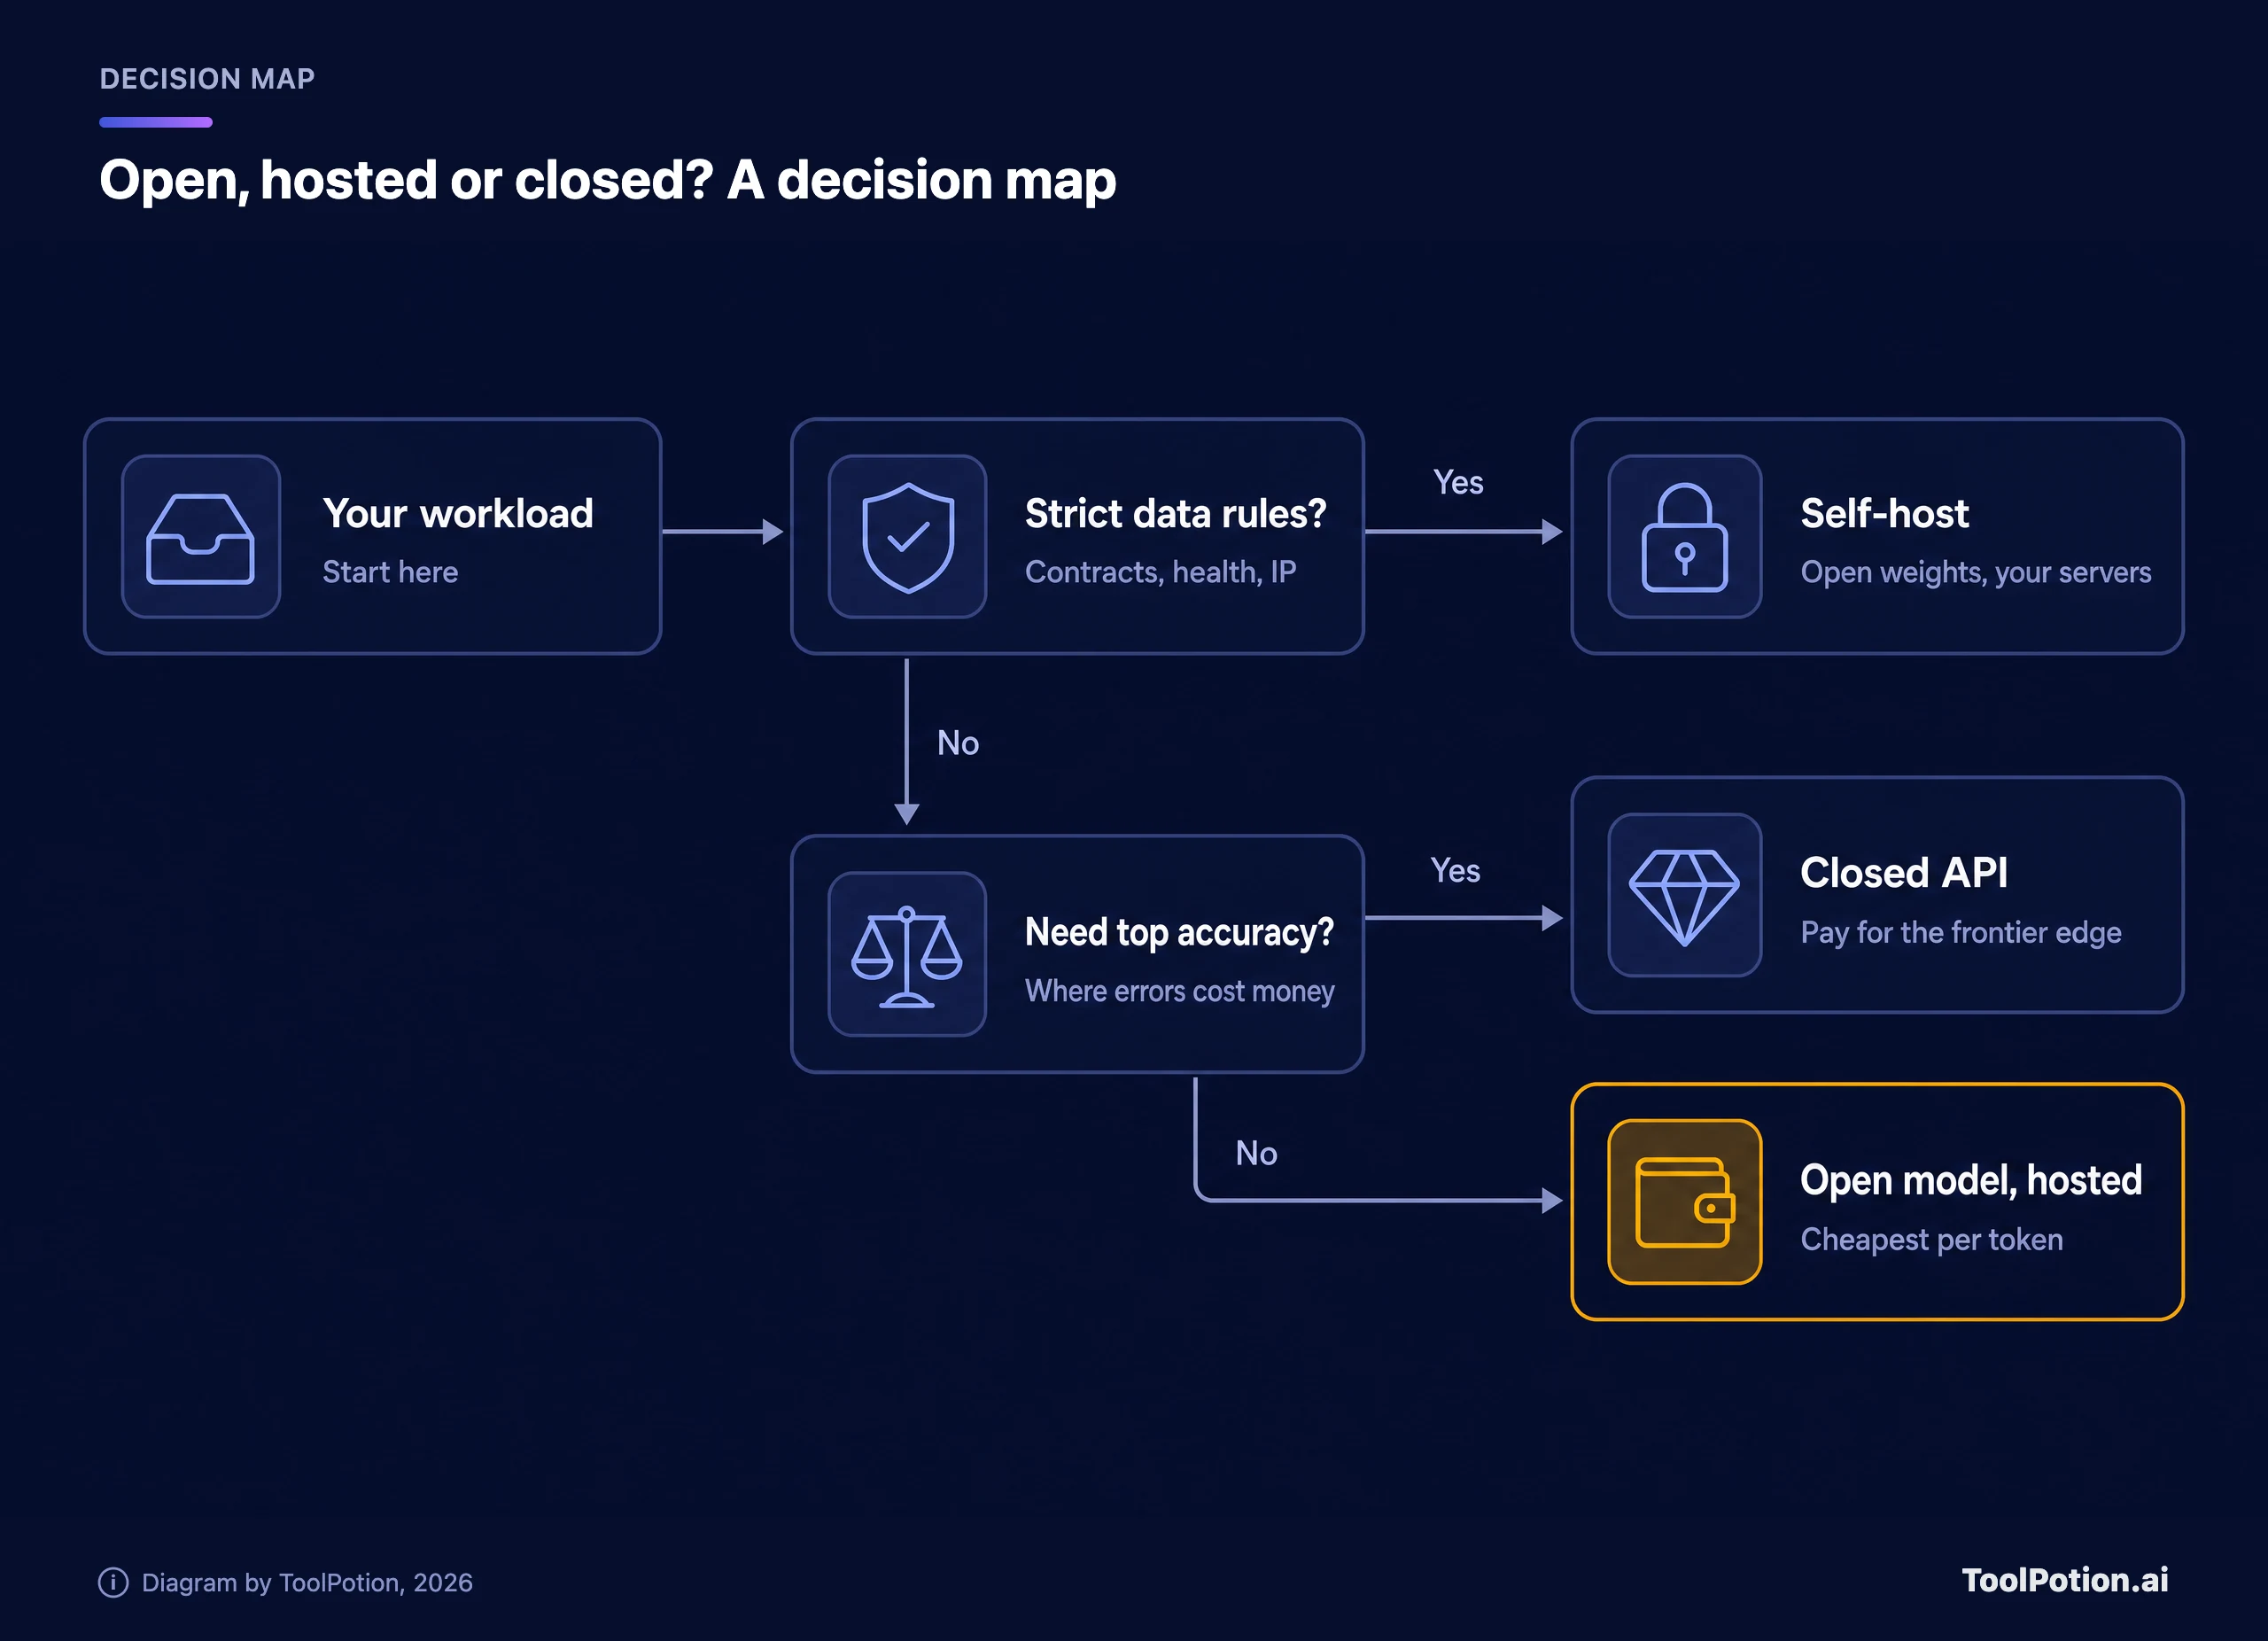
Kalau data Anda tidak boleh keluar dari kendali Anda, Anda self-hosting, dan modelnya harus muat di hardware Anda. Dengan kendala itu:
- Satu GPU atau workstation: Qwen3.8-27B untuk coding dan agent, gpt-oss-120b kalau Anda ingin model buatan Barat, Muse Glimmer atau Gemma 4 untuk laptop.
- Server multi-GPU: DeepSeek V4.1 Flash atau GLM-5.3 jika Anda sanggup membeli delapan kartu besar dan beberapa ratus gigabyte weights.
- Cluster: Kimi K3 atau Qwen3.8-2.4T, tetapi hanya kalau Anda punya tim yang pekerjaannya menjalankan inference.
Kalau data Anda boleh keluar, tanyakan apakah kesalahan itu mahal. Di mana kesalahan mahal (draf hukum, analisis keuangan, kode yang rilis tanpa review), bayar model frontier closed dan uji pada contoh Anda sendiri. Di mana tidak (meringkas, tagging, ekstraksi, pencarian internal, kode draf pertama), model open lewat host murah adalah harga terbaik yang bisa Anda dapatkan.
Jalankan daftar ini secara berurutan sebelum memilih:
1. Tuliskan kendala yang tidak bisa digeser: lokasi data, anggaran per bulan, atau batas bawah kualitas.
2. Periksa lisensi untuk penggunaan Anda. Produk yang dibangun di atas model hampir selalu aman. Menjual ulang modelnya yang berisi syarat-syarat.
3. Periksa memori: weights dalam GB dibandingkan hardware yang benar-benar akan Anda beli atau sewa.
4. Hitung harga beban kerja yang sama di API pembuat, host pihak ketiga, dan GPU sewaan.
5. Jalankan 50 tugas Anda sendiri pada dua atau tiga kandidat dan pertahankan pemenangnya.
Uji sebelum berkomitmen. Benchmark di sini berasal dari vendor sendiri dan dijalankan pada suite yang berbeda, jadi skor 90 di satu leaderboard tidak banyak berarti dibanding 88 di leaderboard lain. Ambil 50 tugas nyata dari beban kerja Anda, jalankan pada dua atau tiga kandidat, lalu nilai hasilnya. Satu sore melakukan itu lebih berguna daripada seminggu membaca model card.
Risiko yang tidak dicantumkan di model card
Keamanan. Open weights tidak membuat model aman. Dalam evaluasi 2025 terhadap model DeepSeek yang lebih lama, NIST milik pemerintah AS menemukan bahwa yang terbaik di antaranya, R1-0528, menuruti 94% permintaan jelas-jelas berbahaya di bawah jailbreak umum, dibandingkan 8% untuk model referensi AS. Agent DeepSeek juga 12 kali lebih mungkin mengikuti instruksi berbahaya yang disembunyikan dalam konten yang mereka tangani (NIST CAISI). Itu model yang lebih lama daripada lini V4 saat ini, dan tidak ada evaluasi publik setara untuk rilis terkini di sumber-sumber di balik tulisan ini. Anggap sebagai alasan untuk menguji, terutama sebelum Anda memberi model alat dan akses tulis.
Sensor. NIST juga menemukan model DeepSeek menggaungkan narasi CCP yang tidak akurat empat kali lebih banyak daripada model referensi AS. Laporan NIST terpisah tentang Kimi K2 Thinking menemukan sensor yang berat dalam bahasa Mandarin, tetapi modelnya relatif tidak tersensor dalam bahasa Inggris, Spanyol, dan Arab. Kalau pengguna Anda bertanya soal politik atau sejarah dalam bahasa Mandarin, uji langsung. Kalau urusannya kode dan spreadsheet, hal ini jarang muncul.
Residensi data. Siapa yang menghosting model menentukan ke mana data Anda pergi. Kebijakan privasi DeepSeek menyatakan bahwa mereka mengumpulkan, memproses, dan menyimpan data pribadi di Republik Rakyat Tiongkok (kebijakan privasi DeepSeek). Itu berlaku untuk aplikasi dan API-nya sendiri, bukan untuk weights berlisensi MIT yang Anda jalankan di tempat lain. Mistral menawarkan yang sebaliknya: mereka mengatakan melatih Large 4 di datacenter mereka sendiri di Eropa dan menjalankan preview sebagai deployment Eropa di bawah hukum Eropa. Untuk host mana pun, tanyakan di mana inference berjalan dan apa yang dicatat sebelum Anda mengirim data pelanggan.
Basi. Model open kedaluwarsa dalam hitungan bulan. Weights gpt-oss sudah berumur setahun, Llama terbaru Meta berasal dari 2025, dan Qwen serta DeepSeek sama-sama merilis beberapa versi di 2026 saja. Kunci versi model persis yang Anda uji, dan uji ulang saat Anda upgrade.
Siapa yang masih sebaiknya membayar API closed
Selisih 3% adalah pembacaan satu benchmark. Model closed masih memimpin di puncak paling atas, dan lab yang menjualnya terus menambah alat dan fitur terkelola yang tidak disertakan dalam open weights.
Bayar Claude atau ChatGPT jika Anda butuh akurasi terbaik untuk pekerjaan sulit yang taruhannya tinggi, jika tidak ada orang yang bisa menjalankan infrastruktur, atau jika volumenya terlalu kecil untuk membuat pengaturan hosting apa pun berarti. Tim yang melakukan beberapa ribu panggilan per hari akan mengeluarkan lebih sedikit untuk waktu engineer daripada yang dihemat dari token. Bayar juga jika Anda ingin satu vendor bertanggung jawab atas uptime, keamanan, dan dukungan.
Campur, jangan berpindah total. Setup yang umum mengirim sebagian besar pekerjaan rutin ke model open lewat host dan mengeskalasi kasus sulit ke model closed. Aturan routing dalam panduan kami tentang mencocokkan tier model dengan tugas berlaku langsung di sini: default ke yang murah, eskalasi saat gagal.
Pertanyaan yang sering diajukan
Apa bedanya open-weight dan open-source?
Open-weight berarti Anda bisa mengunduh model yang sudah dilatih. Open-source, dalam arti ketat, juga mencakup data pelatihan dan kode di bawah lisensi yang disetujui. Hampir tidak ada dalam daftar ini yang memenuhi standar itu. Model Apache 2.0 dan MIT paling mendekati dalam praktik. Lisensi kustom seperti milik Kimi dan Qwen menambahkan syarat.
Bolehkah saya memakai model ini secara komersial?
Ya untuk membangun produk di atasnya, dengan setiap lisensi yang dibahas di sini. Syaratnya berlaku ketika Anda menjual model itu sendiri sebagai layanan, dan dalam beberapa kasus ketika produk Anda sangat besar. Model Apache 2.0 dan MIT sama sekali tidak memiliki syarat pendapatan.
Model open mana yang terbaik untuk coding?
Menurut angka yang dilaporkan vendor, GLM-5.3, Kimi K3, dan DeepSeek V4.1 Flash memimpin, dan ketiganya butuh hardware kelas server. Untuk satu mesin, Qwen3.8-27B adalah pilihan praktis. Jalankan tes sendiri pada codebase Anda, karena suite benchmark-nya berbeda-beda.
Apakah DeepSeek aman untuk data perusahaan?
Tergantung cara Anda menjalankannya. Aplikasi dan API DeepSeek menyimpan data di Tiongkok sesuai kebijakan di atas. Weights MIT, yang dijalankan di server sendiri atau host yang Anda percaya, tidak mengirim apa pun ke DeepSeek. Risiko perilaku model yang terpisah dari evaluasi NIST yang lebih lama tetap berlaku.
Berapa memori GPU yang saya butuhkan?
Kira-kira parameter dikali bit dibagi delapan, ditambah sekitar 20% untuk cache dan runtime. Model 27B pada 8-bit sekitar 33 GB termasuk overhead. Model 117B pada 4-bit sekitar 70 GB. Estimator di atas menghitungnya untuk Anda.
Kapan Mistral Large 4 akan open?
Mistral menjanjikan weights tak lama setelah pengumuman, dan belum menerbitkan syarat lisensinya. Cek halaman Hugging Face-nya sebelum Anda menjadikannya dasar rencana.